Примечание автора: на примере 30-минутной задачи для агента-разработчика разберём, из чего складываются расходы на обычный ввод, запись в кэш, чтение из кэша, вывод и обмен данными с инструментами при многократных вызовах агента. Сравним тарификацию кэша у трёх провайдеров и на примере 12 вызовов покажем, при каких условиях кэш действительно помогает сэкономить.
9 ноября 2026 года Google Cloud представила две системы TPU восьмого поколения — TPU 8tx и TPU 8i Max — и открыла исходный код TPU Sync для передачи KV-кэша. «Стена памяти в эпоху агентов» снова стала предметом обсуждения, и многие разработчики закономерно задаются вопросом: если KV-кэш на нижнем уровне работает всё быстрее, станет ли дешевле счёт за API агента?
Главное: прочитав статью, вы получите полную формулу расчёта стоимости агента, сравнение тарификации кэша у трёх провайдеров и список способов оптимизации затрат, которые можно применить сразу.
Стоимость многошаговых вызовов API агентом: кратко о главном
| Пункт | Подробности |
|---|---|
| Предыстория | 2026-11-09 Google представила TPU 8tx, TPU 8i Max и TPU Sync, уделив особое внимание узким местам, связанным с памятью и KV-кэшем в агентных системах |
| Что интересует разработчиков | Приведёт ли оптимизация на низком уровне к снижению счетов за вызовы Agent API |
| Главный вывод | Стоимость складывается из обычных входных токенов, записи в кэш, чтения из кэша, выходных токенов, количества вызовов и расходов на инструменты |
| Ключевые переменные | Стабилен ли префикс, покрывает ли TTL кэша время ожидания инструментов, не разрастается ли история диалога |
| На что влияет | Сценарии с многошаговыми вызовами: агенты для программирования, работы с длинными документами, совместной работы нескольких агентов и другие |
Как выглядит 30-минутная задача агента
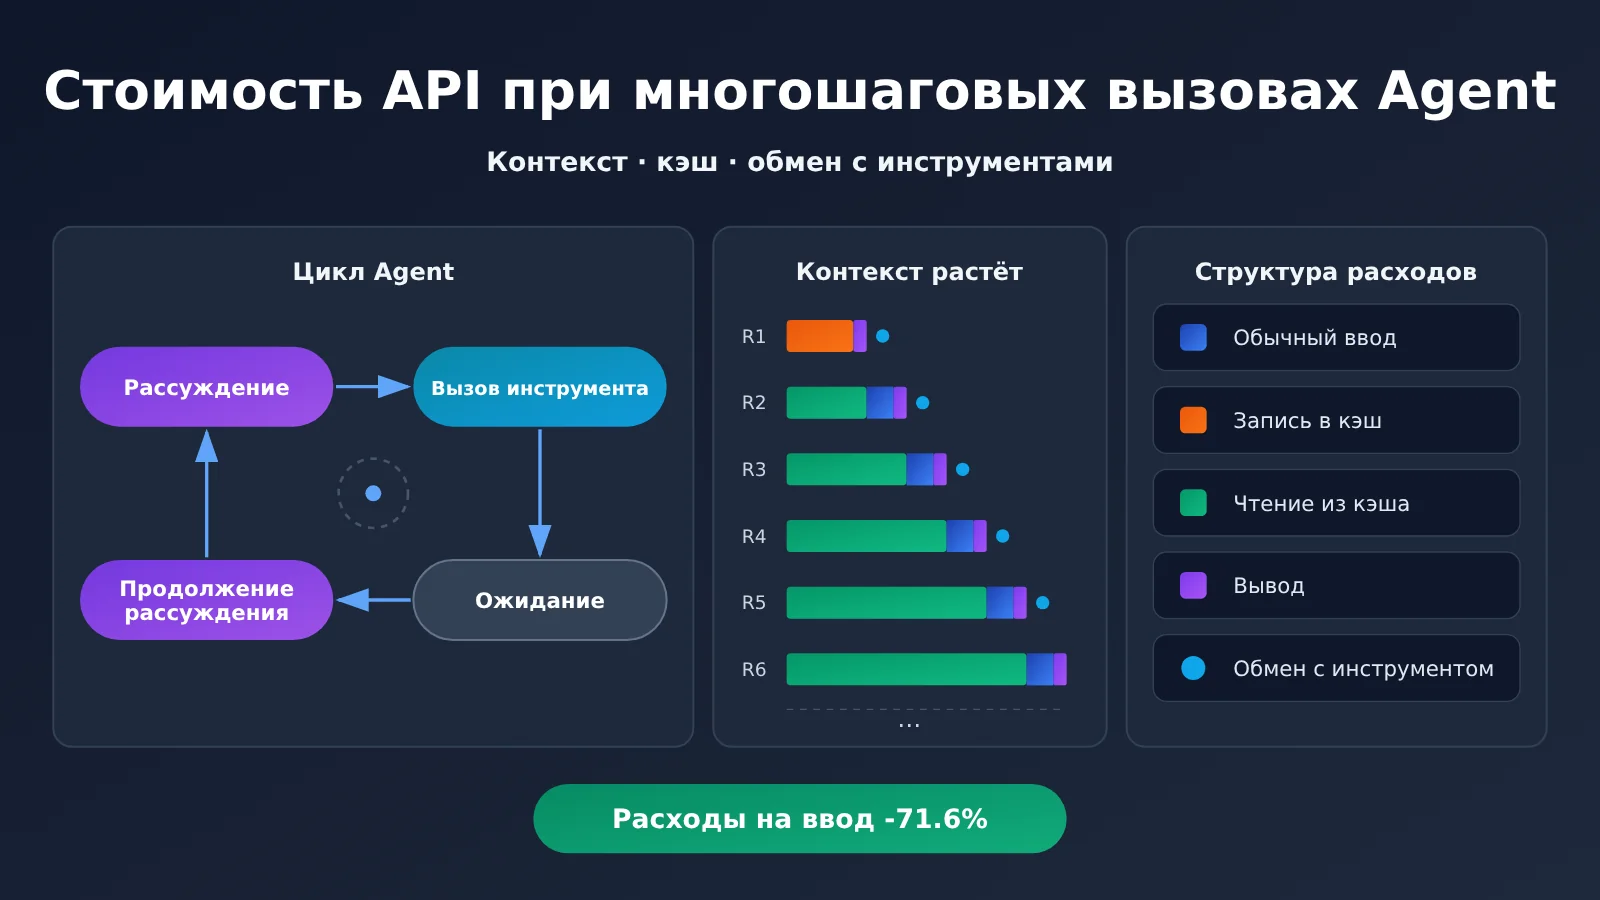
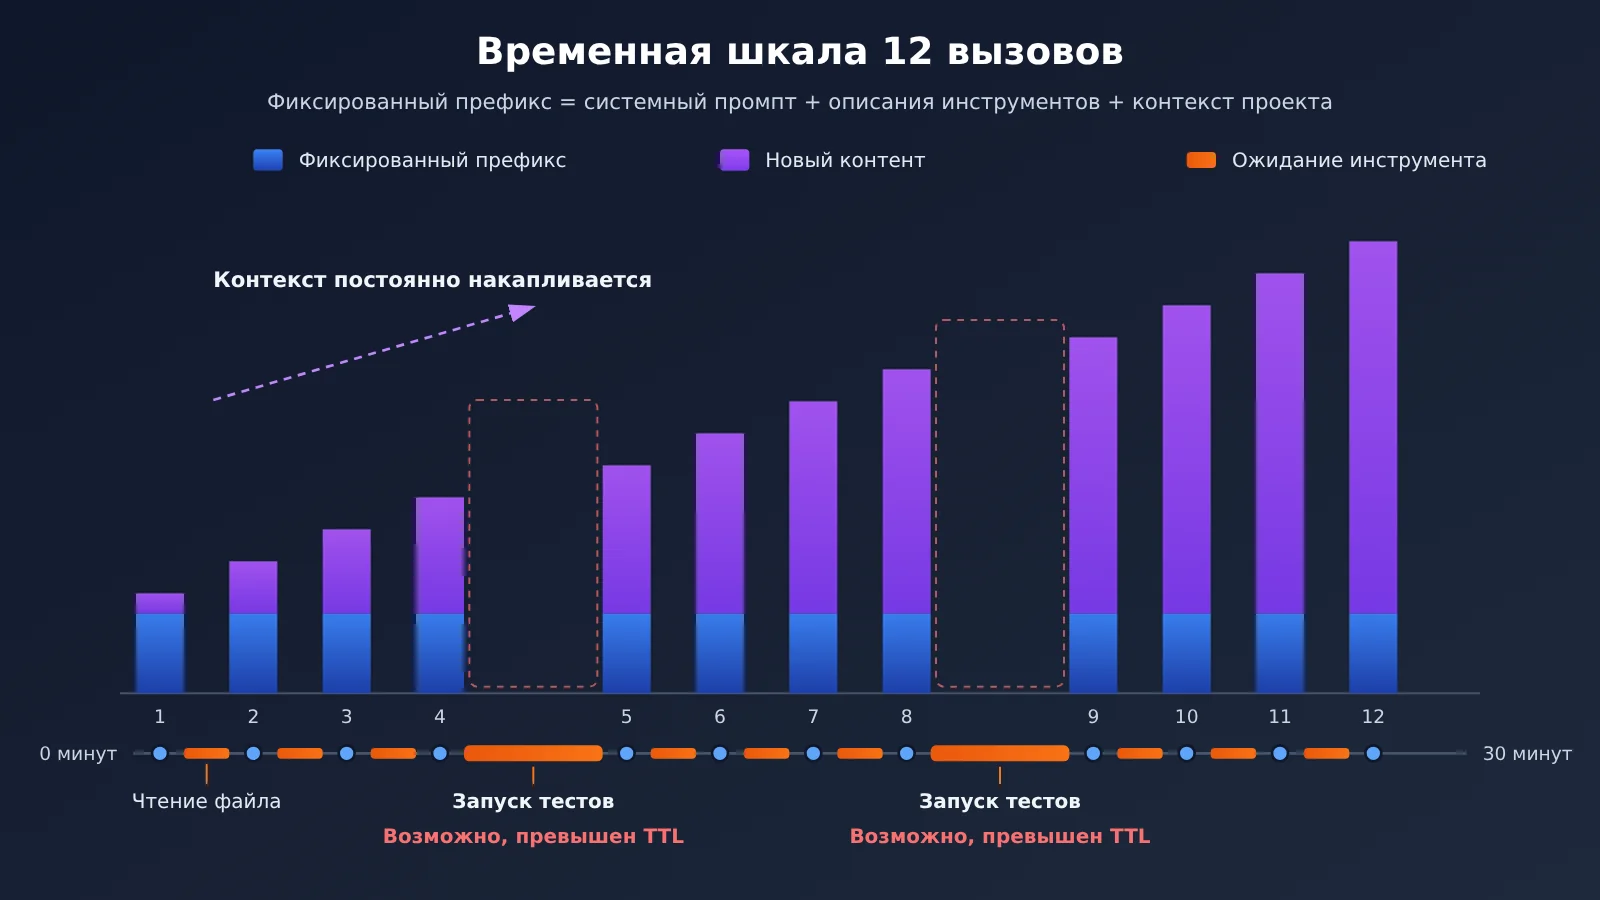
Представьте, что агент для разработки ПО получает задачу: исправить ошибки в тестах определённого модуля. Сначала он изучает структуру проекта и нужный исходный код, составляет план изменений, затем с помощью инструментов редактирует файлы и запускает тесты. Дождавшись результатов, он анализирует ошибки и продолжает работу. За 30 минут цикл «рассуждение — инструмент — ожидание — рассуждение» может повториться больше десяти раз.
Проблема в том, что API Большой языковой модели по сути не хранит состояние между запросами. При каждом вызове агенту приходится заново отправлять модели системный промпт, описания инструментов, контекст проекта, а также предыдущие реплики и результаты работы инструментов. Поэтому двенадцатый запрос часто включает почти всю историю первых одиннадцати раундов. Отсюда и возникает «повторный расчёт контекста».
Из чего складываются затраты на многошаговые вызовы API агентом
Если разобрать одну задачу агента на составляющие, в расходах можно выделить как минимум пять категорий. Первые четыре — это стоимость токенов модели, а пятая возникает за пределами модели, но о ней часто забывают.
| Статья расходов | Что означает | Особенности тарификации |
|---|---|---|
| Обычный ввод | Входные токены, которые не попали в кэш и тарифицируются по стандартной цене | Стандартная цена за входные токены |
| Запись в кэш | Часть входных данных, сохраняемая для повторного использования | У некоторых поставщиков и моделей тарифицируется по ставке выше стандартной цены на входные токены |
| Чтение из кэша | Входные данные, для которых нашлось совпадение в кэше | Обычно обходится намного дешевле, чем ввод по стандартной цене |
| Выходные токены | Сгенерированный моделью контент, включая параметры вызова инструмента | Как правило, самая высокая цена за токен; кэширование не снижает эти расходы |
| Инструменты и внешнее выполнение | Поиск, выполнение кода, базы данных и другие внешние сервисы | Тарифицируются отдельно по правилам соответствующих сервисов и увеличивают число вызовов модели |
На основе этих категорий можно записать формулу стоимости одной задачи:
Общая стоимость задачи = Σ (обычный ввод × цена входных токенов + запись в кэш × цена записи + чтение из кэша × цена чтения + выходные токены × цена выходных токенов) + расходы на инструменты и внешнее выполнение
Знак Σ означает, что стоимость суммируется по каждому вызову модели в рамках задачи. Поэтому само количество вызовов становится множителем: чем больше обращений к инструментам, тем больше вызовов модели и тем чаще приходится заново оплачивать фиксированный префикс. Вызов инструмента обходится не только в стоимость самого инструмента: он также разбивает один процесс рассуждения на несколько этапов, и при каждом модель снова получает весь контекст.
Разница между KV Cache, Prompt Cache и сжатием контекста при многошаговых вызовах Agent
Когда обсуждают стоимость работы Agent, эти три понятия чаще всего путают. Они относятся к разным уровням и по-разному влияют на счёт.
| Технология | Уровень | Что означает | Как влияет на пользователей API |
|---|---|---|---|
| KV Cache | Нижний уровень инференса модели | Сохраняет состояния Key/Value, используемые при вычислениях внимания, чтобы не пересчитывать предыдущие токены | Пользователь не управляет им напрямую; он влияет на затраты и задержки у поставщика услуг |
| Prompt Cache | Уровень API-сервиса | Поставщик услуг повторно использует одинаковые префиксы промптов и отдельно тарифицирует запись в кэш и чтение из него | Напрямую отражается в полях счёта, связанных с кэшированием |
| Сжатие контекста | Уровень приложения | Суммирует, отбирает или обрезает историю перед передачей модели | Сокращает фактическое число передаваемых токенов, но может привести к потере деталей |
Стоит отметить, что, согласно официальной документации OpenAI, Prompt Cache хранит KV-тензоры, а не исходный текст токенов. Поэтому Prompt Caching можно понимать как сервисное решение, которое использует повторное применение KV-состояний на нижнем уровне и предусматривает отдельную тарификацию. Оно не никак не связано с KV Cache, но пользователю заметны лишь правила оплаты.
Сжатие контекста — совсем другое. Оно меняет то, «что передаётся» в последующих запросах, а не то, «как повторно используются данные». Чем агрессивнее сжатие, тем меньше токенов, но тем выше риск, что Agent забудет важные детали.
Почему оптимизация нижнего уровня для многошаговых вызовов Agent не обязательно снижает счёт
Новая система Google TPU 8i Max удваивает пропускную способность HBM и объём встроенной SRAM. TPU Sync во внутренних тестах на платформе Ironwood сократил задержку передачи KV Cache более чем на 90%, а Agent Compute Engine приостанавливает сессии, когда Agent бездействует, и выгружает рабочую память с чипа. Эти оптимизации повышают эффективность использования ресурсов у поставщика услуг и снижают задержки инференса, например TTFT. Для пользователя это может означать более быстрый ответ.
Но цены на API устанавливает сам поставщик услуг, а счёт пользователя по-прежнему зависит от числа токенов. Рост эффективности оборудования может со временем повлиять на цены, но автоматической и пропорциональной передачи этой экономии нет. Кроме того, по состоянию на 2026-11-10 TPU 8tx и TPU 8i Max всё ещё имеют статус Coming soon, а цены на них не объявлены. Разработчики могут сразу управлять структурой своих токенов, но не оборудованием вышестоящего поставщика.
Стоимость многошаговых вызовов API агентом: сравнение тарификации кэширования у трёх провайдеров
Все три ведущих провайдера поддерживают кэширование, но способы его активации, TTL и правила тарификации заметно различаются. Таблица составлена по официальной документации; точные условия зависят от модели и интерфейса.
| Провайдер | Механизм кэширования | Варианты TTL | Плата за запись | Плата за чтение | Доступные платформы |
|---|---|---|---|---|---|
| OpenAI | Prompt Caching, поддерживает автоматическое кэширование префикса моделью | Для некоторых новых моделей по умолчанию — 30 минут, некоторые модели поддерживают 12 часов | Для моделей и интерфейсов с соответствующими настройками: 30 минут — 1,25× от стоимости обычного ввода, 12 часов — 2,5×; в других режимах кэширования отдельная плата за запись может не взиматься | Обычно 0,1× от стоимости обычного ввода, для некоторых моделей ещё ниже | Официальный API, APIYI apiyi.com |
| Anthropic | Prompt Caching | По умолчанию — 5 минут, можно увеличить до 1 часа | 5 минут — 1,25× от стоимости обычного ввода, 1 час — 2× | Зависит от модели | Официальный API, APIYI apiyi.com |
| Google Gemini | Context Caching: неявное и явное кэширование | Для явного кэширования можно задать TTL | Для явного кэширования взимается отдельная плата, рассчитанная по числу кэшированных токенов и времени хранения | При попадании в кэш снижаются расходы на повторный ввод | Официальный API, APIYI apiyi.com |
Для примера возьмём официальные цены Claude Sonnet 5.5: обычный ввод стоит $2.00 за миллион токенов, запись в кэш на 5 минут — $2.50, на 1 час — $4.00, чтение из кэша — $0.10. Чтение из кэша обходится всего в 5% от стоимости обычного ввода. Именно поэтому кэширование повторяющихся префиксов позволяет значительно сократить расходы.
Важно учитывать, что OpenAI прямо указывает: попадание в кэш не гарантируется при каждом запросе. Явное кэширование Gemini тоже не означает «бесплатное хранение»: плата взимается за само время хранения. Кэширование даёт скидку при определённых условиях, а не автоматически снижает стоимость.
🎯 Техническая рекомендация: возможности кэширования, правила тарификации и возвращаемые поля различаются у разных моделей. Единый шлюз не обеспечит всем моделям одинаковые скидки за кэширование. Рекомендуем через APIYI apiyi.com протестировать подходящие модели с одним и тем же кодом, совместимым с OpenAI, и ориентироваться на фактические поля
usageв ответе и данные в счёте.
Реальный расчет экономии на кэшировании при многошаговых вызовах агента: пример с 12 вызовами
Возьмем описанную ранее 30-минутную задачу разработки и рассчитаем затраты по официальным ценам Claude Sonnet 5.5. Предположим, что:
- модель вызывается 12 раз, каждый раз передается 22 000 токенов;
- 20 000 токенов в каждом запросе — это повторяющиеся системный промпт, описания инструментов и контекст проекта;
- каждый раз добавляются 2 000 новых токенов;
- используется кэширование на 1 час, и последующие запросы успешно обращаются к кэшу.
Без кэширования: 12 × 22 000 × $2 / 1 000 000 = $0.528.
С кэшированием на 1 час: запись в кэш первых 20 000 токенов стоит $0.080, обычная обработка первых 2 000 токенов — $0.004, чтение из кэша в последующих 11 вызовах — $0.022, обработка 11 порций новых токенов — $0.044. Итого — $0.150, экономия на входных токенах составляет около 71.6%.
В этом примере учитываются только входные токены, без выходных токенов, вызовов инструментов и расходов на внешние сервисы. В реальных сценариях Agent история запросов будет расти с каждым шагом, но общий вывод останется тем же: повторяющийся контекст — одна из главных статей расходов, которая быстро увеличивается при многошаговых вызовах агента.
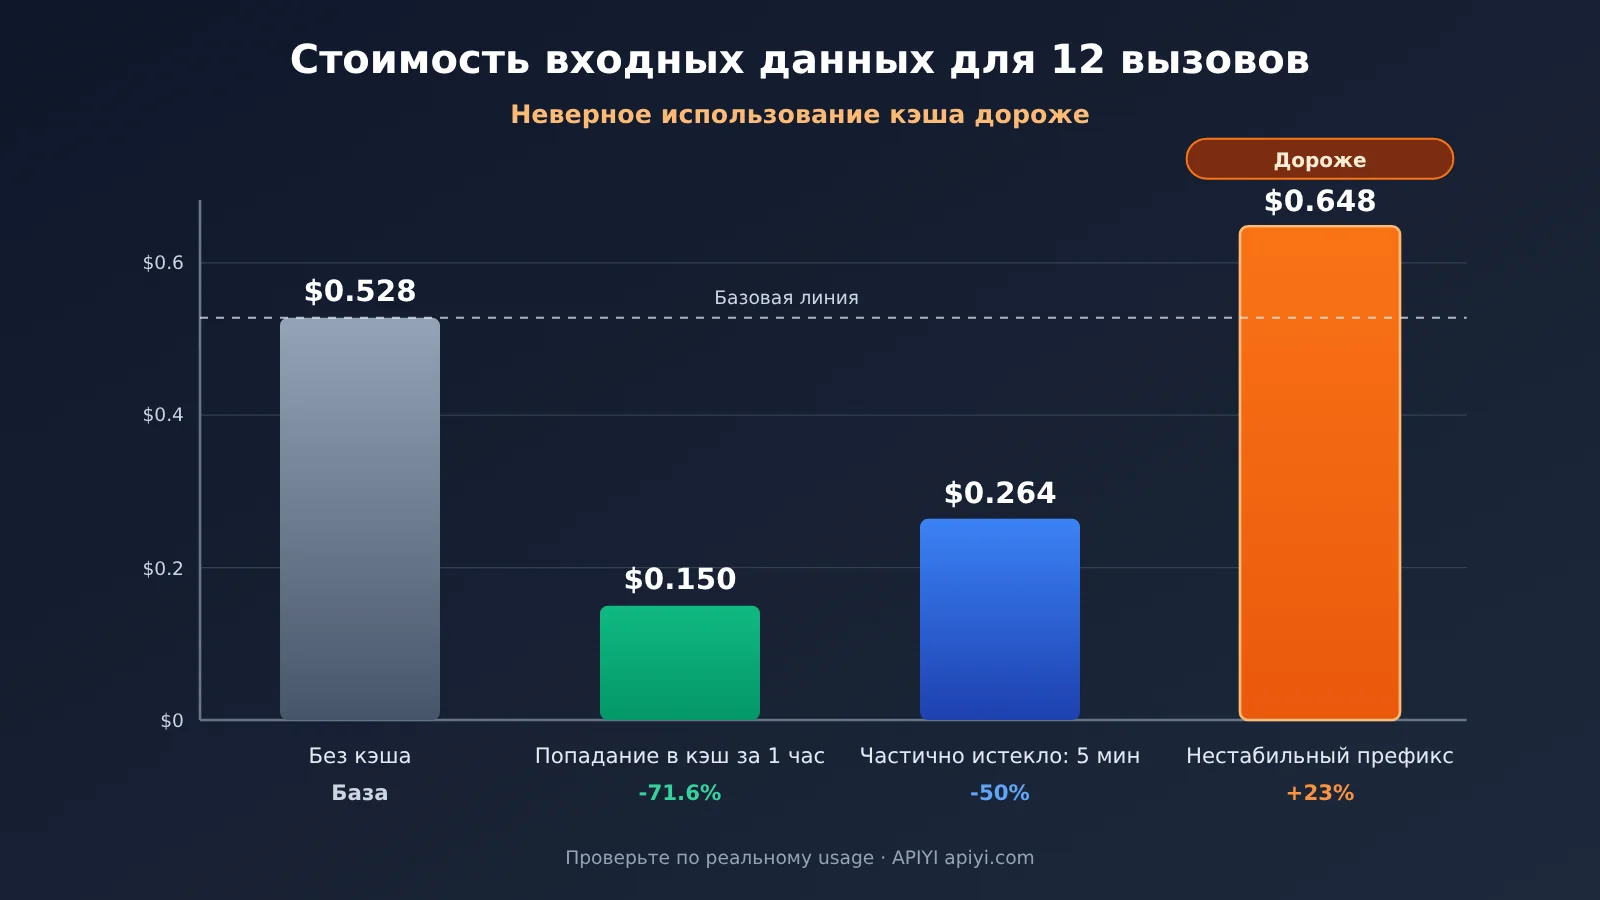
Как сбои кэша, изменения префикса и TTL влияют на расходы Agent
Выше мы рассмотрели идеальный сценарий. Теперь на тех же тарифах разберём три типичные ситуации, в которых всё может пойти не так. Ниже приведены примеры расчётов по официальным тарифам, выполненные автором статьи.
| Сценарий | Допущение | Стоимость входных токенов | Относительно варианта без кэша |
|---|---|---|---|
| Без кэша | Все 12 вызовов оплачиваются по обычному тарифу на входные токены | $0.528 | Базовый вариант |
| Кэш на 1 час, полное попадание | 1 запись, 11 чтений | $0.150 | Экономия около 71.6% |
| Кэш на 5 минут, полное попадание | Тариф на запись — $2.50, 11 чтений | $0.120 | Экономия около 77.3% |
| Кэш на 5 минут, частичное истечение срока действия | Из-за задержки при ожидании инструмента понадобилось 4 записи и 8 чтений | $0.264 | Экономия около 50% |
| Нестабильный префикс | Префикс меняется при каждом вызове, поэтому все 12 вызовов оплачиваются по тарифу записи на 5 минут | $0.648 | Расходы, наоборот, вырастают примерно на 23% |
Вот несколько выводов, которые помогут принять решение:
- TTL должен покрывать время ожидания инструмента: запись в кэш на 5 минут обходится дешевле, но если тестовый запуск или ручное подтверждение занимает больше 5 минут, кэш истечёт, и данные придётся записывать заново. Экономия заметно сократится.
- Стабильность префикса важнее TTL: если поставить временную метку или случайный ID в самое начало промпта, кэш не будет срабатывать ни при одном вызове. В режиме с повышенной платой за запись из-за этого кэш может увеличить счёт.
- Чем дольше TTL, тем не всегда лучше: запись в кэш на 1 час стоит в 1,6 раза дороже, чем на 5 минут. Такой вариант выгоден только в том случае, если между вызовами действительно может пройти больше 5 минут.
Как снизить расходы на API при многошаговых вызовах агента
Минимальный пример: отслеживаем попадания в кэш при каждом вызове
Первый шаг к оптимизации — увидеть, сколько она стоит. Код ниже отправляет запрос через OpenAI-совместимый интерфейс и выводит связанные с кэшем поля из usage:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="your-model-name",  # Замените на модель, которую хотите протестировать
    messages=[
        {"role": "system", "content": "固定的系统提示词与工具说明……"},
        {"role": "user", "content": "本轮新增的任务内容"}
    ]
)
usage = resp.usage
details = getattr(usage, "prompt_tokens_details", None)
print("输入:", usage.prompt_tokens, "输出:", usage.completion_tokens,
      "缓存命中:", getattr(details, "cached_tokens", None))
Полная реализация: стабильный префикс и отслеживание стоимости отдельной задачи
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Стабильный префикс: системные инструкции, описания инструментов и общий контекст проекта. Размещайте его в начале и не меняйте ни одного байта.
STABLE_PREFIX = [
    {"role": "system", "content": "你是代码修复 Agent。工具定义与项目规范如下……"},
]

@dataclass
class TaskCost:
    # Цена: долларов за миллион токенов. Укажите официальную цену используемой модели.
    input_price: float
    cache_read_price: float
    output_price: float
    records: list = field(default_factory=list)

    def add(self, usage):
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        uncached = usage.prompt_tokens - cached
        cost = (uncached * self.input_price
                + cached * self.cache_read_price
                + usage.completion_tokens * self.output_price) / 1_000_000
        self.records.append({"cached": cached, "uncached": uncached,
                             "output": usage.completion_tokens, "cost": cost})

    def summary(self):
        total_in = sum(r["cached"] + r["uncached"] for r in self.records)
        hit = sum(r["cached"] for r in self.records) / max(total_in, 1)
        return {"calls": len(self.records), "cache_hit_rate": round(hit, 3),
                "total_cost": round(sum(r["cost"] for r in self.records), 4)}

def run_turn(history, new_msg, tracker, model="your-model-name"):
    # Только добавляйте новые сообщения, не меняя порядок истории; динамическую информацию (например, метки времени) размещайте в конце.
    history.append({"role": "user", "content": new_msg})
    resp = client.chat.completions.create(
        model=model, messages=STABLE_PREFIX + history)
    tracker.add(resp.usage)
    history.append({"role": "assistant",
                    "content": resp.choices[0].message.content})
    return resp

tracker = TaskCost(input_price=2.0, cache_read_price=0.1, output_price=0.0)
history = []
run_turn(history, "测试 test_auth 失败,报错如下……", tracker)
print(tracker.summary())
Учтите: приведённая выше оценка учитывает только скидку на чтение из кэша. Если используемая модель отдельно тарифицирует запись в кэш, добавьте соответствующие расходы на основе возвращаемых ею полей. Названия и значения полей usage могут различаться у разных моделей — ориентируйтесь на фактический ответ.
🚀 Быстрый старт: рекомендуем сначала запустить этот скрипт отслеживания на бесплатном тестовом тарифе APIYI apiyi.com. Сравните долю попаданий в кэш и стоимость одной задачи для разных моделей, а затем выберите модель и TTL для рабочей среды.
Пять способов снизить стоимость многоэтапных вызовов агента
- Стабилизируйте префикс промпта: размещайте системные инструкции, описания инструментов и общие справочные материалы в начале, а временные метки и динамические данные пользователя — в конце. Не меняйте без необходимости порядок инструментов и поля в их описаниях.
- Выбирайте подходящий TTL: для задач с частыми вызовами и короткими интервалами используйте небольшой TTL. Для агентов, которые надолго уходят на тестирование, сборку или ручное согласование, оцените, компенсирует ли экономия на повторной записи повышенную стоимость записи при более длительном TTL.
- Контролируйте историю контекста: только добавляйте новые данные, не меняя порядок уже переданных, чтобы не нарушать префикс кэша. Сводите длинные ответы инструментов к кратким итогам, сохраняя ключевые выводы, статус задачи и необходимые подтверждения.
- Сокращайте число лишних вызовов модели: объединяйте инструменты, которые можно запустить пакетно, в один вызов. Детерминированные шаги поручайте коду, а не модели — так вы сократите количество циклов взаимодействия.
- Отслеживайте фактические метрики: записывайте для каждой задачи обычный ввод, запись в кэш, чтение из кэша, выходные токены, долю попаданий в кэш, TTFT и общую стоимость. Оценивайте затраты на уровне задачи, а не отдельного запроса.
Анализ влияния многошаговых вызовов API агентами на затраты
Влияние на разработчиков
- Модель затрат нужно считать не за «один запрос», а за «одну задачу»: расходы на агента зависят от всей цепочки вызовов. Если смотреть только на цену отдельного вызова, итоговый счёт можно сильно недооценить.
- При разработке промптов нужно учитывать структуру тарификации: стабильность префикса напрямую влияет на работу кэширования, поэтому проектирование структуры промпта становится частью оптимизации затрат.
- Выбор между моделями требует практических тестов: скидки за кэширование, TTL и наценка за запись различаются от модели к модели. Стоимость одной и той же задачи может заметно отличаться при смене модели.
Влияние на отрасль
- Конкуренция в сфере инфраструктуры смещается в сторону нагрузки от агентов: Google уделяет особое внимание пропускной способности памяти, передаче KV-кэша и приостановке с последующим возобновлением работы агентов. Это показывает, что многошаговые сценарии и длинный контекст стали основными типами нагрузки.
- Пользователи прежде всего почувствуют улучшение задержки: оптимизация на нижнем уровне в первую очередь повышает TTFT и пропускную способность. Снизится ли цена за токен, зависит от тарифной политики провайдера, поэтому разработчикам не стоит заранее закладывать это в бюджет.
Часто задаваемые вопросы
Вопрос 1. Почему API-запросы агента в несколько ходов обходятся дороже, чем ожидалось?
API не хранит состояние, поэтому при каждом запросе приходится заново передавать системный промпт, определения инструментов и историю контекста. Чем больше запросов, тем чаще эта неизменная часть оплачивается повторно. Вызовы инструментов также увеличивают количество ходов.
Вопрос 2. KV Cache и Prompt Cache — это одно и то же?
Не совсем. KV Cache — это повторное использование состояния на низком уровне инференса модели. Prompt Cache — это кэширование повторно используемого префикса на уровне API и связанная с ним тарификация. В документации OpenAI указано, что сохраняются именно тензоры KV. Пользователь может заметить Prompt Cache только по правилам тарификации, а напрямую управлять KV Cache не может.
Вопрос 3. Снизятся ли цены на API сразу после выпуска новых TPU от Google?
Оснований так считать нет. По состоянию на 2026-11-10 TPU 8tx и TPU 8i Max всё ещё имеют статус Coming soon, а цены не объявлены. Оптимизация оборудования в первую очередь повышает эффективность использования ресурсов и снижает задержки у провайдеров. Переложат ли они эту экономию в снижение цены токенов, зависит от ценовой политики каждого провайдера.
Вопрос 4. Кэширование всегда помогает сэкономить?
Не всегда. Если префикс меняется при каждом запросе и кэш не срабатывает, а выбранный режим предусматривает дополнительную плату за запись в кэш, расходы могут оказаться выше, чем без кэширования. Если ожидание ответа от инструмента превышает TTL, частая перезапись кэша также снижает экономию.
Вопрос 5. Как быстро сравнить эффективность кэширования у разных моделей?
Запустите одну и ту же задачу агента на нескольких моделях по одинаковому сценарию и зафиксируйте долю попаданий в кэш и общую стоимость выполнения одной задачи. Через APIYI apiyi.com можно вызывать такие модели, как OpenAI, Claude и Gemini, с одним API-ключом. Для сравнения достаточно менять параметр model.
Вопрос 6. Чем опасно сжатие контекста?
Сжатие меняет содержимое последующих запросов: важные детали могут потеряться, агент начнёт повторять ошибки, а число ходов в итоге вырастет. Кроме того, если сжатое содержимое заново генерируется на каждом ходу, это нарушает стабильность префикса для кэширования. Поэтому сжатие нужно проектировать с учётом стратегии кэширования.
Вопрос 7. Одинаковы ли скидки за кэширование для всех моделей при вызове через единый шлюз?
Нет. Возможности кэширования, правила тарификации и поля ответа зависят от самой модели на стороне провайдера. При тестировании через APIYI apiyi.com отдельно проверяйте поля кэширования и фактические списания для каждой модели, а затем учитывайте их в бюджете.
Ключевые выводы о стоимости многошаговых вызовов API агентом
- Единица расчёта — задача: счёт за работу агента складывается из всех вызовов в цепочке, а не из стоимости одного запроса.
- Повторяющийся контекст обходится дороже всего: в примере с 12 вызовами часовой кэш позволяет сэкономить около 71,6% на входных токенах.
- Скидка за кэш действует не всегда: если префикс нестабилен или время жизни кэша (TTL) слишком мало, экономия сокращается, а расходы могут даже вырасти.
- У трёх провайдеров разные правила расчёта: множитель за запись в кэш, скидку за чтение и плату за хранение нужно проверять для конкретной модели.
- Оптимизация оборудования не означает снижения счёта: оптимизация KV-кэша на нижнем уровне сначала уменьшает задержки, а цена зависит от тарифов провайдера.
- Сначала измерьте, затем оптимизируйте: APIYI (apiyi.com) позволяет через единый интерфейс проверить процент попаданий в кэш и стоимость задач для разных моделей.
Итоги
Стоимость многошаговых вызовов API агентом зависит от повторного учёта контекста, попаданий в кэш и обращений к инструментам — важны все три фактора:
- Повторный учёт контекста определяет базовые расходы: чем больше вызовов, тем больше повторов.
- Попадания в кэш определяют размер скидки на повторяющуюся часть. Ключевую роль играют стабильность префикса и TTL.
- Обращения к инструментам влекут внешние расходы и увеличивают число вызовов модели.
Инвестиции Google в KV-кэш и преодоление «стены памяти» на уровне инфраструктуры ускорят работу агентов, но разработчики уже сейчас могут контролировать структуру токенов. Начните со стабильного префикса, подходящего TTL, сокращения истории, уменьшения числа вызовов и мониторинга затрат на уровне задач. Затем проверьте эффект каждого изменения на реальных данных через APIYI (apiyi.com).
📚 Дополнительные материалы
- Google Cloud Blog — Introducing TPU 8tx and TPU 8i Max: анонс новых систем TPU восьмого поколения
- Ссылка:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
Подробнее: о проблеме нехватки памяти у AI-агентов и контексте KV-кэша
-
Google Cloud Blog — Introducing TPU Sync: библиотека с открытым исходным кодом для передачи KV-кэша и весов
- Ссылка:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
Подробнее: об оптимизации передачи KV-кэша на низком уровне и методике тестирования
-
Документация OpenAI API — Prompt Caching: механизм кэширования и рекомендации по его использованию
- Ссылка:
platform.openai.com/docs/guides/prompt-caching -
Подробнее: о правилах кэширования префиксов, времени хранения и мониторинге
-
Документация Anthropic — Prompt Caching: время жизни кэша и информация о тарификации
- Ссылка:
docs.anthropic.com/en/docs/build-with-claude/prompt-caching -
Подробнее: о стоимости записи и чтения кэша со сроком хранения 5 минут и 1 час
-
Google AI for Developers — Context Caching: неявное и явное кэширование в Gemini
- Ссылка:
ai.google.dev/gemini-api/docs/caching - Подробнее: о времени жизни явного кэша и расходах на его хранение
Автор: техническая команда APIYI
Техническое обсуждение: посетите главную страницу APIYI apiyi.com, чтобы связаться с нами. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com.