Примечание автора: не видите расход контекста в поле ввода Codex? Проверьте /status. В этой статье за пять шагов разберём, как по журналу вызовов APIYI рассчитать расход токенов и стоимость каждого запроса в Codex. А ещё приведём таблицу, которая поможет решить, когда сжать контекст, а когда начать новый диалог.
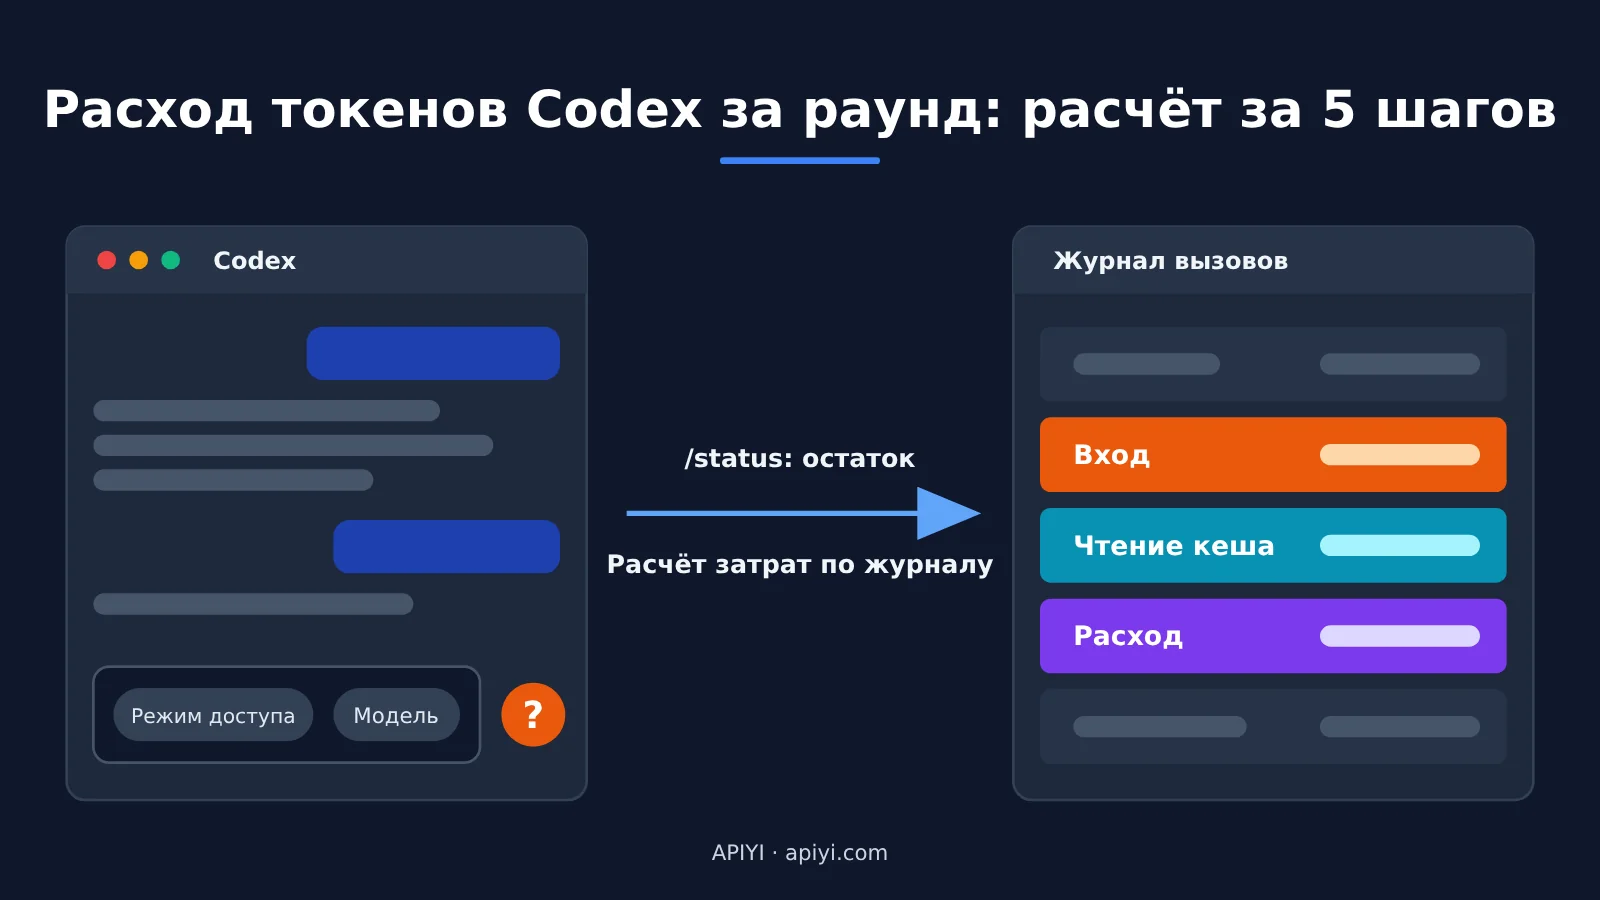
Вы подключили Codex к APIYI и несколько часов подряд работаете в одном диалоге. Под полем ввода отображаются только режим разрешений и модель. Сколько контекста уже использовано, не видно, поэтому непонятно, пора ли открывать новое окно.
Сразу к делу: Codex показывает расход контекста, но теперь он находится в /status; данные для расчёта стоимости доступны в журнале вызовов APIYI / apiyi.com. В этой статье мы за пять шагов разберём, как посмотреть расход токенов Codex для каждого запроса в журнале вызовов APIYI: на что смотреть, как всё сложить и когда сжать контекст или начать новый диалог.
Это не очередная статья с одними объяснениями. На каждом шаге мы покажем, что вы увидите в интерфейсе и куда нажать, а также объясним, как проверить результат.
Почему в Codex не видно расхода токенов за каждый ход
Многие думают, что Codex убрал отображение контекста. На самом деле эта информация доступна в трёх местах, и в каждом показываются разные данные.
- Десктопный клиент / плагин для IDE: в поле ввода отображаются только режим разрешений и модель. Введите
/status, чтобы увидеть chat ID, context usage (долю использованного контекста) и rate limits (остаток лимитов). - CLI: команда
/statusпоказывает текущую модель, политику подтверждений, доступные для записи директории и текущее использование токенов. В нижней строке CLI и так есть подсказка о контексте. С помощью/statuslineтуда можно добавить context stats (статистику контекста) и token counters (счётчики токенов). Выбранные настройки сохранятся вtui.status_lineфайлаconfig.toml. codex exec --json: при неинтерактивном выполнении Codex выводит по одной строке с JSON-событием при каждом изменении состояния. Событиеturn.completedсодержитusageс пятью полями:input_tokens,cached_input_tokens,cache_write_input_tokens,output_tokensиreasoning_output_tokens.
Кроме того, /usage показывает только активность по токенам на уровне аккаунта и работает лишь при входе через официальный аккаунт. Если вы используете сторонний ключ, эта команда не подойдёт.
Сравнение трёх способов учёта токенов в Codex
| Способ | Где работает | Что видно | Чего не видно |
|---|---|---|---|
| Логи вызовов APIYI | Десктопный клиент, IDE и CLI | Входные и выходные токены, чтение и запись кэша, стоимость каждого запроса | Содержимое диалога; одна строка — один запрос, расход за ход нужно суммировать самостоятельно |
Codex /status |
Интерактивный интерфейс десктопного клиента и CLI | Использование контекста, остаток лимитов, текущее использование токенов | Стоимость |
codex exec --json |
Только неинтерактивное выполнение | Входные и выходные токены, чтение и запись кэша, токены рассуждений за каждый ход | Данные интерактивного TUI и десктопного клиента |
Из этих трёх способов только логи показывают стоимость. При этом сам сервис, через который идут запросы, должен предоставлять логи и детализацию расхода. В официальной подписке подробные данные по отдельным запросам недоступны.
Шаг 1. Определяем, как считать расход токенов Codex
Прежде чем приступать к подсчётам, запомните: один запрос — это не один ход диалога.
Запрос — это одно обращение Codex к модели. Ход — весь процесс от вашего сообщения до ответа Codex с результатом работы. За один ход Codex может читать файлы, запускать команды и менять код. После каждого вызова инструмента он снова отправляет модели результат вместе со всей историей. Поэтому одному ходу диалога в журнале обычно соответствует несколько строк, а для сложной задачи их могут быть десятки.
Кроме того, сама модель не помнит предыдущие сообщения. Входные данные на N-м ходу ≈ всё содержимое предыдущих N-1 ходов + новые данные текущего хода. Именно поэтому длинный диалог обходится всё дороже.
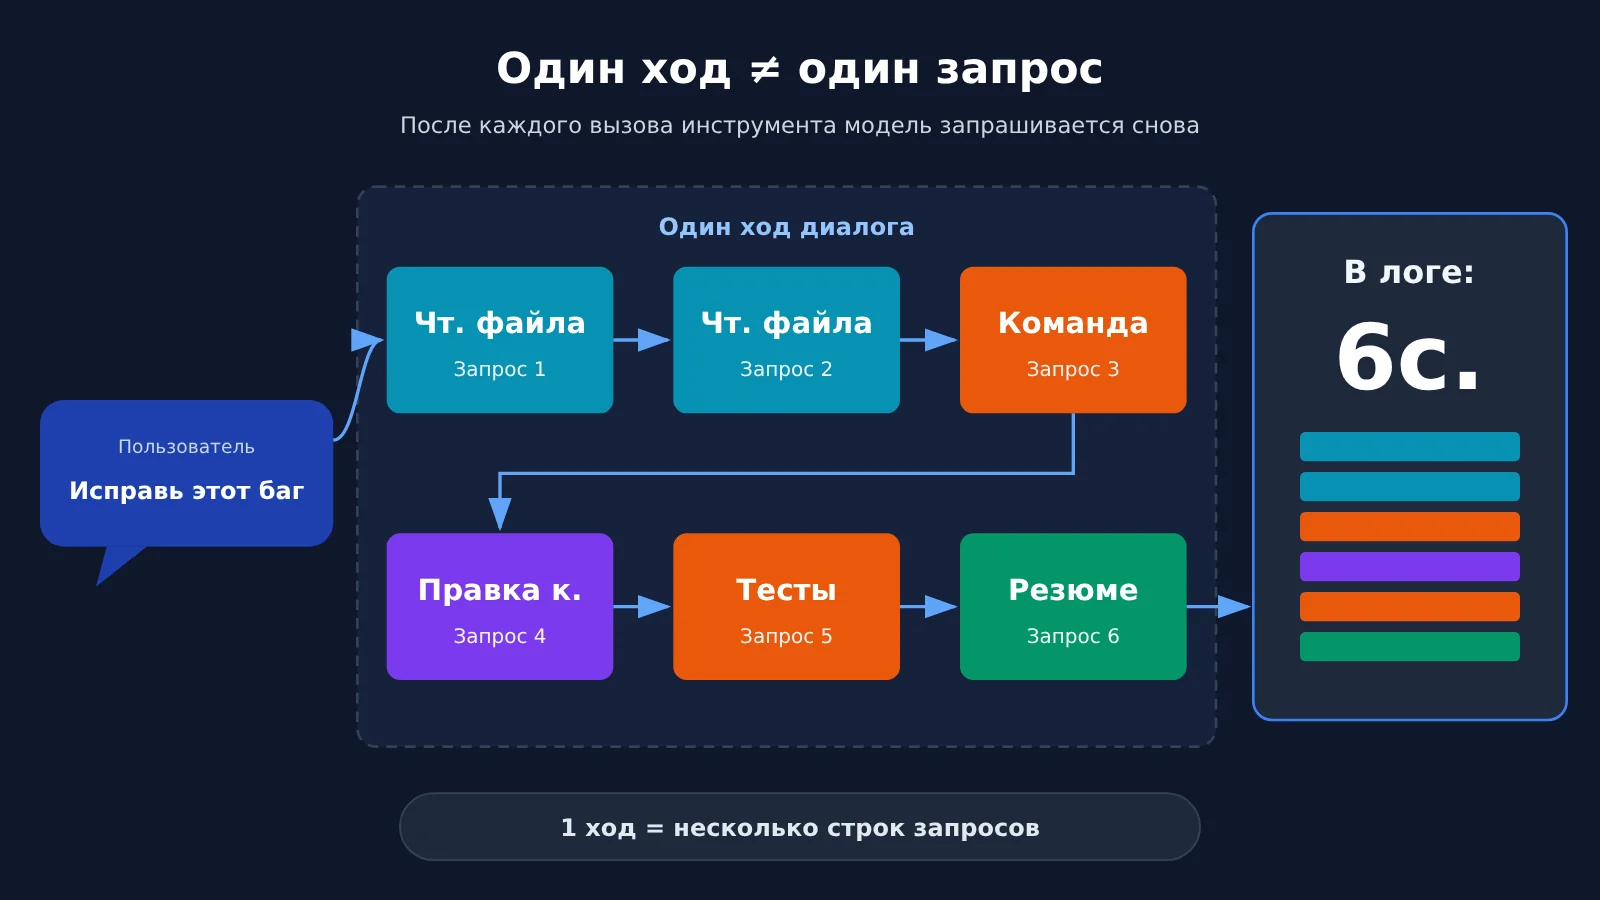
Проверка: увидев несколько строк запросов в журнале, вы понимаете, что они относятся к одному ходу, и не считаете каждую строку отдельным ходом.
Шаг 2: создайте отдельный токен для Codex
Для подсчёта нужно, чтобы в выбранных логах были только запросы Codex. Если Codex использует один ключ со скриптами или другими инструментами, отфильтровать его запросы по токену не получится.
- Откройте страницу токенов в консоли APIYI и нажмите «Добавить токен». Дайте ему понятное имя, например со словом «codex».
- Откройте
config.tomlCodex и добавьте провайдер в разделmodel_providers. Укажитеbase_url = "https://api.apiyi.com/v1", а черезenv_keyзадайте переменную окружения, из которой будет считываться токен. - Укажите этот провайдер в
model_provider. Десктопное приложение, IDE и CLI используют один и тот же файл конфигурации, поэтому достаточно изменить его один раз. - Для всех остальных инструментов используйте другие ключи — не используйте этот токен повторно.
🎯 Технический совет: отдельный токен, фильтрация логов по токену и экспорт — три инструмента консоли APIYI / apiyi.com, которые помогут собрать статистику. В официальной подписке детали отдельных запросов недоступны, а с выделенным токеном расходы Codex можно посчитать отдельно.
Проверка: на странице логов нажмите «Развернуть» и в расширенных фильтрах выберите этот ключ в поле «Токен». В списке должны остаться только запросы Codex.
Шаг 3: разбираем отдельный запрос в журнале
Откройте api.apiyi.com/log — это раздел «Журнал» в меню слева. Каждая строка в списке соответствует одному API-запросу.
В верхней части страницы можно отфильтровать запросы по времени, типу, модели и статусу кеша. Подсказка для статуса кеша гласит: «Попадание = чтение кеша, промах = создание кеша». Нажмите «Развернуть», чтобы добавить фильтры по токену, потоковому режиму, диапазону токенов промпта и ответа, времени до первого байта и другим параметрам.
Что означают столбцы журнала
| Столбец | Что вы увидите | Как это понимать |
|---|---|---|
| Время | Время завершения запроса | По умолчанию UTC+0, на 8 часов позже пекинского времени |
| Модель | Например, gpt-5.6-terra | При смене модели кеш не используется совместно |
| Информация | Потоковый или обычный режим, время до первого байта, токены промпта и ответа, сумма | В одной ячейке собрана сводка по запросу |
| Промпт / ответ | Два числа | Промпт — входные токены, ответ — выходные; токены рассуждений обычно входят в число токенов ответа |
| Расход | Сумма в долларах | Сумма до скидки, с учётом коэффициента группы |
| Описание | Коэффициенты, токены, записанные в кеш и прочитанные из него | Чтение и запись кеша указаны отдельно — гадать не придётся |
Для запросов с кешированием в столбце «Информация» показано количество токенов, прочитанных из кеша и записанных в него. В строках без подробностей о кеше отображается только что-то вроде «Обычный режим, первый байт: N сек., промпт/ответ, сумма». Для моделей изображений и видео с оплатой за запрос тоже показываются токены промпта и ответа, но стоимость считается не по токенам — не применяйте к ним расчёты из этой статьи.
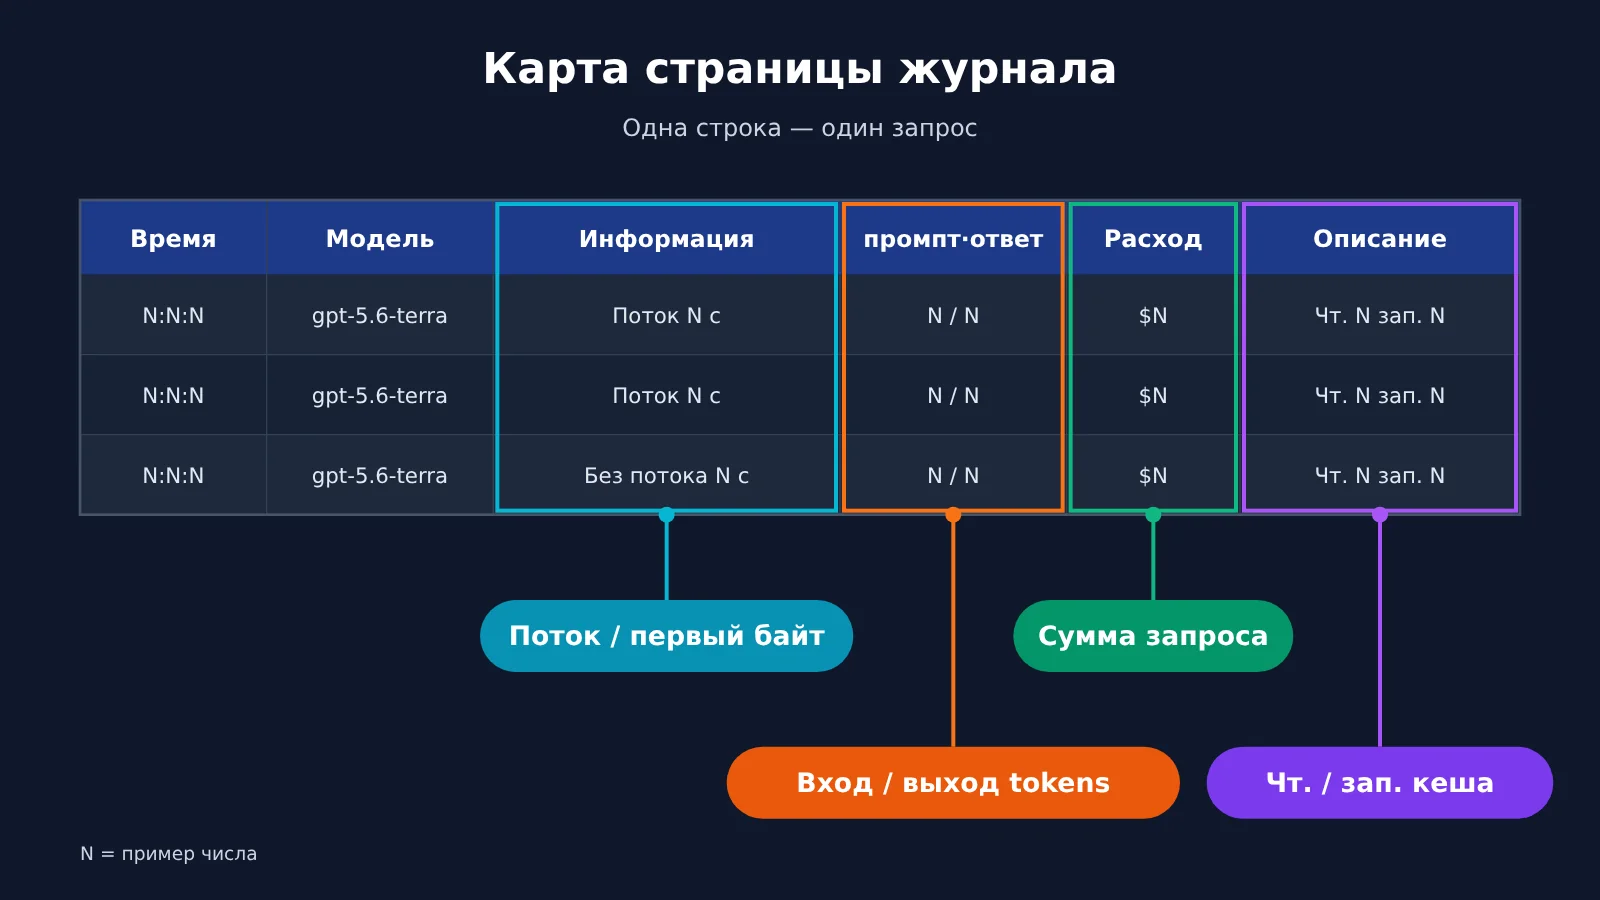
Проверка: выберите любую строку и попробуйте определить, сколько в запросе входных и выходных токенов, сколько токенов прочитано из кеша и сколько он стоил.
Шаг 4. Суммируйте строки лога, чтобы узнать расход токенов за один цикл Codex
Одна строка показывает расход только для одного запроса. Чтобы узнать расход за один цикл диалога, нужно сложить значения.
Правило подсчёта: суммируйте все запросы с одним токеном и одной моделью, отправленные примерно в течение 5 минут после вашей инструкции. При необходимости скорректируйте временной интервал.
- Посмотреть на странице: отфильтруйте записи по токену, модели и временному интервалу, затем проверьте промпты и ответы в каждой строке. Подходит для разовой проверки.
- Экспортировать и пересчитать: нажмите «Экспорт» в правом верхнем углу списка, скачайте файл Excel или CSV и суммируйте данные в таблице, сгруппировав их по времени.
- Использовать API запросов к логу: вызовите
GET /api/log/self. Для авторизации используйте персональный токен доступа, который начинается сnap_: API-ключ с префиксомsk_вернёт ошибку 401. Передайте параметрыtype=2(только расход),token_name,start_timestampиend_timestamp(Unix-время в секундах). Обратите внимание: параметр пагинации записывается в camelCase —pageSize. Вариантpage_sizeбудет проигнорирован без сообщения об ошибке. - Пересчитать в деньги:
quota, возвращённое интерфейсом, разделите на 500 000 — получится сумма в долларах. Полеotherсодержит строку JSON: её нужно отдельно разобрать, чтобы получитьusageи другие подробности.
При запросе через API обязательно указывайте временной интервал, желательно не более 1 дня. Если его не задать, интерфейс будет искать по всей истории, и для аккаунтов с большим объёмом данных запрос может завершиться ошибкой по тайм-ауту. Сам запрос к логу квоту не расходует.
Сколько стоит один раунд работы с Codex
| Модель | Вход | Чтение из кеша | Выход | Контекст | Пример: стоимость одного раунда |
|---|---|---|---|---|---|
| gpt-5.6-sol | $4 | $0.4 | $20 | 1,000,000 | около $0.214 |
| gpt-5.6-terra | $2 | $0.2 | $12 | 1,000,000 | около $0.107 |
| gpt-5.6-luna | $0.2 | $0.02 | $1.2 | 1,000,000 | около $0.011 |
Все цены указаны за миллион токенов и проверены 2026-10-28. Если вход одного запроса превышает 272,000 токенов, цена входных токенов удваивается.
💰 О ценах: актуальные модели и цены смотрите в списке моделей на платформе APIYI / apiyi.com. В примере для одного раунда взято 120,000 входных токенов, из которых 96,000 получены из кеша, и 4,000 выходных токенов. Для sol расчёт такой: 24,000 без попадания в кеш × $4 + 96,000 из кеша × $0.4 + 4,000 выходных токенов × $20. Делим на миллион и получаем около $0.214.
Эти цифры показывают две вещи. Во-первых, 96,000 токенов из кеша обошлись всего примерно в $0.038 — кеширование играет ключевую роль в стоимости длинных диалогов. Во-вторых, если выполнить тот же раунд с luna, расходы составят примерно одну двадцатую от стоимости sol. Правда, на официальной странице luna указано, что модель слабее работает с очень длинным контекстом — свыше 256K.
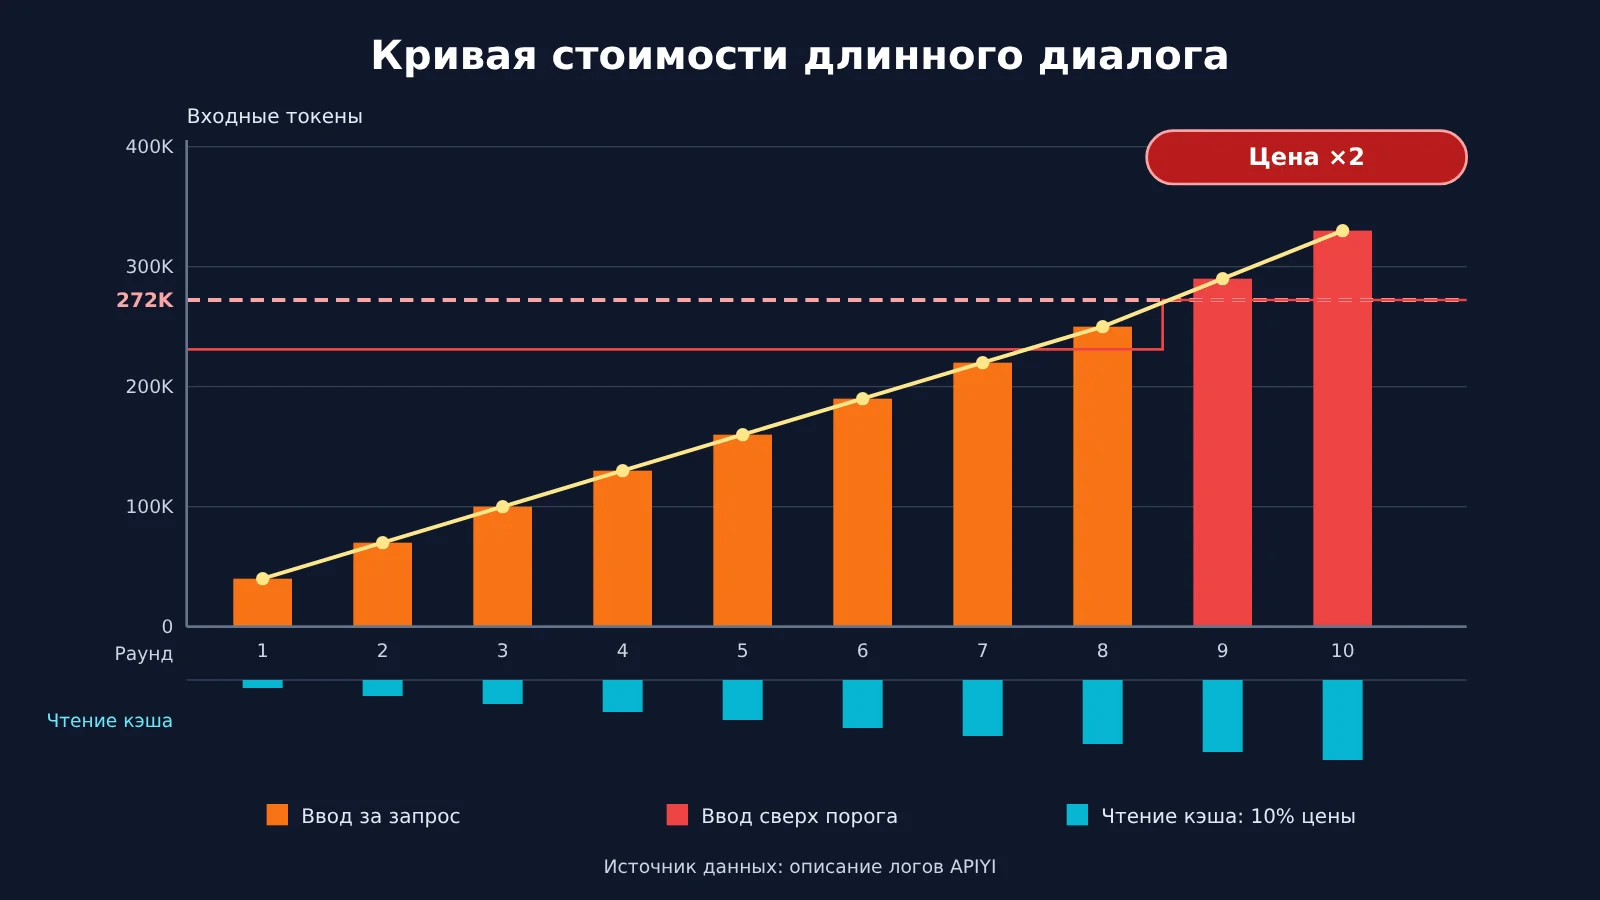
Проверка: вы можете рассчитать, на сколько входных токенов в этом раунде больше, чем в предыдущем, и определить, сколько из добавленных токенов получено из кеша.
Шаг пятый: решаем по данным о токенах Codex, сжать контекст или открыть новое окно
Когда есть данные по каждому запросу, решение можно принимать на основе цифр. Обратите внимание на три сигнала:
- Рост входных токенов: если с каждым запросом их становится всё больше, значит, вывод инструментов и история быстро накапливаются.
- Доля чтения из кеша: если она заметно снижается, значит, префикс изменился и большая часть новых входных токенов тарифицируется по полной цене.
- Входные токены в одном запросе: если их число приближается к 272 000, следующий запрос может перейти на более дорогой тарифный уровень.
Когда сжимать контекст, а когда открывать новое окно
| Что видно в журнале | Что делать | Почему |
|---|---|---|
| Число входных токенов близко к 272 000, задача ещё не завершена | Сначала вручную запустить /compact |
Так можно избежать перехода на тарифный уровень, где входные токены стоят вдвое дороже |
| Число входных токенов близко к 272 000, этап работы завершён | Открыть новое окно | Новый диалог будет чище, чем сжатый контекст |
| Доля чтения из кеша снижается несколько запросов подряд | Открыть новое окно для новой темы | Кеш уже не используется, и большая часть дальнейшего диалога тарифицируется по полной цене |
| Прирост входных токенов за запрос внезапно увеличился | Проверить вывод инструментов и при необходимости уменьшить tool_output_token_limit |
Большие объёмы вывода команд попали в историю |
| Число входных токенов стабильно, доля чтения из кеша высока | Продолжить текущий диалог | В этих условиях длинный диалог наиболее выгоден |
| Контекст недавно сжимали, но он снова почти заполнен | Открыть новое окно | После нескольких сжатий сводка становится всё менее подробной |
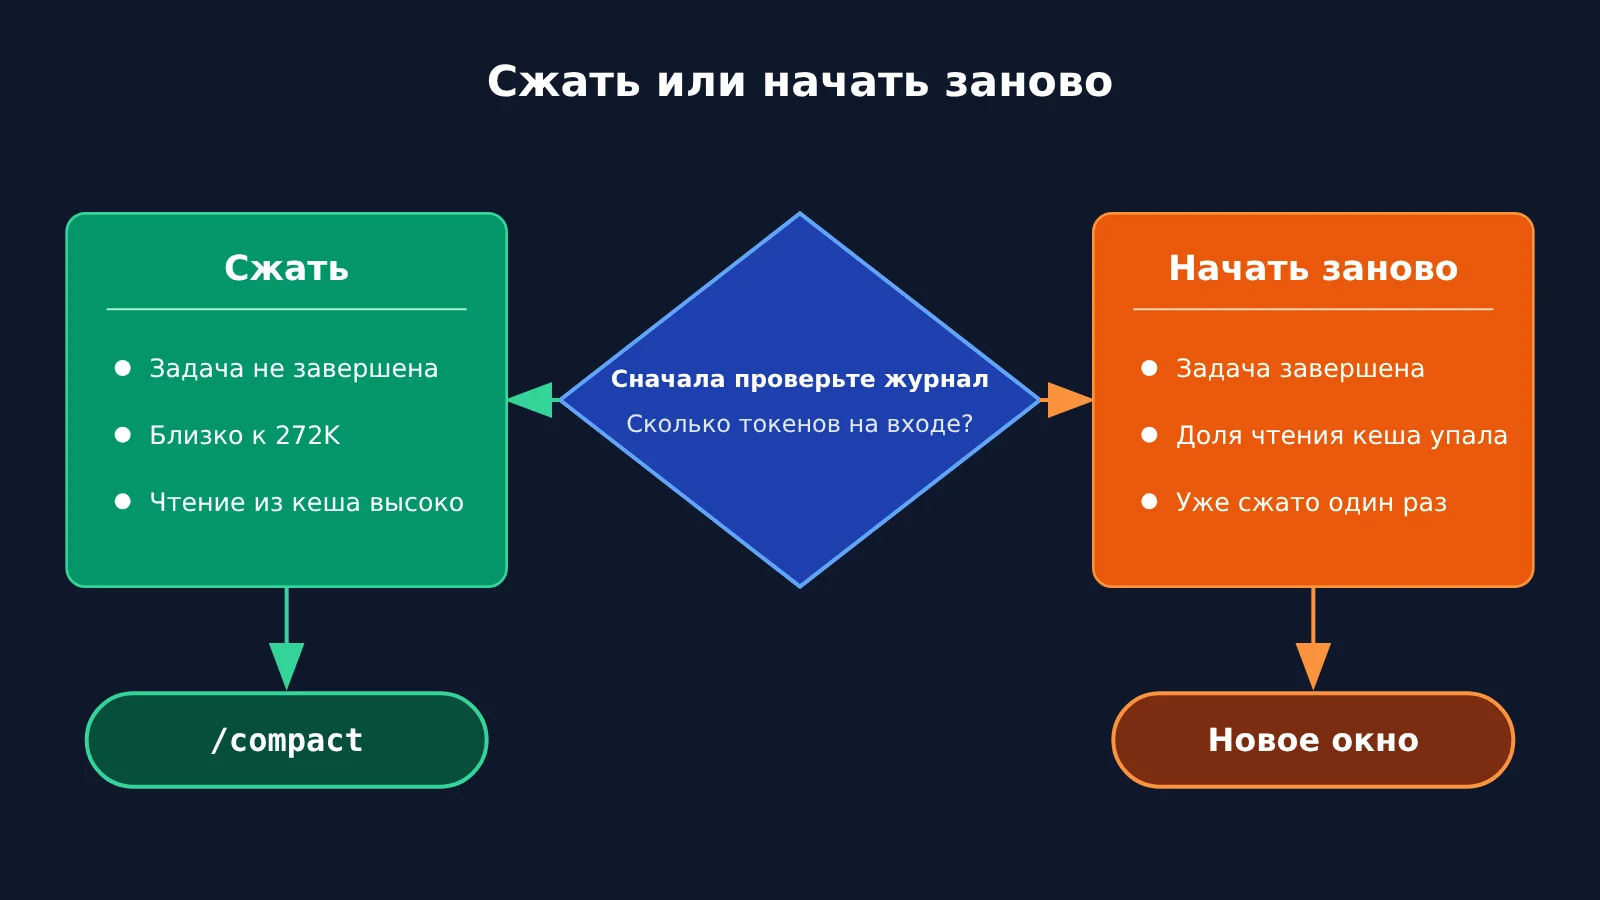
Как настроить сжатие контекста в Codex
Сжатие заменяет более ранние сообщения в диалоге кратким резюме, освобождая место в контекстном окне. Codex поддерживает ручное и автоматическое сжатие.
- Ручное сжатие: в десктопном приложении и CLI можно ввести
/compact. - Автоматическое сжатие: порог срабатывания задаётся параметром
model_auto_compact_token_limit. Если его не указать, используется значение модели по умолчанию. - Что учитывается при расчёте порога: параметр
model_auto_compact_token_limit_scopeможет принимать значениеtotal(весь активный контекст) илиbody_after_prefix(только часть, добавленная после переданного префикса). - При использовании стороннего base_url: если названия модели нет во встроенной таблице Codex, рекомендуется вручную указать
model_context_windowи порог автоматического сжатия. Чтобы сжатие срабатывало до перехода на следующую ценовую ступень, установите порог ниже 272 000. - Не включайте
remote_compactionбез необходимости: значениеv2требует, чтобы вышестоящий сервис поддерживал протокол сжатия на стороне Responses. Надёжнее оставитьunsupportedи использовать локальное сжатие.
Цена сжатия
Сжатие не бесплатно. Оно переписывает префикс истории, из-за чего кеш становится недействительным, а входные данные следующего запроса оплачиваются почти по полной стоимости. Поэтому после сжатия лучше сразу перейти к новой теме, а не возвращаться к прежним задачам. Кроме того, при сжатии теряются детали: нет гарантии, что резюме сохранит всю информацию.
Частые вопросы FAQ
Q1: В журнале нет одного из запросов. Его не записали?
В журнал попадают только вызовы, за которые была списана плата. Запросы, завершившиеся ошибкой сети, авторизации или проверки параметров, не доходят до провайдера: плата за них не списывается, и в журнале они не появляются. И наоборот: если запись есть, значит, запрос действительно израсходовал ресурсы. Также проверьте, правильно ли выбраны фильтр по токену доступа и временной интервал.
Q2: Почему сумма меньше, чем я рассчитал по количеству токенов?
Чаще всего дело в кэшировании. В канале OpenAI используется автоматическое кэширование префикса: если префикс содержит не менее 1024 токенов и остаётся неизменным, он попадает в кэш. Токены, прочитанные из кэша, тарифицируются по 10% от цены входных токенов. Их количество можно посмотреть в столбце с пояснениями в журнале APIYI / apiyi.com. Кроме того, в журнале указана сумма до скидки, а фактическая стоимость ≈ сумма в журнале ÷ (1 + доля бонусного пополнения).
Q3: Почему время в журнале не совпадает со временем моих действий?
По умолчанию время в журнале отображается в UTC+0, а пекинское время — UTC+8. Разница составляет 8 часов. Если искать «тот сеанс в три часа дня» по пекинскому времени, может показаться, что часть данных пропала. Перед фильтрацией просто пересчитайте время.
Q4: Как долго хранится журнал?
Рассчитывайте на то, что данные доступны примерно за последние 30 дней. Фактический срок хранения может быть больше, но платформа этого не гарантирует, а правила очистки могут измениться. Если данные нужны для долгосрочной сверки, регулярно сохраняйте их с помощью функции «Экспорт» или API запросов к журналу.
Q5: Можно ли по журналу узнать, какие файлы прочитал Codex и что он отправил?
Нет. В журнале хранится только основная информация, необходимая для расчёта стоимости: количество токенов, сумма и коэффициент тарификации. Содержимое запросов и ответов не записывается. Чтобы узнать, что произошло в конкретном сеансе, нужно посмотреть сам диалог с Codex.
Q6: Как проще автоматически записывать расход для каждого сеанса?
При запуске из скрипта можно использовать `codex exec —json` и считывать данные usage из события `turn.completed`. При интерактивной работе можно через API запросов к журналу регулярно получать и суммировать данные по отдельному токену доступа и временному интервалу. Новые пользователи могут сначала получить бесплатный тестовый баланс в APIYI / apiyi.com и проверить весь процесс.
Расход токенов Codex за один ход: главное
- Функция никуда не делась: расход контекста можно посмотреть через
/status, а в CLI — вывести в нижнюю строку с помощью/statusline. - Запрос ≠ ход: один ход диалога может включать несколько вызовов инструментов, которым в журнале соответствуют отдельные строки. Их нужно суммировать по временному интервалу.
- Отдельный ключ: создайте для Codex отдельный API-ключ, чтобы легко отфильтровать его запросы в журнале.
- Смотрите столбец с пояснениями: чтение и запись кэша указаны отдельно, а токены, найденные в кэше, тарифицируются по цене со скидкой 90%.
- Порог 272K: если объём входных данных одного запроса превышает 272 000 токенов, цена на входные токены удваивается.
- Сжатие имеет свою цену: после сжатия кэш становится недействительным, поэтому входные токены этого запроса тарифицируются почти по полной цене. После сжатия удобно сразу перейти к новой теме.
Итоги
Если в Codex не видно расхода контекста, это не значит, что функцию удалили: её просто перенесли. Команда /status показывает, сколько контекста осталось, а журнал вызовов — сколько стоил каждый ход. Вместе эти данные помогут решить, когда открыть новое окно.
Попробуйте прямо сейчас: создайте отдельный API-ключ для Codex, откройте страницу журнала APIYI / apiyi.com и сложите расходы по нескольким запросам последнего хода диалога.
📚 Справочные материалы
- Официальный репозиторий OpenAI Codex: исходный код CLI и определения событий
- Ссылка:
github.com/openai/codex -
Примечание: поле usage события
turn.completedопределено вcodex-rs/exec/src/exec_events.rs -
Официальная документация Codex: справочник по слеш-командам и настройкам
- Ссылка:
developers.openai.com/codex -
Примечание: описание команд
/status,/compact,/statuslineи параметров сжатия контекста -
Документация APIYI: журналы вызовов, тарификация кеша и API для запросов к журналам
- Ссылка:
docs.apiyi.com - Примечание: описание полей журнала, правило тарификации кеша по 10% от обычной стоимости и способ пересчёта
quota
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI. Подробнее о настройках читайте в документации.