Claude Fable 5.2 вышла 9 ноября 2026 года. Стандартные цены на API на 20% ниже, чем у версии 5.1.
Многие команды сразу задаются вопросом: раз модель стала дешевле, можно ли просто включить режим max?
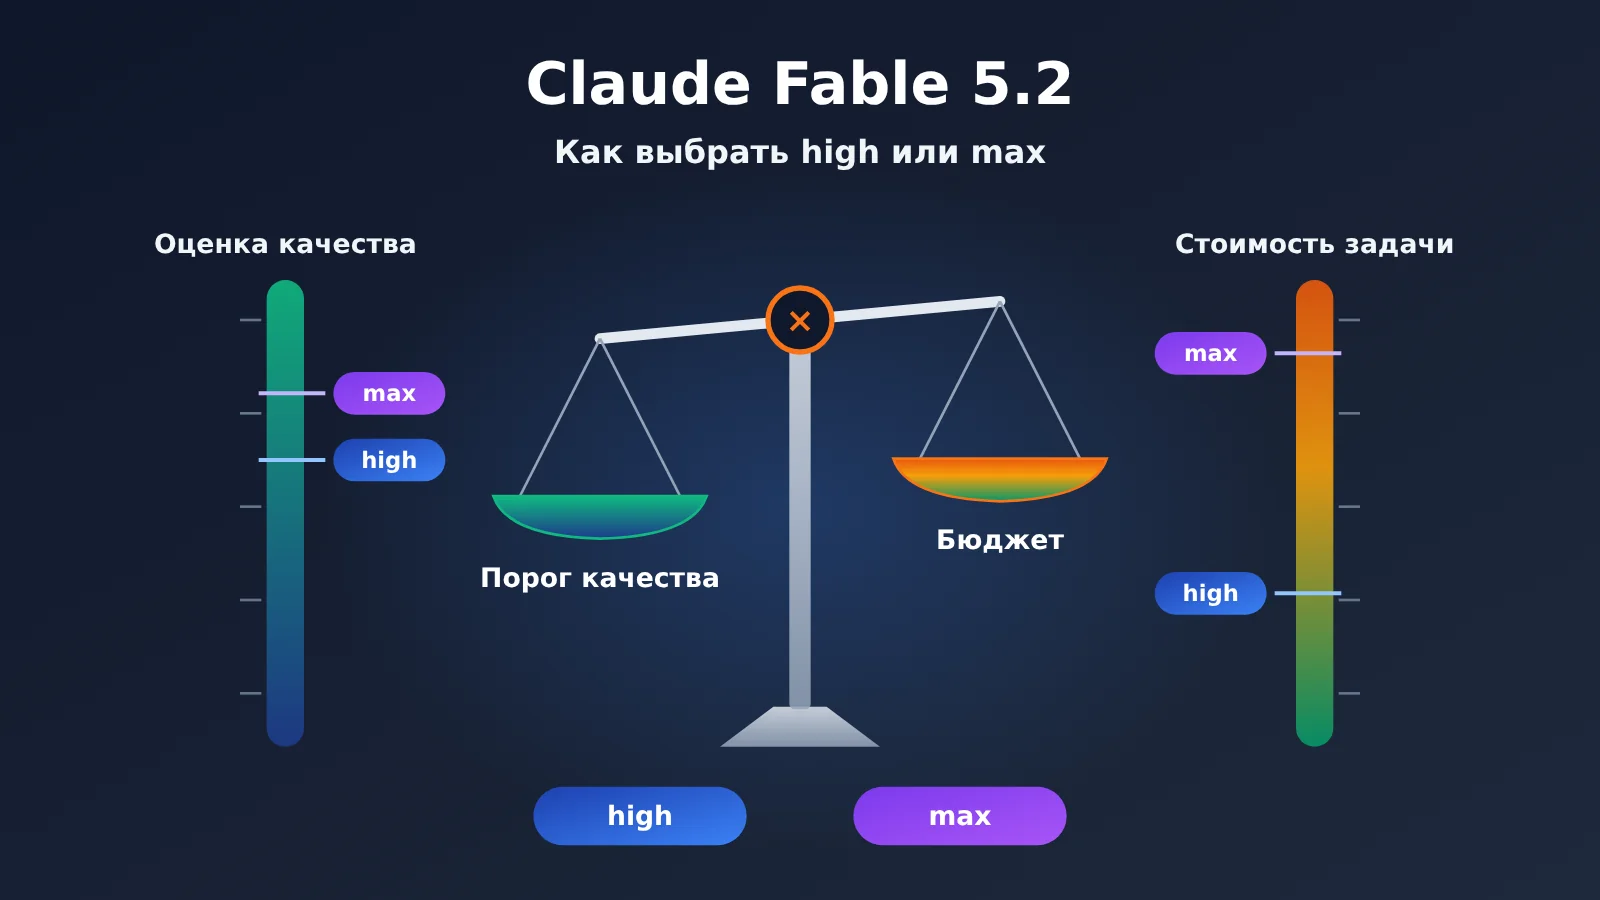
В этой статье мы сравним Fable 5.2 high и Fable 5.2 max в рамках одного подхода, оценивая и качество, и стоимость выполнения задачи.
Главное: прочитав статью, вы поймёте, в каких случаях подходят режимы high и max в Fable 5.2, а также получите готовый список пунктов для приёмки обновления.
Содержание
- Что нужно знать: термины, связанные с выбором режима Fable 5.2
-
- Режимы high и max в Fable 5.2 отличаются не только ценой за единицу
-
- Качество и стоимость Fable 5.2 в одной таблице
-
- Проверяем тенденции для разных режимов Fable 5.2 по данным независимых организаций
-
- Выбираем режим Fable 5.2 в зависимости от задачи
-
- Решаем, переходить ли на max в Fable 5.2, по результатам собственных проверок
- Часто задаваемые вопросы / Главное / Итоги
Что важно знать
| Термин | Значение | На что обратить внимание при чтении статьи |
|---|---|---|
| Effort | Настройка, которая управляет объёмом вычислительных усилий модели | В API для Fable 5.2 значение по умолчанию — high |
| Adaptive thinking | Механизм, с помощью которого модель автоматически распределяет вычислительные усилия | В Fable 5.2 всегда включён |
| Harness | Среда выполнения, которая предоставляет модели инструменты, сессии и правила выполнения | Harness в Cursor и AA различаются |
| Intelligence Index | Сводный индекс AA, рассчитанный как взвешенная оценка нескольких тестов | Это индекс, а не процент правильных ответов |
| Процентный пункт | Абсолютная разница между двумя процентными значениями | Изменение с 56,9% до 60,0% — это 3,1 процентного пункта |
| Стоимость одной задачи | Расходы на модель в расчёте на одну задачу при определённых условиях тестирования | Это не то же самое, что счёт за API |
| Порог приёмки | Требование к качеству, которому должна соответствовать задача | Сначала нужно пройти порог, а уже затем сравнивать бюджет |
| Разделение задач на уровни | Группировка задач по сложности и цене ошибки | Для разных уровней подходят разные настройки |
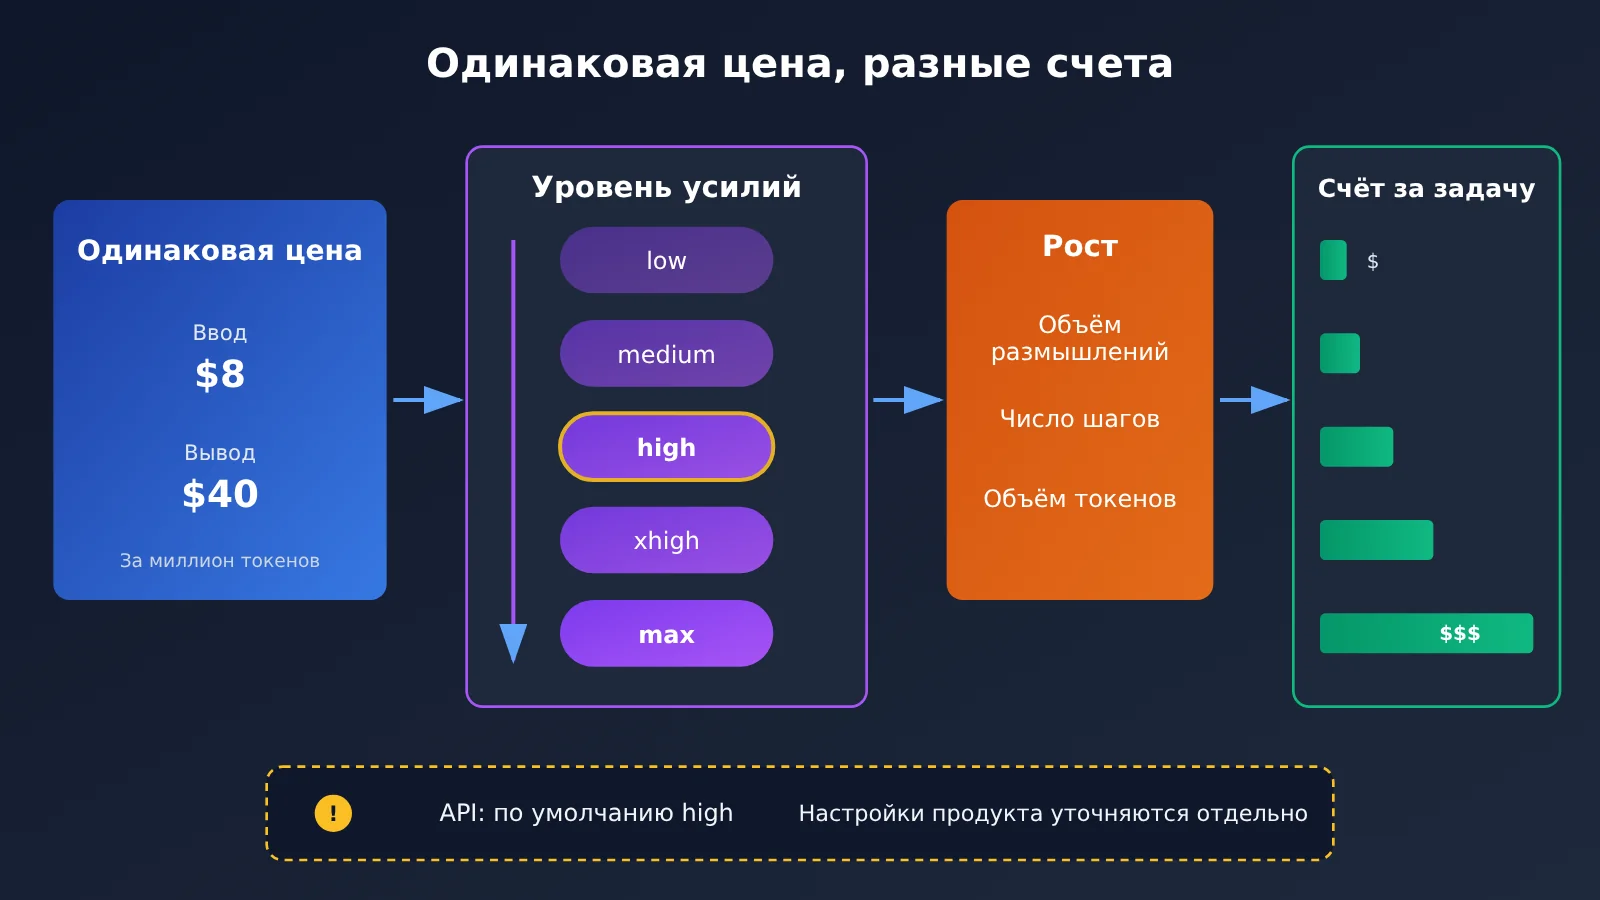
1. В Fable 5.2 режимы high и max меняют не одну и ту же цену за единицу
Многие думают, что чем выше уровень, тем дороже обходится каждый токен. На деле по стандартным тарифам Anthropic входные данные для Fable 5.2 стоят 8 долларов за миллион токенов, а выходные — 40 долларов за миллион. Эта цена не зависит от выбранного уровня.
Параметр effort определяет, сколько ресурсов модель потратит на размышления над задачей, сколько шагов предпримет, сколько времени займёт работа и сколько токенов израсходуется. Поэтому цена за единицу остаётся прежней, но стоимость задачи может отличаться в несколько раз.
Как уровни Fable 5.2 влияют на счёт
В Fable 5.2 адаптивное мышление всегда включено, а effort задаёт верхнюю границу и склонность модели к дополнительным вычислительным усилиям. При повышении уровня модель обычно выполняет больше рассуждений и вызовов инструментов, поэтому число оплачиваемых токенов растёт.
Предположим, что входные данные в обоих случаях составляют 100 тысяч токенов. Если объём выходных данных вырастет с 20 до 40 тысяч токенов, стоимость стандартного режима 5.2 поднимется с 1,60 до 2,40 доллара — это даже больше, чем 2 доллара за тот же объём данных в 5.1.
Также важно различать два значения по умолчанию. В официальной документации модели указано, что в API по умолчанию используется effort high. У таких продуктов, как Cursor, есть собственный уровень настроек: например, контекст по умолчанию в Cursor составляет 300K, тогда как в документации API указан объём 1M. Это разные уровни настроек.
И ещё один момент: в официальном руководстве по промптам отмечено, что одинаковые названия уровней в разных версиях могут соответствовать разному объёму вычислительных усилий. Поэтому опыт работы с уровнями в версии 5.1 нельзя напрямую переносить на 5.2.
2 Качество и стоимость Fable 5.2 в одной таблице
CursorBench 4.0 — это оценка Cursor на собственных задачах и в собственной среде с инструментами. Она не является независимым универсальным тестом, но сравнивает пять уровней в рамках одного Harness, поэтому подходит для наблюдения за относительными различиями между ними. Данные приведены по состоянию на 10 ноября 2026 года.
| Уровень Fable 5.2 | Оценка | Стоимость одной задачи (доллары) | Токены (агрегированное поле) | Шаги |
|---|---|---|---|---|
| Low | 53.2% | 3.94 | 36,616 | 30 |
| Medium | 54.8% | 4.66 | 44,103 | 35 |
| High | 56.9% | 9.70 | 99,259 | 69 |
| Extra High | 56.3% | 15.48 | 161,251 | 108 |
| Max | 60.0% | 32.79 | 352,794 | 218 |
Примечание: столбец с токенами содержит агрегированное поле со страницы бенчмарка. Его не следует считать показателем только объёма вывода. Источник: CursorBench 4.0.
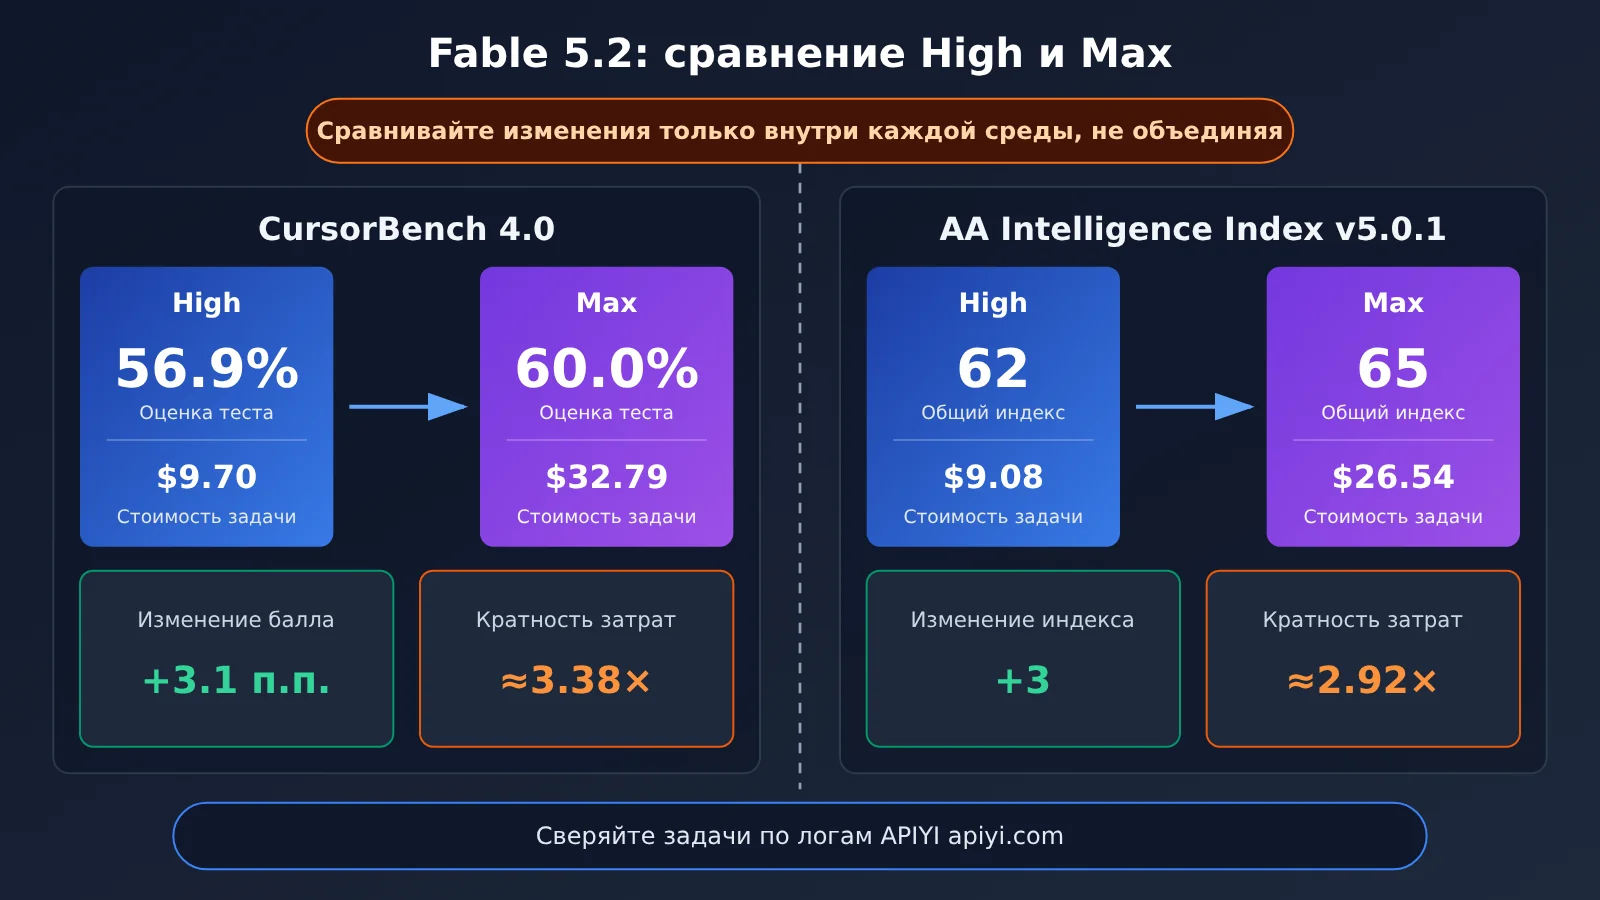
Fable 5.2: от High до Max — плюс 3,1 процентного пункта при стоимости примерно в 3,38 раза выше
В этой таблице оценка растёт с 56.9% на уровне High до 60.0% на Max — на 3,1 процентного пункта. Стоимость одной задачи увеличивается с 9.70 до 32.79 доллара — примерно в 3,38 раза, то есть примерно на 238%.
Согласно расчётам в этой статье, значение поля с токенами увеличивается примерно в 3,55 раза, а число шагов — с 69 до 218, то есть примерно в 3,16 раза. Рост стоимости в основном связан с увеличением объёма размышлений и числа шагов выполнения, а не с ценой за единицу.
Эти данные показывают лишь то, что в данной среде более высокая оценка сопровождается заметно большими расходами.
Как интерпретировать необычный результат Extra High
Есть в таблице и примечательный момент: Extra High примерно на 60% дороже High, но оценка при этом ниже на 0,6 процентного пункта.
💡 Рекомендация по выбору: сравнивать можно только уровни в одной и той же таблице; показатели из разных оценок нельзя объединять. Если хотите провести аналогичное сравнение на своих задачах, можно сверить данные через единый интерфейс APIYI apiyi.com и журналы вызовов. Но сначала проверьте, какие ID моделей и уровни поддерживает платформа в этот день.
3. Проверяем тенденцию по уровням Fable 5.2 на данных независимой организации
Если смотреть только на результаты в одной среде оценки, выводы могут зависеть от особенностей этой среды. AA — независимая организация, и её рейтинг поможет проверить, наблюдается ли тенденция, замеченная в Cursor, и в другой среде. Ниже — актуальный снимок данных на 10 ноября 2026 года; версия методики — Intelligence Index v5.0.1.
| Конфигурация | Intelligence Index | Стоимость за задачу (доллары США) |
|---|---|---|
| Fable 5.2 medium | 56 | 3.80 |
| Fable 5.2 high | 62 | 9.08 |
| Fable 5.2 xhigh | 62 | 14.83 |
| Fable 5.2 max | 65 | 26.54 |
| Opus 5.5 max | 59 | 10.04 |
65 — это не точность 65%
На странице с описанием методики AA указано, что индекс версии v5.0.1 складывается из 9 оценок, а на каждую из четырёх категорий навыков приходится по 25%. Таким образом, 65 — это сводный балл индекса, а не точность 65%. В среде AA переход от high к max повышает индекс на 3 пункта, а стоимость одной задачи возрастает примерно в 2,92 раза. У high и xhigh одинаковый результат — 62, но это не значит, что модели ведут себя одинаково на каждой задаче.
Сравнивать можно только результаты внутри каждой среды
В обеих средах прослеживается одна тенденция: у max выше балл, а стоимость примерно втрое больше, чем у high. Это подтверждает общую тенденцию. Однако задачи, способы оценки и расчёты стоимости в AA и Cursor различаются, поэтому нельзя объединять 65 баллов AA и 60,0% Cursor в один показатель точности.
4. Как выбрать уровень Fable 5.2 в зависимости от задачи
В официальном руководстве по промптам предлагается начать с уровня high для API и повышать или понижать его по результатам собственных оценок. medium больше подходит для интерактивных сценариев, xhigh — для сложных и длительных задач, где дополнительная мощность уже подтвердила свою пользу, а max — для оценки предельных возможностей модели или редких задач, для которых не важны ни время, ни расход токенов. На низких уровнях также стоит учитывать риск преждевременного завершения задачи.
Таблица рекомендаций для разных сценариев Fable 5.2
Три сценария ниже — гипотетические. Они нужны, чтобы показать принцип выбора.
| Гипотетический сценарий | Рекомендуемый стартовый уровень | Когда стоит повысить уровень | Чего лучше не делать |
|---|---|---|---|
| Изменение требований (изменить поля, настроить интерфейс, добавить тесты) | Оценить medium, при необходимости перейти на high |
Если на medium задача завершается раньше времени или часть изменений пропущена |
По умолчанию включать max для небольших изменений |
| Сложное исправление (баги в нескольких модулях, проблемы с параллельным выполнением) | High |
Если доля успешно выполненных задач на high не достигает критериев приёмки |
Сразу переходить на xhigh без проверки |
| Длительное исследование (открытые вопросы, поиск решений) | Начать с high |
Если задача важна, цена ошибки высока, а оценка уже показала пользу max |
Устанавливать max по умолчанию для всех запросов |
Когда выбирать Fable 5.2 high
- Для большинства API-задач, требующих серьёзных рассуждений и имеющих чёткие критерии приёмки;
- Если в команде ещё нет системы оценки уровней и нужен рекомендованный отправной вариант;
- Для производственных процессов с большим числом запросов, где важна стоимость каждой задачи.
Когда выбирать Fable 5.2 max
- Чтобы оценить предельные возможности модели в определённом классе задач;
- Для редких открытых задач, где цена ошибки намного выше стоимости модели;
- Если на собственных примерах уже подтверждено, что
maxподнимает долю успешно выполненных задач выше установленного порога, аhighне справляется.
🎯 Техническая рекомендация: выбирайте уровень отдельно для каждого класса задач — не нужно принимать решение для каждого запроса. В качестве отправной точки рекомендуется сначала протестировать
highна группе типичных задач. Если вы планируете подключаться через APIYI apiyi.com, перед запуском проверьте на платформе актуальные на сегодня ID модели, группу, конечную точку и поддержку параметра effort.
5 Решите по результатам собственных проверок, стоит ли переходить с Fable 5.2 на max
Публичные бенчмарки показывают лишь общую тенденцию. Решение об обновлении принимайте по результатам собственных проверок. Этот список можно использовать как есть. Главное правило: за один раз меняйте только уровень effort.
| Что фиксировать | Требования |
|---|---|
| Задачи и входные данные | Один и тот же набор задач, одинаковые входные данные и один и тот же system-промпт |
| Доступ к инструментам | Полностью одинаковый набор инструментов и права доступа |
| Модель и уровень effort | Записывайте ID модели и effort; в каждом прогоне меняйте только уровень effort |
| Критерии прохождения | Заранее определите пороговые значения. Не меняйте их после просмотра результатов |
| Использование токенов | Отдельно записывайте количество входных токенов, токенов записи и чтения кэша, а также выходных токенов |
| Время и повторные попытки | Фиксируйте общее время, количество повторных попыток и досрочных завершений |
| Фактическое списание | Ориентируйтесь на списания в журнале платформы, а не на расчёты по официальным тарифам |
| Неудачные примеры | Сохраняйте исходные ответы и анализируйте, какие проблемы удалось устранить с помощью max |
Fable 5.2: быстрый старт — сначала фиксируем usage
Минимальный пример ниже показывает только, как выполнить вызов и записать usage. В этой статье не приводится способ передачи параметра effort: доступна ли Fable 5.2 на платформе и поддерживается ли передача effort, нужно проверять по актуальной документации платформы.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Совместимый с OpenAI интерфейс APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # Укажите ID модели, доступность которой подтверждена в актуальной документации платформы
    messages=[{"role": "user", "content": "按验收标准修复以下函数……"}]
)
print(resp.usage)  # Записываем usage для последующей сверки
Полный код для записи результатов и сверки
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Официальные тарифы Anthropic в долларах за миллион токенов; используются только для оценки и не отражают фактическое списание
RATE_IN, RATE_OUT = 8.0, 40.0

def run_task(task_id: str, prompt: str, model: str, effort_label: str, passed_fn):
    """Выполняет задачу и возвращает запись с результатом проверки. effort_label — только метка для записи."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    text = resp.choices[0].message.content
    u = resp.usage
    est_usd = u.prompt_tokens / 1e6 * RATE_IN + u.completion_tokens / 1e6 * RATE_OUT
    return {
        "task_id": task_id,
        "model": model,
        "effort": effort_label,
        "passed": passed_fn(text),          # Заранее написанная функция проверки
        "prompt_tokens": u.prompt_tokens,
        "completion_tokens": u.completion_tokens,
        "est_usd": round(est_usd, 4),       # Оценочная стоимость
        "seconds": round(time.time() - start, 1),
        "output": text,                     # Сохраняем исходный текст неудачного результата
    }

def quota_to_usd(quota: int) -> float:
    """В логах платформы фактическое списание в долларах равно quota ÷ 500000."""
    return quota / 500000
В документации по логам APIYI перечислены поля model_name, prompt_tokens, completion_tokens, quota, duration_for_view, request_id и другие. Значение quota ÷ 500000 соответствует фактическому списанию в долларах, а поле other содержит дополнительные сведения, например коэффициент группы. Свяжите записи с результатами проверки и логи по request_id — так вы сможете рассчитать реальные затраты на задачи, прошедшие проверку, а не просто смотреть на стоимость отдельного запроса.
🚀 Быстрый старт: чтобы сначала проверить процесс на небольшой выборке, зарегистрируйтесь на APIYI apiyi.com и воспользуйтесь бесплатным тестовым лимитом для новых пользователей. Отработайте подход «одна задача, одна переменная, запись фактических расходов», а затем решайте, стоит ли расширять выборку.
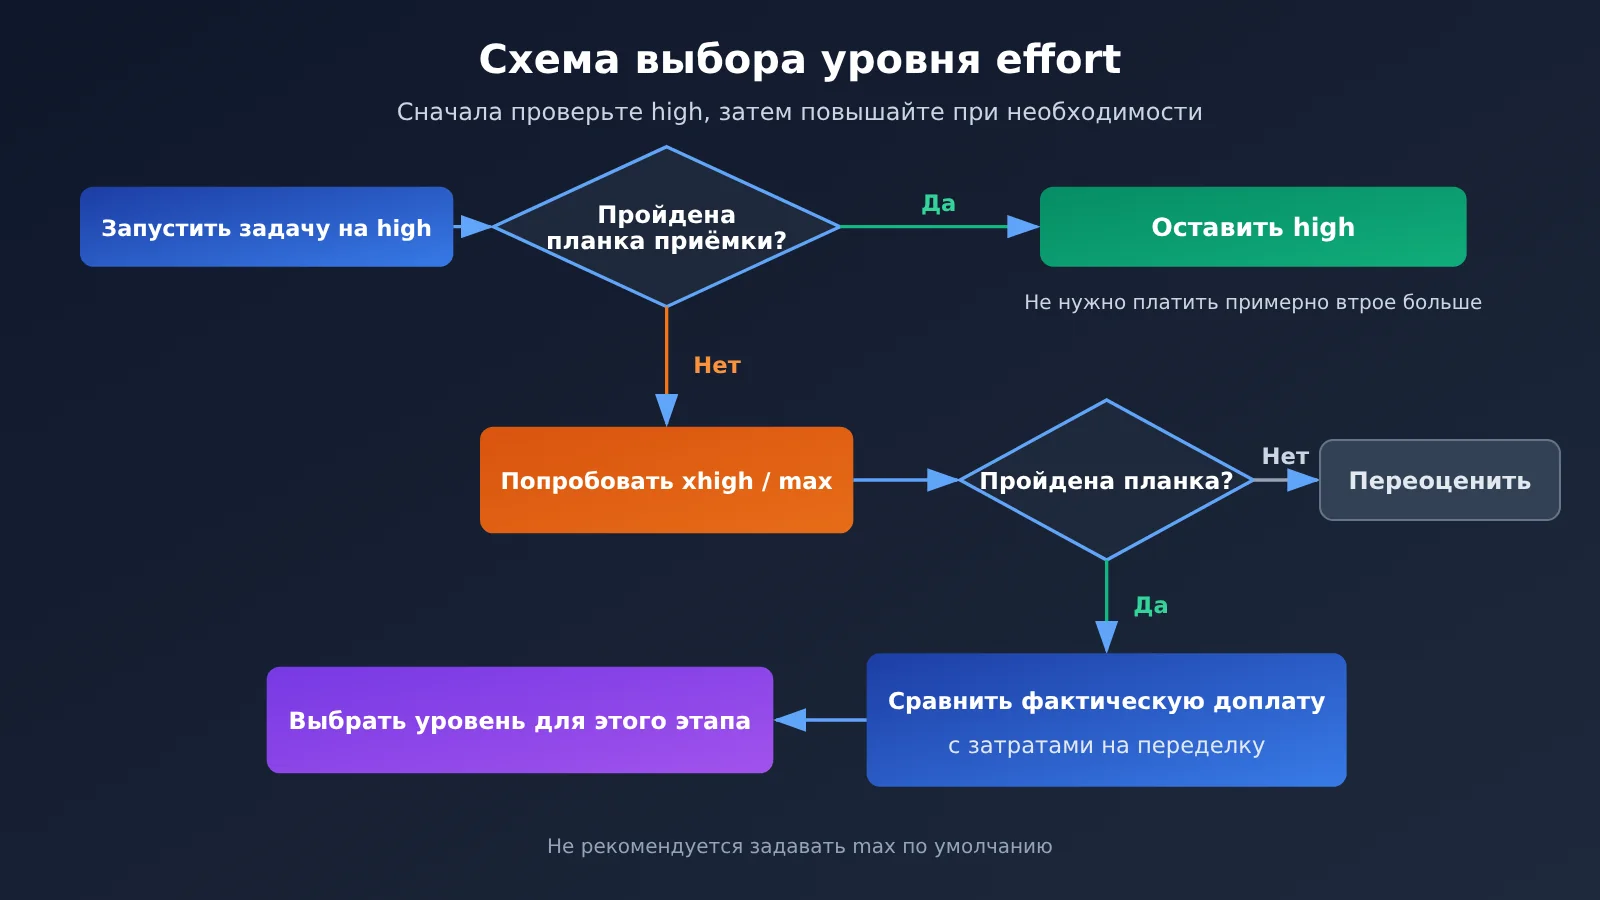
Главный принцип: сначала проверьте, достигает ли high нужного порога качества. Если да, нет смысла платить примерно втрое больше ради нескольких дополнительных процентов. Сравнивать дополнительные затраты на max со стоимостью ошибок и повторной работы стоит только в том случае, если high не достигает порога, а max — достигает. Не рекомендуется использовать max по умолчанию для всех запросов.
Часто задаваемые вопросы
Вопрос 1. Что означает уровень effort в Claude Fable 5.2?
Effort — это настройка, которая определяет, сколько ресурсов модель тратит на размышления. Доступны уровни от low до max. Цена за токен при этом не меняется, но меняются объём вычислений, количество шагов, время выполнения и расход токенов. Поэтому стоимость одной и той же задачи на разных уровнях может различаться в несколько раз. По умолчанию API использует уровень high.
Вопрос 2. Насколько high отличается от max в Fable 5.2?
В CursorBench 4.0 результат для high составил 56,9% при стоимости 9,70 доллара, а для max — 60,0% при стоимости 32,79 доллара. Разница в результате — 3,1 процентного пункта, а стоимость выше примерно в 3,38 раза. В AA результат для high составил 62 при стоимости 9,08 доллара, а для max — 65 при стоимости 26,54 доллара. Стоимость выше примерно в 2,92 раза. Эти данные можно сравнивать только внутри каждой из двух систем оценки.
Вопрос 3. Когда были собраны эти данные? Могут ли они измениться?
Fable 5.2 выпустили 9 ноября 2026 года, а данные в статье — это снимок, сделанный 10 ноября. Страницы AA и Cursor обновляются динамически, поэтому после изменения версии, набора задач или алгоритма расчёта стоимости цифры могут измениться. При цитировании указывайте дату, когда были получены данные.
Вопрос 4. Extra High показал результат ниже, чем High. Значит, его не стоит использовать?
Это результат только одного запуска CursorBench 4.0 — из него нельзя сделать вывод, что xhigh хуже справляется со всеми задачами. Разработчики рекомендуют использовать xhigh для сложных и длительных задач, если собственные тесты показали, что он даёт преимущество. Пока такого преимущества нет, не стоит включать его по умолчанию.
Вопрос 5. Как сравнить стоимость разных уровней Fable 5.2 через API?
Используйте один и тот же набор задач, меняя только уровень effort, и записывайте usage и фактические списания платформы. При вызове через унифицированный интерфейс APIYI apiyi.com фактическую сумму в долларах можно рассчитать по формуле quota ÷ 500000, используя данные из журналов. Перед запуском проверьте актуальные на этот день ID модели, группу и поддержку effort на платформе. В этой статье не приводятся непроверенные способы передачи параметров.
Вопрос 6. В чём ограничения открытых результатов оценки?
CursorBench — это оценка поставщика инструментов в собственной среде, а индекс AA — взвешенная комплексная оценка. Ни то ни другое не равно доле успешно выполненных задач в вашем бизнесе. По разнице примерно в 3 процентных пункта также нельзя судить о статистической значимости. Первые отзывы в соцсетях могут дать полезные ориентиры, но окончательные выводы стоит делать по результатам проверки на собственных примерах.
Вопрос 7. После снижения цены API на 20% уровень max стал выгодным?
Не обязательно. Снижение цены даёт пропорциональную экономию только при неизменном объёме использования. На уровне max расход токенов и количество шагов могут более чем втрое превышать показатели high, поэтому рост объёма легко сводит экономию от снижения цены на нет. Сравнивать нужно фактическую стоимость выполнения одной задачи, а не только цену за токен.
Ключевые выводы о Fable 5.2 high и max
- Цена за единицу не меняется, а счёт — да: уровень effort влияет на объём размышлений и количество шагов, поэтому стоимость задачи при одной и той же цене может различаться в несколько раз.
- В API по умолчанию используется high: разработчики рекомендуют начать с high, а затем повысить или понизить уровень по результатам собственной оценки.
- Сравнение Cursor: переход с high на max повышает результат на 3,1 процентного пункта, а стоимость возрастает примерно в 3,38 раза.
- Сравнение AA: показатель растёт с 62 до 65, а стоимость — примерно в 2,92 раза; 65 — это не точность.
- Условия тестирования нельзя объединять: результаты двух оценок можно сравнивать только внутри каждой из них. Сводить их в единый показатель соотношения цены и качества нельзя.
- Оставьте max для отдельных задач: он подходит для оценки максимальных возможностей модели и решения важных открытых задач.
- Проверяйте по фактическим расходам: сравнивайте одну и ту же задачу, меняя только один параметр, и записывайте usage. Сверить расходы можно по журналам APIYI apiyi.com.
Итоги
Выбор между Fable 5.2 high и max сводится к трём пунктам:
- Разделяйте цену за единицу и стоимость выполнения задачи: уровень не меняет цену за единицу, но влияет на объём вычислений.
- Сравнивайте данные только в рамках одной среды: и Cursor, и AA показывают, что результат max немного выше, а стоимость примерно втрое больше, чем у high. Но сравнивать результаты между собой нельзя.
- Ориентируйтесь на критерии приёмки: если high проходит проверку, оставьте его. Сравнивать дополнительные затраты и цену возможных доработок стоит только тогда, когда high не справляется, а max проходит проверку.
Для большинства команд надёжнее сначала определить категории задач и зафиксировать критерии приёмки для high, а затем отдельно проверить max на небольшом числе важных задач. Рекомендуем быстро провести проверку на собственных данных через единый интерфейс APIYI apiyi.com и журналы вызовов. Убедитесь, что модель и нужные уровни доступны, прежде чем масштабировать использование.
📚 Источники
- Анонс Anthropic: область запуска Fable и Mythos 5.2 и оценка производителя
- Ссылка:
anthropic.com/claude-fable-and-mythos-5-2 -
Примечание: дата публикации — 2026-11-09; указаны методика расчёта скорости и таблица результатов оценки
-
Цены Claude API: официальные стандартные тарифы
- Ссылка:
platform.claude.com/docs/en/about-claude/pricing -
Примечание: для Fable 5.2 стоимость входных и выходных токенов составляет 8 и 40 долларов за миллион соответственно
-
Характеристики модели Fable 5.2: контекст, лимит вывода и уровень усилий по умолчанию
- Ссылка:
platform.claude.com/docs/en/models/fable-5-2/overview -
Примечание: адаптивное мышление включено всегда; в API по умолчанию задан уровень high
-
Руководство по промптам для Fable 5.2: официальные рекомендации по выбору уровня
- Ссылка:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
Примечание: сценарии использования уровней medium, high, xhigh и max
-
CursorBench 4.0: оценка по пяти уровням в собственной среде Cursor
- Ссылка:
prod.cursor.com/evals -
Примечание: это оценка, проведённая самим поставщиком инструмента, а не независимое повторное тестирование общего назначения
-
Рейтинг моделей Artificial Analysis: динамический рейтинг независимой организации
- Ссылка:
artificialanalysis.ai/leaderboards/models -
Примечание: Intelligence Index и стоимость выполнения каждой задачи
-
Методика оценки Artificial Analysis: состав Intelligence Index v5.0.1
- Ссылка:
artificialanalysis.ai/methodology/intelligence-benchmarking -
Примечание: 9 тестов; на каждую из четырёх категорий способностей приходится по 25%
-
Как Cursor сравнивает качество моделей: статья о методике предыдущей версии бенчмарка
- Ссылка:
prod.cursor.com/blog/cursorbench -
Примечание: полезна только для понимания принципов разработки; не подходит для выводов по статистике версии 4.0
-
APIYI: API для поиска логов: поля логов и расчёт фактически списанной суммы
- Ссылка:
docs.apiyi.com/api-capabilities/log-query - Примечание: фактическое списание в долларах рассчитывается как quota ÷ 500000
Автор: техническая команда APIYI
Техническое обсуждение: свяжитесь с нами на главной странице сайта APIYI apiyi.com. Другие материалы доступны в центре документации docs.apiyi.com