Примечание автора: разберём структуру затрат на инференс, объясним, почему Token-сервисы легко уходят в убыток, и дадим практический чек-лист для оценки поставщиков API моделей.
Токены уже вовсю продают в прямых эфирах, но финансовые показатели провайдеров инференса вроде SiliconFlow по-прежнему не радуют. В другой новости компания сочла Claude слишком дорогим, перешла на GLM, поддержала 2000 инженеров на 56 картах B200 и сократила затраты на AI примерно на 90%. Если посмотреть на эти две истории вместе, становится видно: у структуры затрат Token-сервисов есть свои закономерности. В этой статье мы отталкиваемся от структуры затрат на инференс, объясняем, почему Token-сервисы работают в минус, а затем переходим к вопросу, который действительно волнует разработчиков: как оценить, надёжен ли поставщик API моделей.
Это не очередная статья с пересудами об индустрии. Все разборы ниже строятся вокруг технических переменных: амортизации GPU, коэффициента использования, разницы в стоимости Prefill и Decode, KV Cache, доли попаданий в кэш и стратегий субсидирования. После прочтения вы сможете сразу применить это при выборе провайдера.
Главная ценность: после прочтения вы поймёте, из чего складывается стоимость токена, и получите методику оценки поставщика по 6 измерениям. А ещё узнаете, как с помощью реальных данных о вызовах проверить, прозрачна ли тарификация.
Почему Token-сервисы убыточны: главное о структуре затрат на инференс
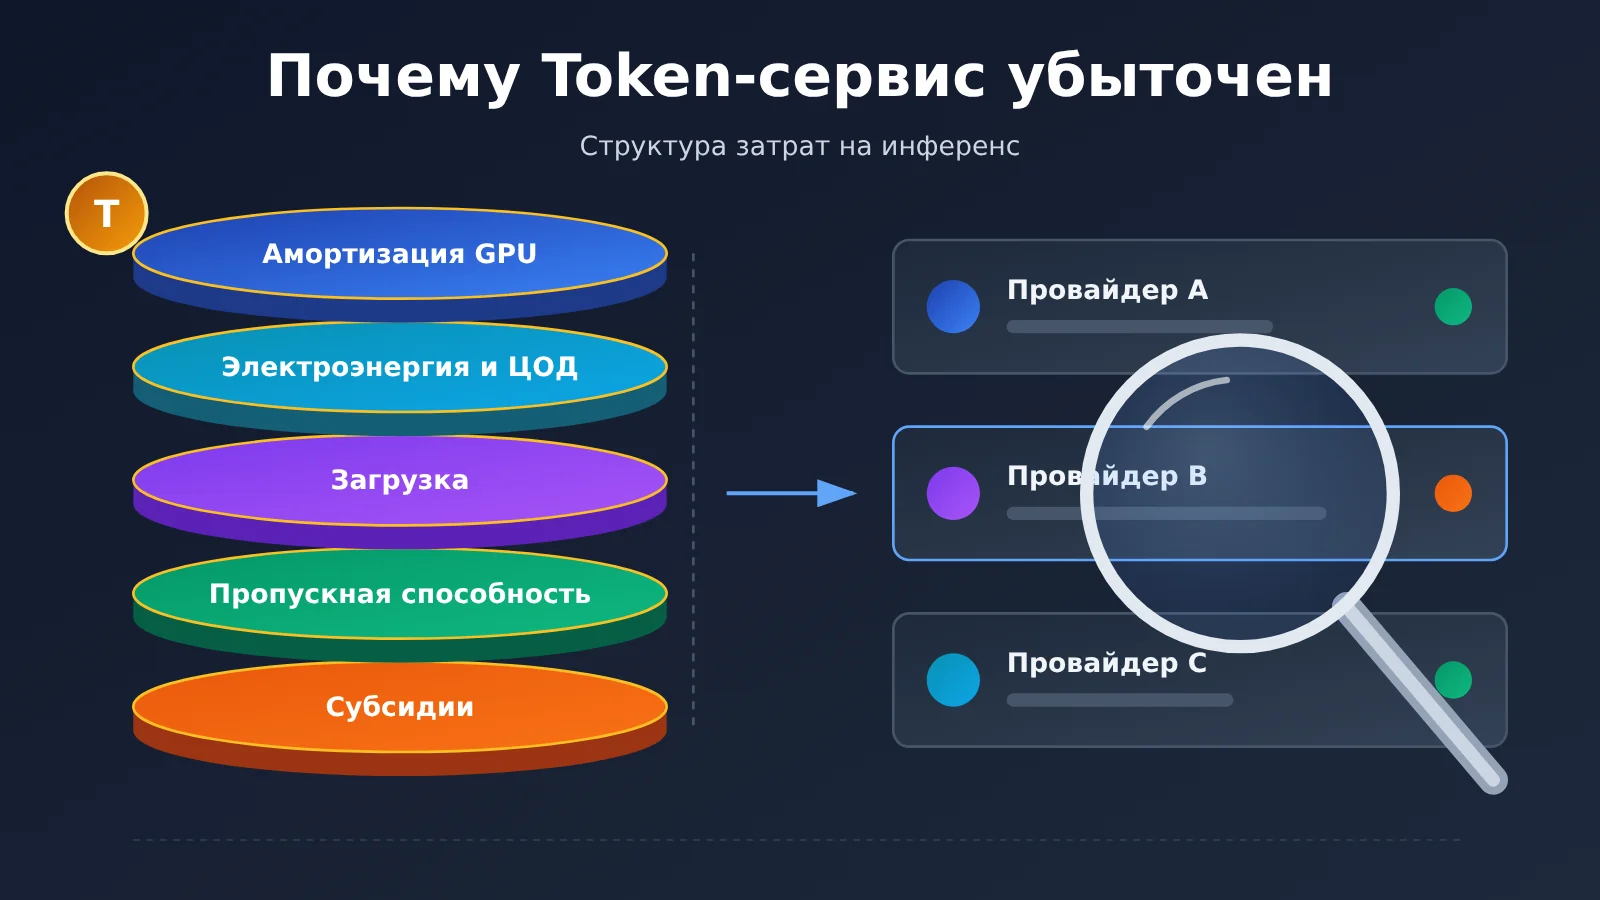
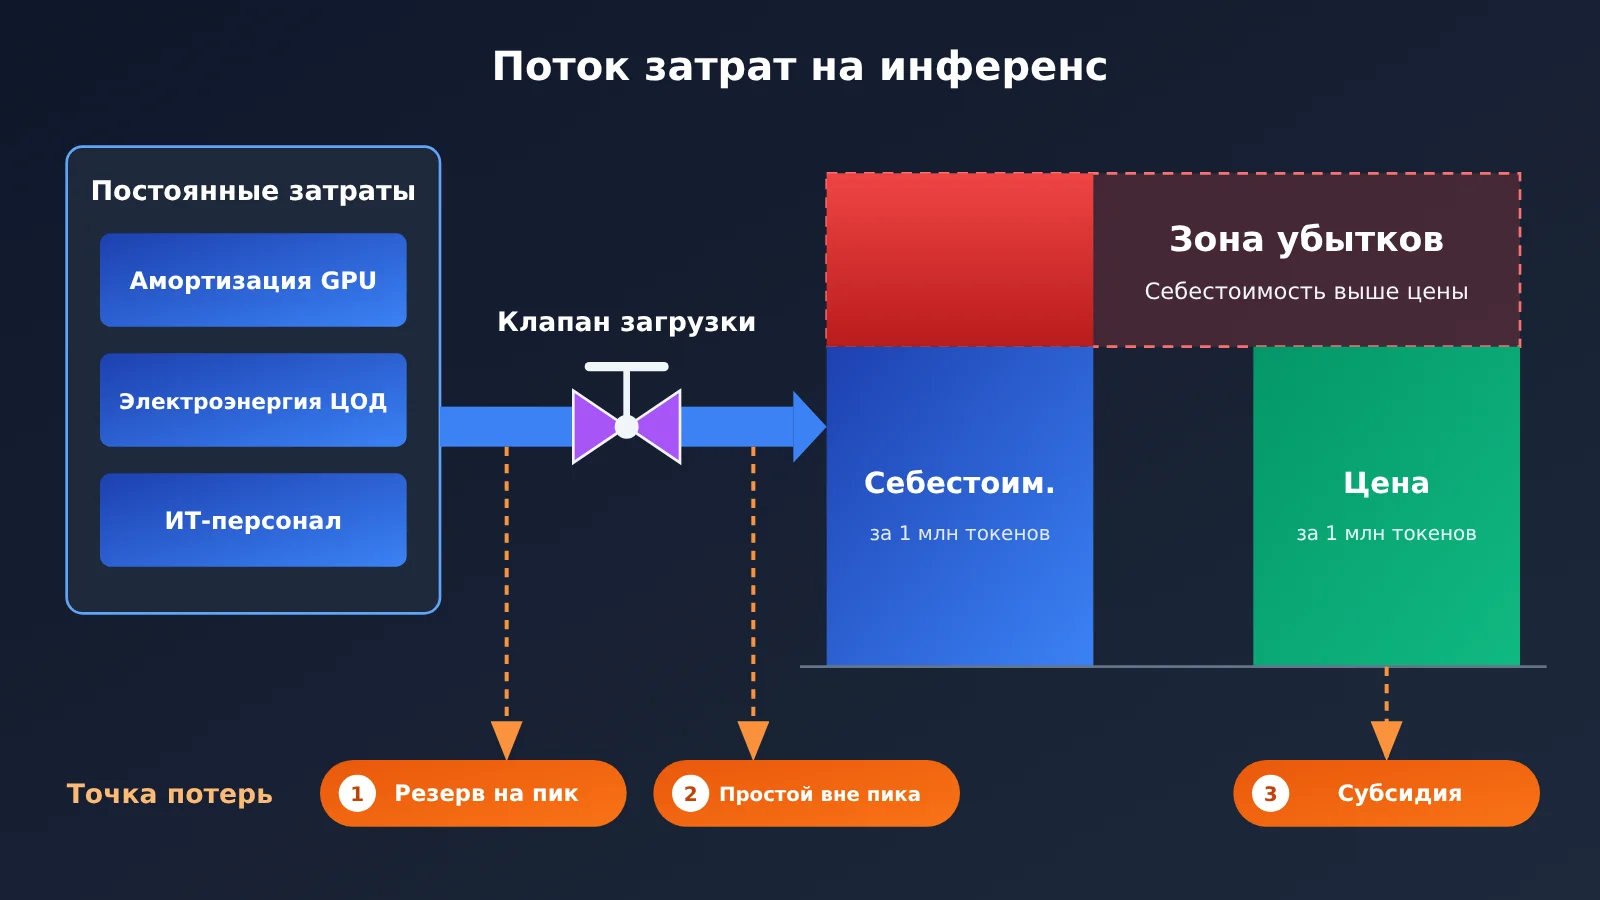
Сразу к выводу. Большая часть затрат на инференс-сервис — это фиксированные издержки, а выручка считается по объёму токенов. Связывает их «загрузка». Если загрузка не растёт или конкуренция прижимает цену к маржинальным издержкам, в отчётах появляется убыток.
| Элемент затрат | Описание | Влияние на цену за токен |
|---|---|---|
| Капитальные затраты на GPU и амортизация | Покупка или долгосрочная аренда топовых GPU, амортизация по годам | Фиксированные затраты: чем ниже загрузка, тем выше доля на токен |
| Дата-центр, электроэнергия, сеть | Хостинг, охлаждение, пропускная способность, межрегиональное резервирование | Условно-фиксированные затраты; распределяются только при масштабе |
| Загрузка GPU | Доля времени, когда GPU реально занят инференсом, и насыщенность батчинга | Ключевой рычаг прибыли и убытка; разница пиков и спадов напрямую съедает прибыль |
| Структура Prefill / Decode | Вход обрабатывается параллельно, выход генерируется токен за токеном | Выходные токены дороже; при длинных ответах нагрузка выше |
| Длинный контекст и KV Cache | Память занята кэшем, снижается ёмкость параллельных запросов | Запросы с длинным контекстом уменьшают число пользователей, которых можно обслужить |
| Субсидии и привлечение клиентов | Бесплатные лимиты, дешёвый трафик, доля каналам | Краткосрочно разгоняет объём, долгосрочно снижает маржу |
Подробно о ключевых элементах структуры затрат Token-сервиса
Несоответствие фиксированных затрат и выручки по факту потребления — первая причина. Полностью укомплектованный GPU-сервер несёт амортизацию, расходы на электричество и дата-центр независимо от того, есть запросы или нет. Пользователь же платит только за фактически потраченные токены. В дневной пик нужно держать достаточно мощностей, чтобы выдерживать задержку, а ночью эти мощности простаивают. Затраты простоя в итоге раскладываются на токены, проданные в часы пик. Если при ценообразовании ориентироваться только на «теоретическую стоимость при полной загрузке», в реальной работе почти гарантированно будет убыток.
Ценовая конкуренция прижимает цену к маржинальным издержкам — вторая причина. Веса open-source моделей доступны всем, несколько провайдеров инференса разворачивают одну и ту же модель, пространство для дифференциации минимально — цена закономерно становится главным инструментом конкуренции. То, что токены продвигают в прямых эфирах со скидками, говорит о том, что такой товар уже близок к «стандартизированному сырьевому товару». В такой ситуации провайдеру трудно покрывать фиксированные затраты за счёт наценки — приходится бороться масштабом и эффективностью планирования.
Разбор стоимости инференс-сервиса: как рассчитывается цена за токен
Чтобы понять, почему сервисы на токенах уходят в минус, нужно разбить один запрос на инференс на два этапа. На разных этапах расходуются разные ресурсы — и подход к тарификации тоже разный. Именно поэтому многие провайдеры назначают отдельные цены на вход, выход и кэш.
Prefill и Decode: почему выходные токены дороже
Сначала запрос попадает в фазу Prefill. Модель параллельно обрабатывает все входные токены: вычислений много, но эффективность высокая — вычислительная мощность GPU используется полностью. Затем начинается фаза Decode: модель генерирует по одному токену за раз и постоянно перечитывает предыдущий KV Cache. Эта фаза сильнее ограничена пропускной способностью видеопамяти, и загрузить GPU на полную мощность не получается.
Поэтому при одинаковом количестве токенов удельная стоимость выхода обычно заметно выше стоимости входа. У крупнейших провайдеров цена за выходной токен, как правило, тоже выше цены за входной. Если бизнес в основном связан с длинными ответами — генерацией кода, написанием больших текстов или многораундовыми рассуждениями Agent, — затраты смещаются в сторону выхода. При оценке провайдера в первую очередь смотрите на цену выходного токена и пропускную способность выхода.
KV Cache и длинный контекст: невидимый налог на видеопамять
Длинный контекст стоит дороже не только из-за «больше входа». KV Cache растёт вместе с длиной контекста и занимает всё больше видеопамяти, а число запросов, которые одна карта может обслуживать одновременно, соответственно падает. То есть один пользователь со сверхдлинным контекстом может занять в параллельной обработке место нескольких обычных пользователей. Эти затраты не всегда полностью отражаются в цене за токен — провайдеру приходится балансировать за счёт тарификации по уровням, ограничения скорости или лимитов на длину контекста.
Попадание в кэш: и способ снизить затраты, и тарифная ловушка
Кэширование промптов (Prompt Caching) позволяет не пересчитывать повторяющийся префикс: за попавшую в кэш часть берут по более низкой цене чтения кэша. В сценариях вроде Agent или RAG, где системный промпт длинный и повторяется, доля попаданий в кэш заметно влияет на итоговый счёт. Учтите: у разных провайдеров правила тарификации записи в кэш, чтения из кэша и срока его действия различаются, а иногда кэш нужно включать явно. При оценке обязательно проверьте, содержит ли возвращаемое поле usage статистику токенов, связанных с кэшем.
| Метрика тарификации | Особенности расхода ресурсов | Что уточнить при оценке |
|---|---|---|
| Входные токены | Prefill — параллельные вычисления, высокая эффективность | Есть ли тарификация по уровням в зависимости от длины контекста |
| Выходные токены | Decode — генерация по одному токену, ограничена пропускной способностью видеопамяти | Цена выхода, пропускная способность выхода (Token/s) |
| Запись в кэш | Первичная запись в кэш, часть платформ тарифицирует отдельно | Есть ли наценка за запись, какой срок действия кэша |
| Чтение из кэша | Попадание в префикс, повторные вычисления пропускаются | Скидка на попавшую в кэш часть, раскрывается ли usage |
| Токены рассуждения (reasoning) | Внутренний процесс рассуждения reasoning-модели | Считаются ли они выходом, можно ли ограничить бюджет |
💰 Пояснение по тарификации: таблица выше описывает только измерения тарификации и не содержит конкретных цен. Актуальные цены на вход и выход, а также на чтение и запись кэша для моделей из этой статьи смотрите на странице цен APIYI:
https://docs.apiyi.com/models. У разных моделей и в разных группах правила тарификации могут отличаться — перед заказом сверьте всё по пунктам.
Собственный инференс vs вызов API: как считать затраты на токены
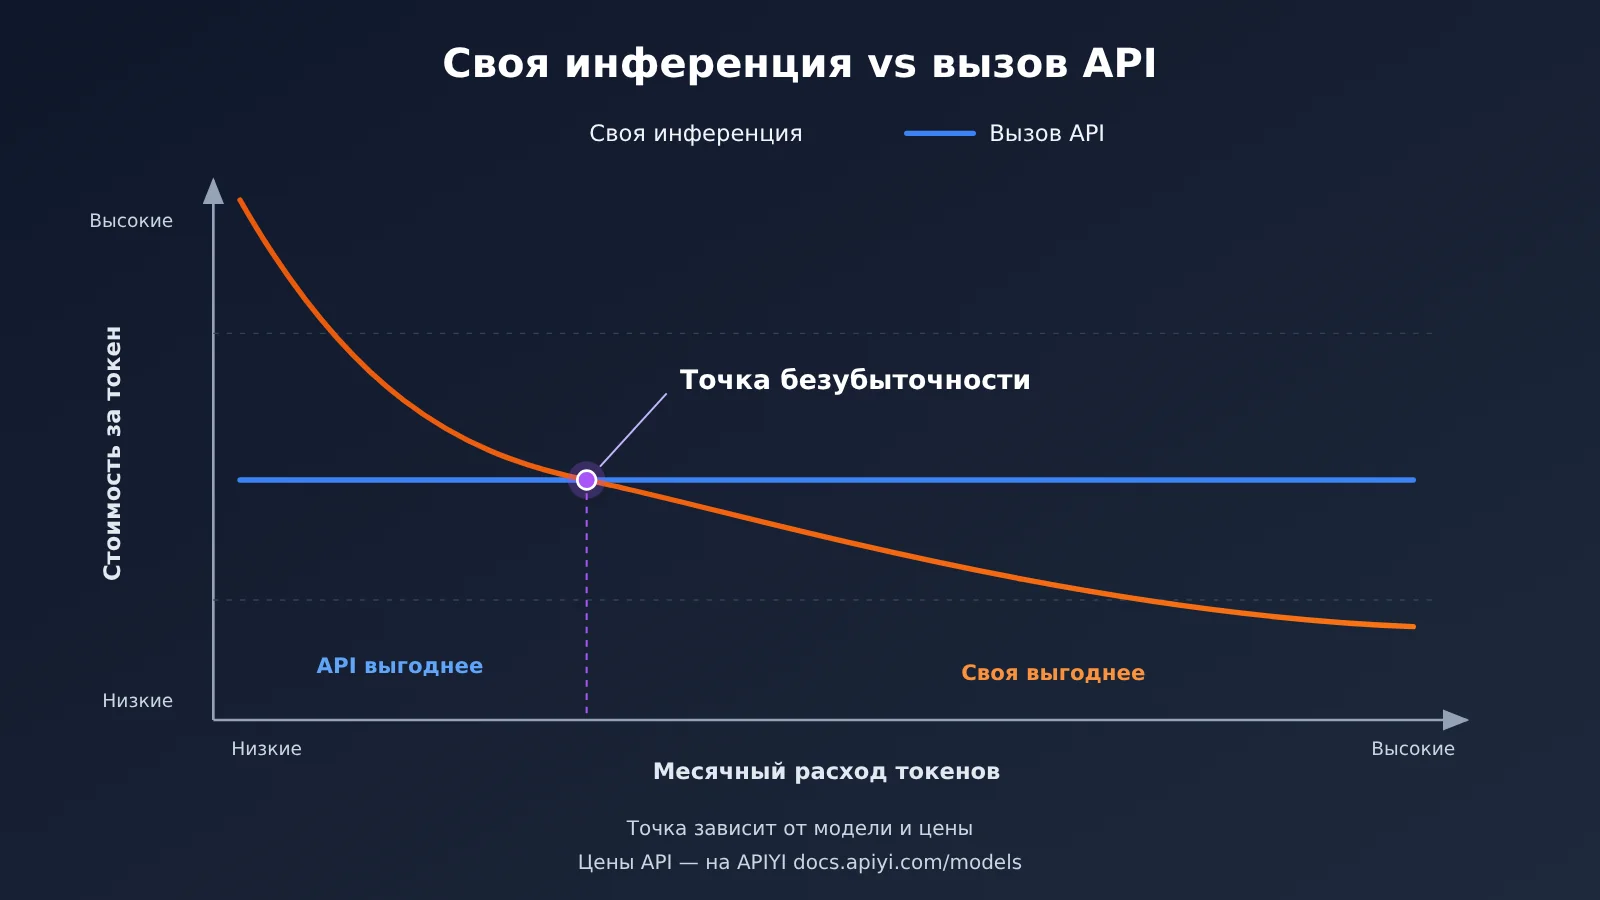
Кейс «56 GPU B200 обслуживают 2000 инженеров, а затраты снизились примерно на 90%» работает при нескольких предпосылках. Нагрузка компании идёт от внутренних инженеров: запросов много, и они относительно стабильны. Нагрузка сосредоточена в рабочие часы, предсказуемость высокая. Модель заменили на открытую GLM, которую можно развернуть у себя. Эти три момента позволяют хорошо распределить фиксированные затраты по объёму и как раз обойти самую болезненную для публичных провайдеров инференса проблему — утилизацию.
С другой стороны, этот кейс не значит, что всем командам стоит строить собственный инференс. Если запросов мало, нагрузка сильно колеблется или нужно часто переключаться между несколькими закрытыми моделями, затраты на простой GPU-кластера быстро превысят счёт за API. Ценность публичных провайдеров инференса как раз в том, что они сглаживают пики за счёт нагрузки множества клиентов и получают более высокую общую утилизацию.
| Вариант | Структура затрат | Когда подходит | Основные риски |
|---|---|---|---|
| Собственный GPU-кластер | Высокие фиксированные затраты, низкие предельные | Крупные команды с большим объёмом, стабильной нагрузкой и фиксированной моделью | Простой и неэффективное использование, трудозатраты на эксплуатацию, обесценивание оборудования при смене поколений |
| Официальный API одной модели | Только оплата по факту использования | Бизнес, сильно зависящий от одной закрытой модели | Цена от одного поставщика, высокие затраты на переключение, ограниченная доступность по регионам |
| Агрегатор API нескольких моделей | Оплата по факту, единый интерфейс | Нужно сравнивать, переключать и смешивать несколько моделей | Нужно проверять прозрачность биллинга и стабильность |
| Гибридная архитектура | Частые задачи — на своём железе, длинный хвост — через API | Средний или крупный бизнес с чётким разделением моделей по уровням | Рост сложности архитектуры |
Сравнительный анализ собственного варианта: у собственного инференса есть преимущество по нижней границе удельной стоимости, но только если утилизация достаточно высока, а команда умеет заниматься развёртыванием, квантизацией, масштабированием и восстановлением после сбоев. Для сравнения: удельная стоимость API более предсказуема, и он лучше подходит командам с сильно колеблющейся нагрузкой и потребностью параллельно проверять несколько моделей.
Сравнительный анализ агрегаторов: у официальных API есть преимущество по скорости вывода новых моделей на рынок, но в большинстве случаев один аккаунт покрывает модели только одного поставщика. Плюс агрегатора нескольких моделей — один интерфейс к множеству моделей, что упрощает A/B-сравнение и разделение затрат по уровням. Такие платформы, как APIYI apiyi.com, совместимы одновременно с форматами API OpenAI и Anthropic, поэтому для переключения модели достаточно минимально изменить существующий код.
Как оценить провайдера API для моделей: быстрый чек-лист из 6 измерений
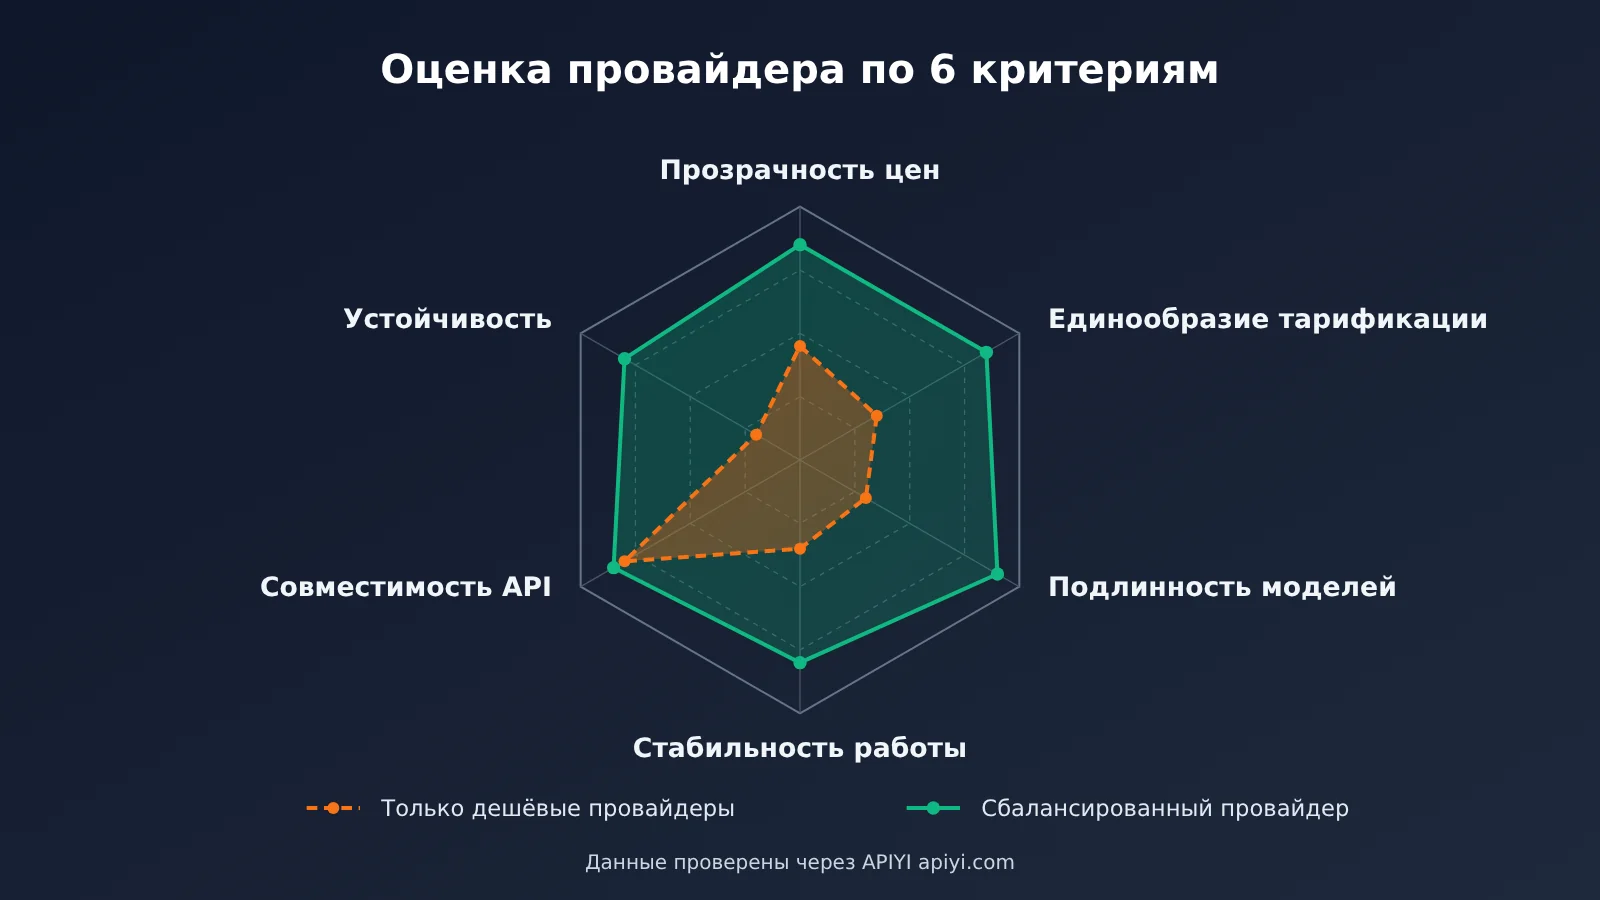
Когда вы понимаете структуру затрат, можно сделать обратный вывод: цена, которая долго держится ниже себестоимости, неустойчива. Провайдер либо где-то «экономит», либо какое-то время живет за счет субсидий. Поэтому при оценке провайдера нельзя смотреть только на ценник — нужно проверять все 6 измерений вместе.
| Измерение | Ключевой вопрос | Как проверить |
|---|---|---|
| 1. Прозрачность цен | Отдельно ли опубликованы цены на вход, выход и кеширование | Сверить страницу с ценами и зафиксировать каждую позицию |
| 2. Согласованность биллинга | Совпадает ли фактическое списание с usage |
Сделать небольшой пакет вызовов и сверить детализацию счета |
| 3. Подлинность модели | Нет ли деградации, смешивания моделей или чрезмерного квантования | Сравнить качество вывода на фиксированном тестовом наборе |
| 4. Стабильность производительности | Какие задержка до первого токена, пропускная способность и доля ошибок | Прогнать тесты в пик и в низкую нагрузку |
| 5. Совместимость интерфейса | Совместим ли формат с OpenAI / Anthropic | Взять текущий SDK и проверить, заменив только base_url |
| 6. Устойчивость | Не выглядит ли цена явно ниже разумного диапазона себестоимости | Оценить риск субсидий через структуру затрат |
Шаг 1: Подключение через совместимый интерфейс и минимальный вызов
Объяснить процесс тестирования можно и без написания кода. Если ваш проект уже использует OpenAI SDK, обычно достаточно поменять два параметра: заменить api_key на ключ от провайдера, а base_url — на адрес API провайдера. На примере APIYI: base_url в формате, совместимом с OpenAI, — https://api.apiyi.com/v1, запросы чата идут по пути /v1/chat/completions, а в поле model достаточно указать название нужной модели.
Если проект построен на Anthropic SDK — например, используется модельный ряд Claude или инструменты вроде Claude Code, — адрес API тоже можно заменить и работать через нативный формат Anthropic по пути /v1/messages. Точные адреса и названия моделей смотрите в документации APIYI: https://docs.apiyi.com. При минимальном вызове рекомендую сразу включить потоковый вывод через stream — так потом будет удобнее измерять задержку до первого токена.
Шаг 2: Проверяем логику тарификации и поля usage
В ответе на каждый вызов формат OpenAI возвращает usage.prompt_tokens и usage.completion_tokens, а некоторые модели ещё и cached_tokens для попаданий в кэш. В формате Anthropic этому соответствуют input_tokens, output_tokens и поля чтения и записи кэша. Оценить стоимость одного вызова можно простой формулой: количество входных токенов умножить на цену входных, прибавить количество выходных токенов, умноженное на цену выходных, и прибавить количество токенов чтения и записи кэша, умноженное на соответствующую цену кэша.
Сравните расчёт с детализацией счёта платформы — отклонение должно иметь объяснение. Если постоянно выходит «счёт больше, чем следует из usage», или попадания в кэш вообще не отражаются в тарификации, это повод насторожиться. Цены, которые используете в расчёте, берите из опубликованных данных на странице цен APIYI: https://docs.apiyi.com/models.
Шаг третий: проверяем производительность, качество и пиковую нагрузку
При тестировании производительности стоит фиксировать три показателя: задержку первого токена (TTFT), пропускную способность вывода (токенов в секунду) и долю ошибок (тайм-ауты, ограничение скорости 429, 5xx). Проведите по одному раунду тестирования в пиковые часы рабочего дня и в ночные часы спада: чем меньше колебания, тем лучше провайдер планирует мощности. Для проверки качества используйте фиксированный набор промптов, охватывающий код, рассуждения и длинные тексты, и перекрёстно сравнивайте вывод с официальным каналом или другими платформами — это помогает заметить, что модель понизили в классе или подменили.
| Что тестируем | Ключевые параметры / поля | Ориентир для прохождения |
|---|---|---|
| Задержка первого токена | Включить stream, замерить время до первого чанка |
Разница между пиком и спадом не слишком большая |
| Пропускная способность вывода | completion_tokens ÷ время генерации |
Близко к другим каналам той же модели |
| Сверка биллинга | Поля usage × цена за единицу со страницы тарифов |
Отклонения от детализации счёта объяснимы |
| Попадания в кэш | cached_tokens или поле чтения кэша |
У повторных запросов с длинным префиксом есть попадания |
| Стабильность | Количество 429 / 5xx / тайм-аутов | Низкая доля ошибок и есть описание повторных попыток |
🚀 Быстрый старт: если хотите сравнить стоимость и производительность нескольких моделей на одном наборе интерфейсов, сначала зарегистрируйтесь через APIYI apiyi.com и получите тестовый лимит. Платформа предоставляет вызовы API популярных моделей из этой статьи, совместима с форматами OpenAI и Anthropic — достаточно заменить
base_urlнаhttps://api.apiyi.com/v1, и можно начинать проверку. Цены на модели смотрите наhttps://docs.apiyi.com/models.
Частые вопросы FAQ
Q1: Почему токен-сервис убыточен?
В сервисах инференса основную часть затрат составляют фиксированные расходы: амортизация GPU, электричество для ЦОД и т. п. При этом выручка привязана к объёму токенов. В пиковые часы нужно резервировать вычислительные мощности, а в часы спада они простаивают — удерживать высокую загрузку долго сложно. Добавьте к этому ценовые войны из-за однородности открытых моделей и субсидии в виде бесплатных квот — цену легко опустить ниже себестоимости.
Q2: Почему выходные токены обычно дороже входных?
Входные токены обрабатываются параллельно на этапе Prefill, поэтому GPU используются эффективно. Выходные генерируются по одному на этапе Decode: приходится многократно читать KV Cache, и всё упирается в пропускную способность видеопамяти, так что удельная стоимость выше. Поэтому в задачах с длинным выводом особенно важны цена выходных токенов и пропускная способность.
Q3: Всегда ли собственные GPU дешевле, чем вызов API?
Не всегда. Кейсы вроде «56 B200 обслуживают 2000 инженеров» опираются на крупную, стабильную и предсказуемую внутреннюю нагрузку. Если команда небольшая или нагрузка сильно колеблется, собственные мощности будут простаивать, и удельная стоимость окажется выше. Лучше сначала прогнать реальный профиль использования через API, а потом оценивать точку безубыточности.
Q4: Можно ли пользоваться API-провайдером с особо низкими ценами?
Проверить можно, но нужно больше валидации. Цена заметно ниже разумного диапазона себестоимости обычно означает одно из четырёх: субсидии, ограничения скорости, деградацию модели или скидку в обмен на стабильность. Надёжнее сверять качество и биллинг по чек-листу из 6 критериев из этой статьи, а не смотреть только на ценник.
Q5: Как недорого сравнить API разных моделей?
Рекомендую тестировать на мультимодельной платформе, совместимой с популярными форматами API:
1. Зарегистрируйте аккаунт в APIYI (apiyi.com) и получите API-ключ
2. Настройте интерфейс, совместимый с OpenAI или Anthropic, по документации `https://docs.apiyi.com`
3. С фиксированным тестовым набором по очереди меняйте поле `model` и записывайте задержку, качество и `usage`
Один и тот же код позволяет провести сравнение по разным моделям — переключаться очень просто.
Q6: Как узнать цену кэша? У разных платформ одинаковая методика расчёта?
Нет. Где-то запись в кэш тарифицируется отдельно, где-то скидка действует только на чтение, плюс отличаются срок действия и способ включения. При работе через APIYI цены чтения и записи кэша смотрите в актуальных данных на странице цен `https://docs.apiyi.com/models` и сверяйте списания с полями кэша в возвращаемом `usage`.
Q7: Какой показатель при оценке провайдера упускают чаще всего?
Согласованность биллинга и стабильность в часы пик. Многие команды делают один тест в непиковое время и выходят в прод, а потом в пике постоянно ловят 429 или таймауты. Другие никогда не сверяют `usage` с счётом. Оба пункта стоит включить в обязательную проверку перед запуском.
Ключевые выводы: стоимость Token-сервисов и оценка API-провайдеров
- Корень убытков: высокие фиксированные затраты, оплата по факту использования и колебания загрузки. Эти три фактора не совпадают, и Token-сервис легко уходит в минус.
- Выход дороже: Decode ограничен пропускной способностью видеопамяти, поэтому в сценариях с длинным выводом нужно внимательно следить за ценой выходных токенов и пропускной способностью.
- У длинного контекста есть скрытые затраты: KV Cache занимает видеопамять и снижает параллелизм, поэтому провайдерам приходится балансировать тарифными уровнями и лимитами.
- Самостоятельный хостинг не для всех: только большая и стабильная нагрузка позволяет размыть фиксированную стоимость GPU; небольшим командам лучше сначала использовать API.
- Оценка по шести параметрам: прозрачность цен, согласованность биллинга, соответствие модели заявленной, стабильность производительности, совместимость API и долгосрочная устойчивость.
- Как начать: быстро проверить всё на практике через APIYI, совместимый с форматами OpenAI / Anthropic; актуальные цены — в
docs.apiyi.com/models.
Итог: как понять Token-сервисы через структуру затрат и выбрать правильного провайдера API для моделей
Почему Token-сервисы убыточны? В конечном счёте всё упирается в структуру затрат на инференс:
- С точки зрения затрат: амортизация GPU и электроэнергия в ЦОД — это фиксированные расходы, а загрузка — главный рычаг рентабельности. Выходные токены и длинный контекст дополнительно повышают стоимость.
- С точки зрения выручки: из-за однородности open-source моделей ценовых войн трудно избежать, а субсидии помогают набрать объём, но давят на маржу.
- С точки зрения выбора: низкая цена ещё не означает выгоду. Смотрите на шесть параметров: прозрачность цен, согласованность биллинга, соответствие модели заявленной, стабильность производительности, совместимость с API и долгосрочную устойчивость.
Разработчикам стоит опираться на реальные данные вызовов, а не гадать, кто из провайдеров протянет дольше. Сначала прогоните небольшой трафик, сверьте биллинг и сравните качество, а уже потом выбирайте основную модель и резервный канал.
Рекомендую быстро проверить результат через APIYI apiyi.com. Платформа даёт API-доступ к моделям из этой статьи, совместимый с интерфейсами OpenAI и Anthropic; документация — https://docs.apiyi.com. Актуальные цены на вход, выход и кеширование для всех моделей смотрите на странице цен https://docs.apiyi.com/models.
📚 Источники
- 36氪 — Токены уже продают в прямых эфирах Ли Цзяци, а «硅基流动» и другие всё ещё в убытках?: репортаж о проблемах рентабельности провайдеров инференса
- Ссылка:
36kr.com/p/4055385238017664 -
Пояснение: фон отрасли — превращение токенов в товар и убытки провайдеров инференса
-
36氪 — Кто-то ежемесячно сжигает 10 000 долларов, считает Claude слишком дорогим, и эта компания перешла на GLM: кейс снижения затрат за счёт собственного инференса
- Ссылка:
36kr.com/p/4055383551038595 -
Пояснение: кейс собственного инференса на 56 картах B200 для 2000 инженеров — помогает понять границу затрат между self-hosted-решением и API
-
Центр документации APIYI: подключение к интерфейсу и цены на модели
- Ссылка:
docs.apiyi.com - Пояснение: способы совместимого подключения OpenAI / Anthropic, цены на модели смотрите на
docs.apiyi.com/models
Автор: техническая команда APIYI
Техническая связь: по вопросам выбора модели и оценки стоимости токенов пишите нам через официальный сайт APIYI apiyi.com, больше материалов по подключению — в центре документации docs.apiyi.com