Примечание автора: на примере Iceman — бесплатной скрытой модели без владельца в OpenCode — разберём три слоя информации: официальные заявления, параметры каталога и неподтверждённые сигналы. Дадим чек-лист из 5 пунктов для проверки перед подключением и объясним, как объединять несколько id при чтении рейтинга использования.
Бесплатно, без ограничений на количество запросов, с большим контекстным окном — но никто не знает, кто её сделал. Такие бесплатные скрытые модели в последнее время часто встречаются в инструментах разработки, и у многих разработчиков первая реакция — «сначала подключим к проекту и попробуем». В этой статье на примере Iceman в OpenCode мы ответим на конкретный вопрос: что нужно проверить, прежде чем отправлять код или бизнес-данные бесплатной модели неизвестного происхождения.
Это не статья с призывом не пользоваться такими моделями — бесплатную скрытую модель вполне можно использовать для проверки прототипов и экспериментов с публичным кодом. Главное — отделить сведения, на которые можно опираться при использовании, от слухов и понять, как условия обучения и хранения данных на практике отразятся на ваших данных.
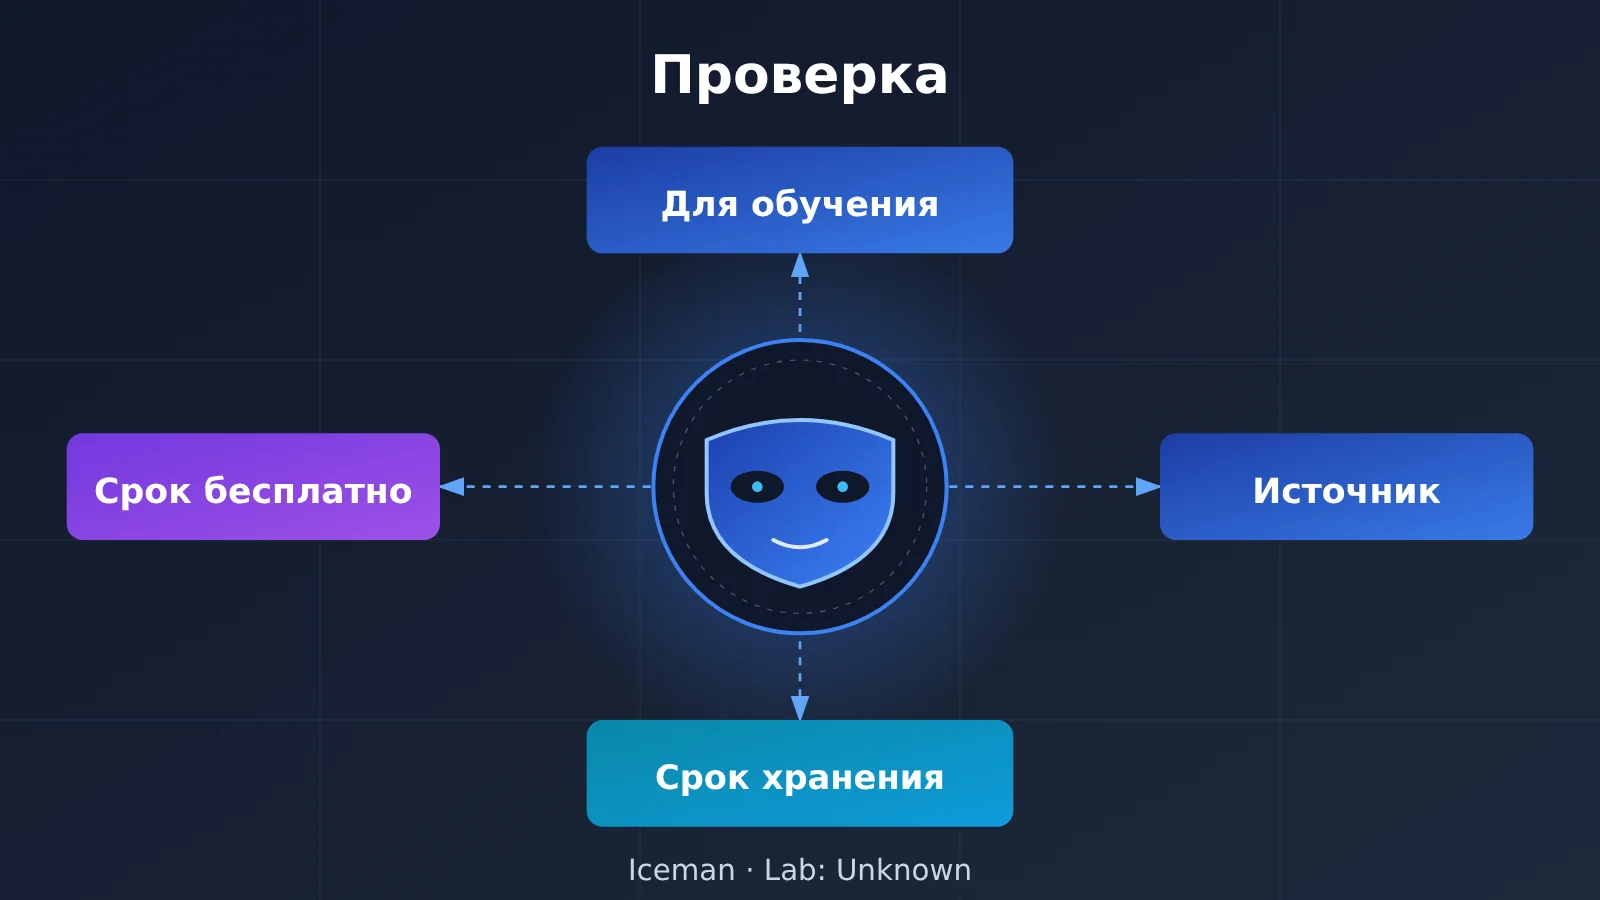
Главная ценность: дочитав статью, вы получите многоразовый чек-лист для проверки скрытых моделей по четырём аспектам: обучение на данных, нулевое хранение данных, срок бесплатного доступа и происхождение и принадлежность. А ещё научитесь распознавать ошибки интерпретации рейтингов вроде «фиктивного роста из-за смены id».
Ключевые моменты бесплатной скрытой модели Iceman
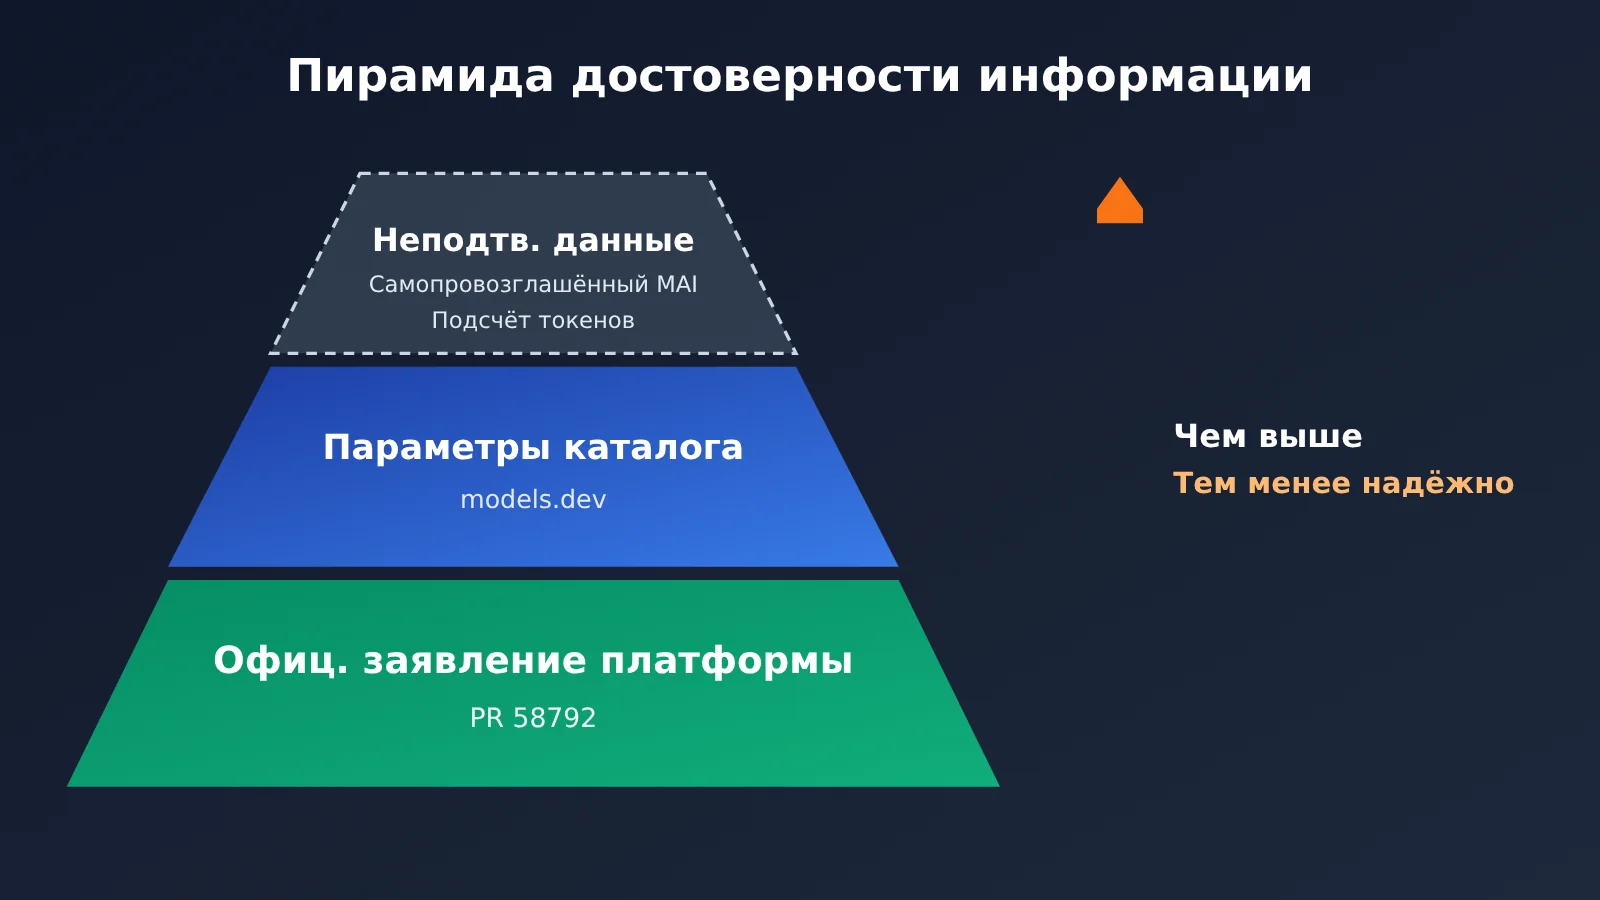
По состоянию на 2026-11-04 18:31 UTC модель Iceman по-прежнему не признана ни одной лабораторией ИИ. Согласно данным об использовании OpenCode, с 23 октября она под двумя id накопила в общей сложности около 3,37 трлн токенов. В таблице ниже информация о ней разбита на три уровня по степени достоверности — это основа для всех дальнейших выводов.
| Уровень информации | Конкретное содержание | Можно ли использовать как основание |
|---|---|---|
| Официальное заявление платформы | Объединённый PR 58792 в OpenCode: бесплатно на ограниченное время, без ограничений на запросы, промпты используются для обучения, ненулевое хранение данных | ✅ Да, это факт на уровне условий |
| Параметры каталога | Каталог models.dev: контекст 262 144, до 131 072 выходных токенов, поддержка рассуждений и вызова инструментов, текст на входе — текст на выходе | ✅ Да, для технического выбора |
| Неподтверждённые сведения | Сторонние трекеры утверждают, что она представляется как Microsoft MAI, а подсчёт токенов совпадает с MAI Thinking 1 | ❌ Нет, можно воспринимать только как слух |
Подробный разбор официальных условий скрытой модели Iceman
24 октября OpenCode добавил Iceman в пакет Go за 10 долларов в месяц — это соответствует pull request 58792 в репозитории, объединённому в 20:24 UTC. Название модели — Iceman Contributor Free, в условиях указано «бесплатно на ограниченное время, без ограничений на запросы». В том же изменении отмечены две вещи: промпты, отправленные ей, будут использоваться для обучения, а политика хранения данных не является нулевым хранением данных.
Именно эти два пункта разработчикам стоит держать в голове в первую очередь: они куда прямее, чем контекстное окно и длина вывода, определяют, какие данные можно отправлять. Кроме того, тот же PR добавил этот id в список скрытых моделей OpenCode, поэтому в колонке «лаборатория» на странице использования отображается Unknown. Иначе говоря, платформа сама прямо говорит вам: источник неизвестен.
Что на самом деле означает Contributor в названии скрытой модели
Многие понимают Contributor в iceman-contributor как название какой-то лаборатории или имя контрибьютора. На самом деле речь об одном из форматов обмена в OpenCode: данные для обучения в обмен на бесплатный доступ. У Meta Muse Spark 1.3 и 1.2 тоже есть версии Contributor — значит, это общий ярлык уровня платформы, а не подсказка об источнике модели.
Поэтому, увидев слово Contributor, правильно читать его так: «данные этого канала попадут в обучение», а не «это версия, которую предоставила какая-то лаборатория». В контрольном списке ниже этот пункт будет первым.
Влияние условий обучения бесплатной скрытой модели на код и конфиденциальные данные
«Промпты используются для обучения» звучит абстрактно, но в проекте это вполне конкретная проблема: каждый фрагмент контекста, который вы отправляете, может стать обучающим примером для чужой модели. В сценариях с инструментами программирования контекст — это часто не только ваш вопрос, но и автоматически приложенные файлы, логи ошибок, конфигурационные файлы и даже переменные окружения.
Ненулевое хранение данных означает, что содержимое запросов какое-то время остаётся на сервере. Как долго, где именно и кто его обрабатывает — при неизвестном происхождении модели проверить невозможно. Для корпоративных проектов это обычно напрямую задевает пункты о конфиденциальности в договоре или требования к соответствию данных. В таблице ниже фактические риски разложены по типам данных.
| Тип данных | Типичный источник | Риск при обучении + ненулевом хранении | Рекомендация |
|---|---|---|---|
| Открытый или публичный код | Публичные репозитории, примеры проектов | Низкий: содержимое и так открыто | Можно использовать |
| Частный бизнес-код компании | Внутренние репозитории, ключевые алгоритмы | Высокий: возможна утечка деталей реализации и архитектуры | Не рекомендуется отправлять |
| Ключи и конфигурация | .env, конфигурационные файлы, CI-скрипты |
Очень высокий: учётные данные могут сохраниться и попасть в обучение | Обязательно исключить |
| Персональные данные пользователей | Логи, выборки из баз данных, тикеты | Очень высокий: затрагивает соответствие требованиям к персональным данным | Запрещено отправлять |
| Синтетические или обезличенные данные | Тестовые фикстуры, mock-данные | От низкого до среднего: зависит от качества обезличивания | Можно использовать после обезличивания |
Отдельно стоит напомнить о проблеме «неявного контекста» в инструментах для программирования. Многие агенты автоматически читают файлы рабочей области: кажется, что вы всего лишь спросили, как написать функцию, но в запрос могут попасть вся структура каталогов и соседние файлы. Когда используете канал с обучением, самый надёжный вариант — работать в отдельной рабочей области, где есть только публичные или синтетические данные.
Как проверить бесплатную скрытую модель: чек-лист из 5 пунктов перед подключением
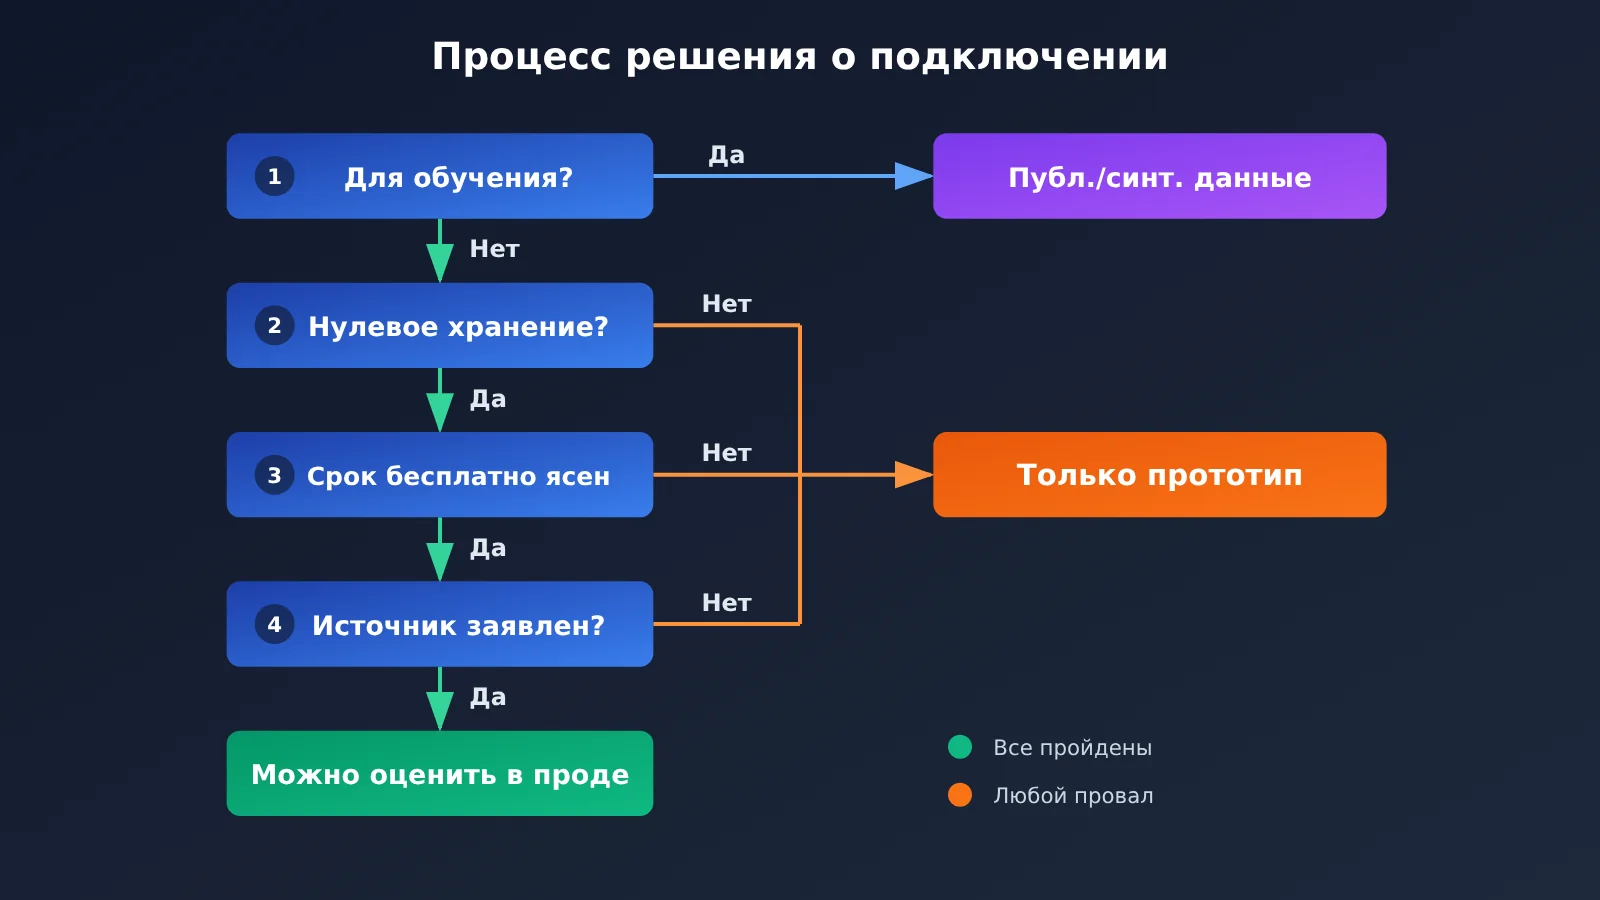
Этот чек-лист не про одну только модель Iceman — он подойдёт для любой бесплатной модели, чьё происхождение не подтверждено. Первые четыре пункта касаются условий и авторства, пятый — того, как читать данные. Лучше закрепить это как постоянный процесс ревью внутри команды.
| № | Что проверить | Где уточнить | Текущий статус Iceman |
|---|---|---|---|
| 1 | Используются ли промпты для обучения | условия платформы, история изменений конфигурации модели | Да, используются для обучения |
| 2 | Есть ли нулевое хранение данных | условия платформы, описание приватности | Нет, нулевого хранения нет |
| 3 | Как долго действует бесплатный период | анонсы платформы, описание тарифов | Указано только «ограниченное время», срок неизвестен |
| 4 | Подтверждено ли происхождение | официальное заявление лаборатории | Не подтверждено, лаборатория указана как Unknown |
| 5 | Разделены ли данные об использовании по id | все связанные id в рейтинге использования | Да, разделены на iceman и iceman-contributor |
Происхождение скрытой модели: почему зацепка — ещё не подтверждение
Что касается происхождения Iceman, сайт-трекер stealthmodels.com сообщает: аккаунт X @aitrackerbot обнаружил, что Iceman представляется как MAI от Microsoft, а способ подсчёта prompt-токенов полностью совпадает с MAI Thinking 1. Но собственные тесты сайта показали, что он совпадает и с MAI Thinking 1, и с серией GPT-6 от OpenAI. То есть подсчёт токенов не позволяет отличить эти модели друг от друга.
То, кем модель «представляется», тоже ненадёжный признак: модель может повторять сведения о личности из обучающих данных, а может быть намеренно задана системным промптом. На данный момент Microsoft не сделала никаких заявлений. Поэтому эту информацию правильно считать «зацепкой», а не фактом для вашего документа по выбору технологий.
Как раньше раскрывали авторство скрытых моделей
Судя по прошлым скрытым моделям OpenCode, авторство обычно раскрывают при релизе или в течение нескольких недель. ox-alpha признали как GLM-5.3 Flash от Z.ai, cat-jam — как Beam от Reflection AI, а Space Bunny — как M3.1 Flash от MiniMax через 26 дней после первого появления. По состоянию на 4 ноября Iceman доступна уже 11 дней, но авторство всё ещё никто не подтвердил.
Ценность прецедентов в том, что они задают ожидания, а не предсказывают будущее. Они говорят: подтверждения авторства, возможно, придётся ждать несколько недель. Всё это время размер модели, её происхождение и длительность бесплатного периода остаются неизвестными — и ваш план не должен на них опираться.
Быстрый старт со скрытой бесплатной моделью: читаем рейтинг использования, объединив несколько id
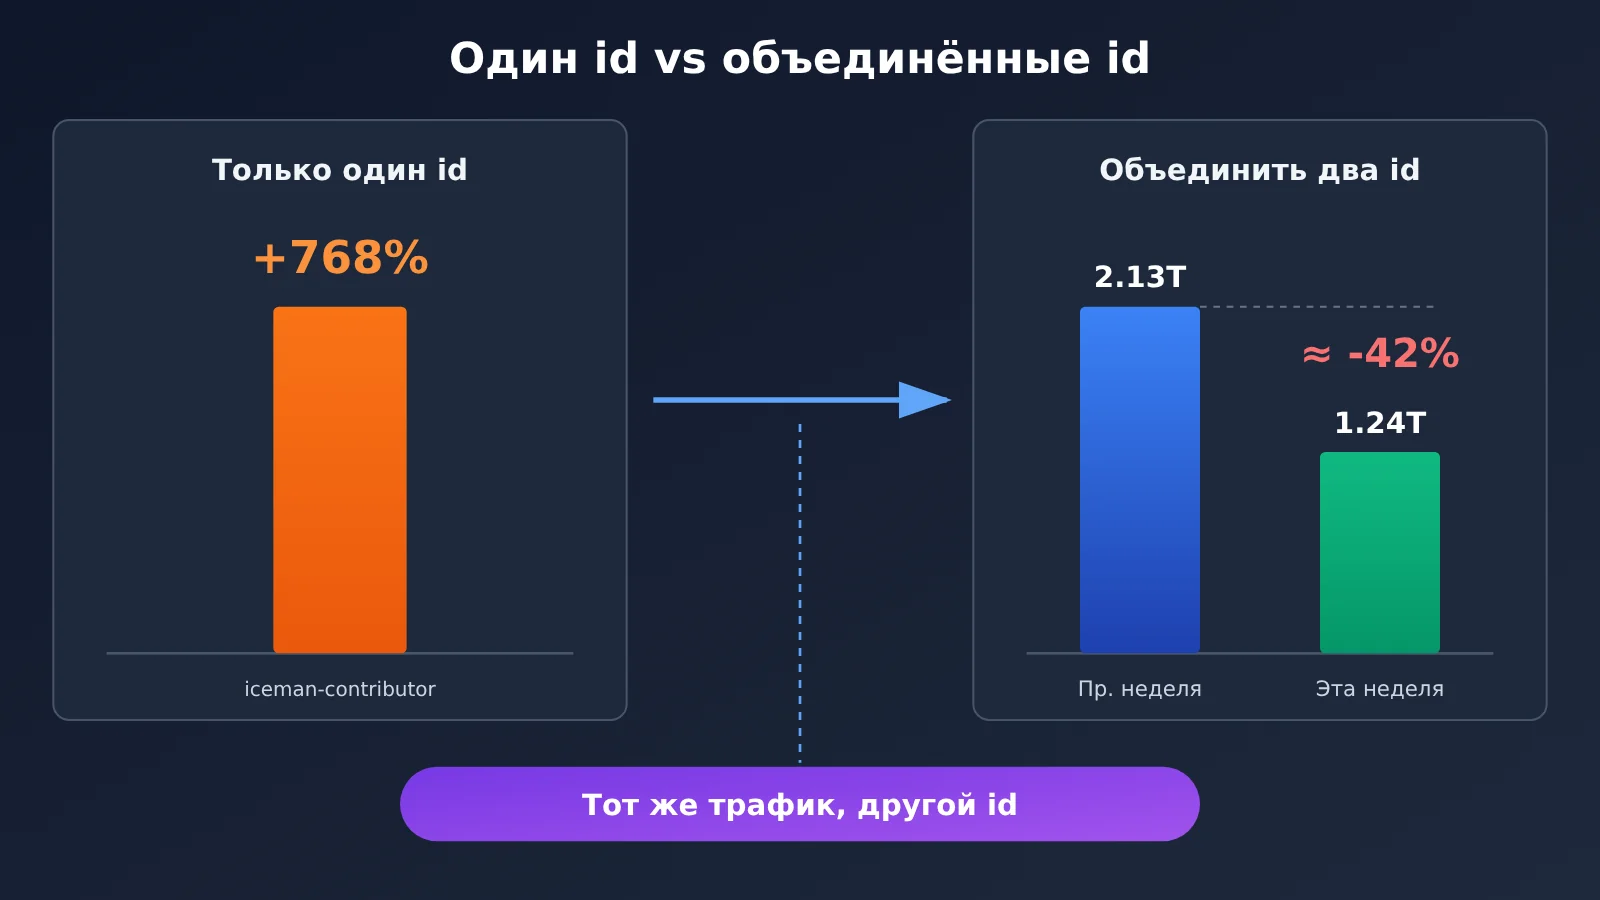
Показатели Iceman в недельном рейтинге OpenCode — классический пример того, как легко неправильно прочитать榜单. Если смотреть только на один id, напрашивается вывод о «взрывном росте». А если объединить два id, вывод получается ровно противоположным.
| id | Место в недельном рейтинге | Tokens за неделю | Изменение к прошлой неделе |
|---|---|---|---|
| iceman-contributor | #12 | 670B | +768% |
| iceman | #16 | 567B | -72% |
| Итого | — | около 1.24T | около -42% (на прошлой неделе около 2.13T) |
+768% — это не рост, а переток трафика одной и той же модели с одного id на другой. В сумме два id за последние 7 дней прогнали около 1.24 трлн tokens, что примерно на 42% меньше, чем около 2.13 трлн неделей ранее. Суточное потребление достигло пика 28 октября — около 653 млрд tokens, а с 29 октября по 3 ноября держалось в диапазоне от 162 до 251 млрд в день.
Минимальный пример: объединение id и расчёт реального изменения к предыдущей неделе
Этот код на Python демонстрирует логику объединения; данные взяты из публичных цифр выше. Значения по каждому id за прошлую неделю восстановлены из значений текущей недели и изменения к предыдущей, поэтому они приблизительные.
# Несколько id одной модели: токены за текущую неделю (в миллиардах) и изменение к предыдущей неделе
ids = {
    "iceman-contributor": {"this_week": 670, "change": 7.68},   # +768%
    "iceman":             {"this_week": 567, "change": -0.72},  # -72%
}

this_total = sum(v["this_week"] for v in ids.values())
# Восстанавливаем значение прошлой недели из изменения: last = this / (1 + change)
last_total = sum(v["this_week"] / (1 + v["change"]) for v in ids.values())

print(f"本周合计:{this_total}B")
print(f"上周合计(反推):{last_total:.0f}B")
print(f"合并后环比:{(this_total / last_total - 1):.1%}")
После запуска получим примерно 1 237B за текущую неделю, около 2 100B за прошлую неделю и объединённое изменение примерно от -41% до -42%, что в целом совпадает с суммарными данными из отчёта. При обратном расчёте есть погрешность округления, поэтому в реальном анализе лучше считывать исходные недельные данные по каждому id напрямую.
Полная реализация: шлюз стратегии моделей перед подключением
Код ниже превращает чек-лист в простой «шлюз стратегии». Он не вызывает API какой-либо конкретной платформы, а только по метаданным, которые вы заполняете после ручной проверки, решает, можно ли отправлять данные определённого типа в ту или иную модель. Его можно поставить перед своим слоем маршрутизации запросов.
from dataclasses import dataclass
from typing import Optional

@dataclass
class ModelPolicy:
    model_id: str
    used_for_training: bool          # пункт проверки 1
    zero_data_retention: bool        # пункт проверки 2
    free_until: Optional[str]        # пункт проверки 3, None означает, что срок неизвестен
    lab_confirmed: bool              # пункт проверки 4
    related_ids: tuple = ()          # пункт проверки 5, для объединённой статистики

# Уровень чувствительности данных: 0 — публичные, 1 — обезличенные/синтетические, 2 — приватный код, 3 — ключи или приватные данные
SENSITIVITY = {"public": 0, "synthetic": 1, "private_code": 2, "secret_or_pii": 3}

def max_allowed_level(p: ModelPolicy) -> int:
    """Возвращает максимально допустимый уровень чувствительности для отправки, исходя из условий модели"""
    if p.used_for_training or not p.zero_data_retention:
        return 1          # обучение или ненулевое хранение: допускаются только публичные и синтетические данные
    if not p.lab_confirmed:
        return 1          # источник не подтверждён: тоже только низкочувствительные данные
    return 2              # приватный код рассматриваем только после подтверждения условий и принадлежности модели

def can_send(p: ModelPolicy, data_kind: str) -> bool:
    level = SENSITIVITY[data_kind]
    if level >= 3:
        return False      # ключи и приватные данные никогда не отправляем во внешние бесплатные каналы
    return level <= max_allowed_level(p)

def production_ready(p: ModelPolicy) -> list:
    """Возвращает список проблем, блокирующих вывод в продакшен; пустой список означает, что можно переходить к оценке"""
    issues = []
    if p.used_for_training:
        issues.append("提示词用于训练")
    if not p.zero_data_retention:
        issues.append("非零数据保留")
    if p.free_until is None:
        issues.append("免费期限未知,存在突然收费或下线风险")
    if not p.lab_confirmed:
        issues.append("来源未认领,无法评估模型规模与长期可用性")
    return issues

iceman = ModelPolicy(
    model_id="iceman-contributor",
    used_for_training=True,
    zero_data_retention=False,
    free_until=None,
    lab_confirmed=False,
    related_ids=("iceman", "iceman-contributor"),
)

for kind in SENSITIVITY:
    print(f"{kind:15s} -> {'允许' if can_send(iceman, kind) else '拒绝'}")

print("生产接入阻碍:", production_ready(iceman))
Совет на практике: держите метаданные из примера выше как общий конфиг команды и обновляйте их каждый раз, когда меняются условия платформы или статус подтверждения модели. Тогда новый коллега, подключая любую бесплатную модель, сможет сразу воспользоваться теми же критериями оценки, а не решать на глазок.
Часто задаваемые вопросы (FAQ)
В1: Что такое бесплатная stealth-модель?
Stealth-модель (stealth model) — это модель, которая появляется на платформе под кодовым именем, а лаборатория-разработчик пока не раскрыта. На странице использования платформы её источник обычно отображается как Unknown. Iceman — как раз одна из таких моделей в списке stealth-моделей OpenCode; по состоянию на 2026-11-04 её так никто и не признал своей.
В2: Чем Iceman отличается от iceman-contributor?
Судя по публичным данным, это два id, под которыми рейтинг использования OpenCode отслеживает одну и ту же модель: в недельном списке один взлетает, другой падает, а на деле трафик просто перетекает между двумя id. Слово Contributor отсылает к платформенной схеме обмена «доступ в обмен на данные для обучения», а не к названию какой-то лаборатории.
В3: Сколько продлится бесплатный период Iceman?
Публичного ответа пока нет. В изменениях OpenCode написано только «ограниченное время бесплатно, без ограничений на запросы», без даты окончания. Размер модели, разработчик и срок бесплатного доступа сейчас неизвестны, поэтому не стоит рассчитывать на её бесплатность в продакшене.
В4: Для каких сценариев бесплатные stealth-модели подходят лучше всего?
При условии, что в условиях явно указано «используется для обучения, ненулевое хранение», подходящие сценарии такие:
— **Эксперименты в open-source проектах**: работа с кодом, который и так открыт — например, примеры или тесты для открытой библиотеки.
— **Оценка возможностей**: проверка рассуждений и вызова инструментов на синтетических задачах, чтобы понять поведение на большом контексте.
— **Личные учебные прототипы**: демо без реальных данных, чтобы проверить, работает ли сценарий взаимодействия.
В5: Как внедрить в команде этот чек-лист проверки stealth-моделей?
Советую разбить на три шага: сначала вписать 5 проверок в документ о допуске моделей, затем — как в «шлюзе политик» выше — отсекать на уровне маршрутизации по уровню чувствительности данных, и наконец выделить отдельное рабочее пространство для инструментов программирования, чтобы агент автоматически не подхватывал приватные файлы. При изменении условий достаточно обновить метаданные.
В6: Можно ли верить модели, которая называет себя продуктом такой-то компании?
Напрямую верить нельзя. Самоописание модели может тянуться из обучающего корпуса или системного промпта, а способ подсчёта токенов может полностью совпадать у нескольких моделей. Например, сторонние тесты Iceman показали, что его подсчёт так же совпадает с MAI Thinking 1 и серией GPT-6, так что различить их по этому признаку невозможно. Принадлежность определяется только официальным заявлением лаборатории.
В7: Что будет с данными, отправленными раньше, если stealth-модель признают?
Заявка на принадлежность меняет только информацию об источнике, но не условия, которые действуют при отправке данных. Если на тот момент в условиях было указано, что данные используются для обучения и срок хранения не нулевой, то порядок обработки этих данных уже зафиксирован. Именно поэтому проверку нужно провести до отправки, а не после заявки.
Ключевые выводы о бесплатных stealth-моделях
- Сначала условия, потом параметры: назначение для обучения и хранение данных определяют, что можно отправлять; длина контекста — только сколько можно отправить.
- Contributor — это схема обмена: бесплатный доступ в обмен на данные для обучения, а не указание на происхождение модели.
- Косвенные признаки — не подтверждение: самоназвание модели и подсчёт токенов не доказывают принадлежность.
- Срок бесплатного доступа считайте неизвестным: у «ограниченного времени» нет даты окончания, поэтому не закладывайте его в планы.
- В рейтинге смотрите на объединённые id: у Iceman +768% после объединения на самом деле превращаются примерно в -42%.
- Конфиденциальные данные — только изолированно: ключи, приватные данные и приватный ключевой код не отправляйте в каналы для обучения.
Итог
Можно ли подключить бесплатную скрытую модель к проекту — зависит от того, какие данные вы собираетесь отправлять, а не от того, бесплатна она или нет. На примере Iceman опираться можно на условия платформы и параметры из каталога: использование данных для обучения, ненулевое хранение данных, бесплатный доступ на ограниченное время, контекст 262 144, поддержка рассуждений и вызова инструментов. А вот на разные намёки о разработчике опираться нельзя — до официального подтверждения это всего лишь слухи.
Методику, которую можно переиспользовать, стоит свести к трём пунктам:
- Смотрите на информацию послойно: отделяйте заявления платформы, параметры каталога и неподтверждённые сведения — решения принимайте только по первым двум слоям.
- Используйте по уровням данных: каналы с обучением на данных — только для публичных или синтетических данных, приватный код и персональные данные обрабатывайте отдельно.
- Читайте рейтинги с объединёнными метриками: несколько id одной и той же модели нужно сначала сложить, а потом считать темп роста — иначе смена id создаст иллюзию бурного роста.
Кто бы ни взял на себя авторство Iceman позже, этот способ проверки можно ещё долго применять к следующей появившейся скрытой модели.
📚 Справочные материалы
- ArtificialWatch — анализ использования и атрибуции Iceman: основной источник фактов для этой статьи.
- Ссылка:
artificialwatch.com/wire/iceman-opencode-stealth-model-3-trillion-tokens-unclaimed -
Пояснение: собраны данные об использовании двух id Iceman, изменениях в условиях и clues об атрибуции; опубликовано 2026-11-04.
-
Страница использования OpenCode Data: данные об использовании iceman и iceman-contributor.
- Ссылка:
opencode.ai/data -
Пояснение: здесь можно напрямую посмотреть место каждого id в недельном рейтинге и расход токенов.
-
Каталог моделей models.dev: технические параметры Iceman.
- Ссылка:
models.dev -
Пояснение: содержит информацию о контекстном окне, максимальном выводе, reasoning и вызове инструментов.
-
Отслеживание скрытых моделей на stealthmodels.com: источник сообщений о следах атрибуции.
- Ссылка:
stealthmodels.com - Пояснение: там записаны тесты, касающиеся заявленной самим Iceman идентичности и подсчёта токенов; используйте их только как ориентир.
Автор: техническая команда APIYI
Примечание: факты в статье актуальны на 2026-11-04. Статус заявки Iceman и срок бесплатного доступа могут измениться в любой момент — ориентируйтесь на актуальные условия платформы.