Nota del autor: partiendo de la estructura de costos de los servicios de inferencia, explicamos por qué los servicios de tokens tienden a perder dinero y ofrecemos una lista práctica para evaluar proveedores de API de modelos.
Los tokens ya se venden en transmisiones en vivo, pero el desempeño financiero de proveedores de inferencia como SiliconFlow sigue sin ser bueno. En otra noticia, una empresa consideraba que Claude era demasiado caro y se pasó a GLM: con 56 GPU B200 para atender a 2000 ingenieros, sus costos de IA cayeron alrededor de un 90%. Si miramos ambos casos en conjunto, la estructura de costos de los servicios de tokens tiene sus propias reglas. Este artículo parte de la estructura de costos de los servicios de inferencia para explicar por qué los servicios de tokens pierden dinero y, después, aterrizar en lo que de verdad le importa al desarrollador: cómo evaluar si un proveedor de API de modelos es confiable.
No es otro artículo de chismes del sector. El desglose gira en torno a variables técnicas: depreciación de GPU, utilización, la diferencia de costo entre Prefill y Decode, KV Cache, tasa de aciertos de caché y estrategias de subvención. Al terminar, podrás aplicarlo directamente en la evaluación para elegir proveedor.
Valor clave: al terminar este artículo, entenderás la composición de costos detrás del precio de los tokens y dominarás un método de evaluación de proveedores en 6 dimensiones. También sabrás cómo usar datos reales de invocación para comprobar si la facturación es transparente.
Por qué el servicio de tokens pierde dinero: puntos clave de la estructura de costos de inferencia
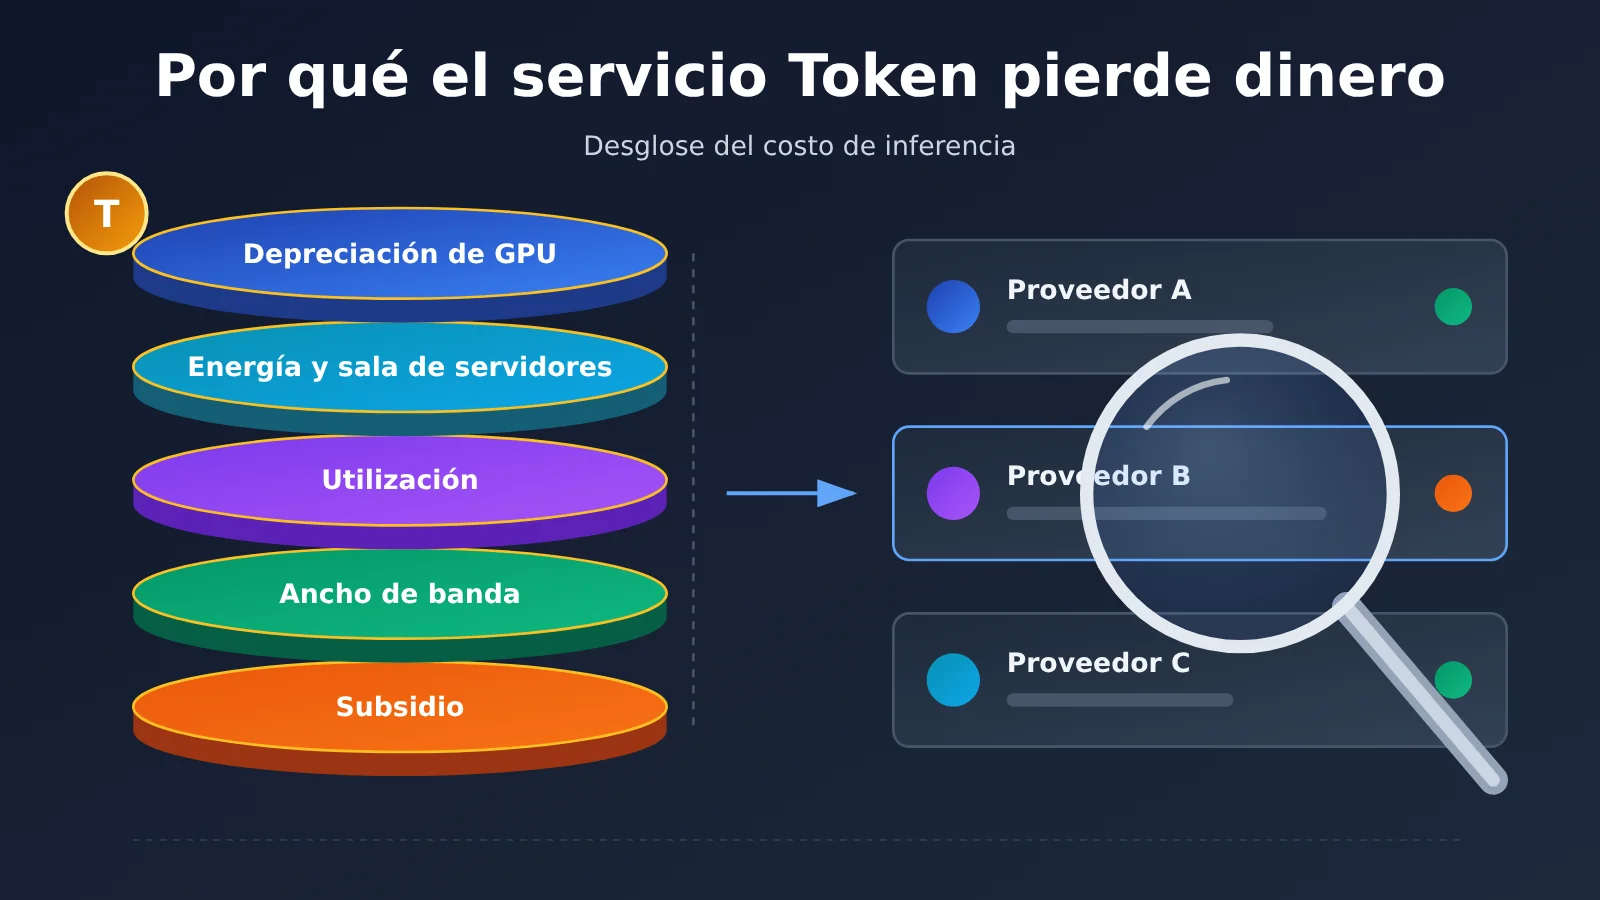
Primero, la conclusión. La mayor parte del costo del servicio de inferencia es fijo, mientras que los ingresos se cobran por cantidad de tokens, y ambos se conectan mediante la “utilización”. Si la utilización no sube, o si la competencia empuja el precio hasta cerca del costo marginal, las cuentas terminan en pérdidas.
| Elemento de costo | Descripción | Impacto en el precio unitario del token |
|---|---|---|
| CAPEX y depreciación de GPU | Costo de compra o alquiler a largo plazo de GPU de gama alta, amortizado por años | Costo fijo; cuanto menor la utilización, mayor el costo asignado por token |
| Centro de datos, electricidad y red | Alojamiento, refrigeración, ancho de banda y recuperación ante desastres entre regiones | Costo semifijo; solo se diluye al alcanzar escala |
| Utilización de GPU | Proporción del tiempo en que realmente se ejecuta la inferencia y saturación del procesamiento por lotes | La palanca clave de la rentabilidad; la diferencia entre picos y valles se come directamente el margen |
| Estructura Prefill / Decode | La entrada se procesa en paralelo; la salida se genera token a token | Los tokens de salida son más caros; los escenarios de salida larga generan más presión |
| Contexto largo y KV Cache | La VRAM queda ocupada por la caché, lo que reduce la capacidad de concurrencia | Las solicitudes con contexto largo reducen el número de usuarios que se pueden atender |
| Subsidios y adquisición de clientes | Cuotas gratuitas, captación con precios bajos y comisiones para canales | Atrae volumen a corto plazo, pero reduce el margen bruto a largo plazo |
Detalle de los puntos clave de la estructura de costos del servicio de tokens
El desajuste entre costos fijos e ingresos por consumo es la primera causa. Un servidor de GPU completamente equipado genera depreciación, factura eléctrica y costos de centro de datos tanto si recibe solicitudes como si no. Sin embargo, los usuarios solo pagan por los tokens que realmente consumen. En las horas pico del día hay que reservar suficiente capacidad de cómputo para garantizar la latencia; en los valles nocturnos, esa capacidad queda ociosa. El costo de los periodos de inactividad acaba repercutiendo en los tokens que se venden en las horas pico. Si el precio se fija tomando como referencia únicamente el “costo teórico a plena carga”, la operación real casi con seguridad perderá dinero.
La competencia de precios empuja el precio unitario hacia el costo marginal es la segunda causa. Los pesos de los modelos de código abierto están al alcance de cualquiera, y varios proveedores de inferencia despliegan el mismo modelo, así que el espacio de diferenciación es muy pequeño y el precio se convierte naturalmente en el principal medio de competencia. Que se promocionen tokens en transmisiones en vivo demuestra que este tipo de producto ya se acerca a un “commodity estandarizado”. En esta situación, a los proveedores les cuesta cubrir los costos fijos cobrando un sobreprecio y solo pueden competir por escala y eficiencia en la asignación de recursos.
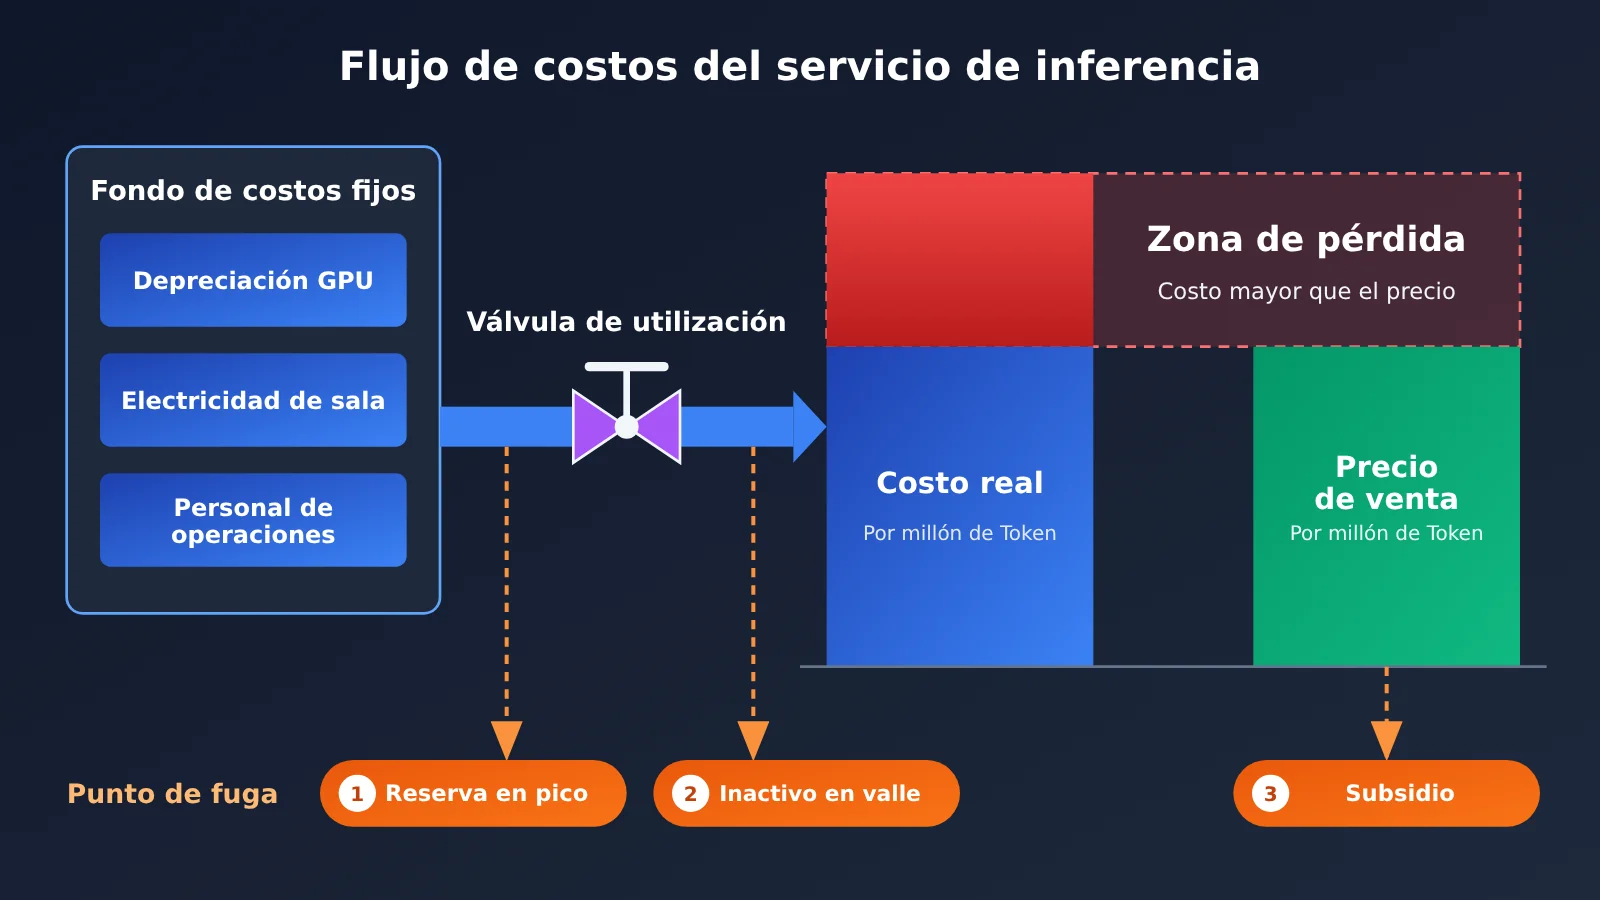
Desglose de costos de los servicios de inferencia: cómo se calcula el precio unitario por token
Para entender por qué un servicio de tokens puede perder dinero, hay que dividir una solicitud de inferencia en dos fases. Cada fase consume recursos distintos, así que la base de facturación también cambia. Esa es precisamente la razón por la que muchos proveedores fijan precios por separado para entrada, salida y caché.
Prefill y Decode: por qué los tokens de salida son más caros
Una solicitud pasa primero por la fase de Prefill. El modelo procesa en paralelo todos los tokens de entrada: es intensivo en cómputo, pero eficiente, y la capacidad de cómputo de la GPU se aprovecha al máximo. Después entra en la fase de Decode, donde el modelo genera solo un token a la vez y debe leer repetidamente la KV Cache anterior. Esta fase está más limitada por el ancho de banda de la VRAM, así que es difícil saturar la capacidad de cómputo de la GPU.
Por eso, para una misma cantidad de tokens, el costo unitario de salida suele ser claramente superior al de entrada. En los proveedores principales, el precio unitario de salida también suele ser mayor que el de entrada. Si el negocio se basa en salidas largas, como generación de código, redacción de textos largos o inferencia multironda de agentes, el costo se concentra en el lado de salida. Al evaluar un proveedor, prioriza el precio unitario de salida y el throughput de salida.
KV Cache y contexto largo: el impuesto invisible sobre la VRAM
El costo de una solicitud con contexto largo no se limita a “más entrada”. La KV Cache ocupa más VRAM a medida que crece la longitud del contexto, y el número de solicitudes que una GPU puede atender a la vez disminuye. En otras palabras, un usuario con contexto ultra largo puede ocupar el cupo de concurrencia de varios usuarios normales. Es posible que este costo no se refleje por completo en el precio unitario, y el proveedor solo pueda equilibrarlo mediante precios por tramos, limitación de tasa o límites de longitud de contexto.
Aciertos de caché: una herramienta para reducir costos y también una trampa de precios
La caché de indicaciones (Prompt Caching) permite que los prefijos repetidos no se vuelvan a calcular, y la parte que acierta se factura al precio más bajo de lectura de caché. En negocios como agentes y RAG, donde la indicación de sistema es larga y repetitiva, la tasa de aciertos de caché influye de forma notable en la factura final. Ten en cuenta que cada proveedor factura de forma distinta la escritura de caché, la lectura de caché y la vigencia de la caché; algunos incluso requieren activarla explícitamente. Al evaluar, asegúrate de comprobar si el campo usage devuelto incluye estadísticas de tokens relacionadas con la caché.
| Criterio de facturación | Característica del consumo de recursos | Punto a confirmar al evaluar |
|---|---|---|
| tokens de entrada | Cómputo paralelo en Prefill, mayor eficiencia | Si el precio se divide por tramos según la longitud del contexto |
| tokens de salida | Decode genera uno a uno, limitado por el ancho de banda de la memoria | Precio unitario de salida, throughput de salida (tokens/s) |
| escritura de caché | Primera escritura en caché; algunas plataformas la facturan por separado | Si la escritura tiene recargo y cuánto dura la vigencia |
| lectura de caché | Acierta el prefijo y evita el recálculo repetido | Descuento en la parte acertada y si se muestra en usage |
| tokens de pensamiento de razonamiento | Proceso de pensamiento interno de los modelos de razonamiento | Si se cuentan como salida y si se puede limitar el presupuesto |
💰 Nota sobre los criterios de precio: la tabla anterior solo describe las dimensiones de facturación, no precios concretos. Para los precios unitarios de entrada y salida, y los precios de lectura y escritura de caché de los modelos mencionados en este artículo, consulta los datos reales de la página de precios de APIYI:
https://docs.apiyi.com/models. Los criterios de facturación pueden variar según el modelo y el grupo; revisa cada punto antes de contratar.
Inferencia autoalojada vs. llamada a API: cómo calcular el costo por Token
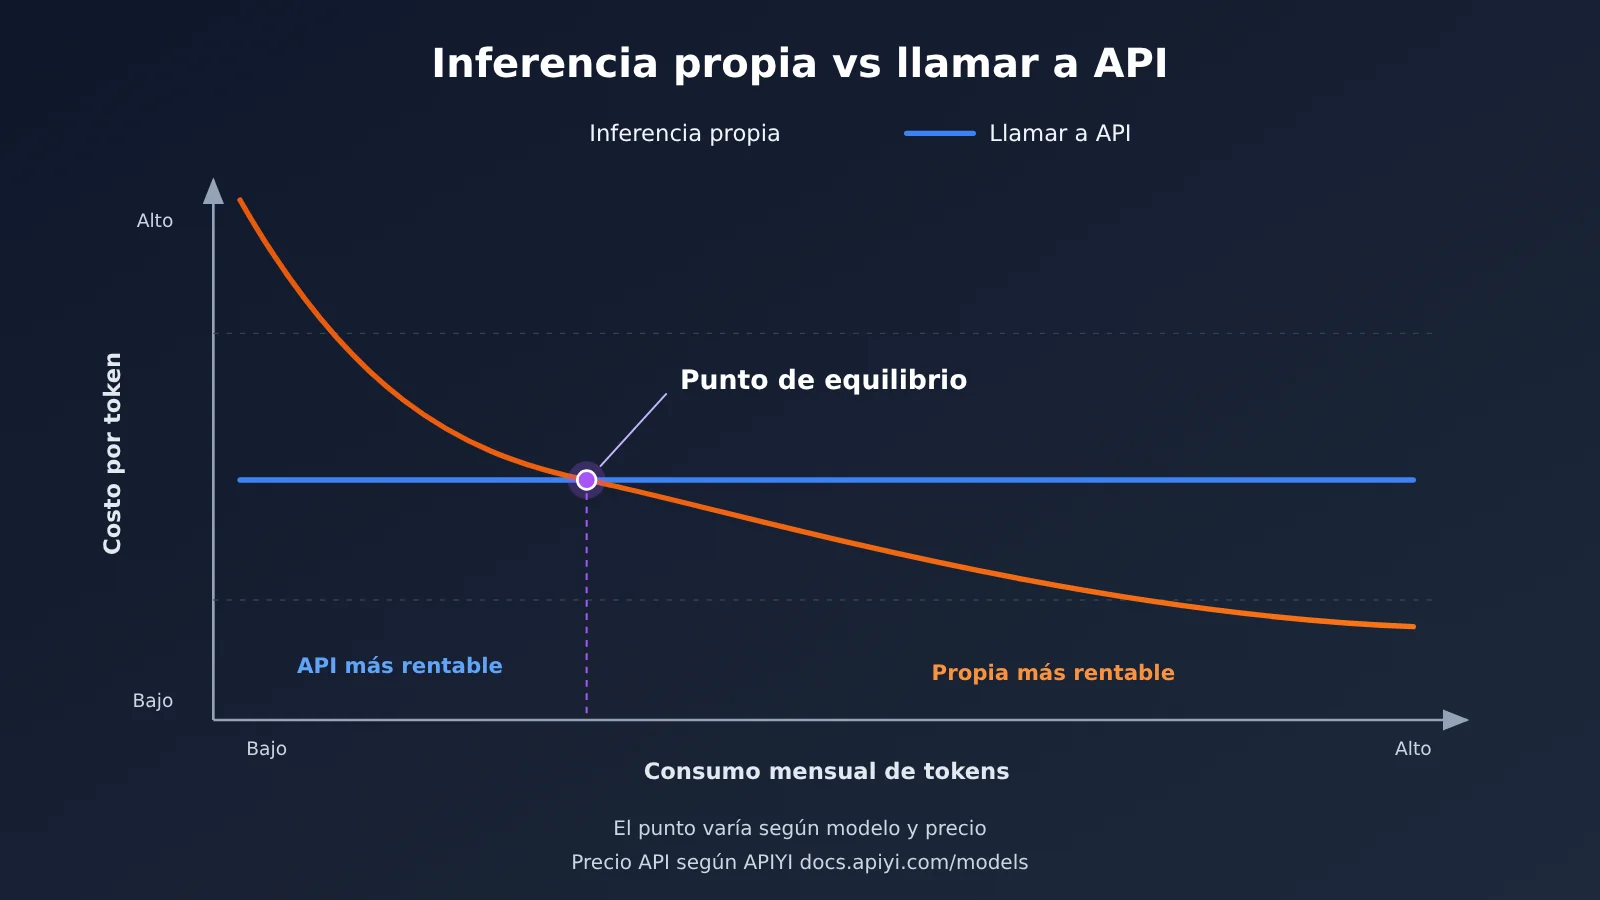
«56 tarjetas B200 atienden a 2000 ingenieros y reducen el costo alrededor de un 90%»: este caso se sostiene sobre varias premisas. La carga de esta empresa proviene de sus ingenieros internos, con un volumen de solicitudes alto y relativamente estable. Se concentra en horario laboral y es muy predecible. El modelo se cambió a GLM, de código abierto y autodesplegable. Estos tres puntos permiten diluir lo suficiente los costos fijos y justo evitan el problema de utilización que más preocupa a los proveedores públicos de inferencia.
A la inversa, este caso no implica que todos los equipos deban autoalojar. Si el volumen de solicitudes es bajo y muy variable, o si se necesita cambiar con frecuencia entre varios modelos de código cerrado, el costo de mantener ociosos los clústeres de GPU propios superará rápidamente la factura de API. El valor de un proveedor público de inferencia consiste precisamente en usar la carga de muchos clientes para «recortar picos y rellenar valles» entre sí y obtener así una utilización global más alta.
| Opción | Estructura de costos | Escenario de uso | Riesgos principales |
|---|---|---|---|
| Clúster de GPU autoalojado | Costos fijos altos, costos marginales bajos | Equipos grandes con uso elevado, carga estable y modelo fijo | Desperdicio por inactividad, personal de operaciones y depreciación por renovación de hardware |
| API oficial de un único modelo | Pago puro por uso | Negocios fuertemente dependientes de un modelo de código cerrado | Precio único, alto costo de cambio y disponibilidad regional limitada |
| Plataforma agregadora de API multimodelo | Pago por uso, interfaz unificada | Necesidad de comparar, cambiar y combinar varios modelos | Hay que verificar la transparencia y la estabilidad de la facturación |
| Arquitectura híbrida | Autoalojamiento para tareas de alta frecuencia, API para tareas de cola larga | Escala de negocio mediana-grande y estratificación clara de modelos | Mayor complejidad arquitectónica |
Análisis comparativo de la opción autoalojada: el autoalojamiento tiene ventaja en el límite inferior del costo unitario, pero requiere una utilización suficientemente alta y un equipo capaz de encargarse del despliegue, la cuantización, el escalado y la recuperación ante fallos. En comparación, el costo unitario de la opción API es más predecible y encaja mejor con equipos de carga muy variable que necesitan validar varios modelos en paralelo.
Análisis comparativo de las plataformas agregadoras: la API oficial tiene ventaja en la velocidad de lanzamiento de modelos, pero en la mayoría de los casos una cuenta solo cubre los modelos de un proveedor. La ventaja de una plataforma agregadora multimodelo es que una sola interfaz conecta con varios modelos, lo que facilita las comparaciones A/B y la estratificación de costos. Plataformas como APIYI apiyi.com son compatibles tanto con el formato de API de OpenAI como con el de Anthropic, así que se puede cambiar de modelo con muy pocos cambios en el código existente.
Cómo evaluar a un proveedor de API de modelos: lista rápida de 6 dimensiones
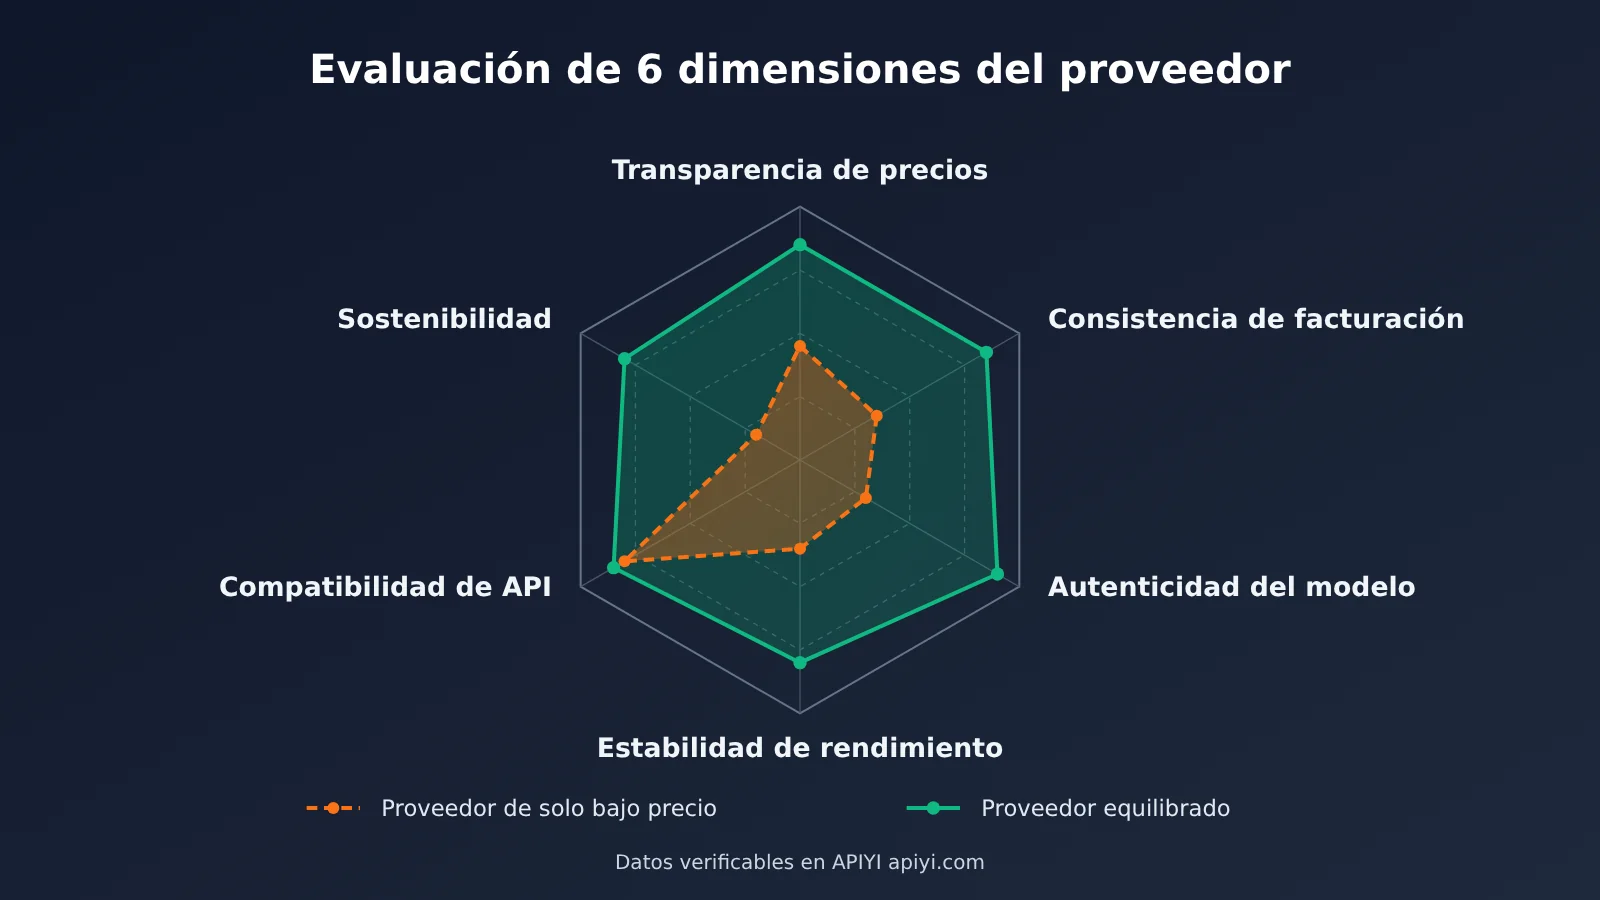
Una vez que entiendes la estructura de costos, puedes sacar una conclusión: un precio por debajo del costo a largo plazo no es sostenible. El proveedor o recorta en algún punto, o se sostiene durante un tiempo con subsidios. Al evaluar a un proveedor, no hay que fijarse solo en el precio de lista; conviene revisar estas 6 dimensiones en conjunto.
| Dimensión | Pregunta clave | Método de verificación |
|---|---|---|
| 1. Transparencia de precios | ¿Se publican por separado los precios de entrada, salida y caché? | Revisar la página de precios y registrar cada criterio de cálculo |
| 2. Consistencia de facturación | ¿El cobro real coincide con usage? |
Hacer llamadas de prueba en pequeño volumen y revisar el detalle de la factura |
| 3. Autenticidad del modelo | ¿Hay degradación, mezcla de modelos o cuantización excesiva? | Comparar la calidad de salida con un conjunto de pruebas fijo |
| 4. Estabilidad de rendimiento | ¿Cómo están la latencia del primer token, el throughput y la tasa de errores? | Medir una ronda en hora punta y otra en hora valle |
| 5. Compatibilidad de interfaz | ¿Es compatible con los formatos de OpenAI / Anthropic? | Probar con el SDK actual cambiando solo base_url |
| 6. Sostenibilidad | ¿El precio está claramente por debajo del rango de costo razonable? | Evaluar el riesgo de subsidio según la estructura de costos |
Paso 1: Conectar mediante una interfaz compatible y hacer una llamada mínima
Se puede explicar el flujo de pruebas sin escribir código. Si tu proyecto ya usa el SDK de OpenAI, normalmente solo hay que cambiar dos ajustes: sustituir api_key por la clave que proporciona el proveedor y cambiar base_url por la dirección de la interfaz del proveedor. Tomemos APIYI como ejemplo: la base_url en formato compatible con OpenAI es https://api.apiyi.com/v1, las solicitudes de chat van por la ruta /v1/chat/completions y basta con poner el nombre del modelo objetivo en el campo model.
Si el proyecto se basa en el SDK de Anthropic, por ejemplo, con modelos de la serie Claude o herramientas tipo Claude Code, también puedes sustituir la dirección de la interfaz y usar el formato nativo de Anthropic a través de la ruta /v1/messages. Para la dirección concreta y los nombres de los modelos, toma como referencia la documentación de APIYI: https://docs.apiyi.com. Para la llamada mínima, conviene activar también la salida en streaming con stream, para poder medir después la latencia del primer token.
Paso 2: Revisar el criterio de facturación y el campo usage
En la respuesta de cada llamada, el formato OpenAI devuelve usage.prompt_tokens y usage.completion_tokens; algunos modelos también incluyen cached_tokens cuando hay aciertos de caché. En el formato Anthropic, los campos correspondientes son input_tokens, output_tokens y los campos de lectura y escritura de caché. Puedes estimar el coste de una llamada con una fórmula sencilla: cantidad de tokens de entrada por el precio unitario de entrada, más cantidad de tokens de salida por el precio unitario de salida, más cantidad de tokens de lectura y escritura de caché por el precio unitario de caché correspondiente.
Compara el valor estimado con el detalle de facturación de la plataforma; la desviación debería poder explicarse. Si durante mucho tiempo ves que “la factura es mayor que lo calculado a partir de usage”, o que los aciertos de caché nunca aparecen en la facturación, conviene estar alerta. Para los precios unitarios usados en la estimación, toma como referencia los datos publicados en la página de precios de APIYI: https://docs.apiyi.com/models.
Tercer paso: medir rendimiento, calidad y horas pico
Para las pruebas de rendimiento conviene registrar tres métricas: latencia hasta el primer token (TTFT), throughput de salida (tokens por segundo) y tasa de error (timeouts, límites de tasa 429 y errores 5xx). Haz una ronda en hora pico de un día laborable y otra en el valle nocturno; cuanto menor sea la variación, mejor será la planificación de capacidad del proveedor. Para las pruebas de calidad, usa un conjunto fijo de indicaciones que cubra código, razonamiento y textos largos, y compara de forma cruzada con las salidas del canal oficial o de otras plataformas; esto ayuda a detectar si el modelo fue degradado o sustituido.
| Prueba | Parámetro / campo clave | Referencia aceptable |
|---|---|---|
| Latencia del primer token | Activar stream y registrar el tiempo del primer chunk |
La diferencia entre pico y valle no es excesiva |
| Throughput de salida | completion_tokens ÷ tiempo de generación |
Similar al de otros canales del mismo modelo |
| Verificación de facturación | Cada campo de usage × el precio unitario de la página de precios |
La desviación frente al desglose de facturación se puede explicar |
| Aciertos de caché | cached_tokens o el campo de lectura de caché |
Las solicitudes repetidas con prefijos largos registran aciertos |
| Estabilidad | número de 429 / 5xx / timeouts | Tasa de error baja y con explicación de reintentos |
🚀 Inicio rápido: Si quieres comparar el costo y el rendimiento de varios modelos bajo la misma interfaz, primero regístrate en APIYI apiyi.com y obtén cuota de prueba. La plataforma ofrece invocaciones de API para los principales modelos tratados en este artículo, es compatible con los formatos de interfaz de OpenAI y Anthropic, y basta con cambiar
base_urlporhttps://api.apiyi.com/v1para empezar a validar. Los precios de cada modelo se consultan enhttps://docs.apiyi.com/models.
Preguntas frecuentes (FAQ)
Q1: ¿Por qué el servicio de Tokens pierde dinero?
El servicio de inferencia se basa principalmente en costos fijos como la depreciación de las GPU y la electricidad del centro de datos, mientras que los ingresos se facturan según el volumen de Tokens. En horas pico hay que reservar capacidad de cómputo, y en horas valle esa capacidad queda ociosa, por lo que es difícil mantener una utilización alta de forma sostenida. A esto se suman las guerras de precios y los subsidios de cuota gratuita provocados por la homogeneización de los modelos de código abierto, que fácilmente empujan el precio por debajo del costo.
Q2: ¿Por qué el Token de salida suele ser más caro que el de entrada?
La entrada se calcula en paralelo durante la fase de Prefill, con una alta eficiencia de utilización de la GPU. La salida se genera token a token en la fase de Decode, requiere leer repetidamente la KV Cache y está limitada principalmente por el ancho de banda de la memoria de video, por lo que su costo unitario es mayor. Por eso, los negocios con salidas largas deben prestar especial atención al precio unitario de salida y al throughput.
Q3: ¿Montar GPU propias siempre sale más barato que llamar a una API?
No necesariamente. Casos como «56 B200 sostienen a 2000 ingenieros» dependen de una carga interna masiva, estable y predecible. Los equipos con poco uso o con demanda muy variable terminan con una infraestructura propia gravemente ociosa y un costo unitario aún mayor. Se recomienda primero usar una API para trazar la curva real de consumo y luego evaluar el punto de equilibrio.
Q4: ¿Se puede usar un proveedor de API con precios muy bajos?
Se puede probar, pero conviene verificar mucho. Un precio claramente por debajo del rango de costo razonable suele implicar alguna de estas situaciones: subsidios, limitación de tasa, degradación del modelo o descuentos por menor estabilidad. Revisar la calidad y la facturación con la lista de 6 dimensiones de este artículo es más confiable que mirar solo el precio de lista.
Q5: ¿Cómo comparar el rendimiento de las APIs de varios modelos con bajo costo?
Se recomienda usar una plataforma multimodelo compatible con los formatos de interfaz más comunes para hacer pruebas unificadas:
1. Registrarse en APIYI apiyi.com y obtener la clave API
2. Configurar la interfaz compatible con OpenAI o Anthropic según la documentación `https://docs.apiyi.com`
3. Con un conjunto de pruebas fijo, ir alternando el campo `model` y registrando la latencia, la calidad y el `usage`
Con el mismo código se puede completar la comparación horizontal, y el costo de cambiar de modelo es muy bajo.
Q6: ¿Cómo consultar el precio de la caché? ¿Los criterios son iguales entre plataformas?
No son iguales. Algunas plataformas cobran aparte la escritura en caché, otras solo aplican descuento a la lectura, y la vigencia y la forma de activación también varían. Al llamar a través de APIYI, los precios de lectura y escritura de caché se rigen por los datos reales de la página de precios `https://docs.apiyi.com/models`, y conviene contrastar el cobro con los campos de caché que devuelve el `usage`.
Q7: ¿Cuál es el indicador que más se pasa por alto al evaluar a un proveedor?
La consistencia de la facturación y la estabilidad en horas pico. Muchos equipos hacen una sola prueba en horario de baja demanda y lanzan el servicio, para luego encontrarse con frecuentes errores 429 o timeouts en horas pico. También hay bastantes equipos que nunca contrastan la correspondencia entre el `usage` y la factura. Ambos aspectos deberían formar parte de la lista de verificación obligatoria antes del lanzamiento.
Costes del servicio de Tokens y evaluación de proveedores de API: puntos clave
- La raíz de las pérdidas: costes fijos altos, ingresos por consumo y fluctuación de la utilización; el desajuste entre estos tres factores hace que el servicio de Tokens pierda dinero con facilidad
- La salida es más cara: el Decode está limitado por el ancho de banda de la memoria de vídeo; en negocios con salidas largas hay que vigilar de cerca el precio unitario de salida y el throughput
- El contexto largo tiene costes ocultos: la KV Cache ocupa memoria de vídeo y reduce la concurrencia, así que los proveedores solo pueden equilibrar la balanza con niveles de precios y limitación de peticiones
- Montarlo por cuenta propia tiene barrera: solo cargas grandes y estables permiten diluir el coste fijo de las GPU; los equipos pequeños deberían priorizar el uso de API
- Evaluar en seis dimensiones: precios transparentes, facturación coherente, modelos reales, rendimiento estable, compatibilidad de interfaces y sostenibilidad
- Cómo empezar: probar rápidamente con APIYI en formatos compatibles con OpenAI / Anthropic; los precios se rigen por
docs.apiyi.com/models
Conclusión: entender el servicio de Tokens desde la estructura de costes y elegir bien el proveedor de API de modelos
Por qué pierde dinero el servicio de Tokens: en última instancia, lo determina la estructura de costes del servicio de inferencia:
- Lado de los costes: la depreciación de las GPU y la electricidad del centro de datos son costes fijos; la utilización es la palanca de rentabilidad, y los Tokens de salida y el contexto largo elevan aún más el coste
- Lado de los ingresos: la homogeneización de los modelos de código abierto hace inevitable la guerra de precios; las subvenciones atraen volumen pero reducen el margen bruto
- Lado de la selección: un precio bajo no equivale a ser rentable; hay que valorar de forma integral con estas 6 dimensiones: precios transparentes, facturación coherente, modelos reales, rendimiento estable, compatibilidad de interfaces y sostenibilidad
Para los desarrolladores, en lugar de adivinar cuánto aguantará cada proveedor, es mejor hablar con datos reales de invocación. Primero, con poco tráfico, validar la verificación de la facturación y la comparación de calidad; después, decidir el modelo principal y los canales de respaldo.
Recomendamos verificar rápidamente los resultados a través de APIYI apiyi.com. La plataforma ofrece la invocación de API de los modelos tratados en este artículo, compatible con los formatos de interfaz de OpenAI y Anthropic; la documentación de integración está en https://docs.apiyi.com. Los precios de entrada, salida y caché de todos los modelos se rigen por los datos reales de la página de precios https://docs.apiyi.com/models.
📚 Referencias
- 36Kr – Los tokens ya se venden en el livestream de Li Jiaqi, ¿por qué empresas como SiliconFlow siguen perdiendo dinero?: reportaje sobre las dificultades de rentabilidad de los proveedores de servicios de inferencia
- Enlace:
36kr.com/p/4055385238017664 -
Descripción: contexto del sector sobre la comoditización de los tokens y las pérdidas de los proveedores de inferencia
-
36Kr – Hay quien gasta 10.000 dólares al mes, considera que Claude es demasiado caro y esta empresa se pasó a GLM: caso de reducción de costos con inferencia autoalojada en una empresa
- Enlace:
36kr.com/p/4055383551038595 -
Descripción: caso de inferencia autoalojada con 56 B200 para dar soporte a 2000 ingenieros; sirve para entender los límites de costo entre el autoalojamiento y la API
-
Centro de documentación de APIYI: integración de API y precios de modelos
- Enlace:
docs.apiyi.com - Descripción: consulta las formas de integración compatibles con OpenAI / Anthropic; los precios de los modelos se consultan en
docs.apiyi.com/models
Autor: equipo técnico de APIYI
Contacto técnico: si tienes dudas sobre la selección de modelos y la evaluación de costos de Token, puedes contactarnos a través del sitio web oficial de APIYI, apiyi.com. Para más material de integración, visita el centro de documentación en docs.apiyi.com