Примечание автора: один ключ, один фиксированный набор скриптов и одна инъекция сбоя — чтобы горизонтально сравнить способность нескольких моделей к многораундовому вызову инструментов и получить воспроизводимые и проверяемые выводы.
При выборе модели для Agent многие команды упираются в одну и ту же проблему. В одиночном вопросе-ответе модели показывают примерно одинаковый результат, но как только начинается многораундовый цикл «вызвать инструмент → получить результат → вызвать снова → обработать ошибку → выдать структурированный ответ», различия сразу проявляются. В этой статье описан небольшой тест многораундового вызова инструментов, где один ключ проверяет несколько моделей — он поможет вам с очень низкими затратами превратить эти различия в данные, которые можно записать и перепроверить.
Это не рейтинг моделей. В статье нет ни одного бенчмарка, который не был бы реально прогнан, — только про то, как спроектировать тест, чтобы вы получили выводы для своего собственного сценария. Ключ к тесту — контроль переменных: один и тот же ключ, одно и то же определение инструментов, одни и те же моковые данные, меняется только название модели. Через такие агрегаторы, как APIYI apiyi.com, одним ключом можно вызывать DeepSeek, Gemini, Qwen, Claude, GPT и другие модели — при горизонтальном сравнении экономится куча времени на переключениях.
Главная ценность: дочитав статью, вы соберёте воспроизводимый тест многораундового вызова инструментов из 5 шагов. Он покрывает пять ключевых этапов: выбор инструмента, валидацию параметров, возврат ID вызова, повтор после сбоя и финальную проверку JSON.
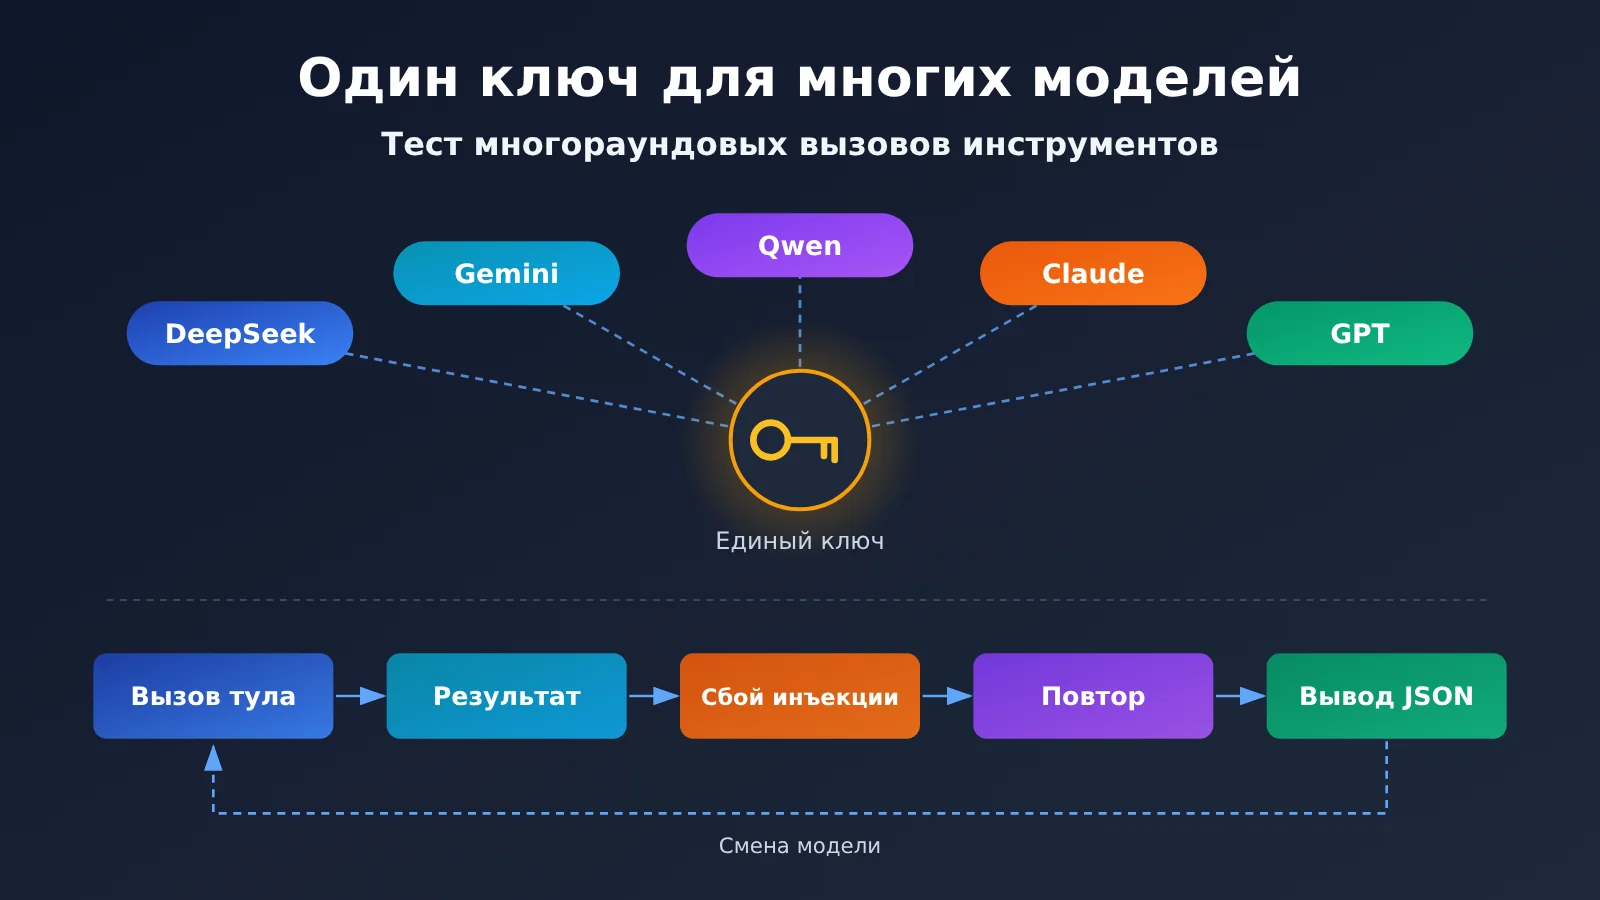
Ключевые моменты небольшого теста многораундового вызова инструментов
Прежде чем проектировать тест многораундового вызова инструментов, нужно определить, что такое «воспроизводимость». Один и тот же ввод в разное время и у разных людей должен давать сравнимые результаты одного типа. Единичный красивый вывод — ещё не основание для выводов. Таблица ниже — это скелет всего теста.
| Момент | Описание | Ценность |
|---|---|---|
| Один ключ, несколько моделей | Все модели идут через один и тот же вход интерфейса, меняется только поле model | Убирает помехи от сети, аутентификации и версии SDK |
| Фиксированные Mock-инструменты | Возвращаемые значения инструментов жёстко заданы, без подключения к реальной базе данных или внешним сервисам | Результаты инструментов при каждом прогоне абсолютно одинаковы |
| Одна инъекция сбоя | При первом вызове конкретного инструмента стабильно возвращается ошибка, допускающая повтор | Видно, сможет ли модель корректно повторить попытку и не начнёт ли выдумывать данные |
| Структурированная финальная точка | Итоговый ответ обязан быть JSON, соответствующим Schema | Можно программно определить, пройден тест или нет |
| Полный след | Сохраняются параметры запроса, сырой ответ, usage и время выполнения | Выводы можно перепроверить, а после смены версии модели — прогнать регрессию |
Почему тест многораундового вызова инструментов должен быть «маленьким»
Тест должен быть маленьким, потому что большой тест трудно воспроизвести. В реальной работе цепочка инструментов может включать десяток инструментов и зависеть от внешних систем — любое колебание тут же спишут на проблемы модели. Хороший маленький тест — это 2–3 инструмента только для чтения плюс один искусственно внедрённый сбой; этого достаточно, чтобы покрыть самые хрупкие места многораундового цикла.
Тест при этом должен быть «полным». Он обязан пройти весь цикл, а не просто посмотреть, вызовет ли модель инструмент в первом раунде. Многие модели отлично выступают в первом раунде, а ломаются во втором и третьем: не передают правильный ID вызова, получив ошибку, сразу сдаются или, не имея данных, сами придумывают номер отслеживания посылки. Такие проблемы видны только тогда, когда цикл доведён до последнего раунда.
Принципы проектирования теста нескольких моделей с одним ключом
Контроль переменных — предпосылка сравнительного теста. Если модель A работает через официальный SDK, модель B — через сторонний SDK, а модель C вообще переключили на другой прокси-адрес, то в итоге непонятно, откуда взялась разница: от модели или от цепочки. При едином входе способ аутентификации, стратегия повторов, настройки таймаутов и формат логов остаются одинаковыми, и единственная переменная — сама модель.
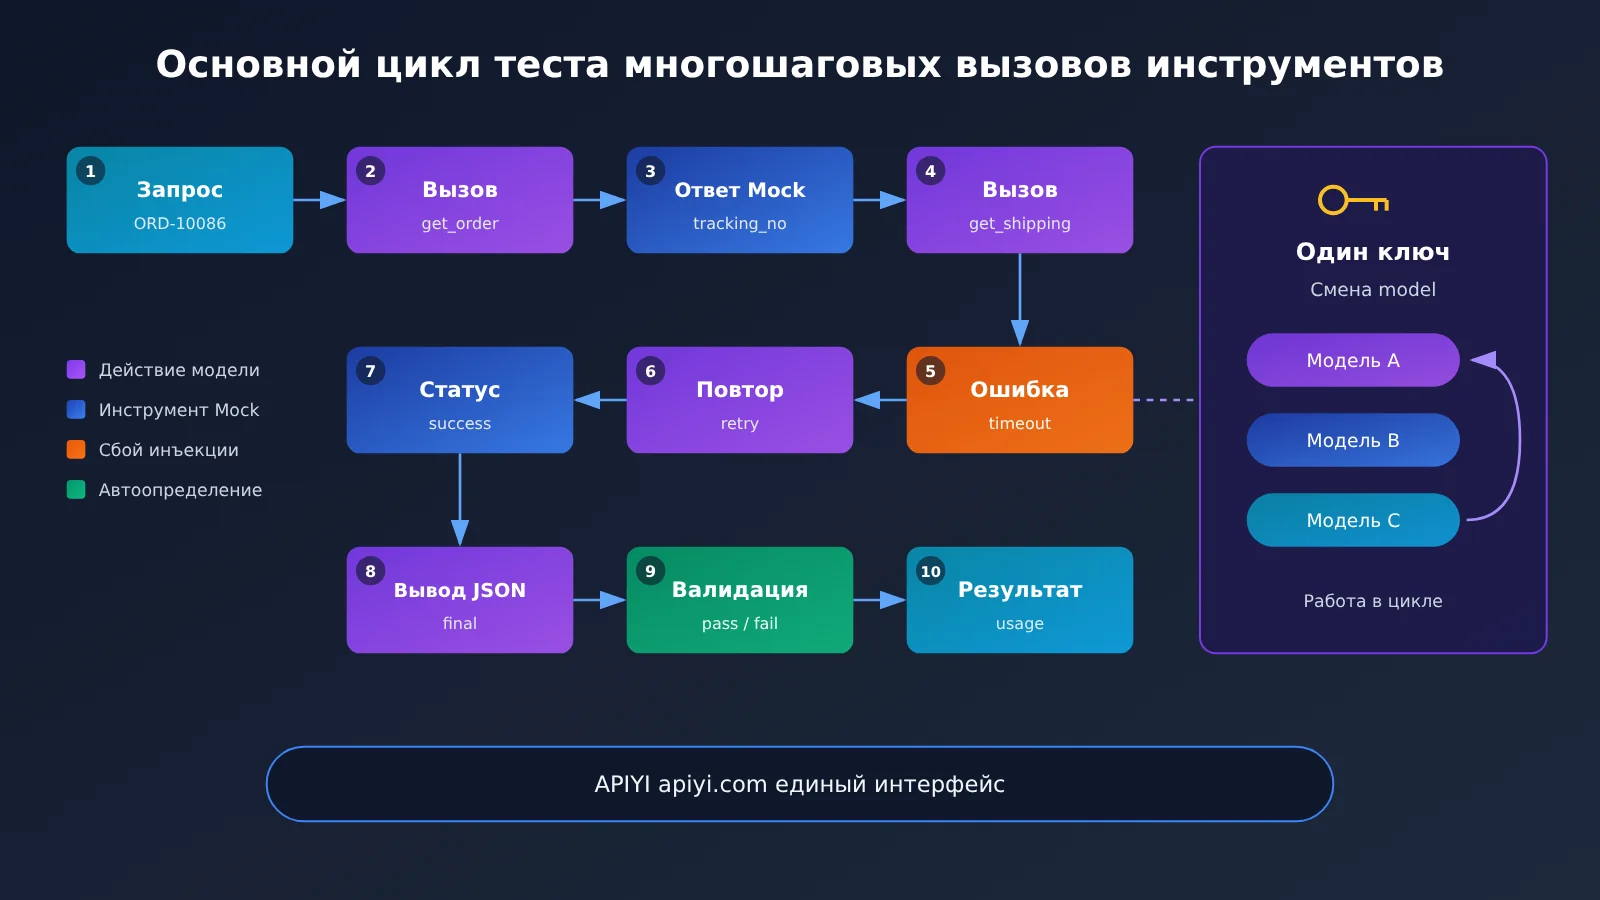
Быстрый старт: тест многораундовых вызовов инструментов
В этом разделе не будет кода — только параметры, определения инструментов и шаги выполнения. Реализовать можно на любом удобном языке: Python, Node.js или Shell-скрипт. Главное — записать каждую настройку в один фиксированный конфигурационный файл и сохранить его вместе с результатами теста.
Шаг 1: Единый интерфейс и параметры запуска
Сначала определите точку входа API и параметры сэмплирования. APIYI поддерживает оба формата API — OpenAI и Anthropic; один и тот же ключ подходит и для вызовов в стиле Chat Completions, и для вызовов в стиле Messages. В таблице ниже перечислены параметры, которые рекомендуется зафиксировать.
| Параметр | Рекомендуемое значение | Описание |
|---|---|---|
| base_url (формат OpenAI) | https://api.apiyi.com/v1 |
Вызов через единый вход APIYI; точный адрес — в документации docs.apiyi.com |
| base_url (формат Anthropic) | См. адрес для совместимости с Anthropic в документации APIYI | Для тестирования протокола tool_use / tool_result |
| api_key | Тот же API-ключ | Общий для всех моделей, чтобы исключить различия в аутентификации |
| temperature | 0 или минимально возможное | Снижает случайность; если некоторые reasoning-модели не поддерживают — фиксируйте фактическое значение |
| max_tokens | Фиксированное значение | Чтобы обрезка вывода не привела к ложному выводу |
| tool_choice | auto | Наблюдать за самостоятельным решением модели, не принуждая к вызову |
| Максимальное число раундов | Фиксированный лимит, например 6 раундов | Чтобы модель не ушла в бесконечные повторные попытки |
| Число запусков для каждой модели | Фиксированное число, например 5 запусков | Оценивать стабильность по нескольким запускам, а не по одному |
🚀 Совет для быстрого старта: можно сначала зарегистрироваться в APIYI (apiyi.com) и получить API-ключ, а затем по очереди вызвать модели-кандидаты с этим же ключом. Убедившись, что каждая модель возвращает корректный ответ с вызовом инструмента, начинайте полноценное тестирование. Инструкция по подключению — в docs.apiyi.com.
Шаг 2: Определите 2–3 инструмента только для чтения
К дизайну инструментов есть два требования: только чтение и детерминированность. Режим только чтения нужен, чтобы во время тестов случайно не сработали операции записи, а детерминированность — чтобы инструмент каждый раз возвращал одно и то же. Рекомендую взять вымышленный сценарий с запросом заказа и двумя инструментами:
- get_order: параметр
order_id(строка, фиксированный формат — «ORD-» плюс цифры). Всегда возвращает статус заказа, название товара и номер отслеживанияtracking_no. - get_shipping: параметр
tracking_no(строка). При первом вызове всегда возвращает ошибку, гдеerrorравенtimeout, аretryable—true; со второго раза и далее возвращает фиксированный статус доставки и ожидаемую дату доставки. - Необязательный отвлекающий инструмент get_coupon: не связан с вопросом и нужен, чтобы посмотреть, не вызовет ли модель его лишний раз.
Схему параметров нужно описать строго: типы полей, обязательные поля и регулярные форматы должны быть явно указаны. Параметры, которые сгенерировала модель, сначала проходят проверку по схеме и только потом попадают в mock-функцию. Если проверка не прошла, это нужно записать как «ошибку параметров», а не тихо исправлять.
Шаг 3: Напишите фиксированный промпт и пользовательский вопрос
В системном промпте пишите только правила, без ответа. Можно потребовать, чтобы модель отвечала исключительно на основе данных, возвращённых инструментами; при ошибке инструмента, если она допускает повтор, делать не более 2 повторов; в итоге выводить только один JSON-объект с полями order_status, shipping_status, eta и data_source. Пользовательский вопрос фиксируется одной фразой, например: «Проверь, где сейчас заказ ORD-10086».
Как только промпт определён, его больше не меняют. Если в тесте выяснится, что какая-то модель падает из-за неоднозначности промпта, правильный подход — завести новую версию и перетестировать все модели с ней, а не менять промпт только для этой одной модели.
Шаг 4: Запуск цикла и инъекция сбоя
Логика выполнения идёт в таком порядке:
- Отправляем system- и user-сообщения, а также определения инструментов.
- Если в ответе есть вызовы инструментов, по очереди проверяем параметры, выполняем соответствующую Mock-функцию и возвращаем результат по протоколу.
- Для первого вызова get_shipping всегда возвращаем retryable-ошибку.
- Повторяем шаг 2, пока модель не даст финальный ответ без вызовов инструментов или пока не достигнем максимального числа раундов.
- Проверяем финальный ответ через JSON Schema и сохраняем все сообщения, исходные ответы и usage по каждому раунду.
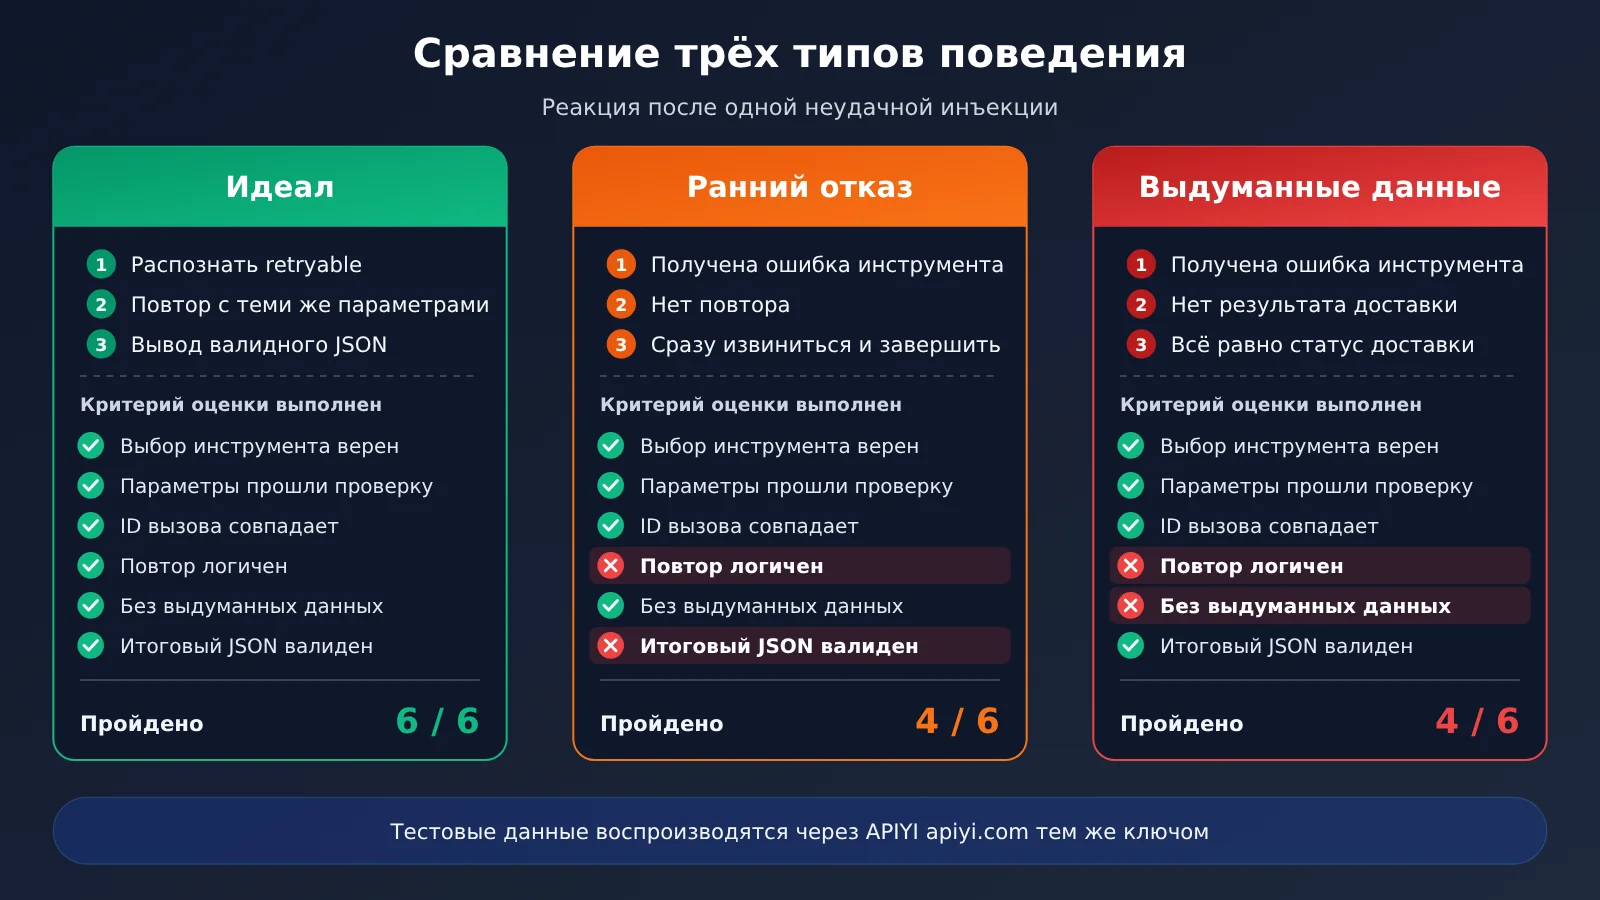
Именно на инъекции сбоя тест лучше всего различает модели. Идеальное поведение: модель распознаёт, что retryable равно true, и повторно вызывает get_shipping с теми же параметрами. На практике чаще всего встречаются три проблемных поведения: сразу извиниться перед пользователем и завершить работу; выдумать статус доставки; менять параметры и повторять попытки, пока не упрётся в лимит раундов.
Шаг 5: Оценка по чек-листу и фиксация результатов
После каждого запуска проверяем пункты программно, стараясь по минимуму полагаться на субъективную оценку человека. Человек только перепроверяет образцы, которые программа пометила как аномальные.
Различия протоколов многораундового вызова инструментов: форматы OpenAI и Anthropic
Чтобы один и тот же тест работал в обоих форматах интерфейса, сначала нужно разобраться в деталях протоколов. Даже небольшая разница в протоколе приводит к проблемам вроде «curl работает, а клиент — нет». Советую сначала минимальным запросом убедиться, что протокол собран правильно, и только потом переходить к сравнению возможностей моделей.
| Этап | Формат, совместимый с OpenAI | Формат, совместимый с Anthropic |
|---|---|---|
| Определение инструментов | массив tools, у каждого элемента type = function, параметры в parameters | массив tools, схема параметров в input_schema |
| Инициирование вызова моделью | tool_calls в сообщении assistant, каждый с id | tool_use в блоках содержимого assistant, каждый с id |
| Форма параметров | arguments обычно строка JSON, её нужно парсить самостоятельно | input — сразу JSON-объект |
| Возврат результата | сообщение с role = tool, несущее tool_call_id | блок содержимого tool_result в сообщении user, несущий tool_use_id |
| Пометка ошибки | обычно произвольное поле ошибки в содержимом результата | tool_result поддерживает флаг is_error |
| Параллельные вызовы | один ответ может содержать несколько tool_calls | один ответ может содержать несколько блоков tool_use |
Есть несколько граблей, на которые наступают чаще всего. Первое: в формате OpenAI arguments — это строка, и некоторые модели время от времени выводят лишние символы, из-за чего парсинг падает. Это само по себе должно попадать в оценку, а не гаситься в коде обработкой ошибок. Второе: при возврате результата ID должен однозначно соответствовать ID инициированного вызова, и при параллельных вызовах особенно важно следить за порядком. Третье: некоторые модели в одном ответе и выдают текст, и инициируют вызов инструмента — логика обработки должна поддерживать оба варианта одновременно.
💡 Технический совет: через единую точку входа APIYI apiyi.com можно одним и тем же ключом прогонять один и тот же набор тестов и в формате OpenAI, и в формате Anthropic. Так можно понять, в чём проблема — в самой модели или в слое адаптации протокола.
Чек-лист оценки и шаблон записи для многораундовых вызовов инструментов
Чек-лист оценки — ключ к воспроизводимости выводов. Каждый пункт должен проверяться программно и соответствовать реальному бизнес-риску. В таблице ниже — рекомендуемые проверки; добавляйте или убирайте их под свой бизнес.
| Пункт проверки | Как проверять | Связанный бизнес-риск |
|---|---|---|
| Правильный выбор инструмента | В первом раунде вызывается get_order, без вызова мешающих инструментов | Лишние вызовы увеличивают задержку и стоимость |
| Параметры проходят проверку | Параметры соответствуют схеме: типы, обязательные поля, формат | Неверные параметры попадут в реальную систему |
| ID вызова сопоставлен правильно | Возвращённый результат совпадает с ID инициированного вызова | Путаница в контексте между раундами |
| Разумное поведение при повторе | После retryable-ошибки — повтор с теми же параметрами и без превышения лимита | Слишком ранний отказ или бесконечные повторы |
| Нет выдуманных данных | Все поля в финальном ответе можно найти в возвращённых значениях инструмента | Галлюцинации напрямую влияют на пользователя |
| Финальный JSON валиден | Проходит проверку по JSON Schema, без лишнего текста | Сбой парсинга на стороне потребителя |
| Число раундов и расход токенов | Записывать общее число раундов, входные и выходные токены | Оценка стоимости и задержки |
После фиксированного числа прогонов для каждой модели сводим результаты в таблицу. Рекомендуемые столбцы: ID модели, формат API, номер запуска, число пройденных пунктов, детали проваленных пунктов, общее число раундов, входные токены, выходные токены, время выполнения, дата теста. Заголовок таблицы и конфигурационный файл кладём в репозиторий. При обновлении модели или переходе на новую версию достаточно прогнать тот же набор скриптов, чтобы сравнить регрессию.
Как считать расходы при многораундовых вызовах инструментов
Расход токенов нужно записывать по каждому раунду отдельно, а не смотреть только на последний. В многораундовом цикле на каждом шаге предыдущие сообщения и результаты инструментов снова отправляются как входные данные, поэтому входные токены накапливаются от раунда к раунду. Чем больше повторов, тем выше стоимость. Именно поэтому пункт «разумное поведение при повторе» стоит оценивать отдельно.
При расчёте стоимости берём входные и выходные токены из usage (а при попадании в кэш — ещё и кэшированные токены) и умножаем каждый показатель на соответствующую цену. Цены на входные и выходные токены, стоимость кэша и правила тарификации для всех моделей берём из фактических данных на странице цен APIYI: docs.apiyi.com/models. В этой статье мы не приводим конкретные цифры: цены меняются, и жёстко зашитые в текст числа быстро устаревают.
Один ключ — много моделей: список кандидатов
Кандидатов стоит подобрать так, чтобы они охватывали разных провайдеров и разные ниши: например, одна модель с хорошим соотношением цена/качество, одна основная рабочая модель и одна с сильными навыками рассуждения. В таблице ниже — только серии моделей и на что смотреть при тестировании, без выводов: выводы должны опираться на ваши собственные замеры.
| Серия моделей | На что смотреть при тестировании | Рекомендуемый формат API | Доступные платформы |
|---|---|---|---|
| Серия DeepSeek | Стабильность разбора строковых параметров, повторные попытки после неудачной подстановки | Совместим с OpenAI | APIYI apiyi.com, официальный API |
| Серия Gemini | Склонность к параллельным вызовам, не подмешивается ли текст в итоговый JSON | Совместим с OpenAI | APIYI apiyi.com, официальный API |
| Серия Qwen | Ложные вызовы инструментов-помех, соответствие ID в многораундовых сценариях | Совместим с OpenAI | APIYI apiyi.com, официальный API |
| Серия Claude | Обработка is_error в tool_result, контроль числа раундов |
Совместим с Anthropic | APIYI apiyi.com, официальный API |
| Серия GPT | Строгое соблюдение схемы, расход токенов | Совместим с OpenAI | APIYI apiyi.com, официальный API |
Конкретные доступные ID и версии моделей смотрите в списке моделей APIYI. Записывая результаты, обязательно указывайте полный ID модели, а не только название серии: разные версии одной серии могут заметно отличаться по поведению при вызове инструментов.
💡 Совет по выбору: что выбрать — зависит от сложности ваших инструментов, терпимости к галлюцинациям и бюджета. Рекомендую на APIYI apiyi.com прогнать каждый модельный кандидат одним и тем же ключом по одному кругу, а потом сопоставить с ценами на docs.apiyi.com/models и принять решение комплексно.
Частые вопросы (FAQ)
Вопрос 1: Что такое мини-тест многораундового вызова инструментов?
Это небольшой тест с детерминированным результатом. Используются 2–3 Mock-инструмента и одна намеренно внедрённая ошибка — модель должна полностью пройти цикл «вызвать инструмент → обработать результат → повторить попытку → выдать структурированный ответ», после чего программа по пунктам определяет, пройден тест или нет. Главное здесь — способен ли цикл стабильно отработать до конца, а не уровень знаний модели.
Вопрос 2: Почему важно тестировать несколько моделей одним ключом?
Чтобы контролировать переменные. Разные ключи, SDK и адреса прокси дают различия в аутентификации, таймаутах и адаптации протокола — из-за этого сравнение искажается. Когда точка входа одна, меняется только поле model, и различия в результатах можно отнести именно к самой модели.
Вопрос 3: Гарантирует ли temperature = 0 полную воспроизводимость?
Нет, полной гарантии нет. Даже при temperature = 0 у части моделей вывод слегка колеблется, а рассуждающие модели могут вообще не поддерживать снижение этого параметра. Поэтому тест нужно прогонять фиксированное число раз и смотреть на долю успешных прогонов и распределение сбоев, а не на один конкретный результат. Фактически использованные значения параметров тоже стоит записывать.
Вопрос 4: Для каких задач подходит этот тест?
— **Выбор Agent-решения**: перед запуском в продакшен сравнить кандидатов по стабильности работы с циклом инструментов.
— **Регрессия при обновлении модели**: после выхода новой версии прогнать тот же набор скриптов и убедиться, что деградации нет.
— **Проверка миграции протокола**: при переходе с формата OpenAI на формат Anthropic убедиться, что слой адаптации работает корректно.
Вопрос 5: Как быстро начать вызывать эти модели?
1. Зарегистрируйте аккаунт на APIYI apiyi.com и получите ключ.
2. Посмотрите docs.apiyi.com и уточните адрес, совместимый с OpenAI, и адрес, совместимый с Anthropic.
3. Настройте параметры по таблице из шага 1 этой статьи и сначала минимальным запросом проверьте, что каждая модель возвращает вызов инструмента.
APIYI поддерживает единый доступ к нескольким моделям, упомянутым в статье: для переключения модели достаточно изменить поле model.
Вопрос 6: Как оценить стоимость теста?
Стоимость примерно равна «число моделей × число прогонов × суммарное число Token за один прогон × цена за единицу». В многораундовом цикле входные Token накапливаются с каждым раундом, а повторные попытки ещё увеличивают расход. Цены за единицу и правила тарификации кэша смотрите в актуальных данных на странице цен APIYI docs.apiyi.com/models. Рекомендую сначала прогнать по 1 разу на каждую модель, чтобы оценить расход, и только потом решать, сколько будет официальных прогонов.
Вопрос 7: Какие ограничения есть у этого теста?
Мини-тест покрывает только типичные сценарии отказа и не может представлять все сложные бизнес-кейсы. Mock-инструменты возвращают очень чистые данные, тогда как реальная система может отдавать данные с хаотичным форматом или чрезмерно длинные. После успешного прохождения теста стоит добавить реальные аномальные примеры из бизнеса и постепенно расширять набор кейсов.
Ключевые выводы из мини-теста многораундового вызова инструментов
- Сначала — контроль переменных: один ключ, один набор конфигураций, меняем только поле model.
- Инструменты только для чтения и детерминированные: возвращаемые значения Mock жёстко заданы, чтобы при каждом запуске видеть одинаковые данные.
- Обязательно добавляем сбой: одна ошибка с возможностью повторной попытки лучше всего показывает, умеет ли модель корректно обрабатывать циклы.
- Оценка программная: каждый пункт проверки можно определить автоматически, человек только просматривает аномалии.
- Полная трассировка: сохраняйте исходные ответы, usage по каждому раунду и полный ID модели — так удобнее делать регрессию.
- Цены — по официальной странице: расчёт стоимости ведём по странице цен APIYI docs.apiyi.com/models.
- Единый вход удобнее: APIYI совместим с форматами OpenAI и Anthropic, поэтому один скрипт может покрыть оба протокола.
Итог
Мини-тест многораундового вызова инструментов, где одним ключом проверяются несколько моделей, держится на трёх вещах:
- Воспроизводимость: фиксированная конфигурация, фиксированные Mock-данные, фиксированная версия промпта и несколько запусков.
- Проверяемость: вместо субъективных впечатлений — валидация по схеме и чек-лист оценки.
- Возможность регрессии: полная трассировка, чтобы после обновления модели быстро перепроверить всё тем же скриптом.
Этот подход не скажет, «какая модель лучшая», но покажет, какая модель в вашей цепочке инструментов стабильнее, экономнее по токенам и предсказуемее ведёт себя при ошибках. Рекомендую сначала прогнать процесс на сценарии с запросом заказа из этой статьи, а затем заменить инструменты на свои из бизнеса.
Для горизонтальной проверки нескольких моделей одним ключом рекомендую использовать APIYI apiyi.com. Как подключиться — см. docs.apiyi.com, цены и правила расчёта — на docs.apiyi.com/models.
📚 Справочные материалы
- Документация OpenAI по вызову функций: описание протокола для
tools,tool_callsи сообщений с рольюtool. - Ссылка:
platform.openai.com/docs/guides/function-calling -
Пояснение: как обрабатываются строки параметров и
tool_call_idв формате, совместимом с OpenAI. -
Документация Anthropic по использованию инструментов: описание блоков содержимого
tool_useиtool_result. - Ссылка:
docs.anthropic.com/en/docs/build-with-claude/tool-use -
Пояснение: как используются
input_schema,tool_use_idиis_error. -
Центр документации APIYI: инструкция по подключению к унифицированному интерфейсу.
- Ссылка:
docs.apiyi.com -
Пояснение: адреса, совместимые с OpenAI и Anthropic, и примеры вызовов.
-
Страница моделей и цен APIYI: список моделей и правила тарификации.
- Ссылка:
docs.apiyi.com/models - Пояснение: все цены за входные, выходные данные и кеширование — по фактическим данным на этой странице.
Автор: техническая команда APIYI
Для связи по техническим вопросам: пишите нам через главную страницу сайта APIYI apiyi.com; больше материалов по подключению — в центре документации docs.apiyi.com