От автора: на примере реального тестирования Apple Intelligence для материкового Китая в iOS 27.3 разбираем логику разделения задач между моделью на устройстве и облачной большой языковой моделью, а также даём готовый к применению фреймворк оценки по 5 измерениям и шаги внедрения в продукт.
С выходом бета-версии iOS 27.3 для разработчиков Apple Intelligence для материкового Китая наконец открылась для тестирования. В основе — собственные модели Apple и Alibaba Qwen: удаление объектов с фото, базовая коррекция текста и перевод в реальном времени работают на устройстве, а длительные задачи Siri и «Спросить» в визуальном интеллекте отдаются в облако Qwen. Этот запуск в Китае — как раз очень конкретный пример разделения задач между устройством и облаком.
Это не очередной обзор функций, а разбор на этом примере логики проектирования разделения задач между устройством и облаком: какие AI-задачи стоит держать на устройстве, какие обязательно отдавать облачной большой языковой модели и как разработчику провести эту границу в своём продукте.
Главная ценность: после этой статьи у вас будет фреймворк оценки разделения задач между устройством и облаком по 5 измерениям, а также 4 шага, чтобы внедрить в своём приложении гибридную архитектуру «fallback на устройстве + облачное усиление».
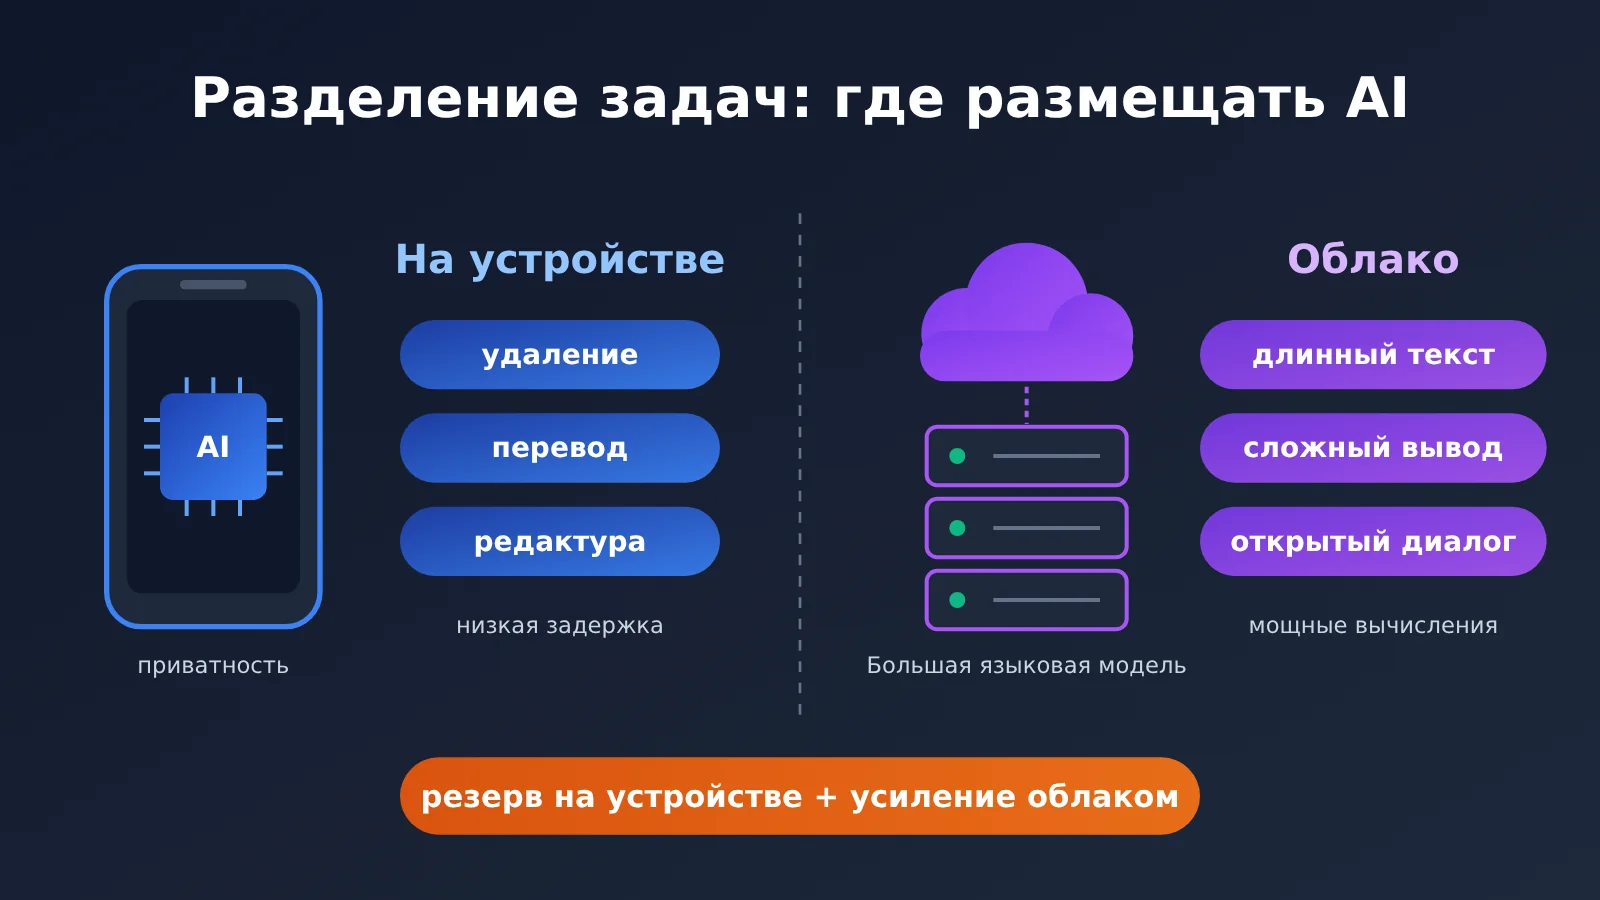
Ключевые моменты разделения задач между устройством и облаком в китайской версии Apple Intelligence
Сначала сведу в одну таблицу то разделение задач, которое удалось подтвердить в тестах. Столбцы «Где выполняется» и «Что показали тесты» основаны на публичных тестах — видно, что Apple распределяет задачи не случайно, а по чётким правилам.
| Функция | Где выполняется | Источник модели | Что показали тесты |
|---|---|---|---|
| Удаление объектов на фото | На устройстве | Собственная модель Apple для работы на устройстве | На простом фоне работает чисто, на сложных текстурах часто остаются цветные артефакты низкого разрешения |
| Перевод в реальном времени | На устройстве | Модель Apple на устройстве, нужно скачать языковые пакеты (около 2 ГБ каждый) | Задержка в повседневной речи меньше 1 секунды, точность неплохая |
| Инструменты письма (базовая редактура) | В основном на устройстве | Собственная модель Apple | Удобно вызывать на уровне системы, но переписывание на китайском звучит довольно коряво |
| Сводки уведомлений / поиск по фотоальбому на естественном языке | На устройстве | Собственная модель Apple, нужно построить локальный индекс | Сразу после обновления нужно подождать день-два, пока завершится индексация |
| Сложные задачи Siri | В облаке | Alibaba Qwen, требуется разрешение пользователя и вход в аккаунт Qwen | Результат примерно через 7–8 секунд, содержание довольно краткое |
| Визуальный интеллект «Спросить» / «Поиск» | В облаке | «Спросить» подключено к Qwen, «Поиск» по умолчанию использует визуальную модель Baidu, можно подключить сторонние приложения | После адаптации сторонние приложения могут появиться в списке поисковых сервисов |
Подробный разбор разделения задач между устройством и облаком: почему удаление объектов и перевод остаются на устройстве
У удаления объектов на фото и синхронного перевода есть три общие черты: на вход идут личные данные пользователя (снимки, голос из звонка), задержка критична, а границы задачи четко очерчены. Лица и геоданные на фотографиях не покидают устройство — риск для приватности минимален; перевод должен работать прямо по ходу разговора, и любой сетевой «раунд-трип» ломает ритм беседы, а задержка меньше секунды на устройстве — как раз то, что делает опыт комфортным.
Цена тоже очевидна. Размер параметров модели на устройстве ограничен вычислительными возможностями и памятью телефона, поэтому удаление объектов дает осечку на сложных текстурах вроде большой лужайки или булыжной мостовой, а каждый языковой пакет для перевода занимает около 2 ГБ. Пакет обновления системы в этот раз весит целых 12 ГБ — по сути, это «плата за аренду» для моделей на устройстве.
Подробный разбор разделения задач между устройством и облаком: почему длинные задачи Siri отдаются в облако
Запросы вроде «помоги спланировать четырехдневную поездку в Цзючжайгоу» требуют большого объема знаний о мире, генерации длинного текста и многошагового планирования — маленькая модель на устройстве такое просто не вытянет. Подход Apple: когда Siri понимает, что вопрос выходит за ее возможности, она показывает всплывающее окно и спрашивает, согласен ли пользователь вызвать Qwen; если тот отказывается, Siri просто не отвечает.
Это окно стоит взять на заметку разработчикам. Оно явно сообщает пользователю, что «данные покинут устройство», и возвращает ему право решать вопрос приватности. Тесты заодно напоминают: качество облачного результата зависит от того, какой контекст и какой промпт система передала модели. Маршрут от Siri заметно хуже, чем если спросить напрямую в приложении Qwen, — а значит, «подключили большую языковую модель» не равно «хорошо ее использовали».
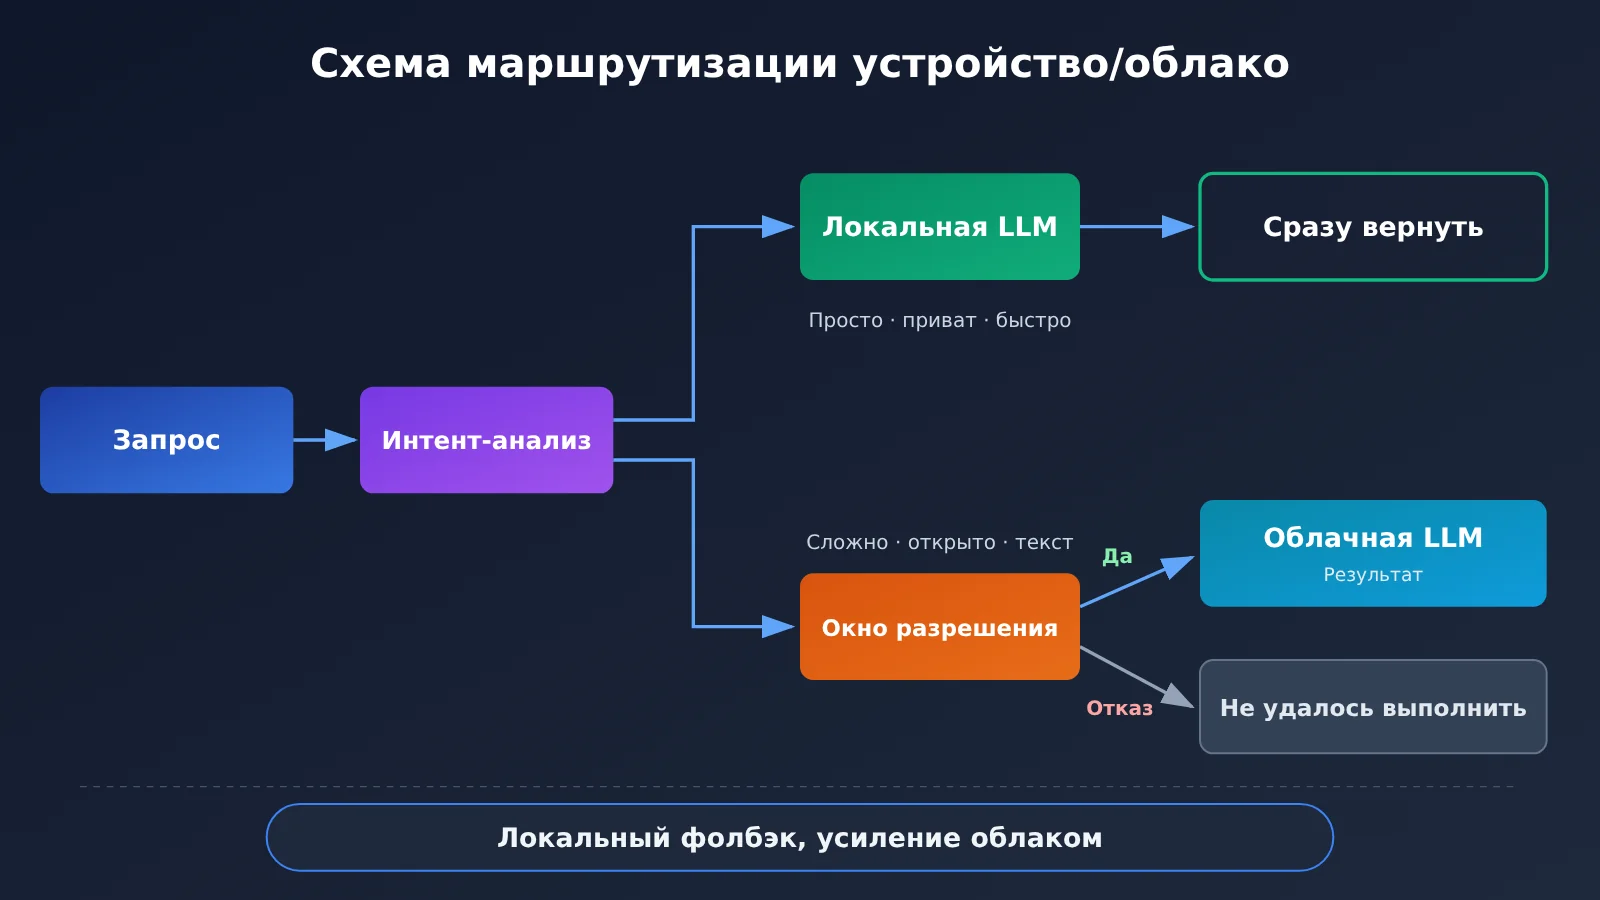
Фреймворк для разделения задач между устройством и облаком: 5 измерений, определяющих, где выполнять задачу
Из того, как устроено разделение обязанностей в китайской версии Apple Intelligence, можно вывести 5 критериев оценки. Когда делаете реальное решение, каждую задачу можно прогнать по этим 5 измерениям — куда склоняется большинство, туда задачу и относим.
| Критерий | Признаки в пользу устройства | Признаки в пользу облака | Пример в Apple Intelligence |
|---|---|---|---|
| Чувствительность данных | Личные данные: фото, контакты, история переписки | Публичные знания, вопросы, которые пользователь сам отправил | Удаление объектов — на устройстве, вопросы по гайдам — в облаке |
| Требования к задержке | Нужен ответ в пределах секунды, при прерывании результат теряется | Можно подождать несколько секунд | Перевод — на устройстве, длинные задачи Siri — около 7–8 секунд |
| Сложность задачи | Чёткие границы, короткий вывод | Открытые вопросы и ответы, многошаговое планирование, генерация длинных текстов | Базовая редактура — на устройстве, сложные запросы — к Qwen |
| Актуальность знаний | Не зависит от свежей внешней информации | Нужны знания о мире или поиск в реальном времени | «Поиск» в Visual Intelligence подключён к Baidu и сторонним сервисам |
| Доступность офлайн | Должно работать при слабой сети или без неё | Сценарий по умолчанию — онлайн | Перевод в реальном времени работает локально после загрузки языкового пакета |
Типичные ошибки при разделении задач между устройством и облаком
Многие команды, распределяя задачи между устройством и облаком, наступают на одни и те же грабли. Эти ошибки стоит обойти заранее:
- Ошибка первая: «если можно на устройство — тащим всё на устройство». Возможности локальных моделей ограничены. Если пихать в них сложные задачи, получите такой же низкокачественный результат, как с провалившимся удалением объектов, — и только испортите впечатление.
- Ошибка вторая: «подключили облако — и всё само заработает». Пример Siri с гайдами показывает: системный промпт, организация контекста и контроль длины вывода тоже определяют качество.
- Ошибка третья: игнорировать разрешения и деградацию. При вызове облака нужно продумать запасной путь на случай, если пользователь откажет в разрешении или сеть отвалится. Функция не должна просто «исчезать».
- Ошибка четвёртая: посчитать затраты один раз. На устройстве это разовые расходы на хранилище и размер пакета, в облаке — постоянные расходы на вызовы по мере использования. Эти две статьи нужно считать раздельно.
Быстрый старт с разделением задач между устройством и облаком: 4 шага для внедрения в своём приложении
Ниже превращаем схему принятия решений в конкретные выполнимые шаги. Даже если вы делаете не мобильную ОС, а обычное приложение, мини-программу или десктопный инструмент — этот подход подойдёт точно так же.
Шаг 1. Инвентаризируйте задачи и разметьте их по принципу «устройство — облако»
Перечислите все функции продукта, которые планируете подключить к AI, и оцените каждую по 5 измерениям из предыдущего раздела. Рекомендую свести всё в список задач минимум с такими колонками: «название задачи, чувствительность данных, требования к задержке, сложность, целевое расположение» — на ревью всё будет как на ладони.
Шаг 2. Выбираем лёгкое решение для задач на устройстве
Для задач на устройстве в первую очередь используйте нативные возможности системы или лёгкие модели: например, системные интерфейсы перевода, OCR и распознавания речи либо квантованные модели с небольшим числом параметров. Главное — контролировать размер модели и впечатление от первой загрузки. Ориентируйтесь на подход Apple: большие ресурсы загружаются по требованию, а при первом использовании пользователь получает понятное уведомление.
Шаг 3. Подключаем API большой модели для облачных задач
Для облачных задач нужна большая модель с достаточными возможностями. Если вы хотите использовать серию Qwen, как в Apple Intelligence для материкового Китая, или одновременно сравнивать GPT, Claude и другие модели, это можно делать через единый вызов APIYI. APIYI предоставляет доступ к API основных больших моделей, упомянутых в статье, и совместим с двумя форматами интерфейсов — OpenAI и Anthropic. Обычно существующий код достаточно перенести, заменив адрес API и ключ. Актуальный список доступных моделей смотрите на странице цен.
Ключевые параметры подключения приведены в таблице ниже. Адреса API уточняйте в документации APIYI — docs.apiyi.com:
| Параметр | Назначение | Рекомендация для сценария с разделением задач между устройством и облаком |
|---|---|---|
| Адрес API (base_url) | Определяет сервер, на который отправляется запрос | Указывайте по документации APIYI docs.apiyi.com; для форматов OpenAI и Anthropic используются свои адреса, описанные в документации |
| API Key | Аутентификация и биллинг | Храните только на сервере, не включайте в установочный пакет клиента |
| model | Выбор вызываемой модели | Для сложных задач планирования выбирайте модель с сильным рассуждением, для простых переписываний подойдёт лёгкая модель |
| max_tokens | Ограничение длины вывода | Для гайдов и отчётов задавайте запас побольше, чтобы не получить излишне краткий ответ в духе Siri |
| stream | Потоковый вывод | Для длинных облачных задач лучше включить — это компенсирует ощущаемую задержку в несколько секунд |
| Таймауты и повторы | Обработка сетевых сбоев | Задайте разумный таймаут; при ошибке переключайтесь на упрощённый результат на устройстве или показывайте понятное сообщение |
Шаг 4: Продумайте окно авторизации и путь деградации
Возьмите за образец окно подтверждения, которое Siri показывает перед обращением к Qwen: любая функция, отправляющая данные пользователя в облако, при первом вызове должна объяснять, «что именно отправляется и кому». Если пользователь отказывается, не стоит, как Siri, просто сдаваться — можно откатиться к возможностям на самом устройстве и выдать упрощённый результат либо предложить пользователю вручную дополнить информацию.
🚀 Быстрый старт: советуем сначала выбрать самую сложную облачную задачу и проверить на ней прототип. Зарегистрировавшись через APIYI apiyi.com, вы сразу получите тестовую квоту — переключайтесь между разными моделями в одном и том же OpenAI-совместимом формате, сравните, какая модель даёт лучшее качество в вашем сценарии, и только потом определяйтесь с финальным решением.
Сравнение схем разделения задач между устройством и облаком: только на устройстве, только в облаке и совместная схема
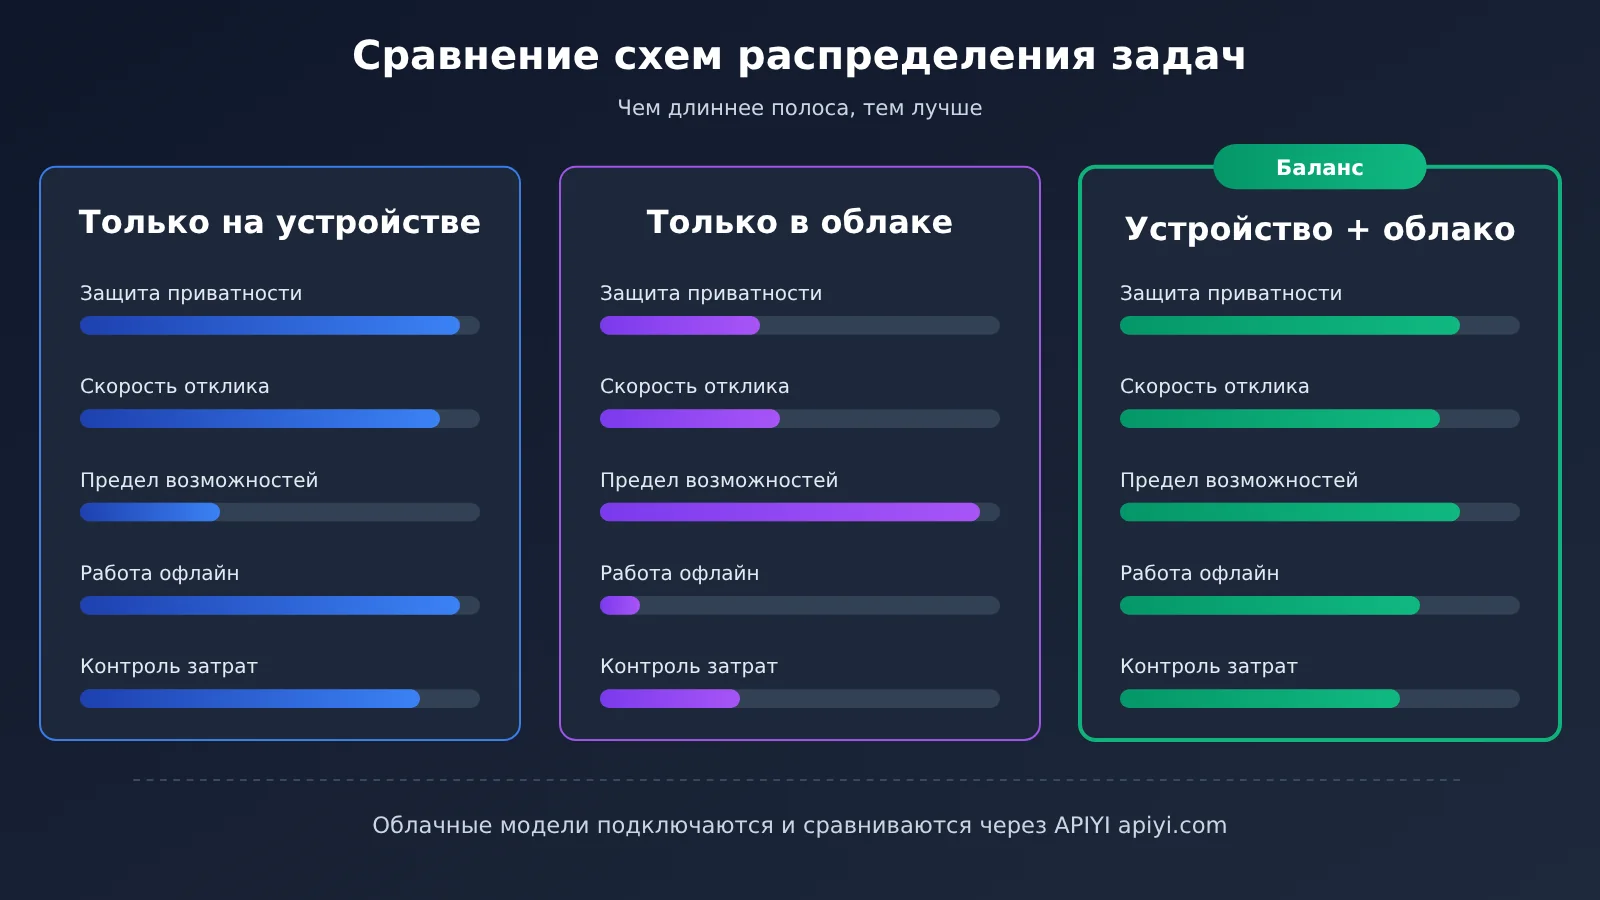
| Схема | Ключевые особенности | Когда подходит | Главные недостатки | Платформы для облачных моделей |
|---|---|---|---|---|
| Только на устройстве | Данные не покидают устройство, работает офлайн | Перевод, удаление объектов, распознавание речи и другие задачи с чёткими границами | Низкий потолок возможностей, нагрузка на размер приложения и хранилище | Не применимо |
| Только в облаке | Высокий потолок возможностей, быстрые итерации | Открытые вопросы-ответы, длинные тексты, многошаговое планирование | Зависит от сети, есть вопросы к приватности и постоянные затраты на вызовы | APIYI apiyi.com, официальные API моделей |
| Устройство + облако | Локальная страховка, усиление из облака, маршрутизация по задачам | Подавляющее большинство потребительских AI-продуктов | Сложная архитектура: нужно продумать маршрутизацию, авторизацию и деградацию | APIYI apiyi.com, официальные API моделей |
Разбор сравнения схем
Разбор схемы «только на устройстве»: вариант «только на устройстве» лидирует по приватности и скорости отклика — лучшее доказательство тому задержка перевода в реальном времени меньше 1 секунды. Но локальные модели ограничены вычислительными ресурсами и памятью: при сложном удалении текстур и сложном переписывании китайских текстов качество заметно падает. Для сравнения, совместная схема «устройство + облако» может передать эти сложные задачи в облако и поднять потолок возможностей, сохраняя базовый уровень приватности.
Разбор схемы «только в облаке»: вариант «только в облаке» силён в широте знаний и генеративных способностях — после интеграции Qwen в Siri она наконец смогла отвечать на вопросы по гайдам. Но каждый вызов зависит от сети и разрешения пользователя; если пользователь откажет или сеть будет слабой, функция просто перестанет работать. Для ключевых функций, которые должны быть доступны «в любой момент», совместная схема «устройство + облако» по-прежнему остаётся более надёжным выбором.
💡 Рекомендация по выбору: выбор схемы зависит от состава ваших задач. Если для облачной части нужно выбирать между Qwen, GPT, Claude и другими моделями, можно через APIYI apiyi.com провести сравнительное тестирование на одних и тех же задачах через единый интерфейс и принимать решение по реальному качеству вывода, а не по рекламным характеристикам.
Расчёт затрат при разделении устройства и облака: разово на устройстве, по факту в облаке
Стоимость — один из самых недооценённых аспектов разделения вычислений между устройством и облаком. Затраты на стороне устройства в основном выражаются в размере установочного пакета, занимаемом месте в хранилище пользователя и впечатлении от первой загрузки. Обновление Apple размером 12 ГБ и языковые пакеты примерно по 2 ГБ каждый — наглядный пример таких затрат. Затраты в облаке — это постоянные расходы на вызовы модели по мере использования: чем активнее пользователь, тем выше расходы.
Apple и сама ведёт этот расчёт. На телеконференции по финансовым результатам руководство Apple отметило, что для будущих функций вроде Siri AI и продвинутого интеллектуального редактирования фотографий, которые зависят от облачных больших языковых моделей, будет установлен базовый лимит использования, а активным пользователям придётся докупать квоту. Иными словами, модель «бесплатный базовый лимит + плата за интенсивное использование», скорее всего, станет основной бизнес-моделью для облачных AI-функций. Разработчики могут взять эту идею на заметку при проектировании своих продуктов.
Если говорить конкретно о стоимости вызовов облачных моделей, у разных моделей сильно различаются цены за входные и выходные токены, а также правила оплаты кеширования, и они могут меняться в любое время. В этой статье мы не приводим конкретные цифры. Все цены на модели, правила тарификации, стоимость входных и выходных токенов и кеширования — ориентируйтесь на актуальные данные на странице цен APIYI: https://docs.apiyi.com/models.
💰 Оптимизация затрат: при расчёте облачных затрат рекомендуется оценивать по формуле «среднее число входных токенов на одну задачу × цена входных токенов + среднее число выходных токенов × цена выходных токенов». Цены берите только со страницы цен APIYI docs.apiyi.com/models. Если системные промпты часто повторяются, проверьте, указана ли на странице цен оплата кеширования: это поможет дополнительно снизить постоянные расходы.
Часто задаваемые вопросы (FAQ)
Вопрос 1. Что такое разделение работы между устройством и облаком?
Разделение работы между устройством и облаком — это подход, при котором задачи AI делятся по своим особенностям: часть обрабатывается локальной моделью на устройстве, а часть отправляется в облачную большую модель. Apple Intelligence для материкового Китая — типичный пример: очистка объектов и перевод работают на устройстве, сложные задачи Siri и визуальный интеллект с функцией «Спросить» передаются в облачную Qwen (千问).
Вопрос 2. В чём ключевое различие между моделью на устройстве и облачной большой моделью?
Модель на устройстве сохраняет преимущество в приватности, задержке и работе офлайн, но её потолок возможностей ограничен вычислительными ресурсами и памятью; облачная большая модель обладает широкими знаниями и сильной генерацией, но зависит от сети, требует авторизации пользователя и создаёт постоянные затраты на вызовы. Это не отношения замены, а взаимодополнение.
Вопрос 3. Когда Apple Intelligence для материкового Китая станет официально доступен?
Открытая бета-версия Apple Intelligence для материкового Китая доступна вместе с бета-версией iOS 27.3 для разработчиков: войдите в приложение Apple Developer, а затем проверьте обновления ПО. В первой бета-прошивке есть баги; по публичным сообщениям, официальная версия ожидается в декабре, поэтому на основном устройстве лучше дождаться официального релиза и только потом обновляться.
Вопрос 4. Какие задачи AI лучше всего подходят для устройства?
В основном подходят следующие сценарии:
— **Обработка приватных данных**: удаление объектов на фото, поиск по галерее на естественном языке, сводка уведомлений
— **Взаимодействие с сверхнизкой задержкой**: перевод речи в реальном времени, подсказки при вводе
— **Функции, необходимые офлайн**: перевод в условиях слабой сети, распознавание речи, базовая проверка текста
Вопрос 5. Как быстро вызывать облачные большие модели вроде Qwen через API?
Рекомендую тестировать через платформу-агрегатор множества моделей:
1. Зарегистрируйтесь на APIYI (apiyi.com) и получите API-ключ
2. В центре документации docs.apiyi.com ознакомьтесь с инструкциями по подключению в формате, совместимом с OpenAI, или в формате, совместимом с Anthropic
3. На странице цен docs.apiyi.com/models уточните доступные модели и тарификацию, затем замените адрес интерфейса и ключ — и можно вызывать
Так вы сможете в рамках одного набора интерфейсов сравнить результат Qwen и других популярных моделей.
Вопрос 6. Что делать, если при облачном вызове пользователь отказывается авторизовать запрос?
Siri в этом случае просто отказывается отвечать, что выглядит довольно резко. Лучшее решение — продумать путь деградации: вернуться к устройству и выдать упрощённый результат или предложить пользователю дополнить информацию и попробовать снова, при этом уважая выбор пользователя и не донимая его повторными всплывающими окнами.
Вопрос 7. Какие известные ограничения есть у схемы разделения работы между устройством и облаком?
Объективно говоря, основных три:
— **Сложность архитектуры**: нужно дополнительно поддерживать маршрутизацию намерений, процесс авторизации и логику деградации
— **Согласованность опыта**: стиль вывода на устройстве и в облаке различается, пользователь может почувствовать разрыв
— **Границы экосистемы**: как показывает практика, системный AI не может проникнуть в сторонние приложения вроде WeChat и Meituan, личный контекст остаётся фрагментированным, и разделение работы между устройством и облаком не решает проблему изолированных данных
Ключевые тезисы: как делить задачи между устройством и облаком
- Суть разделения: приватные задачи с низкой задержкой и чёткими границами — на устройство; сложные, открытые задачи с длинным текстом — в облако
- Пример из китайской версии: собственная модель Apple отвечает за перевод, а Alibaba Qwen берёт на себя длинные задачи Siri и визуальные запросы
- Рамка для решения: оценивайте задачу по пяти параметрам — чувствительность данных, задержка, сложность, актуальность, работа офлайн
- Согласие обязательно: перед отправкой данных с устройства нужно явно получить согласие пользователя и заранее продумать запасной путь на случай отказа
- Главное для качества: подключить большую языковую модель — это только начало; промпт, контекст и длина вывода определяют итоговый опыт
- Как начать: облачные модели подключаются через единый шлюз APIYI apiyi.com — совместим с форматами OpenAI и Anthropic
Итоги
Запуск Apple Intelligence для китайского рынка дал нам чёткий ориентир по разделению задач между устройством и облаком:
- На устройстве — приватность и скорость: удаление, перевод, суммаризация уведомлений остаются на устройстве; цена — размер приложения и занимаемое хранилище
- Облако добирает потолок возможностей: сложные вопросы и визуальные запросы уходят к Qwen; цена — задержка, авторизация и постоянные расходы
- Совместная работа — это норма: подстраховка на устройстве, усиление в облаке, плюс окна авторизации и пути деградации — вот и получается работоспособная форма продукта
Для разработчиков самый практичный путь — сначала разметить задачи по фреймворку принятия решений, а затем выбрать одну облачную задачу для проверки прототипом. Рекомендую через APIYI apiyi.com сравнивать реальные результаты разных больших языковых моделей через единый интерфейс; цены моделей и правила тарификации — по странице цен docs.apiyi.com/models.
📚 Источники
- 爱范儿: тест iPhone с ИИ для китайского рынка: тест первой версии Apple Intelligence для китайского рынка на developer beta
- Ссылка:
ifanr.com/1687733 -
Пояснение: источник фактов о разделении функций между устройством и облаком, результаты тестов
-
APIYI Documentation Center: описание подключения в форматах, совместимых с OpenAI и Anthropic
- Ссылка:
docs.apiyi.com -
Пояснение: адрес интерфейса, способ аутентификации и параметры вызова — в соответствии с этим документом
-
Страница цен моделей APIYI: список доступных моделей и правила тарификации
- Ссылка:
docs.apiyi.com/models - Пояснение: цена за вход/выход, цена кэша и прочая информация о тарификации — по фактическим данным этой страницы
Автор: техническая команда APIYI
Общение по техническим вопросам: свяжитесь с нами на главной странице APIYI apiyi.com; больше материалов по подключению — в документации docs.apiyi.com