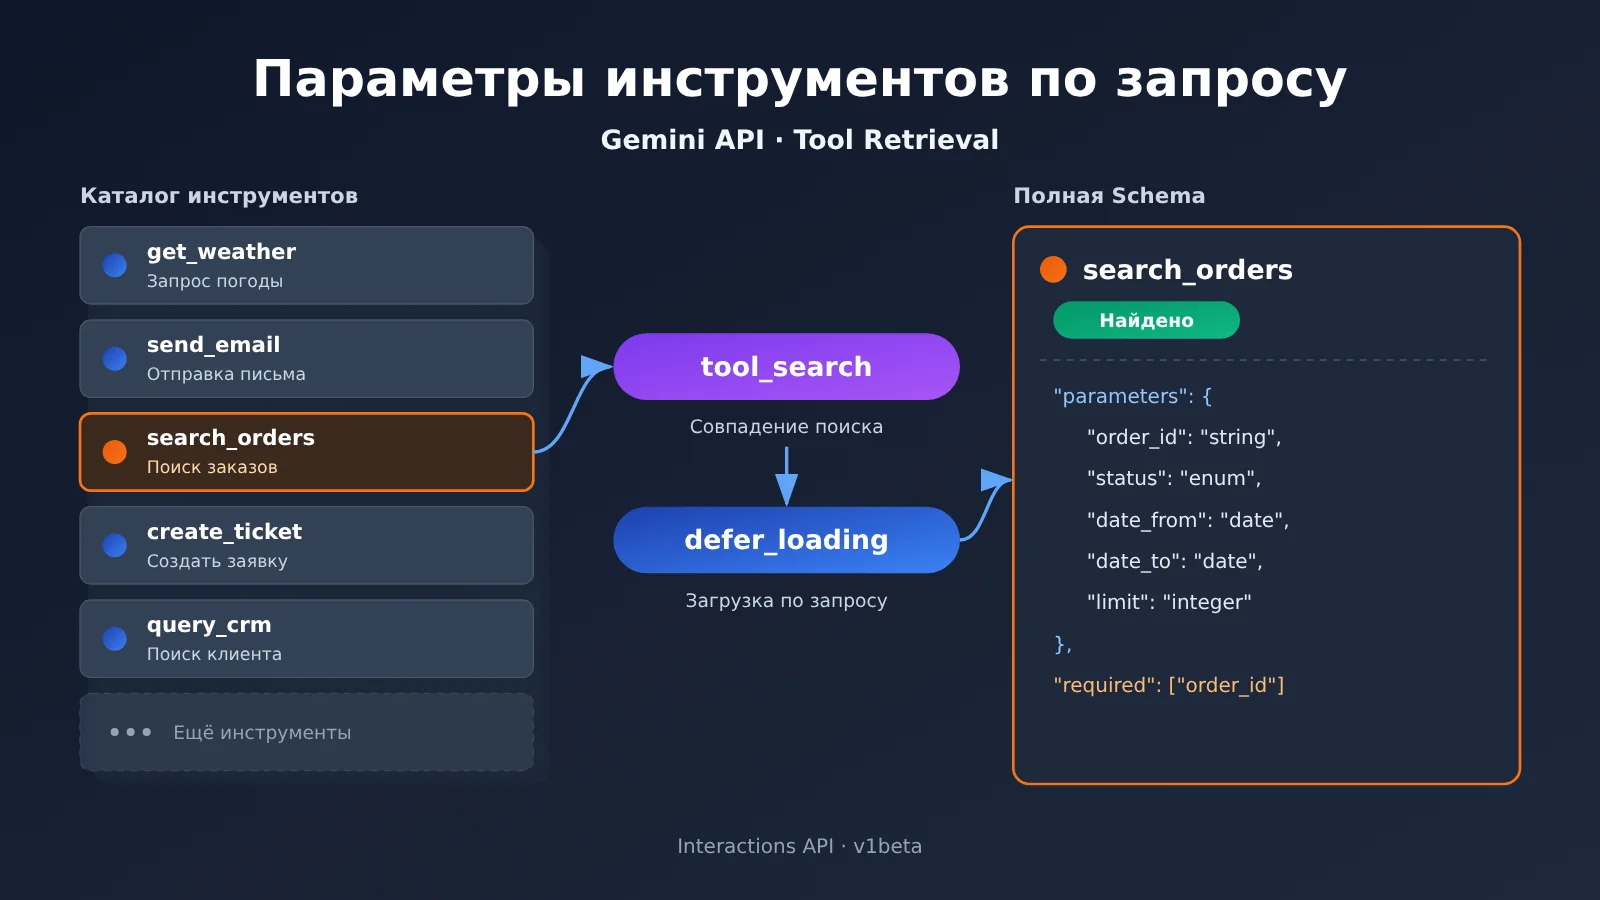
19 ноября 2026 года Google в режиме Preview представила в Gemini Interactions API Tool Retrieval (поиск инструментов). Агент сначала видит только названия и краткие описания инструментов, а полную схему параметров загружает в контекст, когда инструмент действительно нужно вызвать. В первую очередь это решает проблему, когда инструментов становится всё больше и контекст заполняется определениями неиспользуемых инструментов. Лучше всего подход подходит агентам с большим числом инструментов, где вызовы сосредоточены на нескольких часто используемых, но при этом есть много редких long-tail-инструментов. Это не значит, что всем приложениям включение по умолчанию окупится.
Что вы узнаете из этой статьи?
- Что именно меняет Tool Retrieval и почему одновременно верны утверждения «разработчик всё равно должен передавать полные объявления инструментов» и «модели не нужно заранее читать полную схему»
- Полную цепочку выполнения от регистрации инструмента до
function_call, а также разделение серверного и клиентского поиска - 4 идентификатора моделей, которые сейчас явно поддерживаются, стандартные цены и смысл фразы «отдельной платы за функцию нет, но токены тарифицируются как обычно»
- Два официальных примера расчёта с противоположным направлением: когда экономия есть, а когда выходит дороже
- Ограничения, которые нужно учитывать перед подключением, и способы понять, стоит ли вашему агенту это внедрять
Навигация по материалу: дальше сначала идёт таблица концепций и краткий обзор влияния, чтобы быстро синхронизироваться по контексту. В разделе «Объективные факты» последовательно описаны информация о релизе, механизм работы, гибридная загрузка и удалённый MCP, поддерживаемые модели и стоимость, ограничения использования — всё по официальному анонсу Google и документации для разработчиков. В разделе «Анализ и выводы» даны оценка подходящих сценариев, методика измерения базовой линии перед миграцией и несколько частых вопросов; материалы, содержащие оценки или прогнозы, будут отмечены отдельно.
Gemini API Tool Retrieval: что нужно знать заранее (To Know)
| Понятие | Краткое объяснение |
|---|---|
| Tool Retrieval | Сначала выполняется поиск нужных инструментов, а затем полные определения параметров найденных инструментов добавляются в контекст модели |
| Interactions API | Интерфейс Gemini для агентов: управляет историей взаимодействий, шагами выполнения инструментов и выводом модели; официально доступен с июня 2026 года |
| Схема параметров | Структура, описывающая, какие параметры принимает функция, какие у них типы и какие обязательны; обычно выражается через JSON Schema |
| Function Calling | Модель генерирует имя функции и параметры, приложение выполняет функцию и возвращает результат модели |
tool_search |
Тип инструмента, который объявляет механизм поиска инструментов; с его помощью модель находит и загружает определения инструментов |
defer_loading |
Настройка серверного режима, которая откладывает загрузку полных определений параметров инструментов до момента, когда инструмент будет найден при поиске |
short_description |
Краткое описание отложенного инструмента, по которому модель распознаёт его в начальном каталоге |
| Удалённый MCP | Подключение инструментов, предоставляемых сторонними сервисами вне приложения, через Model Context Protocol |
| Неявное кэширование | Платформа автоматически переиспользует одинаковый префикс контекста; для совпавшей части применяется тариф для кэшированного ввода |
Краткий обзор влияния Tool Retrieval в Gemini API
-
Разработчикам, которые подключают к агенту много бизнес-инструментов: теперь можно не строить собственный инструмент поиска — модель будет сама читать схемы десятков и даже сотен инструментов по мере необходимости. Правда, полный массив инструментов всё равно придётся отправлять в каждом запросе, а кэширование и тарификацию нужно пересмотреть. Перед миграцией стоит на текущем процессе Function Calling замерить, сколько реально занимают определения инструментов — например, через такой унифицированный мультимодельный интерфейс, как APIYI apiyi.com, можно быстро получить контрольную базовую линию.
-
Продуктовым менеджерам и тем, кто отвечает за затраты: отдельной платы за функцию нет, но каждый серверный поиск запускает дополнительный вывод модели. Экономия зависит от масштаба набора инструментов, длины контекста и частоты поиска. Проверять это нужно по полям в счёте, а не только по рекламным заявлениям.
-
Приложениям с небольшим набором инструментов и стабильными вызовами: официальные примеры расчёта показывают, что при небольшом наборе инструментов в сочетании с длинным контекстом общее число токенов, наоборот, растёт. Так что продолжать загружать инструменты напрямую — более надёжный выбор.
-
Командам, работающим с агентскими фреймворками: это новая возможность на уровне API модели, и фреймворки не обязательно сразу её поддержат. Не стоит считать, что вопрос постепенной загрузки на уровне фреймворка уже решён сам собой.
Объективные факты: что именно выпустил Gemini API Tool Retrieval
Информация о выпуске Gemini API Tool Retrieval и предыстория
Официальный блог Google 19 ноября 2026 года опубликовал материал «Introducing Tool Retrieval in the Gemini API». Его авторы — продакт-менеджер Gemini API Люсия Лорер (Lucia Loher) и научный сотрудник Google DeepMind Нора Касснер (Nora Kassner). Сейчас функция находится на стадии Preview: она доступна только в Interactions API и требует версии v1beta. Старый метод generateContent её не поддерживает.
Подготовка на инженерной стороне началась раньше анонса. 18 ноября официальный Python SDK от Google выпустил v3.6.0 — в списке изменений указано, что добавлены публичные Schema, связанные с Tool Retrieval и результатами функций. В тот же день Go SDK v1.79.0 тоже получил соответствующие обновления. Судя по хронологии, речь идёт о том, что уже вышедший в GA Interactions API дополняется возможностями обнаружения инструментов и их загрузки по требованию, а не о запуске нового API-продукта.
Запросы от разработчиков тоже документированы. 18 марта 2026 года разработчик открыл Issue #2185 в репозитории Python SDK с просьбой поддержать defer_loading и tool_search. Причина: после подключения к агенту более 30 инструментов полная Schema раздувает контекст. Сопровождающие Google 20 марта ответили и зарегистрировали это как запрос на новую функцию. Это отзывы о потребностях, а не тесты производительности.
Если сформулировать Tool Retrieval одной фразой: инструменты можно сначала обнаружить, а конкретные параметры читать уже тогда, когда их нужно вызвать.
Как Tool Retrieval меняет способ загрузки Schema инструментов
При традиционной статической загрузке даже если пользователь хочет всего лишь оформить возврат, объявления параметров десятков инструментов — заказы, логистика, склад, CRM и так далее — попадают в контекст при каждом выводе модели. В документации Google упоминается, что несколько десятков объявлений функций могут занимать десятки тысяч токенов. Это съедает место в истории диалога, а когда похожих инструментов много, они ещё и могут мешать модели выбрать правильный.
Ключевой момент Tool Retrieval — разделение на три уровня:
- Уровень API-запроса: разработчик как обычно отправляет полное определение инструментов, включая Schema параметров.
- Начальный контекст модели: инструменты, помеченные
defer_loading: true, появляются только в виде названия плюсshort_description. Если краткое описание не настроено, берётся первое предложение полногоdescription. - Этап вызова инструмента: после того как инструмент найден при поиске, полная Schema попадает в контекст, и модель на её основе генерирует вызов с параметрами.
Так что фраза из заголовка «больше не загружает все параметры инструментов каждый раз» точнее всего означает, что модель больше не читает все полные параметры заранее на каждом раунде, а не то, что разработчику больше не нужно отправлять полные объявления. В серверном режиме официально требуется заново отправлять полный массив tools при каждом запросе, даже если используется previous_interaction_id.
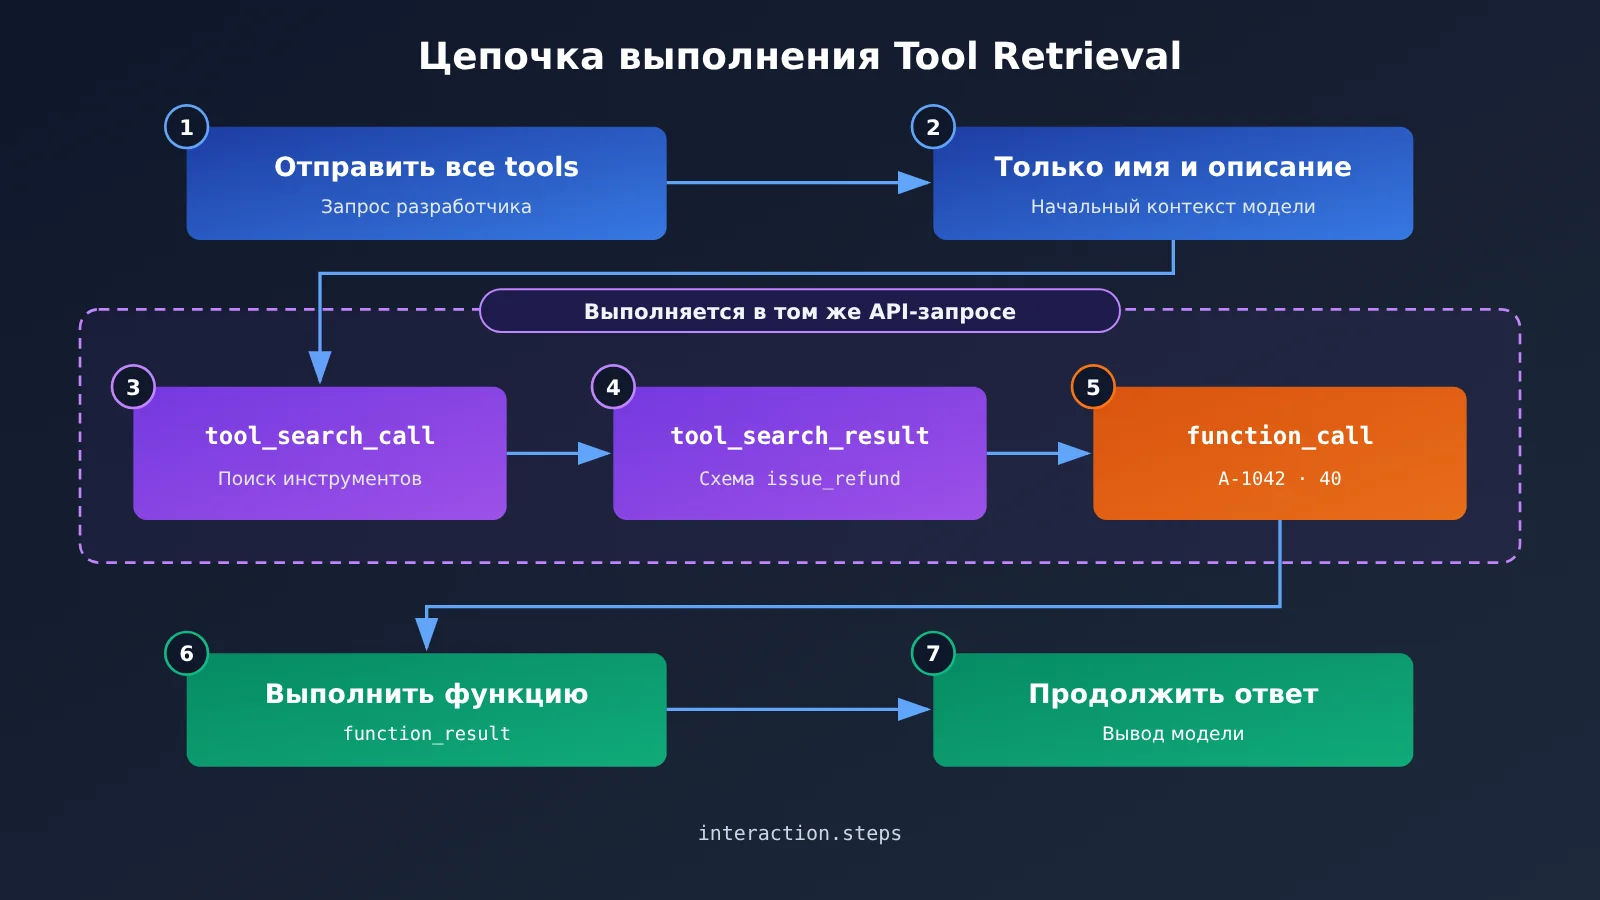
Цепочка выполнения Tool Retrieval: на примере официального сценария возврата средств
Google в своём анонсе использовал сценарий возврата средств по заказу: товар из заказа A-1042 прибыл повреждённым, пользователь требует вернуть 40 долларов США, а нужный для этого инструмент — issue_refund. Полный процесс серверного поиска выглядит так:
- В запросе объявляется
{"type": "tool_search"}, а для редко используемых инструментов вродеissue_refundустанавливаетсяdefer_loading: true. - Модель, исходя из задачи, понимает, что ей нужна возможность возврата средств, и инициирует
tool_search_call. - API возвращает
tool_search_result, содержащий полную схему параметровissue_refund. - Модель читает определение параметров и генерирует
function_callс параметрамиorder_id: "A-1042"иamount: 40. - Приложение выполняет функцию и возвращает
function_result, на основании которого модель продолжает выполнение задачи.
Поиск, загрузка и генерация вызова функции могут происходить в рамках одного и того же внешнего запроса к API, и все шаги можно просмотреть в interaction.steps. Но учтите: один запрос не означает, что внутри выполняется только одно рассуждение — каждый серверный поиск вызывает дополнительный вызов модели, за который нужно платить. Кроме того, это демонстрационный пример, и он не отражает никакой статистики успешности возвратов.
Ниже — пример кода, составленный по официальной документации, с прямым подключением к конечной точке Google; он нужен только для демонстрации структуры запроса:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order.",
        "short_description": "Refund a customer order.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"}
            },
            "required": ["order_id", "amount"]
        }
    }
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Refund 40 USD for order A-1042.",
    tools=tools
)
for step in interaction.steps:
    print(step.type)  # tool_search_call / tool_search_result / function_call
Распределение обязанностей в Function Calling не изменилось. Для пользовательских функций API возвращает только function_call — выполнение возврата, обращение к базе данных и обработка прав доступа по-прежнему остаются работой приложения. И только при подключении к удалённому MCP-серверу API сам инициирует удалённый вызов и возвращает mcp_server_tool_call и mcp_server_tool_result.
Гибридная загрузка Tool Retrieval, удалённые MCP и два режима поиска
Google рекомендует гибридный подход: часто используемые инструменты загружать напрямую, а редкие, узкоспециализированные long-tail инструменты — лениво. Тогда для простых задач не нужно сначала выполнять поиск, а long-tail возможности не занимают контекст постоянно. Удалённые MCP-серверы тоже можно целиком перевести в режим ленивой загрузки — например, добавить defer_loading: true к конфигурации с type: "mcp_server", и инструменты, которые предоставляет этот сервер, будут подгружаться по требованию, без необходимости объявлять каждый по отдельности.
Помимо серверного режима, где поиск выполняет Gemini, официально доступен и клиентский режим: разработчик объявляет tool_search с execution: "client", его приложение само запрашивает реестр инструментов, а затем помещает полные объявления найденных инструментов в function_result.result и возвращает их модели. Различия такие:
| Критерий сравнения | Серверный поиск | Клиентский поиск |
|---|---|---|
| Где выполняется | На сервере Gemini API (по умолчанию server) |
В приложении разработчика (client) |
| Нужно ли создавать свой поисковик | Не нужно | Нужно |
| Нужно ли заранее объявлять библиотеку инструментов | Нужно | Не нужно — новые инструменты можно подключать прямо в ходе сессии |
defer_loading |
Применимо | Неприменимо |
| Дополнительные сетевые запросы | Без дополнительных клиентских обращений | На каждый поиск — дополнительный запрос |
| Контроль доступа | Определяется набором инструментов, объявленных в запросе | Можно совместить со своей фильтрацией прав на уровне пользователя |
| Типичные сценарии | Крупный, относительно фиксированный набор инструментов | Динамическая библиотека инструментов, мультиарендность, корпоративный приватный реестр |
В клиентском режиме возвращаемые объявления функций должны быть структурированными объектами, а не JSON-строками. В одном запросе нельзя смешивать оба режима, и объявить можно не более одного tool_search.
Какие модели поддерживает Gemini API Tool Retrieval и сколько это стоит
В анонсе Google формулировка довольно широкая: говорится, что поддерживаются Gemini 3.6 и все более новые модели, включая все модели Gemini 4. Но в документации для разработчиков на 20 ноября явно указаны только четыре ID моделей. При внедрении ориентируйтесь на документацию: если задать defer_loading для неподдерживаемой модели, API вернёт HTTP 400.
| ID модели | Стандартная цена ввода (долл. США за миллион токенов) | Стандартная цена вывода (включая Thinking) | Примечание |
|---|---|---|---|
gemini-4-hydrogen |
$1.50 | $7.50 | отмечена Free Tier |
gemini-4-argon |
$2.00 (с 1 декабря $4.00) | $10.00 (с 1 декабря $20.00) | нет Free Tier |
gemini-3.8-flash |
$0.75 (с 1 января 2027 года $1.50) | $3.75 (с 1 января 2027 года $7.50) | отмечена Free Tier |
gemini-3.6-flash |
$0.75 (с 1 января 2027 года $1.50) | $3.75 (с 1 января 2027 года $7.50) | отмечена Free Tier |
Цены взяты из тарифа Standard на странице тарифов Google Gemini Developer API. Фактические квоты и ограничения скорости для Free Tier нужно уточнять для каждого проекта.
Что касается биллинга, Google прямо говорит, что за Tool Retrieval нет отдельной платы за функцию, но это не значит, что поиск бесплатный. Сокращённый список отложенных инструментов, фиксированные поисковые инструкции, которые добавляются после включения tool_search, дополнительные рассуждения при каждом поиске на стороне сервера, загруженная полная схема и её сохранение в последующих ходах — всё это расходует токены по тарифу выбранной модели. При контроле затрат обращайте особое внимание на поле total_tool_use_tokens: в нём фиксируется дополнительный входной объём вызовов модели, вызванный поиском на стороне сервера. Если смотреть только на снижение токенов первого ввода, легко переоценить экономию.
Официальные примеры расчёта токенов для Tool Retrieval
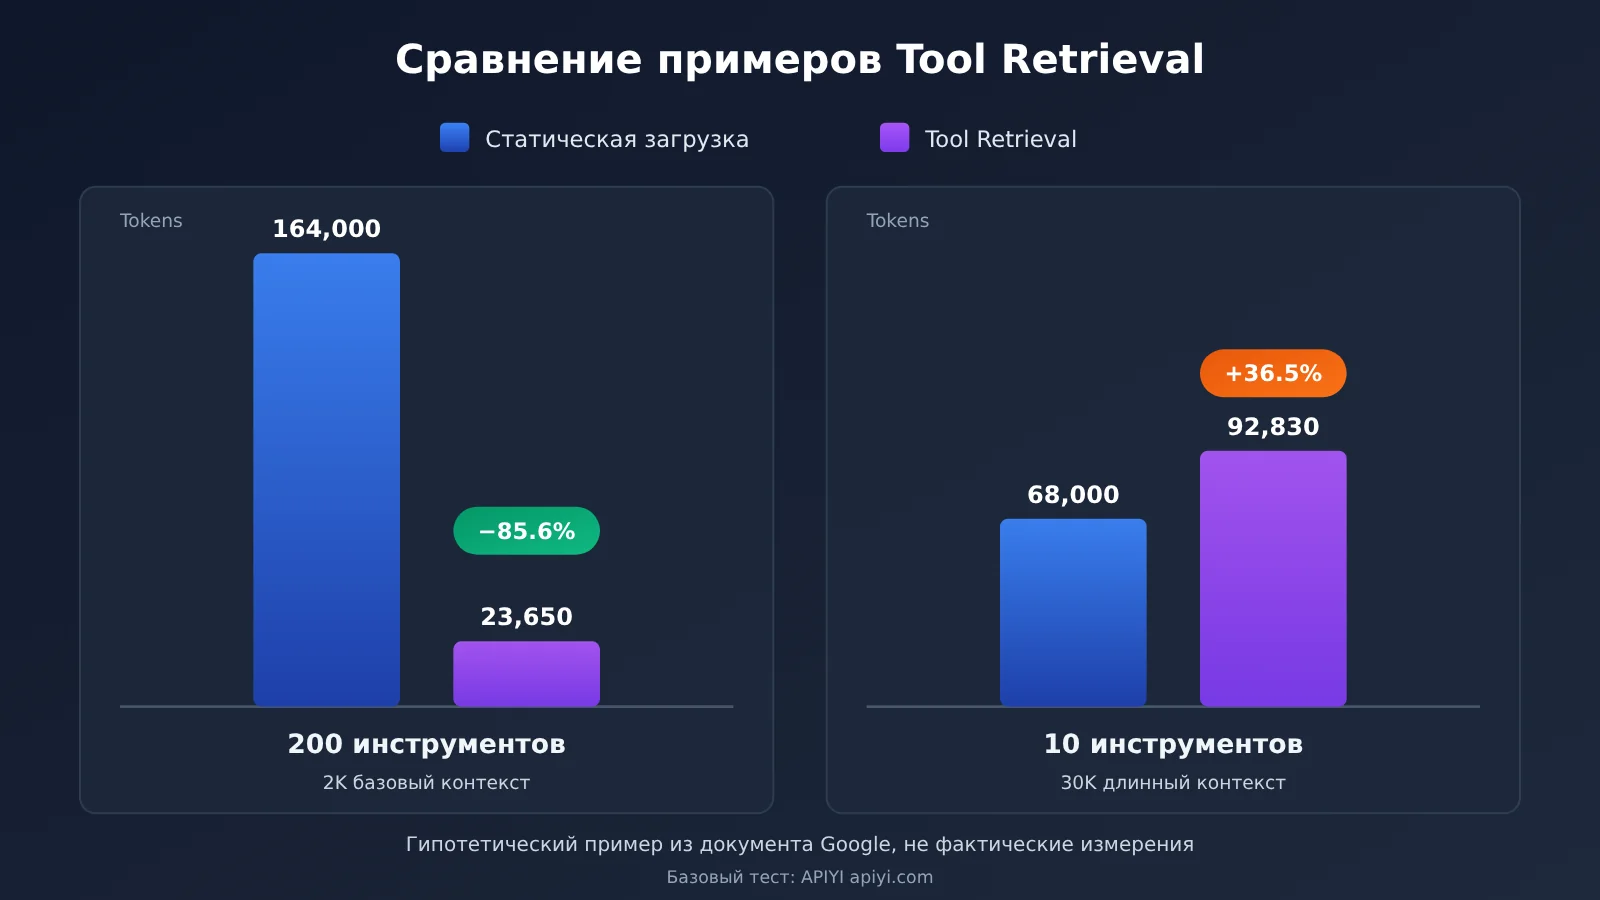
Ранние официальные тесты показали, что каждый отложенный инструмент в начальном каталоге занимает в среднем около 26 Tokens. Это приблизительная величина, а не фиксированные накладные расходы. В документации также приведены два гипотетических примера расчёта, и выводы в них противоположны:
| Сценарий (официальное допущение) | Статическая загрузка всех инструментов | Tool Retrieval | Изменение |
|---|---|---|---|
| 200 инструментов, по 400 Tokens каждый, базовый контекст 2,000, используются 2 инструмента, всего 2 запроса | 164,000 | около 23,650 | снижение примерно на 85.6% (по расчётам примера) |
| 10 инструментов, по 400 Tokens каждый, базовый контекст 30,000, используются 2 инструмента, всего 2 запроса | 68,000 | 92,830 | рост примерно на 36.5% (по расчётам примера) |
Вторая группа примеров выходит дороже потому, что серверный поиск требует дополнительного прохода инференса и повторной обработки уже длинного контекста, а сами 10 инструментов занимают немного — экономия на Schema не перекрывает затраты на поиск. Обе группы цифр — это гипотетические примеры, которые сам Google обозначил как таковые; в них не учтены выходные токены и выгода от кэширования, и это не бенчмарк для продакшена. На момент проверки материалов Google не опубликовал измеренную долю экономии токенов, улучшение задержки или прирост точности выбора инструментов для этой функции.
Что касается кэширования, Google говорит, что Tool Retrieval поддерживает неявное кэширование: полная Schema не попадает в начальный префикс, поэтому системные инструкции, каталог инструментов и другие префиксы легче остаются стабильными. Но в документации есть и предупреждение: отложенная загрузка укорачивает исходный промпт, и запросы, которые раньше дотягивали до минимального порога кэша только за счёт большого объёма Schema, могут из-за этого оказаться ниже порога.
Текущие ограничения использования Tool Retrieval
Несколько моментов из официальной документации, на которых проще всего споткнуться при разработке:
- Загруженные инструменты нельзя выгрузить: как только Schema извлечена, она остаётся в текущей сессии до самого конца. Если в длинной сессии постоянно извлекать новые инструменты, контекст продолжит расти.
- При каждом запросе нужно заново отправлять полный массив инструментов: включая
tool_search, все отложенные и неотложенные инструменты, а также соответствующие конфигурации MCP. Нельзя передать толькоnameиshort_description, опустивparameters. - Инструменты, явно названные в системных инструкциях, не стоит задерживать: модель может вызвать их напрямую, минуя поиск, что приведёт к ошибке из-за отсутствия контекста загрузки.
- В сессиях без сохранения состояния нужно полностью сохранять шаги извлечения: если вы управляете историей самостоятельно с помощью
store=false, тоtool_search_call,tool_search_resultи ихsignatureнельзя удалять или изменять, иначе можно получить HTTP 400. - При отладке смотрите на steps: даже если
interaction.statusне равенrequires_action, в результате может оказаться ожидающий выполненияfunction_call. - При отсутствии совпадений может вернуться текст: когда серверный поиск не находит подходящих инструментов, он не обязательно возвращает структурированную ошибку.
Анализ: что Gemini API Tool Retrieval значит для разработки агентов
Когда Tool Retrieval уместен
Реальная ценность этого обновления в том, что оно разделяет две вещи: «поддержание полного списка инструментов» и «чтение этого списка на каждом шаге рассуждения». Библиотека инструментов может продолжать расти, а в контексте модели постоянно находится лишь очень тонкий каталог. Для команд, которые постоянно подключают новые бизнес-системы, это снижает нагрузку по предварительному урезанию набора инструментов, а также уменьшает случаи, когда ради контроля над токенами приложение на каждом шаге динамически фильтрует инструменты и из-за этого ломает префикс кэша.
Но официальный пример расчёта уже показывает, что выгода не безусловна. С учётом официальных инженерных рекомендаций можно ориентировочно оценить ситуацию по таблице ниже (это рекомендации для выбора решения, а не жёсткие количественные пороги):
| Тип агента | Характеристики инструментов | Рекомендация |
|---|---|---|
| Поддержка клиентов, помощник для бизнес-процессов | Несколько десятков инструментов; несколько часто используемых инструментов для запросов; возвраты, согласования, договоры и т. п. используются редко | Часто используемые загружать напрямую, для длинного хвоста — серверный поиск |
| Агент для разработки/эксплуатации с несколькими MCP-серверами | На каждом сервере много инструментов, в одной задаче используется лишь малая часть | Для MCP-сервера целиком задать defer_loading |
| Платформа с мультитенантностью и доступом к инструментам по правам | Набор инструментов зависит от пользователя и рабочего пространства | Клиентский поиск в сочетании с собственным реестром и фильтрацией по правам |
| Небольшой помощник | Менее ~20 стабильных инструментов, большинство используется на каждом шаге | Продолжать статическую загрузку |
| Длинный контекст + частый поиск | Диалог очень длинный, на каждом шаге часто требуется несколько поисков | Сначала измерить, потом решать; есть риск роста чистых затрат |
Наша оценка такова: чем более «длиннохвостым» является распределение вызовов инструментов, тем больше смысла использовать Tool Retrieval. И наоборот, если большинство инструментов нужно на каждом шаге, отложенная загрузка лишь добавит одно дополнительное рассуждение с поиском.
Прежде чем переходить на Tool Retrieval, измерьте реальный расход на схему инструментов
Самый надёжный критерий для решения о миграции — данные вашего собственного бизнеса. Перед миграцией можно на существующем процессе Function Calling, совместимом с OpenAI, сначала измерить разницу во входных токенах между двумя запросами — «все инструменты» и «только фактически используемые инструменты» — и получить реальный расход на схему инструментов. Скрипт ниже делает именно это базовое измерение, а не сам Tool Retrieval:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI для измерения базовой линии статической загрузки
)

def make_tool(name, desc):
    return {"type": "function", "function": {
        "name": name, "description": desc,
        "parameters": {"type": "object",
                       "properties": {"order_id": {"type": "string"}},
                       "required": ["order_id"]}}}

all_tools = [make_tool(f"crm_tool_{i}", f"CRM operation {i}") for i in range(50)]
messages = [{"role": "user", "content": "查询订单 A-1042 的状态"}]

for label, tools in [("全量 50 个工具", all_tools), ("仅 1 个工具", all_tools[:1])]:
    resp = client.chat.completions.create(
        model="your-model-id", messages=messages, tools=tools)
    print(label, "prompt_tokens =", resp.usage.prompt_tokens)
Посмотреть полный скрипт базового измерения (сравнение по количеству инструментов)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Измерение накладных расходов на схему инструментов у разных моделей через единый интерфейс APIYI
)

def load_tools(path: str) -> list:
    """Читает определения инструментов в формате OpenAI из реестра бизнес-инструментов (JSON-файла)"""
    with open(path, "r", encoding="utf-8") as f:
        return json.load(f)

def measure(model: str, tools: list, prompt: str) -> int:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools if tools else None,
        max_tokens=16,
    )
    return resp.usage.prompt_tokens

def baseline_report(model: str, tools: list, prompt: str, steps=(0, 10, 20, 50, 100)):
    base = measure(model, [], prompt)
    print(f"无工具基础输入: {base} tokens")
    for n in steps:
        if n == 0 or n > len(tools):
            continue
        used = measure(model, tools[:n], prompt)
        print(f"{n:>4} 个工具: {used} tokens, Schema 约占 {used - base} tokens")

if __name__ == "__main__":
    tools = load_tools("tool_registry.json")
    baseline_report("your-model-id", tools, "查询订单 A-1042 的状态")
🎯 Совет по технике: прежде чем оценивать Tool Retrieval, можно через APIYI apiyi.com с одним API-ключом прогнать базовую линию статической загрузки на нескольких популярных моделях и увидеть, сколько токенов схема инструментов реально занимает в вашем запросе. Получив базовую линию, включите в Gemini Interactions API
tool_searchдля сравнения и сопоставьте суммуtotal_input_tokensиtotal_tool_use_tokens.
Нужно оговориться: Tool Retrieval опирается на интерфейс v1beta Interactions API и специализированные поля; приведённый выше вызов, совместимый с OpenAI, служит только для оценки накладных расходов при статической загрузке. При сравнительном тестировании советуем держать одинаковыми модель, библиотеку инструментов, набор задач, длину контекста и условия кэширования, а затем сравнивать итоговую стоимость, сквозное время выполнения, долю правильного выбора инструментов и среднее количество поисков. Так различия можно будет объяснить именно стратегией извлечения. Если хочется в одном и том же наборе скриптов сопоставить базовые показатели разных моделей, единый интерфейс APIYI apiyi.com избавит от необходимости подключать каждую модель по отдельности.
Что стоит отслеживать в дальнейшем (прогнозные суждения)
Ниже — суждения, а не подтверждённые факты.
Во-первых, в объявлении и документации для разработчиков есть расхождения в охвате поддерживаемых моделей; попадут ли Gemini 4 Carbon, Gemini 4 Neon и другие модели в список совместимых, нужно следить по обновлениям документации. Во-вторых, невозможность выгрузить уже загруженную схему — заметная слабость Agent в длинных сессиях; появится ли в официальной версии механизм выгрузки или вытеснения, напрямую повлияет на его работу в длительных задачах. В-третьих, пользователи Google ADK ранее сообщали в Issue #7241 о проблемах постепенной загрузки и инвалидации кэша; то, что API модели поддерживает новую возможность, не означает, что фреймворк автоматически её внедрит, — за темпами адаптации на уровне фреймворка стоит следить.
Идея загружать определения инструментов по требованию уже встречалась в отрасли и раньше; Google на этот раз, по сути, добавила её в интерфейс Agent для Gemini. Поскольку на этапе Preview интерфейс может измениться, при подключении к продакшн-системам рекомендуется сохранить переключатель для возврата к статической загрузке.
Несколько частых вопросов о Gemini API Tool Retrieval
Q1: Если включить Tool Retrieval, тело запроса станет меньше?
Нет. В серверном режиме каждый запрос по-прежнему отправляет полный массив инструментов — меньше становится только доля, которую инструменты занимают в начальном контексте модели. Если хочется сначала оценить объём определений инструментов в текущем запросе, можно воспользоваться скриптом из предыдущей части и замерить базовый уровень через APIYI apiyi.com.
Q2: Google официально говорит об экономии 85%?
Таких результатов реальных замеров нет. 85,6% — это расчёт по гипотетическому примеру с 200 инструментами; в том же документе приводится и обратный случай: на небольшом наборе инструментов количество токенов выросло примерно на 36,5%.
Q3: Tool Retrieval — платная функция?
Отдельной платы за функцию нет, но команды поиска, дополнительный инференс и загружаемые схемы тарифицируются как токены по ставке модели. Командам, чувствительным к бюджету, стоит сначала на APIYI apiyi.com провести небольшие тесты затрат на Function Calling у разных моделей с оплатой по факту использования, а уже потом выбирать модель для агента.
Q4: С Tool Retrieval больше не нужно самому выполнять функции?
Нет. Пользовательские функции по-прежнему выполняет приложение и возвращает результат обратно; Tool Retrieval лишь находит и загружает определения инструментов. И только удалённые MCP-инструменты вызываются API за вас.
Библиотека инструментов будет расти, но в каждом отдельном раунде реально нужны лишь некоторые из них. Tool Retrieval разделяет «подготовить все инструменты» и «брать нужное по мере надобности»: при умелом использовании крупный агент становится легче, а при неумелом можно доплатить лишним раундом инференса. Как сказано в «Лунь юй», глава «Вэй Лин-гун»: «Ремесленник, желающий хорошо сделать своё дело, должен сначала отточить свои орудия». Сначала измерьте вес каждого «орудия» в руках, а потом решайте, как его разместить.
📚 Справочные материалы
-
Официальное объявление Google: Introducing Tool Retrieval in the Gemini API (2026-11-19)
- Ссылка:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - Описание: информация о выпуске, цели дизайна, два режима поиска и принципы ценообразования
- Ссылка:
-
Документация для разработчиков Google Tool Retrieval: конфигурация, ограничения, тарификация и примеры расчётов
- Ссылка:
aistudio.google.com/docs/tool-retrieval - Описание: список поддерживаемых моделей, поля Usage, лучшие практики и распространённые ошибки
- Ссылка:
-
Ценообразование Gemini Developer API: стандартные цены моделей и тарифы кеширования
- Ссылка:
aistudio.google.com/docs/pricing - Описание: цена за вход и выход для каждой модели и даты вступления в силу
- Ссылка:
-
Документация Interactions API: назначение интерфейса и порядок выполнения
- Ссылка:
aistudio.google.com/docs/interactions-overview - Описание: диалоги с сохранением состояния, структура steps и отличия от generateContent
- Ссылка:
-
Google Python SDK v3.6.0 и Issue #2185: инженерные подтверждения и запросы разработчиков
- Ссылка:
github.com/googleapis/python-genai/releases/tag/v3.6.0 - Ссылка:
github.com/googleapis/python-genai/issues/2185 - Описание: обновления публичной схемы SDK и ранние запросы сообщества
- Ссылка:
Автор: техническая команда APIYI
Техническая связь: добро пожаловать на главную страницу APIYI apiyi.com, чтобы связаться с нами. Больше материалов по интеграции — в документационном центре docs.apiyi.com