Примечание автора: в этой статье рассказывается, как собрать персонального AI-агента своими силами — на модельном API, инструментах, памяти, планировщике и среде выполнения. В качестве примера взят рабочий процесс AI-новостной разведки, чтобы показать зоны ответственности и стоимость каждой части самодельной системы.
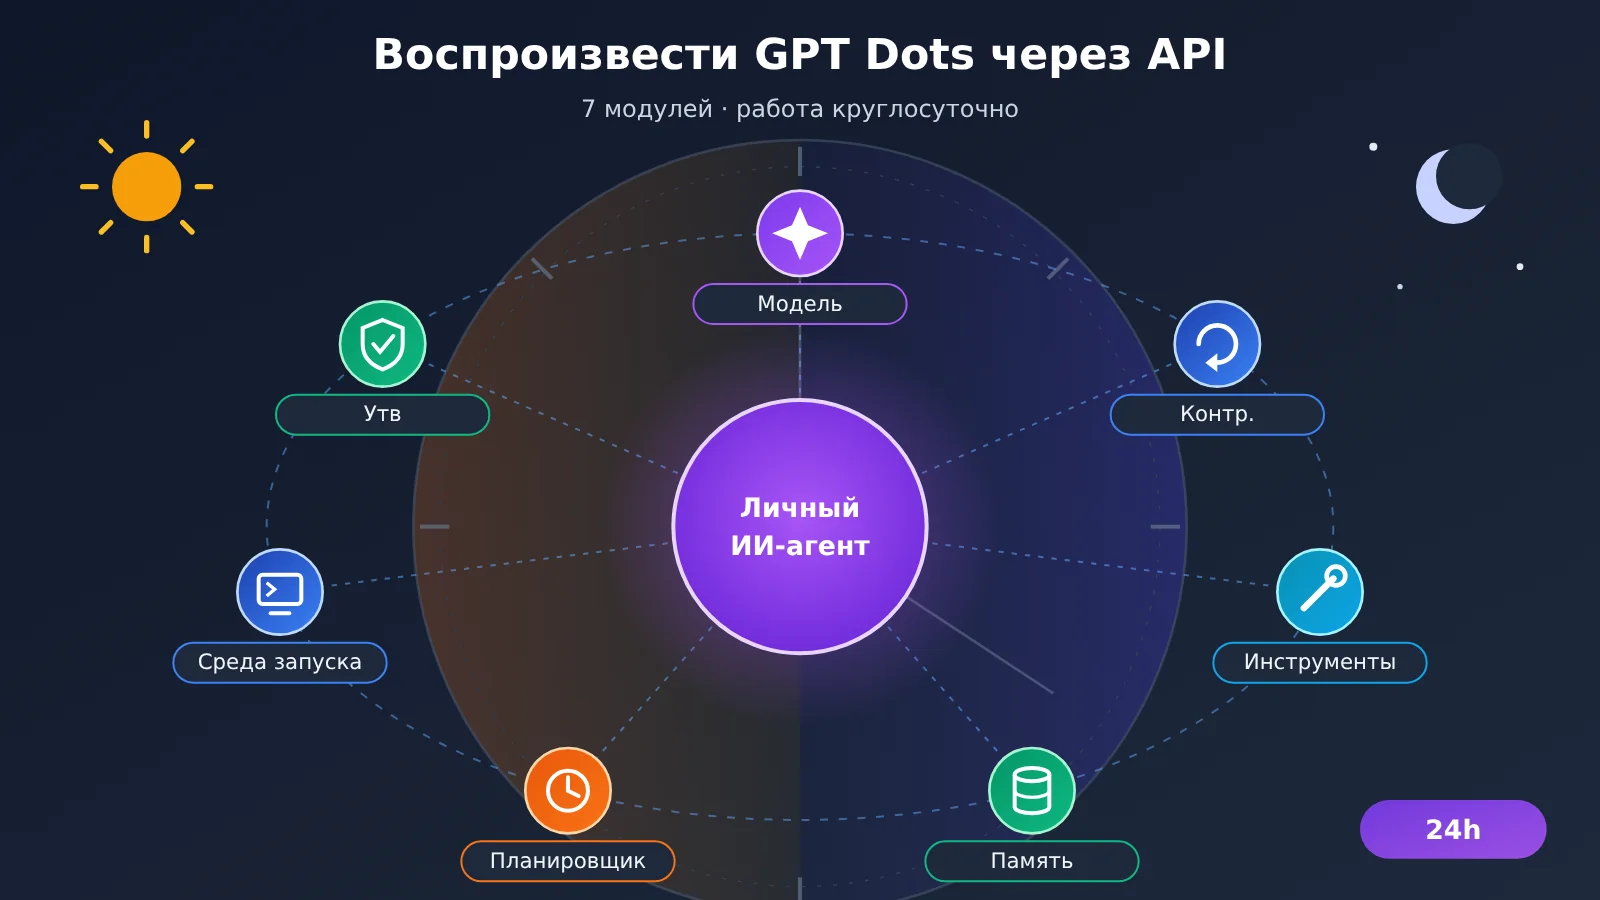
Воспроизвести GPT Dots через API можно — воспроизводится его режим работы: модель принимает решения, программа выполняет, база данных хранит память, планировщик двигает задачи дальше, пока вас нет. Модельный API — лишь один из слоёв. Систему инструментов, долговременную память, очередь задач, среду выполнения и механизм подтверждений разработчику приходится строить самому. Проприетарная конфигурация моделей OpenAI, облачный компьютер и экосистема из 4 000+ приложений относятся к самому продукту Dots — всё это через API напрямую не получить. «24 часа» в заголовке означают, что агент по расписанию продолжает продвигать задачи в фоне; фактическое время доступности системы зависит от сервера, очереди и механизмов повторных попыток.
Дальше текст идёт в порядке сборки. В части 1 Dots разбирается на 7 модулей и помечается, что даёт модель, а что нужно строить самому. Части 2–6 последовательно реализуют подключение модели, вызов инструментов, долговременную память, фоновое планирование и среду выполнения. В части 7 эти компоненты собираются в полный проект Personal AI Radar. В части 8 считается общая стоимость, включая расходы вне модели, и объясняются границы возможностей самодельного решения.
Что нужно знать: термины перед воспроизведением GPT Dots
| Термин | Пояснение |
|---|---|
| API | Интерфейс, через который приложение вызывает модель или внешний сервис; в этой статье речь в основном об интерфейсе вызова больших языковых моделей |
| Agent | Прикладная система, которая использует модель для принятия решений и вызова инструментов, чтобы продвигать задачу |
| Function Calling | Модель выдаёт структурированный запрос на вызов инструмента, ваш код его выполняет и возвращает результат обратно модели |
| tool_use / tool_result | Типы сообщений в интерфейсе Claude Messages — запрос на вызов инструмента и результат его выполнения |
| SQLite | Встраиваемая база данных в одном файле, подходит для хранения предпочтений, состояния задач, логов и других лёгких данных |
| Векторный поиск | Преобразование текста в векторы и поиск релевантных материалов по семантическому сходству |
| Очередь задач | Хранит задачи, ожидающие выполнения, и раздаёт их фоновым Worker’ам по порядку или приоритету |
| Checkpoint | Снимок прогресса, сохраняемый на определённом шаге выполнения задачи; после прерывания работа продолжается с этой точки |
| Среда выполнения | Компьютер или контейнер, где фактически работают браузер, код и операции с файлами |
| Playwright | Библиотека автоматизации для управления браузером из кода: открывает страницы, выполняет клики, извлекает контент |
| Prompt Injection | Атака, при которой в веб-странице или документе прячут вредоносные инструкции, пытаясь перехватить управление поведением Agent |
| MCP | Открытый протокол, соединяющий приложения с моделями и внешние инструменты и источники данных |
1 Из каких модулей состоит GPT Dots
1.1 Официальные возможности GPT Dots
Dots — это постоянно работающий персональный AI-агент, который OpenAI выпустила 29 сентября 2026 года. По официальным материалам, у него есть собственный облачный компьютер и браузер, а задачи, уже поставленные в облаке, продолжают выполняться даже после того, как пользователь выключил компьютер. Он умеет объединять память ChatGPT, собственные заметки и данные подключённых приложений, вести несколько проектов одновременно и общаться с пользователем через ChatGPT, Slack, Microsoft Teams и другие каналы.
В работе Dots есть три ключевых механизма. Проактивные исследования (Proactive Research) в фоне читают разрешённые источники и формируют исследовательские заметки — процесс только на чтение, а любые последующие действия проходят обычную процедуру согласования. Планировщик задач и мониторинг событий позволяют Dot работать по расписанию или по событию. Custom Rules и Auto-review проверяют права и намерения пользователя перед такими операциями, как отправка письма или покупка, а高风险-операции вроде перевода денег или смены пароля обязательно должны переходить под контроль пользователя.
1.2 Семь модулей GPT Dots и их аналоги при самостоятельной сборке
Если разобрать возможности Dots на части, получится 7 модулей. В таблице ниже показано, как каждый модуль реализуется в схеме самостоятельной сборки:
| Модуль | Как это выглядит в Dots | Реализация при самостоятельной сборке | Кто предоставляет |
|---|---|---|---|
| Модель | Рассуждения, планирование, выбор инструментов | API моделей GPT, Claude, Gemini, DeepSeek и др. | Сервис моделей |
| Контроллер агента | Декомпозиция задач, координация нескольких проектов | Собственный цикл или LangGraph, OpenAI Agents SDK | Разработчик |
| Инструменты | Браузер, плагины приложений, Codex | Function Calling + собственные функции-инструменты, сервисы MCP | Разработчик |
| Память | ChatGPT Memory, заметки Dot, контекст проекта | SQLite + векторный поиск + файловая система | Разработчик |
| Планировщик задач | Задачи по расписанию, мониторинг событий, фоновый Agent | APScheduler, Celery, очередь Redis | Разработчик |
| Среда выполнения | Отдельный облачный компьютер | Облачный сервер, Docker, Playwright | Разработчик |
| Согласование безопасности | Custom Rules, Auto-review, передача управления пользователю | Белый список инструментов, очередь согласований, журнал операций | Разработчик |
В таблице только первая строка обеспечивается напрямую API модели, а остальные шесть строк требуют инженерной реализации. Именно поэтому «одним API-ключом полную функциональность Dots не получить»: API-ключ открывает доступ к вызову модели, а «руки, ноги», память и режим работы агента придётся строить самому.
2. Подготовка интерфейсов моделей, необходимых для воспроизведения GPT Dots
2.1. Подключение разных моделей через APIYI
APIYI apiyi.com предоставляет интерфейс, совместимый с OpenAI, и нативный интерфейс Claude Messages. Один API-ключ позволяет вызывать модели разных провайдеров. Модели работают по разным протоколам, поэтому при настройке их нужно различать:
| Тип модели | Протокол | Base URL | Поле вызова инструментов |
|---|---|---|---|
| GPT, DeepSeek, Qwen и другие модели, совместимые с OpenAI | OpenAI Chat Completions | https://api.apiyi.com/v1 |
tools / tool_calls |
| Claude | Anthropic Messages (/v1/messages) |
https://api.apiyi.com |
tool_use / tool_result |
| Gemini | Протокол, совместимый с Gemini | Настройка через соответствующий интерфейс согласно официальной документации | Согласно соответствующему протоколу |
ID моделей и актуальные цены смотрите в списке моделей на платформе. В приведённом ниже коде идентификатор модели единообразно считывается из переменной окружения: чтобы сменить модель, достаточно изменить конфигурацию — код агента остаётся прежним.
2.2 Минимальный вызов модели для воспроизведения GPT Dots
Сначала проверьте, что интерфейс отвечает. Сохраните код ниже как llm.py — в последующих главах client будет импортироваться именно отсюда:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # OpenAI-совместимый интерфейс APIYI
)
MODEL = os.environ["RADAR_MODEL"]  # Укажите реально доступный ID модели из списка моделей

if __name__ == "__main__":
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "用三句话说明什么是个人 AI Agent"}],
    )
    print(resp.choices[0].message.content)
Если Claude работает через нативный интерфейс Messages, используйте Anthropic SDK — Base URL указывается без /v1:
import os
import anthropic

claude = anthropic.Anthropic(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com",  # SDK сам добавит /v1/messages
)

resp = claude.messages.create(
    model=os.environ["CLAUDE_MODEL"],
    max_tokens=1024,
    tools=[{
        "name": "search_news",
        "description": "检索近期 AI 新闻",
        "input_schema": {
            "type": "object",
            "properties": {"query": {"type": "string"}},
            "required": ["query"],
        },
    }],
    messages=[{"role": "user", "content": "查一下今天的模型发布新闻"}],
)
for block in resp.content:
    if block.type == "tool_use":
        print(block.id, block.name, block.input)
Когда Claude возвращает tool_use, ваша программа выполняет инструмент, а затем отправляет блок tool_result с role: user, связывая его с исходным запросом через tool_use_id. Если инструмент отработал с ошибкой, установите is_error: true — модель учтёт это и скорректирует следующий шаг.
🚀 Быстрый старт: сначала прогоните оба фрагмента кода выше на бесплатном тестовом лимите APIYI и убедитесь, что и OpenAI-совместимая цепочка, и нативная цепочка Claude возвращают вызов инструментов. Только после этого переходите к разработке Agent.
2.3 Различия в совместимости интерфейсов и возможностях вызова инструментов
Совместимость протоколов решает вопрос «можно ли вообще отправить запрос», но у разных моделей остаются различия в работе с вызовом инструментов. Методика тестирования вызова инструментов для нескольких моделей, опубликованная APIYI в ноябре 2026 года, выделяет несколько ключевых моментов наблюдения: для серии Gemini важно, выполняются ли параллельные вызовы и не попадает ли лишний текст в итоговый JSON; для серии Qwen — выбор инструмента при наличии отвлекающих инструментов и сопоставление ID между несколькими раундами; для серии Claude — обработка is_error и количество раундов вызова; для серии GPT — степень строгого соблюдения Schema и расход токенов.
Это именно точки внимания при тестировании, без заранее заданного вывода о том, какая модель лучше. Рекомендую дать кандидатам одинаковые определения инструментов и одинаковые задачи, фиксировать число вызовов, число ошибок в параметрах, общий объём токенов и итоговую точность — и уже по данным решать, какая модель станет основной для вашего Agent.
Responses API тоже требует отдельной проверки. В документации APIYI для интерфейса /v1/responses перечислены в основном такие модели, как GPT-4.1 и o3, а текущая документация OpenAI по вызову инструментов указывает, что GPT-6 Astra и GPT-6.1 Sol используют Responses API. Если вы планируете применять возможности Responses API у новых моделей, стоит включить вызов инструментов, встроенные инструменты и управление состоянием в список проверок на совместимость — и выходить в продакшен только после того, как каждый пункт подтверждён на практике.
3. Заставляем агента в стиле GPT Dots выполнять задачи с помощью Function Calling
3.1. Как работает цикл Function Calling
Цикл Function Calling состоит всего из четырёх шагов: программа отправляет модели задачу вместе с определениями инструментов; модель возвращает имя инструмента, который хочет вызвать, и его параметры; программа действительно выполняет этот инструмент; программа дописывает результат выполнения в сообщения и снова отправляет их модели — и та решает, вызывать ли инструменты дальше или уже дать ответ.
Всё решает третий шаг. Модель лишь генерирует запрос на вызов, а обращение к поисковику, чтение и запись файлов, отправку сообщений выполняет ваш код. Поэтому за то, к чему у инструментов есть доступ, как проверяются входные данные и что делать при сбоях, отвечает разработчик.
3.2 Минимальная система из трёх инструментов
Personal AI Radar нужны три базовых инструмента: search_news для поиска новостей, read_file для чтения материалов в рабочей директории и save_note для записи подготовленных результатов в базу данных. Ниже — полный цикл агента:
Посмотреть полный код цикла вызова инструментов, воспроизведённого в GPT Dots
import json
import pathlib
import sqlite3
from llm import client, MODEL

WORKDIR = pathlib.Path("./workspace").resolve()
DB_PATH = "radar.db"

TOOLS = [
    {"type": "function", "function": {
        "name": "search_news",
        "description": "检索近期 AI 新闻,返回标题、链接、发布时间和摘要列表",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {"type": "string"},
                "days": {"type": "integer", "minimum": 1, "maximum": 7},
            },
            "required": ["query"],
        },
    }},
    {"type": "function", "function": {
        "name": "read_file",
        "description": "读取工作目录中的文本文件",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }},
    {"type": "function", "function": {
        "name": "save_note",
        "description": "把一条整理好的新闻资料保存到资料库",
        "parameters": {
            "type": "object",
            "properties": {
                "title": {"type": "string"},
                "url": {"type": "string"},
                "summary": {"type": "string"},
                "project": {"type": "string"},
            },
            "required": ["title", "url", "summary", "project"],
        },
    }},
]

def search_news(query: str, days: int = 1):
    # Подключите выбранный вами поисковый сервис: поисковый API, агрегатор RSS или собственный парсер
    raise NotImplementedError("请接入实际的搜索服务")

def read_file(path: str):
    p = (WORKDIR / path).resolve()
    if not p.is_relative_to(WORKDIR):          # разрешено читать только рабочую директорию
        return {"error": "path outside workspace"}
    return {"content": p.read_text(encoding="utf-8")[:20000]}

def save_note(title: str, url: str, summary: str, project: str):
    with sqlite3.connect(DB_PATH) as db:
        db.execute(
            "INSERT OR IGNORE INTO notes(url, title, summary, project) VALUES (?, ?, ?, ?)",
            (url, title, summary, project),
        )
    return {"saved": True}

REGISTRY = {"search_news": search_news, "read_file": read_file, "save_note": save_note}

def run_agent(task: str, system: str, max_rounds: int = 8) -> str:
    messages = [
        {"role": "system", "content": system},
        {"role": "user", "content": task},
    ]
    for _ in range(max_rounds):
        msg = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS,
        ).choices[0].message
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        for call in msg.tool_calls:
            fn = REGISTRY.get(call.function.name)
            try:
                args = json.loads(call.function.arguments or "{}")
                result = fn(**args) if fn else {"error": "unknown tool"}
            except Exception as e:
                result = {"error": f"{type(e).__name__}: {e}"}
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": json.dumps(result, ensure_ascii=False),
            })
    raise RuntimeError("超过最大工具调用轮次")
В этом коде есть три проектных решения, которые стоит сохранить. max_rounds ограничивает число итераций цикла и не даёт модели снова и снова вызывать один и тот же инструмент, тратя токены. Исключения инструментов упаковываются в {"error": ...} и возвращаются модели — так у неё остаётся возможность сменить параметры или сам подход. А read_file с помощью проверки пути запирает область чтения в пределах рабочего каталога: это самая базовая граница прав доступа.
3.3 Переход от самописного цикла к фреймворку агентов
Самописный цикл подходит для сценариев с одной задачей и небольшим набором инструментов. Когда задаче нужно восстановление после прерывания, ручное утверждение или сложные ветвления, можно перейти на LangGraph: он даёт State для сохранения состояния задачи, Checkpointer для персистентности прогресса и Human-in-the-loop для паузы в ожидании проверки. OpenAI Agents SDK тоже предоставляет оркестрацию рабочих процессов и Guardrails. А когда инструментов становится много, с помощью MCP можно упаковать поиск, работу с файлами, почту и другие возможности в отдельные сервисы, которые переиспользуют сразу несколько агентов.
4. Строим долговременную память для агента в стиле GPT Dots
4.1. Четыре уровня памяти
Контекст Dots складывается из памяти ChatGPT Memory, собственных заметок Dot, контекста текущей задачи и данных подключённых приложений. При этом для новой задачи история подтягивается только по необходимости — полный журнал чата не загружается. Самодельный агент может работать по той же схеме и управлять памятью по уровням:
| Уровень памяти | Что хранит | Жизненный цикл | Когда записывается |
|---|---|---|---|
| Текущий контекст | инструкции текущей задачи, последние результаты инструментов | текущая задача | каждый раунд диалога |
| Память проекта | цели проекта, ключевые решения, прогресс | пока живёт проект | при завершении задачи или изменении решения |
| Память пользователя | предпочтения, интересующие области, формат отчётов | долгосрочно | когда пользователь явно выражает предпочтение |
| Память опыта | причины ошибок, способы исправления | долгосрочно, обновляется по правилам | после провала задачи или правок пользователя |
При каждом вызове модели в промпт попадает только текущий контекст плюс отобранные по релевантности воспоминания. Если запихнуть в запрос всю историю сообщений, это одновременно раздует расход токенов и ухудшит качество поиска.
4.2. Проектирование структуры таблиц SQLite
Схема ниже покрывает четыре уровня памяти и состояние задач, а таблица runs заодно обеспечивает восстановление с точки останова из части 5:
CREATE TABLE IF NOT EXISTS user_memory (
    key TEXT PRIMARY KEY, value TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS projects (
    id TEXT PRIMARY KEY, goal TEXT, decisions TEXT, status TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS runs (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, run_date TEXT,
    next_stage TEXT, state_json TEXT,
    status TEXT, error TEXT, updated_at TEXT,
    UNIQUE (project_id, run_date)
);
CREATE TABLE IF NOT EXISTS notes (
    url TEXT PRIMARY KEY, title TEXT, summary TEXT, project TEXT,
    created_at TEXT DEFAULT CURRENT_TIMESTAMP
);
CREATE TABLE IF NOT EXISTS lessons (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, lesson TEXT, created_at TEXT
);
В notes первичный ключ — URL, поэтому при повторном скачивании одной и той же новости запись автоматически дедуплицируется. Уникальное ограничение (project_id, run_date) в runs гарантирует, что у каждого проекта за день будет ровно одна запись о запуске, — после перезапуска можно найти прогресс за текущий день.
4.3. Векторный поиск для подтягивания исторических материалов
Структурированные данные достаём SQL-запросами, а семантически близкие материалы — векторным поиском. Для этого генерируем эмбеддинги из notes.summary и lessons.lesson, складываем их в векторную БД вроде sqlite-vec или Chroma и записываем в метаданные проект, дату и источник. Когда генерируем темы, сначала ищем по сегодняшним новостям похожие материалы за последние 30 дней и добавляем в промпт несколько найденных саммари — тогда модель может понять, «это продолжение уже существующей темы или совсем новое событие», а пользователю не нужно каждый раз заново объяснять контекст.
5. Как заставить GPT Dots-агент постоянно работать в фоне
5.1 Разница между тремя механизмами фоновой работы
Фоновая работа включает три механизма, и у каждого своя зона ответственности. Запланированные задачи запускаются планировщиком системы (APScheduler, cron) по времени и отвечают на вопрос «когда начать». Фоновые запросы к модели — это асинхронные ответы вроде OpenAI Background Mode: отправляете запрос, получаете response ID, опрашиваете статус и забираете результат; у них свой жизненный цикл и условия хранения данных, и они подходят для однократных длительных рассуждений. Долгосрочное планирование агента строится на очереди задач, персистентном состоянии и Worker’ах и отвечает за продвижение многодневных и многоэтапных задач, повторные попытки и восстановление.
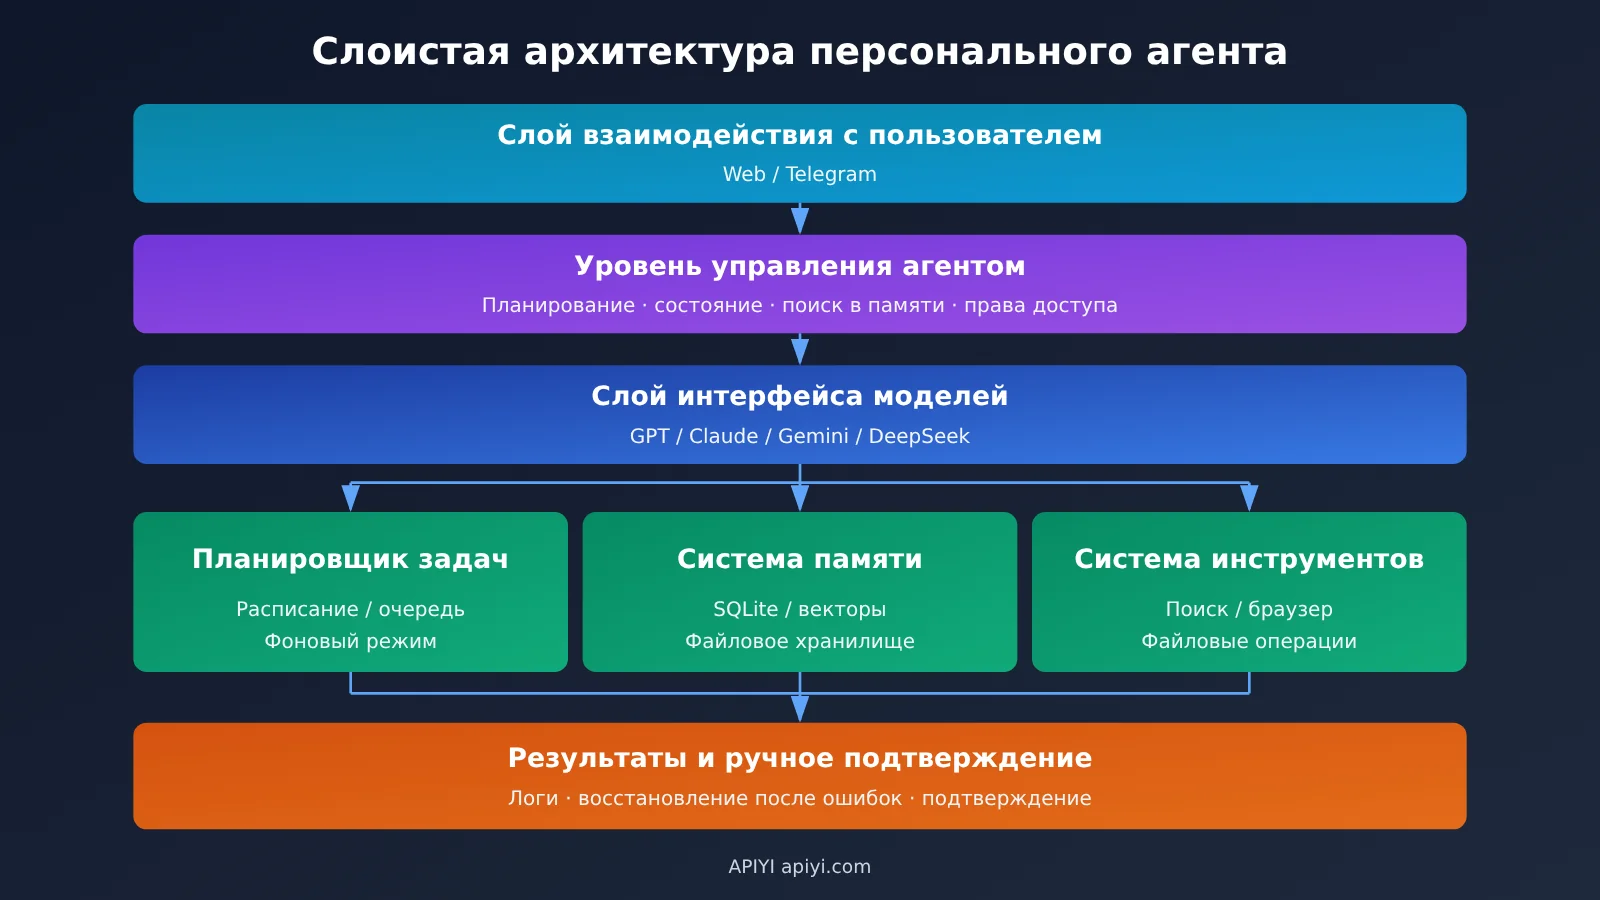
Рекомендуемый поток данных: планировщик → очередь задач → Agent Worker → API модели → выполнение инструментов → база результатов → уведомление. Периодические и длительные задачи управляются раздельно: периодические только кладут задания в очередь, а длительные продвигаются Worker’ом по состоянию.
5.2 Поэтапные Checkpoint и повторные попытки при сбоях
Ниже — скелет планирования Personal AI Radar. После завершения каждого этапа пишется Checkpoint, и после перезапуска процесса работа продолжается с next_stage:
import time
from datetime import date
from apscheduler.schedulers.blocking import BlockingScheduler
from radar_store import load_or_create_run, save_checkpoint, mark_failed
from radar_stages import HANDLERS, TransientError
from notify import notify_owner

STAGES = ["collect", "verify", "analyze", "topics", "report"]

def daily_radar():
    run = load_or_create_run("ai-radar", date.today().isoformat())
    if run.status == "done":
        return
    start = STAGES.index(run.next_stage)
    for stage in STAGES[start:]:
        for attempt in range(3):
            try:
                run.state = HANDLERS[stage](run.state)
                save_checkpoint(run, done_stage=stage)   # запись в таблицу runs
                break
            except TransientError:                       # сеть, rate limit и прочие повторяемые ошибки
                time.sleep(30 * 2 ** attempt)
        else:
            mark_failed(run, stage)
            notify_owner(f"Radar упал на этапе {stage}, прогресс сохранён")
            return

sched = BlockingScheduler(timezone="Asia/Shanghai")
sched.add_job(daily_radar, "cron", hour=8, minute=0,
              misfire_grace_time=3600, max_instances=1)
sched.start()
max_instances=1 не даёт запустить новый прогон, пока не закончился предыдущий, а misfire_grace_time позволяет догнать задачу за сегодня после короткого простоя сервера. При сбое прогресс сохраняется, пользователь получает уведомление, а следующий запуск продолжит с упавшего этапа. Входные и выходные данные каждого этапа, время выполнения и расход токенов пишутся в лог — так удобнее разбираться с проблемами и считать стоимость.
6. Даём GPT Dots-агенту компьютер, на котором можно работать
6.1. Четыре типа сред выполнения и их роли
У Dots есть собственный облачный компьютер. При самостоятельной сборке эту часть должен предоставить разработчик; обычно выбирают один из четырёх вариантов:
- Playwright: управление браузером через код. Подходит для стабильного по структуре сбора веб-данных и извлечения данных после входа. Поведение предсказуемо, стоимость низкая.
- Browser Use: модель управляет браузером с помощью естественного языка. Подходит для веб-задач с изменчивой структурой страниц и нефиксированной последовательностью шагов; каждый шаг требует вызова модели.
- Computer Use: модель смотрит на скриншоты экрана и управляет мышью и клавиатурой. Подходит для настольных программ без API, но требует виртуального рабочего стола.
- Docker: изолированная среда для выполнения кода и обработки файлов. Скрипты, созданные агентом, запускаются в контейнере, поэтому ошибки не затрагивают хост-машину.
6.2. Комбинация решений модели и среды выполнения
API модели отвечает за решения, среда выполнения — за действия. Они соединяются через инструментальные функции. Типичная комбинация в Radar выглядит так: Playwright собирает основной текст новостей, контейнер Docker запускает скрипт очистки данных, а модель получает только очищенный текст и на его основе принимает решение. Любой веб-контент передаётся модели исключительно как «материал»; в системном промпте прямо указано, что инструкции из материалов выполнять нельзя. Все инструменты для отправки и публикации попадают в очередь на утверждение — так снижается риск Prompt Injection.
🎯 Технический совет: вызовы инструментов, связанных со средой выполнения, заметно увеличивают число раундов диалога. Перед запуском можно в APIYI сравнить несколько моделей-кандидатов на одном и том же наборе определений инструментов по числу раундов и расходу токенов, а затем выбрать основную и резервную модели.
7 Практика: собираем Personal AI Radar на API
Ниже — архитектура Personal AI Radar, которая показывает полный рабочий процесс от сбора информации до ежедневного отчёта. Реальный результат каждого этапа зависит от выбранной модели, поискового сервиса и источников, поэтому перед запуском в продакшене всё нужно проверить на настоящих данных.
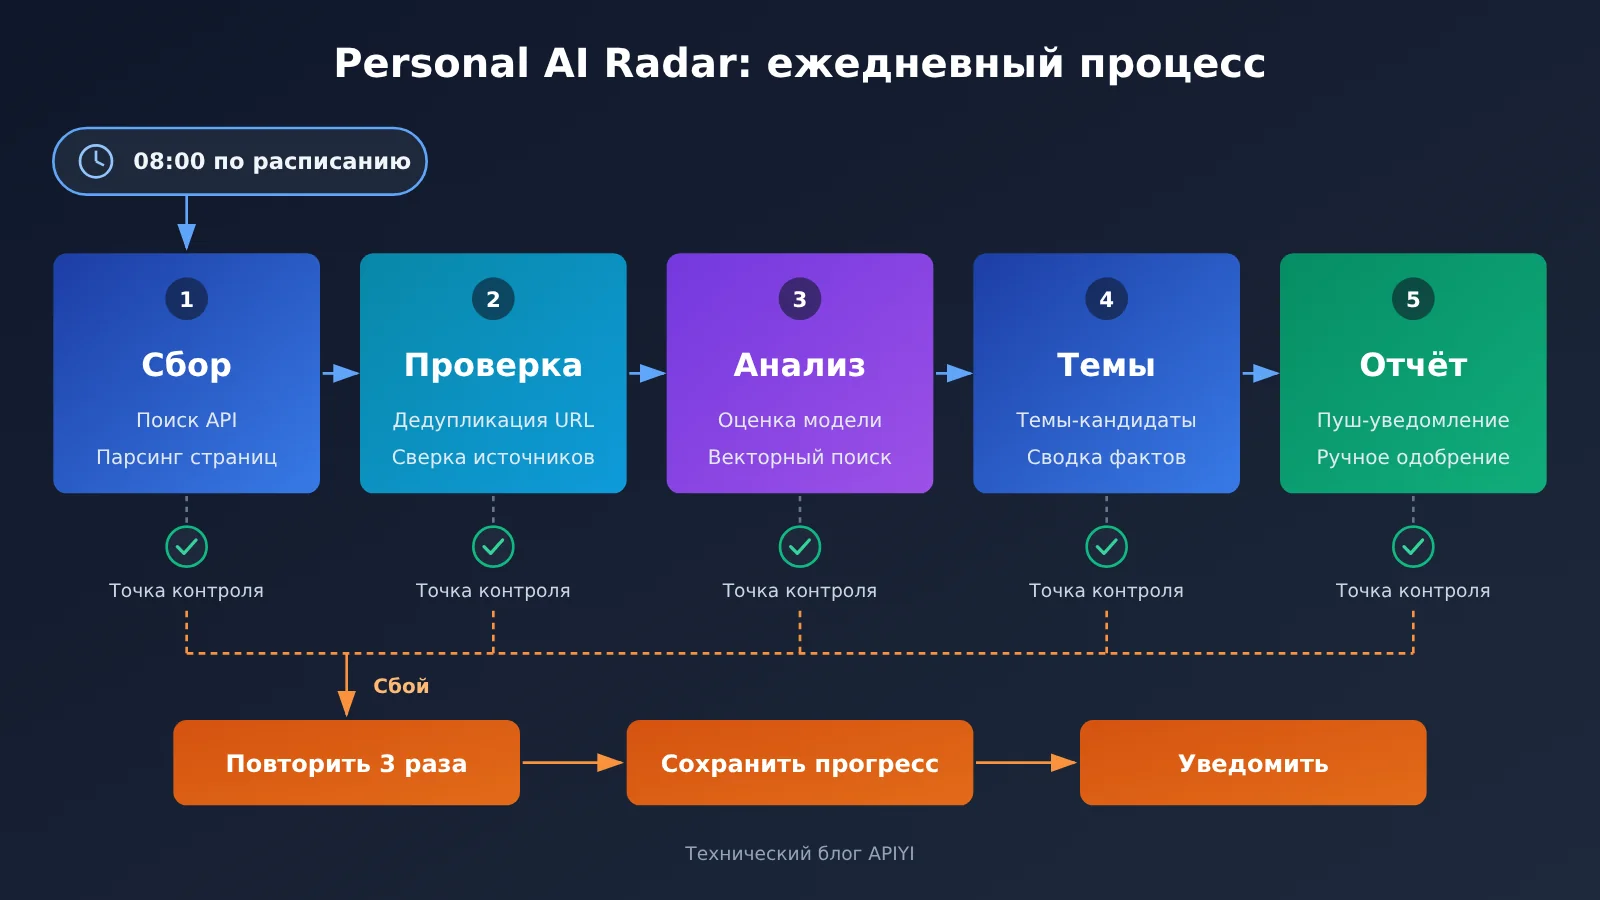
7.1 Пять этапов Personal AI Radar
- Сбор (collect): вызываем
search_newsи ищем новости за последние 24 часа по ключевым словам, которые отслеживает пользователь, затем через Playwright вытаскиваем основной текст, дедуплицируем по URL и сохраняем во временное состояние. - Проверка (verify): перекрёстно сравниваем несколько источников об одном и том же событии, в приоритете — официальные анонсы и первоисточники; записи с единственным источником помечаем как «требует проверки».
- Анализ (analyze): модель выдаёт по каждой новости структурированный JSON — резюме события, ключевые факты с указанием источника, релевантность к интересам пользователя; параллельно ищем в исторических материалах и определяем, это новое событие или продолжение уже известной темы.
- Подбор тем (topics): совмещаем предпочтения из памяти пользователя и темы, уже написанные в памяти проекта, генерируем кандидатов в темы, каждый — с фактическим резюме и ссылками на источники, и записываем в таблицу
notes. - Отчёт (report): формируем дайджест за день и отправляем пользователю; пользователь в чате отвечает командами вроде «измени», «перезапусти», «беру», а агент обновляет память проекта и при необходимости перезапускает выполнение.
7.2 Ключевая конфигурация и обработка ошибок
Основную конфигурацию Radar стоит собрать в одном YAML-файле: отслеживаемые ключевые слова, белый список источников, ID основной и резервной моделей, время ежедневного запуска, часовой пояс, максимальное число раундов работы с инструментами за один прогон, дневной лимит токенов. ID моделей подставляются через переменные окружения, поэтому при смене модели код менять не нужно.
Обработка ошибок различается по типу. Временные сбои — сетевые таймауты, ограничения частоты запросов — повторяем с экспоненциальной задержкой; если JSON от модели не парсится, возвращаем сообщение об ошибке как результат инструмента и просим модель сгенерировать ответ ещё раз; если основная модель падает несколько раз подряд, переключаемся на резервную; если дневной расход токенов превышает бюджет, пропускаем низкорелевантные записи на этапе анализа и отмечаем это в дайджесте. Все действия по публикации и отправке писем только формируют черновик и ждут подтверждения пользователя.
8 Затраты и границы возможностей самодельного агента в стиле GPT Dots
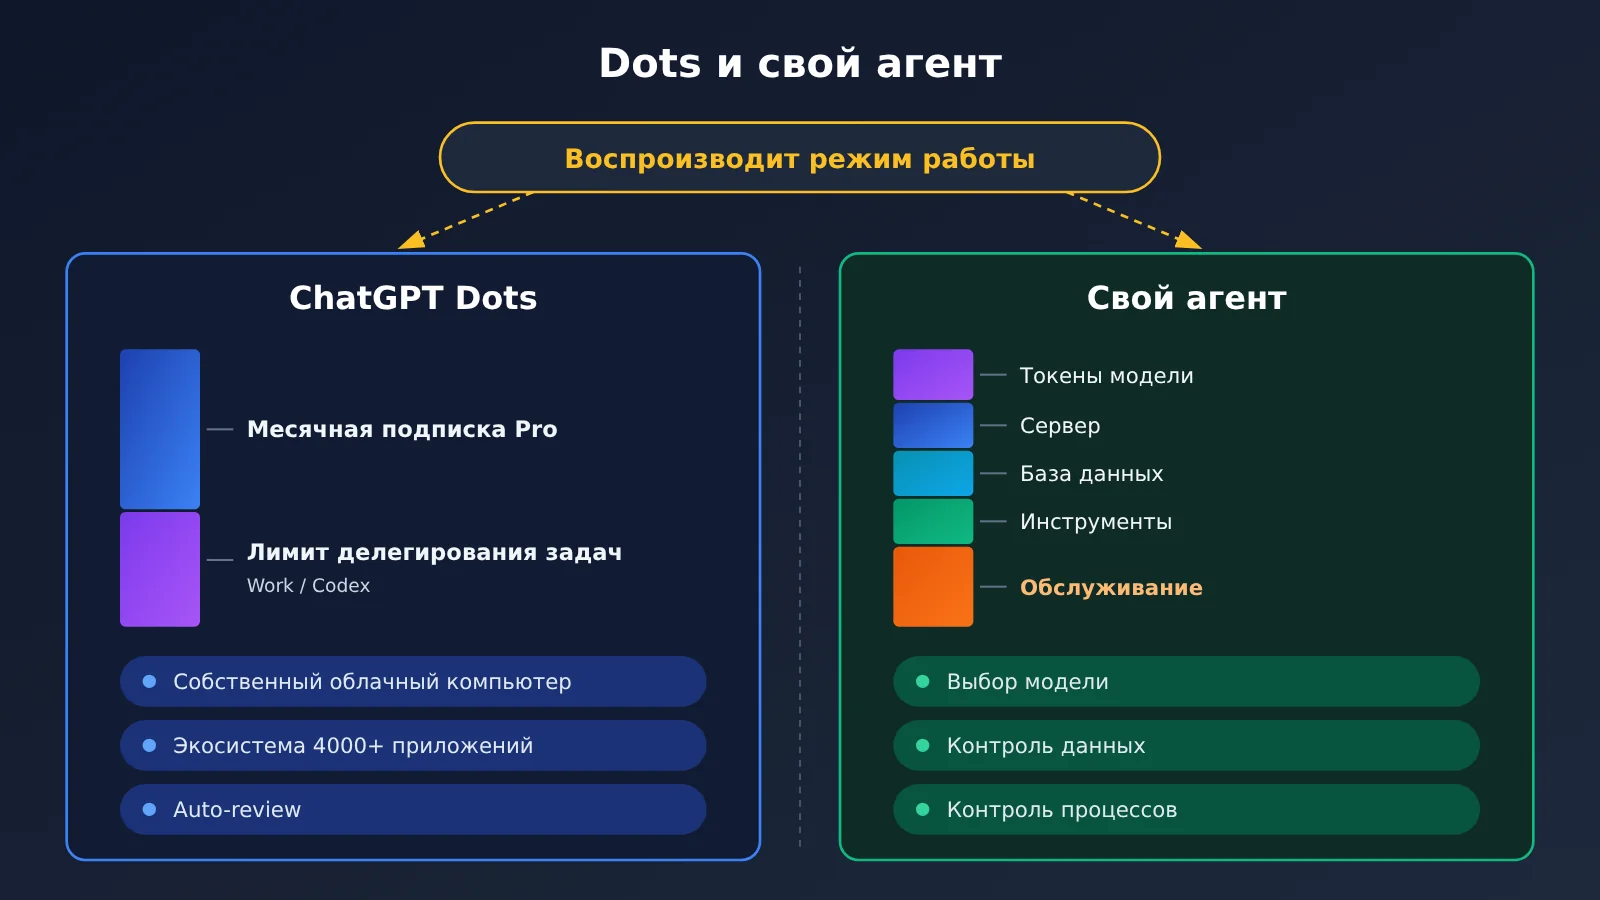
8.1 Пять видов затрат при самостоятельной сборке
Общую стоимость самодельного агента можно записать так:
C_total = C_model + C_server + C_database + C_tools + C_maintenance
- Токены модели: при каждом вызове накапливается сумма по формуле
входные токены ÷ 10⁶ × цена входа + выходные токены ÷ 10⁶ × цена выхода. При длительной работе нужно также учитывать число раундов вызова инструментов, количество повторов, повторную передачу контекста и попадания в кэш. - Сервер: облачный хост, на котором работают планировщик, воркеры и браузер; автоматизация браузера предъявляет повышенные требования к памяти.
- База данных: сам SQLite бесплатен, но после роста объёма данных миграция на PostgreSQL или управляемое векторное хранилище приведёт к расходам на хранение.
- Инструменты: сторонние сервисы вроде API поиска, прокси для парсинга веб-страниц и сервисов уведомлений тарифицируются за вызов или помесячно.
- Сопровождение: рабочие часы разработчика, уходящие на переработку источников информации, обновление моделей и обновление зависимостей, — часто самая большая статья затрат в долгосрочной перспективе.
8.2 Справочные цены на модели
В технической документации APIYI от 13 ноября 2026 года приведены примеры цен на модели Claude — по ним можно прикинуть стоимость работы модели:
| Модель | Ввод / млн токенов | Вывод / млн токенов | Чтение из кэша / млн токенов | Доступная платформа |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | APIYI |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | APIYI |
| Claude Fable 5.2 | $8 | $40 | $0.20 | APIYI |
Актуальный список доступных моделей, групп и цены в реальном времени смотрите на странице моделей docs.apiyi.com/models. Цены показывают только стоимость за единицу, а долю успешных задач нужно проверять отдельно по методике из раздела 2.3. В таких задачах, как Radar, большая часть входа — это повторяющиеся системные промпты и исторические материалы, а чтение из кэша стоит гораздо меньше обычного ввода, поэтому грамотное использование кэша — главный способ удерживать расход токенов под контролем.
8.3 Сравнение стоимости подписки Dots
Что касается индивидуальных пользователей, ChatGPT Pro 100, Pro 200 и Pro 500 стоят $100, $200 и $500 в месяц соответственно. Все три тарифа дают право использовать Dots, но официально отдельная месячная плата за Dot для индивидуальных Pro не указана. Задачи ChatGPT Work или Codex, делегированные через Dot, рассчитываются по лимитам и правилам соответствующих продуктов; расход зависит от модели, контекста, рассуждений, вызовов инструментов и объёма поиска. Для индивидуального Pro нужно быть старше 18 лет; Европейская экономическая зона, Великобритания и Швейцария пока не покрываются.
Для бизнеса: подходящие рабочие пространства Enterprise могут выбрать фиксированную ставку по типу работы или оплату по объёму использования. С 18 ноября 2026 года начнётся оплата для включённых Dots; до этого период предварительного просмотра был бесплатным, а задачи, делегированные в Work или Codex, оплачиваются отдельно. Конкретные суммы — по фактически применимому предложению для рабочего пространства.
8.4 Границы возможностей собственного решения
Собственное решение может полностью воспроизвести ключевую модель работы Dots: непрерывная работа над задачами, многоуровневая память, вызовы инструментов, планирование по расписанию и ручное утверждение. Его преимущество — можно свободно переключать модели, данные и процессы полностью под вашим контролем, а рабочие процессы можно глубоко настроить под бизнес.
Проприетарные компоненты Dots придётся либо восполнить самостоятельно, либо принять отставание: внутренняя конфигурация моделей OpenAI, собственный облачный компьютер Dot, экосистема из 4 000+ плагинов приложений, каналы коммуникации между Slack и Teams, система проверки безопасности Auto-review. У самого Dots тоже есть ограничения: тест, проведённый корреспондентом Axios в октябре 2026 года, показал, что Dots может выполнить многоэтапное планирование поездки и создать 38-страничный памятный альбом, но в контенте встречаются сомнительные статистические данные, а на этапе покупок пользователю предлагают завершить всё самостоятельно. Собственному агенту тоже нужна ручная проверка результатов, а операции с аккаунтами и средствами должны оставаться под ручным подтверждением.
Частые вопросы (FAQ)
Вопрос 1: можно ли одним API-ключом сразу получить все возможности GPT Dots?
API-ключ даёт только возможность вызова моделей. Память, инструменты, планирование, среду выполнения и согласования придётся строить самому, а проприетарный облачный компьютер Dots и его экосистему приложений через API не получить. С одним ключом от APIYI apiyi.com удобно переключаться между несколькими моделями, а остальную часть Agent реализуем по разделам 3–6 этой статьи.
Вопрос 2: при воспроизведении GPT Dots что выбрать — OpenAI-совместимый интерфейс или нативный интерфейс Claude?
Оба варианта можно подключить к одному Agent. Модели вроде GPT и DeepSeek идут через OpenAI-совместимый интерфейс, а Claude — через нативный Messages API, что позволяет полностью использовать механизмы `tool_use`, `tool_result` и `is_error`. Рекомендую абстрагировать в контроллере единый интерфейс вызова инструментов и написать по адаптеру для каждой цепочки.
Вопрос 3: одинаково ли ведут себя разные модели при вызове инструментов?
Даже при совместимости протокола модели различаются в параллельных вызовах, соблюдении Schema, восстановлении после ошибок и числе раундов вызова. Проведите сравнительный тест на одинаковых определениях инструментов и задачах, посчитайте число вызовов, ошибки в параметрах, токены и точность — и уже по результатам выбирайте основную и резервную модель.
Вопрос 4: как самодельный Agent обеспечивает «работу 24 часа в сутки»?
«24 часа» — это режим, при котором задачи по плану продолжают выполняться в фоне. Для реализации нужны три вещи: планировщик на постоянно работающем сервере, состояние задачи с Checkpoint и Worker с возможностью повторных попыток. При обслуживании сервера или сбое зависимостей задачи приостанавливаются, а после восстановления продолжаются с точки останова.
Вопрос 5: сколько примерно стоит Personal AI Radar в месяц?
Зависит от количества источников, глубины обработки каждой новости и выбранной модели. Сначала запустите его на неделю, по логам посчитайте суточные входные и выходные токены, а стоимость модели рассчитайте по формуле из раздела 8.1 и цене модели; затем добавьте сервер, поисковый API и часы на поддержку.
Вопрос 6: как самодельному Agent защититься от Prompt Injection?
Передавайте содержимое веб-страниц и документов как материалы и укажите в системном промпте, что инструкции внутри материалов не выполняются; давайте инструментам только минимальные права, необходимые для задачи; операции отправки наружу, публикации и удаления ставьте в очередь на ручное согласование; все вызовы инструментов пишите в лог. Эти меры заметно снижают риск, но результат всё равно нужно регулярно проверять вручную.
Ключевые моменты воспроизведения GPT Dots
- Цель воспроизведения: повторить схему работы Dots; проприетарные модели, облачные компьютеры и экосистему приложений придётся заменить своими решениями.
- Семь модулей: модель, контроллер, инструменты, память, планировщик, среда выполнения и подтверждения. Из API приходит только модель.
- Вызов инструментов: модель отправляет запрос, программа выполняет инструмент, а за права доступа и обработку ошибок отвечает разработчик.
- Уровни памяти: текущий контекст, проект, пользователь и накопленный опыт хранятся раздельно и извлекаются по необходимости.
- Фоновая работа: планировщик + очередь задач + Checkpoint. При сбое задача повторяется, а выполнение продолжается с контрольной точки.
- Расчёт стоимости: помимо токенов модели нужно учитывать серверы, базы данных, инструменты и трудозатраты на поддержку.
- Выбор модели: подключайте несколько моделей через APIYI и выбирайте основную на одном и том же наборе тестовых данных.
Итог
Ключевые моменты воспроизведения GPT Dots через API:
- Разделяйте уровни: API модели отвечает за принятие решений, фреймворк агента — за оркестрацию, среда выполнения — за непосредственные действия. Каждый из трёх уровней собирается отдельно.
- Сначала запустите минимальный замкнутый цикл: одна модель, три инструмента, одна таблица SQLite и одна задача по расписанию — этого достаточно, чтобы собрать постоянно работающего персонального агента.
- Выбирайте на основе данных: то, как модель справляется с вызовами инструментов, и её реальную стоимость определяют тесты в одинаковых условиях.
Personal AI Radar — хорошая отправная точка: он покрывает пять ключевых возможностей Dots — непрерывную работу, память, вызов инструментов, планирование и совместную работу человека и агента. Рекомендую подключить несколько моделей-кандидатов через APIYI apiyi.com, провести сравнительное тестирование с одним и тем же набором определений инструментов, а затем взять в своего агента самую стабильную модель.
📚 Справочные материалы
- Официальное объявление OpenAI — Introducing dots: позиционирование продукта Dots, облачный компьютер и экосистема приложений
- Ссылка:
openai.com/index/introducing-dots -
Пояснение: главный источник, чтобы понять официальное описание возможностей Dots
-
ChatGPT Learn — Tasks and memory: долгосрочные задачи Dots, фоновые агенты, память и проактивные исследования
- Ссылка:
learn.chatgpt.com/docs/dots/tasks-and-memory -
Пояснение: ориентир при проектировании собственной многоуровневой памяти агента и механизма планирования
-
OpenAI Help Center — About ChatGPT Pro tiers: цены и правила квот для Pro 100, Pro 200 и Pro 500
- Ссылка:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers -
Пояснение: сравнить собственные затраты со стоимостью подписки
-
ChatGPT Learn — Руководство администратора Dots для предприятий: подключение и тарификация Dots в рабочем пространстве Enterprise
- Ссылка:
learn.chatgpt.com/docs/enterprise/dots-admin-guide -
Пояснение: пригодится корпоративным пользователям при оценке расходов на Dots
-
Документация OpenAI Function Calling: формат запросов и ответов при вызове инструментов
- Ссылка:
developers.openai.com/api/docs/guides/function-calling -
Пояснение: официальная основа для реализации цикла вызова инструментов из части 3
-
Официальная документация LangGraph: среда выполнения рабочих процессов агента с состоянием и длительным периодом работы
- Ссылка:
langchain-ai.github.io/langgraph -
Пояснение: готовые реализации checkpoint, персистентности и ручного подтверждения
-
Воспроизводимый тест вызова инструментов нескольких моделей от APIYI: пошаговый дизайн небольшого теста многораундового вызова инструментов
- Ссылка:
help.apiyi.com/en/one-key-multi-model-reproducible-tool-calling-test-en.html -
Пояснение: методика тестирования для сравнения того, как разные модели справляются с вызовом инструментов
-
Описание настройки Base URL в APIYI: конфигурация эндпоинтов для OpenAI-совместимых моделей, Claude и Gemini
- Ссылка:
help.apiyi.com/en/apiyi-base-url-v1-claude-gemini-endpoint-config-guide-en.html - Пояснение: ориентир при настройке подключения моделей по нескольким протоколам
Автор: техническая команда APIYI
Связь по техническим вопросам: пишите нам через официальный сайт APIYI, больше материалов по подключению — в центре документации docs.apiyi.com