Примечание автора: в этой статье по источникам разведены три показателя Gemini 4 Neon и GPT-6.2 Astra — балл интеллекта, время на одну задачу и пара «цена за миллион токенов / стоимость одной задачи». Также здесь есть цены, тарифные ступени и адреса вызова для моделей, уже доступных на APIYI.
18 ноября 2026 года Google выпустила Gemini 4 Neon. В тот же день Сундар Пичаи объявил, что модель начинает появляться в Gemini API в Google AI Studio, Gemini for business, Google Antigravity и Gemini App. В тот же день в статье Artificial Analysis Neon xhigh занял 3-е место в сводном индексе интеллекта; выше него — GPT-6.2 Astra (max) и Claude Fable 5.2 (max). Если сравнивать Neon и Astra, легче всего перепутать цена за миллион токенов и стоимость одной задачи: первая — это цена за миллион токенов по прайс-листу, вторая — сколько на самом деле уходит на выполнение одной задачи.
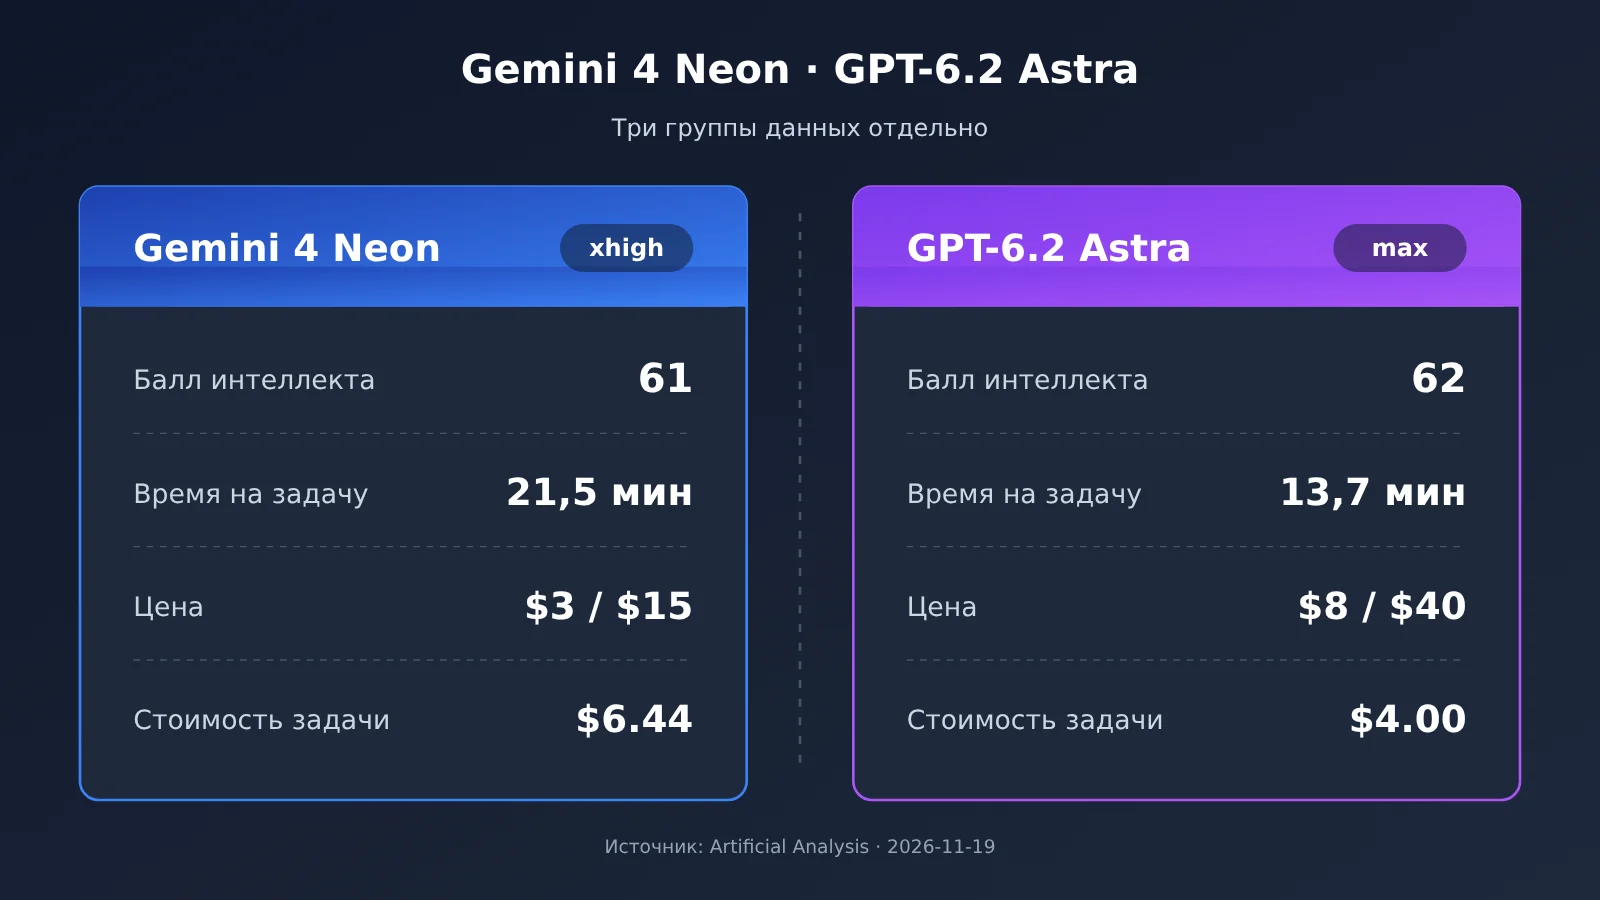
Все три набора цифр ниже взяты со страницы модели в Artificial Analysis (данные прочитаны 2026-11-19, индекс v5.0.1); уровень указан в скобках, разные уровни перечислены отдельно:
- Балл интеллекта: GPT-6.2 Astra (max) — 62, Gemini 4 Neon (xhigh) — 61. У Astra уровень xhigh тоже даёт 62.
- Время на одну задачу: Astra (max) — 13.7 мин, Astra (xhigh) — 7.4 мин, Neon (xhigh) — 21.5 мин.
- Цена за миллион токенов и стоимость одной задачи: у Astra вход — 8, выход — 40 долларов за миллион токенов, у Neon — 3/15; стоимость одной задачи: Astra (max) — 4.00 доллара, Neon (xhigh) — 6.44 доллара.
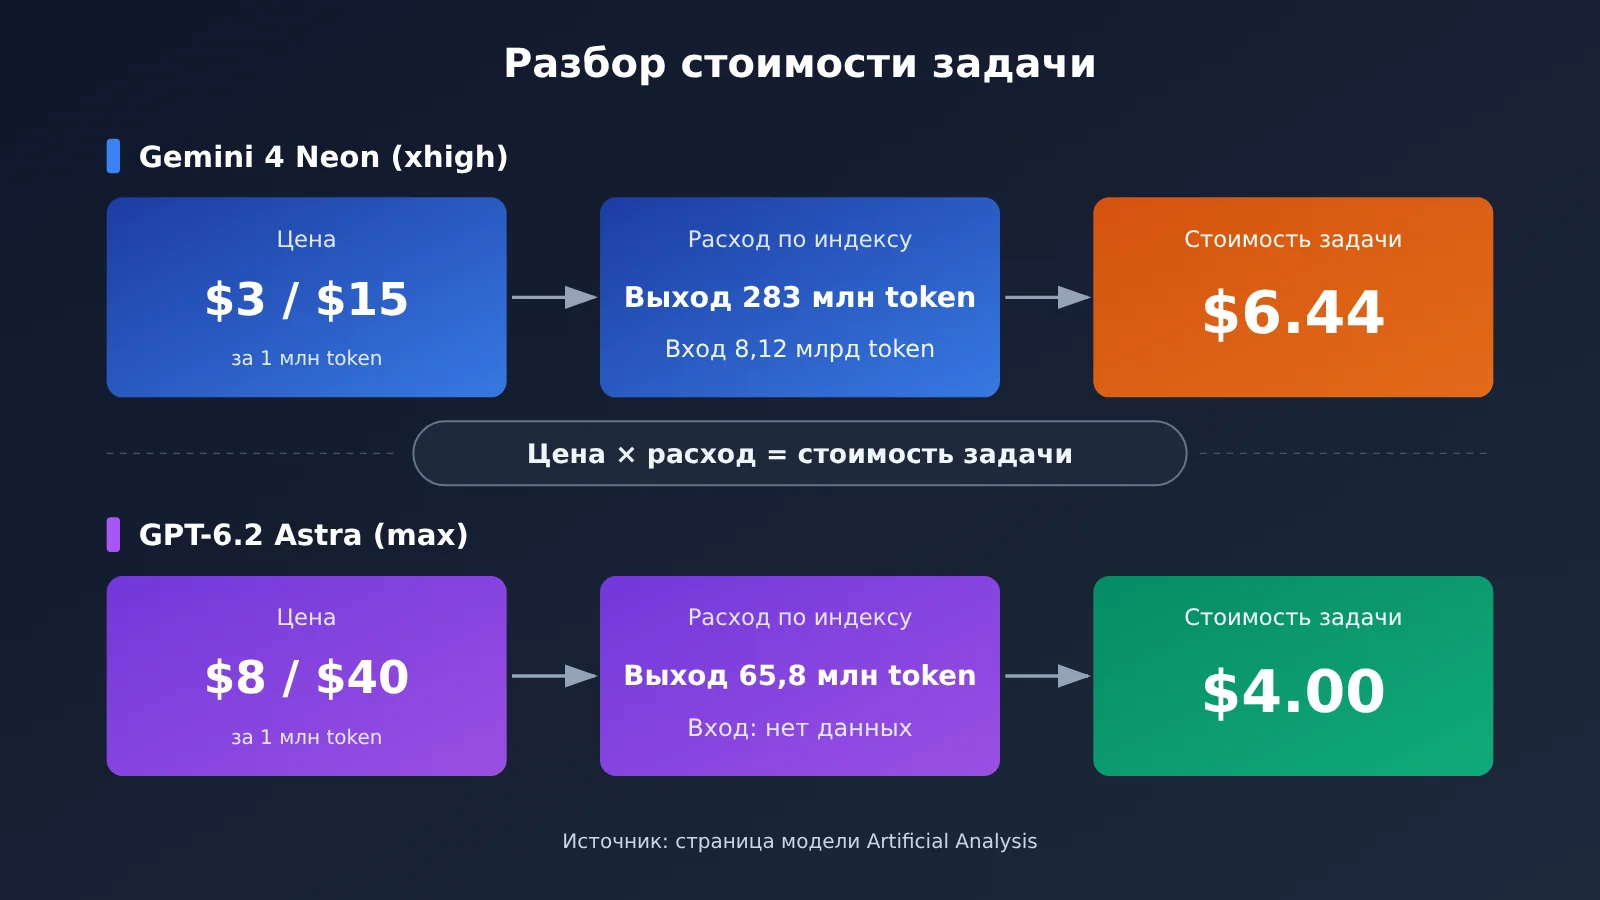
Цена за миллион токенов и стоимость одной задачи расходятся из-за объёма токенов. На одном и том же наборе тестов индекса Astra (max) выдаёт 65.8 млн токенов на выходе, Neon (xhigh) — 283 млн токенов. По скорости Neon — около 110 токенов в секунду и 56.51 секунды до первого токена ответа, Astra — 50 токенов в секунду и 197.65 секунды до первого токена ответа. Эта статья только раскладывает эти цифры по колонкам; какой показатель важнее для вас — зависит от структуры ваших задач.
Что вы получите: после прочтения вы сможете различить, к какому показателю и какому уровню относится каждая цифра у Gemini 4 Neon и GPT-6.2 Astra, а также узнаете, какие модели уже доступны для прямого вызова на APIYI и где цена переходит на следующую тарифную ступень.
Ключевые различия Gemini 4 Neon и GPT-6.2 Astra
Все цифры ниже взяты со страниц моделей на Artificial Analysis: для Neon выбран уровень xhigh, для Astra — max, это верхние ступени на обеих страницах. В сравнительной таблице карточки модели DeepMind есть только три колонки — Gemini 4 Neon, Claude Opus 5.5 и GPT-6.2 Sol, Astra там нет, поэтому для Astra используются только цифры со страницы модели на Artificial Analysis.
| Критерий сравнения | Gemini 4 Neon (xhigh) | GPT-6.2 Astra (max) | Источник |
|---|---|---|---|
| Балл интеллекта | 61 | 62 (на xhigh тоже 62) | Страница модели на Artificial Analysis |
| Время на одну задачу | 21,5 минуты | 13,7 минуты (на xhigh — 7,4 минуты) | Страница модели на Artificial Analysis |
| Цена по прейскуранту (ввод/вывод, долларов за миллион токенов) | 3,00 / 15,00 | 8,00 / 40,00 | Страница модели на Artificial Analysis |
| Стоимость одной задачи | 6,44 доллара | 4,00 доллара | Страница модели на Artificial Analysis |
| Токенов вывода за прогон индекса | 283 млн | 65,8 млн | Страница модели на Artificial Analysis |
| Скорость вывода | 110 токенов/сек | 50 токенов/сек | Страница модели на Artificial Analysis |
| Время до первого токена ответа | 56,51 секунды | 197,65 секунды | Страница модели на Artificial Analysis |
| Скидка за кэш / смешанная цена | 95% / 2,21 | 95% / 5,88 | Страница модели на Artificial Analysis |
Эту таблицу надёжнее всего читать построчно. Балл интеллекта, затраченное время и цена — три независимые группы, и то, что в одной колонке одновременно «высокий балл», «мало времени» и «высокая цена за единицу», никакого противоречия не создаёт.
Почему у GPT-6.2 Astra выше цена за единицу, но ниже стоимость одной задачи
Стоимость одной задачи можно грубо представить как «сколько токенов израсходовано × цена за токен». Заявленная цена вывода у Astra — 40 долларов за миллион токенов, это больше чем в два раза выше, чем 15 долларов у Neon. Однако по данным страницы модели на Artificial Analysis объём вывода при прогоне индекса у Astra составил 65,8 млн токенов — меньше четверти от 283 млн токенов у Neon. Расход оказался намного ниже, и поэтому у стороны с более высокой ценой за токен стоимость одной задачи вышла 4,00 доллара, а у Neon — 6,44 доллара.
Про входную сторону нужно сказать отдельно. На странице модели Neon указано, что при прогоне индекса вход составил 8,12 млрд токенов. В справочных материалах числа входных токенов для Astra нет, поэтому здесь разбираем только выходную сторону и не восстанавливаем полный счёт. Смешанная цена — 2,21 у Neon и 5,88 у Astra — тоже отражает только уровень заявленных цен; чтобы оценить собственный счёт, её нужно ещё умножить на вашу структуру токенов.
В конкретном бизнес-сценарии структура токенов меняется. В задачах с длинным входом и коротким выходом вес цены входа 8 против 3 возрастёт; в задачах с длинным выходом результат будет определять именно статья расхода на выход. Стоимость одной задачи в индексе — это результат на одном фиксированном наборе задач; прежде чем переносить её на свой сценарий, лучше прогнать её на собственных примерах.
Арифметика времени Gemini 4 Neon: быстрый вывод и быстрое завершение — не одно и то же
На странице модели Neon выдаёт около 110 токенов в секунду — более чем вдвое больше, чем 50 токенов/с у Astra, а первый токен ответа появляется уже через 56,51 секунды, тогда как Astra требует 197,65 секунды. При этом время на одну задачу у Neon (xhigh) — 21,5 минуты, а у Astra (max) — 13,7 минуты, у xhigh — 7,4 минуты. Причина снова упирается в объём токенов: модель, которая пишет больше, и завершает работу дольше, как бы быстро она ни выдавала токены.
У Astra уровни xhigh и max дают одинаковый балл интеллекта — 62, но время разное: 7,4 минуты против 13,7. При цитировании обязательно указывать уровень. По Neon в FAQ на странице модели Artificial Analysis отдельно приведены значения времени до первого токена ответа для более низких уровней: high — 40,64 секунды, medium — 20,14 секунды, low — 13,93 секунды. Эти цифры взяты из FAQ и находятся не в той же колонке, что сводная таблица.
Данные Gemini 4 Neon и GPT-6.2 Astra по уровням
| Модель | Уровень | Балл интеллекта | Время на задачу | Скорость вывода |
|---|---|---|---|---|
| Gemini 4 Neon | xhigh | 61 | 21,5 минуты | 110 токенов/с |
| Gemini 4 Neon | high (по умолчанию) | 60 | 14,8 минуты | 101 токенов/с |
| Gemini 4 Neon | medium | 55 | 8,3 минуты | 101 токенов/с |
| Gemini 4 Neon | low | 44 | 3,7 минуты | 97 токенов/с |
| GPT-6.2 Astra | max | 62 | 13,7 минуты | 50 токенов/с |
| GPT-6.2 Astra | xhigh | 62 | 7,4 минуты | 50 токенов/с |
| GPT-6.2 Astra | high | 60 | 5,9 минуты | 50 токенов/с |
| GPT-6.2 Astra | medium | 57 | 4,5 минуты | 49 токенов/с |
| GPT-6.2 Astra | low | 46 | 1,8 минуты | 48 токенов/с |
Все данные взяты со страницы модели Artificial Analysis; high у Neon — уровень по умолчанию, это прямо указано в руководстве для разработчиков Google. У Neon нет уровня max, а скорость вывода у Astra стабильно держится в диапазоне 48–50 токенов/с, так что разница во времени объясняется прежде всего количеством токенов, которое модель выдаёт на каждом уровне. На странице модели приведена стоимость одной задачи только для топового уровня — стоимость остальных уровней здесь не пересчитывается.
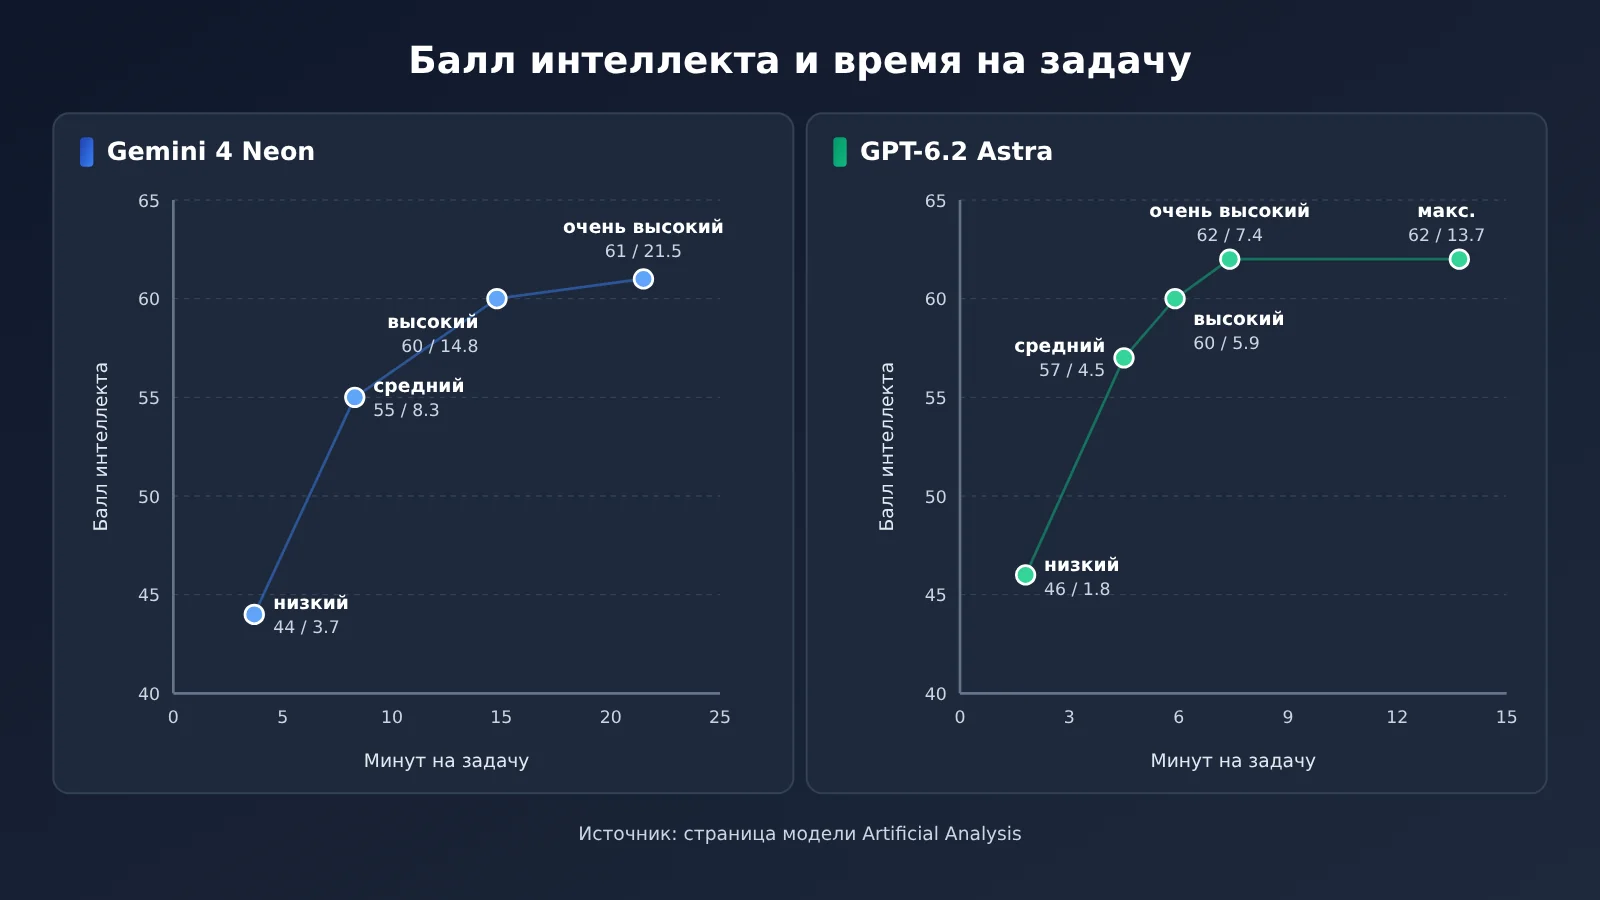
Пояснение к сравнению: цифры на диаграмме и в таблице выше взяты со страницы модели Artificial Analysis. Если хотите проверить расход токенов на собственных задачах, в APIYI можно с одним и тем же ключом переключаться между доступными моделями и сравнивать результаты.
Gemini 4 Neon: официальные данные, карточка модели и сторонние цифры
На стороне Neon есть три типа источников, и методология у них разная. Весь блок из блога Google — это официальные данные самой компании: Artificial Analysis Intelligence Index на xhigh равен 61, общее 3-е место, Vals Index 70.9%, Arena Agent Arena Index 1336. В карточке модели DeepMind тоже указано значение AA Index v5.0.1, равное 61, а в примечаниях к оценке отмечено, что результаты не-Gemini по умолчанию берутся из собственных данных каждой компании — это официальная сводка. Статья Artificial Analysis и страница модели — это сторонние измерения.
| Метрика | Официальные данные (блог Google) | Карточка модели | Статья Artificial Analysis |
|---|---|---|---|
| Индекс интеллекта (xhigh) | 61 | 61 | 61 |
| Coding Agent Index | 58.6 | не указано | 59 (Antigravity CLI, xhigh) |
| MKA | не указано | 56.5% | 56% |
| WebExploitBench v1.2 | 51.26% | 51.3% | не указано |
| SWE-sweep | mini-SWE 12.8%, Antigravity 39.0% | harness производителя 39.0%, mini-SWE 12.8% | не указано |
| Утверждение о стоимости одной задачи | по умолчанию high на 32% дешевле Carbon | не указано | 6.44 доллара, примерно на 17% меньше, чем 7.76 доллара по недисконтной цене Carbon |
Расхождения в таблице сохранены: Coding Agent Index — 58.6 в официальных данных и 59 в статье Artificial Analysis; MKA — 56.5% в карточке модели и 56% в статье Artificial Analysis. Значения SWE-sweep 12.8% и 39.0% получены на двух разных harness, и блог Google объясняет разрыв приростом, который даёт harness.
Со стоимостью тоже три разных счёта. «На 32% дешевле» у Google — это их собственный расчёт, и в блоге не сказано, используется для Carbon вводная цена или стандартная; «примерно на 17% меньше» в статье Artificial Analysis получено из стандартной цены Carbon 4/20, что даёт 7.76 доллара; а 4.90 доллара для Carbon high на странице модели Artificial Analysis рассчитаны по текущей вводной цене 2/10. Все три цифры верны сами по себе, но пересчитывать их друг в друга нельзя.
Сценарии выбора: по какой «книге учёта» смотреть Gemini 4 Neon или GPT-6.2 Astra
Сначала смотрим на цифры GPT-6.2 Astra
- Бюджет на одну задачу: если вы планируете расходы по принципу «сколько стоит один вопрос», начните со страницы модели на Artificial Analysis — стоимость одной задачи у Astra (max) составляет 4,00 доллара.
- Важно общее время выполнения: у Astra в режиме xhigh — 7,4 минуты и балл интеллекта 62, в режиме max — 13,7 минуты. При одинаковом балле разница по времени заметная, так что выбор режима стоит оценивать отдельно.
- Массовые задачи с коротким выводом: Astra в тесте на индекс выдала 65,8 млн токенов, и статья «выходные токены» занимает в её счёте совсем небольшую долю.
Сначала смотрим на цифры Gemini 4 Neon
- Интерфейс и ожидание первого токена: у Neon (xhigh) первый токен ответа появляется через 56,51 секунды, а в режиме low, по данным FAQ, — через 13,93 секунды.
- Мультимодальный ввод: в карточке модели от DeepMind указано, что на входе могут быть текст, изображения, аудио и видео, единое контекстное окно — до 1 млн токенов, знания актуальны до марта 2026 года.
- Оркестрация плюс подзадачи: в руководстве для разработчиков Google упоминается, что
gemini-4-neonможно использовать как оркестрирующую модель, передаваяprevious_interaction_idвgemini-4-hydrogenдля более быстрых подзадач. - Расчёт по цене за токен: на странице тарифов Google AI Studio указано, что у Neon вход — 3,00, кеш — 0,15, выход — 15,00 доллара за миллион токенов; в выходные токены включены токены размышлений, бесплатного тарифа нет.
Модели и цены Gemini 4 Neon и GPT-6.2 Astra в APIYI
На странице сводной таблицы APIYI указано, что она обновлена 2026-11-16 09:39 (UTC+8); 2026-11-19 мы также сверяли API тарифов (версия shell-api-modelmak-v1, всего 285 моделей) — можно построчно сравнить в списке моделей на apiyi.com. В API тарифов model_ratio 1 соответствует 2 долларам США за миллион входных token, completion_ratio 5 означает, что вывод стоит в 5 раз дороже ввода; это совпадает с первым тарифом сводной таблицы.
| ID модели | Ввод | Чтение из кэша | Вывод | Эндпоинт | Примечание |
|---|---|---|---|---|---|
gpt-6.2-astra |
8 | 0.4 | 40 | responses | при вводе более 272000 token — 16; в API тарифов цена вывода на верхнем тарифе около 60, в сводной таблице этот тариф вывода не указан |
gpt-6.2-sol |
2 | 0.1 | 10 | responses (рекомендуется), chat | при вводе более 272000 token — 3; в API тарифов цена вывода на верхнем тарифе около 11.25 |
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | соответствует вводной цене Google до 2026-11-30 |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | группы Default, SVIP |
claude-opus-5-5 |
4 | 0.2 | 20 | chat, messages | есть также версия -thinking |
claude-fable-5-2 |
8 | 0.2 | 40 | chat, messages | есть также версия -thinking |
gemini-4-neon |
— | — | — | — | нет ни в сводной таблице, ни в API тарифов |
Единица везде — доллары США за миллион token. Значения 2/0.1/10 для gemini-4-carbon — текущая цена на витрине APIYI, она совпадает с вводной ценой Google; это отдельная история от последующей стандартной цены Google 4/20. Названия групп в двух местах немного расходятся: например, в сводной таблице написано Default, SVIP, а в API тарифов — default, svip; для серии Claude в сводной таблице указаны Claude_Reverse, Claude_Enterprise, а в API тарифов — ClaudeCodeReverse, ClaudeOfficial. В обоих случаях ориентируйтесь на то, как название отображается на платформе.
Официальная цена Gemini 4 Neon взята со страницы тарифов Google AI Studio: ввод — 3.00, кэш — 0.15, вывод — 15.00 долларов США за миллион token; поддерживается только неявное кэширование. gemini-4-neon отсутствует и в сводной таблице APIYI, и в API тарифов, отдельной страницы модели тоже нет — модель пока не добавлена в каталог. Мы скоро добавим её; модели и цены смотрите в списке моделей на платформе.
Быстрый старт: вызов GPT-6.2 Astra через APIYI
gpt-6.2-astra работает через совместимый с OpenAI эндпоинт responses. Достаточно выполнить четыре шага ниже:
- Зарегистрируйтесь на apiyi.com и создайте API-ключ, запишите его в переменную окружения
APIYI_API_KEY; в коде читайте ключ только из переменной окружения и не храните его в открытом виде. - Инициализируйте клиент через OpenAI SDK:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). - Вызовите эндпоинт responses:
resp = client.responses.create(model="gpt-6.2-astra", input="用三句话说明单价和单任务费用的区别"), затем прочитайтеresp.output_text. - Сверьте тарификацию: в сводной таблице APIYI для первой ступени вход — 8, чтение кэша — 0,4, выход — 40 долларов за миллион токенов; если вход одного запроса превышает 272000 токенов, вход становится 16, в API тарификации для этой ступени
CompletionRatioравен 3.75, выход — около 60 долларов за миллион токенов, в основном тексте сводной таблицы выход для этой ступени не указан.
Для задач с длинным контекстом особенно внимательно относитесь к шагу 4. После превышения 272000 токенов и вход, и выход одновременно переходят на другую ступень, поэтому стоимость одной задачи заметно отклоняется от оценки по первой ступени. Рекомендую сначала посчитать количество токенов в типичных запросах, а уже потом определять бюджет.
Для уже доступных моделей Gemini есть два варианта подключения: gemini-4-carbon и gemini-4-hydrogen можно вызывать через один и тот же OpenAI-совместимый адрес и эндпоинт chat, а можно через нативный адрес Gemini https://api.apiyi.com с версией API v1beta. С правилами параметров Neon можно сначала ознакомиться в руководстве Google для разработчиков: уровни thinking — только low, medium, high, xhigh, по умолчанию high; передача thinking_budget или MINIMAL возвращает HTTP 400; явное кэширование контекста не поддерживается, общий префикс длиннее 4096 токенов автоматически идёт в неявный кэш; по умолчанию для одного сегмента выводится не более 65536 токенов.
🚀 Быстрый старт: рекомендую сначала получить на APIYI (apiyi.com) бесплатный тестовый лимит для новых пользователей, затем тем же ключом по очереди вызвать
gpt-6.2-astra,gpt-6.2-sol,gemini-4-carbon, записать для каждой модели количество входных и выходных токенов и подставить их в таблицу цен выше, чтобы рассчитать стоимость одной задачи.
Рекомендации по выбору между Gemini 4 Neon и GPT-6.2 Astra
| Что для вас важно | На что смотреть в первую очередь | Gemini 4 Neon (xhigh) | GPT-6.2 Astra | Источник |
|---|---|---|---|---|
| Балл интеллекта | Балл интеллекта | 61 | max — 62, xhigh — 62 | Страница модели Artificial Analysis |
| Сколько времени занимает одна задача | Время на задачу | 21.5 минуты | max — 13.7 минуты, xhigh — 7.4 минуты | Страница модели Artificial Analysis |
| Сколько ждать первый токен | Первый токен ответа | 56.51 секунды | max — 197.65 секунды | Страница модели Artificial Analysis |
| Цена за миллион токенов | Цена за единицу | 3 / 15 | 8 / 40 | Страница модели Artificial Analysis, сводная таблица APIYI |
| Сколько стоит пройти индекс | Стоимость одной задачи | 6.44 доллара США | max — 4.00 доллара США | Страница модели Artificial Analysis |
| Как тарифицируется длинный ввод | Ценовая ступень | В справочных материалах ступень не указана | Свыше 272000 токенов ввода — 16, вывода — около 60 | Сводная таблица APIYI, API тарификации |
При принятии решения сначала определите, какая строка важнее всего для вашего бизнеса, а затем смотрите на цифры и источник в этой строке. Разница в балле интеллекта — всего 1 балл, а по времени выполнения, задержке первого токена, цене за токен и стоимости задачи модели выигрывают в разных пунктах. Ни одна строка не заменяет остальные.
💡 Рекомендация по выбору: набор задач индекса и ваши реальные задачи часто различаются по структуре токенов. Мы советуем прогнать собственные примеры на apiyi.com и сравнить доступные модели, записать расход токенов и время выполнения, а уже потом выбирать уровень и модель.
Gemini 4 Neon и GPT-6.2 Astra: частые вопросы
Q1: Что такое Gemini 4 Neon?
Gemini 4 Neon — модель, выпущенная Google 18 ноября 2026 года; её ID — `gemini-4-neon`. В карточке модели DeepMind указано, что она создана на основе Gemini 4 Carbon и в семействе находится между Hydrogen (быстрое выполнение повседневных задач) и Carbon (сложные длительные задачи). Единое контекстное окно — 1048576 токенов.
Q2: Насколько различаются оценки интеллекта Gemini 4 Neon и GPT-6.2 Astra?
На странице модели Artificial Analysis у Neon (xhigh) — 61, у Astra (max) — 62, у Astra (xhigh) — тоже 62. У Astra оба режима дают одинаковый балл, а время выполнения различается — 13.7 и 7.4 минуты. При цитировании обязательно указывайте режим.
Q3: Когда будет доступен Gemini 4 Neon?
Сундар Пичаи в день релиза написал, что Neon доступен с 18 ноября 2026 года в Gemini API внутри Google AI Studio, в Gemini for business, в Google Antigravity для платных тарифов Google AI Pro и Ultra, а также в Gemini App для Pro и Ultra. На странице тарифов Google AI Studio указано, что бесплатного тарифа у него нет.
Q4: У GPT-6.2 Astra выше цена за единицу — почему тогда стоимость одной задачи 4.00 доллара?
Стоимость одной задачи зависит от цены за единицу и объёма использования. На странице модели Artificial Analysis указано: Astra (max) в прогоне индекса выдала 65.8 млн выходных токенов, Neon (xhigh) — 283 млн. Хотя цена за выходные токены у Astra выше — 40 против 15, — объём использования гораздо меньше, поэтому стоимость одной задачи составляет 4.00 доллара, а у Neon — 6.44 доллара.
Q5: Как быстро вызвать GPT-6.2 Astra через API?
1. Зарегистрируйтесь на APIYI apiyi.com, получите API-ключ и бесплатный тестовый лимит;
2. В OpenAI SDK укажите в `base_url` OpenAI-совместимый адрес из раздела быстрого старта выше;
3. Используйте эндпоинт `responses`, в поле модели укажите `gpt-6.2-astra`.
`gemini-4-neon` сейчас нет ни в сводной таблице APIYI, ни в API с ценами. Когда модель появится на платформе, ориентируйтесь на список моделей.
Q6: Какие ограничения нужно учитывать при цитировании этих цифр?
— **Методика подсчёта**: официальные данные компании, карточка модели, статья Artificial Analysis и страница модели — разные источники. В Coding Agent Index встречаются два значения — 58.6 и 59, а у MKA — 56.5% и 56%.
— **Стоимость**: «на 32% ниже» от Google, «примерно на 17% меньше» из статьи Artificial Analysis и 4.90 доллара для Carbon на странице модели — это три разных расчёта, их нельзя объединять.
— **Перенос результатов**: стоимость одной задачи в индексе рассчитана на фиксированном наборе задач; структура токенов в ваших задачах другая, поэтому и результаты будут другими.
Gemini 4 Neon и GPT-6.2 Astra: ключевые выводы (Key Takeaways)
- Балл интеллекта: на странице моделей Artificial Analysis у Astra (max) — 62, Astra (xhigh) — 62, Neon (xhigh) — 61.
- Время выполнения: Neon (xhigh) — 21,5 минуты; Astra max — 13,7 минуты, xhigh — 7,4 минуты. Показатели для разных режимов нужно приводить отдельно.
- Цена за миллион токенов: Astra — 8/40, Neon — 3/15 доллара за миллион токенов. Цена Neon взята со страницы тарифов Google AI Studio.
- Стоимость одной задачи: Astra (max) — 4,00 доллара, Neon (xhigh) — 6,44 доллара. Разница объясняется объёмом выходных токенов.
- Скорость и время до первого токена: Neon — 110 токенов/с, первый токен через 56,51 с; Astra — 50 токенов/с, первый токен через 197,65 с.
- Каталог APIYI:
gpt-6.2-astra— первый тариф 8/0.4/40; при вводе свыше 272000 токенов — 16, выход по тарифному API — около 60.gemini-4-neonпока не добавлена.
Итоги сравнения Gemini 4 Neon и GPT-6.2 Astra
Сравнивая Gemini 4 Neon и GPT-6.2 Astra, главное — считать по трём отдельным статьям:
- Интеллект: 61 против 62. У Astra режимы xhigh и max дают одинаковые 62. Источник — страница моделей Artificial Analysis.
- Время: 21,5 минуты против 13,7 минуты (Astra xhigh — 7,4 минуты). Скорость вывода и время до первого токена — это уже другая пара цифр.
- Цена: 3/15 против 8/40 за миллион токенов; стоимость одной задачи — 6,44 против 4,00 доллара. За этой разницей стоят 283 млн против 65,8 млн выходных токенов.
При выборе сначала решите, какую статью затрат вы считаете основной, а затем проверьте расход токенов на собственных примерах. Рекомендую через APIYI apiyi.com одним ключом сравнить уже доступные модели; когда gemini-4-neon появится в каталоге, её можно будет сразу добавить в тот же процесс.
📚 Справочные материалы
-
Пост Sundar Pichai: выпуск Gemini 4 Neon и каналы запуска
- Ссылка:
x.com/sundarpichai/status/2123167780988125621 - Пояснение: дата релиза и точка входа
- Ссылка:
-
Блог Google «Introducing Gemini 4 Neon»: официально заявленные бенчмарки, цены и позиционирование
- Ссылка:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Пояснение: официальные данные — Coding Agent Index 58.6, стоимость ниже на 32% и т. д.
- Ссылка:
-
Карточка модели DeepMind Gemini 4 Neon: сравнительная таблица и спецификации модели
- Ссылка:
deepmind.google/models/model-cards/gemini-4-neon/ - Пояснение: в сравнительной таблице только три колонки — Neon, Claude Opus 5.5 и GPT-6.2 Sol
- Ссылка:
-
Руководство разработчика Google Cloud: параметры
gemini-4-neonи правила кэширования- Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Пояснение: уровни «размышлений», условия
HTTP 400, неявное кэширование
- Ссылка:
-
Страница тарифов Google AI Studio: официальные цены семейства Gemini 4
- Ссылка:
aistudio.google.com/docs/pricing - Пояснение: Neon 3/0.15/15, вводная цена Carbon действует до 2026-11-30
- Ссылка:
-
Статья Artificial Analysis: анализ показателя интеллекта и стоимости Neon
- Ссылка:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Пояснение: сторонние измерения, включая данные о стандартной цене Carbon примерно на 17% ниже
- Ссылка:
-
Страница модели на Artificial Analysis: Gemini 4 Neon и GPT-6.2 Astra
- Ссылка:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-astra - Пояснение: основной источник данных для трёх «счетов» в этой статье, прочитано 2026-11-19
- Ссылка:
Автор: техническая команда APIYI
Связь по техническим вопросам: будем рады, если вы напишете нам через главную страницу официального сайта APIYI; актуальные модели и цены смотрите в списке моделей платформы и в центре документации.