Nota do autor: entenda os 3 momentos que acionam a compressão automática do contexto de um Agent, as estratégias para preservar informações no resumo e veja um código executável para controlar o consumo de tokens sem perder dados essenciais da tarefa.
Depois de passar algumas horas trabalhando com um Agent de programação como o Codex, muitos desenvolvedores acabam com a mesma dúvida: perto da caixa de entrada aparecem apenas o modo de permissão e o modelo atual, sem indicar quanto do contexto já foi usado. Então, quando é hora de abrir uma nova janela? Quanto mais longa a conversa, mais histórico precisa ser enviado a cada requisição e, naturalmente, mais rápido a cota é consumida. Neste artigo, vamos falar sobre quando a compressão automática do contexto de um Agent (Context Compaction) é acionada e quais estratégias usar para criar resumos. A ideia é ajudar você a entender os mecanismos por trás de ferramentas como o Codex e implementar o mesmo recurso no seu próprio Agent.
Este não é mais um conselho genérico para “lembrar de limpar o histórico de conversas”. É uma solução prática, baseada nos mecanismos de compressão publicados na documentação oficial da OpenAI e da Anthropic e complementada por práticas de engenharia.
O que você vai aprender: ao final do artigo, você vai saber quando a compressão automática do contexto de um Agent é acionada, o que manter e o que descartar no resumo, além de ter em mãos uma implementação em Python pronta para adaptar e usar.
Pontos principais da compressão automática de contexto em Agents
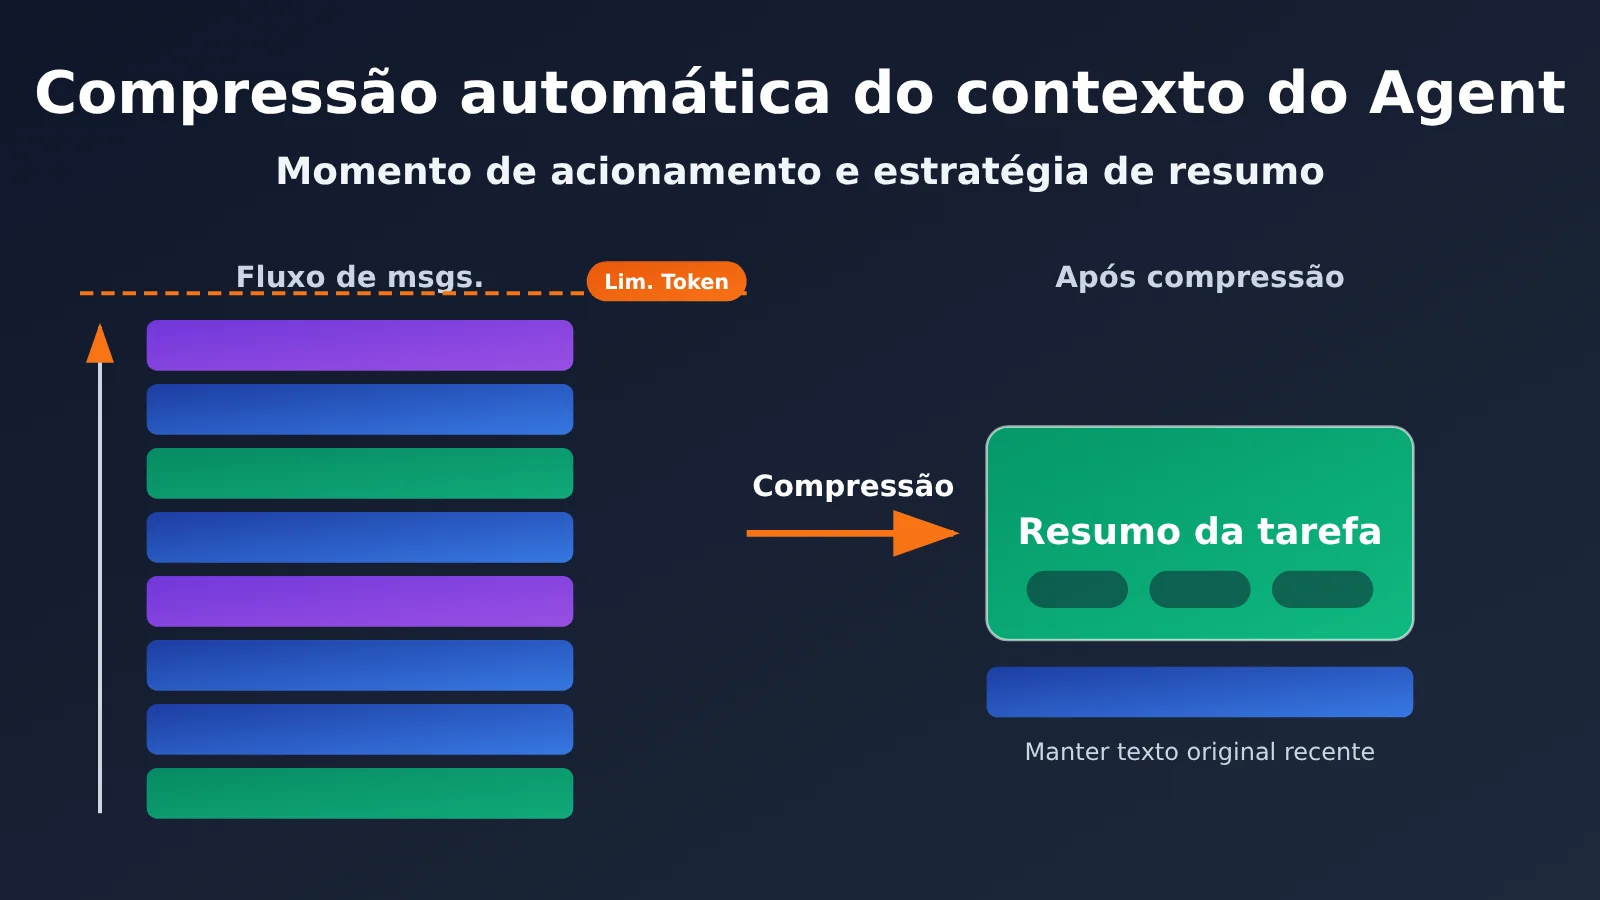
Em resumo: a compressão automática de contexto de um Agent costuma ser acionada quando o contexto atinge um limite definido de tokens. Ela comprime conversas anteriores e registros de chamadas de ferramentas em uma descrição do estado atual que permita ao Agent continuar trabalhando. O objetivo não é apenas encurtar o histórico, mas preservar o progresso da tarefa, fatos importantes, operações concluídas, decisões relevantes e próximos passos, removendo detalhes redundantes do processo.
| Ponto | Descrição | Benefício |
|---|---|---|
| Acionamento por limite de tokens | O contexto é comprimido automaticamente ao atingir uma quantidade predefinida de tokens | Evita intervenção manual e impede que a janela de contexto fique cheia |
| Compressão proativa | A aplicação solicita a compressão em momentos específicos, como ao concluir uma etapa da tarefa | Comprime em pontos de transição entre etapas, minimizando a perda de informação |
| Gerenciamento automático pelo framework | O SDK ou o ambiente de execução do Agent decide quando comprimir com base no espaço disponível no contexto | Funciona sem configuração adicional e facilita a implementação rápida |
| Resumo em vez de truncamento | Preserva progresso, fatos, decisões e próximos passos | O Agent consegue continuar a execução após a compressão |
| Compressão por etapa | Não é recomendável comprimir a cada rodada | Equilibra o aproveitamento do cache e a preservação das informações |
Por que Agents precisam de compressão automática de contexto
A API de um Modelo de Linguagem Grande não mantém estado por conta própria. Uma “conversa com várias rodadas” consiste, na prática, em reenviar todo o histórico de messages ao modelo a cada rodada. Assim, a requisição da 50ª rodada contém todo o conteúdo das 49 anteriores, e o número de tokens de entrada cresce de forma linear ou até mais rápida. Para Agents, a situação é ainda mais crítica: os resultados das chamadas de ferramentas — conteúdo de arquivos, saídas do terminal e resultados de busca — costumam ser muito longos. Bastam algumas chamadas para ocupar boa parte da janela de contexto.
Isso traz dois problemas diretos: primeiro, o custo — quanto mais tokens de entrada por rodada, mais rápido a cota é consumida; segundo, a qualidade — em contextos muito longos, a atenção do modelo a informações importantes do início pode se diluir. Se o limite da janela for ultrapassado, a requisição pode até retornar um erro. A compressão automática de contexto busca equilibrar esses dois fatores: enquanto as informações ainda estão completas e a janela não está cheia, ela “compacta” o histórico em um resumo do estado atual, deixando as próximas requisições mais leves.
Sobre o Codex não exibir o uso de contexto
Não encontramos uma explicação oficial clara sobre por que o cliente deixou de exibir o tamanho da janela de contexto, então não vamos especular. O que sabemos é que o Codex tem um mecanismo próprio de compressão de contexto: conversas longas não acumulam todo o histórico original indefinidamente. Se você quiser acompanhar com precisão o consumo em cada rodada, a forma mais confiável é consultar os logs de chamadas na camada da API. Mais adiante, explicaremos como fazer isso.
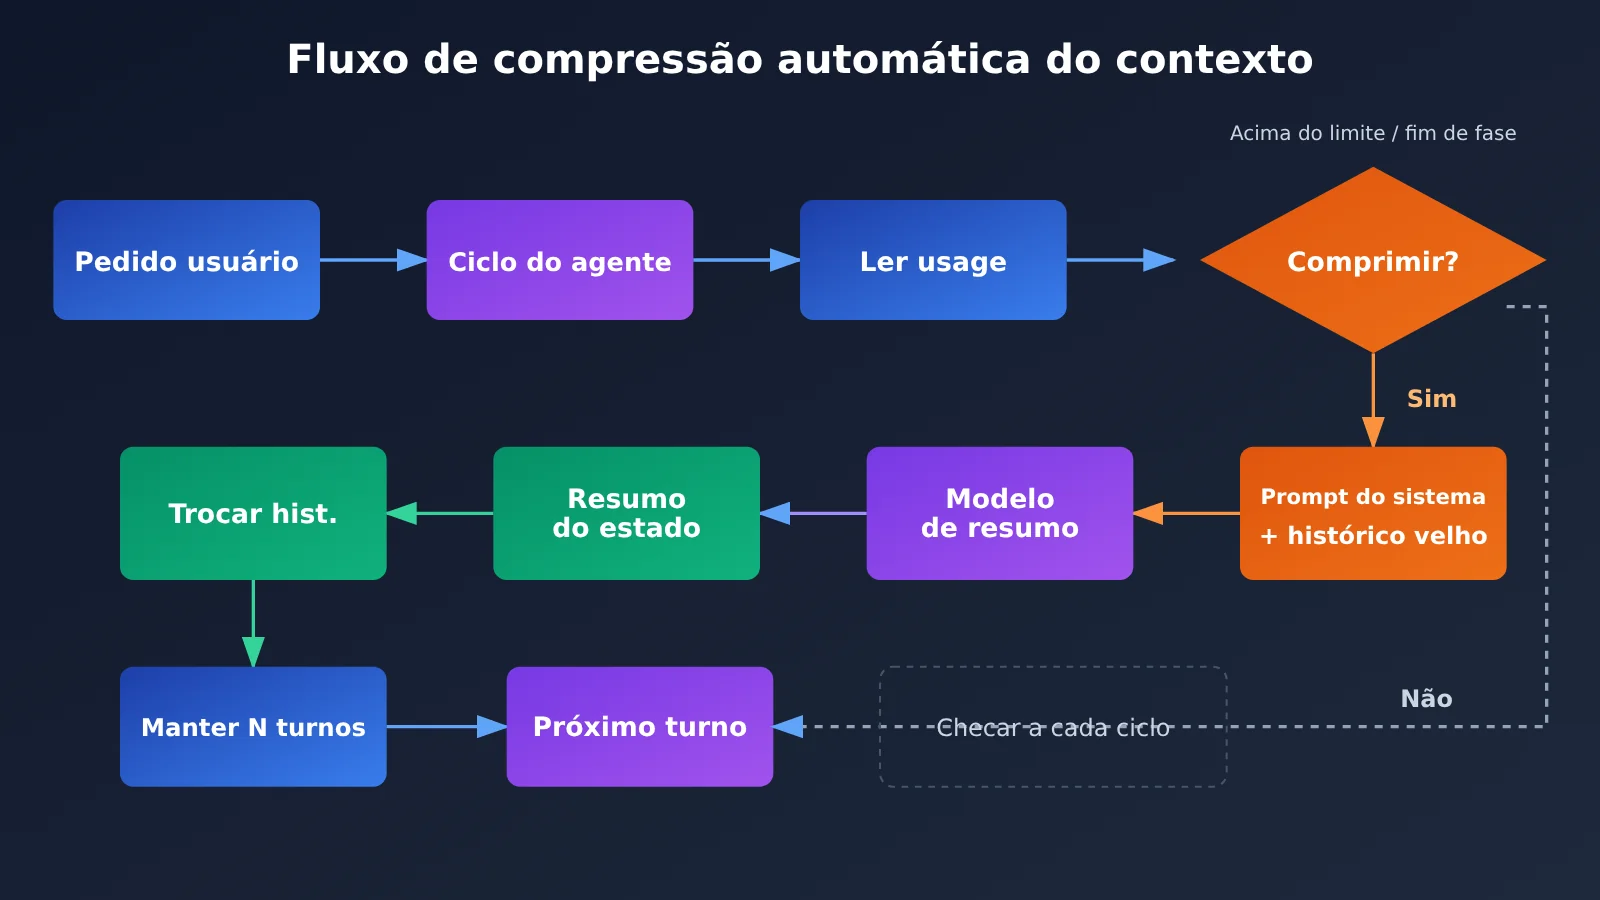
3 momentos para acionar a compactação automática do contexto de um agente
Muita gente presume que “o contexto é compactado quando chega a 80%”, mas essa não é uma regra oficial. A documentação das APIs define as condições de acionamento principalmente por limites de quantidade de tokens, não por uma porcentagem fixa da janela. Além disso, não é preciso esperar até chegar perto do limite: OpenAI e Anthropic também permitem iniciar a compactação por iniciativa da aplicação.
Comparação das regras de acionamento oficiais
| Implementação | Regra de acionamento automático | Explicação oficial |
|---|---|---|
| OpenAI Responses API | A quantidade de tokens após a renderização atinge compact_threshold |
O limite é configurável e o servidor cuida da compactação automaticamente |
| OpenAI Agents SDK | Pressão sobre o contexto ou política com limite explícito | Permite compactação automática, por limite fixo ou forçada |
| Anthropic Messages API | Os tokens de entrada atingem trigger.value |
Padrão de 150.000, mínimo de 50.000 |
| Anthropic Tool Runner | Atinge context_token_threshold |
Padrão de 100.000 |
| Compactação sob demanda da Anthropic | A aplicação inicia a compactação | Pode ser chamada após o fim de um turno completo da conversa |
A tabela mostra um ponto em comum: o acionamento automático quase sempre usa a quantidade de tokens de entrada como critério, com um limite configurável. Ao mesmo tempo, as implementações também permitem que a aplicação decida quando compactar.
Momento 1: acionamento por limite de tokens
Essa é a proteção mais básica. Após cada chamada, leia a quantidade de tokens de entrada retornada pela API e execute a compactação quando ela ultrapassar o limite definido. Não configure esse limite muito perto do máximo da janela: a própria compactação precisa reenviar o histórico anterior ao modelo responsável pelo resumo, e também é necessário reservar espaço para as saídas das ferramentas na próxima rodada.
Na prática, vale usar os valores padrão da Anthropic como referência: em modelos com janelas longas, configure o limite na ordem de centenas de milhares de tokens e garanta que ainda haja espaço suficiente acima dele para acomodar o retorno completo de uma chamada de ferramenta.
Momento 2: compactação ativa ao fim de uma etapa da tarefa
Essa é a forma que causa menos perda de informação. A OpenAI recomenda compactar depois de concluir uma etapa significativa do trabalho, em vez de fazer isso a cada rodada. Por exemplo, imagine que o agente acabou de concluir todo o processo de “localizar o bug → modificar o código → executar os testes com sucesso”. Nesse momento, as tentativas intermediárias já não têm valor; basta lembrar “qual arquivo foi alterado, por que foi alterado e que os testes passaram”.
Ao compactar na transição entre etapas, fica mais fácil produzir um resumo preciso, porque a tarefa está em um estado “limpo”, sem chamadas de ferramentas pela metade aguardando conclusão.
Momento 3: deixar o framework gerenciar a pressão sobre o contexto
Se você usa um framework como o Agents SDK ou o Tool Runner, pode ativar a política de compactação integrada e deixar que o ambiente de execução decida automaticamente com base na pressão sobre o contexto. Essa opção dá menos trabalho, mas oferece menos controle sobre o conteúdo do resumo. É uma boa escolha para protótipos ou cenários gerais.
🎯 Dica técnica: os três momentos não são mutuamente exclusivos. Uma combinação recomendada é “compactar ativamente ao fim das etapas e usar o limite de tokens como proteção”. Para verificar se os limites fazem sentido em diferentes modelos, você pode usar a APIYI apiyi.com para alternar entre modelos como OpenAI, Claude e Gemini com a mesma chave e fazer testes comparativos.
Estratégia de resumo para a compactação automática do contexto de um agente
O momento de acionamento resolve a questão de quando compactar; a estratégia de resumo define como o conteúdo será compactado. O sinal mais comum de falha é o agente esquecer as restrições iniciais do usuário ou repetir ações que já executou. A causa é que o resumo registra apenas “sobre o que se conversou”, em vez de registrar “qual é o estado da tarefa”.
O que preservar e o que descartar no resumo
| Categoria | Preservar | Descartar |
|---|---|---|
| Objetivo da tarefa | Requisitos originais do usuário, restrições obrigatórias e critérios de aceitação | Saudações e confirmações repetidas |
| Progresso da tarefa | Etapas concluídas e estágio atual | Processo de raciocínio detalhado de cada etapa |
| Fatos importantes | Caminhos de arquivos, nomes de funções, valores de configuração e linhas essenciais dos erros | Conteúdo completo de arquivos e logs extensos |
| Decisões importantes | Solução escolhida e motivo da escolha | Discussões detalhadas sobre soluções descartadas |
| Próximas ações | Lista de tarefas pendentes e questões não resolvidas | Detalhes de ações concluídas que não afetam os próximos passos |
Estratégia de resumo em 5 passos
- Preserve sempre o comando de sistema: ele não entra na compactação e permanece no início de
messages. - Preserve as últimas N rodadas na íntegra: as conversas mais recentes costumam estar diretamente relacionadas à operação atual. Mantenha-as como estão e compacte apenas as partes mais antigas.
- Use um modelo de resumo estruturado: peça ao modelo que organize a saída em cinco seções — “objetivo / progresso / fatos / decisões / próximos passos” — para reduzir omissões causadas por resumos livres.
- Enxugue primeiro os resultados das ferramentas: em retornos muito longos, mantenha apenas os trechos essenciais, como as primeiras e últimas linhas de um erro ou os títulos e conclusões dos resultados de busca.
- Arquive separadamente as palavras do usuário: recomenda-se preservar literalmente as restrições explícitas, como “não altere as interfaces públicas”, sem pedir ao modelo que as reescreva.
O modelo estruturado é a parte mais importante dessa estratégia. Ao fazer um resumo livre, o modelo tende a sintetizar o tom geral da conversa. Já as seções estruturadas o levam a conferir cada item e preservar informações sobre o estado da tarefa que podem orientar as próximas ações.
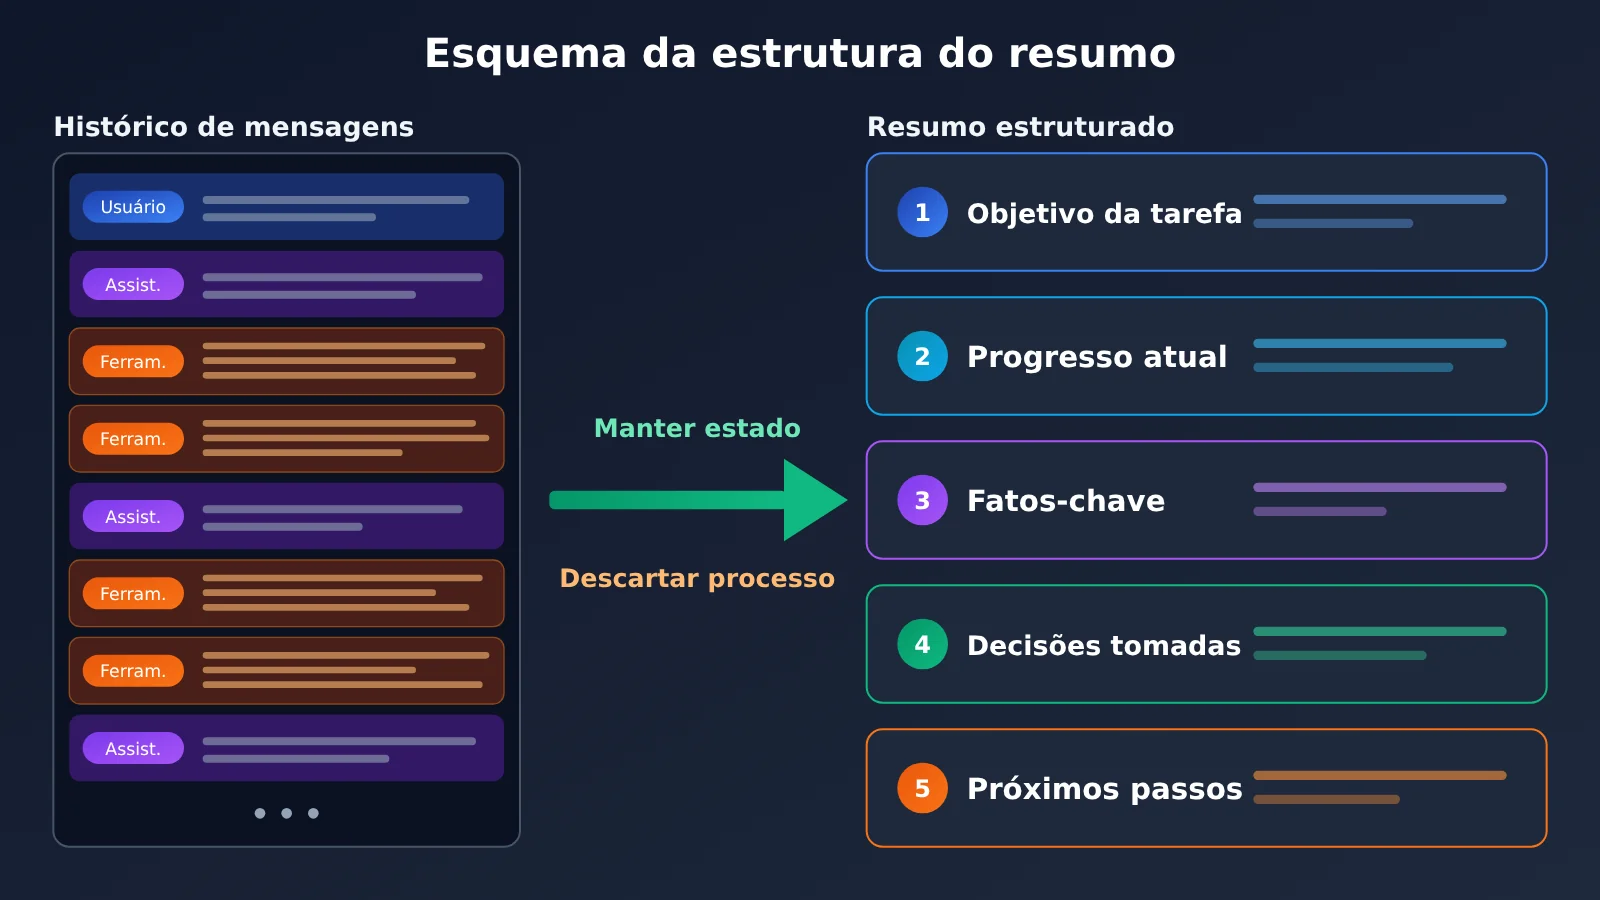
Guia rápido para compactar automaticamente o contexto de um agente
A seguir, vamos implementar uma versão genérica em que o cliente gerencia messages manualmente. Ela funciona com qualquer interface compatível com a OpenAI. A ideia é ler a quantidade de tokens de entrada em usage.prompt_tokens após cada chamada e, quando ela ultrapassar um limite, enviar o histórico mais antigo para um modelo de sumarização compactá-lo.
Exemplo minimalista
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "system", "content": "你是一个编码助手。"}]
messages.append({"role": "user", "content": "帮我检查这个函数的边界条件"})

resp = client.chat.completions.create(model="gpt-4o-mini", messages=messages)
messages.append({"role": "assistant", "content": resp.choices[0].message.content})

# 每轮记录输入 Token,作为是否压缩的判断依据
print("本轮输入 Token:", resp.usage.prompt_tokens)
Veja o código completo de compactação automática do contexto do agente
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MAIN_MODEL = "gpt-4o-mini"      # 主任务模型,可按需替换
SUMMARY_MODEL = "gpt-4o-mini"   # 摘要模型,可用更便宜的模型
TOKEN_THRESHOLD = 100_000       # 输入 Token 阈值,兜底触发
KEEP_RECENT = 6                 # 保留最近 N 条消息原文

SUMMARY_PROMPT = """请把以下 Agent 对话历史压缩为任务状态摘要,严格按五个栏目输出:
【任务目标】用户原始需求与硬性约束(约束请逐字保留)
【当前进度】已完成的步骤与当前阶段
【关键事实】文件路径、函数名、配置值、关键报错
【已做决策】采用的方案及原因
【下一步行动】待办事项与未解决问题
不要记录寒暄和推理过程,不要编造历史中没有的信息。"""


def compact(messages: list) -> list:
    """把早期历史压缩为一条摘要消息,保留系统提示与最近对话。"""
    system_msg = messages[0]
    old = messages[1:-KEEP_RECENT]
    recent = messages[-KEEP_RECENT:]
    if not old:
        return messages

    history_text = "\n".join(f"[{m['role']}] {m['content']}" for m in old)
    resp = client.chat.completions.create(
        model=SUMMARY_MODEL,
        messages=[
            {"role": "system", "content": SUMMARY_PROMPT},
            {"role": "user", "content": history_text},
        ],
    )
    summary = resp.choices[0].message.content
    summary_msg = {"role": "user", "content": f"(以下为之前对话的压缩摘要)\n{summary}"}
    return [system_msg, summary_msg] + recent


class CompactingAgent:
    def __init__(self, system_prompt: str):
        self.messages = [{"role": "system", "content": system_prompt}]
        self.last_prompt_tokens = 0

    def chat(self, user_input: str) -> str:
        # 时机一:上一轮输入 Token 超过阈值时先压缩
        if self.last_prompt_tokens > TOKEN_THRESHOLD:
            self.messages = compact(self.messages)

        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MAIN_MODEL, messages=self.messages)
        reply = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": reply})
        self.last_prompt_tokens = resp.usage.prompt_tokens
        return reply

    def finish_stage(self):
        # 时机二:完成一个任务阶段后主动压缩
        self.messages = compact(self.messages)
        self.last_prompt_tokens = 0


agent = CompactingAgent("你是一个严谨的编码助手。")
print(agent.chat("帮我定位登录接口偶发 500 的原因"))
agent.finish_stage()  # 修复完成后,在阶段边界主动压缩
🚀 Comece agora: cadastre-se na APIYI, em apiyi.com, para receber créditos gratuitos de teste. Para executar o código acima, basta substituir a chave API. A plataforma oferece uma interface compatível com a OpenAI, e você pode escolher modelos de fornecedores diferentes para a tarefa principal e para o resumo, facilitando o controle de custos.
Comparação das formas de compactação automática do contexto de agentes
| Solução | Características principais | Quando usar | Plataformas disponíveis |
|---|---|---|---|
| Compactação manual no cliente | Montagem própria de messages, com controle total sobre a lógica de resumo |
Agentes desenvolvidos internamente e casos que exigem modelos de resumo personalizados | APIYI apiyi.com e APIs oficiais |
| Compactação no servidor por limite | Como o compact_threshold da Responses API |
Quando se busca reduzir o gerenciamento de estado no cliente | Plataformas compatíveis com a interface |
| Compactação integrada ao framework | Gerenciamento automático pelo Agents SDK ou Tool Runner | Criação de protótipos e tarefas gerais | Depende do SDK correspondente |
| Abrir uma nova sessão | Resumir manualmente e abrir uma nova janela | Uso diário de clientes como o Codex | Qualquer cliente |
A compactação manual no cliente oferece mais controle, mas exige que você cuide da contagem de tokens e da qualidade dos resumos. A compactação no servidor dispensa a montagem do histórico, mas os detalhes do resumo não ficam visíveis para quem desenvolve. Para agentes próprios, combinar um resumo estruturado no cliente com um limite como medida de segurança costuma ser a opção mais confiável.
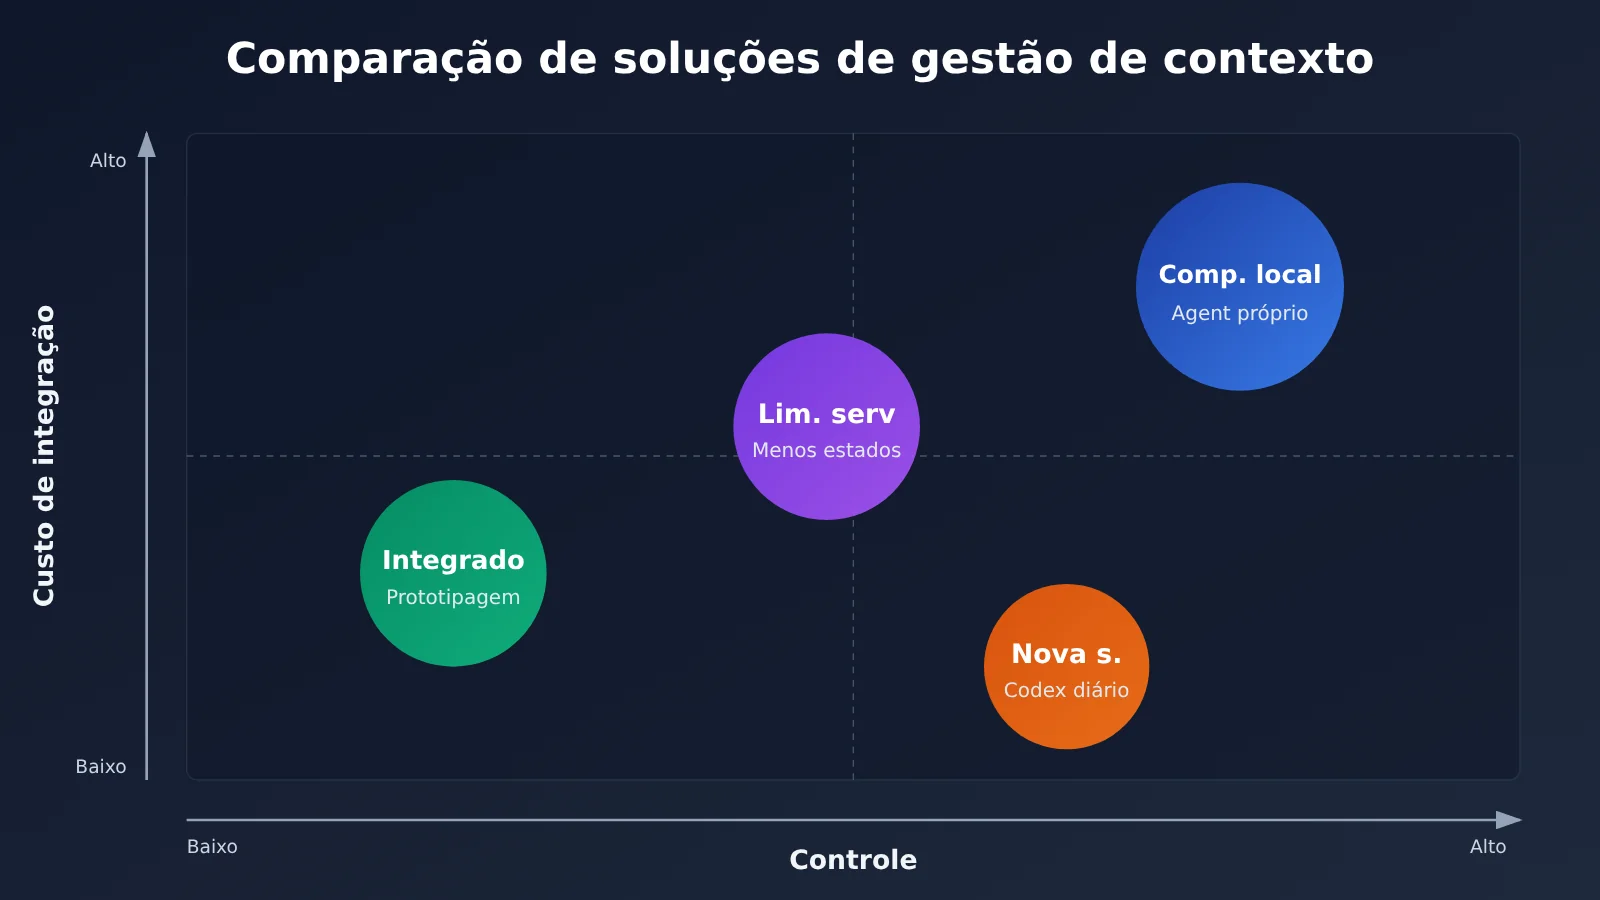
A relação entre a compressão automática de contexto do agente e o custo do cache
A compressão parece sempre economizar dinheiro, mas também é preciso levar em conta o Prompt Caching. Segundo as informações de cobrança de cache da OpenAI na APIYI, a parte da entrada atendida pelo cache custa 10% do preço normal de entrada. Em conversas longas, é fácil aproveitar o cache quando o prefixo do histórico permanece inalterado. Nesse caso, a quantidade de tokens novos cobrados pelo preço integral a cada rodada não é tão grande.
Quando a compressão é executada, o prefixo das mensagens é substituído por um novo resumo. Com isso, o cache da próxima solicitação deixa de ser aproveitado, e a entrada precisa ser processada novamente pelo preço integral. É por isso que a recomendação oficial é não comprimir a cada rodada: a compressão frequente interrompe repetidamente o uso do cache e, às vezes, acaba saindo mais cara do que não comprimir.
Um ritmo mais equilibrado é deixar o histórico crescer de forma estável durante uma etapa, aproveitando ao máximo o cache, e comprimir tudo de uma vez ao final dessa etapa ou quando o contexto estiver próximo do limite.
Perguntas frequentes (FAQ)
Q1: O que é a compressão automática de contexto de um agente?
É o processo de condensar conversas anteriores e registros de chamadas de ferramentas em um resumo do estado da tarefa, substituindo o histórico original. Isso acontece quando o contexto atinge uma determinada quantidade de tokens ou quando uma etapa da tarefa termina. O objetivo é reduzir os tokens de entrada em cada rodada, preservando o progresso, os fatos, as decisões e as próximas ações para que o agente possa continuar trabalhando.
Q2: Qual é a diferença entre comprimir o contexto e simplesmente cortar o histórico?
O corte apenas remove as mensagens mais antigas. É simples de implementar, mas pode apagar os requisitos e as restrições iniciais do usuário. Já a compressão usa um modelo para transformar o histórico em um resumo estruturado, preservando muito mais informações. Em contrapartida, exige uma chamada adicional para gerar o resumo e a recriação do cache após a compressão.
Q3: Existe uma regra universal para comprimir o contexto quando ele atinge 80%?
Não. A documentação oficial geralmente define os gatilhos por limites de tokens. Por exemplo, a Anthropic Messages API usa 150.000 como padrão e 50.000 como mínimo; o Tool Runner usa 100.000 como padrão. O limite deve ser ajustado de acordo com o tamanho da janela de contexto do modelo e o volume de saída de cada chamada de ferramenta.
Q4: Quando devo abrir uma nova janela no Codex?
É recomendável abrir uma nova janela depois de concluir uma etapa completa da tarefa, por exemplo, quando uma funcionalidade estiver desenvolvida e testada. Antes disso, você pode pedir ao agente um resumo no formato “objetivo / progresso / fatos / decisões / próximos passos” e colá-lo no início da nova sessão. Se for mudar para um assunto sem relação com a tarefa atual, também vale abrir uma nova janela para evitar que o histórico irrelevante continue consumindo sua cota.
Q5: Como acompanhar o consumo de tokens se o cliente não mostra o uso do contexto?
Você pode consultá-lo na camada da API. Conforme a documentação de uso do OpenAI Codex, ao configurar a interface do Codex com a APIYI, cada chamada gera logs detalhados e estatísticas de uso no painel da APIYI apiyi.com. Assim, você consegue acompanhar o crescimento dos tokens de entrada a cada rodada em conversas longas e decidir quando comprimir o contexto ou iniciar uma nova sessão.
Q6: Como testar rapidamente a eficácia da minha estratégia de compressão?
Use o código completo deste artigo para executar a mesma tarefa de várias etapas em três modos: “sem compressão”, “compressão por limite” e “compressão por etapa”. Depois, compare o consumo total de tokens e a qualidade da conclusão da tarefa. Com a APIYI apiyi.com, você pode usar uma única chave para escolher modelos de fornecedores diferentes para o modelo principal e o modelo de resumo, facilitando a busca por um equilíbrio entre custo e qualidade.
Q7: Quais são as limitações conhecidas da compressão de contexto?
Primeiro, o resumo pode omitir detalhes, especialmente valores de configuração discretos no código. Segundo, cada compressão invalida o cache, então comprimir com frequência pode aumentar os custos. Terceiro, o modelo de resumo às vezes pode “completar” informações que não existem. Para lidar com isso, use modelos estruturados, preserve as restrições do usuário palavra por palavra e registre fatos importantes, como caminhos de arquivos, em um arquivo externo de notas da tarefa, em vez de depender apenas do resumo.
Principais pontos sobre a compressão automática de contexto em agentes
- Essência da compressão: transformar um histórico extenso em um estado de tarefa que permita continuar a execução, em vez de apenas apagar registros.
- Três momentos para acionar a compressão: ao atingir um limite de tokens como medida de segurança, proativamente ao fim de uma etapa ou conforme o framework gerencia a pressão sobre o contexto.
- Não existe regra dos 80%: a referência oficial é um limite de tokens, que deve considerar a janela de contexto e o volume das saídas das ferramentas.
- Resumo estruturado: organizar em cinco campos — objetivo, progresso, fatos, decisões e próximos passos — e preservar literalmente as restrições do usuário.
- Não comprima a cada rodada: a compressão frequente reduz os acertos de cache; concentrá-la por etapa ajuda a economizar.
- Use logs para preencher lacunas: se o cliente não mostrar o consumo, observe o crescimento dos tokens a cada rodada nos logs de chamadas da APIYI, em apiyi.com.
Resumo
Os pontos centrais da compressão automática de contexto em agentes são:
- Quando comprimir: priorize a compressão proativa ao fim de cada etapa e use o limite de tokens como medida de segurança. A estratégia integrada ao framework é uma boa opção para começar rapidamente.
- Estratégia de resumo: preserve o comando de sistema e as últimas rodadas na íntegra, comprimindo o histórico anterior em um resumo estruturado de cinco campos.
- Equilíbrio de custos: a compressão invalida o cache. O ideal é manter um crescimento estável durante cada etapa e concentrar a compressão no final.
Se você usa o Codex no dia a dia, pode fazer uma versão manual da compressão: ao concluir uma etapa, gere um resumo e abra uma nova janela. Se estiver desenvolvendo seu próprio agente, adapte diretamente o código deste artigo. Para validar os resultados rapidamente, experimente a APIYI em apiyi.com: a plataforma oferece créditos gratuitos para testes e uma interface unificada para vários modelos. Com os logs de chamadas, você consegue acompanhar claramente a variação de tokens antes e depois da compressão.
📚 Referências
- Documentação da OpenAI Responses API: compactação de contexto e configuração de
compact_threshold - Link:
platform.openai.com/docs/api-reference/responses -
Descrição: orientações oficiais sobre compactação automática no servidor e gerenciamento de estado
-
Documentação do OpenAI Agents SDK: estratégias de gerenciamento de contexto durante a execução de agentes
- Link:
openai.github.io/openai-agents-python -
Descrição: configuração de estratégias de compactação automática, por limite fixo ou forçada
-
Documentação de compactação de contexto da Anthropic: parâmetros que acionam a compactação na Messages API e no Tool Runner
- Link:
docs.anthropic.com - Descrição: valores padrão de
trigger.valueecontext_token_thresholde uso da compactação sob demanda
Autor: equipe técnica APIYI
Troca de conhecimento técnico: entre em contato conosco pela página inicial do site da APIYI. Para mais informações sobre configuração do Codex, conversas com múltiplas interações e cobrança por cache, acesse a central de documentação em docs.apiyi.com