Nota do autor: vamos destrinchar como Claude descobriu a origem das sementes das curvas elípticas do NIST, explicar os limites dessa conclusão e apresentar três formas de usar agentes de IA que pesquisadores podem aplicar diretamente, com código e métodos para controlar custos.
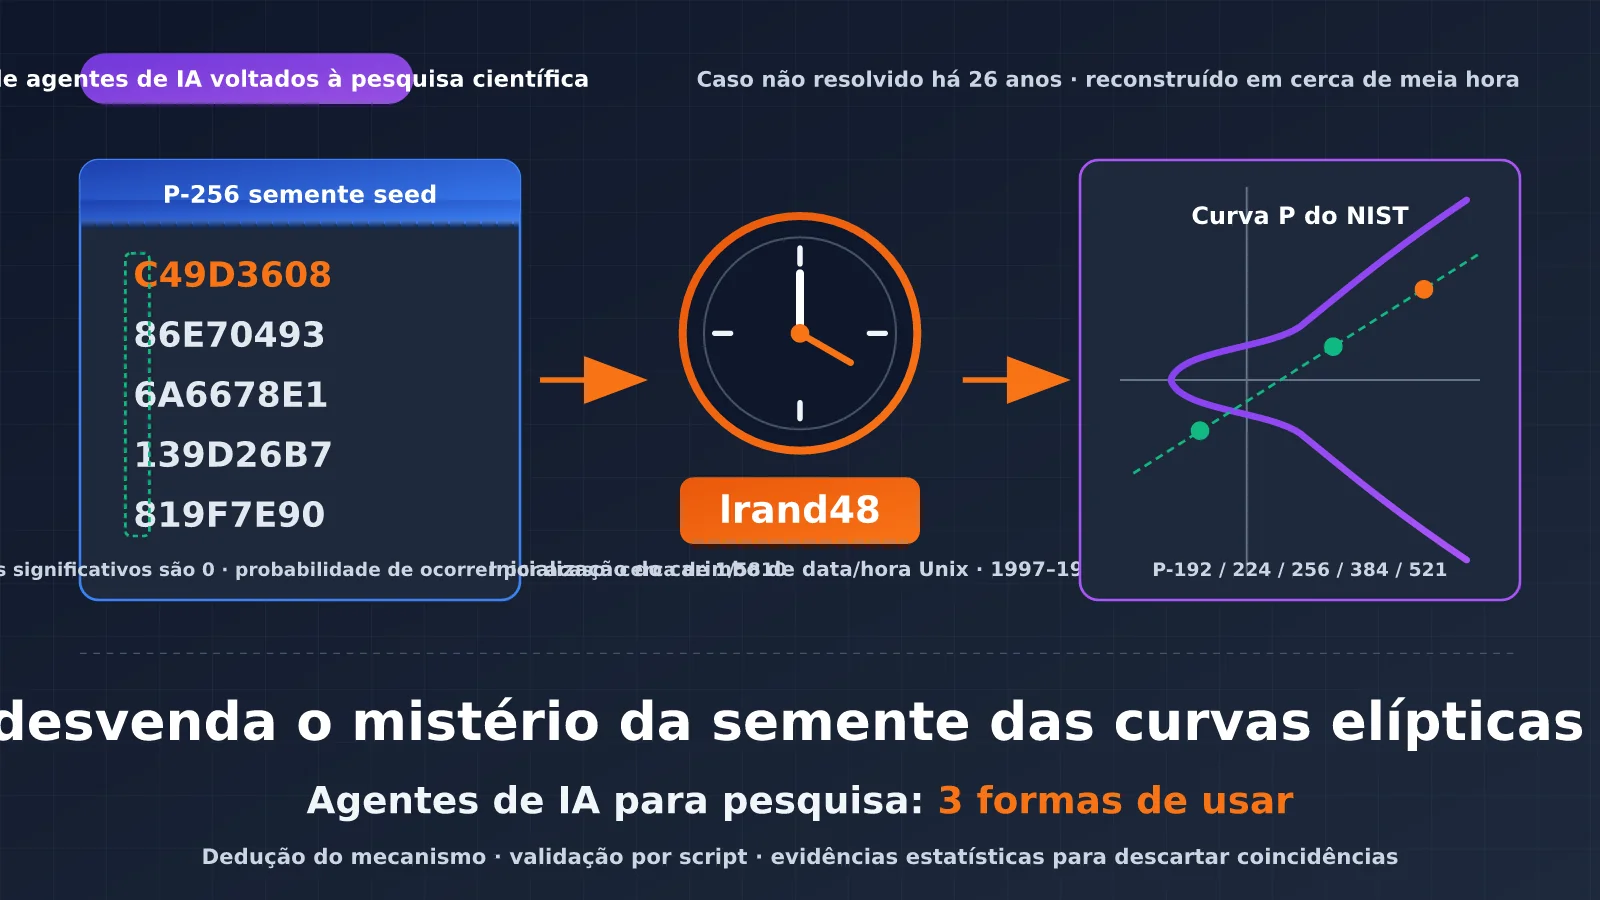
Em 17 de outubro de 2026, a Anthropic Frontier Red Team publicou uma pesquisa: sem receber nenhuma instrução, um modelo de pesquisa interno descobriu, em cerca de meia hora, como foram geradas as sementes das cinco curvas NIST P-192, P-224, P-256, P-384 e P-521. Essas sementes não passaram por nenhum algoritmo de hash. Elas eram saídas do gerador de números pseudoaleatórios lrand48, incluído em bibliotecas C dos anos 1990, com um valor inicial baseado no timestamp Unix. A publicação oficial de @AnthropicAI dizia apenas: “It is just timestamps.” Ela teve cerca de 855 mil visualizações.
Isso não é uma quebra da criptografia nem uma nova vulnerabilidade. Para pesquisadores, o valor desse caso está na forma como Claude trabalhou: deduziu o mecanismo, escreveu um script para verificá-lo e usou evidências estatísticas para descartar a hipótese de coincidência. Esse processo pode ser aplicado diretamente à sua própria pesquisa.
O principal benefício: ao terminar a leitura, você vai saber o que esse caso comprova — e o que não comprova — e terá três fluxos de trabalho com agentes de IA para pesquisa que já pode colocar em prática, cada um com instruções e código executável.
O mistério das sementes das curvas elípticas do NIST desvendado pelo Claude: principais conclusões
| Ponto principal | Explicação | O que isso significa para pesquisadores |
|---|---|---|
| Contexto do enigma | Em 2000, o NIST adotou o ECDSA no FIPS 186-2. As sementes das curvas foram fornecidas pela NSA, sem explicação sobre sua origem. | Um problema que ninguém resolveu por 26 anos pode servir como teste da capacidade de raciocínio da IA. |
| Conclusão | As sementes vieram de saídas do lrand48, inicializado com timestamps entre maio de 1997 e abril de 1998. |
Qualquer pessoa pode reproduzir a conclusão, com baixo custo de verificação. |
| Método principal | Deduzir como o software provavelmente foi escrito, criar um scanner próprio, localizar padrões estatísticos e, depois, recuperar o estado. | Essas três etapas podem ser aplicadas à análise de dados experimentais, à modelagem reversa e a outras tarefas. |
| Implicações para a segurança | Isso não constitui uma vulnerabilidade. Os usuários não precisam mudar configurações nem migrar para outro sistema. | Ao citar o caso em uma revisão ou relatório, descreva-o com precisão e sem exageros. |
| Questões em aberto | A semente da curva B-163 ainda não foi desvendada, e o método usado para gerar o ponto base G das curvas de P-224 a P-521 continua desconhecido. | As conclusões da IA também têm limites; é importante registrar o que ainda não foi resolvido. |
O que o mistério das sementes das curvas elípticas do NIST prova
O padrão ECDSA publica uma semente para cada curva. O hash da semente é usado para determinar o coeficiente b da curva. A semente de P-256 é C49D3608 86E70493 6A6678E1 139D26B7 819F7E90. Como sua origem nunca foi explicada, a comunidade há muito suspeitava que a NSA pudesse ter escolhido de propósito parâmetros com pontos fracos. Koblitz e Menezes escreveram uma revisão chamada A Riddle Wrapped in an Enigma, e Filippo Valsorda chegou a oferecer uma recompensa de US$ 36.864 pelo enigma. Por um tempo, circulou a história de que Jerry Solinas havia gerado a semente a partir do hash de uma frase de brincadeira. Mais tarde, essa hipótese foi desmentida.
Na prática, essa descoberta reforça a confiança nessas curvas. As sementes foram produzidas por um gerador de números pseudoaleatórios comum, inicializado pelo relógio, sem margem para escolha humana. Qualquer pessoa pode reproduzir o processo. O artigo também observa que algumas curvas candidatas igualmente válidas foram descartadas, por motivos desconhecidos, mas eram poucas — o que não parece indicar uma seleção deliberada de curvas fracas. O valor da recompensa será doado ao Internet Security Research Group.
Ao citar esse caso em um artigo ou em uma reunião de grupo, uma formulação precisa seria: “A IA reconstruiu o processo de geração de um parâmetro histórico e tornou possível reproduzi-lo.” Evite dizer que “a IA quebrou a criptografia de curvas elípticas”.
Os 4 passos usados pelo Claude para deduzir a origem das sementes
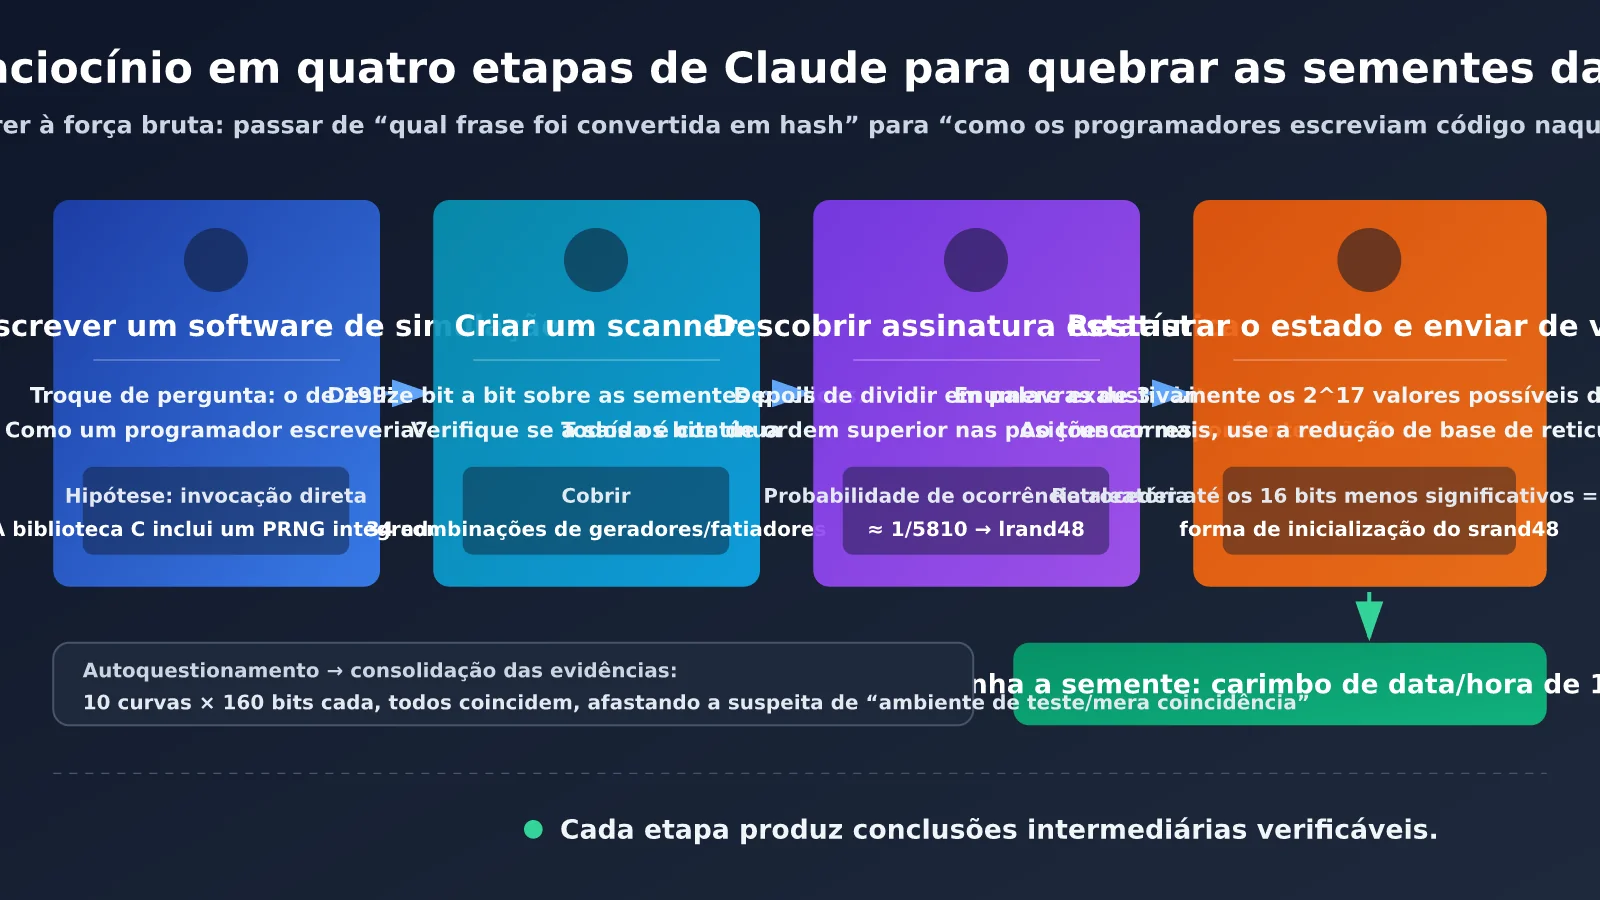
O raciocínio não se baseou em tentativas aleatórias exaustivas. O processo seguiu uma cadeia de inferências que pode ser verificada:
- Reformular a pergunta: em vez de tentar adivinhar “qual frase foi usada para gerar o hash”, o modelo deduziu como alguém que estivesse escrevendo um programa para gerar curvas em 1997 provavelmente teria implementado o código. A conclusão foi que provavelmente usou diretamente o gerador de números aleatórios integrado à biblioteca C.
- Criar um scanner: deslizar bit a bit pelas sementes publicadas e testar se trechos adjacentes pareciam saídas consecutivas de algum gerador dos anos 1990. Foram avaliadas 34 combinações de geradores e recortes.
- Identificar a assinatura estatística: ao dividir as sementes em palavras de 32 bits, os bits mais significativos nas posições correspondentes eram todos zero. A probabilidade de isso acontecer por acaso é de cerca de 1 em 5.810. Esse padrão é compatível com o
lrand48, que retorna os 31 bits mais significativos de um estado de 48 bits. - Recuperar o estado e voltar no tempo: testar exaustivamente os 2^17 valores possíveis para os 17 bits ocultos e validar o resultado com palavras subsequentes. Para as sementes com mais bits truncados, o modelo usou redução de base de reticulado LLL. Em seguida, retrocedeu o estado até encontrar o padrão de inicialização do
srand48: os 16 bits menos significativos iguais a0x330E.
Houve ainda um detalhe interessante durante o raciocínio: por um momento, o modelo suspeitou que pudesse estar em um ambiente de teste. Depois, descartou essa hipótese ao considerar que “10 curvas, com 160 bits correspondentes em cada uma, não poderiam coincidir por acaso”. Esse movimento de “primeiro questionar a própria hipótese e, depois, usar evidências para chegar a uma conclusão” é exatamente o que mais importa em um agente de pesquisa.
Primeiros passos com um agente de IA para pesquisa: um único Key para chamar modelos de ponta
Antes de começar, coloque o fluxo de chamadas da API para funcionar. A APIYI oferece uma interface compatível com a OpenAI: com um único Key, você pode chamar o claude-opus-5-5 ou alternar para modelos de ponta das famílias GPT e Gemini para fazer validações cruzadas.
Não é preciso repetir aqui as etapas de integração. Consulte diretamente o guia oficial de início rápido da APIYI: docs.apiyi.com/getting-started. Siga as instruções para criar um Key no painel de controle e obter o base_url (https://api.apiyi.com/v1). Depois, use o exemplo da documentação para confirmar que o fluxo está funcionando. Consulte o painel para ver os preços e os modelos disponíveis.
Os três casos de uso a seguir compartilham um pequeno wrapper. Salve-o como research_client.py. Ele faz basicamente duas coisas: escolhe o modelo de acordo com a etapa e contabiliza o uso de tokens para ajudar a controlar os custos.
# research_client.py
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")
CHEAP = os.environ.get("CHEAP_MODEL", "claude-opus-5-5")  # 填控制台里的轻量模型名
FLAGSHIP = "claude-opus-5-5"
USAGE = {"prompt": 0, "completion": 0, "calls": 0}


def chat(messages, stage="draft", max_tokens=2048, temperature=0.2):
    """stage='draft' 走便宜模型;stage='verify' 走旗舰模型。"""
    r = client.chat.completions.create(model=FLAGSHIP if stage == "verify" else CHEAP,
        messages=messages, max_tokens=max_tokens, temperature=temperature)
    USAGE["prompt"] += r.usage.prompt_tokens
    USAGE["completion"] += r.usage.completion_tokens
    USAGE["calls"] += 1
    return r.choices[0].message.content


def ask(prompt, stage="draft", system=None, max_tokens=2048):
    msgs = ([{"role": "system", "content": system}] if system else []) + [{"role": "user", "content": prompt}]
    return chat(msgs, stage=stage, max_tokens=max_tokens)


def report():
    print(f"累计调用 {USAGE['calls']} 次,prompt={USAGE['prompt']},completion={USAGE['completion']}")
Como controlar os custos de um agente de IA para pesquisa: use modelos baratos para ajustar o fluxo e modelos de ponta para validações importantes
Tarefas de pesquisa costumam exigir várias rodadas de iteração. Se você usar um modelo de ponta do começo ao fim, vai gastar créditos com problemas de baixo valor, como erros de formatação e falhas ao analisar JSON. Uma abordagem mais segura é distribuir os modelos por etapa:
| Etapa | Modelo recomendado | Critério de avaliação | max_tokens típico |
|---|---|---|---|
| Depuração do fluxo (formato do comando, análise, avaliador) | Modelo leve e barato | O fluxo roda de ponta a ponta sem erros | 512-1024 |
| Geração de hipóteses (listar mecanismos candidatos) | Priorize um modelo leve; passe para um modelo de ponta se a cobertura for insuficiente | A lista de candidatos cobre as principais hipóteses que você já conhece | 1024-2048 |
| Raciocínio sobre mecanismos e validações importantes | claude-opus-5-5 | A conclusão será incluída em um artigo ou determinará o investimento nas próximas etapas experimentais | 2048-4096 |
| Validação cruzada | Alterne para o modelo de ponta de outro provedor usando o mesmo Key | Os dois modelos chegam à mesma conclusão de forma independente | 2048 |
Na prática, vale guardar uma regra: na primeira execução do script, use um modelo barato; quando for registrar uma conclusão pela primeira vez, use um modelo de ponta.
Caso de uso 1 de um agente de IA para pesquisa: primeiro deduza o mecanismo, depois valide
Esta etapa corresponde à abordagem do Claude de “mudar a pergunta”: em vez de tentar adivinhar a resposta diretamente, primeiro deduza o mecanismo que gerou os dados e depois teste essa hipótese com os próprios dados. Ela é útil quando os dados experimentais apresentam padrões anômalos, quando você precisa inferir o processo que gerou dados históricos ou quando não consegue encontrar os parâmetros de origem ao reproduzir um artigo.
Etapas
- Descreva apenas o fenômeno, sem sugerir explicações: forneça ao modelo os dados observados, as restrições conhecidas e o contexto histórico. Evite dizer “acho que isso foi causado por XX” para não direcionar o modelo.
- Peça mecanismos e previsões falsificáveis: cada mecanismo candidato deve incluir uma previsão do tipo “se este mecanismo estiver correto, que característica deve aparecer nos dados?”.
- Ordene pelo custo de validação: peça ao modelo que ordene as opções pelo tempo necessário para validá-las, da menor para a maior. Comece pelas mais baratas.
- Peça a um modelo de ponta para revisar a ordem: você pode gerar a lista de candidatos com um modelo barato e deixar a ordenação final e o raciocínio a cargo do claude-opus-5-5.
Modelo de comando
from research_client import ask, report

PROMPT = """你是一名严谨的研究助理。下面是一组观测数据和背景,不包含任何关于成因的线索。

【观测】
{observation}

【背景约束】
{context}

请完成:
1. 推演“产生这组数据的过程最可能怎么实现”,至少列出 5 个候选机制;
2. 每个机制给出一条可证伪预测:若成立,数据中必然出现的可检验特征;
3. 估计验证每条预测的成本(低/中/高),按成本升序输出;
4. 指出你最不确定的环节。
输出为 Markdown 表格 + 简短说明。"""

draft = ask(PROMPT.format(
    observation="NIST P-256 种子:C49D3608 86E70493 6A6678E1 139D26B7 819F7E90",
    context="1997-1998 年由政府机构用软件生成;官方未公布生成方法;常见猜测为短语哈希但未被证实",
), stage="draft")

final = ask("请审查并修正以下候选机制列表,删除无法证伪的条目,重新排序:\n" + draft,
            stage="verify", max_tokens=3000)
print(final)
report()
Para avaliar se esta etapa foi bem executada, confira dois critérios: cada mecanismo tem uma previsão falsificável? A validação que aparece em primeiro lugar pode ser concluída em até uma hora? Se algum dos critérios não for atendido, peça ao modelo para reescrever a resposta.
Uso 2 de um AI Agent para pesquisa científica: pedir ao modelo que escreva scripts de varredura e validação
Esta etapa corresponde à abordagem em que o Claude escreve um scanner que cobre 34 combinações de geradores e fatias. O ponto principal é transformar “parece com” em “é pouco provável que seja coincidência do ponto de vista estatístico”. Essa abordagem também serve para tarefas como varredura de parâmetros, detecção de sinais e busca por estruturas ocultas nos dados.
Etapas
- Peça ao modelo que escreva um script de varredura, dependente apenas da biblioteca padrão, para testar a previsão com menor custo de validação da primeira abordagem.
- Peça que o script execute também um conjunto de controles aleatórios e informe a “taxa de acerto nos dados reais” e a “taxa de acerto nos dados aleatórios”.
- Execute o script localmente. O modelo fica responsável por escrever o código, não por relatar os resultados.
- Se o resultado for significativo, peça a um modelo de ponta que escreva um script mais rigoroso de recuperação de estado ou ajuste.
Exemplo: reproduzindo uma assinatura estatística como “todos os bits mais altos são 0”
O script abaixo demonstra o princípio por trás da assinatura neste caso. lrand48 retorna os 31 bits mais altos de um estado de 48 bits. Portanto, quando o resultado é armazenado em uma palavra de 32 bits, o bit mais alto sempre será 0. Já em dados verdadeiramente aleatórios, a probabilidade de o bit mais alto de cada palavra ser 0 é de apenas metade.
import os

def lrand48_stream(seed32, n):
    x = (seed32 << 16) | 0x330E          # srand48 inicializa com os 16 bits inferiores fixos em 0x330E
    out = []
    for _ in range(n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        out.append(x >> 17)               # lrand48 retorna apenas os 31 bits mais altos
    return out

def top_bit_zero_ratio(words):
    return sum(1 for w in words if w >> 31 == 0) / len(words)

lr = lrand48_stream(870000000, 20)        # Um timestamp Unix de por volta de 1997
rnd = [int.from_bytes(os.urandom(4), "big") for _ in range(20)]
print("Proporção de bits mais altos iguais a 0 em lrand48:", top_bit_zero_ratio(lr))   # Sempre 1.0
print("Proporção em dados verdadeiramente aleatórios:", top_bit_zero_ratio(rnd))       # Oscila em torno de 0.5
Validando a conclusão final com o código oficial
A página de pesquisa da Anthropic inclui o código de reprodução, publicado sob a licença CC0. De acordo com as instruções oficiais, o conjunto de parâmetros abaixo deve produzir a semente da especificação P-256:
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

seed = candidate(unix("1997-08-16 01:52:34"), 1842, 20, 40, 2)
print(seed)
print("Corresponde ao padrão:", seed == "C49D360886E704936A6678E1139D26B7819F7E90")
O script funciona assim: inicializa lrand48 com um timestamp, agrupa cada 20 saídas para formar uma semente candidata de 20 bytes e verifica se a candidata número 1842 é a semente da especificação. Toda a validação pode ser concluída em menos de um segundo em um notebook comum. “É caro formular a hipótese, mas barato validar a conclusão” é a estrutura ideal para esse tipo de pesquisa.
Uso 3 de um AI Agent para pesquisa científica: combinar com um avaliador automático e iterar até a pontuação convergir
Nas duas primeiras abordagens, uma pessoa avalia os resultados. Na terceira, essa tarefa fica por conta de um programa. Você escreve um avaliador, o modelo envia uma proposta a cada rodada e o avaliador retorna a pontuação e os exemplos que falharam. Com base nisso, o modelo revisa a proposta até a pontuação parar de melhorar. Essa abordagem é adequada para tarefas com métricas de avaliação claras, como regras de extração de dados, ajuste de formas funcionais e busca de parâmetros experimentais.
Etapas
- Escreva o avaliador antes de escolher o modelo: ele precisa ser um programa determinístico, sem depender da avaliação do próprio modelo.
- Separe os conjuntos de desenvolvimento e de validação: use apenas o conjunto de desenvolvimento para dar feedback e, no final, verifique se houve sobreajuste com o conjunto de validação.
- Limite o formato das respostas: peça ao modelo que envie dados como JSON ou expressões regulares, em vez de executar diretamente o código gerado. Se for necessário executar código, faça isso em um sandbox.
- Defina critérios de convergência: pare quando atingir a pontuação máxima, quando não houver melhora por duas rodadas consecutivas ou ao chegar ao número máximo de rodadas — o que acontecer primeiro.
- Teste o ciclo com um modelo mais barato e, depois, use um modelo de ponta para o experimento oficial.
Exemplo: iterando expressões regulares para extrair parâmetros de registros experimentais
import json, re
from research_client import chat, report

DEV = [
    ("样品A在 350 ℃ 退火 2 小时后测得电导率 4.1 S/m。", {"temp_c": 350, "hours": 2, "cond": 4.1}),
    ("退火温度 420°C,保温 1.5 h,电导率为 12.3 S/m。", {"temp_c": 420, "hours": 1.5, "cond": 12.3}),
    ("B组:300摄氏度下处理 3 小时,σ=0.85 S/m。", {"temp_c": 300, "hours": 3, "cond": 0.85}),
    ("在450 ℃条件下退火4h,测得电导率 20 S/m。", {"temp_c": 450, "hours": 4, "cond": 20}),
]
HOLDOUT = [
    ("样品E 380 ℃ 退火 2.5 小时,电导率 7.6 S/m。", {"temp_c": 380, "hours": 2.5, "cond": 7.6}),
    ("C组于 500°C 保温 0.5 h,σ = 33.1 S/m。", {"temp_c": 500, "hours": 0.5, "cond": 33.1}),
]
FIELDS = ["temp_c", "hours", "cond"]

def score(patterns, data):
    hit, fails = 0, []
    for idx, (text, label) in enumerate(data):
        for f in FIELDS:
            try:
                m = re.search(patterns.get(f, "(?!)"), text)
                ok = m is not None and abs(float(m.group(1)) - label[f]) < 1e-9
            except (re.error, IndexError, ValueError, TypeError):
                ok = False
            hit += ok
            if not ok:
                fails.append(f"样本{idx} 字段{f} 抽取失败:{text}")
    return hit / (len(data) * len(FIELDS)), fails

def parse_json(text):
    return json.loads(text[text.find("{"): text.rfind("}") + 1])

messages = [{"role": "user", "content":
    "为下列实验记录写 Python 正则,抽取 temp_c、hours、cond 三个字段,每个正则恰好一个捕获组,捕获纯数字。"
    "只输出 JSON,例如 {\"temp_c\": \"...\", \"hours\": \"...\", \"cond\": \"...\"},注意转义反斜杠。\n"
    + "\n".join(t for t, _ in DEV)}]

best, stale, patterns = -1.0, 0, {}
for rnd in range(6):
    reply = chat(messages, stage="draft", max_tokens=800)   # 跑通后把 stage 改为 "verify"
    try:
        patterns = parse_json(reply)
        s, fails = score(patterns, DEV)
    except (ValueError, json.JSONDecodeError):
        s, fails = 0.0, ["输出不是合法 JSON"]
    print(f"第 {rnd + 1} 轮 开发集得分 {s:.2f}")
    if s >= 1.0:
        break
    stale = stale + 1 if s <= best else 0
    best = max(best, s)
    if stale >= 2:
        break
    messages += [{"role": "assistant", "content": reply},
                 {"role": "user", "content": "以下抽取失败,请修改正则后重新输出完整 JSON:\n" + "\n".join(fails)}]

print("留出集得分:", score(patterns, HOLDOUT)[0])
report()
Um ponto importante: se o modelo obtiver pontuação máxima no conjunto de desenvolvimento, mas tiver um resultado claramente pior no conjunto de validação, isso indica que ele está “decorando as respostas”. Nesse caso, amplie o conjunto de desenvolvimento em vez de continuar iterando.
Comparação entre os 3 usos de AI Agents para pesquisa científica
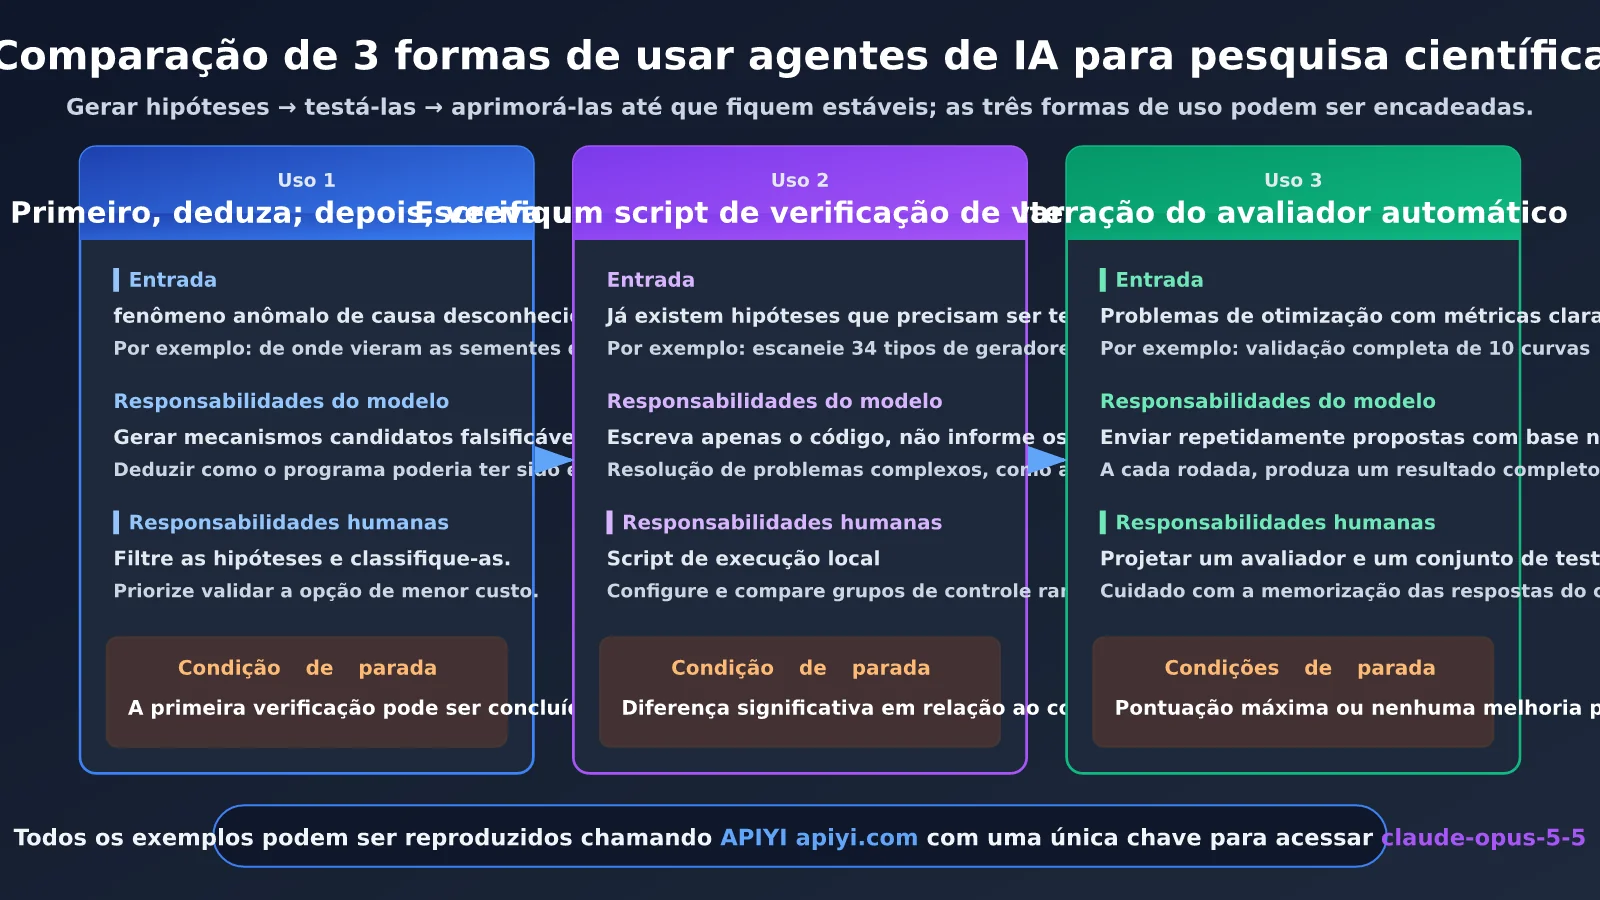
| Dimensão | Uso 1: formular hipóteses | Uso 2: scripts de varredura e validação | Uso 3: iteração com avaliador automático |
|---|---|---|---|
| Etapa correspondente no caso | Deduzir como o programa foi escrito em 1997 | Varredura de 34 geradores e busca por assinaturas estatísticas | Validar todas as 10 curvas após recuperar o estado |
| Tarefas indicadas | Anomalias de causa desconhecida, hipóteses de engenharia reversa | Hipóteses já formuladas que precisam de testes quantitativos | Problemas de otimização com métricas bem definidas |
| Responsabilidade do modelo | Gerar mecanismos candidatos que possam ser refutados | Escrever código, sem relatar resultados | Enviar propostas repetidamente |
| Responsabilidade da pessoa | Selecionar e priorizar hipóteses | Executar localmente e analisar o grupo de controle | Projetar o avaliador e o conjunto de validação |
| Quando envolver um modelo de ponta | Dedução e priorização finais | Resolver problemas complexos, como LLL | Rodadas do experimento oficial |
| Critério de parada | A primeira validação pode ser concluída em até 1 hora | Diferença significativa em relação ao controle aleatório | Pontuação máxima ou nenhuma melhora por 2 rodadas seguidas |
| Forma de acesso | Interface unificada APIYI apiyi.com | A mesma | A mesma |
As três abordagens podem ser combinadas: a primeira gera hipóteses, a segunda as testa e a terceira aprimora as soluções validadas até que fiquem estáveis.
Por que tarefas de pesquisa como as do Claude exigem um modelo de ponta
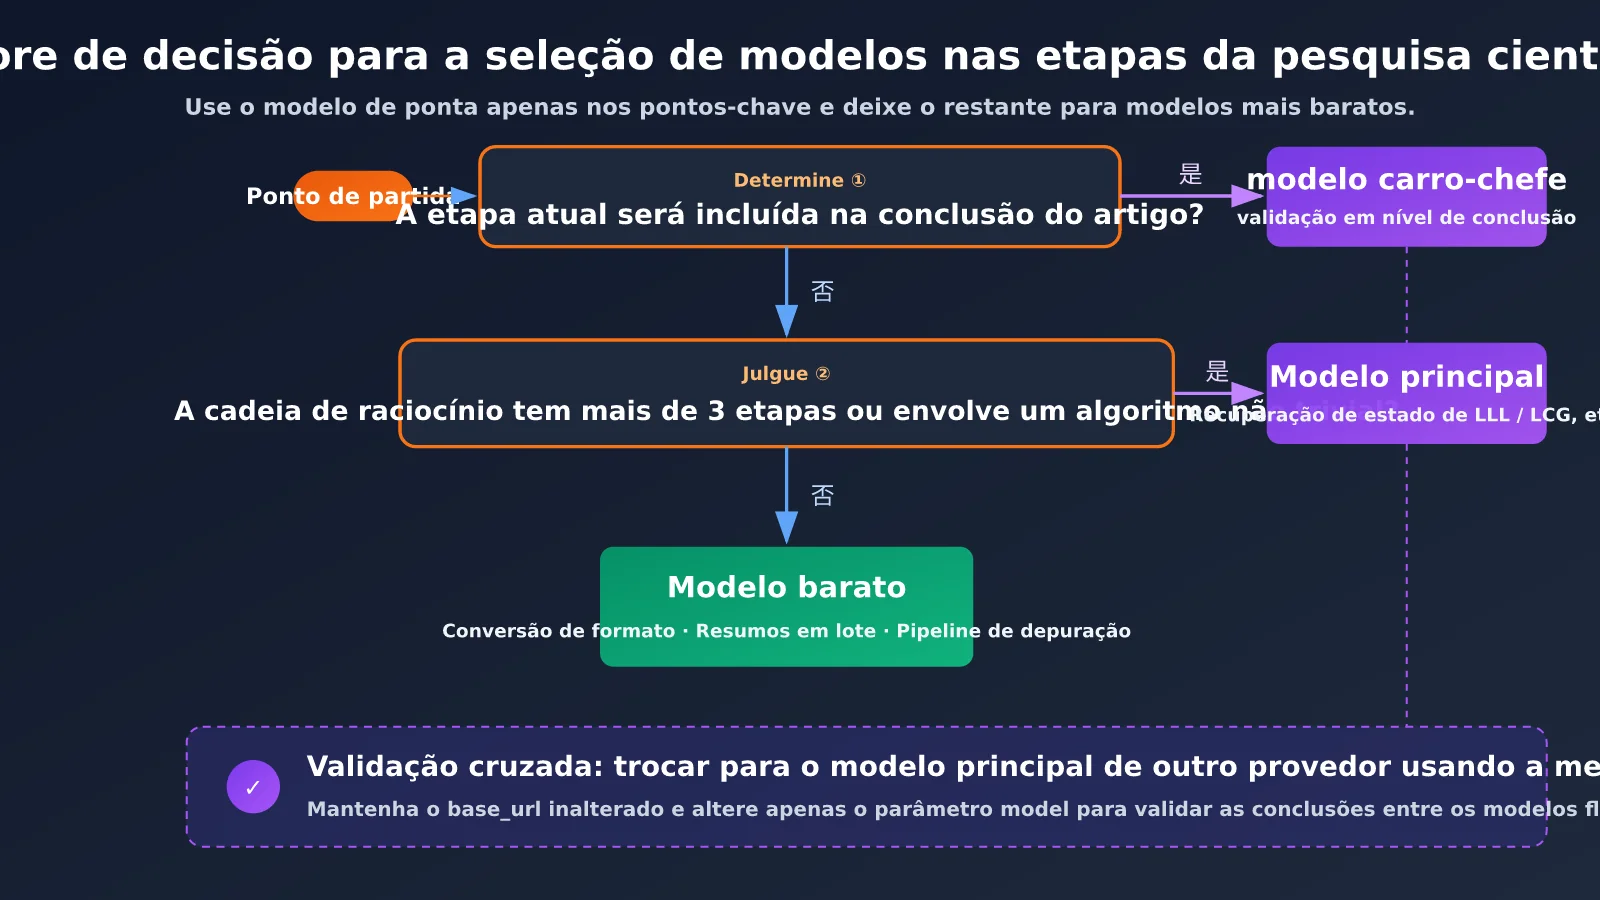
Nem todas as etapas de uma pesquisa precisam de um modelo de ponta, mas há tarefas que simplesmente não funcionam bem quando se troca para um modelo menor. Use a tabela abaixo como referência:
| Critério | Quando vale a pena usar um modelo de ponta | Motivo |
|---|---|---|
| Exige associações entre áreas diferentes | Por exemplo, relacionar “semente de curva” a “detalhes de implementação de bibliotecas C dos anos 1990” | Modelos menores tendem a ficar na superfície do problema, por exemplo, continuando a tentar adivinhar frases |
| A cadeia de raciocínio tem mais de 3 etapas, e cada uma depende da anterior | Por exemplo: dedução → varredura → assinatura → recuperação do estado | Se qualquer etapa intermediária estiver errada, todo o restante sai do rumo |
| Exige questionamento próprio | Por exemplo, suspeitar: “Será que estou em um ambiente de teste?” | Modelos de ponta têm mais chance de buscar contraexemplos por iniciativa própria |
| Envolve algoritmos não triviais | Por exemplo, redução de base LLL ou recuperação do estado de um LCG truncado | A correção do código determina diretamente se a validação é válida |
| A conclusão será incluída em um artigo ou determinará o investimento em experimentos | Qualquer conclusão divulgada externamente | O custo de um erro é muito maior do que o custo da invocação |
Por outro lado, tarefas como conversão de formatos, resumo em lote e depuração de pipelines de avaliação podem ser feitas com modelos mais baratos. O segredo para controlar custos não é usar menos modelos de ponta, e sim reservá-los para as situações listadas na tabela.
Perguntas frequentes (FAQ)
P1: O Claude quebrou a curva elíptica do NIST?
Não. O Claude recuperou o processo de geração da semente, que vinha de um `lrand48` inicializado com um timestamp. Isso não é um novo método de ataque nem representa uma vulnerabilidade. Os usuários não precisam alterar configurações nem migrar. Na verdade, essa conclusão mostra que a semente não foi escolhida manualmente.
P2: Qual é a diferença entre esse método e a busca por força bruta tradicional?
A busca por força bruta percorre todas as possibilidades dentro de um espaço de hipóteses fixo. Primeiro, o Claude mudou esse espaço: em vez de perguntar “qual frase foi hasheada?”, perguntou “qual gerador de números aleatórios foi usado?”. Só então fez uma busca exaustiva limitada (2^17 bits ocultos). O que realmente determinou o sucesso foi a etapa anterior.
P3: Quando essa pesquisa foi publicada? O que ainda falta resolver?
A página de pesquisa da Anthropic e a publicação de @AnthropicAI foram divulgadas em 17 de outubro de 2026. A semente de B-163 ainda não foi descoberta, e o método de geração do ponto base G de P-224 a P-521 continua desconhecido. Além disso, algumas curvas candidatas foram ignoradas, sem que se saiba o motivo.
P4: Em quais cenários de pesquisa essas três formas de uso se encaixam?
– **Investigar anomalias em experimentos**: se os dados de um instrumento apresentarem artefatos periódicos, use a primeira abordagem para deduzir como o software de aquisição foi implementado.
– **Reproduzir artigos históricos**: quando faltarem parâmetros, use a segunda abordagem para varrer combinações de parâmetros candidatos.
– **Extrair e limpar dados**: use a terceira abordagem com um avaliador para iterar até chegar a regras estáveis.
P5: Como usar uma única chave API para chamar vários modelos de ponta e fazer validação cruzada?
Cadastre-se no APIYI, em apiyi.com, e crie uma chave API. Defina `base_url` como `https://api.apiyi.com/v1`. Depois, basta alterar o parâmetro `model` para alternar entre `claude-opus-5-5` e os modelos de ponta das famílias GPT e Gemini. Consulte a lista do console para ver os nomes dos modelos disponíveis.
P6: Quais são as limitações conhecidas dos agentes de IA para pesquisa?
– O modelo pode inventar mecanismos que parecem plausíveis; por isso, toda conclusão precisa ser acompanhada de um script de validação que possa ser executado localmente.
– A iteração do avaliador pode levar a um sobreajuste ao conjunto de desenvolvimento. É essencial manter um conjunto de validação separado.
– O custo de várias chamadas se acumula. Primeiro, ajuste o fluxo com um modelo mais barato e registre o uso. Os detalhes da cobrança podem ser consultados no console do APIYI, em apiyi.com.
Principais pontos sobre agentes de IA para pesquisa
- Limites das conclusões: Claude identificou a origem da seed, não uma vulnerabilidade criptográfica. Na verdade, a confiabilidade da curva aumentou.
- Passo decisivo: mudar o espaço de hipóteses é mais eficaz do que aumentar o poder computacional dentro do espaço antigo.
- Validação em primeiro lugar: o modelo escreve os scripts; uma pessoa os executa. Sempre compare os resultados com uma linha de base aleatória.
- Ciclo de avaliação: combine uma avaliação determinística com um conjunto de validação separado e continue iterando até a pontuação se estabilizar.
- Modelos em camadas: use modelos mais baratos para ajustar o fluxo de trabalho e reserve os modelos de ponta para análises e validações importantes.
- Como começar: use uma única chave da APIYI apiyi.com para chamar o claude-opus-5-5 e alterne entre outros modelos para fazer validações cruzadas.
Resumo
A descoberta de Claude sobre a origem das seeds das curvas elípticas do NIST traz três aprendizados principais para pesquisadores:
- Primeiro, deduza o mecanismo: comece perguntando como os dados foram gerados, em vez de tentar adivinhar a resposta diretamente.
- Deixe os scripts falarem: toda hipótese deve vir acompanhada de código executável para validação e de uma comparação aleatória.
- Feche o ciclo de avaliação: delegue a análise a um programa determinístico, itere até os resultados se estabilizarem e use um conjunto de validação separado para verificar se houve sobreajuste.
O controle de custos deve ser uma prioridade: primeiro, use modelos mais baratos para ajustar o fluxo de trabalho; depois, recorra aos modelos de ponta nas etapas que envolvem conclusões de artigos e algoritmos complexos. Recomendamos usar a APIYI apiyi.com para executar todo o código deste artigo: comece confirmando a seed da P-256 com o código oficial de reprodução e, em seguida, aplique as três formas de uso à sua própria pesquisa.
Leitura complementar
- 📘 Como usar o SDK da OpenAI para invocar modelos da família Claude — entenda as diferenças entre os parâmetros das interfaces compatíveis
- 📊 Práticas para controlar os custos de invocação de APIs de Modelos de Linguagem Grandes — aprenda a acompanhar as estatísticas de uso e configurar alertas de orçamento
- 🚀 Como montar um fluxo de trabalho de validação cruzada entre vários modelos — permita que diferentes modelos de ponta verifiquem as conclusões uns dos outros
📚 Referências
- Página de pesquisa da equipe Frontier Red Team da Anthropic: pesquisa sobre a origem das sementes das curvas ECDSA
- Link:
www.anthropic.com/research/ecdsa-curve-origins -
Descrição: fonte primária, com a metodologia completa, questões ainda em aberto e código de reprodução sob licença CC0
-
Publicação oficial de @AnthropicAI no X (17/10/2026): “It is just timestamps.”
- Link:
x.com/AnthropicAI -
Descrição: declaração oficial; acesse aqui para acompanhar a discussão da comunidade
-
Central de documentação da APIYI: instruções para usar interfaces compatíveis com a OpenAI
- Link:
docs.apiyi.com - Descrição: configuração de
base_url, lista de modelos e informações de cobrança
Autor: Equipe técnica da APIYI
Discussão técnica: compartilhe nos comentários como você usa agentes de IA em suas pesquisas. Para mais informações sobre integração, acesse a central de documentação da APIYI em docs.apiyi.com.