Nota do autor: seguindo as etapas no console, você conclui a integração da API do GPT-6.1 Terra em 5 passos e entende a escolha do endpoint, as armadilhas com parâmetros e a precificação escalonada de 272K.
Em resumo: na integração do GPT-6.1 Terra, a única escolha importante é entre Responses e Chat Completions. Se você precisa chamar ferramentas, tem que usar Responses. Se não precisa, basta reaproveitar quase todo o código atual e trocar o nome do modelo.
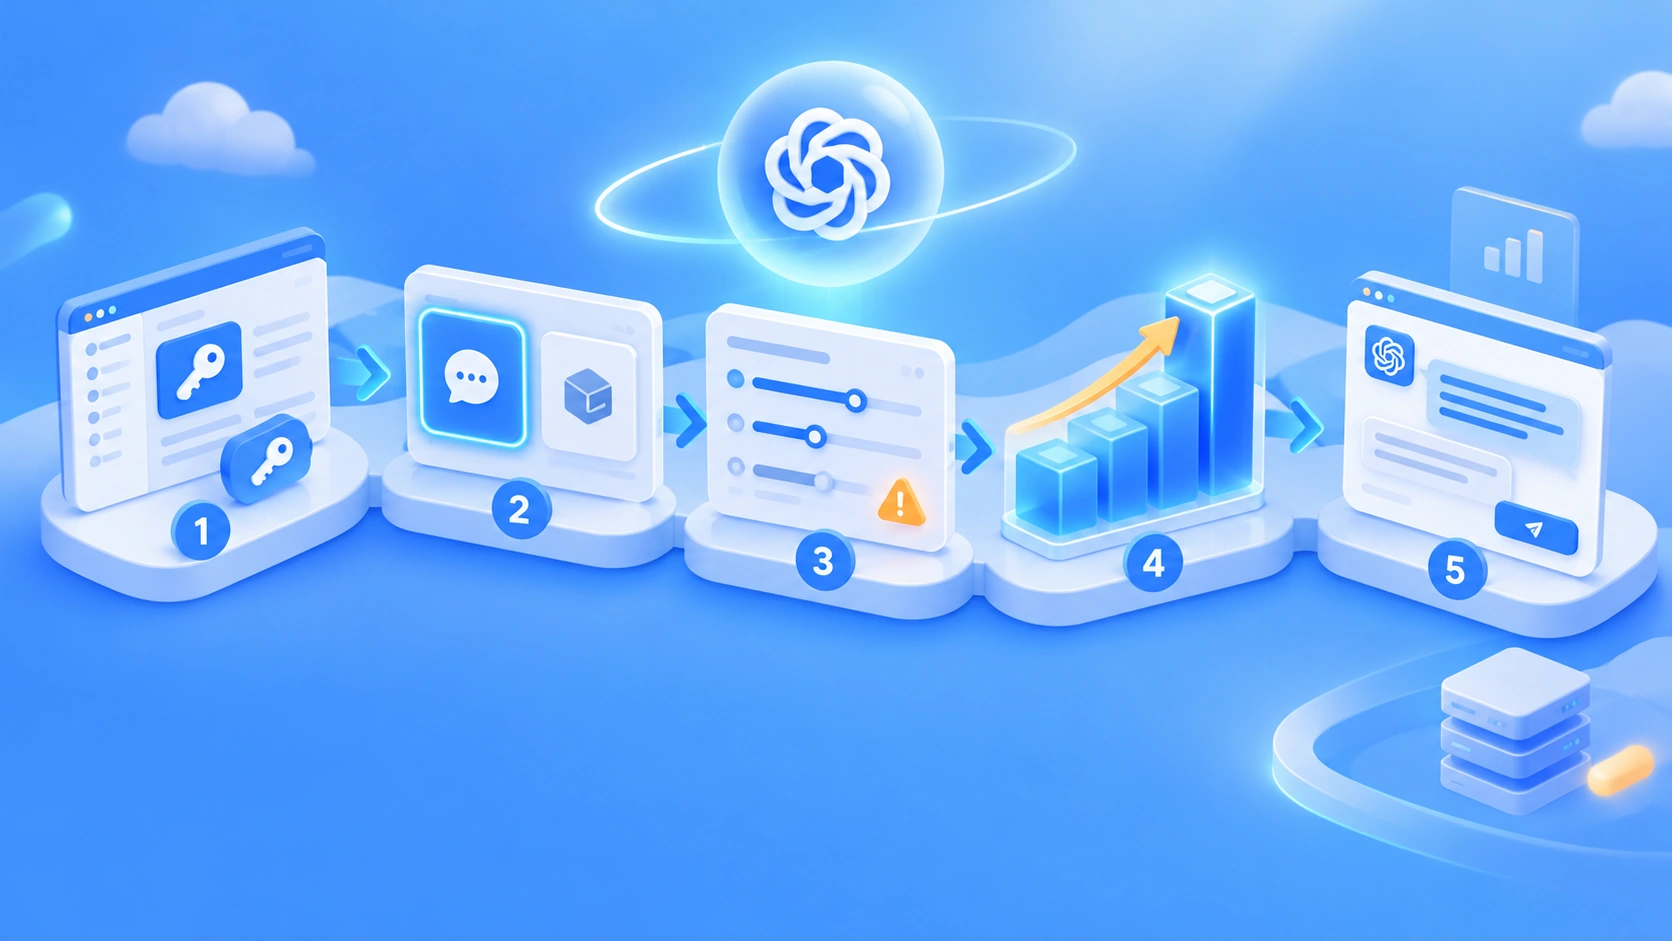
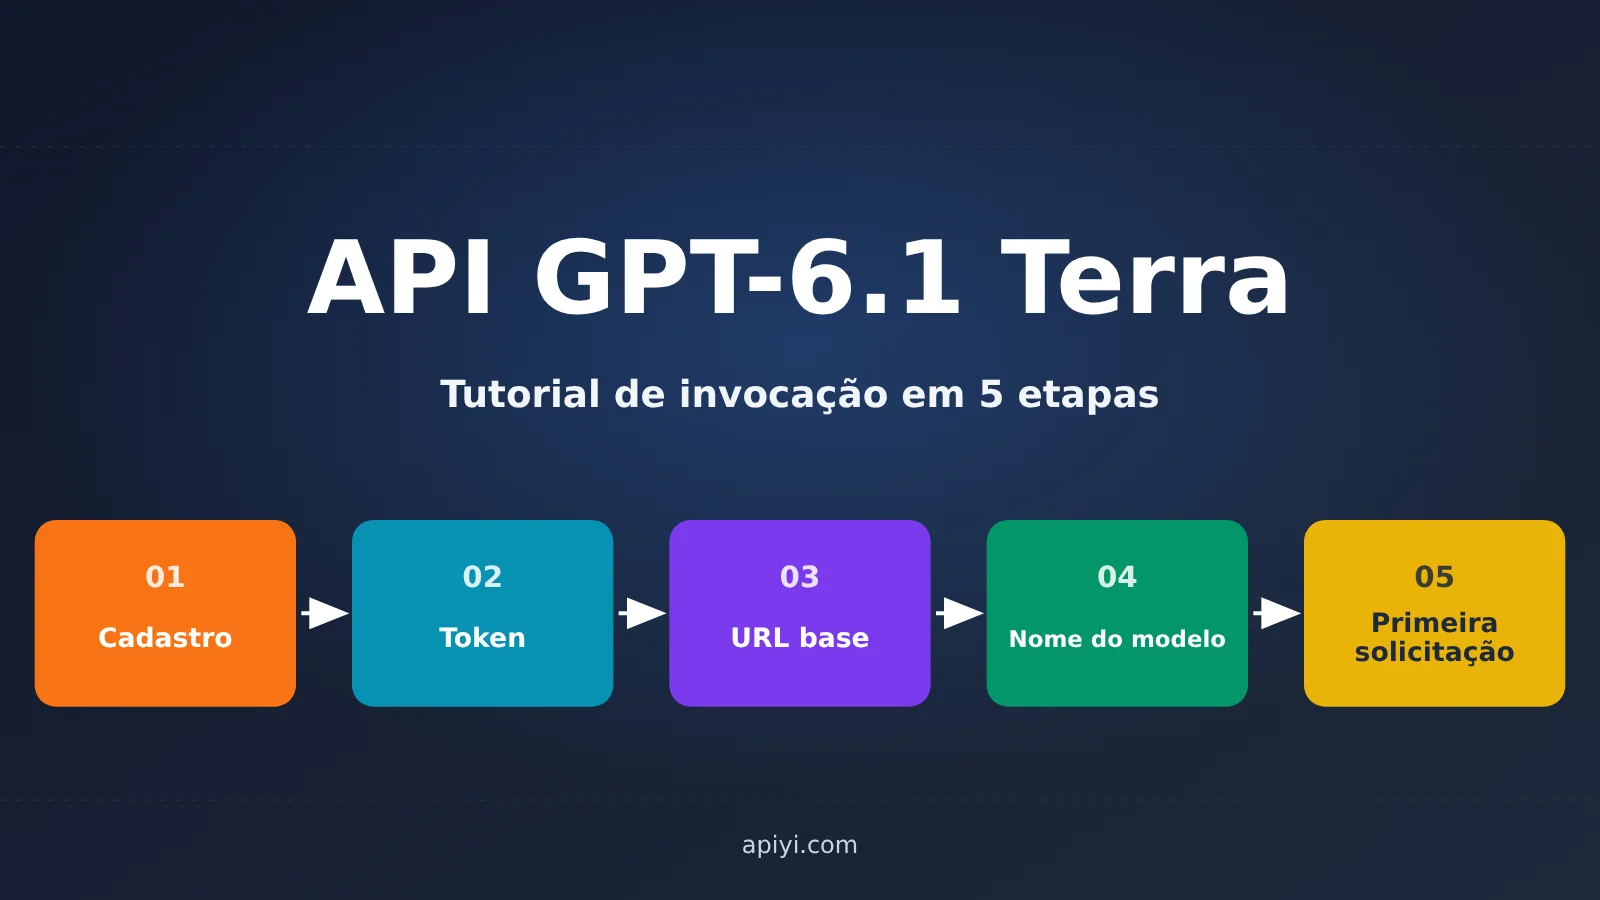
O GPT-6.1 Terra foi lançado em 2026-10-26. O ID do modelo é gpt-6.1-terra, e a documentação oficial já informa os endpoints, os parâmetros e as regras de preço — são informações que podem ser verificadas. Este artigo segue a ordem das etapas no console: cadastro → criação de um token → localização da Base URL → preenchimento do nome do modelo → envio da primeira solicitação. Cada etapa inclui um critério de validação; o uso da linha de comando e do código é opcional.
O que você vai aprender: ao terminar a leitura, você conseguirá validar no console todo o fluxo de integração da API do GPT-6.1 Terra e evitar os erros 400 mais comuns.
📌 Situação atual da plataforma: em 2026-10-27, o modelo
gpt-6.1-terraainda não aparece na lista de modelos em tempo real da APIYI apiyi.com. Vamos disponibilizá-lo o quanto antes. Os modelos da mesma geraçãogpt-6-astra,gpt-6-sol,gpt-6.1-solegpt-6-lunajá estão disponíveis. Você pode usar ogpt-6.1-solpara validar o fluxo de integração. Consulte a lista de modelos da plataforma para ver os modelos e preços atualizados.
Principais pontos da API GPT-6.1 Terra
| Ponto | Descrição | O que isso significa para você |
|---|---|---|
| ID do modelo | gpt-6.1-terra, lançado em 2026-10-26 |
Preencha o campo model da solicitação com esse valor |
| Endpoints disponíveis | Responses, Chat Completions e Batch | Endpoints como Realtime, Assistants e Embeddings não são compatíveis |
| Uso de ferramentas | Apenas o endpoint Responses é compatível | Se você incluir tools no Chat Completions, a solicitação falhará |
| Contexto | Total de 1.050.000 tokens, até 922.000 tokens de entrada por solicitação e 128.000 tokens de saída | É adequado para documentos longos, mas fique de olho na faixa de cobrança de 272K |
| Modalidades | Entrada de texto e imagens; saída de texto | Para enviar imagens, use input_image no Responses |
| Data de corte do conhecimento | 2026-06-01 | Para obter informações mais recentes, use a ferramenta web_search |
Detalhes sobre os limites de capacidade do GPT-6.1 Terra
O GPT-6.1 Terra é compatível com streaming, saídas estruturadas, chamada de funções, file_search, entrada de imagens, pesquisa na web e cache de comandos. Ele não é compatível com ajuste fino nem com saídas preditivas. Se seu projeto antigo depende de modelos ajustados ou de saídas preditivas, não será possível migrá-lo diretamente.
O endpoint Responses aceita várias ferramentas, incluindo web_search, file_search, image_generation, code_interpreter, hosted_shell, apply_patch, skills, computer_use, mcp e tool_search. Por isso, a regra é simples: se você precisa de ferramentas, escolha Responses. Neste modelo, o Chat Completions serve apenas para conversas sem ferramentas.
Como chamar a API GPT-6.1 Terra: fluxo pelo console em 5 etapas
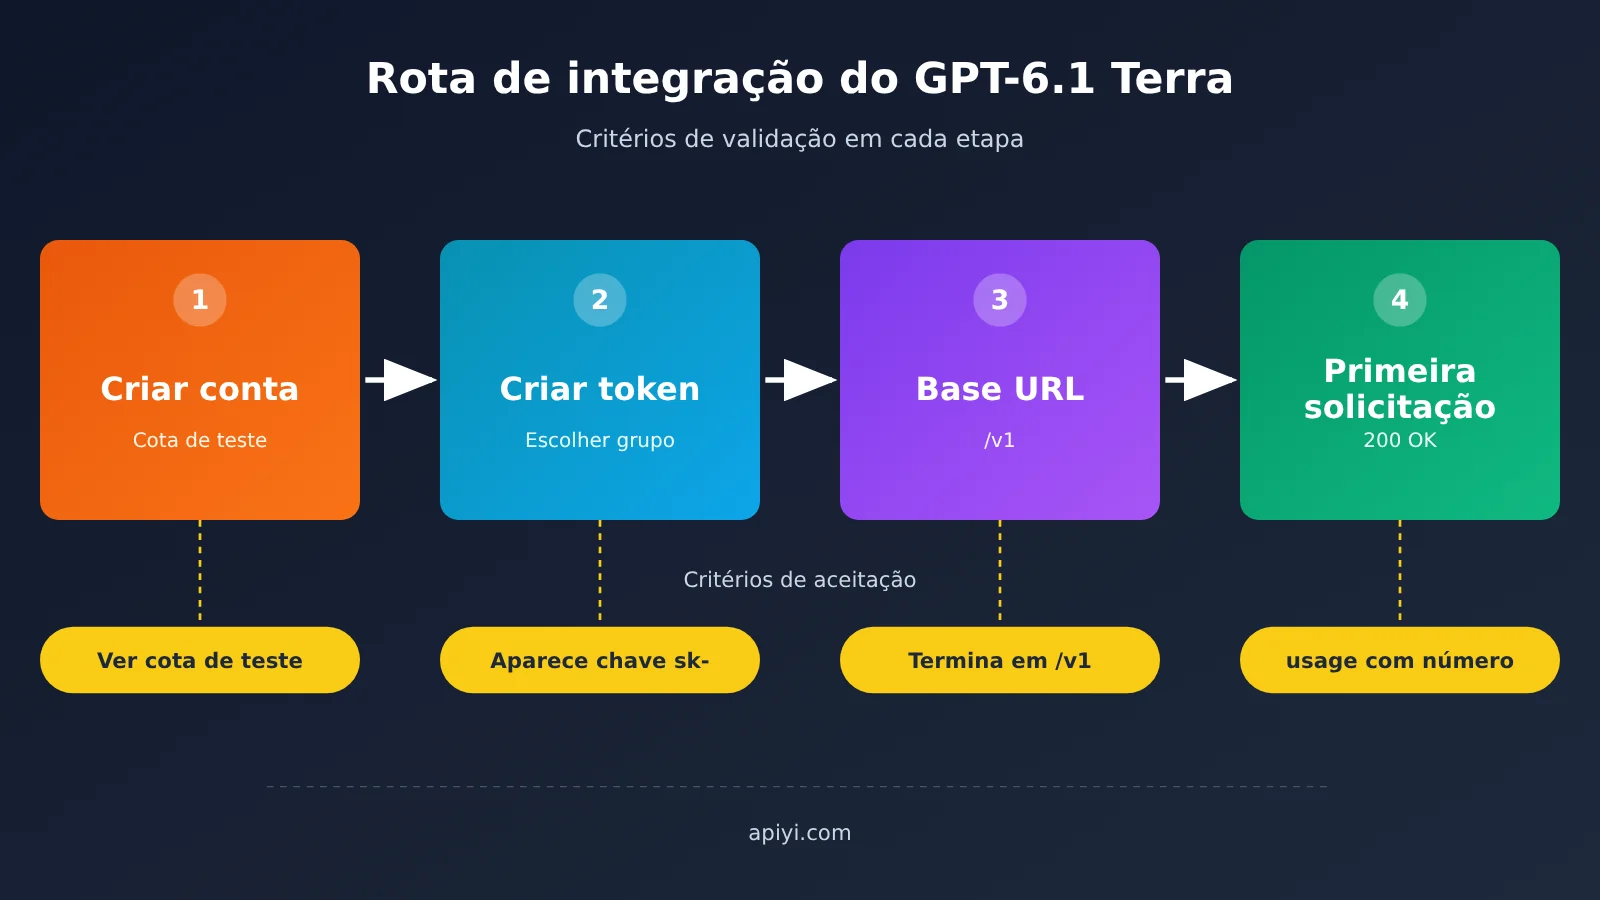
Etapa 1: criar uma conta
- Acesse APIYI apiyi.com e siga as instruções da página para criar uma conta com seus próprios dados. A plataforma exige que o cadastro seja feito pelo próprio usuário.
- Novas contas recebem US$ 0,05 em créditos de teste, o suficiente para fazer uma chamada simples sem adicionar saldo.
- Critério de validação: depois de entrar, acesse o console e confira se os créditos de teste aparecem na carteira ou na página de saldo.
- Se algo der errado: se os créditos não aparecerem, confira primeiro se você concluiu o cadastro. Não adicione saldo ainda.
Se preferir usar o canal oficial, crie uma chave na página API Keys da plataforma OpenAI. Para isso, sua conta precisa estar em uma região compatível e ter recebido créditos no nível Build — ou seja, pelo menos US$ 5.
Etapa 2: crie um token e escolha o grupo certo
- Acesse a página de tokens do painel em
api.apiyi.com/tokene clique em Criar token. - Em Selecionar grupo, escolha um grupo. Ele determina os modelos disponíveis, o multiplicador de cobrança e as rotas upstream.
defaultesviptêm o mesmo preço que o serviço oficial;CodexReverseusa recursos de engenharia reversa. - Critério de validação: depois de salvar, deve aparecer na lista de tokens uma chave que começa com
sk-. - Se tiver algum problema: o grupo do usuário não é o mesmo que o grupo do token. O que realmente vale é o grupo selecionado no token.
Etapa 3: encontre a Base URL
A Base URL varia conforme o SDK. É aqui que as pessoas mais costumam errar:
- SDK da OpenAI:
https://api.apiyi.com/v1, incluindo/v1 - SDK da Anthropic: use o domínio raiz, sem
/v1 - SDK do Google GenAI: use o domínio raiz e defina
api_versioncomov1beta
Critério de validação: a série GPT-6.1 usa o SDK da OpenAI ou um cliente compatível com a OpenAI. O endereço configurado deve terminar em /v1. Se tiver algum problema: se aparecer um erro 404, quase sempre é porque /v1 foi omitido ou adicionado duas vezes.
Etapa 4: preencher o nome do modelo
No campo de modelo do cliente ou da ferramenta de depuração, informe o ID do modelo. Recomendamos começar com um modelo leve, como gpt-5.4-mini, para validar o fluxo e, depois, trocar para gpt-6.1-sol. Quando o gpt-6.1-terra estiver disponível na plataforma, basta alterar um campo. A plataforma não aceita formatos de roteamento gratuito como auto ou auto:free, então não tente usá-los.
Critério de validação: o nome do modelo deve corresponder exatamente ao que aparece na lista de modelos da plataforma. Se algo der errado: se aparecer um erro informando que o modelo não existe, confira primeiro a grafia na lista de modelos e, em seguida, verifique se o grupo do token inclui esse modelo.
Etapa 5: fazer a primeira solicitação funcionar
Confira abaixo um exemplo mínimo funcional, com duas opções de escrita e cinco linhas:
- Defina a variável de ambiente:
export OPENAI_API_KEY=sk-你的令牌 - Crie o cliente:
client = OpenAI(base_url="https://api.apiyi.com/v1"). A chave será lida automaticamente da variável de ambiente. - Opção com Responses:
r = client.responses.create(model="gpt-6.1-sol", input="用一句话介绍你自己", reasoning={"effort": "low"}, max_output_tokens=800) - Opção com Chat:
c = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "developer", "content": "简洁回答"}, {"role": "user", "content": "你好"}], max_completion_tokens=800) - Confira a saída:
print(c.model, c.usage.prompt_tokens)
Critério de validação: a solicitação deve retornar HTTP 200 e usage.prompt_tokens deve conter um valor numérico. Na API Responses, confira usage.input_tokens. Depois de trocar para gpt-6.1-terra, o campo model da resposta deve exibir esse nome de modelo.
🚀 Comece rapidamente: recomendamos usar os créditos de teste na APIYI, em apiyi.com, para validar o
gpt-6.1-sole confirmar se a chave, o grupo e o Base URL estão configurados corretamente. Quando o Terra estiver disponível, basta alterar o nome do modelo para usá-lo. Consulte a lista de modelos da plataforma para ver os modelos e preços.
| Etapa | Ação no painel | Critério de validação | O que verificar primeiro se algo der errado |
|---|---|---|---|
| 1 Cadastro | Cadastre-se com seus dados e faça login | É possível ver os US$ 0,05 em créditos de teste | Se o cadastro foi concluído |
| 2 Token | Crie um token e selecione um grupo | A lista exibe uma chave que começa com sk- |
Se o grupo do token foi confundido com o grupo do usuário |
| 3 Base URL | No SDK da OpenAI, informe o endereço com /v1 |
O endereço termina em /v1 |
Se houver erro 404, confira o /v1 |
| 4 Nome do modelo | Informe um modelo, como gpt-6.1-sol |
Corresponde exatamente ao que aparece na lista de modelos | A grafia e os modelos disponíveis para o grupo |
| 5 Solicitação | Faça a primeira chamada | Retorna 200 e usage contém um valor numérico |
Código de status, corpo da resposta e x-request-id |
Se preferir, você também pode usar a integração mais prática do Magpie. Basta inserir a chave e o Base URL na interface gráfica. O Magpie conecta automaticamente agentes de programação como Claude Code, Codex, Pi e Hermes ao mesmo gateway, sem precisar alterar os arquivos de configuração um por um.
Seleção de endpoint da API GPT-6.1 Terra: comparação entre Responses e Chat Completions
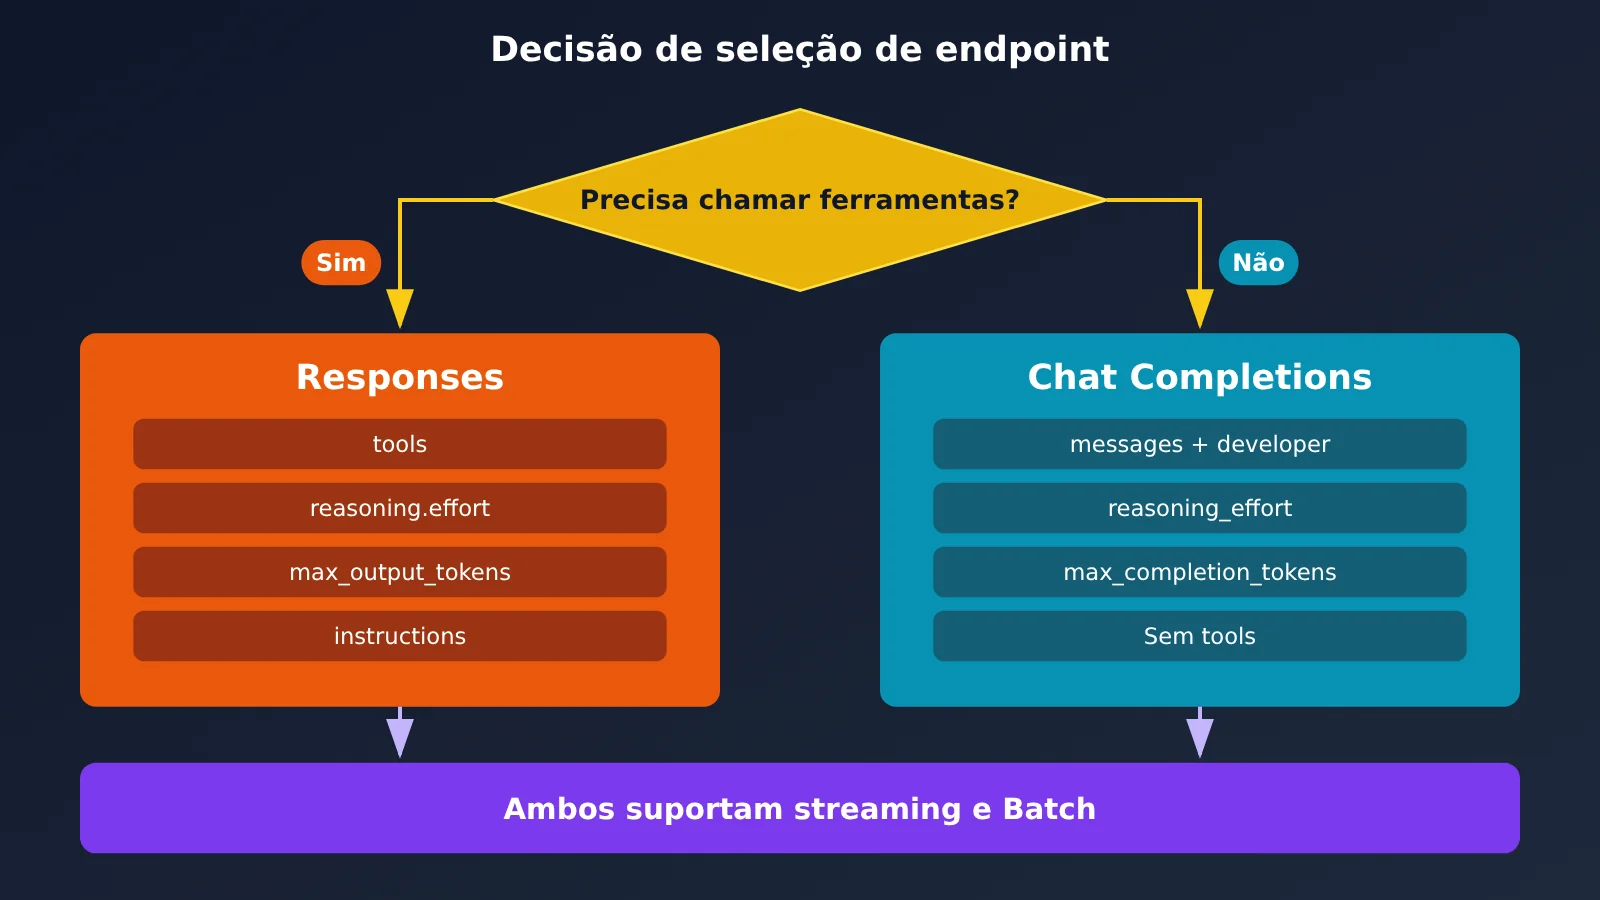
| Item de comparação | Responses (v1/responses) | Chat Completions (v1/chat/completions) |
|---|---|---|
| Chamada de ferramentas | Compatível; aceita 10 categorias de ferramentas integradas | Não compatível; uma solicitação com tools falha |
| Instruções de sistema | instructions |
Papel developer em messages, mais estável que system |
| Nível de raciocínio | reasoning: {effort: ...} |
reasoning_effort |
| Limite de saída | max_output_tokens |
max_completion_tokens |
| Formato de entrada | String ou array de mensagens; imagens usam input_image | Array de messages |
| Reenvio de várias rodadas | include: ["reasoning.encrypted_content"]; inclua também, sem alterações, o output da rodada anterior |
Monte o histórico de mensagens por conta própria |
| Uso no streaming | Retornado por padrão | É preciso adicionar stream_options: {include_usage: true} |
Análise comparativa com Chat Completions: a API Chat leva vantagem na compatibilidade com código legado: na maioria dos projetos, basta alterar o nome do modelo para tudo funcionar. Porém, no Terra, ela não permite chamar ferramentas, e algumas configurações descartam mensagens system. Já o Responses oferece suporte nativo a ferramentas e ao reenvio de raciocínio criptografado, sendo mais adequado para criar agentes e fluxos de raciocínio com várias rodadas.
Há seis níveis de raciocínio: none, low, medium (padrão), high, xhigh e max. Não existe o nível minimal. Os tokens de raciocínio contam tanto para o custo quanto para o limite de saída. Por isso, reserve uma margem em max_output_tokens; caso contrário, a saída pode ser truncada antes de o raciocínio terminar.
Três armadilhas de parâmetros na API GPT-6.1 Terra
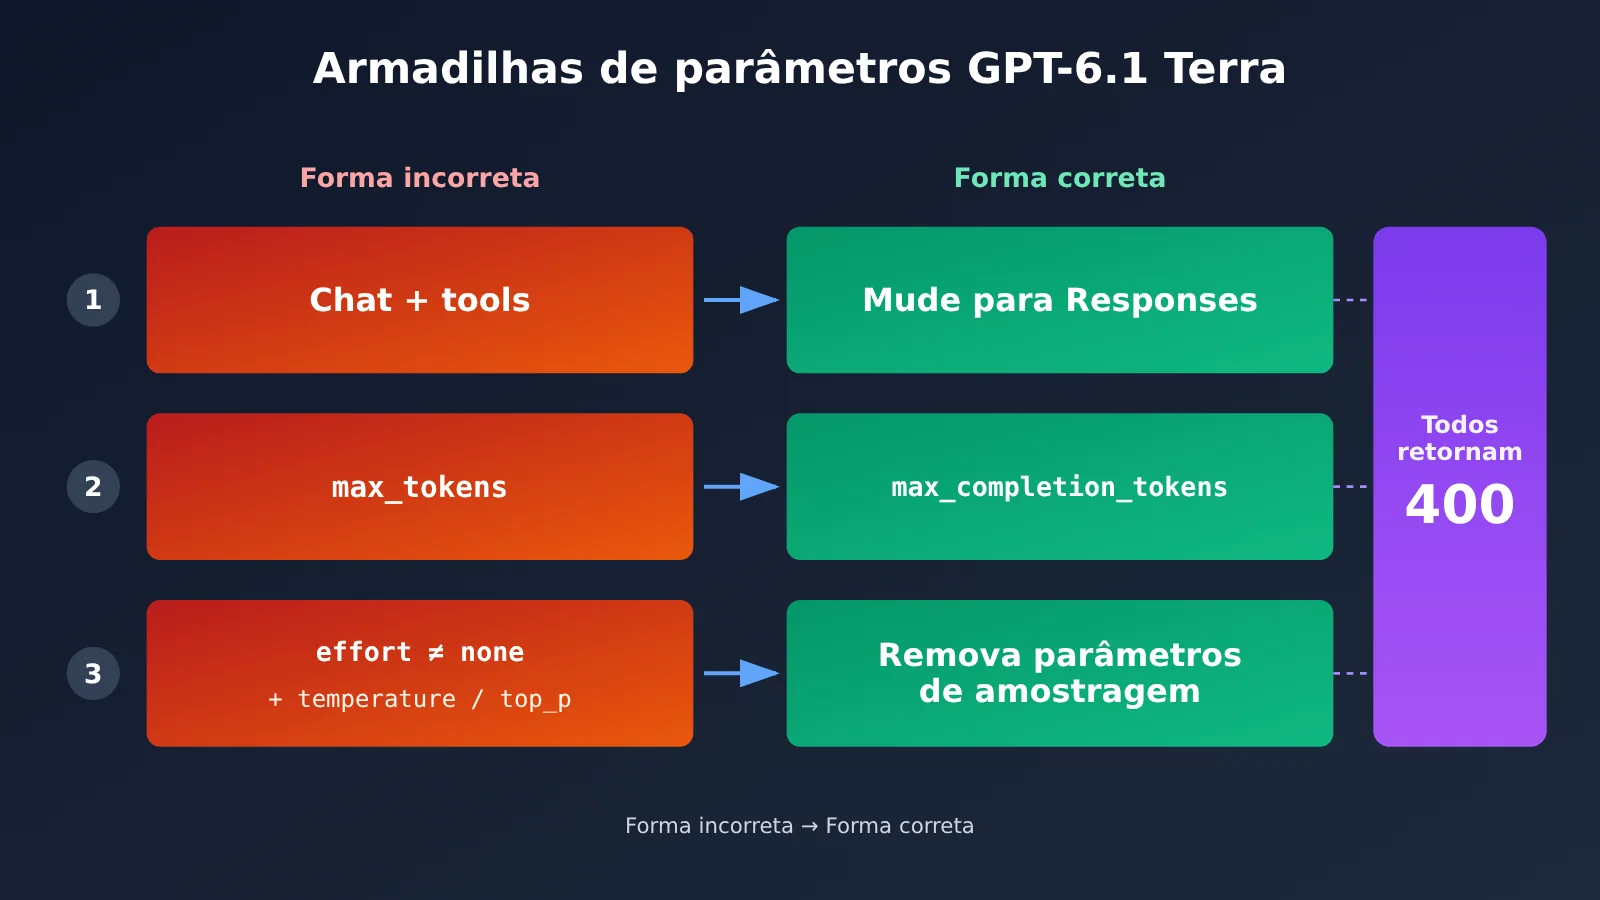
| Armadilha | Forma incorreta | Forma correta | Consequência |
|---|---|---|---|
| Chat com tools | Enviar tools em chat.completions | Usar o endpoint Responses | Falha na solicitação |
| Parâmetro antigo | Enviar max_tokens pelo Chat |
Trocar por max_completion_tokens |
400 |
| Conflito nos parâmetros de amostragem | Enviar temperature ou top_p quando effort não for none | Remover temperature, top_p e top_logprobs. No Chat, também remover logprobs | 400 |
Além dessas três armadilhas, a documentação oficial também lista algumas situações que provocam erro 400: enviar minimal em effort, informar um valor inválido em prompt_cache_options.ttl ou ultrapassar o limite de 922.000 tokens na entrada. O link usado para enviar imagens precisa permitir que o servidor faça o download. Sites com proteção contra bots podem causar falhas; nesse caso, é mais seguro usar um data URL em base64.
Ao investigar erros, lembre-se de um detalhe importante: o texto original do erro aparece apenas uma vez, no corpo da resposta. Os logs de back-end servem como registro de cobrança, e chamadas com falha não são contabilizadas. Por isso, guarde o código de status HTTP, o corpo original completo da resposta e o x-request-id do cabeçalho. Não chame raise_for_status() antes de ler o corpo, ou a mensagem de erro será perdida.
Preços da API GPT-6.1 Terra e faixa de 272K
A seguir estão os preços oficiais, em dólares por milhão de tokens. Atenção: a faixa é definida pela solicitação inteira. Se a entrada ultrapassar 272K, todos os itens cobrados nessa solicitação passam a usar os preços da segunda faixa.
| Item de cobrança | Entrada ≤ 272K | Entrada > 272K |
|---|---|---|
| Entrada | 1 | 2 |
| Saída (incluindo tokens de raciocínio) | 5 | 7.5 |
| Leitura do cache | 0.05 | 0.1 |
| Gravação no cache (30 minutos) | 1.25 | 2.5 |
| Gravação no cache (12 horas) | 2.50 | 5 |
Para estimar o custo, considere os quatro itens: entrada, saída, leitura do cache e gravação no cache. Também é preciso diferenciar as duas durações da gravação: 30 minutos e 12 horas. Considerar apenas os preços de entrada e saída leva a uma estimativa abaixo do custo real em cenários com contexto longo e uso de cache. Os modelos da mesma geração já disponíveis na plataforma têm preços idênticos aos oficiais nos quatro itens e também seguem a cobrança por faixa, aplicada à solicitação inteira.
Os limites de taxa oficiais do plano Standard são: Build, 5.000 RPM / 1 milhão de TPM; Launch, 10 mil RPM / 4 milhões de TPM; Grow, 15 mil RPM / 40 milhões de TPM.
💰 Dica para reduzir custos: em tarefas com documentos longos, tente manter cada entrada abaixo de 272K e use o cache de comandos. Isso pode reduzir bastante o preço por unidade. Na APIYI apiyi.com, os grupos
defaultesvipoferecem preços iguais aos oficiais. Consulte a lista de modelos da plataforma para ver os modelos e preços disponíveis.
Aviso de segurança da API GPT-6.1 Terra
Guarde a chave API em uma variável de ambiente ou em um serviço de gerenciamento de segredos. Não a inclua diretamente no código-fonte nem a envie para um repositório Git. Recomendamos adicionar o arquivo .env ao .gitignore. Se a chave vazar, exclua-a imediatamente na página de tokens e gere outra. Também é importante escolher o grupo certo para o token: um grupo incorreto pode gerar desde um erro de modelo indisponível até cobranças com multiplicadores inesperados. O ideal é usar tokens diferentes para cada projeto, facilitando o controle de cotas e a desativação.
Perguntas frequentes (FAQ)
P1: O que é o GPT-6.1 Terra?
É um modelo lançado pela OpenAI em 2026-10-26, com o ID `gpt-6.1-terra`. Tem uma janela de contexto de 1.050.000 tokens, aceita texto e imagens como entrada e gera texto como saída. Pode ser acessado pelos endpoints Responses, Chat Completions e Batch.
P2: Como escolher entre Responses e Chat Completions para o GPT-6.1 Terra?
Se precisar de chamadas de ferramentas, como function calling ou web_search, escolha Responses. Para conversas simples, Chat também funciona, mas você deve usar `max_completion_tokens` e não pode incluir `tools`.
P3: Já é possível chamar o gpt-6.1-terra pela APIYI?
Até 2026-10-27, o modelo ainda não está disponível na plataforma, mas vamos lançá-lo em breve. Enquanto isso, você pode usar o modelo da mesma geração `gpt-6.1-sol` na APIYI, em apiyi.com, para validar a integração. Consulte a lista de modelos da plataforma para confirmar os modelos e preços disponíveis.
P4: Por que recebo um erro 400 quando envio temperature?
Quando o nível de esforço de raciocínio não está definido como none, não é possível enviar `temperature`, `top_p` ou `top_logprobs`. Remova esses parâmetros ou defina `effort` como none.
P5: Posso fazer testes sem adicionar créditos?
Sim. Novas contas registradas na APIYI, em apiyi.com, recebem US$ 0,05 em créditos de teste, o suficiente para fazer uma chamada simples. Recomendamos validar primeiro a integração com `gpt-5.4-mini` e, depois, mudar para o modelo desejado.
P6: Quais são as limitações conhecidas do GPT-6.1 Terra?
O modelo não oferece suporte a fine-tuning nem a predicted outputs. Também não pode ser usado com os endpoints Realtime, Assistants, Embeddings, Images, Audio e outros. Entradas com mais de 272K tokens são cobradas integralmente pela segunda faixa de preço. Acima de 922.000 tokens, a solicitação retorna um erro 400.
GPT-6.1 Terra API: principais pontos
- A escolha mais importante: se precisar de ferramentas, use Responses; caso contrário, basta trocar o nome do modelo no Chat.
- Três armadilhas com parâmetros: não envie
toolsno Chat; usemax_completion_tokens; seeffortnão fornone, não envie parâmetros de amostragem. - 5 etapas no console: faça o cadastro, crie um token e escolha um grupo, informe a Base URL com
/v1, preencha o nome do modelo e envie uma solicitação. - Sinais de que está tudo certo: a chave começa com
sk-, a solicitação retorna200,usageapresenta valores numéricos e o campomodelretorna o nome informado. - Quatro itens de cobrança: entrada, saída, leitura do cache e gravação no cache. Acima de 272K, a solicitação inteira entra na segunda faixa de preço.
- Como começar: primeiro, teste o fluxo completo com
gpt-6.1-solna APIYI. Quando o Terra estiver disponível, basta trocar o nome do modelo.
Resumo
Os pontos principais para integrar a API GPT-6.1 Terra podem ser resumidos em três:
- Escolha o endpoint primeiro: decida se vai usar Responses ou Chat. Isso define como escrever os parâmetros e se será possível usar ferramentas.
- Valide cada etapa: token, Base URL, nome do modelo e primeira solicitação — cada etapa tem sinais claros para confirmar que está funcionando.
- Tenha os custos em mente: a faixa acima de 272K é calculada sobre a solicitação inteira, e os quatro itens de cobrança do cache também devem entrar no orçamento.
Recomendamos começar testando o fluxo completo com gpt-6.1-sol na APIYI, em apiyi.com. Em 27/10/2026, o modelo gpt-6.1-terra ainda não estava disponível na plataforma. Vamos disponibilizá-lo em breve. Consulte a lista de modelos da plataforma para ver os nomes e preços atualizados.
📚 Referências
- Página do modelo OpenAI — GPT-6.1 Terra: especificações do modelo e suporte a endpoints
- Link:
platform.openai.com/docs/models/gpt-6.1-terra -
Descrição: informações oficiais sobre contexto, modalidades e ferramentas disponíveis
-
Guia dos modelos mais recentes da OpenAI: migração de parâmetros e limitações
- Link:
platform.openai.com/docs/guides/latest-model -
Descrição: regras para parâmetros como reasoning.effort e max_completion_tokens
-
Página de preços da OpenAI: preços por faixa e valores para cache
- Link:
platform.openai.com/docs/pricing - Descrição: preços para as duas faixas de 272K e para diferentes durações de gravação em cache
Autor: equipe técnica da APIYI
Contato técnico: fale com a gente pela página inicial do site da APIYI. Para mais informações sobre a integração, consulte o centro de documentação em docs.apiyi.com