Nota do autor: o Gemini 4 Hydrogen concentra programação do dia a dia, processamento de conteúdos e execução de Agent em um único modelo. Este artigo resume as novas capacidades, as formas de acesso gratuito e a divisão de tarefas em relação aos modelos da mesma família.
Resumo em uma frase: o Gemini 4 Hydrogen é o modelo de execução de alta eficiência que o Google lançou dentro da família Gemini 4, com foco em programação do dia a dia, Agent com múltiplas ferramentas e processamento de conteúdos em vários formatos. Usuários do plano gratuito podem experimentá-lo pelo modo Auto do Gemini App ou pelo nível gratuito do Google AI Studio.
Para saber: 5 termos para entender antes de ler
- Agent: sistema que conclui tarefas de várias etapas com o modelo e um ambiente de execução de ferramentas — por exemplo, primeiro buscar arquivos, depois alterar o código e, por fim, executar testes.
- Token: unidade de medida que o modelo usa para processar texto e outras informações; tanto a cobrança da API quanto o limite de contexto são calculados em tokens.
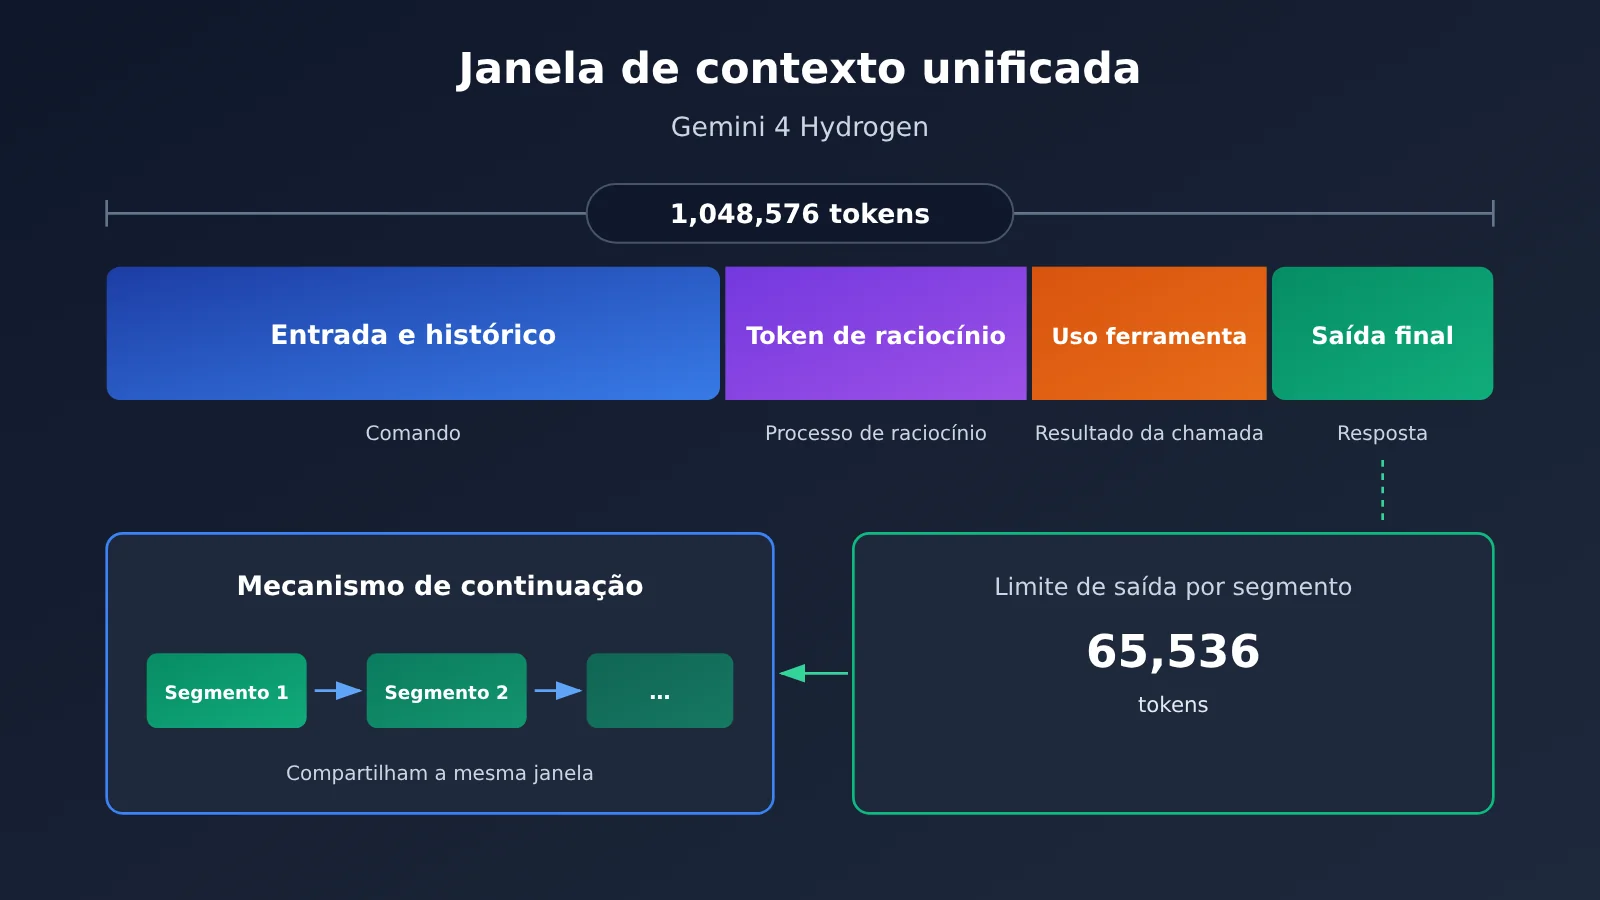
- Janela de contexto: intervalo de informações que uma única execução do modelo consegue acomodar; o limite específico é definido pelo modelo. No Hydrogen, entrada, pensamento, chamadas de ferramentas e saída somam 1,048,576 tokens.
- thinking_level: parâmetro do nível de pensamento que controla a profundidade de raciocínio do modelo. O Hydrogen oferece quatro níveis: Low, Medium, High e XHigh.
- Grounding: conectar as respostas geradas às evidências externas recuperadas, como Google Search Grounding e Google Maps Grounding.
O Google lançou oficialmente o Gemini 4 Hydrogen em 12 de novembro de 2026 e começou a liberá-lo gradualmente no Gemini API, no Google AI Studio, no Gemini App e na Pesquisa Google. A maior mudança desta vez é que ele levou o nível de inteligência da família Gemini 4 para tarefas diárias de alta frequência. No Terminal-Bench 4.1, o resultado oficial é 57.0%, contra 18.2% do Gemini 3.8 Flash da geração anterior.
Não se trata de vazamento nem de notícia de pré-lançamento. O blog oficial do Google, o model card do Google DeepMind, a documentação técnica do Google Cloud e o blog oficial do Google em chinês já confirmaram o lançamento; TechCrunch, Ars Technica, 9to5Google e The Verge também noticiaram.
Valor central: entenda em poucos minutos o que o Gemini 4 Hydrogen melhorou, onde é possível usá-lo gratuitamente e se ele se encaixa no seu trabalho.
Google lança oficialmente o Gemini 4 Hydrogen: a família Gemini 4 ganha um novo membro
Visão rápida das informações essenciais do Gemini 4 Hydrogen
| Item | Detalhe verificado |
|---|---|
| Data de lançamento | 12 de novembro de 2026, implantação gradual em todo o mundo |
| Responsável | Google DeepMind |
| ID do modelo na API | gemini-4-hydrogen |
| Posicionamento oficial | Modelo de execução eficiente para programação cotidiana e AI Agent |
| Modelos da mesma família | Gemini 4 Carbon, Gemini 4 Argon |
| Cota de contexto | Entrada, raciocínio, chamadas de ferramentas e saída somam 1.048.576 tokens |
| Níveis de raciocínio | Low / Medium / High / XHigh, com High como padrão na API |
| Corte de conhecimento | Março de 2026 |
| Status do produto | Disponível oficialmente (o Google Cloud indica GA de curto prazo, com aviso de pelo menos 45 dias antes da desativação) |
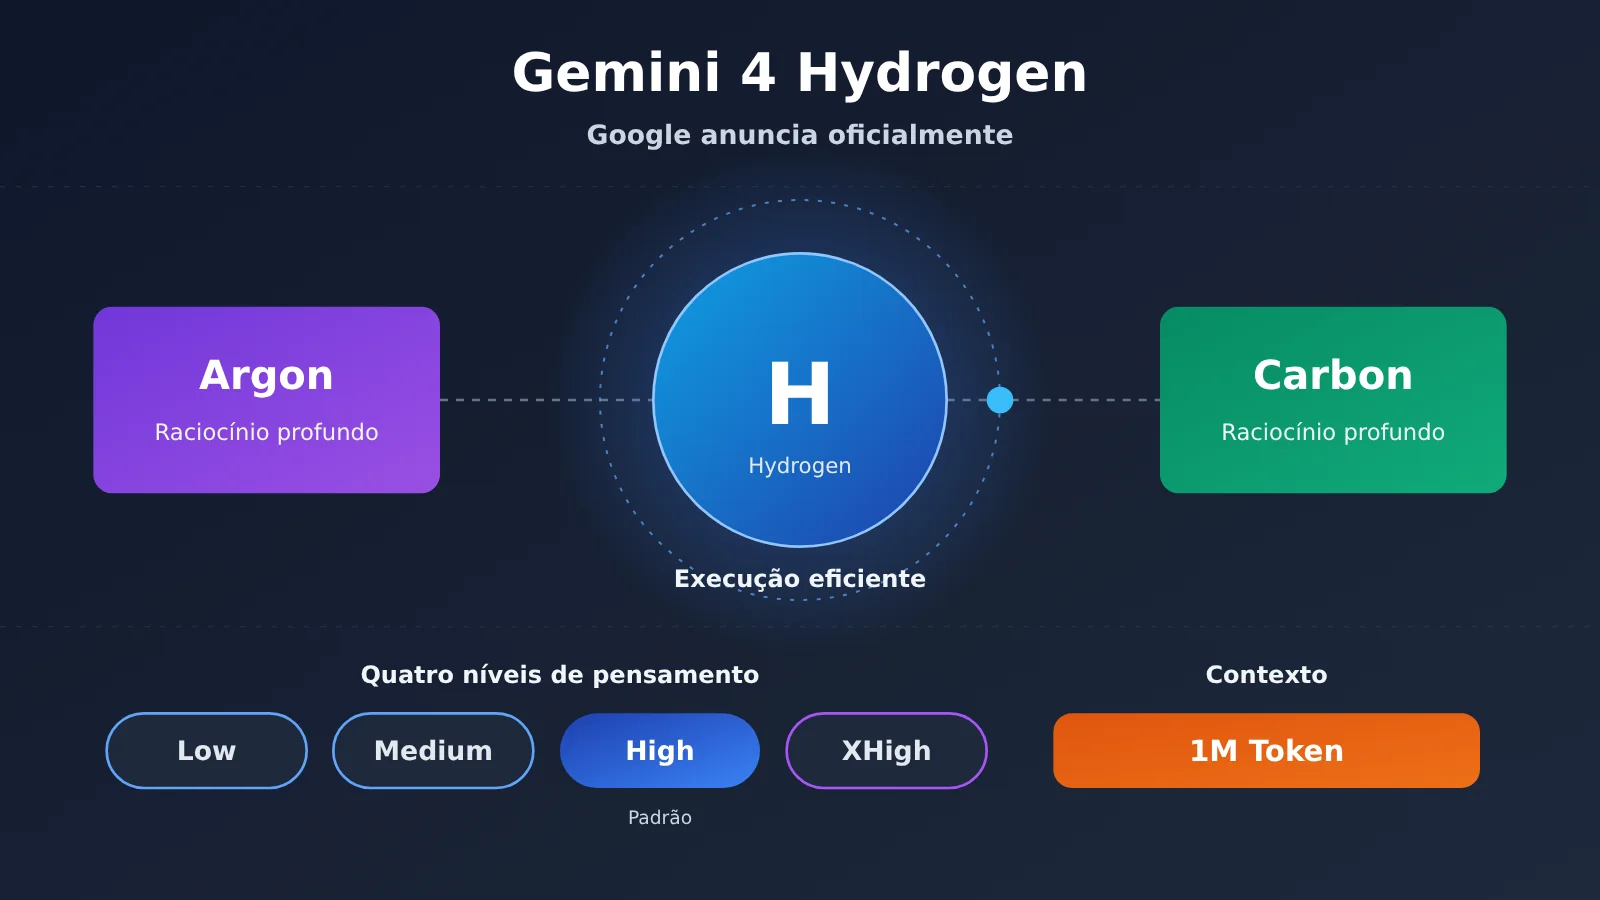
Dentro da família Gemini 4, a divisão de trabalho entre os três modelos é bem clara. Carbon e Argon ficam com o raciocínio profundo, voltado a tarefas complexas e demoradas, enquanto Hydrogen prioriza velocidade, programação do dia a dia, uso de várias ferramentas e execução automatizada. O model card oficial também informa que o Hydrogen foi adaptado a partir do Gemini 4 Carbon, mas o Google não divulgou o tamanho exato de parâmetros.
O Hydrogen pode ser usado sozinho ou atuar como executor ou verificador em sistemas Agent com múltiplos modelos. A prática mais comum é deixar Carbon ou Argon fazerem o julgamento e, depois, o Hydrogen colocar a mão na massa. O Ars Technica interpreta esse lançamento como o Hydrogen assumindo o lugar da linha Flash.
Resultados oficiais do Gemini 4 Hydrogen em comparação com o 3.8 Flash
| Item avaliado | Gemini 4 Hydrogen | Gemini 3.8 Flash | Origem dos dados |
|---|---|---|---|
| Terminal-Bench 4.1 | 57,0% | 18,2% | Google oficial |
| Velocidade de conclusão de tarefas nas mesmas condições de teste | cerca de 2,5x mais rápido | linha de base | Google oficial |
| Frequência de fatos inventados | mais de 5x menor | linha de base | Google oficial |
| Tarefas de dados corporativos, como dados de grafos e SQL | velocidade de execução 2–2,8x, uso de tokens 12%–23% menor | linha de base | testes de parceiros |
Esses números são divulgados oficialmente ou vêm de testes de parceiros, então não dá para concluir diretamente que todas as tarefas ficam 2,5x mais rápidas. Na avaliação entre modelos do model card do DeepMind, o Hydrogen marca 76,1% no AutomationBench-AA, 71,6% no Agents’ Last Exam v1.1 e 58,8% no HLE-Diamond. Mas no Terminal-Bench 4.1 (57,0%) e no OSWorld-2.1 (77,6%) ele fica abaixo dos 63,9% e 83,9% do Claude Sonnet 5.5. A nota metodológica oficial também menciona que algumas notas de concorrentes vêm dos próprios fabricantes ou de rankings públicos, e que as configurações de teste não são totalmente equivalentes.
Quais capacidades o Gemini 4 Hydrogen aprimorou?
Aprimoramentos em quatro tipos específicos de tarefas
Os principais cenários listados oficialmente pelo Google podem ser agrupados em quatro categorias, cada uma correspondendo a etapas específicas do trabalho cotidiano:
- Modificação e depuração de código: compreender repositórios de código, localizar erros, corrigir bugs, alterar dependências e executar testes. O foco desta melhoria é a edição precisa, ou seja, alterar apenas o que deve ser alterado, sem mexer em código não relacionado.
- Execução de agentes em múltiplas etapas: chamar ferramentas de forma contínua, pesquisar arquivos em paralelo e executar operações. Quando uma chamada de ferramenta falha, ele consegue ajustar a estratégia e seguir adiante.
- Compreensão de documentos e multimodal: consegue ler PDF, DOC/DOCX, PPT/PPTX, XLS/XLSX, OpenDocument, gráficos e páginas web. Uma única requisição pode conter até 3000 imagens ou documentos; a entrada de vídeo com áudio tem cerca de 45 minutos e sem áudio cerca de 1 hora; o áudio pode chegar a cerca de 8.4 horas.
- Desenvolvimento web interativo: gerar páginas interativas, protótipos de sites, componentes executáveis e conteúdo visual.
Vale observar que a saída do Hydrogen é apenas texto; imagens, áudio e vídeo só podem ser usados como entrada. Ele consegue compreender vídeos e também participar do fluxo de produção de vídeos, mas não é, por si só, um modelo de geração de vídeo. O exemplo de edição de vídeo demonstrado pelo Google depende de habilidades personalizadas e ferramentas externas.
Casos reais do Gemini 4 Hydrogen: Box, Pixelcut e demonstração do Google
Os dados dos parceiros abaixo vêm dos testes iniciais divulgados no anúncio do Google e não passaram por reteste independente de terceiros. A Box usa o Hydrogen para processar documentos corporativos, planilhas e cálculos de dados, com velocidade cerca de 2 vezes maior que o 3.8 Flash e consumo de tokens 12% menor. A Pixelcut executou 276 vezes em design automatizado e geração de código, com velocidade 1,8 vez maior e melhora de 30% na organização do código.
As demonstrações do próprio Google tendem para o visual. Por exemplo, gerar em tempo real estruturas 3D em uma ilha voxel compartilhada usando linguagem natural (Geminisland), gerar protótipos de sites de e-commerce com efeitos WebGL2 e componentes 3D de produtos, além de gerar Google Slides a partir de vídeos de palestra do YouTube e modelos, com verificação e correção automática de sobreposição de texto. Esses casos mostram que o Google já validou os fluxos de trabalho correspondentes, mas usuários comuns não necessariamente conseguem acertar de primeira com o mesmo comando.
Contexto unificado de um milhão de tokens e quatro níveis de pensamento
Os 1.048.576 tokens do Hydrogen são uma cota unificada: entrada, contexto histórico, tokens de pensamento, tokens de chamada de ferramentas e saída final são todos descontados daqui. Portanto, não é “1 milhão de entrada e depois 1 milhão de saída”. Em geral, a geração em primeiro plano de um único segmento tem limite de 65.536 tokens; saídas mais longas precisam de continuation_token para continuação ou do mecanismo de geração longa em segundo plano, e ainda estão sujeitas à cota unificada.
O nível de pensamento tem grande impacto no desempenho real. A seguir está a avaliação independente concluída pela Artificial Analysis em 12 de novembro, que é dado de terceiros:
| Nível de pensamento | Uso recomendado oficialmente | Índice de inteligência | Tempo médio das tarefas de referência | Custo médio das tarefas de referência |
|---|---|---|---|---|
| Low | Tarefas simples como classificação | 27 | 1,3 minuto | $0.29 |
| Medium | Programação convencional | 41 | 3,7 minutos | $0.80 |
| High (padrão da API) | Agent com múltiplas etapas | 51 | 8,3 minutos | $1.87 |
| XHigh | Raciocínio profundo complexo | 54 | 13,5 minutos | $3.16 |
O tempo e o custo nesta tabela são resultados das tarefas padronizadas de avaliação do Artificial Analysis Intelligence Index v5.0.1 e não representam o tempo ou o custo reais de cada resposta em uma conversa comum. Os dados revelam dois pontos. Primeiro, sob o mesmo nome de modelo, há uma diferença de 10 pontos entre High e Medium, então é preciso indicar o nível na comparação. Segundo, XHigh tem apenas 3 pontos a mais que High, mas o custo médio sobe de 1,87 dólar para 3,16 dólares, então o nível mais alto não é necessariamente vantajoso.
Como experimentar o Gemini 4 Hydrogen gratuitamente? Os três pontos de entrada em detalhes
Formas de uso do Gemini 4 Hydrogen em cada nível
| Entrada / nível de usuário | Forma de uso do Hydrogen | Descrição |
|---|---|---|
| Conta gratuita do Gemini App | Acionamento por roteamento automático do Auto | Perguntas simples costumam usar o Flash-Lite; solicitações que exigem raciocínio podem ser encaminhadas ao Hydrogen |
| Google AI Plus | Seleção manual disponível | Alternância pelo seletor de modelos |
| Google AI Pro | Seleção manual disponível e uso em Tasks | Liberação gradual no Antigravity |
| Google AI Ultra | Seleção manual disponível, com acesso a modelos de nível superior | Orchestrator disponível (Carbon/Argon) |
| Camada gratuita do Google AI Studio | Escolha direta do ID do modelo | Sujeito aos limites de cota da camada gratuita |
| Camada gratuita da Gemini API | Invocação de gemini-4-hydrogen |
Limites de RPM/TPM/RPD calculados por projeto |
Entrada 1: Gemini App. Quando o usuário gratuito ativa o Auto, o sistema escolhe o modelo automaticamente conforme a dificuldade da tarefa, e as solicitações que exigem raciocínio podem ser encaminhadas ao Hydrogen. Com o Auto desativado, a conta gratuita passa a usar o Flash-Lite. Há ainda um ponto que confunde muita gente: ao escolher o modelo manualmente no Gemini App, se você não especificar outro nível de pensamento, o padrão é Low, enquanto o nível padrão da API do Hydrogen é High.
Para confirmar qual modelo foi usado em uma resposta, no computador você pode seguir as instruções da central de ajuda oficial: clique em More → Show thinking steps abaixo da resposta e role até o final para ver as informações do modelo. A interface pode variar entre clientes e regiões, então considere sempre o que aparece na sua tela.
Entrada 2: Google AI Studio. Basta selecionar o Gemini 4 Hydrogen na lista de modelos para testar a conversa — ideal para validar o comando e o nível de pensamento antes de escrever código. A camada gratuita não tem um número fixo de invocações; ela considera, por projeto, RPM (requisições por minuto), TPM (tokens de entrada por minuto) e RPD (requisições por dia, reiniciado à meia-noite do horário do Pacífico). A cota real é a que aparece como limite efetivo no AI Studio.
Entrada 3: Gemini API. Tanto a camada gratuita quanto a paga podem invocar a API, mas os limites são diferentes. Além disso, o conteúdo da camada gratuita da API pode ser usado para melhorar os produtos do Google, e a página oficial de preços informa que o conteúdo da camada paga não é usado para essa finalidade. Vale levar isso em conta ao lidar com dados comerciais sensíveis.
O Google usa a expressão “lançamento gradual”; no dia do lançamento, houve usuários relatando que a opção do modelo no Gemini App apareceu por pouco tempo e sumiu, ou que o modelo aparecia no Antigravity mas a invocação falhava. Um lançamento global também não significa que o acesso à rede, a elegibilidade da conta e as políticas de serviço na região da China continental fiquem sem restrições.
Exemplo de chamada da API do Gemini 4 Hydrogen
Se você precisa integrar a um projeto existente por meio da interface compatível com OpenAI, pode usar a abordagem abaixo:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",  # O nome de modelo realmente disponível deve ser conferido na lista de modelos da plataforma
    messages=[{"role": "user", "content": "帮我定位这段 Python 代码的 Bug 并给出最小修改"}]
)
print(response.choices[0].message.content)
Ver o código completo com prompt de sistema e tratamento de exceções
import openai
from typing import Optional

def ask_hydrogen(
    prompt: str,
    system_prompt: Optional[str] = None,
    max_tokens: int = 4000
) -> str:
    """Chama o Gemini 4 Hydrogen para lidar com tarefas cotidianas de programação ou organização de material"""
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": prompt})

    try:
        # Atenção: o Hydrogen ignora temperature/top_p/top_k personalizados, então não é preciso defini-los
        # Os tokens de raciocínio entram na cobrança da saída, então max_tokens precisa reservar espaço para o raciocínio
        response = client.chat.completions.create(
            model="gemini-4-hydrogen",
            messages=messages,
            max_tokens=max_tokens
        )
        return response.choices[0].message.content
    except Exception as e:
        return f"Error: {str(e)}"

print(ask_hydrogen(
    prompt="把这份会议纪要整理为三级标题的 Markdown 文档",
    system_prompt="严格遵守用户指定的格式,不添加无关内容"
))
🚀 Comece rápido: a APIYI (apiyi.com) oferece uma interface compatível com OpenAI — com uma única chave API você chama OpenAI, Claude, Gemini e outros modelos populares, e novos usuários têm cota gratuita para testes. Antes de integrar, confira na lista de modelos da plataforma se o Hydrogen está disponível e qual é o nome exato do modelo; a forma de enviar parâmetros como o nível de raciocínio deve seguir a documentação da plataforma.
Quem está migrando do 3.8 Flash precisa ficar atento a algumas mudanças incompatíveis:
thinking_budgeteMINIMALnão são mais suportados; continuar usando retorna HTTP 400.- O nível de raciocínio padrão passou de Medium para High.
- O cache de contexto explícito não é mais suportado; existe apenas o cache implícito, com mínimo de 4096 tokens.
- Chamadas de ferramentas em múltiplas rodadas exigem salvar e reenviar corretamente as thought signatures.
Como escolher entre Gemini 4 Hydrogen, Flash, Argon e Carbon?
Divisão por dificuldade da tarefa, velocidade de resposta e complexidade de execução
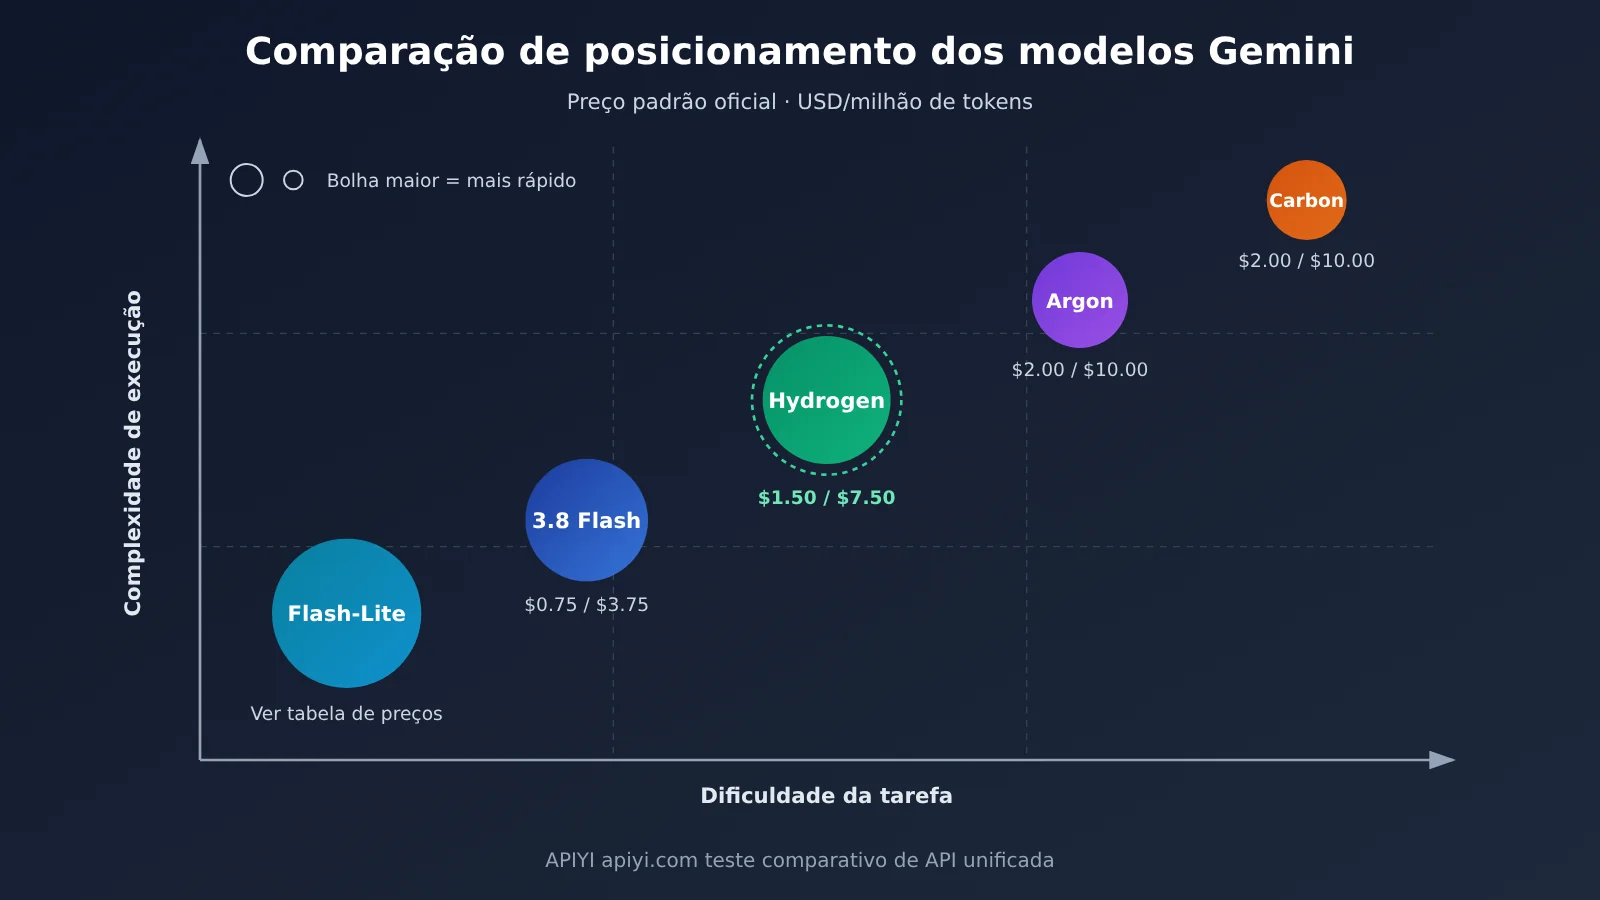
| Modelo | Dificuldade da tarefa | Velocidade de resposta | Complexidade de execução | Tarefas típicas | Preço padrão oficial da API (entrada/saída) | Plataformas disponíveis |
|---|---|---|---|---|---|---|
| Flash-Lite | Baixa | Mais rápida | Baixa | Perguntas e respostas simples | Dados não fornecidos | Gemini App, entre outros |
| Gemini 3.8 Flash | Média-baixa | Rápida | Média | Tarefas leves do dia a dia | $0.75 / $3.75 (até 31 de dezembro de 2026) | Gemini API, APIYI apiyi.com (consulte a lista de modelos) |
| Gemini 4 Hydrogen | Média-alta | Rápida | Alta (várias ferramentas) | Programação do dia a dia, processamento de materiais, execução de Agent | $1.50 / $7.50 | Gemini API, AI Studio, APIYI apiyi.com (consulte a lista de modelos) |
| Gemini 4 Argon | Alta | Média | Alta | Fluxos de trabalho complexos | $2.00 / $10.00 (até 30 de novembro de 2026) | Gemini API, entre outros |
| Gemini 4 Carbon | Máxima | Lenta | Máxima | Design arquitetônico aprofundado, tarefas difíceis de longo prazo | $2.00 / $10.00 (até 30 de novembro de 2026) | Gemini API, entre outros |
A fonte dos preços é a página oficial de preços do Google AI Studio; a unidade é dólares por milhão de tokens; a data de verificação é 13 de novembro de 2026; o cálculo é feito com base na chamada Standard. A página de preços informa que o 3.8 Flash será ajustado para $1.50/$7.50 a partir de 1º de janeiro de 2027; Argon e Carbon serão ajustados para $4/$20 a partir de 1º de dezembro de 2026; Hydrogen não tem, até o momento, um ajuste de preço semelhante anunciado. Os preços Batch e Flex do Hydrogen são $0.75/$3.75, e o Priority é $2.70/$13.50.
Portanto, no momento da publicação, o preço padrão por token do Hydrogen é o dobro do preço atual do 3.8 Flash, e não mais barato. Os tokens de raciocínio entram no preço de saída; o custo total de uma tarefa real depende do comprimento do raciocínio, do número de tentativas, do volume de chamadas de ferramentas e da eficiência de conclusão. No nível pago, o Google Search Grounding é gratuito nas primeiras 5.000 chamadas por mês (compartilhado com Gemini 3 e modelos mais recentes); depois, custa US$ 14 por 1.000 chamadas. A camada gratuita da API não tem essa cota gratuita.
A diferença entre uso individual e colaboração entre múltiplos modelos
Para mapear as tarefas aos modelos, dá para pensar assim: perguntas e respostas simples ficam com o Flash-Lite; programação do dia a dia, organização de documentos e tarefas de Agente de complexidade média encontram no Hydrogen uma opção com melhor equilíbrio entre custo e benefício; já design de arquitetura aprofundado, que exige raciocínio entre módulos, fica com o Carbon ou o Argon. Usar o Hydrogen sozinho funciona bem em tarefas com objetivo claro e etapas bem definidas. Mas, diante de problemas que exigem reavaliar a direção várias vezes, é fácil ele seguir por um caminho errado e executar passos demais.
O principal exemplo de colaboração entre múltiplos modelos é o Google Antigravity Orchestrator, lançado na mesma época. Nesse fluxo, o Carbon primeiro analisa o repositório de código e define o plano de alterações; o Hydrogen fica responsável pelas edições concretas, pela atualização de dependências e pela execução de testes; e, quando surge um erro complexo, o controle volta para o Carbon decidir. Um relatório oficial do Google afirma que, no teste Terminal-Bench 4.1, essa abordagem reduz em média 24% o consumo de cota em comparação com o uso isolado do Carbon, aumenta em 19% a velocidade de conclusão e tem desempenho de sucesso próximo ao do Carbon.
💡 Sugestão de escolha: A escolha do modelo depende da dificuldade da tarefa e do orçamento. Recomenda-se rodar primeiro o mesmo conjunto de tarefas reais com o Hydrogen nos níveis Medium e High, e também com o Argon, comparando taxa de conclusão e consumo de Tokens. A APIYI (apiyi.com) oferece chamadas por interface unificada para vários modelos; para trocar de modelo, basta alterar o parâmetro
model, o que facilita esse tipo de comparação.
Análise de impacto do Gemini 4 Hydrogen
Impacto para desenvolvedores
- A camada de execução de agentes ganhou uma nova opção: em chamadas de múltiplas ferramentas e tarefas de automação, os resultados oficiais do Hydrogen mostram uma melhora significativa em relação ao 3.8 Flash, tornando-o adequado como executor e verificador em sistemas de agentes.
- A migração exige alterações na configuração: parâmetros de raciocínio, mecanismo de cache, parâmetros de amostragem e assinatura de chamada de ferramentas mudaram; substituir diretamente o nome do modelo pode gerar erro.
- A forma de estimar custos precisa mudar: o preço unitário dobrou, ao mesmo tempo que a eficiência na conclusão de tarefas pode aumentar. É preciso calcular o custo total por tarefa completa, e não por requisição individual.
Impacto para o setor e para usuários comuns
- Experiência de busca aprimorada: o Hydrogen já está em uso na Pesquisa Google para melhorar o tratamento de perguntas complexas com múltiplas condições, erros de digitação, consultas múltiplas e respostas com visualização.
- “Planejamento por Modelo de Linguagem Grande, execução por modelo pequeno” se torna prática comum: o Orchestrator transformou a divisão de trabalho entre modelos em um recurso de produto, reduzindo a barreira para orquestração de múltiplos modelos.
- As limitações permanecem: o model card oficial mostra que a taxa de recusas injustificadas do Hydrogen piorou 5,57 pontos percentuais em relação ao 3.8 Flash, e o relatório completo de segurança ainda não foi publicado. Também há usuários no Hacker News relatando que ele apresenta problemas de execução excessiva em algumas tarefas de agentes.
Perguntas frequentes (FAQ) sobre o Gemini 4 Hydrogen
P1: O que é o Gemini 4 Hydrogen?
É o modelo da série Gemini 4 lançado oficialmente pelo Google DeepMind em 12 de novembro de 2026, com ID de modelo de API `gemini-4-hydrogen`. Sua proposta é ser um modelo de execução de alta eficiência para programação cotidiana e para AI Agents, com suporte a contexto unificado de um milhão de tokens e quatro níveis de pensamento.
P2: Qual é a diferença entre o Gemini 4 Hydrogen e o Gemini 3.8 Flash?
Dados oficiais mostram que o Hydrogen pontua 57,0% no Terminal-Bench 4.1, enquanto o 3.8 Flash pontua 18,2%, e, nas mesmas condições, a velocidade de conclusão de tarefas é cerca de 2,5 vezes maior. Porém, o preço unitário padrão da API é o dobro do preço atual do 3.8 Flash, e a migração ainda exige lidar com problemas de incompatibilidade de parâmetros.
P3: Usuários gratuitos podem usar o Gemini 4 Hydrogen?
Sim. No Gemini App, com uma conta gratuita e o modo Auto ativado, as solicitações que exigem raciocínio podem ser encaminhadas ao Hydrogen. Na camada gratuita do Google AI Studio é possível selecionar o modelo diretamente, mas sujeito aos limites de RPM, TPM e RPD.
P4: Em quais cenários o Gemini 4 Hydrogen se destaca?
– **Correção de bugs e atualização de dependências dentro de repositórios de código**: prioriza edições precisas, evitando ao máximo alterar código não relacionado.
– **Síntese de materiais em vários formatos**: pode analisar simultaneamente PDF, Excel, PPT, gráficos e páginas web.
– **Execução de agentes com múltiplas ferramentas**: pode rodar de forma independente ou executar etapas específicas sob o planejamento do Carbon/Argon.
P5: Como chamar o Gemini 4 Hydrogen rapidamente via API?
Além da API Gemini oficial do Google, também é possível usar plataformas agregadoras compatíveis com OpenAI:
1. Registre uma conta na APIYI apiyi.com e obtenha a chave API e a cota gratuita de teste.
2. Confirme no catálogo de modelos o status de disponibilidade e o nome do modelo Hydrogen.
3. Defina o base_url no código deste artigo como `https://api.apiyi.com/v1` e execute a validação.
P6: Quais são as limitações conhecidas do Gemini 4 Hydrogen?
Ele ainda pode alucinar; o conhecimento tem corte em março de 2026, então eventos recentes precisam ser obtidos por meio de busca. Os níveis de pensamento mais altos aumentam significativamente o tempo e o custo, e ocasionalmente ocorrem timeouts. Ele não oferece suporte a Live API, cache explícito nem fine-tuning. Se precisar comparar outros modelos como alternativa, você pode testar a troca de modelo no APIYI apiyi.com usando o mesmo conjunto de código.
Gemini 4 Hydrogen: principais pontos
- Lançamento oficial: disponibilizado em 12 de novembro de 2026, confirmado em conjunto pelo blog oficial, pelo model card e pela documentação técnica.
- Posicionamento central: o modelo de execução eficiente da família Gemini 4, responsável por programação cotidiana e tarefas de agentes.
- Regra de contexto: 1,048,576 tokens compartilhados entre entrada, raciocínio, chamadas de ferramentas e saída.
- Quatro níveis de raciocínio: High é o nível padrão com melhor equilíbrio custo-benefício; XHigh aumenta bastante o custo.
- Acesso gratuito: modo Auto do Gemini App, camada gratuita do AI Studio e camada gratuita da Gemini API.
- Alerta de custo: o preço unitário padrão é o dobro do preço atual do 3.8 Flash; é preciso calcular o custo total com base na tarefa completa.
- Como começar: integrações de desenvolvimento podem usar a interface unificada da APIYI apiyi.com para comparar e validar rapidamente.
Resumo: quem deve experimentar o Gemini 4 Hydrogen primeiro?
Diferentes usuários podem começar por diferentes pontos de entrada:
- Usuários comuns: abram o modo Auto no Gemini App e confirmem o modelo realmente usado em More → Show thinking steps.
- Criadores de conteúdo: testem na camada gratuita do AI Studio a organização de documentos longos, a reescrita com formatação e a síntese de materiais em múltiplos formatos.
- Desenvolvedores: foquem em modificações e depuração de código; antes de migrar, verifiquem o parâmetro thinking e as configurações de cache.
- Construtores de agentes: usem o Hydrogen como camada de execução, deixem decisões complexas para o Carbon ou o Argon e comparem o custo total com tarefas reais.
Escolha o caminho de início assim: se quiser apenas experimentar, use o Gemini App ou o Google AI Studio; se for fazer integração de desenvolvimento, use a API. Se você quiser usar uma única chave para comparar, ao mesmo tempo, o desempenho de modelos como Gemini, Claude e OpenAI no seu negócio, pode validar rapidamente pela APIYI apiyi.com; novos usuários recebem créditos de teste gratuitos.
📚 Referências
- Blog oficial do Google: Introducing Gemini 4 Hydrogen: anúncio de lançamento e cases de parceiros
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Descrição: posicionamento oficial, comparação de desempenho e casos de demonstração
-
Blog oficial do Google em chinês: anúncio de lançamento em chinês
-
Link:
china.googleblog.com/2026/11/gemini-4-hydrogen.html -
Model card e metodologia de avaliação do Google DeepMind: avaliação entre modelos e dados de segurança
- Link:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Link:
deepmind.google/models/evals-methodology/gemini-4-hydrogen/ -
Documentação técnica do Google Cloud: especificações e guia de migração
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Página de preços e limites de taxa do Google AI Studio: preços da API e regras do nível gratuito
- Link:
aistudio.google.com/docs/pricing -
Link:
ai.google.dev/gemini-api/docs/rate-limits -
Central de ajuda dos Gemini Apps: níveis de assinatura, modo Auto e como consultar o modelo
-
Link:
support.google.com/gemini/answer/18648722 -
Avaliação independente da Artificial Analysis: índice de inteligência de raciocínio em quatro níveis
-
Link:
artificialanalysis.ai/models/gemini-4-hydrogen -
Blog do Google Antigravity: orquestração multi-modelo com Orchestrator
-
Link:
antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity -
Reportagens de terceiros: TechCrunch, Ars Technica, 9to5Google, The Verge
- Link:
arstechnica.com/google/2026/11/google-rolls-out-gemini-4-hydrogen-finally-replacing-3-8-flash/ - Link:
9to5google.com/2026/11/12/gemini-4-hydrogen-launch/
Autor: equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site oficial da APIYI. Mais materiais de integração estão disponíveis no centro de documentação em docs.apiyi.com