Nota do autor: ao encontrar um 429, não é preciso trocar de modelo na hora. Este artigo usa uma investigação em 3 etapas para descobrir se o rate limit vem do provedor upstream, do gateway ou do plano gratuito, e mostra como configurar backoff exponencial, Retry-After e failover.
Ao rodar tarefas em lote de madrugada, de repente o log despeja uma tela cheia de 429 Too Many Requests, e a primeira reação de muita gente é “esse modelo não presta, melhor trocar logo”. Só que esse julgamento costuma ser precipitado. Um 429 só diz que “alguém está te limitando” — não diz quem está limitando, nem qual é a dimensão da limitação. A ideia central deste artigo é primeiro localizar a origem do rate limit, e só depois decidir entre backoff ou troca de modelo.
Este não é um artigo genérico sobre retentativas. Vamos seguir a ordem real de investigação, destrinchando a mensagem de erro, os cabeçalhos de resposta e as dimensões do rate limit, e em seguida apresentar recomendações de configuração dos parâmetros de backoff e da cadeia de failover.
Valor principal: ao terminar a leitura, você será capaz de, em poucos minutos, determinar se um 429 veio do provedor upstream, de um gateway intermediário ou da cota do plano gratuito — e configurar na sua aplicação uma estratégia de tolerância a falhas do tipo “esperar quando vale a pena esperar, trocar quando vale a pena trocar”.
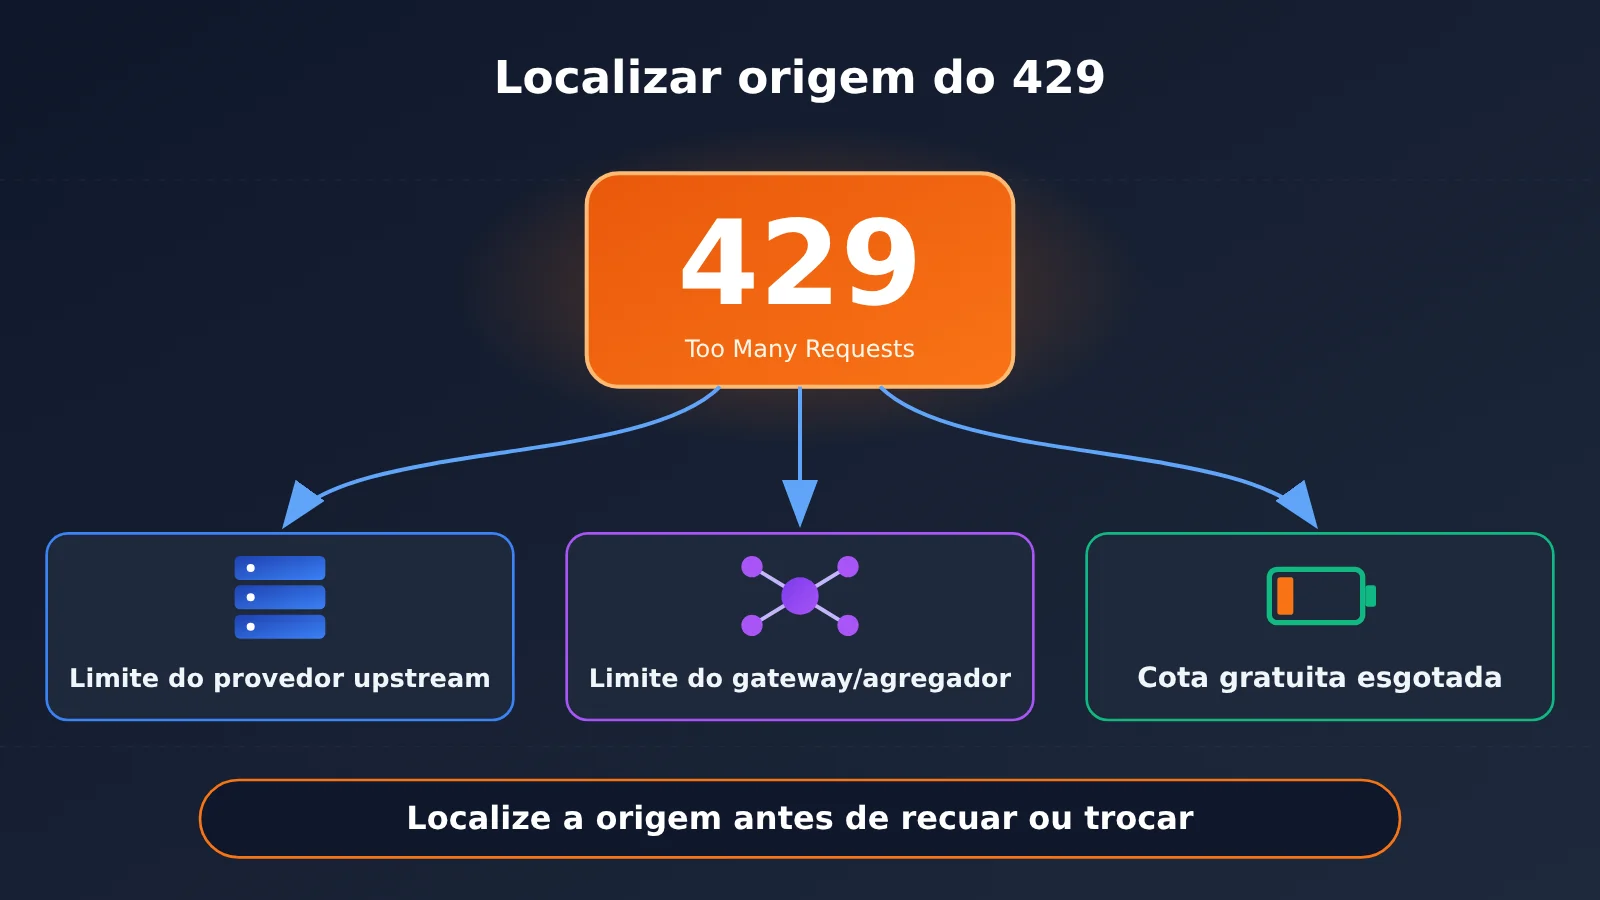
Pontos-chave para identificar limitação de taxa 429
O 429 é o código de status “muitas requisições” do padrão HTTP. No cenário de APIs de Modelo de Linguagem Grande, ele pode ser retornado por qualquer camada da cadeia de invocação. A tabela abaixo resume as três fontes mais comuns e o tratamento correto correspondente a cada uma.
| Origem da limitação de taxa | Características típicas | Deve trocar de modelo? | Tratamento recomendado |
|---|---|---|---|
| Fornecedor do modelo upstream | O corpo do erro traz o tipo e a redação de erro do próprio fornecedor, e os cabeçalhos de resposta trazem campos de limitação do fornecedor | Geralmente não | Faça backoff conforme o Retry-After; se necessário, reduza a concorrência ou solicite aumento de cota |
| Gateway intermediário/plataforma de agregação | A redação do erro vem do gateway, indicando taxa em nível de conta ou de grupo | Não | Verifique a cota e as configurações de concorrência do lado do gateway, ou troque de grupo no gateway |
| Camada gratuita/cota de teste | Indica cota gratuita, número de requisições diárias ou capacidade insuficiente | Depende | Faça upgrade para a camada paga, ou troque para um modelo similar com capacidade disponível |
Por que 429 não significa que o modelo está fora do ar
Quando o modelo em si está indisponível, o sinal mais comum é a série de erros 5xx. Por exemplo, a sobrecarga da Anthropic retorna 529 overloaded_error, e anomalias em gateways ou balanceadores de carga costumam gerar 502 e 503. Esses códigos de status indicam que o servidor temporariamente não consegue dar conta, o que é uma coisa completamente diferente de “sua conta excedeu a cota”.
Já o 429 tem um significado claro de atribuição: a regra de limitação é direcionada a você — pode ser sua chave API, sua organização, a camada gratuita em que você está, ou a taxa que o gateway lhe atribuiu. Trocar de modelo às vezes contorna o problema, mas se a limitação vier da cota em nível de conta do gateway, trocar de modelo vai bater na mesma parede. Se a limitação vier do limite de tokens por minuto do fornecedor upstream, esperar alguns segundos já resolve; trocar de modelo, por outro lado, introduz incerteza na qualidade da saída.
Um compilado de troubleshooting de terceiros sobre o Claude Code também confirma isso: ao encontrar um 429, o Claude Code exibe Request rejected (429), seguido do texto original do servidor, e é exatamente esse texto que diz se a limitação vem da Anthropic, do gateway ou da camada gratuita. Por isso, o primeiro passo da investigação é sempre ler a mensagem de erro completa, e não apenas olhar o código de status.
Diferenças entre o 429 e os códigos de status vizinhos
Para não misturar erros diferentes, a tabela abaixo lista alguns códigos de status que são facilmente confundidos com o 429 na invocação do modelo.
| Código de status | Significado | Responsável | Indicado para retry | Indicado para failover |
|---|---|---|---|---|
| 429 | Requisições em excesso, limite de taxa ou cota atingido | Cota do lado da chamada | Sim, com backoff | Trocar só depois que o backoff não resolver |
| 529 | Upstream sobrecarregado (exclusivo da Anthropic) | Capacidade do lado do servidor | Sim, backoff curto | Sim |
| 503 | Serviço temporariamente indisponível | Servidor ou gateway | Sim | Sim |
| 500/502 | Erro interno ou erro de gateway | Servidor ou gateway | Retry em número limitado | Sim |
| 400/401/403 | Problemas de parâmetro, autenticação ou permissão | Configuração do lado da chamada | Não | Não, é preciso corrigir a configuração |
Há um detalhe nessa tabela que costuma passar batido: segundo testes de terceiros, o mecanismo fallbackModel do Claude Code só é acionado em caso de sobrecarga 529, tentando no máximo 3 modelos de reserva, e não quando ocorre um 429. Isso mostra que os próprios criadores da ferramenta entendem que a primeira reação a um 429 deve ser o backoff, e não a troca de modelo.
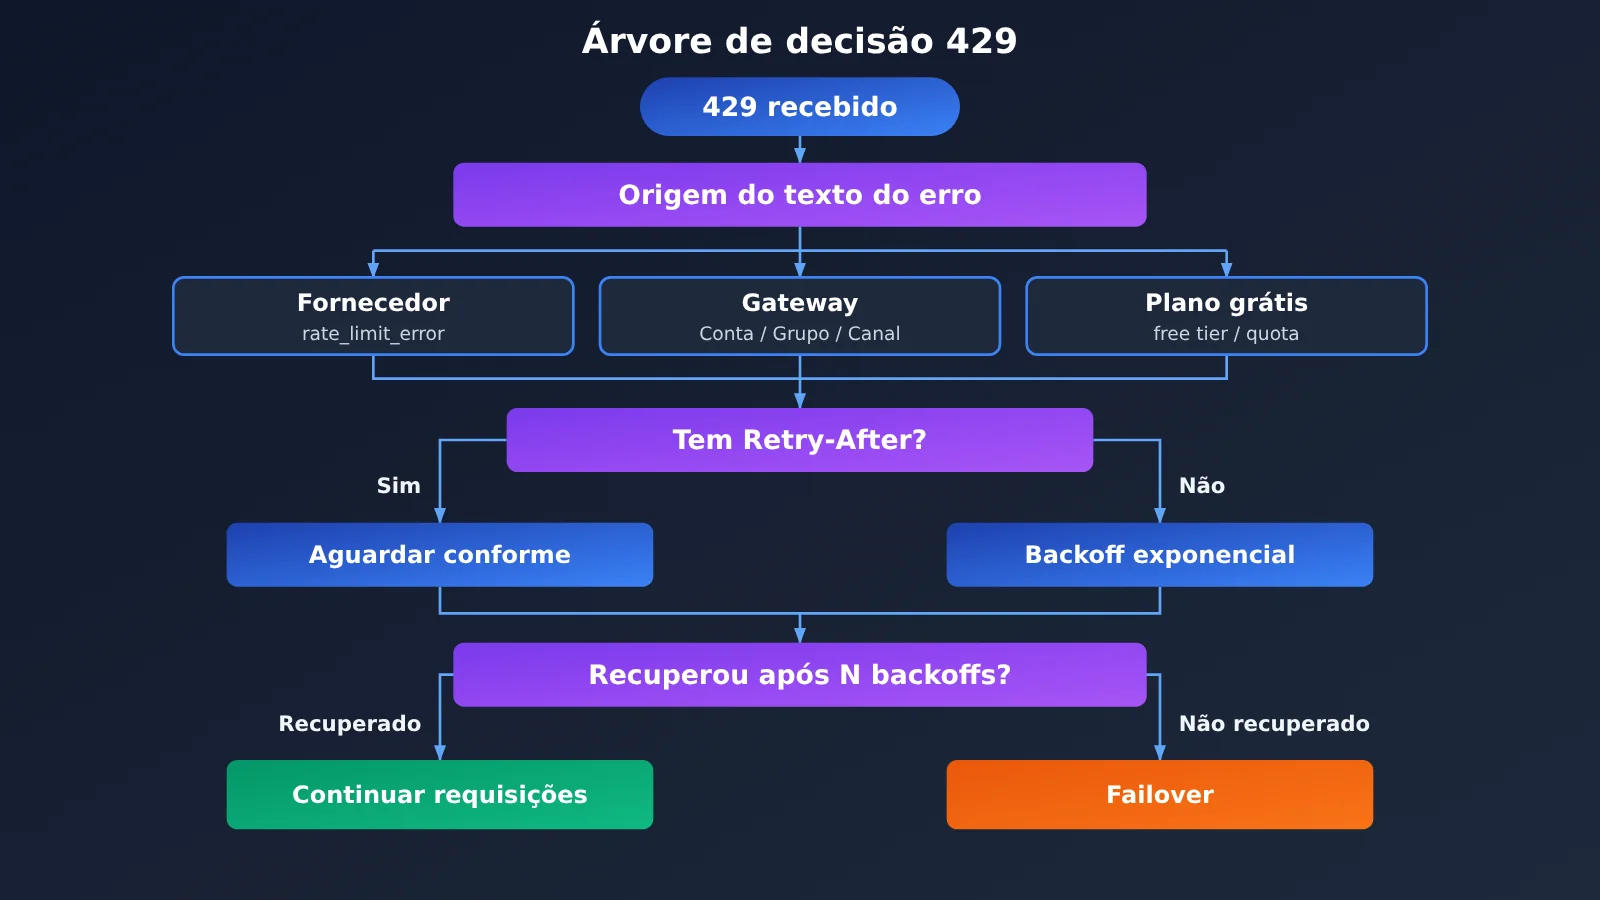
Como descobrir de quem vem o 429 de limitação: diagnóstico em 3 passos
A seguir, um fluxo de diagnóstico de 429 que você pode seguir à risca. Os três passos estão ordenados do menor para o maior custo e, na maioria dos casos, você já identifica a origem logo no primeiro passo.
Passo 1: leia o corpo completo do erro 429
Não registre apenas o status code no log — grave o corpo da resposta exatamente como veio. Os 429 retornados por camadas diferentes têm diferenças claras de redação, e essa é a pista mais direta.
- Retornado pelo provedor upstream: o corpo do erro normalmente traz um campo de tipo de erro do próprio provedor. A Anthropic, por exemplo, retorna o tipo
rate_limit_error, e APIs no estilo OpenAI trazem um código comorate_limit_exceeded, indicando se o limite estourado foi de requisições ou de tokens. - Retornado pelo gateway: a redação costuma mencionar conceitos do próprio gateway, como “conta”, “grupo”, “token de acesso” ou “canal”, ou então escreve explicitamente o nome do gateway.
- Retornado pelo nível gratuito: aparecem termos como “free tier”, “quota”, “daily limit” e “capacity”. Em testes de terceiros com uso gratuito de determinados modelos, esse tipo de 429 por capacidade é encontrado com frequência.
Se você chama via proxy ou plataforma de agregação, preste atenção especial para saber se o gateway repassa o erro original do upstream. Se repassa, é o upstream que está te limitando; se usa uma redação personalizada e não repassa, é o gateway que está te limitando.
Passo 2: Verificar os cabeçalhos de resposta 429
Os cabeçalhos de resposta são a segunda cadeia de evidências. Os principais fornecedores retornam a cota restante e o tempo de redefinição nos cabeçalhos de resposta, e o gateway também pode incluir seus próprios campos.
| Cabeçalho de resposta | Origem comum | Significado | Uso para diagnóstico |
|---|---|---|---|
Retry-After |
Padrão HTTP, comum a vários | Número de segundos sugerido para esperar | Priorizar no backoff |
x-ratelimit-remaining-requests |
Interfaces no estilo OpenAI | Requisições restantes na janela atual | Determinar se é limitação de RPM |
x-ratelimit-remaining-tokens |
Interfaces no estilo OpenAI | Tokens restantes na janela atual | Determinar se é limitação de TPM |
anthropic-ratelimit-requests-remaining |
Anthropic | Requisições restantes | Confirmar que a limitação vem da Anthropic |
anthropic-ratelimit-input-tokens-remaining |
Anthropic | Tokens de entrada restantes | Determinar se é limitação de tokens de entrada |
A regra de julgamento é simples: se aparecerem cabeçalhos de limitação com prefixo do fornecedor e o valor restante for 0 , basicamente podemos confirmar que é o fornecedor upstream limitando você; se não houver nenhum cabeçalho de limitação do fornecedor, apenas campos personalizados do gateway ou absolutamente nada, a possibilidade de ser a camada do gateway é maior. Vale notar que, nos últimos anos, alguns fornecedores passaram a exibir os limites específicos apenas no console, e as informações nos cabeçalhos de resposta podem estar incompletas; nesse caso, é preciso voltar à redação do erro do Passo 1 e à comparação de dimensões do Passo 3.
Etapa 3: Comparar com as dimensões de limitação de taxa
Depois de saber quem está aplicando o limite, é preciso entender o que exatamente está sendo limitado. As regras de limitação de taxa não são padronizadas entre os fornecedores. Um comparativo de terceiros com cinco fornecedores mostra que: a Anthropic limita principalmente por tokens por minuto, e tokens que acertam o cache não entram na cota; a DeepSeek limita principalmente o número de requisições simultâneas; já a OpenAI e o Google deixam as cotas específicas mais para consulta no console.
Isso tem impacto direto na estratégia de configuração. As correspondências mais comuns são:
- RPM (requisições por minuto) acima do limite: combine várias requisições pequenas em requisições em lote ou adicione um token bucket no cliente para enviar em taxa constante.
- TPM (tokens por minuto) acima do limite: encurte o contexto, ative o cache de prompts e divida tarefas com documentos longos em janelas de tempo diferentes.
- Número de requisições simultâneas acima do limite: reduza a quantidade de workers e use uma fila para controlar quantas requisições estão em andamento ao mesmo tempo; apenas aplicar backoff tem efeito limitado.
- Cota diária ou crédito gratuito esgotado: backoff não resolve; só resta esperar o reset, fazer upgrade de plano ou trocar para outro canal.
O caso 4 é o único tipo de 429 em que o backoff está fadado a não funcionar — e também é a situação que deve ser identificada o quanto antes para partir direto para o failover.
Como configurar a estratégia de backoff para 429
Depois de confirmar que o 429 é um rate limit recuperável, entramos na fase de backoff. O objetivo do backoff não é “tentar novamente o mais rápido possível”, mas sim “recuperar o quanto antes sem agravar o congestionamento”.
Backoff exponencial com jitter aleatório
A abordagem mais comum é o backoff exponencial (Exponential Backoff) com jitter aleatório. O tempo de espera na n-ésima tentativa é aproximadamente “delay base × 2 elevado a n”, somado a um valor aleatório, com um teto definido. A função do jitter aleatório é espalhar os momentos de retry de vários clientes, evitando que todos atinjam o servidor no mesmo segundo e formem uma “tempestade de retries”.
Se a resposta trouxer Retry-After, ele deve ter prioridade sobre o tempo de backoff que você mesmo calculou. O servidor sabe melhor do que você quando a janela será reiniciada; esperar conforme a sugestão dele costuma ser o caminho mais rápido para a recuperação.
Valores recomendados para os parâmetros de backoff
A tabela abaixo traz um conjunto de parâmetros iniciais adequado à maioria dos cenários de conversação e processamento em lote. No uso real, ajuste conforme a tolerância de latência do seu negócio.
| Parâmetro | Valor inicial recomendado | Descrição |
|---|---|---|
| Delay base | 1 segundo | Tempo de espera antes da primeira tentativa |
| Multiplicador de backoff | 2 | O tempo de espera dobra a cada tentativa |
| Espera máxima por tentativa | 30-60 segundos | Impede que o tempo de espera cresça indefinidamente |
| Número máximo de tentativas | 3-5 vezes | Após isso, entra em failover ou retorna erro |
| Jitter aleatório | 0-100% aleatório do tempo de espera | Recomenda-se “full jitter”, para espalhar as tentativas |
| Retry-After | Se existir, tem prioridade | Substitui o tempo de backoff calculado por você |
Dois detalhes de configuração costumam passar despercebidos. Primeiro, em cenários interativos (como uma interface de chat) o tempo total de espera não deve ser longo; vale definir um orçamento total de timeout e, ao ultrapassá-lo, partir direto para o failover ou avisar o usuário. Segundo, não faça backoff e retry para erros de configuração como 400, 401 e 403 — por mais que espere, eles não vão se resolver sozinhos, e você só vai gastar tempo e quota à toa.
Se você usa um SDK oficial, muitos já trazem retry automático embutido para 429 e 5xx, normalmente controlado por um parâmetro do tipo max_retries. Antes de envolver isso em mais uma camada de retry própria, confira o comportamento padrão do SDK — duas camadas de retry sobrepostas podem multiplicar o número real de tentativas.
Como configurar o failover para erros 429
O backoff é “esperar no mesmo lugar”; o failover é “pegar outro caminho”. Não é uma escolha entre um ou outro, mas uma relação de sequência: primeiro o backoff, e se ele não resolver, então o failover.
Quando disparar o failover
A recomendação é disparar a troca quando qualquer uma das condições abaixo for atendida, em vez de trocar assim que aparecer um 429:
- atingiu o número máximo de tentativas e o 429 continua retornando;
- a mensagem de erro aponta claramente para cota diária, esgotamento do limite gratuito ou “capacidade insuficiente”;
- o tempo de espera indicado no
Retry-Afterultrapassa o limite aceitável para o negócio; - o mesmo canal falha várias vezes seguidas em pouco tempo e atinge o limiar do circuit breaker.
As recomendações de terceiros para lidar com 429 frequentes em um modelo popular no OpenRouter seguem a mesma lógica: primeiro backoff, depois failover para outro modelo na mesma interface. Essa ordem permite aproveitar a qualidade de saída do modelo original e, ao mesmo tempo, garantir que o serviço não pare.
Três designs para a cadeia de failover
As “rotas de reserva” do failover têm níveis diferentes, e o custo da troca vai do menor para o maior nesta ordem:
- Mesmo modelo, outro canal: o mesmo modelo, mas com outra chave API, outro grupo ou outro provedor. É o que dá a melhor consistência de saída e deve ser a primeira escolha.
- Mesmo fabricante, outra faixa: por exemplo, sair do modelo topo de linha para um modelo leve da mesma família — a capacidade cai um pouco, mas o estilo é parecido.
- Troca de modelo entre fabricantes: migrar para um modelo equivalente de outro fabricante. É a opção de maior disponibilidade, mas o efeito do comando e o formato da saída precisam ser validados antes.
Além disso, vale adicionar uma camada de circuit breaker: quando um canal falha consecutivamente até atingir o limiar, ele é simplesmente ignorado durante um período de resfriamento; terminado o resfriamento, enviamos algumas requisições de sondagem e, quando ele se recupera, aumentamos o volume aos poucos. Isso evita que toda requisição bata na parede antes de trocar de canal, reduzindo bastante a latência geral.
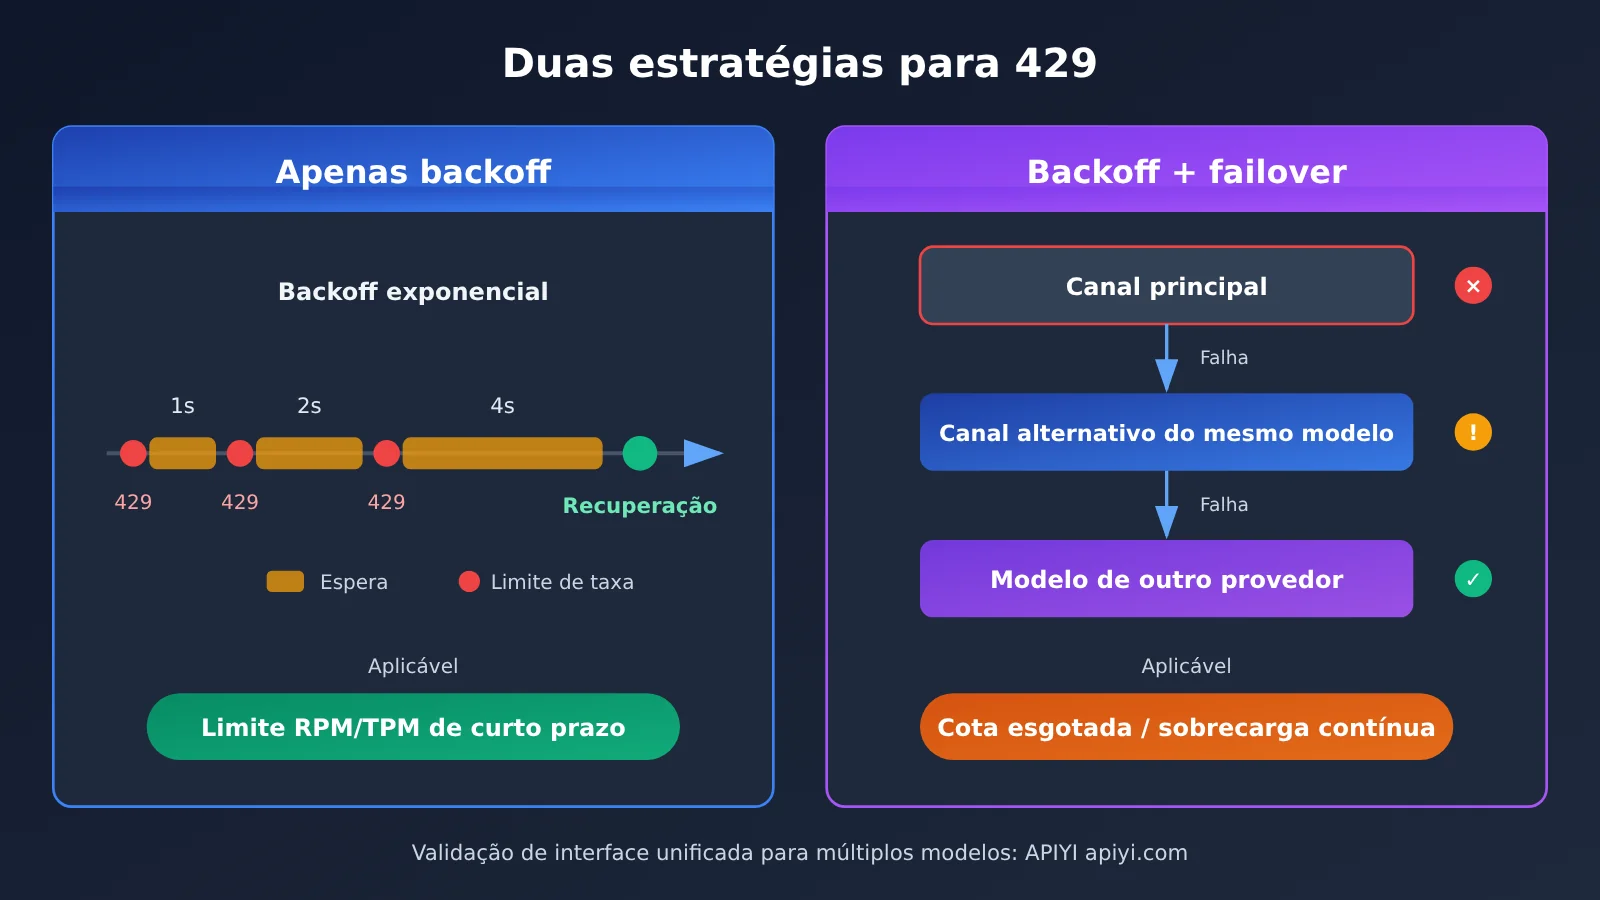
As duas estratégias comparadas na figura acima podem ser validadas em um projeto real através de uma mesma interface unificada. Em plataformas como a APIYI, que são compatíveis com os formatos de interface da OpenAI e da Anthropic, o mesmo código só precisa alterar o parâmetro model para trocar o modelo de reserva — muito menos trabalhoso do que manter um SDK separado para cada fabricante.
Guia rápido para lidar com rate limit 429
A seguir, organizo o conteúdo anterior em uma lista de configuração que você pode usar diretamente como referência na prática. O texto não traz implementação de código; você pode usá-lo como checklist em revisões de código ou configurações de operações.
Checklist de 5 configurações
- Logs: registrar o corpo completo da resposta e os cabeçalhos, incluindo pelo menos código de status, tipo de erro, mensagem de erro,
Retry-Aftere os diversos camposratelimit. - Classificação: no cliente, classificar os erros em três categorias: “pode tentar de novo com backoff” (429 de taxa, 529, 503), “precisa trocar” (cota esgotada, falhas persistentes) e “não deve tentar novamente” (400, 401, 403).
- Backoff: conforme a tabela de parâmetros acima, configurar backoff exponencial com full jitter, com prioridade para
Retry-After, e definir número máximo de tentativas e orçamento total de timeout. - Cadeia de fallback: configurar a lista de reserva na ordem “mesmo modelo, trocar de canal → mesmo fornecedor, trocar de faixa → fornecedor diferente, trocar de modelo”, validando com antecedência o comportamento do comando em cada modelo de fallback.
- Circuit breaker e alertas: definir limite de falhas e tempo de cooldown para cada canal, além de alertas para a proporção de 429; se ela ficar persistentemente alta, isso indica que é preciso solicitar aumento de limite ou ajustar a concorrência.
Exemplo de cadeia de modelos de fallback
A tabela abaixo mostra um exemplo comum de cadeia de fallback em três níveis. Os nomes específicos dos modelos devem seguir a lista de modelos da plataforma; os valores de cobrança devem seguir a página de preços. Este artigo não lista preços unitários específicos.
| Nível | Critério de escolha | Formato da API | Plataformas disponíveis | Base de preço |
|---|---|---|---|---|
| Principal | Modelo flagship com o melhor resultado para o negócio | Formato OpenAI ou Anthropic | APIYI apiyi.com, API oficial | Conforme docs.apiyi.com/models |
| Fallback nível 1 | Outro canal ou grupo do mesmo modelo | Igual ao principal | APIYI apiyi.com, API oficial | Conforme docs.apiyi.com/models |
| Fallback nível 2 | Modelo leve do mesmo fornecedor ou modelo equivalente de outro fornecedor | Formato compatível com OpenAI | APIYI apiyi.com e outras plataformas agregadoras | Conforme docs.apiyi.com/models |
Na integração, se você usa o SDK oficial da OpenAI ou da Anthropic, normalmente basta alterar base_url para o endereço fornecido pela plataforma e trocar api_key pela chave da plataforma. Para endereços de API específicos e instruções de invocação de cada modelo, recomendamos consultar a central de documentação da APIYI em docs.apiyi.com e não copiar endereços não verificados da internet.
🚀 Começo rápido: ao montar uma cadeia tolerante a falhas para 429, recomendo primeiro integrar o modelo principal e os modelos de fallback com o mesmo código via APIYI apiyi.com. A plataforma oferece chamadas de API para os principais modelos abordados neste artigo, compatíveis com os formatos de interface da OpenAI e da Anthropic; para trocar de modelo, basta alterar o parâmetro
model. A documentação de integração está em docs.apiyi.com. Os preços de entrada e saída por modelo, preços de cache e critérios de cobrança devem seguir os dados reais da página de preços docs.apiyi.com/models.
Perguntas Frequentes (FAQ)
Q1: O que é a limitação de taxa 429?
429 é o código de status Too Many Requests do padrão HTTP, que indica que o chamador excedeu, dentro de uma janela de tempo, o número permitido de requisições, tokens, concorrência ou cota total. Ele diz que “você foi limitado”, não que o modelo em si apresentou falha.
Q2: Qual é a diferença entre 429, 529 e 503?
O 429 aponta para um problema de cota do lado do chamador — a responsabilidade é “você está usando demais”; o 529 é o erro de sobrecarga da Anthropic e o 503 é serviço temporariamente indisponível — ambos são responsabilidade da capacidade do lado do servidor. Para o primeiro, priorize o backoff e o ajuste de uso; para os dois últimos, é mais indicado fazer um backoff curto e partir direto para o failover.
Q3: Como identificar rapidamente se o 429 vem do provedor upstream ou do gateway?
Primeiro, observe a redação do corpo do erro: os que trazem o tipo de erro do provedor geralmente vêm do upstream; os que mencionam conceitos como conta, grupo, canal etc. geralmente vêm do gateway. Depois, verifique os cabeçalhos de resposta: se aparecer um campo `ratelimit` com prefixo do provedor e o valor restante for 0, basicamente dá para confirmar que é o upstream limitando.
Q4: Por que, mesmo após muitos backoffs, o 429 não se recupera?
A causa mais comum é ter julgado errada a dimensão da limitação. Se a cota diária ou a cota gratuita se esgotou, o backoff está fadado a ser inútil; se o limite de concorrência foi excedido e o cliente continua enviando em alta concorrência, o backoff apenas alivia. Nesse momento, deve-se reduzir a concorrência ou entrar diretamente no failover.
Q5: Como montar rapidamente uma cadeia de failover multi-modelo?
Recomenda-se validar usando uma plataforma com interface unificada para múltiplos modelos:
1. Registre-se em APIYI apiyi.com e obtenha a chave API;
2. Configure o `base_url` conforme a documentação em docs.apiyi.com, integrando no formato OpenAI ou Anthropic;
3. Configure no cliente a lista de modelos primários e de backup, alternando ao alterar o parâmetro `model`.
Assim, os modelos primário e de backup compartilham o mesmo código, e o custo de testar a cadeia de failover fica bem menor.
Q6: O failover pode fazer os custos saírem do controle?
É possível. O preço unitário, o comprimento da janela de contexto e a estratégia de cache do modelo de backup podem ser diferentes dos do modelo primário, e trocas frequentes alteram a estrutura da fatura. Recomenda-se verificar antecipadamente o preço de cada modelo de backup, usando sempre como referência os dados reais da página de preços da APIYI em docs.apiyi.com/models, e configurar alertas para a proporção de failover.
Q7: Quais são as limitações conhecidas das soluções para 429?
O backoff aumenta a latência das requisições, não sendo adequado para cenários com exigência de tempo real muito alta; a troca entre provedores pode trazer diferenças de estilo e formato de saída, exigindo testes de regressão prévios; alguns provedores só exibem os limites no console, com informações incompletas nos cabeçalhos de resposta, de modo que a investigação depende apenas da redação do erro e dos dados de monitoramento.
Principais pontos do tratamento de limitação de taxa 429
- 429 só diz que você foi limitado: ele não diz quem limitou nem o que foi limitado, e não pode ser equiparado diretamente a uma falha do modelo.
- Leia primeiro o texto do erro: a redação do corpo do erro é a pista mais rápida para distinguir upstream, gateway ou plano gratuito.
- Depois olhe os cabeçalhos de resposta: o campo
ratelimitcom prefixo do provedor e oRetry-Aftersão a segunda cadeia de evidências. - Trate conforme a dimensão: RPM em ritmo constante, TPM reduzindo o contexto, concorrência controlando workers, cota esgotada trocando direto.
- Primeiro backoff, depois troca: backoff exponencial com jitter total,
Retry-Aftertem prioridade, e o retry tem limite. - Design em camadas da cadeia de failover: trocar de canal para o mesmo modelo primeiro, trocar de modelo entre provedores como fallback, combinado com circuit breaker.
- Reduza custos com uma interface unificada: pela interface da APIYI compatível com os formatos OpenAI e Anthropic, dá para gerenciar modelo principal e backup com um único conjunto de código.
Resumo
Ao encontrar um 429, a ordem correta é “localizar a origem → identificar a dimensão → backoff → troca”, e não sair trocando de modelo logo de cara:
- Localizar a origem: a redação do corpo do erro mais os cabeçalhos de resposta permitem distinguir provedor upstream, gateway e plano gratuito.
- Identificar a dimensão: descobrir se é número de requisições, número de tokens, concorrência ou cota total, para decidir se o backoff vai funcionar.
- Configurar tolerância a falhas: backoff exponencial com jitter como primeira linha de defesa, failover em camadas com circuit breaker como segunda.
Ao consolidar esse fluxo em logs, classificação de erros e configuração do cliente, o 429 deixa de ser “alarme no meio da madrugada” e passa a ser um evento rotineiro, previsível e autorrecuperável.
Recomenda-se validar rapidamente o efeito de troca entre modelo principal e de backup pela APIYI apiyi.com; as instruções de integração estão em docs.apiyi.com, e os preços e critérios de cobrança dos modelos envolvidos devem seguir docs.apiyi.com/models.
📚 Referências
- Rate Limit Reached in Claude Code: What Each 429 Message Means: interpretação do significado de cada mensagem de erro 429 no Claude Code
- Link:
ofox.ai/blog -
Descrição: explica como distinguir, pela fala original do servidor, entre o rate limiting da Anthropic, o do gateway e o do plano gratuito
-
Claude Code fallbackModel: 3-Tier Failover Setup: configuração de modelo de fallback no Claude Code
- Link:
ofox.ai/blog -
Descrição: aponta que o fallbackModel é acionado em sobrecarga 529, com no máximo 3 modelos, e não em 429
-
LLM API Rate Limits Compared: comparação das regras de rate limiting de 5 grandes fornecedores de modelos
- Link:
ofox.ai/blog -
Descrição: compara diferentes critérios de rate limiting, como por token, por concorrência e apenas exibição no console
-
Central de documentação e página de preços do APIYI: instruções de integração e cobrança de modelos
- Link:
docs.apiyi.comedocs.apiyi.com/models - Descrição: o formato da interface, a configuração de base_url e os preços reais de cada modelo têm como referência estas páginas
Autor: Equipe técnica do APIYI
Intercâmbio técnico: sinta-se à vontade para entrar em contato conosco pela página inicial do APIYI em apiyi.com para trocar experiências sobre rate limiting e tolerância a falhas; há mais materiais de integração no centro de documentação docs.apiyi.com