Resumo: O DeepSeek Harness consegue se conectar a gateways como o APIYI por meio de “API de modelo personalizado”. Os desenvolvedores configuram um provedor separado para cada protocolo, preenchem o ID do modelo que o gateway realmente suporta e, conforme a necessidade da tarefa, também integram ferramentas de busca na web de forma independente.
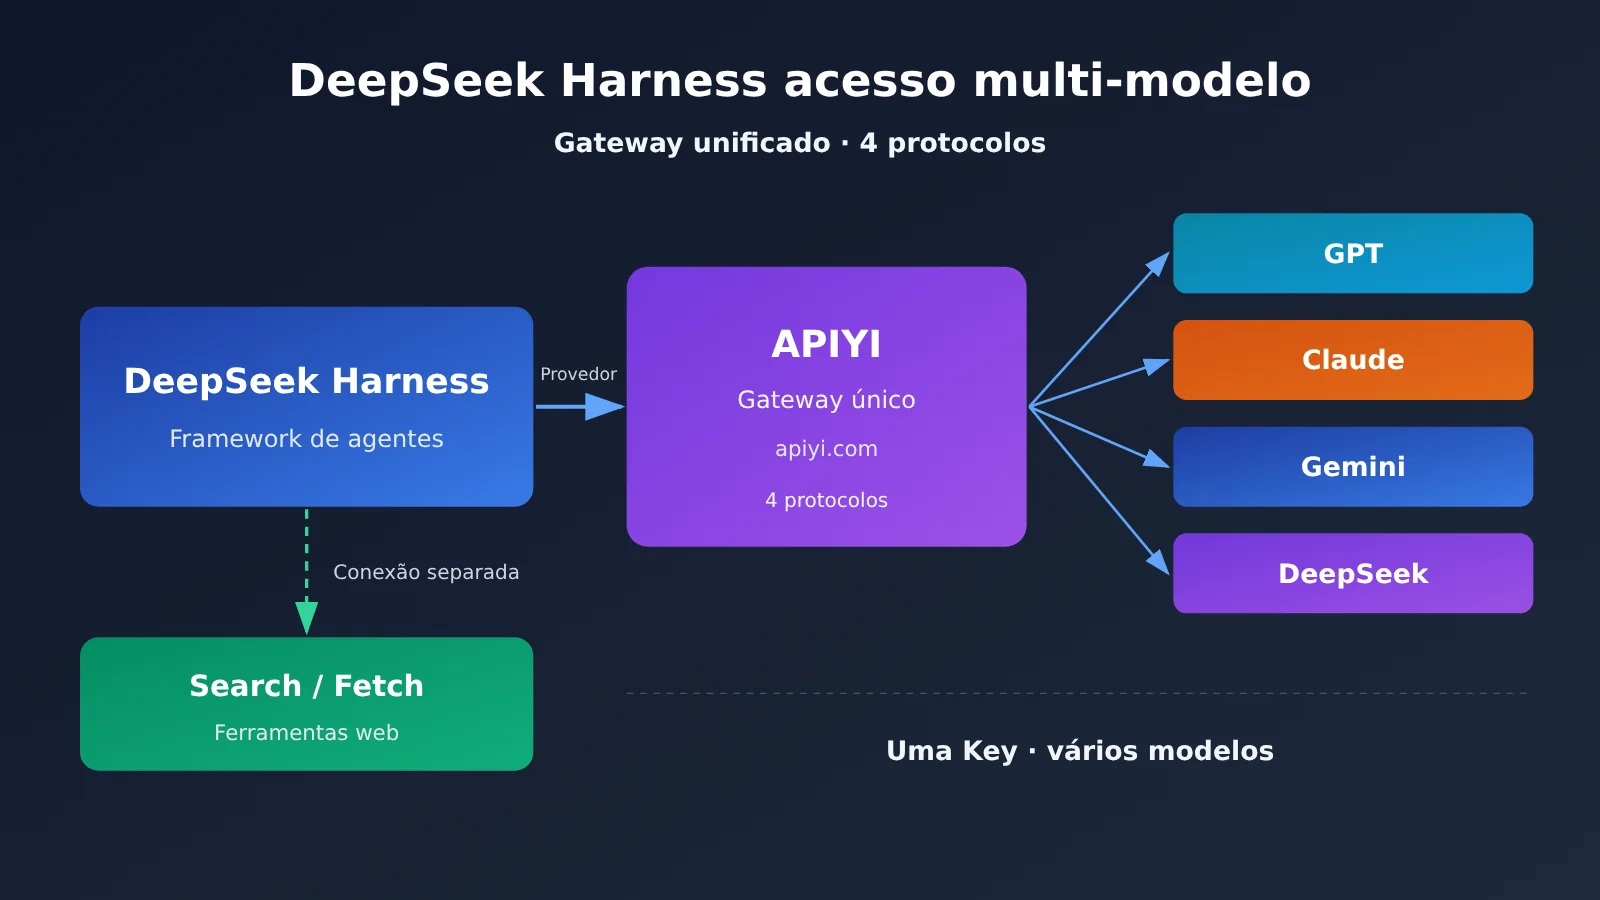
O DeepSeek Harness permite adicionar gateways de API de terceiros como provedores de modelo personalizados, com quatro protocolos disponíveis: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages e Gemini API. Assim, uma única instância do Harness consegue, por meio de um gateway unificado como o APIYI apiyi.com, invocar simultaneamente modelos de várias empresas. O sucesso da integração depende de quatro pontos: correspondência entre protocolo e Base URL, ID do modelo alinhado ao do gateway, compatibilidade dos parâmetros de raciocínio e de saída e planejamento separado da ferramenta de busca na web.
A seguir, o texto explica primeiro o mecanismo de adaptação de modelos do Harness e onde o gateway se encaixa nele; depois, seguindo a tela de configurações, conclui passo a passo uma configuração de provedor personalizado e apresenta um modelo de arquivo de configuração para o APIYI. Na sequência, reúne os problemas de compatibilidade e os códigos de erro mais comuns quando a interface conecta mas a invocação falha, distingue as duas rotas de busca na web — a busca integrada do lado do servidor do DeepSeek e o Search / Fetch independentes do APIYI — e, por fim, propõe um design em camadas e recomendações de implantação para Agentes com múltiplos modelos.
Saiba Mais: Terminologia de Integração Multi-Modelo do DeepSeek Harness
| Termo | Explicação |
|---|---|
| Harness | O framework de execução do Agente, responsável pela integração de modelos, chamada de ferramentas, contexto, sessão e o loop de execução de tarefas |
| API Gateway | Gateway que encaminha e gerencia de forma unificada as requisições de API de múltiplos modelos, oferecendo um único ponto de entrada externo |
| Base URL | Endereço base das requisições de API; dependendo do protocolo, o prefixo do caminho do endereço muda |
| Provider | Um provedor de serviço de modelo configurado no Harness, correspondente a um conjunto de endereço, protocolo e chave |
| Model ID | Identificador do modelo especificado na requisição, que deve coincidir com o nome realmente fornecido pelo gateway |
| Chat Completions | Interface de completude de conversa no estilo OpenAI, o protocolo mais usado por gateways compatíveis |
| Responses API | Interface de resposta estruturada da OpenAI, voltada para chamada de ferramentas e interação multi-turno |
| Anthropic Messages | Interface de mensagens no estilo Anthropic, o protocolo nativo da série de modelos Claude |
| Reasoning Effort | Parâmetro do nível de raciocínio do modelo, como off, low, medium, high, max |
| Tool Calling | O modelo ou o Agente decide chamar uma ferramenta externa e usar o resultado no raciocínio seguinte |
| Search / Fetch | Search é responsável pela busca na web e por retornar a lista de resultados; Fetch é responsável por capturar o corpo do texto da página web especificada |
| API Key | Credencial de autenticação de identidade, que determina quais modelos e interfaces a requisição pode acessar |
1 Por que o DeepSeek Harness é adequado para acesso a APIs multimodelo
1.1 Mecanismo de provedores de modelo do DeepSeek Harness
O DeepSeek Harness foi disponibilizado como código aberto em 13 de agosto de 2026, em versão de prévia para desenvolvedores, sob licença MIT. Sua arquitetura central é “Everything is a Plugin”. Adaptadores de modelo, ferramentas, Skills, armazenamento e gerenciamento de sessões são plugins substituíveis. Assim, a integração de modelos se torna um item de configuração aberto, em vez de um vínculo fixo com um fornecedor embutido no produto.
Na camada de modelo, o Harness permite adicionar vários provedores e alternar modelos durante a sessão. Cada provedor pode configurar chave API, Base URL, nome do modelo, protocolo de API, tamanho da janela de contexto, máximo de tokens de saída, capacidade de entrada de imagens e nível de raciocínio. Serviços proxy de API, gateways internos da empresa e serviços de modelos auto-hospedados podem ser integrados como provedores independentes.
Vale notar que o Harness ainda está em estágio de prévia para desenvolvedores, e a documentação oficial alerta que versões futuras podem introduzir mudanças incompatíveis. Antes de usar em produção, recomenda-se fixar a versão e fazer backup da configuração.
1.2 O papel do gateway de API no DeepSeek Harness
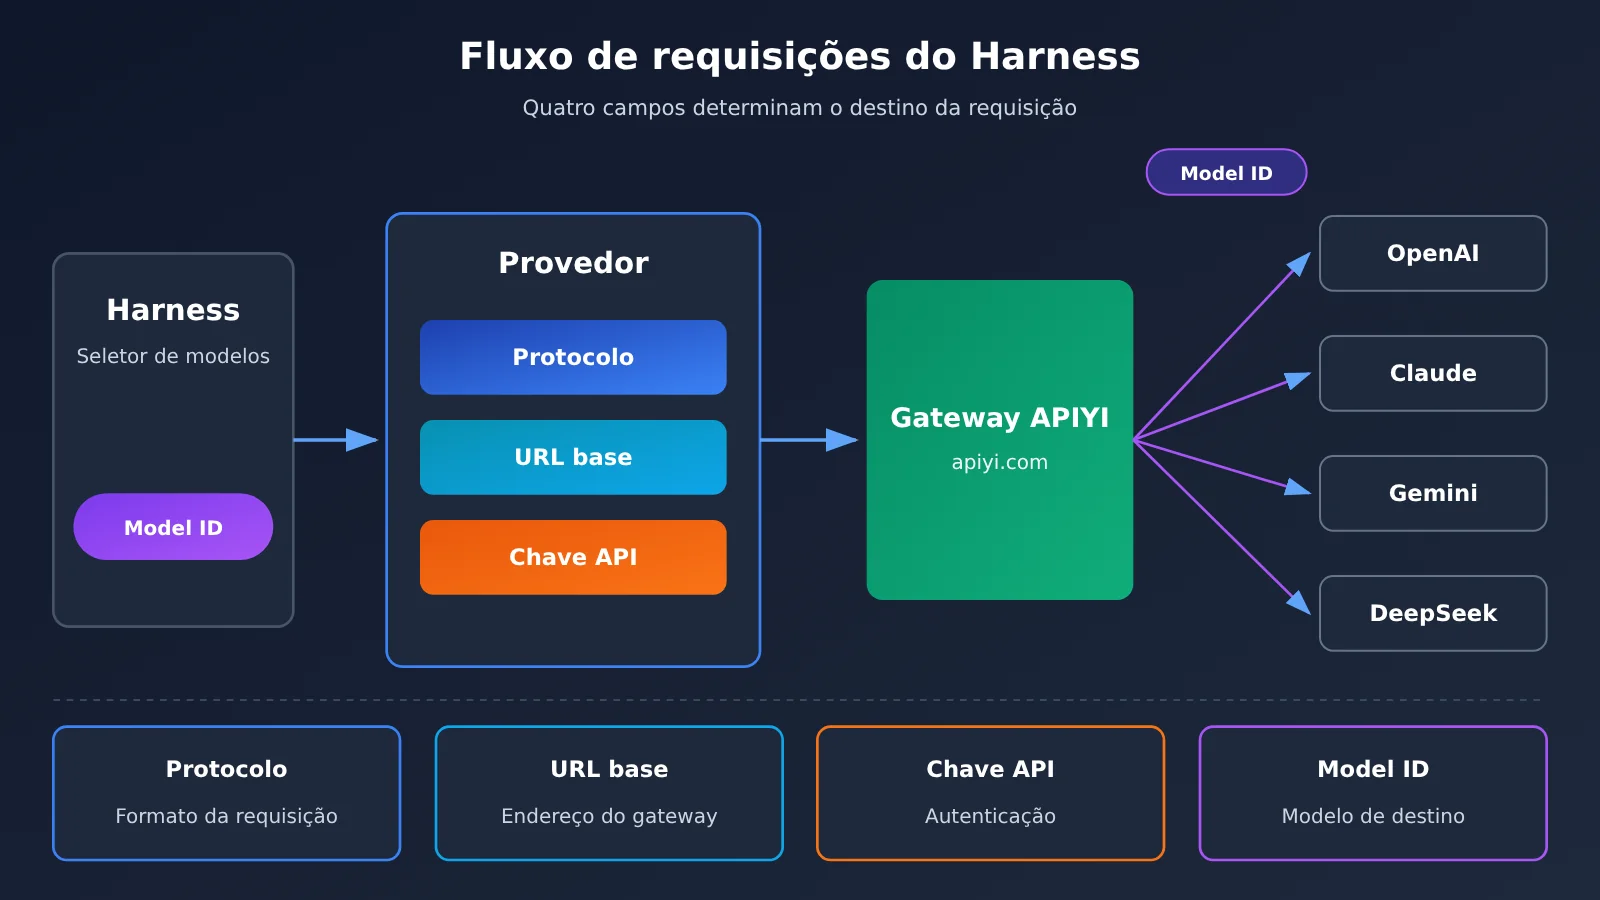
Na visão do Harness, um gateway é um Provider. Quatro campos determinam o destino de uma requisição: o Base URL aponta para o endereço do gateway, o protocolo define o formato da requisição e da resposta, a chave API comprova a identidade de quem faz a chamada e o Model ID informa ao gateway para qual modelo a requisição deve ser encaminhada.
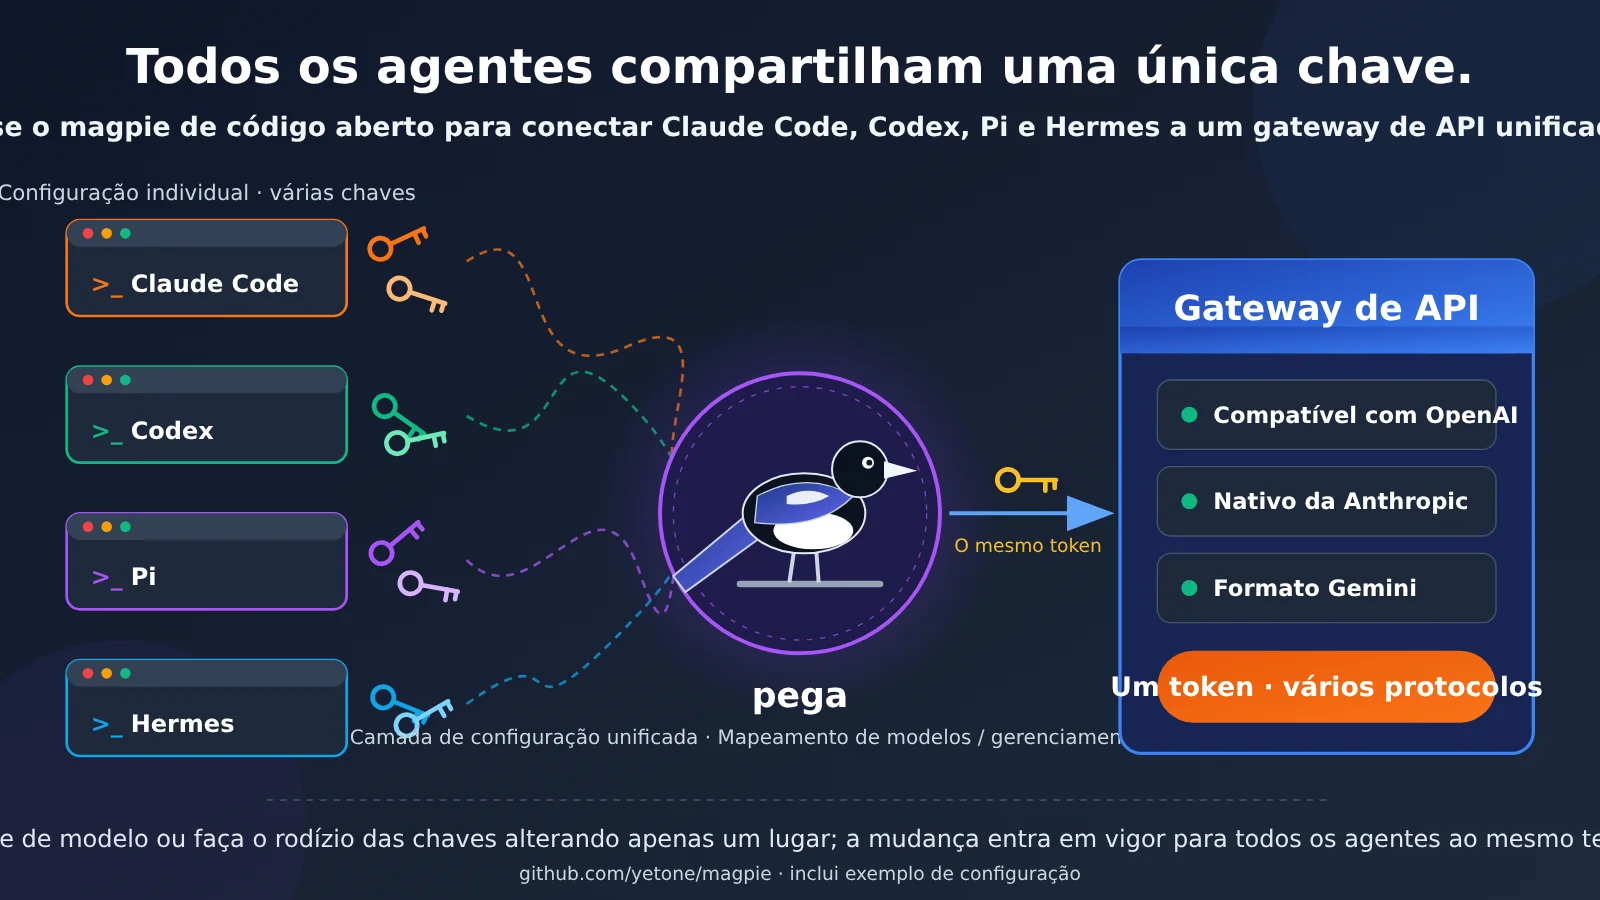
Tomemos como exemplo o APIYI apiyi.com: a plataforma oferece, com uma única chave API, modelos como OpenAI, Claude, Gemini e DeepSeek, e disponibiliza três entradas de protocolo: compatível com OpenAI, Anthropic nativo e Gemini. No Harness, basta criar o provedor correspondente de acordo com o protocolo; trocar de modelo passa a ser apenas alterar o Model ID, sem precisar solicitar uma conta separada e manter chaves para cada fornecedor.
2 Configurando um provedor de modelo personalizado no DeepSeek Harness do zero
2.1 Abrindo a interface de configuração de modelos do DeepSeek Harness
A maneira mais rápida de iniciar o Harness localmente é com o comando npm oficial; é necessário ter o Node.js instalado previamente:
npx @deepseek-ai/dsh web
# Por padrão, abre a interface Web local: http://127.0.0.1:3080
Depois de entrar na interface, clique em sequência em Configurações → Modelo → Adicionar provedor de modelo → API de modelo personalizado para ver o formulário de configuração do provedor. A versão desktop oficial oferece pacotes de instalação para macOS Apple Silicon e Windows 64 bits; o caminho de configuração é o mesmo.
2.2 Preencher as informações do provedor DeepSeek Harness
| Configuração | Função | O que preencher |
|---|---|---|
| ID do provedor | Identificador exclusivo do provedor | Deve estar em minúsculas e não pode ser renomeado após a criação, como apiyi |
| Nome de exibição | Nome mostrado no menu de modelos | Pode ser algo como “APIYI compatível com OpenAI” |
| Protocolo da API | Formato das requisições e respostas | Deve corresponder à Base URL; consulte 2.3 |
| Base URL | Endereço do serviço de API | Atenção ao prefixo de versão; consulte 2.4 |
| Chave API | Credencial de autenticação | Armazenada no arquivo de credenciais; a interface mostra apenas uma prévia mascarada |
| ID do modelo | Nome real do modelo a ser invocado | Deve ser idêntico à lista de modelos do gateway |
| Janela de contexto / Máximo de tokens de saída | Contexto e tamanho máximo de saída | Preencha conforme as especificações reais do modelo |
| Tipo de entrada | Entrada de texto ou imagem | Marque a opção de imagem apenas para modelos de visão |
| Nível de raciocínio | Nível de raciocínio e mapeamento de parâmetros | Adicione apenas os níveis realmente suportados pelo modelo |
O ID do provedor não pode ser renomeado porque as configurações de modelo, as conversas anteriores e as referências de credenciais apontam todas para esse ID. Se precisar trocá-lo, crie um novo provedor primeiro e depois exclua o antigo.
O botão “Obter modelos disponíveis” do formulário tenta ler a lista de modelos a partir do gateway. Se o gateway não fornecer uma lista padrão de modelos, ou se o formato retornado não estiver dentro do que o Harness reconhece, basta adicionar o ID do modelo manualmente — o resultado é o mesmo.
2.3 Escolhendo o protocolo de API do DeepSeek Harness
A API de modelos personalizados do Harness suporta quatro protocolos: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages e Gemini API. Um provedor só pode ser vinculado a um protocolo. Se o mesmo gateway expõe entradas para os três protocolos, você precisa criar três provedores.
A escolha do protocolo acompanha a família do modelo. GPT, DeepSeek e a maioria dos modelos nacionais funcionam com mais segurança no OpenAI Chat Completions; a linha Claude pode usar Anthropic Messages para manter os recursos nativos; a linha Gemini usa a Gemini API. O protocolo Responses é adequado para cenários que exigem respostas estruturadas e chamada de ferramentas, desde que tanto o gateway quanto o modelo de destino suportem essa interface.
2.4 Configurando uma instância do DeepSeek Harness com a APIYI
A relação oficial entre protocolo e Base URL fornecida pela APIYI é a seguinte:
| Protocolo | Base URL da APIYI | Modelos aplicáveis | Plataformas disponíveis |
|---|---|---|---|
| Compatível com OpenAI (Chat Completions) | https://api.apiyi.com/v1 |
GPT, DeepSeek e outros | APIYI apiyi.com, APIs oficiais de cada fabricante |
| Anthropic nativo | https://api.apiyi.com |
Linha Claude | APIYI, Anthropic oficial |
| Gemini | https://api.apiyi.com/v1beta |
Linha Gemini | APIYI, Google oficial |
O protocolo Anthropic usa o domínio raiz, e o adaptador monta os caminhos seguintes por conta própria. Se você adicionar /v1 depois do domínio raiz, pode haver duplicação de caminho e o retorno será 404. Para o acesso via protocolo Responses, consulte a documentação da APIYI Responses API e confirme antes de preencher.
Além da configuração pela interface, o Harness também permite editar manualmente o arquivo de configuração, localizado em $DSH_HOME/profiles/web/cordis.patch.yml. Abaixo está um template de provedor compatível com OpenAI da APIYI, escrito conforme a estrutura oficial de configuração:
- id: llm-pi-ai
  config:
    providers:
      apiyi:
        apiKeyEnv: APIYI_API_KEY          # lê a chave da variável de ambiente
        api: openai-completions           # protocolo OpenAI Chat Completions
        baseURL: https://api.apiyi.com/v1 # entrada compatível com OpenAI da APIYI
        models:
          - id: MODEL_ID_FROM_APIYI       # substitua pelo ID de modelo realmente disponível na conta
Passos de uso:
- Defina a variável de ambiente
APIYI_API_KEY; - Substitua
MODEL_ID_FROM_APIYIpelo nome de modelo realmente disponível no console da APIYI; - Salve a configuração, selecione o provedor
apiyie o modelo correspondente no seletor de modelos do Harness; - Inicie uma conversa simples para confirmar que a interface está funcionando.
Esse template mostra a estrutura oficial de configuração; os nomes de modelo devem seguir a lista que pode ser chamada na sua própria conta. As mudanças na configuração do modelo geralmente passam a valer na próxima requisição, sem precisar reiniciar a Web UI. A configuração pela interface é adequada para adicionar modelos e alterar chaves no dia a dia; o arquivo de configuração é adequado para ajustar parâmetros de compatibilidade, modo de inferência, timeout, retry e outros ajustes avançados.
Antes de conectar ao Harness, recomenda-se verificar separadamente a Key e o Model ID com um script, dividindo “gateway disponível” e “configuração do Harness correta” em dois problemas para investigar:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # entrada compatível com OpenAI da APIYI apiyi.com
)

resp = client.chat.completions.create(
    model="MODEL_ID_FROM_APIYI",  # consistente com o Model ID preenchido no Harness
    messages=[{"role": "user", "content": "用一句话介绍你自己"}],
    max_tokens=100
)
print(resp.choices[0].message.content)
🚀 Sugestão para começar rápido: novos usuários podem se registrar em APIYI apiyi.com e receber créditos gratuitos de teste; primeiro use o script acima para confirmar que o model ID funciona, depois escreva na configuração do Harness — o tempo total de solução de problemas cai bastante.
3 A interface do DeepSeek Harness conecta, mas por que a invocação do modelo ainda falha?
A documentação oficial do Harness deixa isso claro: mesmo com o endereço da API e a chave corretos, o gateway ainda pode rejeitar a requisição. O motivo é que interfaces compatíveis diferentes têm exigências distintas quanto aos papéis das mensagens, ao comprimento da saída e aos parâmetros de raciocínio. Os três parâmetros compat abaixo servem justamente para resolver esse tipo de problema e devem ser ativados conforme a necessidade, de acordo com o erro que a interface retornar de fato.
3.1 Compatibilidade com o papel Developer
A especificação mais recente da OpenAI introduziu role: developer, mas alguns gateways compatíveis aceitam apenas system. Se aparecer a situação de “todas as requisições falham” ou “somente os modelos de raciocínio falham”, dá para desativar o papel developer:
compat:
  supportsDeveloperRole: false
Ao ativar essa opção, o adaptador ajusta a forma como os papéis são tratados na requisição, para que ela fique no formato que o gateway aceita.
3.2 Compatibilidade do parâmetro de saída máxima
A nova interface da OpenAI usa max_completion_tokens para indicar a saída máxima, enquanto alguns gateways aceitam apenas o tradicional max_tokens. O significado é o mesmo; se o nome do campo não bater, a validação de parâmetros falha na hora. A configuração correspondente é:
compat:
  maxTokensField: max_tokens
3.3 Compatibilidade com o modo de raciocínio do DeepSeek
Alguns modelos DeepSeek ativam o raciocínio por padrão. Ao definir o nível de raciocínio como off no Harness, certos protocolos compatíveis apenas omitem os parâmetros de raciocínio, e o modelo continua raciocinando conforme o comportamento padrão — o que resulta naquele “off que não desliga”. Por isso a documentação oficial oferece um formato de raciocínio específico para o DeepSeek:
compat:
  thinkingFormat: deepseek
Depois de habilitado, ao desligar o raciocínio o adaptador envia explicitamente {"thinking": {"type": "disabled"}}, e ao ligar envia {"thinking": {"type": "enabled"}}. O exemplo oficial é voltado para o modelo DeepSeek V4 atrás de um gateway compatível com OpenAI. Em gateways multimodelo, dá para definir esse parâmetro apenas para os modelos DeepSeek, mantendo GPT, Claude e outros modelos no padrão.
Quanto aos níveis de raciocínio, o Harness permite mapear os valores off, low, medium, high e max da interface para os valores de parâmetro que a API realmente aceita. Incluir na configuração apenas os níveis que o modelo realmente suporta evita que o usuário selecione um nível inválido e a requisição retorne erro. Um exemplo completo com os três parâmetros de compatibilidade combinados fica assim:
- id: llm-pi-ai
  config:
    providers:
      apiyi:
        apiKeyEnv: APIYI_API_KEY
        api: openai-completions
        baseURL: https://api.apiyi.com/v1
        compat:
          supportsDeveloperRole: false
          maxTokensField: max_tokens
        models:
          - id: MODEL_ID_FROM_APIYI
3.4 Solução rápida de erros comuns do DeepSeek Harness
| Erro ou fenômeno | Possível causa | Como resolver |
|---|---|---|
| MISSING_CREDENTIAL | Chave não configurada | Verifique a chave API e o nome da variável de ambiente |
| UNKNOWN_MODEL | ID do modelo não registrado | Adicione o ID correto do modelo no provedor |
| HTTP 401 | Chave inválida ou permissão insuficiente | Confira o conteúdo da chave e o grupo a que ela pertence |
| HTTP 404 | Caminho do Base URL incorreto | Confira o protocolo e o prefixo de versão (/v1, domínio raiz, /v1beta) |
| Lista de modelos vazia | O gateway não suporta a interface padrão de listagem de modelos | Adicione o ID do modelo manualmente |
| Todas as requisições falham | Conflito no formato da role ou dos parâmetros | Verifique os parâmetros de compatibilidade compat |
| Apenas modelos de raciocínio falham | A role Developer é incompatível | Defina supportsDeveloperRole: false |
| off não consegue desativar o raciocínio | O modelo ativa o raciocínio por padrão | Defina thinkingFormat: deepseek |
| Interface de busca retorna 503 | O grupo do token não tem permissão para ferramentas | Troque para um token dos grupos default ou svip |
| Conversa normal, mas acesso à internet indisponível | Ferramenta de busca não integrada ou protocolo não suportado | Verifique as capacidades da ferramenta e a configuração do cliente |
Os primeiros oito itens seguem a documentação oficial de configuração do Harness; os problemas relacionados a grupos vêm da documentação oficial do APIYI. A ordem de investigação sugerida é de cima para baixo: primeiro confirme as credenciais, depois o ID do modelo, em seguida o caminho e, por fim, a compatibilidade dos parâmetros.
4 Adicionar capacidade de busca na web ao DeepSeek Harness
4.1 Diferenciar a busca integrada ao modelo da API de busca independente
O sucesso em uma chamada de conversa comum apenas prova que a chave API é válida, que o ID do modelo está correto e que o protocolo de conversa é basicamente compatível. A capacidade de busca na web também exige que o modelo suporte a ferramenta correspondente, que a requisição declare corretamente a ferramenta, que o serviço de API suporte o protocolo dessa ferramenta e que o Harness consiga processar a resposta da ferramenta — ou que o desenvolvedor integre a busca separadamente no lado da aplicação. Portanto, sucesso no chat e sucesso na busca na web são duas etapas de verificação independentes.
No ecossistema DeepSeek, a capacidade de busca na web segue dois caminhos técnicos:
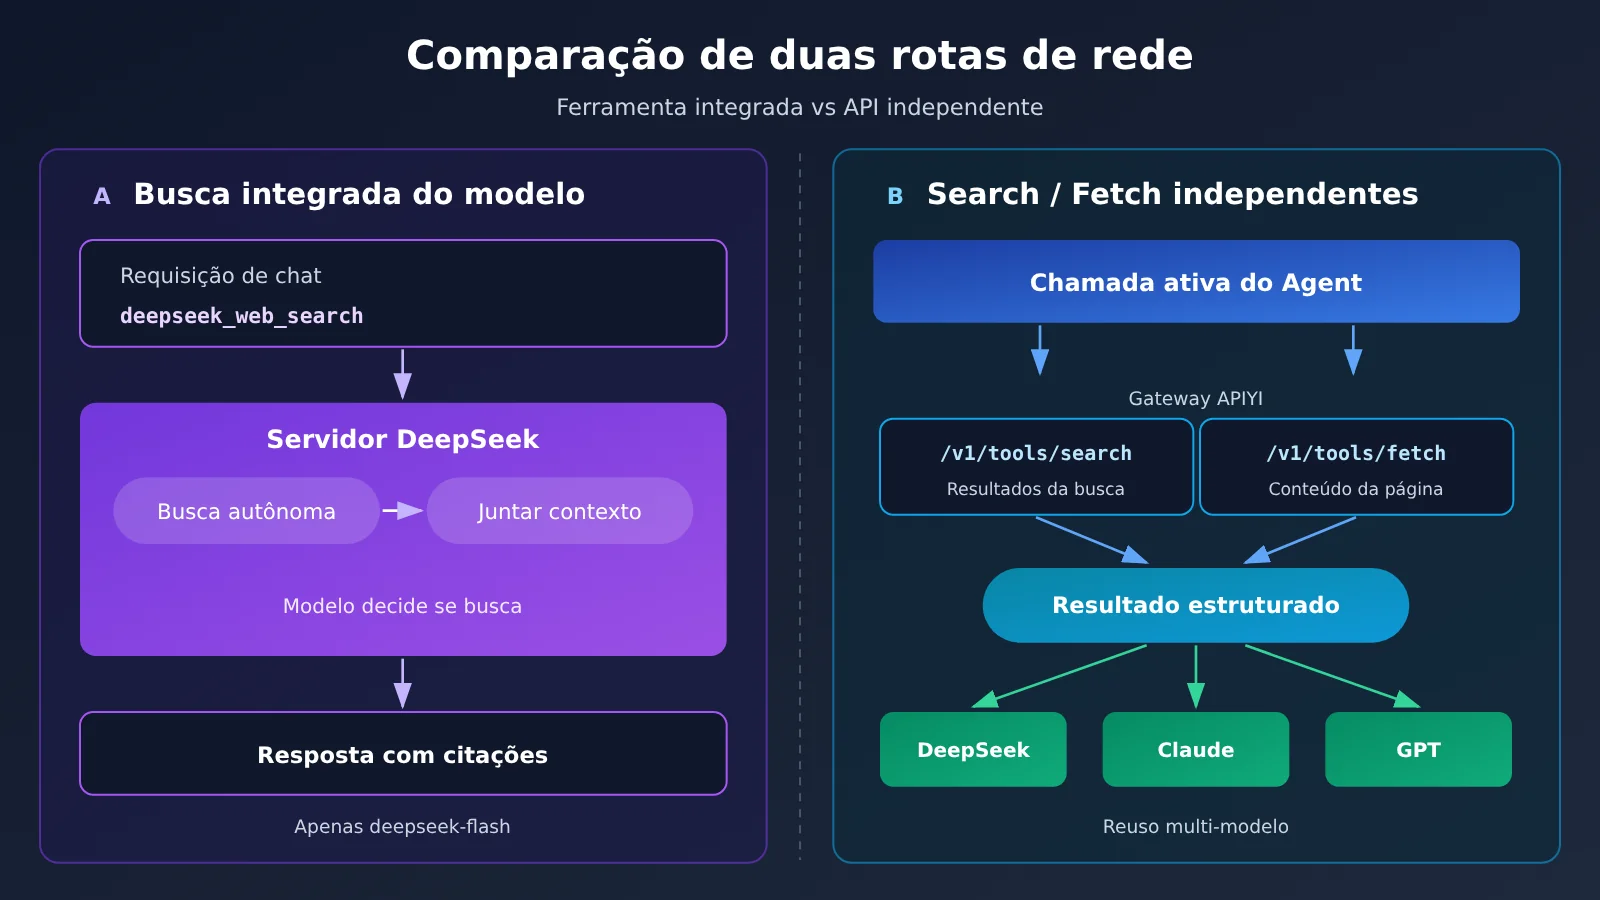
| Dimensão | Rota A: ferramenta de servidor integrada ao modelo | Rota B: API Search / Fetch independente |
|---|---|---|
| Método de invocação | Na requisição de conversa, declarar deepseek_web_search e deepseek_read_url |
O programa solicita ativamente /v1/tools/search e /v1/tools/fetch |
| Quem decide a busca | O próprio modelo julga de forma autônoma | O desenvolvedor ou a lógica de ferramentas do Agent |
| Execução da ferramenta | O servidor DeepSeek realiza a busca e a montagem do contexto | O cliente recebe o resultado e o processa por conta própria |
| Escopo de modelos | O anúncio oficial indica explicitamente deepseek-flash |
Independe do modelo; qualquer modelo pode reutilizar os resultados |
| Critério de cobrança | Cobrança conforme o número real de termos de busca, páginas web coletadas etc. | Cobrança por número de requisições bem-sucedidas; não consome tokens do modelo |
| Canais disponíveis atualmente | API oficial do DeepSeek | API oficial do DeepSeek, APIYI |
4.2 Como funciona a busca integrada ao modelo
Em 13 de novembro de 2026, a DeepSeek liberou várias capacidades de aplicação por trás do App, entre elas a busca na internet e a leitura de links, oferecidas como ferramentas do lado do servidor. Basta declará-las na lista de ferramentas da requisição:
[
  {"type": "deepseek_web_search", "name": "deepseek_web_search"},
  {"type": "deepseek_read_url", "name": "deepseek_read_url"}
]
Depois de declaradas, o modelo decide sozinho se precisa acessar a internet e gera os termos de busca; o servidor da DeepSeek executa a pesquisa e retorna uma resposta com citações das fontes. Ao ativar o modo de raciocínio, a busca passa a ser um fluxo de várias etapas: o modelo pode pesquisar várias palavras-chave, abrir páginas web, procurar dentro da página e fazer verificação cruzada. A documentação oficial indica que ele responde após no máximo cerca de 20 invocações de ferramentas. O deepseek_read_url reconhece apenas a URL presente na última mensagem do usuário, considerando no máximo 10 links diferentes.
Os desenvolvedores ainda precisam lidar com os blocos de conteúdo retornados, as informações de citação, os eventos de streaming e o histórico de múltiplos turnos. Segundo o comunicado oficial, essa integração completa de ferramentas em nível de conversa é suportada pelo deepseek-flash (DeepSeek-V4.1-Flash). Conforme a documentação do APIYI, o trabalho de compatibilidade para chamar esse tipo de busca integrada através do gateway em clientes como Harness e Claude Code ainda está no planejamento futuro; por enquanto, para usar a rota A, é preciso conectar-se diretamente à API oficial da DeepSeek.
4.3 Integração das ferramentas independentes de Search / Fetch da APIYI
A APIYI lançou em 21 de outubro de 2026 as interfaces de ferramenta independentes DeepSeek Search & Fetch, correspondentes a deepseek-search e deepseek-fetch. O Search retorna resultados de busca estruturados, e o Fetch acessa a página web indicada e devolve o conteúdo em Markdown. As requisições não precisam enviar ID de modelo e não consomem tokens do modelo — a cobrança é por número de chamadas bem-sucedidas.
O exemplo a seguir primeiro faz a busca e depois captura a página web que ficou em primeiro lugar:
import os
import requests

BASE = "https://api.apiyi.com/v1/tools"  # Interface de ferramenta independente da APIYI
headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}

search = requests.post(
    f"{BASE}/search",
    headers=headers,
    json={"query": "DeepSeek Harness 插件", "count": 5},
    timeout=60,
)
search.raise_for_status()
results = search.json()["results"]

if results:
    url = results[0]["url"]
    fetch = requests.post(
        f"{BASE}/fetch",
        headers=headers,
        json={"url": url},
        timeout=60,
    )
    if fetch.ok:
        print(fetch.json()["content"])
Atenção especial ao grupo do token: os grupos default e svip conseguem chamar essas duas interfaces, enquanto tokens do grupo ClaudeCode não funcionam diretamente — a documentação já registrou casos de resposta 503. Os testes internos descritos na documentação da APIYI mostram que o Search devolve 5 resultados em cerca de 1,8 segundo, e que 20 requisições concorrentes retornaram todas 200; já o Fetch, ao acessar uma página inacessível, retorna falha e não gera cobrança. Esses números vêm dos testes da própria plataforma: o desempenho real depende da rede e do site de destino. Sobre preço, a documentação lista US$ 0,90 por 1.000 chamadas como valor dentro da plataforma, e com os bônus de recarga o valor efetivamente pago fica menor — o console é a referência final.
Para que o Agent dentro do Harness use essa lógica por conta própria, é preciso empacotá-la como um plugin de ferramenta. Plugins do Harness são escritos em TypeScript e registram ferramentas por meio do objeto de contexto ctx; quando o plugin é removido, o framework limpa automaticamente as ferramentas e os eventos registrados. Na hora de empacotar, a recomendação é registrar search e fetch como duas ferramentas separadas, para que o modelo receba primeiro a lista de resultados e só depois decida quais páginas capturar.
💡 Dica técnica: as ferramentas independentes de Search / Fetch são desacopladas do modelo, então o mesmo conjunto de resultados de busca pode ser entregue a modelos diferentes, como GPT, Claude e DeepSeek. Usando a APIYI em apiyi.com, você gerencia invocação de modelo e ferramentas de busca com uma única chave API, o que facilita comparar no Harness a qualidade das respostas de modelos distintos sobre o mesmo material.
5 Como projetar um Agente multi-modelo do DeepSeek Harness
5.1 Escolha modelos diferentes de acordo com a tarefa
O valor da integração de múltiplos modelos está em alocar modelos de acordo com a tarefa. Um Agente de programação pode usar um modelo especializado em código; tarefas frequentes, como organizar documentos, resumir e reescrever, combinam com modelos de menor custo; já para analisar capturas de tela e entender gráficos, é obrigatório escolher um modelo visual com suporte a entrada de imagens e marcar a opção de imagem em Input Type.
Tomando os modelos oficiais da DeepSeek como exemplo, o DeepSeek-V4.1-Flash oferece suporte à compreensão de imagens, enquanto o DeepSeek-V4-Pro não oferece, e os preços dos dois chegam a diferir várias vezes. No Harness, configure-os como dois Model IDs no mesmo provedor e alterne entre eles na sessão conforme a tarefa; assim você equilibra qualidade e custo.
5.2 Gerenciamento em camadas da invocação de modelos e das capacidades de busca do DeepSeek Harness
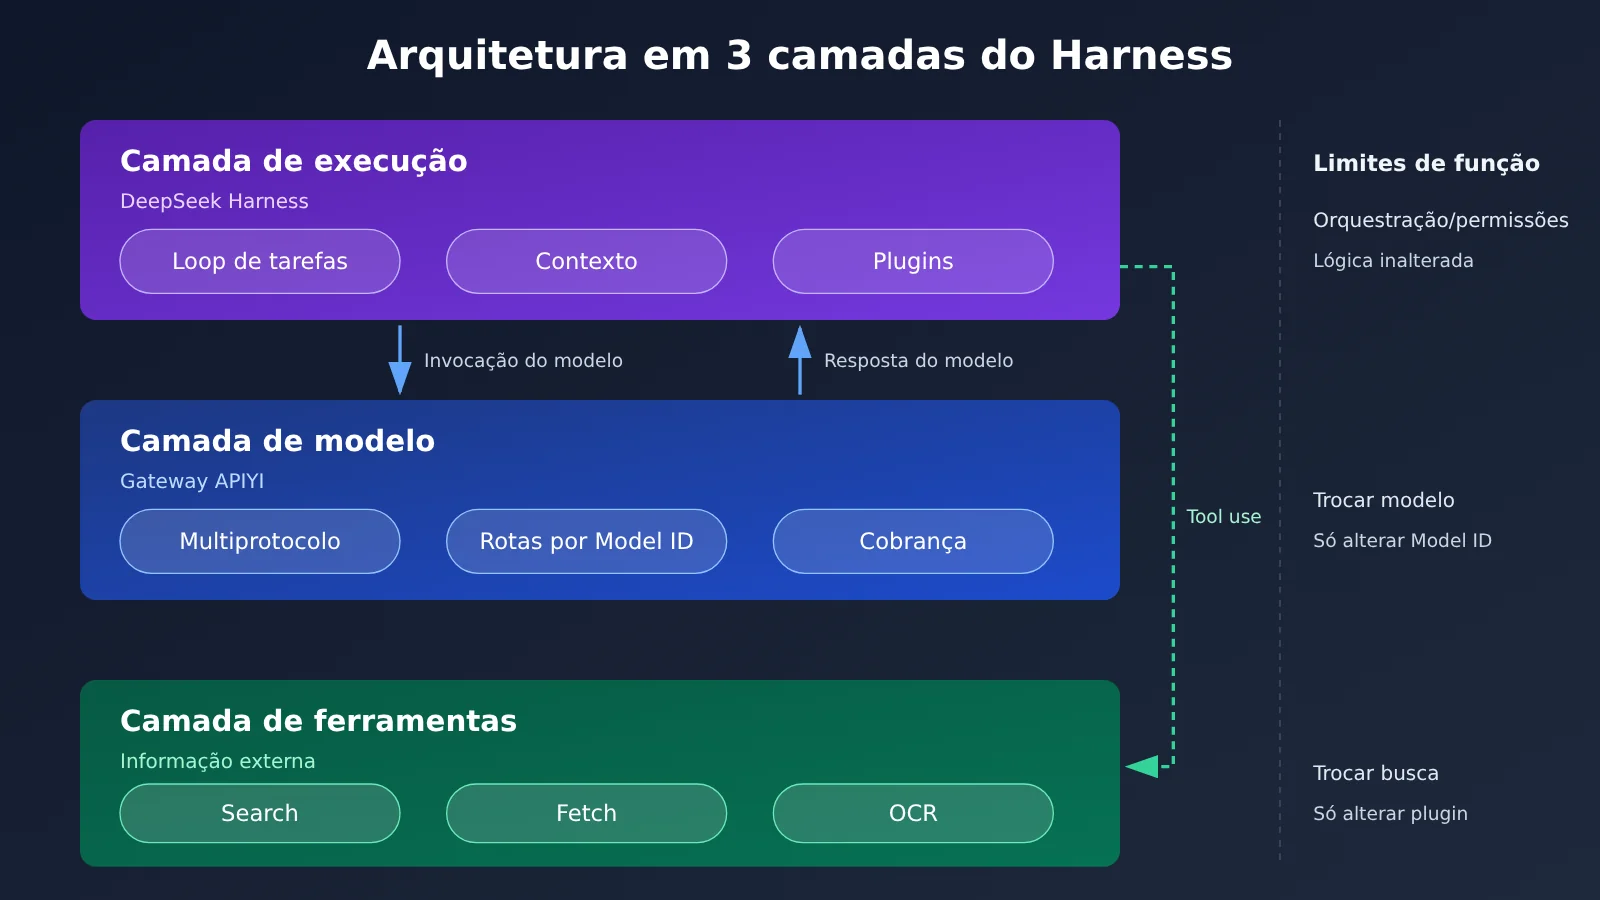
A estrutura recomendada tem três camadas. A camada de execução fica a cargo do Harness e cuida do loop de tarefas, da compressão de contexto, do carregamento de plugins e do controle de permissões; a camada de modelos fica a cargo do gateway de API e cuida da conversão de protocolos, do roteamento de modelos e da cobrança; a camada de ferramentas fornece informações externas por meio de interfaces independentes, como Search / Fetch. Cada camada pode ser substituída de forma independente: para trocar de modelo, basta alterar o Model ID; para trocar o serviço de busca, basta alterar o plugin de ferramentas; a lógica de execução permanece inalterada.
A separação em camadas também traz benefícios de segurança. Uma avaliação controlada do Harness feita pelo Laboratório Zhuque da Tencent mostrou que conteúdo não confiável, como páginas web, arquivos e Skills, pode influenciar o comportamento do Agente por meio de injeção indireta de comandos. Com a camada de ferramentas separada da camada de execução, é possível adicionar uma etapa unificada de filtragem e confirmação antes que os resultados da busca entrem no contexto e antes da execução de ferramentas sensíveis.
5.3 Recomendações para implantação real do DeepSeek Harness
- Configuração de modelos: um protocolo corresponde a um provedor; defina o Provider ID em minúsculas logo de início; copie sempre o Model ID do console do gateway.
- Gestão de chaves: o Harness armazena as chaves em
$DSH_HOME/.credentials.yaml; os arquivos de configuração referenciam apenas variáveis de ambiente, evitando que chaves em texto simples entrem em configurações compartilhadas ou repositórios de código. - Testes de compatibilidade: a cada novo modelo integrado, valide na ordem: conversa normal, desativação do raciocínio, saída longa e entrada de imagem; em seguida, habilite o parâmetro
compatconforme o erro. - Invocação de ferramentas: controle a quantidade de plugins. Relatos da comunidade mostram que, após instalar mais de uma dúzia de plugins, podem ocorrer estouro de contexto e aumento do consumo de Tokens; manter descrições enxutas nas ferramentas de busca tende a ser mais estável.
- Registro de custos: Tokens de modelos e chamadas de ferramentas são cobrados separadamente; recomenda-se contabilizá-los em separado no backend do gateway. O console da APIYI apiyi.com permite consultar o uso por Key, o que é adequado para atribuir uma Key independente a cada Agente e rastrear custos por responsável.
Além disso, antes de atualizar o Harness, faça backup das configurações em $DSH_HOME. A comunidade já registrou um caso em que as configurações de plugins de terceiros foram perdidas após uma atualização de versão, e a recuperação levou várias horas.
Perguntas frequentes (FAQ)
Q1: O DeepSeek Harness só funciona com modelos DeepSeek?
O Harness permite conectar, por meio de uma API de modelo personalizada, qualquer serviço compatível com um dos quatro protocolos, incluindo as séries OpenAI, Claude e Gemini, além de diversos gateways de API e serviços de modelos auto-hospedados. Os modelos oficiais da DeepSeek são apenas uma das opções.
Q2: Por que criar vários provedores para um mesmo gateway?
O Harness determina que cada provedor seja vinculado a apenas um protocolo. A APIYI disponibiliza simultaneamente três pontos de entrada: compatível com OpenAI, Anthropic e Gemini. Se você quiser chamar GPT, Claude e Gemini usando os protocolos nativos de cada um, será preciso criar três provedores, com Base URL definida respectivamente como `/v1`, o domínio raiz e `/v1beta`.
Q3: Como confirmar qual ID de modelo devo preencher?
Primeiro, experimente a função “obter modelos disponíveis”; se não conseguir ler, copie o nome exato da lista de modelos do painel do APIYI apiyi.com e adicione manualmente. O ID do modelo diferencia maiúsculas de minúsculas e sufixos de versão, e qualquer divergência gera UNKNOWN_MODEL ou um erro do gateway.
Q4: Depois de conectar via APIYI, posso usar deepseek_web_search diretamente?
Atualmente a APIYI já oferece suporte às interfaces independentes Search / Fetch da DeepSeek; a compatibilidade para chamar a busca integrada ao modelo por meio de clientes como o Harness ainda está em planejamento. Nesta fase, recomenda-se usar `/v1/tools/search` e `/v1/tools/fetch` da APIYI, empacotados como ferramentas do Agent; quando precisar da busca integrada, conecte-se diretamente à API oficial da DeepSeek.
Q5: A interface de busca retorna 503, mas a conversa funciona normalmente. Qual é o motivo?
O motivo mais comum é o grupo do token. Tokens do grupo ClaudeCode não conseguem chamar diretamente as interfaces de ferramentas independentes; basta trocar para uma Key dos grupos default ou svip. No painel do APIYI apiyi.com, você pode criar um token separado, do grupo correspondente, exclusivo para a ferramenta de busca, e gerenciá-lo de forma independente da Key usada para invocar os modelos.
Q6: Quais são as limitações de conectar vários modelos ao DeepSeek Harness?
O Harness ainda é uma versão de prévia para desenvolvedores, e a estrutura de configuração pode mudar conforme a versão; cada gateway tem um nível diferente de transparência em relação a Responses, parâmetros de raciocínio e protocolos de ferramentas, sendo necessário validar modelo por modelo. Muitos plugins aumentam o custo de contexto e de tokens, e a qualidade de entrega de tarefas complexas também depende da configuração dos plugins e do gerenciamento do processo de execução.
Resumo
O mecanismo de adaptação de modelos abertos do DeepSeek Harness permite que uma estrutura de Agent invoque modelos de vários fornecedores por meio de um gateway unificado. Na hora de colocar em produção, vale ficar atento a estes pontos:
- O protocolo define o provedor: um protocolo, um Provider; o prefixo de versão da Base URL precisa corresponder estritamente ao protocolo;
- Copie o ID do modelo direto do gateway: pegue no console; se a lista não carregar, adicione manualmente;
- Ative os parâmetros de compatibilidade conforme o erro: o papel
developer, o campomax_tokense o formato de raciocínio do DeepSeek cobrem a maioria dos casos de “conecta, mas não funciona”; - Planeje o acesso à rede separadamente: a busca integrada usa a API oficial da DeepSeek; os recursos independentes de Search / Fetch podem ser chamados via gateway e encapsulados como ferramentas;
- Camadas e governança: separe a camada de execução, a camada de modelo e a camada de ferramentas, e gerencie chaves, versões e custos de forma independente.
A sugestão é começar com um único modelo para validar o fluxo completo “verificação por script → configuração do Harness → conversa simples” e, aos poucos, ir adicionando mais modelos e ferramentas de busca. Recomendamos resgatar a cota gratuita de teste em APIYI apiyi.com e usar uma única chave para validar de ponta a ponta vários modelos e os recursos de Search / Fetch.
📚 Referências
- Documentação de configuração de modelos do DeepSeek Harness: campos de provedor personalizado e parâmetros de compatibilidade
- Link:
deepseek-harness.github.io/deepseek-harness/guide/providers -
Descrição: documentação oficial de supportsDeveloperRole, maxTokensField e thinkingFormat
-
Repositório GitHub do DeepSeek Harness: código-fonte, Releases e formas de inicialização
- Link:
github.com/deepseek-ai/deepseek-harness -
Descrição: atualizações de versão e notas sobre a fase de preview para desenvolvedores
-
Documentação das ferramentas de acesso à rede da DeepSeek: deepseek_web_search e deepseek_read_url
- Link:
api-docs.deepseek.com/zh-cn/guides/web_tools/ -
Descrição: como declarar a busca integrada, limitações e critérios de cobrança
-
Guia de configuração da Base URL do APIYI: explicação dos três caminhos de protocolo
- Link:
help.apiyi.com/apiyi-base-url-v1-claude-gemini-endpoint-config-guide.html -
Descrição: cenários de uso de
/v1, do domínio raiz e de/v1beta -
Documentação de DeepSeek Search & Fetch do APIYI: interfaces das ferramentas independentes e requisitos de agrupamento
- Link:
docs.apiyi.com/api-capabilities/deepseek-search-fetch/overview - Descrição: parâmetros de requisição, agrupamento de tokens e critérios de cobrança
Autor: Equipe técnica da APIYI
Contato técnico: se tiver problemas durante a configuração, fale com a gente pela página inicial do APIYI apiyi.com. Mais detalhes sobre as interfaces estão no centro de documentação docs.apiyi.com