Nota do autor: usando o Meta Muse como estudo de caso, este texto explica o que exatamente precisa ser refinado em um agente de IA, com foco em ajuste de comportamento e visibilidade de estado, e apresenta passos que você pode seguir.
Muitas equipes que desenvolvem agentes de IA enfrentam a mesma situação: a capacidade do modelo já é suficiente, a demonstração flui bem, mas os usuários abandonam depois de alguns dias de uso real. O problema geralmente não está no modelo em si, mas nas duas camadas de ajuste de comportamento e visibilidade de estado, que não receberam o refinamento necessário. Neste artigo, usamos o Muse, da Meta, como estudo de caso para destrinchar o que, afinal, se refina ao refinar um agente de IA.
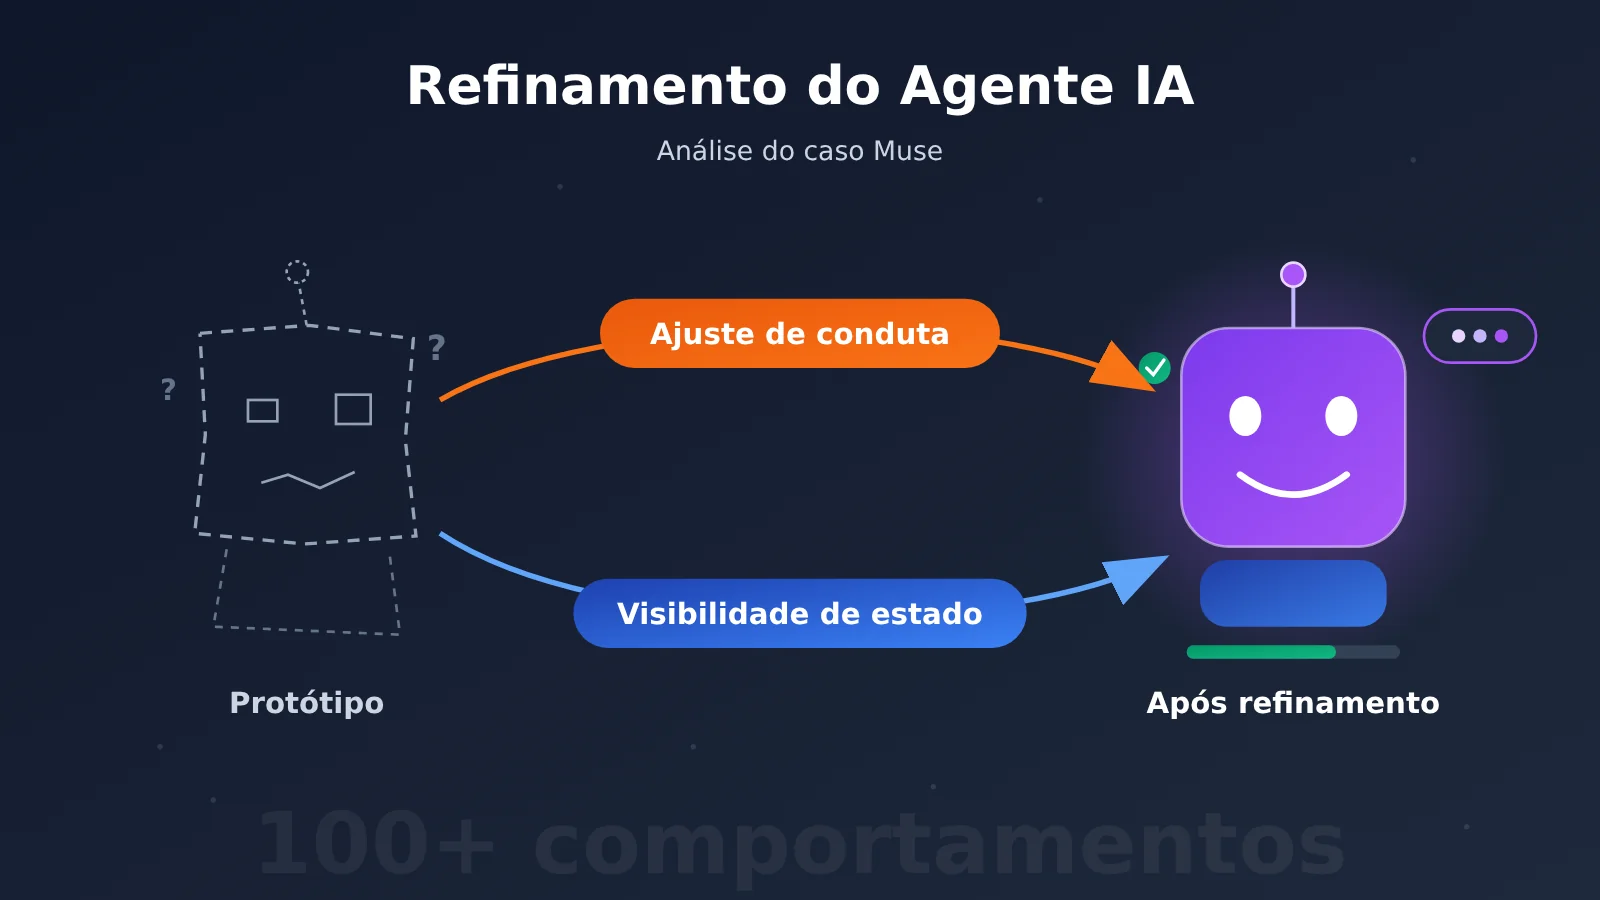
Este não é mais um texto vago sobre “os detalhes fazem a diferença”. Segundo relatos públicos, antes do lançamento a equipe do Muse testou e ajustou mais de cem comportamentos específicos do modelo e fez com que o avatar mostrasse, por meio de expressões e movimentos, o que o agente estava fazendo naquele momento. As duas coisas podem ser decompostas em tarefas de engenharia concretas.
Valor central: depois de ler este artigo, você conseguirá transformar o “refinamento” em uma lista de comportamentos, uma tabela de sinais de estado e um processo de testes, e aplicar tudo diretamente no seu produto de agente.
O contexto do refinamento de agentes de IA: por que o Muse merece ser destrinchado
Primeiro, o contexto do caso. Segundo relatos, o Reality Labs — departamento da Meta responsável por VR/AR — perdeu cerca de 19,2 bilhões de dólares só em 2025, e a aposta no metaverso é vista de fora como um fracasso de custo altíssimo. Depois disso, Zuckerberg não recuou para o negócio principal de publicidade: seguiu investindo na direção de agentes de IA. Cerca de seis semanas após o lançamento, o Muse já contava, segundo relatos, com 10 milhões de usuários.
Há dois detalhes desse projeto diretamente ligados a “refinamento”. Primeiro, a equipe é liderada por Alexander Wang e Nat Friedman, vindos da Scale AI; segundo o próprio Wang, as duas frentes — modelo e produto — somam menos de 200 pessoas. A equipe pequena é intencional: a ideia é evitar os acordos e a inconsistência de experiência que aparecem quando equipes grandes decidem por consenso. Segundo, o Muse não foi posicionado como “o modelo mais inteligente do mercado”. A vantagem dele está em encurtar a distância entre “o que o modelo tecnicamente consegue fazer” e “como uma pessoa comum realmente se sente ao usar” — em tarefas do dia a dia, como cancelar assinaturas e acompanhar cobranças.
Para quem desenvolve, a receita e a escala do Muse servem pouco como referência. O que vale como referência é a forma como ele entende “refinamento”: refinamento é um conjunto de comportamentos concretos que dá para testar, não uma expressão de marketing.
Principais pontos para aprimorar agentes de IA
De forma geral, o que o Muse faz pode ser resumido nestas direções para o refinamento de agentes de IA:
| Ponto | Descrição | Benefício para o usuário |
|---|---|---|
| Ajuste de comportamento | Testar e ajustar item por item o comportamento específico do modelo antes do lançamento (mais de cem itens no Muse) | As reações do agente são previsíveis e não variam sem motivo |
| Limites de decisão | Definir claramente quando ele executa sozinho e quando pergunta ao usuário antes | Menos interrupções, sem extrapolar permissões |
| Visibilidade do estado | Mostrar com sinais visuais ou textuais o que o agente está fazendo | O usuário não precisa adivinhar “se ele entendeu e se está trabalhando” |
| Consistência da experiência | Manter o comportamento consistente em diferentes entradas e páginas | Pequenos atritos não se acumulam em um custo de uso perceptível |
| Cenários de borda | Tratar com cuidado erros, interrupções e a segunda e a terceira abas | Continua fluido no uso diário e repetido |
Primeiro ponto do refinamento de agentes de IA: ajuste de comportamento não é o mesmo que “modelo mais inteligente”
“O modelo é muito inteligente” e “o agente é fácil de usar” são coisas diferentes. Um modelo muito capaz, se não souber quando parar para confirmar, quando pode agir diretamente e como reportar o progresso, ainda pode ser irritante de usar. As mais de cem ações ajustadas pela equipe do Muse são basicamente essas.
O objeto do ajuste de comportamento é a forma de reagir em cada cenário, não os parâmetros do modelo. Por exemplo, se o usuário diz “cancele aquela assinatura para mim”, o agente deve primeiro listar as assinaturas que encontrou e pedir confirmação ao usuário, ou executar diretamente? Ao chegar à página de pagamento, deve confirmar mais uma vez? Cada ponto de decisão como esse é um comportamento que precisa ser testado e estabelecido.
Segundo ponto do refinamento de agentes de IA: visibilidade do estado é trabalho de design
O avatar do Muse mostra por meio de pequenas animações que está “fazendo” o trabalho atual, e o usuário não precisa ler mensagens de status técnicas. Isso responde à dúvida que toda pessoa que delega uma tarefa à IA tem: ele entendeu o que eu quis dizer? Ele está realmente trabalhando?
Eliminar essa sensação de incerteza é trabalho de design, e precisa cobrir cada canto do produto, não apenas o fluxo de demonstração. Segundo relatos, antes de lançar o aplicativo de celular, a Meta já havia desenvolvido tecnologia de geração de expressões faciais e movimentos sincronizados com a voz, preparando-se para experiências de voz em tempo real e para futuros dispositivos vestíveis. A maioria das empresas deixa essa camada para “depois de validar a ideia central”, mas o Muse fez isso antes.
Início rápido para aprimorar agentes de IA: 6 passos práticos
A seguir, reescrevo a abordagem do Muse como um processo que equipes de pequeno e médio porte também conseguem executar. Não é preciso ter centenas de pessoas nem um orçamento de centenas de bilhões — o que é necessário é a paciência de refazer a “segunda, terceira rodada” continuamente.
Passo 1: Criar uma lista de comportamentos do agente de IA
Primeiro, liste os pontos de decisão que o agente vai encontrar em tarefas reais, e para cada item deixe claro “condição de disparo, comportamento esperado, contraexemplo”. Para começar, de 30 a 50 itens já bastam; depois vá complementando conforme o feedback dos testes. Segue uma referência de categorias:
| Categoria de comportamento | Ponto de decisão típico | Critério de aprimoramento |
|---|---|---|
| Confirmação de intenção | Instrução ambígua, como “cancele aquela assinatura” | Quando houver vários candidatos, liste-os para o usuário escolher, não tente adivinhar |
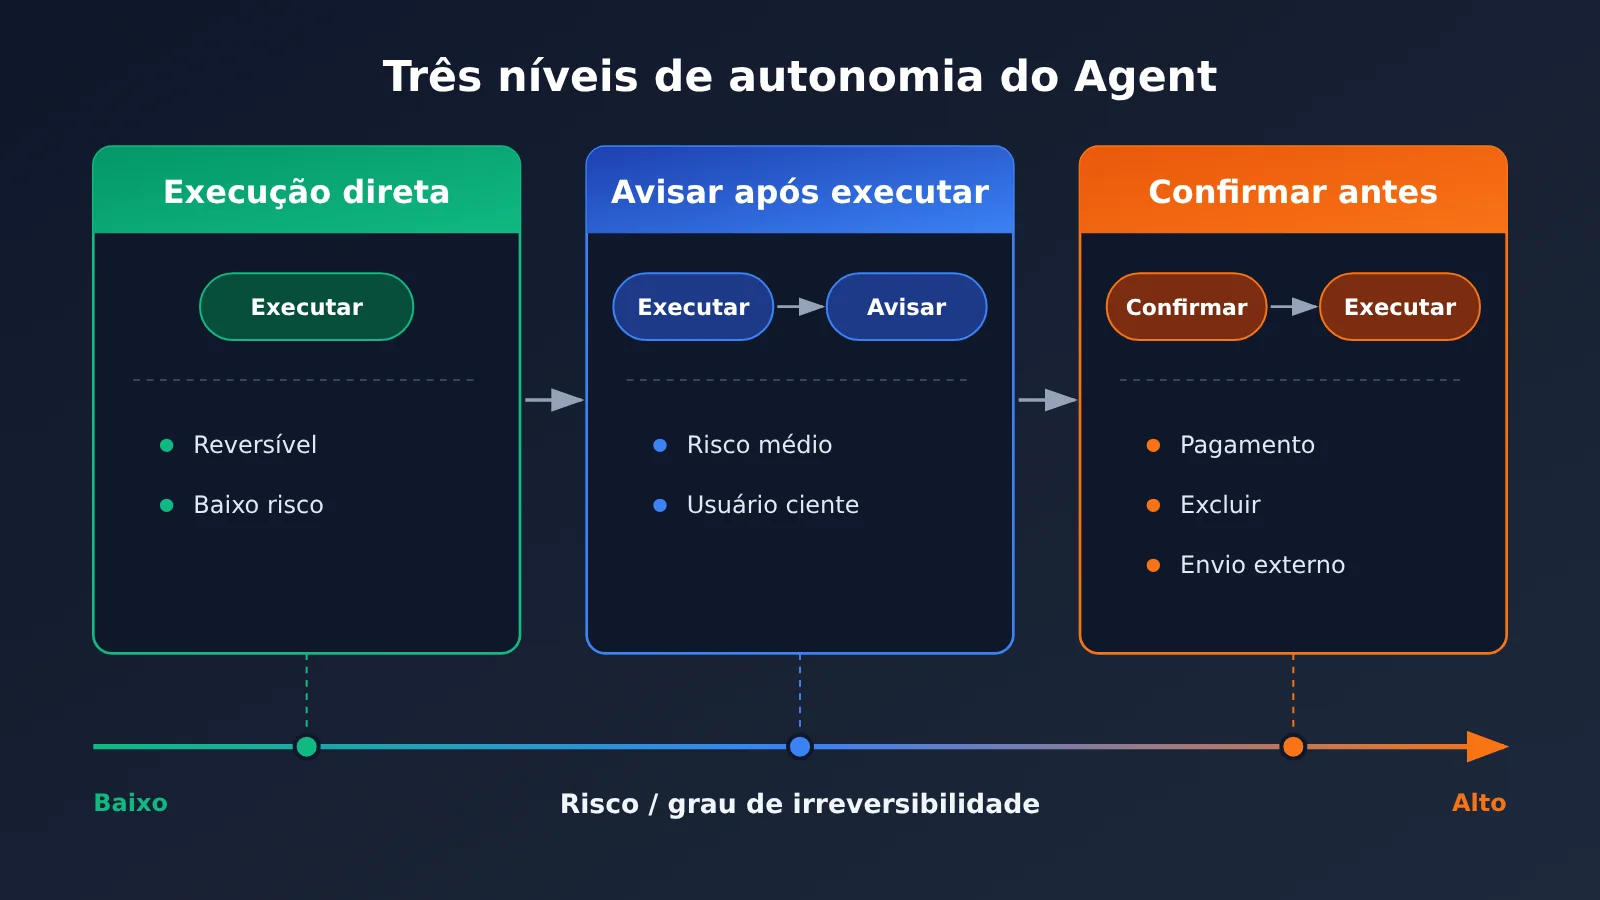
| Execução autônoma | Operações de baixo risco e reversíveis | Execute diretamente e faça um breve relato ao concluir |
| Bloqueio de alto risco | Envolve pagamento, exclusão, envio externo | Exige confirmação em duas etapas e explica as consequências |
| Relato de progresso | Tarefas com várias etapas e demoradas | Dê feedback visível em cada etapa-chave |
| Tratamento de falhas | Site não abre, permissões insuficientes | Explique o motivo e sugira o próximo passo, não falhe silenciosamente |
| Encerramento da tarefa | Tarefa concluída | Dê um sinal claro de “concluído” e um resumo do resultado |
Passo 2: delimitar a fronteira entre autonomia e confirmação do agente de IA
Depois de montar a lista, é preciso definir um “nível de autonomia” para cada tipo de operação. A divisão mais comum tem três faixas: executar direto, executar e avisar depois, e confirmar antes de executar. A decisão se baseia principalmente em dois pontos: a operação pode ser desfeita? Qual o custo de uma falha?
É nesta etapa que as divergências internas do time mais aparecem. Foi por isso que a Muse apostou em um time pequeno: questões de fronteira exigem alguém responsável pela experiência como um todo, com poder de decisão — não dá para cada módulo decidir isoladamente com base no que é “localmente razoável”. Caso contrário, a mesma operação exige confirmação na página A e é executada direto na página B.
Passo 3: mapear os estados internos do agente de IA para sinais visíveis ao usuário
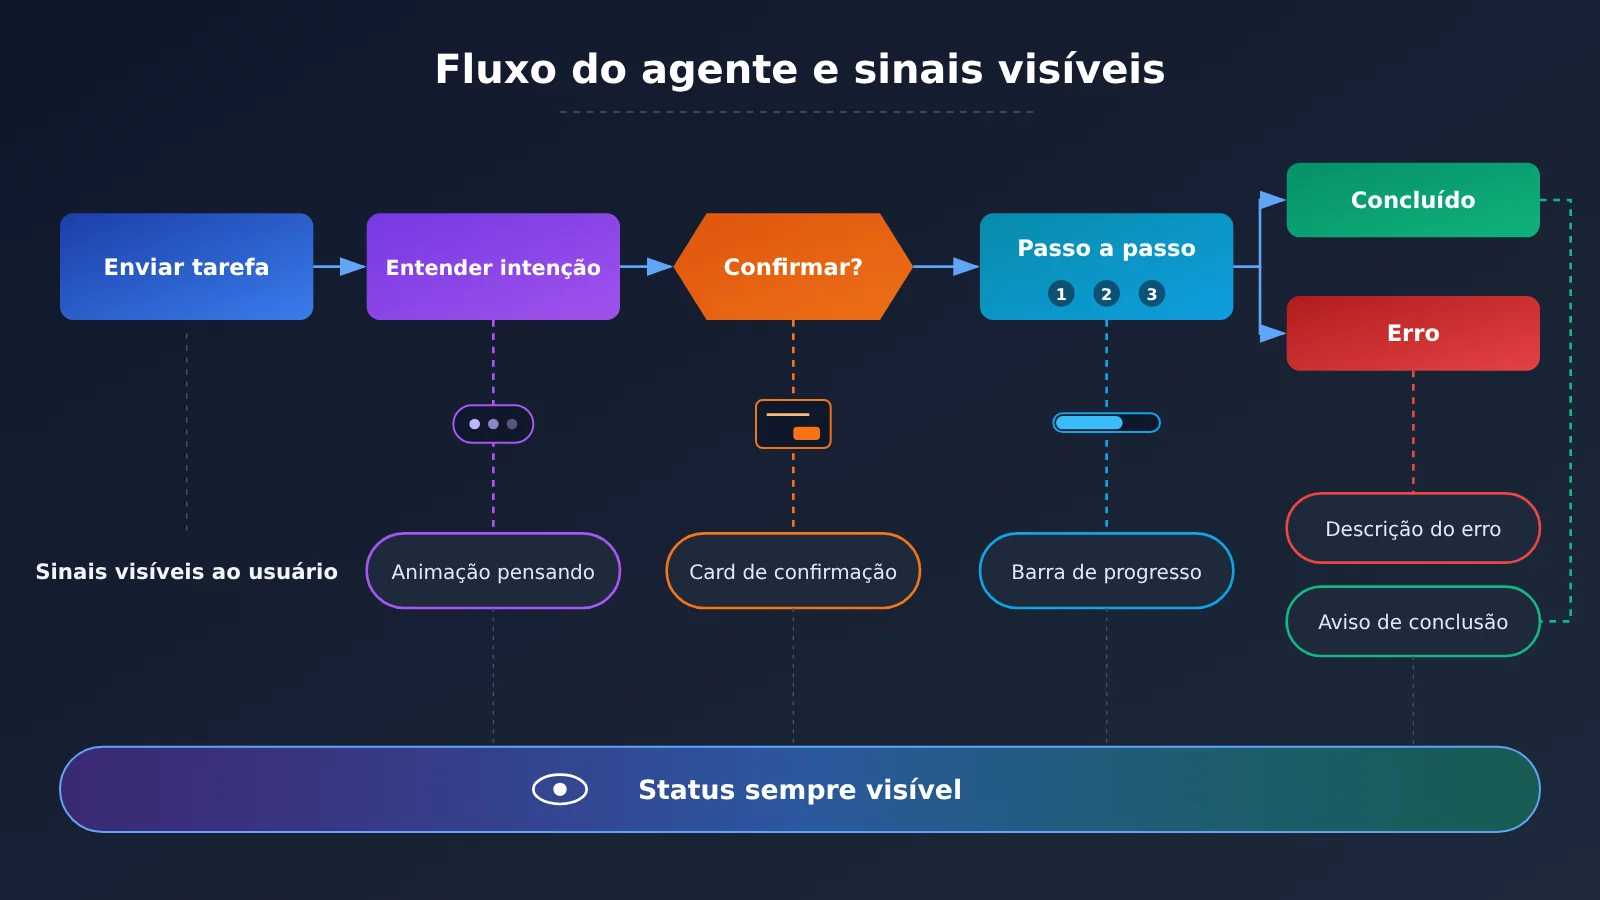
O agente tem muitos estados internos, mas o usuário só se importa com alguns poucos. Na prática, o caminho é agrupar os estados internos em 5 ou 6 estados que o usuário consiga entender e, para cada um, definir um sinal fixo:
| Estado interno do agente | Sinal visível ao usuário | Contraexemplo comum |
|---|---|---|
| Interpretando a intenção / planejando | Animação de “pensando” ou “entendendo sua necessidade” | Tela branca por alguns segundos, e o usuário acha que travou |
| Chamando ferramentas / acessando serviços externos | Mostrar o nome da etapa atual, como “abrindo a página de assinatura” | Exibir diretamente o nome bruto da ferramenta ou o JSON |
| Aguardando confirmação do usuário | Destacar o cartão de confirmação, deixando claro o que vai acontecer | Esconder a pergunta de confirmação no meio de uma resposta longa |
| Em execução (várias etapas) | Progresso por etapa, marcando o que já foi concluído e o que está em andamento | Apenas um ícone girando |
| Concluído | Marca clara de conclusão e resumo do resultado | A resposta termina, mas não diz se a tarefa foi concluída |
| Erro / interrupção | Explicar o motivo em linguagem comum e as ações possíveis | Erro técnico, ou simplesmente nenhum feedback |
Do ponto de vista de implementação, dá para usar a saída em streaming da interface do modelo para alimentar esses sinais. No formato compatível com OpenAI, ao ativar stream, o conteúdo e as chamadas de ferramenta são retornados em partes; nos eventos de streaming do formato Anthropic Messages, os blocos de texto e os blocos tool_use vêm separados. Basta o front-end escutar esses eventos e alternar para o estado visível correspondente — não é preciso esperar a resposta inteira terminar.
Etapa 4: Projetar o conjunto de testes de comportamento do agente de IA
Cada comportamento precisa ter casos de teste correspondentes, cobrindo pelo menos três situações: “entrada normal, entrada ambígua, ambiente anômalo”. Durante os testes, não basta verificar se a resposta está correta; é preciso observar também:
- Se os pontos que exigem confirmação foram confirmados e se os locais que não deveriam incomodar não receberam perguntas desnecessárias;
- Se os sinais de status apareceram no momento certo em cada fase;
- Se o comportamento é consistente ao iniciar a mesma tarefa por entradas diferentes;
- Se, após um erro, o usuário consegue entender o que aconteceu e sabe qual é o próximo passo.
Recomenda-se fixar o conjunto de testes e executá-lo por completo sempre que alterar o comando, trocar o modelo ou ajustar ferramentas, para evitar consertar um item e quebrar três.
Etapa 5: Fazer comparação entre diferentes modelos base de agente de IA
O Muse deixa claro um ponto: o valor da camada de refinamento não depende do “modelo mais forte”. A mesma lista de comportamentos apresenta diferenças entre modelos, portanto é preciso fazer uma comparação horizontal para encontrar a combinação que atende aos critérios de comportamento com custo adequado.
| Etapa de refinamento | Principais requisitos para o modelo | Raciocínio de seleção | Plataformas disponíveis |
|---|---|---|---|
| Análise e planejamento de intenção | Raciocínio estável, segue instruções | Priorizar modelos de ponta ou de raciocínio | APIYI apiyi.com, API oficial |
| Execução de chamadas de ferramentas | Formato de chamada de função estável | Escolher modelos com desempenho confiável em chamadas de ferramentas | APIYI apiyi.com, API oficial |
| Textos de progresso / anúncio de status | Resposta rápida, baixo custo | Escolher modelos leves e rápidos | APIYI apiyi.com, API oficial |
| Avaliação em lote do conjunto de testes | Grande volume, reproduzível | Escolher modelos com bom custo-benefício para revisão | APIYI apiyi.com, API oficial |
🎯 Sugestão técnica: Ao fazer comparação entre múltiplos modelos, é possível usar a APIYI apiyi.com para chamadas unificadas. A APIYI oferece as APIs dos principais Modelos de Linguagem Grande abordados neste artigo e é compatível com os dois formatos de interface, OpenAI e Anthropic. O mesmo código de agente pode comparar apenas alternando o parâmetro
model, sem precisar escrever uma camada de adaptação para cada fornecedor. A forma de integração e os endereços das interfaces estão no centro de documentação da APIYI: docs.apiyi.com.
Etapa 6: Faça continuamente a “segunda e a terceira passada” na experiência do agente de IA
Há uma metáfora nos materiais de referência: não basta decorar a fachada do restaurante; também é preciso limpar o banheiro. As ferramentas de IA atuais conseguem criar rapidamente uma primeira versão bonita, e isso acaba levando as pessoas a criar sempre uma nova primeira versão, em vez de corrigir aquelas partes do produto atual que “funcionam, mas não são boas de usar”.
Sugiro que, toda semana, você selecione nos registros de uso real trechos em que o usuário hesitou, repetiu a pergunta ou desistiu no meio do caminho, e volte à etapa 1 para complementar o checklist de comportamento. Produtos que as pessoas usam repetidamente são construídos justamente nessas segundas e terceiras passadas, que parecem invisíveis.
💰 Nota de custo: o conjunto de testes de comportamento precisa ser executado repetidamente, e o volume de chamadas não é pequeno. Para preços unitários de entrada e saída de cada modelo e critérios de cobrança de cache, use como referência os dados reais da página de preços da APIYI em https://docs.apiyi.com/models; este artigo não lista preços específicos.
Comparação das abordagens de refinamento do agente de IA
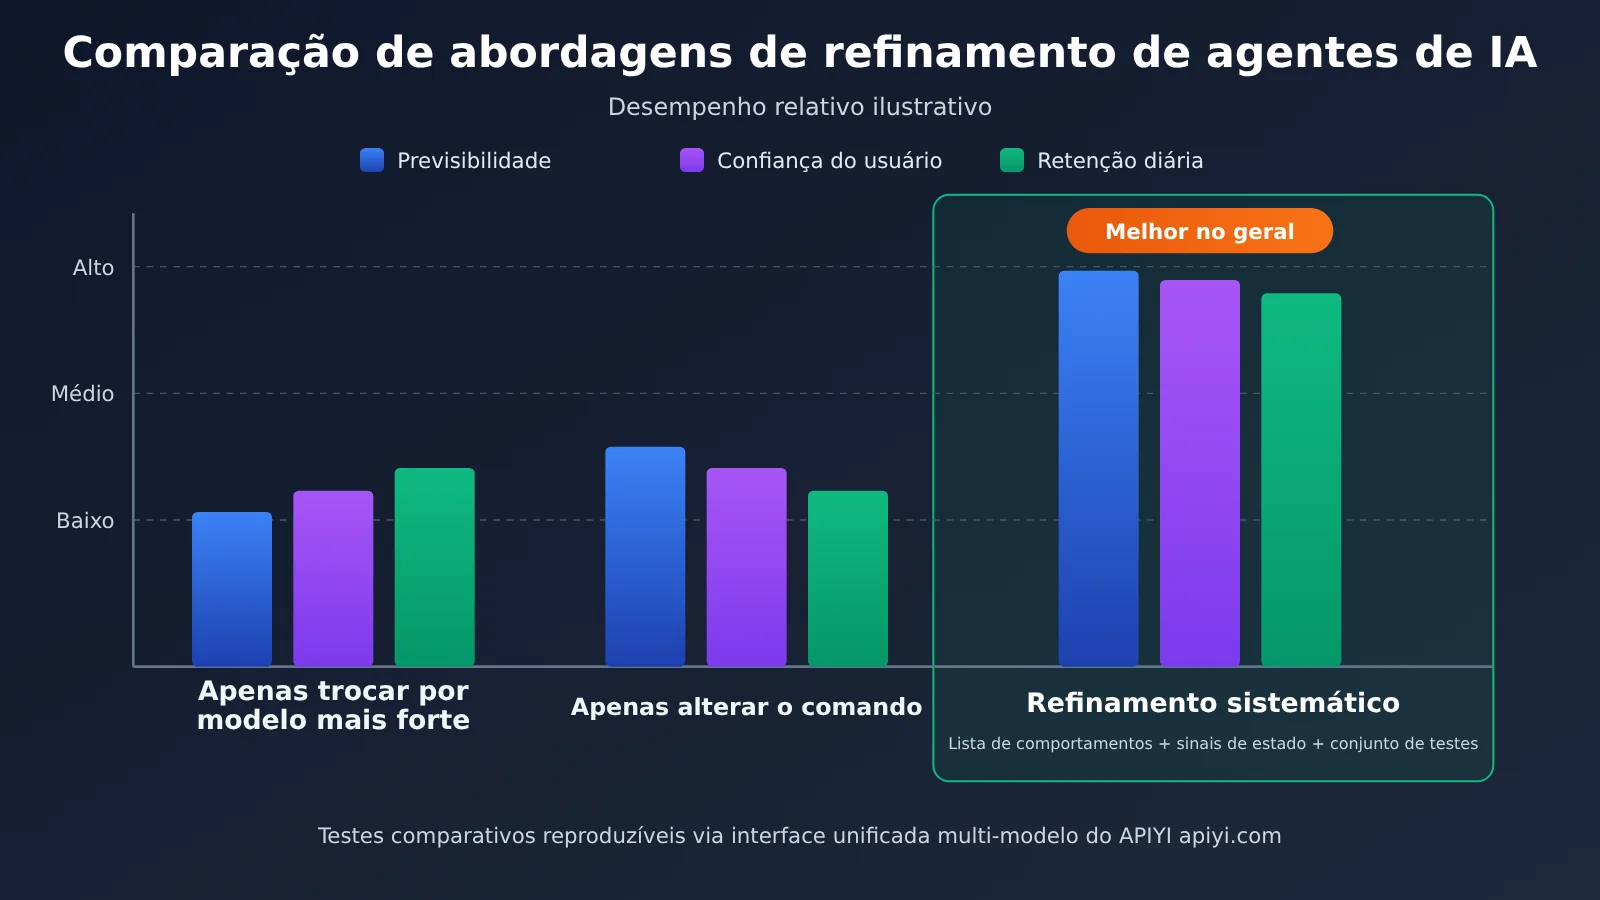
| Abordagem | Prática central | Cenário indicado | Principais limitações |
|---|---|---|---|
| Apenas trocar por um modelo mais forte | Atualizar o modelo base esperando que a experiência melhore naturalmente | Protótipos iniciais com capacidade claramente insuficiente | Custo maior; problemas de comportamento, como confirmação e reporte de progresso, continuam existindo |
| Apenas alterar o comando | Acumular regras no comando de sistema | Corrigir pontualmente problemas isolados | Quanto mais regras se acumulam, mais confuso fica; sem testes, elas tendem a conflitar |
| Refinamento sistêmico | Checklist de comportamento + limites de autonomia + sinais de estado + conjunto de testes | Agentes de tarefas cotidianas voltados a usuários reais | Investimento inicial alto; é preciso alguém dedicado a responder pela experiência como um todo |
Leitura comparativa das abordagens de refinamento do agente de IA
Análise comparativa de apenas trocar o modelo: modelos mais fortes de fato são superiores em raciocínio complexo, mas não sabem por conta própria quais operações do seu produto precisam de confirmação prévia nem como o progresso deve ser exibido. Em contrapartida, o refinamento sistêmico trata diretamente do atrito sentido pelo usuário; o Muse, mesmo sem depender do modelo mais forte, também conquistou um bom crescimento inicial — e isso é um exemplo disso.
Análise comparativa de apenas alterar o comando: ajustar o comando dá resultado rápido e serve para resolver problemas pontuais. Porém, sem checklist de comportamento e conjunto de testes, as regras tendem a entrar em conflito; conserta-se uma coisa e afeta-se outra. Para agentes que precisam ser operados por muito tempo, o refinamento sistêmico é mais confiável.
💡 Nota comparativa: recomenda-se validar as diferenças entre as abordagens acima com os dados do seu próprio negócio. É possível rodar uma comparação com o mesmo conjunto de testes em vários modelos pela APIYI apiyi.com e, depois, avaliar o custo-benefício com os dados da página de preços.
Perguntas frequentes sobre refinamento de agentes de IA
Q1: O que significa, na prática, refinar um agente de IA?
Refere-se a testar, ajustar e fixar, item por item, o comportamento do agente em tarefas reais — incluindo quando ele pede confirmação, quando executa de forma autônoma, como informa o progresso e como se explica depois de um erro —, além de permitir que o usuário veja o estado atual do agente a qualquer momento. É um trabalho de engenharia testável, não uma “otimização genérica de experiência”.
Q2: Qual é a diferença entre ajuste de comportamento e engenharia de comandos?
A engenharia de comandos é uma das técnicas; o ajuste de comportamento é o objetivo e a metodologia. O ajuste de comportamento começa definindo uma “lista de comportamentos esperados” e um conjunto de testes, e depois usa comandos, design de ferramentas, interação de front-end e outras abordagens para implementar tudo isso, com validação de regressão contínua. Alterar apenas os comandos sem criar um conjunto de testes dificilmente garante consistência.
Q3: Qual é o tamanho da base de usuários e da equipe do Muse?
Segundo relatos, o Muse alcançou 10 milhões de usuários cerca de seis semanas após o lançamento. De acordo com Alexander Wang, as equipes de modelo e de produto somam menos de 200 pessoas no total. Para a escala habitual da Meta, de bilhões de usuários, trata-se apenas de um resultado inicial; mais adiante ainda será preciso reduzir o custo do serviço e ampliar a escala.
Q4: Em quais cenários de agentes a visibilidade de status é mais adequada?
Ela é adequada principalmente aos seguintes cenários:
– **Tarefas delegadas**: cancelar assinaturas, acompanhar cobranças, preencher formulários e outras operações de várias etapas;
– **Tarefas demoradas**: que exigem acessar vários sites ou chamar várias ferramentas e levam mais tempo para serem executadas;
– **Operações de alto risco**: que envolvem pagamentos, exclusões ou envios externos e exigem confirmação explícita do usuário.
Q5: Como montar rapidamente um ambiente de teste de refinamento de agentes com vários modelos?
Você pode seguir os passos abaixo:
1. Cadastre-se no APIYI (apiyi.com) e obtenha uma chave API;
2. Consulte a central de documentação docs.apiyi.com e integre usando o formato compatível com OpenAI ou Anthropic;
3. Com o mesmo conjunto de testes de comportamento, alterne o parâmetro `model` e execute as comparações em sequência;
4. Combine com os dados reais de cobrança da página de preços https://docs.apiyi.com/models para escolher a combinação de modelos adequada.
Q6: Quais são os custos e as limitações de um refinamento sistemático?
– **Investimento inicial**: a construção da lista de comportamentos e do conjunto de testes leva tempo, e no curto prazo não se vê um “novo recurso”;
– **Custo de chamadas**: os testes de regressão chamam o modelo repetidamente, e a cobrança segue a página de preços da plataforma utilizada;
– **Exigência organizacional**: é preciso haver alguém com poder de decisão sobre a experiência como um todo; caso contrário, as regras de limite ficarão inconsistentes por causa de concessões de diferentes áreas;
– **Limitação**: o refinamento não cobre lacunas estruturais na capacidade do modelo; quando a capacidade é claramente insuficiente, ainda é necessário trocar de modelo.
Principais aprendizados sobre o refinamento de agentes de IA
- O refinamento pode ser testado: antes do lançamento, o Muse ajustou mais de cem comportamentos específicos do modelo;
- Útil não é o mesmo que mais inteligente: a vantagem do Muse está em reduzir o atrito de uso, não em ter a maior capacidade de modelo;
- Os limites precisam de alguém para bater o martelo: as regras de execução autônoma e confirmação prévia precisam ser unificadas, não decididas por cada módulo;
- O estado precisa ser visível: use sinais para responder ao usuário “ele entendeu?”, “está fazendo?” e “terminou?”;
- Casos de borda também importam: erros, interrupções, a segunda aba e o fluxo de demonstração devem receber o mesmo tratamento;
- Comparar vários modelos é mais confiável: é possível usar a interface unificada da APIYI para comparar modelos diferentes com o mesmo conjunto de testes.
Resumo
Os principais pontos do refinamento de agentes de IA:
- Ajuste de comportamento: organizar os pontos de decisão em uma lista de verificação; para cada item, descrever a condição de gatilho, o comportamento esperado e um contraexemplo; e fazer regressão contínua com um conjunto de testes;
- Visibilidade de estado: consolidar os estados internos em poucos sinais que o usuário consiga entender, cobrindo todo o fluxo de compreensão, execução, confirmação, conclusão e erro;
- Iteração contínua: encontrar pontos de atrito em registros de uso reais e insistir em fazer a segunda e a terceira versão, em vez de ficar refazendo a primeira.
As lições do Muse também se aplicam a equipes pequenas e médias: a equipe pequena fica responsável pelas decisões críticas, leva a sério os detalhes chatos e, depois de falhar, muda o que realmente importa e tenta de novo. Nada disso exige perder mais de dez bilhões antes.
Se você está montando um conjunto de testes de comportamento para o seu agente, pode usar APIYI apiyi.com para fazer comparações rápidas em vários modelos. A plataforma é compatível com os formatos de API da OpenAI e da Anthropic; as instruções de integração estão em docs.apiyi.com, e a cobrança segue a página de preços https://docs.apiyi.com/models.
📚 Referências
- MindStudio – Estudo de caso do Muse da Meta: contexto, equipe e detalhes do refinamento do Muse
- Link:
mindstudio.ai/blog/meta-muse-ai-companion-lessons -
Descrição: principal fonte dos fatos deste estudo de caso, publicado em 4 de novembro de 2026
-
Central de documentação do APIYI: instruções de integração unificada de múltiplos modelos
- Link:
docs.apiyi.com -
Descrição: formas de integração nos formatos compatíveis com OpenAI e Anthropic
-
Página de preços de modelos do APIYI: critérios de cobrança e preço unitário de cada modelo
- Link:
docs.apiyi.com/models - Descrição: os preços unitários de entrada e saída, assim como os preços de cache, seguem os dados reais exibidos nesta página
Autor: equipe técnica do APIYI
Contato técnico: fale com a gente pelo site oficial do APIYI, apiyi.com, para trocar ideias sobre práticas de refinamento de agentes; mais materiais estão disponíveis na central de documentação em docs.apiyi.com