Nota del autor: con Muse, de Meta, como caso práctico, explicamos qué se debe pulir concretamente en un agente de IA, con especial atención al ajuste del comportamiento y a la visibilidad del estado, y ofrecemos pasos que se pueden seguir al pie de la letra.
A muchos equipos que desarrollan agentes de IA les ocurre lo mismo: la capacidad del modelo ya es suficiente, las demostraciones salen bien, pero los usuarios se van después de usarlo unos días. El problema no suele estar en el modelo, sino en que no se han pulido bien estas dos capas: ajuste del comportamiento y visibilidad del estado. En este artículo usamos Muse, de Meta, como caso para desglosar qué se está puliendo realmente cuando se pule un agente de IA.
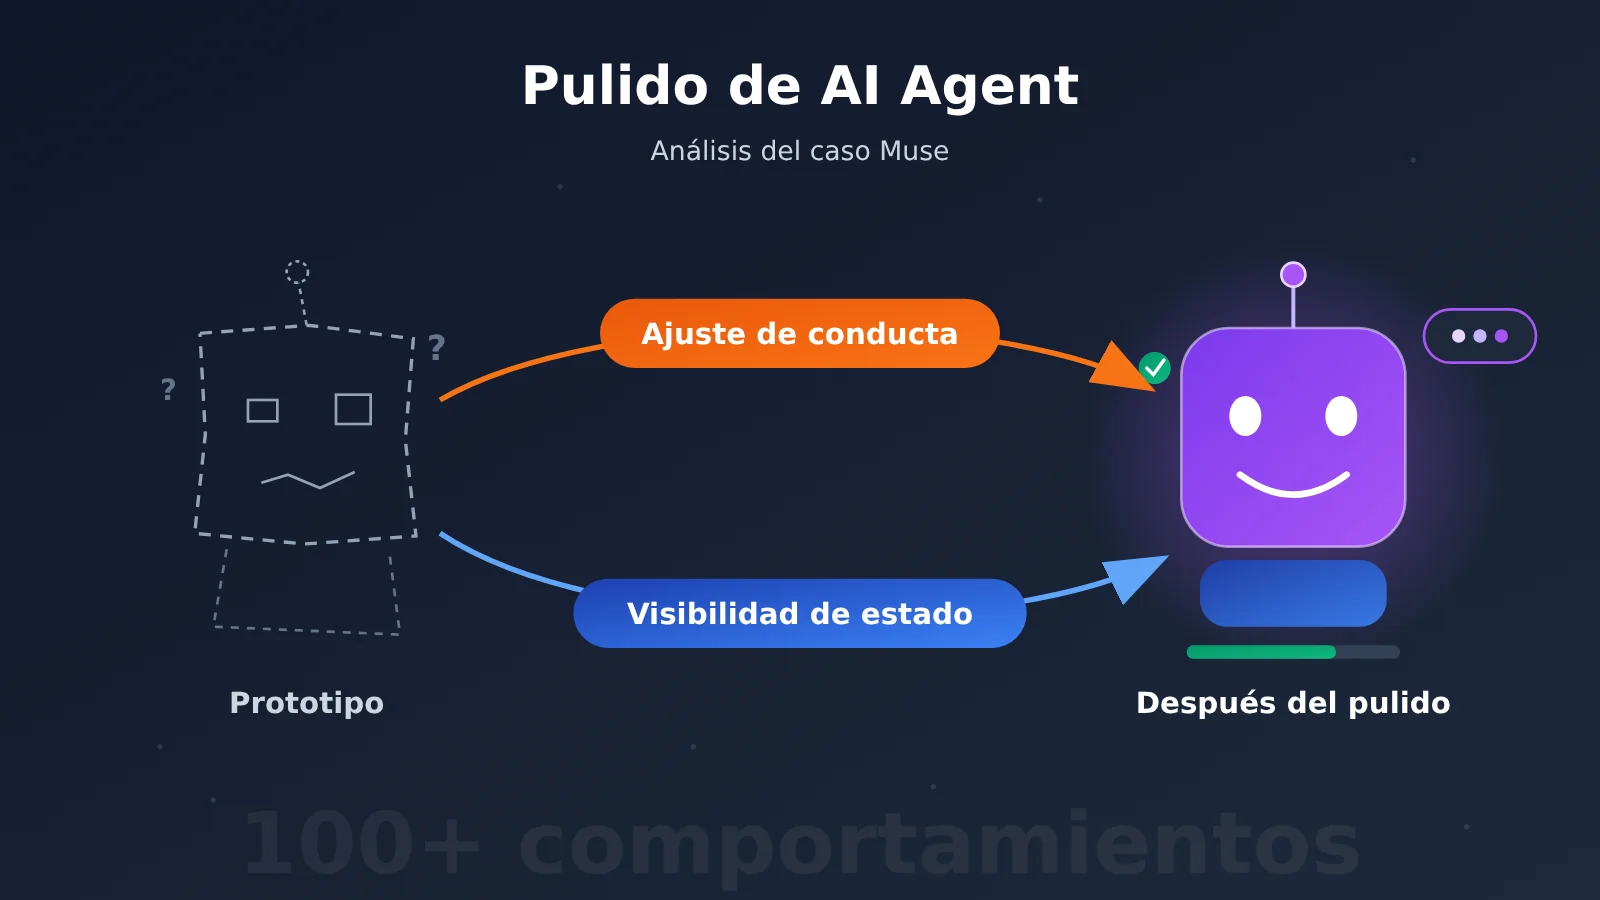
No es otro artículo con reflexiones vagas del tipo “los detalles marcan la diferencia”. Según informes públicos, el equipo de Muse probó y ajustó más de cien comportamientos concretos del modelo antes del lanzamiento, e hizo que el avatar mostrara directamente, mediante expresiones y movimientos, qué estaba haciendo el agente en cada momento. Ambas cosas se pueden descomponer en tareas de ingeniería concretas.
Valor central: al terminar de leer, podrás convertir “pulir” en una lista de comportamientos, una tabla de señales de estado y un proceso de pruebas, y aplicarlo directamente en tu propio producto de agentes.
Contexto del pulido de agentes de IA: por qué vale la pena analizar Muse
Primero, pongamos en contexto el caso. Según se ha informado, Reality Labs —la división de Meta responsable de VR/AR— perdió cerca de 19.200 millones de dólares solo en 2025, y la apuesta por el metaverso se percibe básicamente como un fracaso muy costoso. Después, Zuckerberg no se replegó a su negocio principal de publicidad, sino que siguió invirtiendo en la dirección de los agentes de IA. Unas seis semanas después del lanzamiento de Muse, se informó que ya había alcanzado los 10 millones de usuarios.
Hay dos detalles del proyecto directamente relacionados con el «pulido». El primero: el equipo está liderado por Alexander Wang y Nat Friedman, de Scale AI y, según el propio Wang, entre las líneas de modelo y producto suman menos de 200 personas. El equipo pequeño es intencional; busca evitar los compromisos y la inconsistencia de experiencia que aparecen cuando los equipos grandes toman decisiones por consenso. El segundo: Muse no se posicionó como «el modelo más inteligente del mercado»; su ventaja está en cerrar la brecha entre «lo que el modelo puede hacer técnicamente» y «cómo lo siente realmente una persona común al usarlo», por ejemplo en tareas cotidianas como cancelar suscripciones o hacer seguimiento de facturas.
Para los desarrolladores, los ingresos y la escala de Muse no aportan mucho como referencia. Lo que sí vale la pena tomar como referencia es su forma de entender el «pulido»: el pulido es un conjunto de comportamientos concretos que se pueden probar, no una frase de marketing.
Puntos clave para pulir un agente de IA
Si abstraemos lo que hace Muse, el pulido de un agente de IA se puede agrupar en las siguientes direcciones:
| Aspecto | Descripción | Beneficio para el usuario |
|---|---|---|
| Ajuste de comportamiento | Probar y ajustar cada comportamiento concreto del modelo antes del lanzamiento (Muse: más de cien) | Las respuestas del agente son predecibles, no van bien un día y mal otro |
| Límites de decisión | Definir en qué situaciones actúa por su cuenta y en cuáles pregunta primero al usuario | Menos interrupciones y sin salirse de sus límites |
| Visibilidad del estado | Mostrar con señales visuales o de texto qué está haciendo el agente | El usuario no tiene que adivinar “¿lo entendió?, ¿está trabajando?” |
| Consistencia de la experiencia | Mantener el mismo comportamiento en distintos accesos y páginas | Las pequeñas fricciones no se acumulan hasta convertirse en un costo de uso evidente |
| Casos límite | Tratar con cuidado los errores, las interrupciones, la segunda y la tercera pestaña | Sigue siendo cómodo en el uso diario repetido |
Punto clave 1 del pulido de un agente de IA: ajustar el comportamiento no equivale a “hacer que el modelo sea más inteligente”
“El modelo es muy inteligente” y “el agente es fácil de usar” son dos cosas distintas. Un modelo muy capaz, si no sabe cuándo detenerse a confirmar, cuándo puede actuar directamente o cómo informar del progreso, sigue resultando irritante de usar. Los más de cien comportamientos que ajusta el equipo de Muse son básicamente estos.
El ajuste de comportamiento se centra en la forma de reaccionar en cada situación, no en los parámetros del modelo. Por ejemplo, si el usuario dice “ayúdame a cancelar esa suscripción”, ¿el agente debería enumerar primero las suscripciones que encontró y pedir confirmación, o ejecutar directamente? Cuando llega a la página de pago, ¿debe confirmar otra vez? Cada uno de estos puntos de decisión es un comportamiento que hay que probar y fijar.
Punto clave 2 del pulido de un agente de IA: la visibilidad del estado es trabajo de diseño
El avatar de Muse muestra mediante pequeñas animaciones que está haciendo el trabajo actual; el usuario no necesita leer mensajes de estado técnicos. Esto responde a la duda que tiene cualquiera que delega una tarea a una IA: ¿ha entendido lo que quiero decir? ¿de verdad lo está haciendo?
Eliminar esa sensación de incertidumbre es trabajo de diseño, y debe cubrir cada rincón del producto, no solo el flujo de la demo. Según se informa, antes de lanzar su aplicación móvil, Meta ya había desarrollado tecnología de generación de expresiones faciales y movimientos sincronizados con la voz, preparándose para experiencias de voz en tiempo real y futuros dispositivos portátiles. La mayoría de las empresas dejan esta capa para “después de validar la idea central”; Muse la hizo antes.
Guía rápida para pulir agentes de IA: 6 pasos prácticos
A continuación reescribimos la propuesta de Muse como un proceso que incluso equipos pequeños y medianos pueden llevar a cabo. No hacen falta cientos de personas ni presupuestos de cientos de miles de millones; lo que sí hace falta es paciencia para seguir haciendo «la segunda pasada, la tercera pasada».
Paso 1: Crear un checklist de comportamiento del agente de IA
Primero, haz una lista de los puntos de decisión que el agente enfrentará en tareas reales, y para cada uno deja claro «la condición que lo dispara, el comportamiento esperado y el contraejemplo». Para empezar, 30 o 50 elementos son suficientes; después los irás ampliando con el feedback de las pruebas. Aquí tienes una referencia por categorías:
| Categoría de comportamiento | Puntos de decisión típicos | Criterio de pulido |
|---|---|---|
| Confirmación de intención | La instrucción es ambigua; por ejemplo, «cancela esa suscripción» | Si hay varios candidatos, muéstralos para que el usuario elija; no adivines |
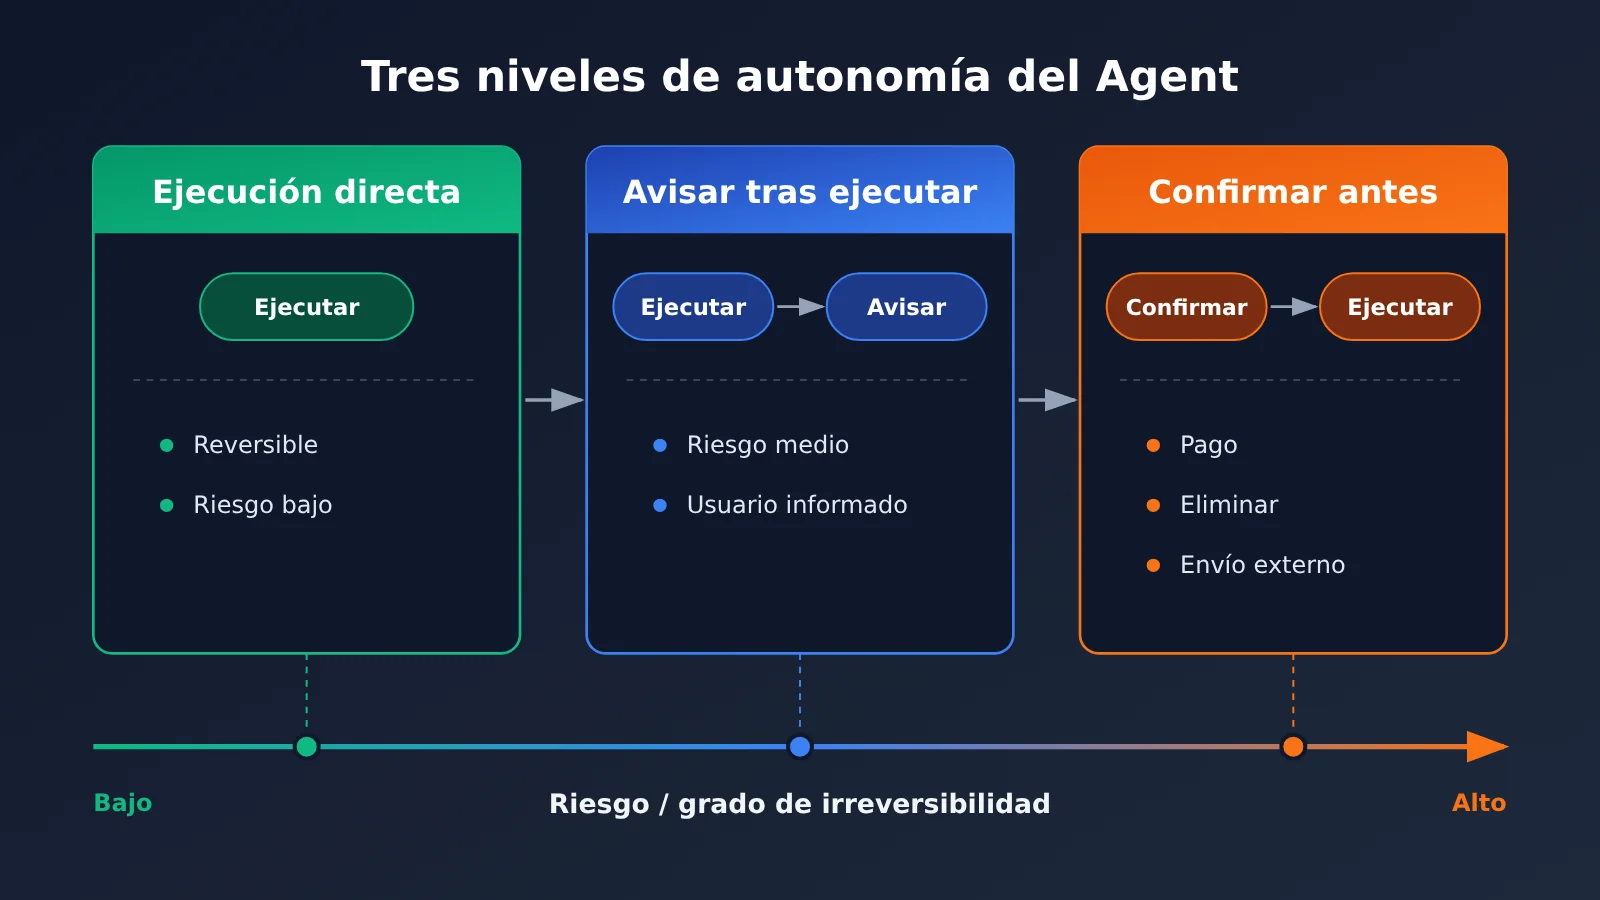
| Ejecución autónoma | Operaciones de bajo riesgo y reversibles | Ejecuta directamente y, al terminar, da un resumen breve |
| Bloqueo de alto riesgo | Implica pagos, eliminación o envíos externos | Requiere confirmación doble y explica las consecuencias |
| Reporte de progreso | Tareas de varios pasos y larga duración | Ofrece feedback visible en cada paso clave |
| Gestión de fallos | El sitio web no carga, permisos insuficientes | Explica la causa y sugiere el siguiente paso; no falles en silencio |
| Cierre de la tarea | Tarea completada | Da una señal clara de «completado» y un resumen del resultado |
Paso 2: delimitar la frontera entre autonomía y confirmación del agente de IA
Una vez armada la lista, hay que asignarle a cada tipo de operación un «nivel de autonomía». La clasificación más habitual tiene tres escalones: ejecutar directamente, ejecutar y luego avisar, y confirmar antes de ejecutar. El criterio para decidir se apoya básicamente en dos cosas: si la operación se puede deshacer y cuánto cuesta un fallo.
Este es el paso donde más fácilmente surgen discrepancias dentro del equipo. La razón por la que Muse trabaja con un equipo pequeño es justamente esta: los temas de fronteras necesitan a alguien que responda por la experiencia global y tome la decisión final, y no que cada módulo decida por su cuenta según lo que resulta «razonable en su parcela». De lo contrario, acabas con la misma operación pidiendo confirmación en la página A y ejecutándose directamente en la página B.
Paso 3: mapear el estado interno del agente de IA a señales visibles para el usuario
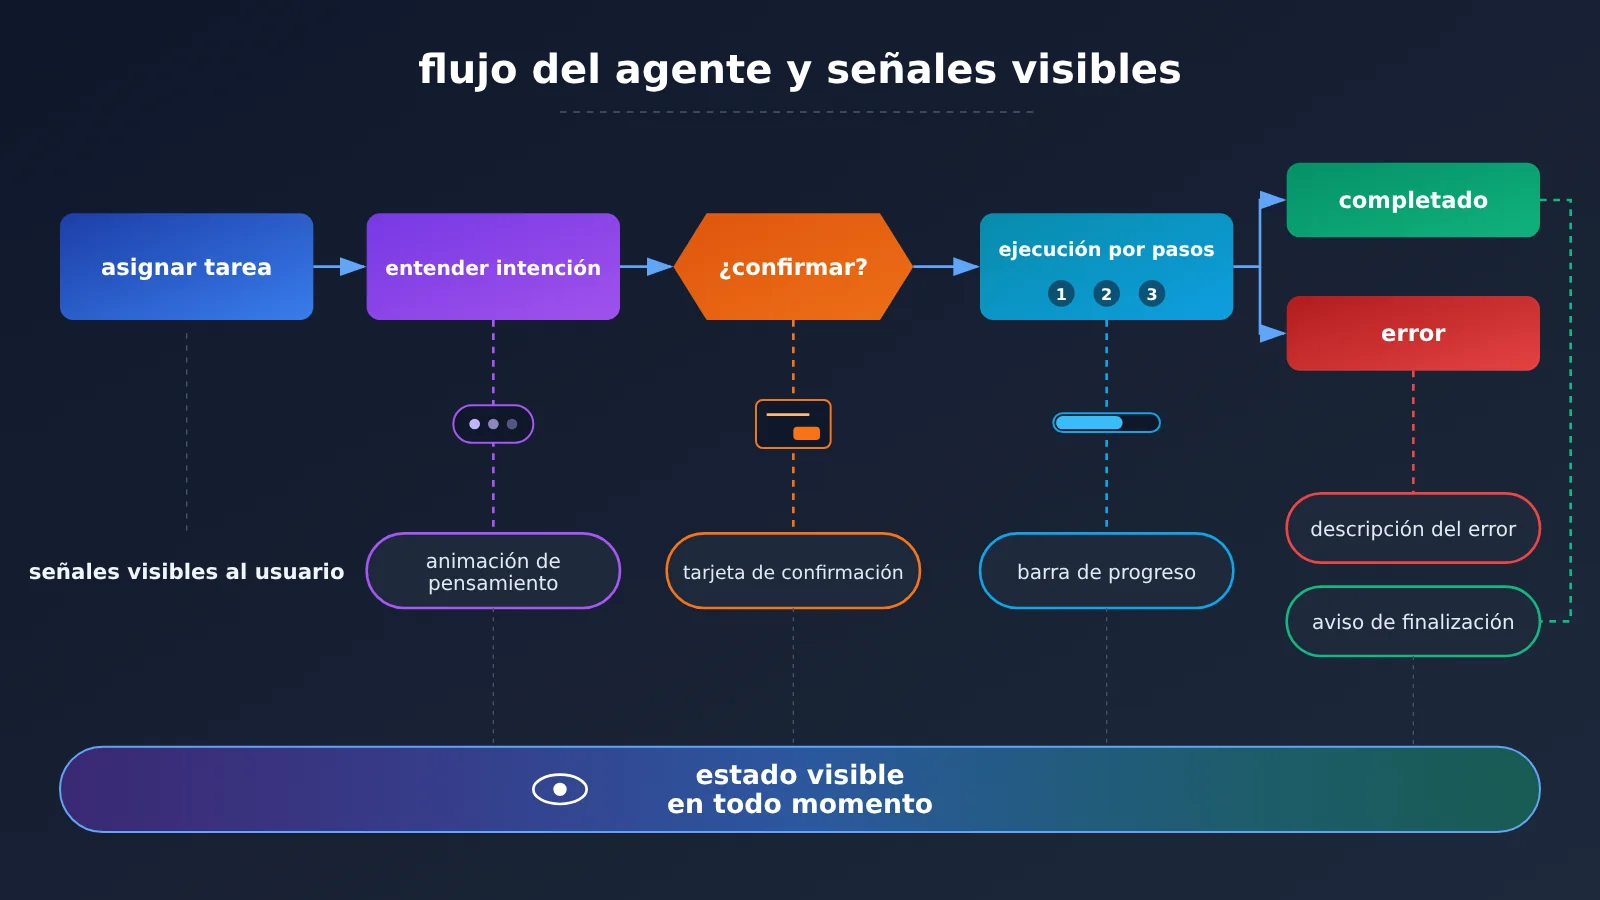
Dentro del agente hay muchísimos estados, pero al usuario solo le importan unos pocos. En la práctica, se trata de agrupar los estados internos en 5 o 6 estados que el usuario pueda entender y, luego, diseñar una señal fija para cada uno:
| Estado interno del agente | Señal visible para el usuario | Contraejemplo habitual |
|---|---|---|
| Analizando la intención / planificando | Animación de pensamiento o «estoy entendiendo lo que necesitas» | Pantalla en blanco durante varios segundos y el usuario cree que se ha colgado |
| Invocando herramientas / accediendo a servicios externos | Mostrar el nombre del paso actual, por ejemplo «abriendo la página de suscripción» | Mostrar directamente el nombre crudo de la herramienta o el JSON |
| Esperando la confirmación del usuario | Resaltar la tarjeta de confirmación e indicar las consecuencias | Esconder la pregunta de confirmación en medio de una respuesta larga |
| En ejecución (varios pasos) | Progreso por pasos, marcando lo completado y lo que está en curso | Un solo icono girando |
| Completado | Marca clara de finalización y resumen del resultado | La respuesta termina, pero no dice si la tarea tuvo éxito |
| Error / interrupción | Explicar el motivo y las acciones disponibles en lenguaje llano | Un error técnico, o directamente ninguna respuesta |
A nivel de ingeniería, se puede aprovechar la salida en streaming de la interfaz del modelo para impulsar estas señales. El formato compatible con OpenAI, al activar stream, devuelve el contenido y las llamadas a herramientas por fragmentos; los eventos de streaming del formato Anthropic Messages distinguen los bloques de texto y los bloques tool_use. El frontend solo tiene que escuchar estos eventos y cambiar al estado visible correspondiente, sin necesidad de esperar a que termine toda la respuesta.
Paso 4: Diseñar un conjunto de pruebas de comportamiento para agentes de IA
Cada comportamiento debe tener su caso de prueba correspondiente y cubrir al menos tres escenarios: entrada normal, entrada ambigua y entorno anómalo. A la hora de probar, no basta con ver si la respuesta es correcta; también hay que observar:
- si se pide confirmación cuando hace falta y si no se molesta al usuario con preguntas innecesarias;
- si las señales de estado aparecen a tiempo en cada etapa;
- si el comportamiento es coherente cuando la misma tarea se inicia desde distintos puntos de entrada;
- si, cuando hay un error, el usuario puede entender qué ha pasado y sabe qué hacer después.
Conviene fijar el conjunto de pruebas y ejecutarlo completo cada vez que se modifique una indicación, se cambie de modelo o se ajuste una herramienta, para no arreglar una cosa y romper tres.
Paso 5: Comparar distintos modelos base para agentes de IA
Muse deja una idea clara: el valor de la capa de refinamiento no depende de tener «el modelo más potente». Una misma lista de comportamientos da resultados distintos según el modelo, así que conviene hacer una comparación cruzada y encontrar la combinación que cumpla los criterios de comportamiento con un coste adecuado.
| Etapa de refinamiento | Requisito principal del modelo | Enfoque de selección | Plataformas disponibles |
|---|---|---|---|
| Análisis de intención y planificación | Razonamiento estable y seguimiento de instrucciones | Priorizar modelos insignia o de razonamiento | APIYI apiyi.com, API oficial |
| Ejecución de llamadas a herramientas | Formato de llamada a funciones estable | Elegir modelos fiables en llamadas a herramientas | APIYI apiyi.com, API oficial |
| Textos de progreso / avisos de estado | Respuesta rápida y bajo coste | Elegir modelos ligeros y rápidos | APIYI apiyi.com, API oficial |
| Evaluación por lotes del conjunto de pruebas | Gran volumen y reproducibilidad | Elegir modelos con buena relación calidad-precio para la evaluación | APIYI apiyi.com, API oficial |
🎯 Consejo técnico: Para comparar varios modelos, puedes usar APIYI apiyi.com como punto de acceso unificado. APIYI ofrece las API de los principales Modelos de Lenguaje Grande que aparecen en este artículo y es compatible tanto con el formato de interfaz de OpenAI como con el de Anthropic. Con el mismo código de agente, basta cambiar el parámetro
modelpara comparar, sin necesidad de escribir una capa de adaptación para cada proveedor. La forma de integración y la dirección de la interfaz se detallan en el centro de documentación de APIYI: docs.apiyi.com.
Paso 6: seguir haciendo una “segunda y tercera pasada” a la experiencia del agente de IA
En los materiales de referencia hay una analogía: no basta con redecorar la fachada del restaurante; también hay que limpiar los baños. Las herramientas de IA actuales pueden crear rápidamente una primera versión bonita, y eso justamente hace que uno tienda a hacer una y otra vez nuevas primeras versiones en lugar de arreglar esas partes del producto actual que “funcionan, pero no se sienten bien”.
Se recomienda que cada semana, a partir de los registros de uso reales, selecciones fragmentos en los que los usuarios dudaron, repitieron preguntas o abandonaron a mitad de camino, y vuelvas al paso 1 para ampliar la lista de comportamientos. Los productos que la gente usa una y otra vez se construyen en esas segundas y terceras pasadas que pasan desapercibidas.
💰 Nota sobre costos: el conjunto de pruebas de comportamiento debe ejecutarse muchas veces, así que el volumen de llamadas no es menor. Para conocer el precio por unidad de entrada y salida de cada modelo, así como los criterios de facturación de caché, consulta los datos reales de la página de precios de APIYI https://docs.apiyi.com/models; este artículo no incluye precios concretos.
Comparativa de enfoques para el pulido de agentes de IA
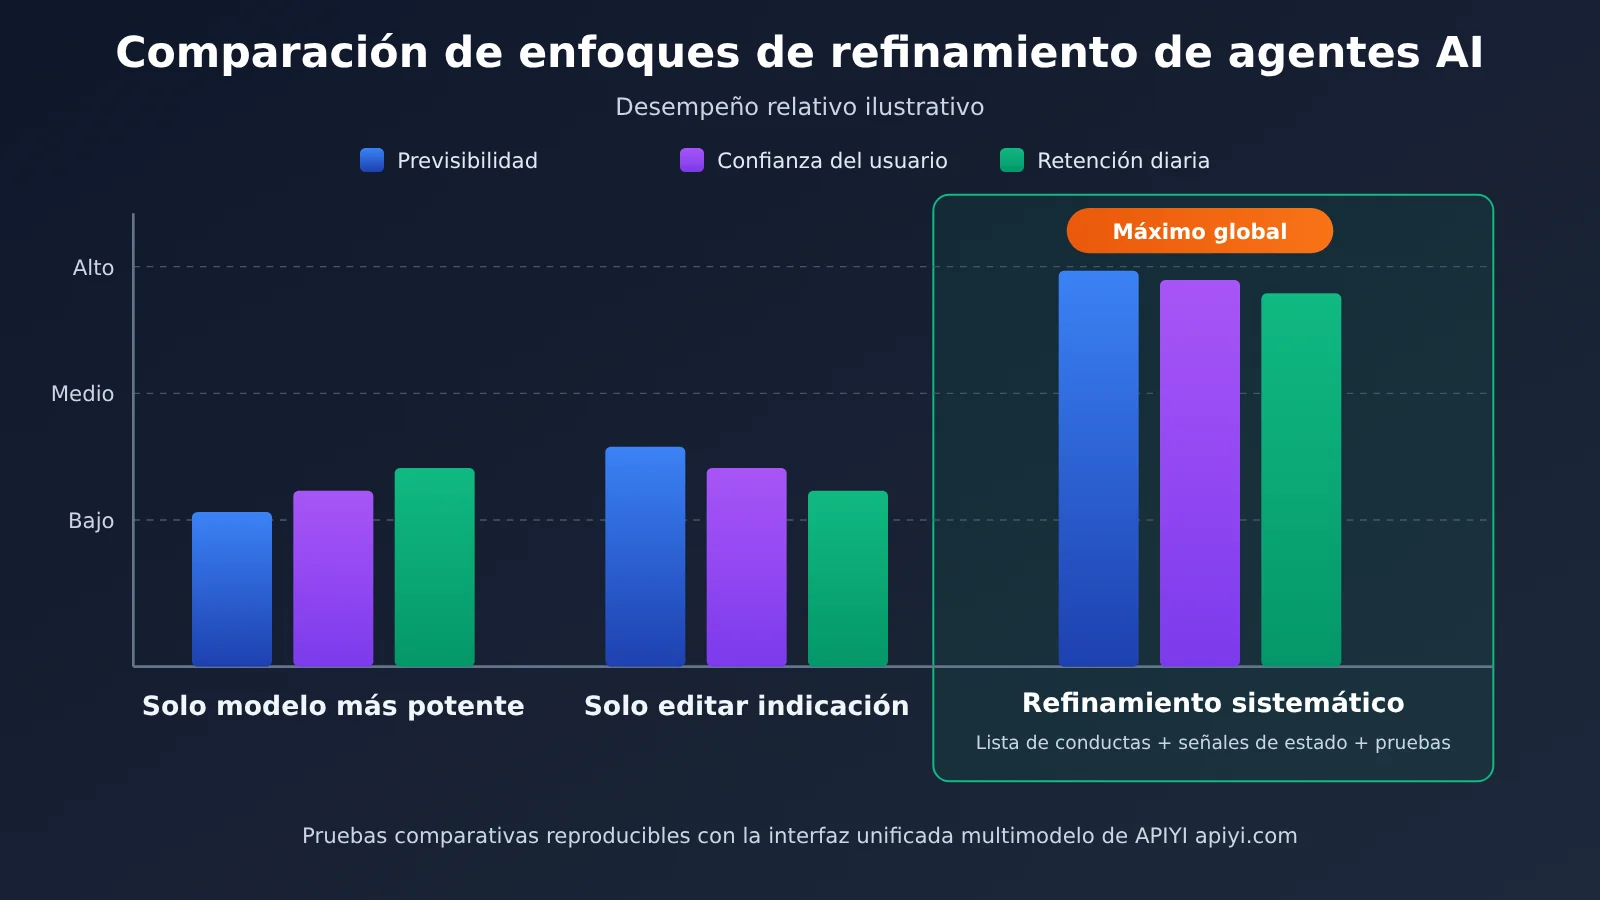
| Enfoque | Cómo se hace | Cuándo conviene | Limitaciones principales |
|---|---|---|---|
| Solo cambiar a un modelo más potente | Actualizar el modelo base y esperar que la experiencia mejore por sí sola | Prototipos tempranos con capacidades claramente insuficientes | Suben los costos y los problemas de comportamiento, como confirmaciones o reportes, siguen ahí |
| Solo modificar la indicación | Acumular reglas en la indicación de sistema | Parches pequeños para problemas puntuales | Cuantas más reglas, más caos; sin pruebas, es fácil que se contradigan |
| Pulido sistemático | Lista de comportamientos + límites de autonomía + señales de estado + conjunto de pruebas | Agentes orientados a tareas cotidianas para usuarios reales | Requiere una inversión inicial grande y a alguien responsable de la experiencia global |
Lectura comparativa de los enfoques de pulido para agentes de IA
Análisis comparativo de solo cambiar el modelo: un modelo más potente sí lleva la delantera en razonamiento complejo, pero no sabe por sí solo qué acciones de tu producto deben confirmarse primero ni cómo mostrar el progreso. En cambio, el pulido sistemático ataca directamente la fricción que percibe el usuario. Muse, que logró un buen crecimiento temprano sin depender del modelo más potente, es un ejemplo.
Análisis comparativo de solo modificar la indicación: los parches en la indicación dan resultados rápidos y sirven para resolver problemas puntuales. Pero sin una lista de comportamientos ni un conjunto de pruebas, las reglas chocan fácilmente entre sí: arreglas una y afectas otra. Para un agente que se va a operar a largo plazo, el pulido sistemático es más fiable.
💡 Nota comparativa: conviene validar estas diferencias entre enfoques con tus propios datos de negocio. Puedes usar el mismo conjunto de pruebas en varios modelos a través de APIYI apiyi.com y luego evaluar el retorno de la inversión con los datos de la página de precios.
Preguntas frecuentes (FAQ) sobre el refinamiento de agentes de IA
Q1: ¿A qué se refiere exactamente el refinamiento de agentes de IA?
Se refiere a probar, ajustar y fijar, punto por punto, el comportamiento de un agente en tareas reales: cuándo pide confirmación, cuándo actúa por su cuenta, cómo informa del progreso y cómo explica los errores, además de permitir que el usuario vea en todo momento el estado actual del agente. Es un trabajo de ingeniería que se puede probar, no una vaga “optimización de la experiencia”.
Q2: ¿Cuál es la diferencia entre el ajuste de comportamiento y la ingeniería de indicaciones?
La ingeniería de indicaciones es uno de los medios; el ajuste de comportamiento es el objetivo y la metodología. El ajuste de comportamiento empieza por definir una “lista de comportamientos esperados” y un conjunto de pruebas; después se implementa con indicaciones, diseño de herramientas, interacción en el frontend y otras vías, y se valida de forma continua con pruebas de regresión. Si solo cambias las indicaciones y no creas un conjunto de pruebas, es difícil garantizar la consistencia.
Q3: ¿Cuál es la escala de usuarios y de equipo de Muse?
Según los reportes, Muse alcanzó los 10 millones de usuarios unas seis semanas después de su lanzamiento. Según Alexander Wang, los equipos de modelo y de producto suman menos de 200 personas en total. Para la escala habitual de Meta, del orden de miles de millones de usuarios, esto es solo un resultado temprano; más adelante tendrán que reducir el costo del servicio y ampliar la escala.
Q4: ¿En qué escenarios de agentes encaja mejor la visibilidad del estado?
Principalmente en estos escenarios:
– **Tareas de gestión**: cancelar suscripciones, hacer seguimiento de facturas, rellenar formularios y otras operaciones de varios pasos;
– **Tareas que requieren tiempo**: implican visitar varios sitios web o usar varias herramientas y tardan bastante en completarse;
– **Operaciones de alto riesgo**: procesos que implican pagos, eliminaciones o envíos externos y requieren confirmación explícita del usuario.
Q5: ¿Cómo montar rápidamente un entorno de pruebas para el refinamiento de agentes con varios modelos?
Puedes seguir estos pasos:
1. Regístrate en APIYI, en apiyi.com, y obtén una clave API;
2. Consulta el centro de documentación en docs.apiyi.com e intégralo con el formato compatible con OpenAI o Anthropic;
3. Con el mismo conjunto de pruebas de comportamiento, ve cambiando el parámetro `model` para ejecutar comparativas;
4. Con los datos reales de facturación de la página de precios https://docs.apiyi.com/models, elige la combinación de modelos que más te convenga.
Q6: ¿Qué costos y limitaciones tiene el refinamiento sistemático?
– **Inversión inicial**: crear la lista de comportamientos y el conjunto de pruebas lleva tiempo y, a corto plazo, no se ve una “nueva función”;
– **Costo de invocación**: las pruebas de regresión llaman repetidamente al modelo, y la facturación se rige por la página de precios de la plataforma utilizada;
– **Requisitos organizativos**: hace falta alguien que tome la decisión final sobre la experiencia global; de lo contrario, las reglas de los límites quedarán inconsistentes por las concesiones entre las partes;
– **Limitaciones**: el refinamiento no compensa carencias graves en la capacidad del modelo; si la capacidad es claramente insuficiente, seguirá siendo necesario cambiar de modelo.
Puntos clave del pulido de agentes de IA
- El pulido se puede probar: antes del lanzamiento de Muse se ajustaron más de cien comportamientos específicos del modelo.
- Fácil de usar no significa más inteligente: la ventaja de Muse es reducir la fricción de uso, no ser el modelo con mayor capacidad.
- Alguien debe decidir los límites: las reglas para ejecutar de forma autónoma y para confirmar antes de actuar deben ser uniformes; cada módulo no puede decidir por su cuenta.
- El estado debe ser visible: usar señales para responder al usuario si lo entendió, si lo está haciendo y si ya terminó.
- Los casos límite importan igual: tratar de la misma forma los errores, las interrupciones, la segunda pestaña y el flujo de demostración.
- Comparar varios modelos es más fiable: se puede usar la interfaz unificada de APIYI para comparar distintos modelos con el mismo conjunto de pruebas.
Resumen
Puntos clave del pulido de agentes de IA:
- Ajuste de comportamiento: organiza los puntos de decisión en una lista; en cada uno indica la condición que lo activa, el comportamiento esperado y un contraejemplo, y ejecuta pruebas de regresión continuas con un conjunto de pruebas.
- Visibilidad del estado: reduce los estados internos a unas pocas señales que el usuario pueda entender, y mantenlas a lo largo de todo el flujo: comprensión, ejecución, confirmación, finalización y error.
- Iteración continua: encuentra puntos de fricción en los registros de uso reales; insiste en hacer una segunda y una tercera versión, en lugar de rehacer una y otra vez la primera.
La experiencia de Muse también aplica a equipos pequeños y medianos: que el equipo se encargue de las decisiones clave, se tome en serio los detalles aburridos y, tras un fracaso, cambie lo que de verdad importa y lo vuelva a intentar. Nada de esto exige perder más de diez mil millones primero.
Si estás pensando en crear un conjunto de pruebas de comportamiento para tu agente, puedes comparar rápidamente varios modelos a través de APIYI apiyi.com. La plataforma es compatible con los formatos de API de OpenAI y Anthropic. Las instrucciones de integración están en docs.apiyi.com y la facturación se rige por la página de precios https://docs.apiyi.com/models.
📚 Referencias
- MindStudio – Análisis del caso de Muse de Meta: contexto, equipo y detalles de refinamiento de Muse
- Enlace:
mindstudio.ai/blog/meta-muse-ai-companion-lessons -
Descripción: fuente principal de los hechos del caso presentados en este artículo, publicada el 4 de noviembre de 2026
-
Centro de documentación de APIYI: instrucciones para el acceso unificado a múltiples modelos
- Enlace:
docs.apiyi.com -
Descripción: formas de integración con formatos compatibles con OpenAI y Anthropic
-
Página de precios de modelos de APIYI: criterios de facturación y precios unitarios de cada modelo
- Enlace:
docs.apiyi.com/models - Descripción: los precios unitarios de entrada, salida y caché se rigen por los datos reales de esta página
Autor: Equipo técnico de APIYI
Intercambio técnico: te invitamos a contactarnos en el sitio oficial de APIYI, apiyi.com, para conversar sobre prácticas de refinamiento de agentes; para más materiales, puedes visitar el centro de documentación docs.apiyi.com