作者注:以 Meta Muse 为案例,说明 AI agent 打磨具体要打磨哪些东西,重点是行为调校和状态可见性,并给出可以照着做的步骤。
很多团队做 AI agent 时都会遇到同一个情况:模型能力已经够用,演示也很顺利,但用户真正用了几天就流失了。问题通常不在模型本身,而在 行为调校与状态可见性 这两层没有打磨到位。本文以 Meta 的 Muse 为案例,拆解 AI agent 打磨到底在打磨什么。
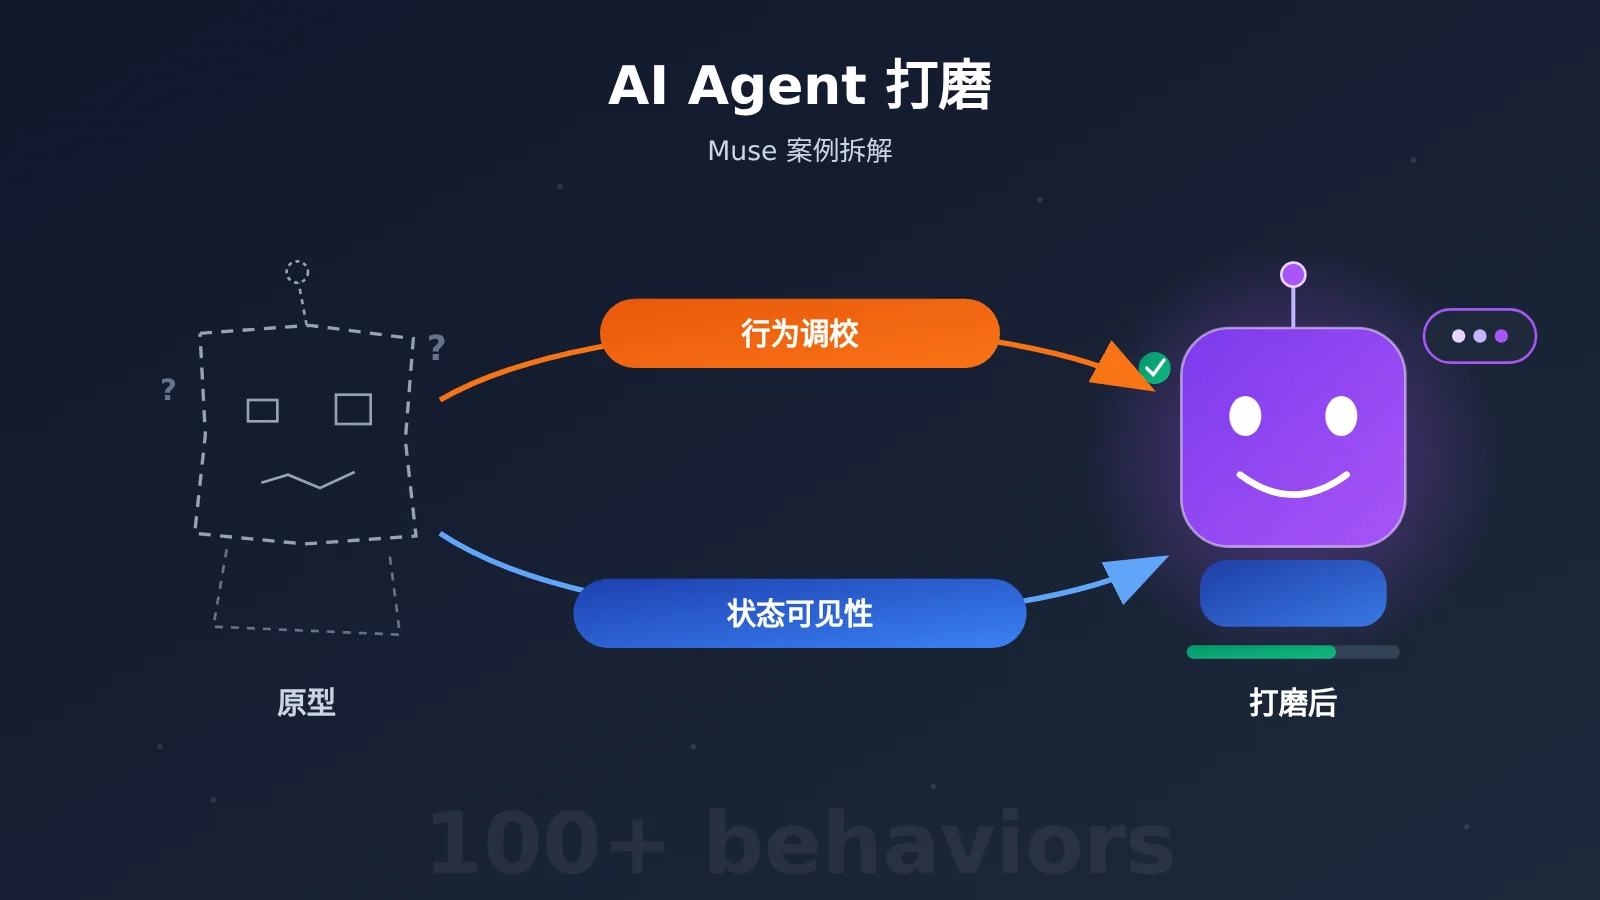
这不是又一篇“细节决定成败”的空泛感想。根据公开报道,Muse 团队在上线前测试并调整了一百多项具体的模型行为,并让头像用表情和动作直接显示 agent 当前在做什么。这两件事都可以拆成具体的工程任务。
核心价值:读完本文,你能把“打磨”变成一张行为清单、一张状态信号表和一套测试流程,并直接用在自己的 agent 产品上。
AI agent 打磨的背景:Muse 为什么值得拆解
先交代案例背景。据报道,Meta 负责 VR/AR 的 Reality Labs 部门仅 2025 年就亏损约 192 亿美元,元宇宙路线基本被外界看作一次代价很高的失败。之后扎克伯格没有收缩到广告主业,而是继续投入 AI agent 方向。Muse 上线约六周,据报道用户就达到 1000 万。
这个项目有两个细节和“打磨”直接相关。第一,团队由来自 Scale AI 的 Alexander Wang 和 Nat Friedman 牵头,据 Wang 本人描述,模型和产品两条线加起来不到 200 人。小团队是有意为之,目的是避免大团队靠共识做决策时产生的妥协和体验不一致。第二,Muse 并没有被定位为“市面上最聪明的模型”,它的优势在于缩小了“模型技术上能做到什么”和“普通人实际用起来是什么感受”之间的差距,例如取消订阅、跟踪账单这类日常任务。
对开发者来说,Muse 的营收和规模参考意义不大。值得参考的是它对“打磨”的理解:打磨是一组可以测试的具体行为,不是营销用语。
AI agent 打磨核心要点
把 Muse 的做法抽象一下,AI agent 打磨可以归为下面几个方向:
| 要点 | 说明 | 用户收益 |
|---|---|---|
| 行为调校 | 上线前逐项测试并调整具体模型行为(Muse 超过一百项) | agent 的反应可预期,不会时好时坏 |
| 决策边界 | 明确什么情况自己执行,什么情况先问用户 | 少打扰,同时不越权 |
| 状态可见性 | 用视觉或文字信号显示 agent 正在做什么 | 用户不用猜“它懂了没、在干活没” |
| 体验一致性 | 不同入口、不同页面行为保持一致 | 小摩擦不会累积成明显的使用成本 |
| 边角场景 | 认真处理报错、中断、第二个和第三个标签页 | 日常反复使用时仍然顺手 |
AI agent 打磨重点一:行为调校不等于“模型更聪明”
“模型很聪明”和“agent 很好用”是两回事。一个能力很强的模型,如果不知道什么时候该停下来确认、什么时候可以直接行动、怎样汇报进度,用起来照样让人烦躁。Muse 团队调的一百多项行为,主要就是这些。
行为调校的对象是场景下的反应方式,不是模型参数。比如用户说“帮我把那个订阅退了”,agent 应该先列出它找到的订阅并请用户确认,还是直接执行?执行到付款页面时,要不要再确认一次?每个这样的判断点都是一项需要测试和固定下来的行为。
AI agent 打磨重点二:状态可见性是设计工作
Muse 的头像会通过小的动画提示“正在做”当前的工作,用户不需要去读技术性的状态消息。这回答了每个把任务交给 AI 的人都会有的疑问:它理解我的意思了吗?它真的在做吗?
消除这种不确定感属于设计工作,而且要覆盖产品的每个角落,不能只在演示流程里做。据报道,Meta 在发布手机应用之前,就已经开发了与语音同步的面部表情和动作生成技术,为实时语音体验和未来的可穿戴设备做准备。大多数公司会把这一层推到“验证核心想法之后”,Muse 则提前做了。
AI agent 打磨快速上手:6 个实操步骤
下面把 Muse 的思路改写成中小团队也能执行的流程。不需要上百人,也不需要上百亿预算,需要的是持续做“第二遍、第三遍”的耐心。
步骤 1:建立 AI agent 行为清单
先把 agent 在真实任务里会遇到的判断点列出来,每项写清楚“触发条件、期望行为、反例”。刚开始列 30 到 50 项就可以,之后随测试反馈持续补充。下面是一份分类参考:
| 行为类别 | 典型判断点 | 打磨标准 |
|---|---|---|
| 意图确认 | 指令有歧义,例如“退掉那个订阅” | 有多个候选时列出来让用户选,不要自己猜 |
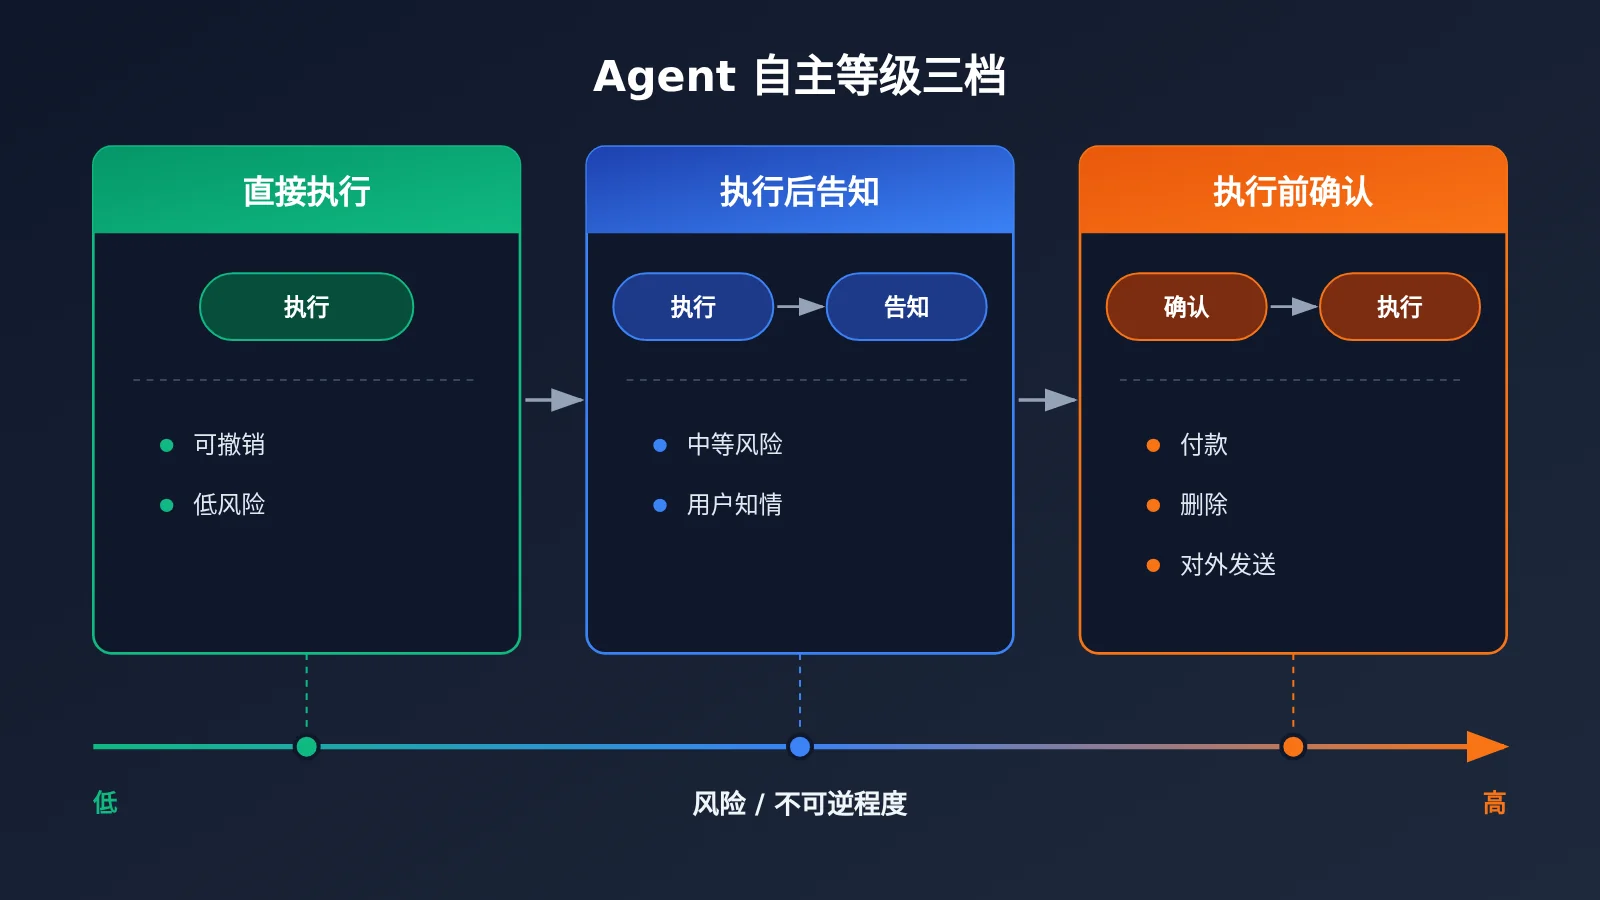
| 自主执行 | 低风险、可撤销的操作 | 直接执行,完成后简短汇报 |
| 高风险拦截 | 涉及付款、删除、对外发送 | 必须二次确认,并说明后果 |
| 进度汇报 | 多步骤、耗时较长的任务 | 每个关键步骤都给出可见反馈 |
| 失败处理 | 网站打不开、权限不足 | 说明原因和下一步建议,不要静默失败 |
| 任务收尾 | 任务完成 | 给出明确的“已完成”信号和结果摘要 |
步骤 2:划定 AI agent 自主与确认的边界
清单列好之后,要为每类操作定一个“自主等级”。常用的分法是三档:直接执行、执行后告知、执行前确认。判断依据主要看两点:操作能不能撤销,失败的代价有多大。
这一步最容易出现团队内部意见分歧。Muse 用小团队的原因就在这里:边界问题需要有一个人对整体体验负责并拍板,不能让每个模块各自按“局部合理”的方式决定。否则就会出现同一个操作在 A 页面要确认、在 B 页面直接执行的情况。
步骤 3:把 AI agent 内部状态映射成用户可见信号
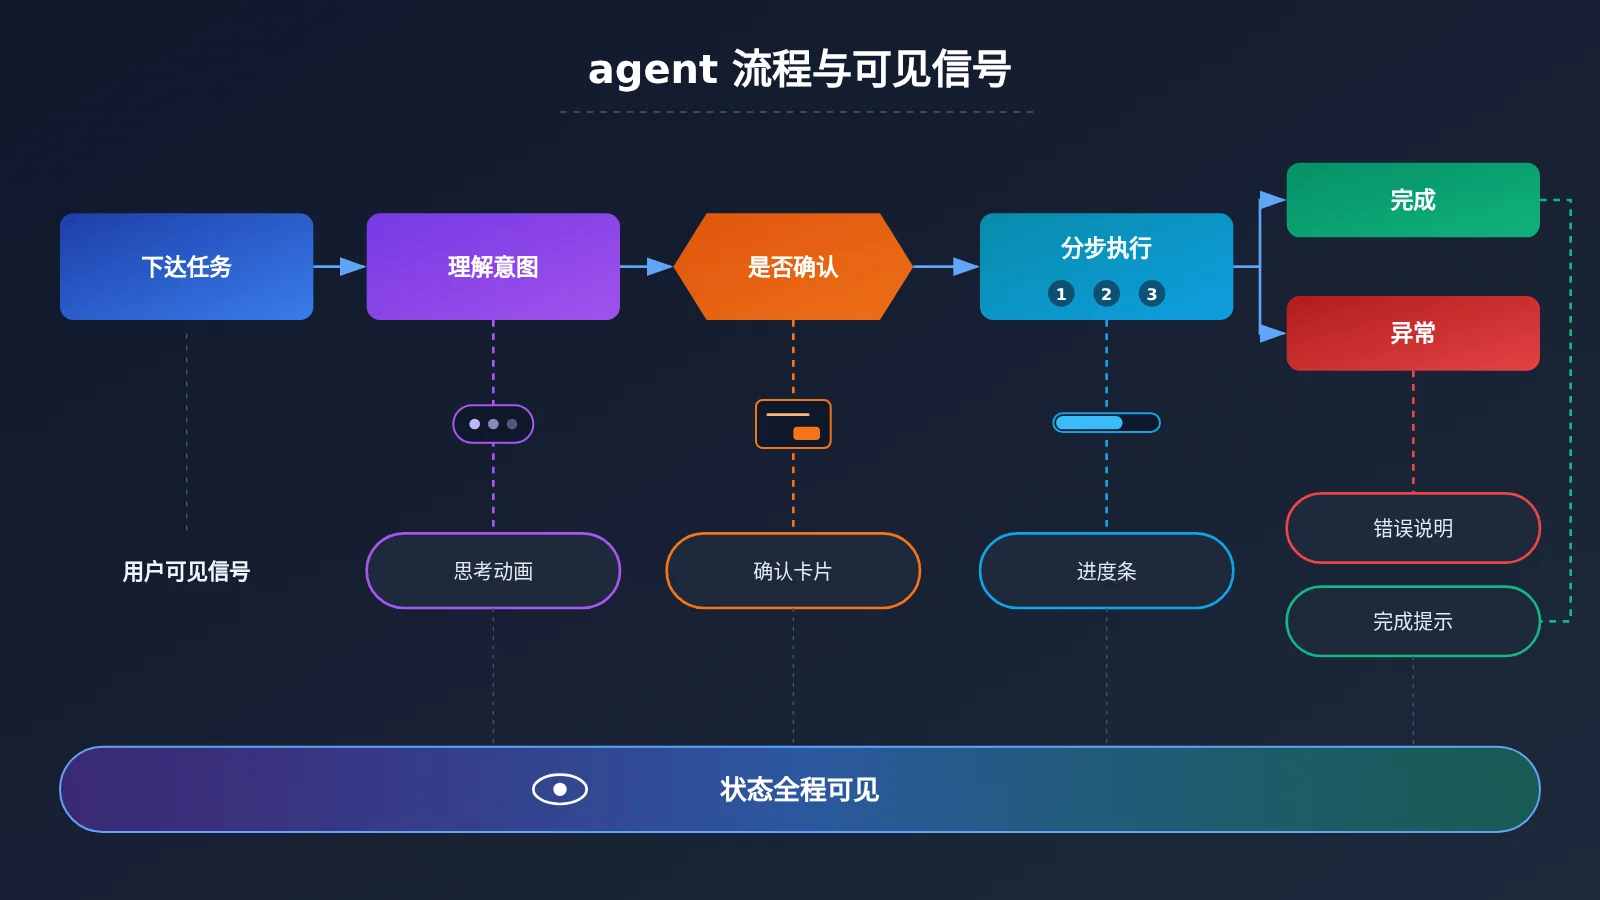
agent 内部有很多状态,但用户只关心少数几个。实际做法是把内部状态归并成 5 到 6 个用户能看懂的状态,再给每个状态设计固定的信号:
| agent 内部状态 | 用户可见信号 | 常见反例 |
|---|---|---|
| 解析意图 / 规划中 | 思考动画或“正在理解你的需求” | 白屏几秒,用户以为卡住了 |
| 调用工具 / 访问外部服务 | 显示当前步骤名称,如“正在打开订阅页面” | 直接显示原始工具名或 JSON |
| 等待用户确认 | 高亮确认卡片,写明后果 | 把确认问题藏在长段回复里 |
| 执行中(多步骤) | 分步进度,标注已完成和进行中 | 只有一个转圈图标 |
| 已完成 | 明确完成标记和结果摘要 | 回复结束了,但没说任务是否成功 |
| 出错 / 中断 | 用人话说明原因和可选操作 | 技术报错,或者干脆没有反馈 |
工程上,可以利用模型接口的流式输出来驱动这些信号。OpenAI 兼容格式开启 stream 后会逐段返回内容和工具调用;Anthropic Messages 格式的流式事件会区分文本块和 tool_use 块。前端监听这些事件,切换到对应的可见状态即可,不必等整段回复结束。
步骤 4:设计 AI agent 行为测试集
每项行为都要有对应的测试用例,至少覆盖“正常输入、模糊输入、异常环境”三种情况。测试时不只看答案对不对,还要看:
- 该确认的地方有没有确认,不该打扰的地方有没有乱问;
- 状态信号有没有在每个阶段按时出现;
- 同一任务从不同入口发起,行为是否一致;
- 出错后用户能不能看懂,并知道下一步怎么做。
建议把测试集固定下来,每次改提示词、换模型或调工具后都完整跑一遍,避免修好一项、弄坏三项。
步骤 5:在不同 AI agent 底座模型上做对照
Muse 说明了一点:打磨层的价值不依赖“最强模型”。同一份行为清单在不同模型上的表现会有差异,所以需要横向对照,找出满足行为标准、成本又合适的组合。
| 打磨环节 | 对模型的主要需求 | 选型思路 | 可用平台 |
|---|---|---|---|
| 意图解析与规划 | 推理稳定、遵循指令 | 优先选旗舰或推理类模型 | API易 apiyi.com、官方 API |
| 工具调用执行 | 函数调用格式稳定 | 选工具调用表现可靠的模型 | API易 apiyi.com、官方 API |
| 进度文案 / 状态播报 | 响应快、成本低 | 选轻量快速模型 | API易 apiyi.com、官方 API |
| 测试集批量评估 | 量大、可复现 | 选性价比高的模型做评审 | API易 apiyi.com、官方 API |
🎯 技术建议:做多模型对照时,可以通过 API易 apiyi.com 统一调用。API易 提供本文涉及的主流大模型 API,同时兼容 OpenAI 与 Anthropic 两种接口格式,同一套 agent 代码切换
model参数即可对比,不需要为每家厂商单独写适配层。接入方式和接口地址以 API易 文档中心 docs.apiyi.com 为准。
步骤 6:持续做 AI agent 体验的“第二遍、第三遍”
参考资料里有个比喻:只装修餐厅门面不够,还得把洗手间打扫干净。现在的 AI 工具能很快做出一个漂亮的第一版,这反而让人倾向于不断做新的第一版,而不去修现有产品里那些“能用但不好用”的部分。
建议每周从真实使用记录里挑出用户犹豫、重复提问、中途放弃的片段,回到步骤 1 补充行为清单。反复使用的产品,就是在这些不显眼的第二遍、第三遍里做出来的。
💰 成本说明:行为测试集需要反复运行,调用量不小。关于各模型的输入、输出单价以及缓存计费口径,请以 API易 价格页 https://docs.apiyi.com/models 的实际数据为准,本文不列具体价格。
AI agent 打磨方案对比
| 方案 | 核心做法 | 适用场景 | 主要局限 |
|---|---|---|---|
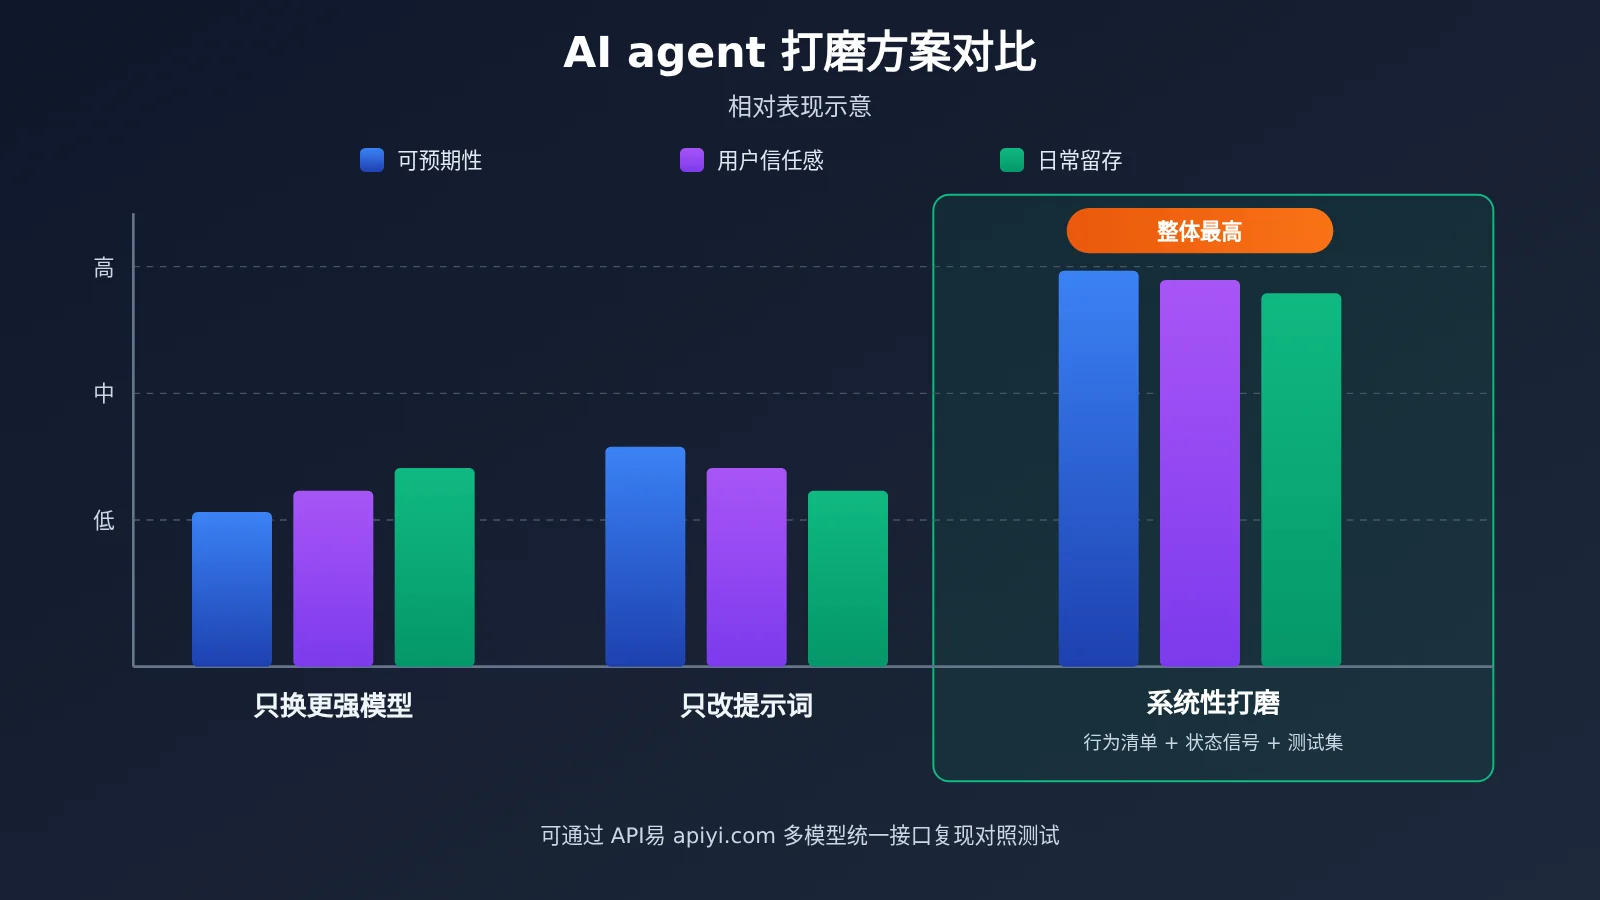
| 只换更强模型 | 升级底座模型,期待体验自然变好 | 能力明显不足的早期原型 | 成本上升,确认、汇报等行为问题依然存在 |
| 只改提示词 | 在系统提示里堆规则 | 小范围修补个别问题 | 规则越堆越乱,缺少测试时容易互相冲突 |
| 系统性打磨 | 行为清单 + 自主边界 + 状态信号 + 测试集 | 面向真实用户的日常任务型 agent | 前期投入大,需要专人对整体体验负责 |
AI agent 打磨方案对标解读
只换模型的对标分析:更强的模型在复杂推理上确实领先,但它不会自己知道你的产品里哪些操作要先确认、进度该怎么展示。相比之下,系统性打磨直接处理用户感受到的摩擦,Muse 没有依赖最强模型也取得了不错的早期增长,就是一个例证。
只改提示词的对标分析:提示词修补见效快,适合解决单点问题。但没有行为清单和测试集,规则之间容易冲突,修好一项、影响另一项。对于要长期运营的 agent,系统性打磨更稳妥。
💡 对比说明:上面的方案差异建议在自己的业务数据上验证。可以通过 API易 apiyi.com 用同一套测试集在多个模型上跑对照,再结合价格页数据评估投入产出。
AI agent 打磨常见问题 FAQ
Q1:AI agent 打磨具体指什么?
指把 agent 在真实任务中的行为逐项测试、调整并固定下来,包括什么时候确认、什么时候自主执行、怎样汇报进度、出错后怎么说明,同时让用户随时能看到 agent 当前的状态。它是可测试的工程工作,不是笼统的“优化体验”。
Q2:行为调校和提示词工程有什么区别?
提示词工程是手段之一,行为调校是目标和方法论。行为调校先定义“期望行为清单”和测试集,再用提示词、工具设计、前端交互等多种方式去实现,并持续回归验证。只改提示词而不建测试集,很难保证一致性。
Q3:Muse 的用户规模和团队规模是怎样的?
据报道,Muse 上线约六周用户达到 1000 万。按 Alexander Wang 的说法,模型和产品团队合计不到 200 人。对 Meta 惯常的数十亿用户量级来说,这只是早期成绩,后续还要降低服务成本、扩大规模。
Q4:状态可见性最适合哪些 agent 场景?
主要适合以下场景:
– **代办类任务**:取消订阅、跟踪账单、填写表单等多步骤操作;
– **耗时任务**:需要访问多个网站或调用多个工具,执行时间较长;
– **高风险操作**:涉及付款、删除、对外发送,需要用户明确确认的流程。
Q5:如何快速搭建多模型的 agent 打磨测试环境?
可以按以下步骤操作:
1. 在 API易 apiyi.com 注册并获取 API Key;
2. 参考文档中心 docs.apiyi.com,按 OpenAI 或 Anthropic 兼容格式接入;
3. 用同一份行为测试集,依次切换 `model` 参数跑对照;
4. 结合价格页 https://docs.apiyi.com/models 的实际计费数据,选出合适的模型组合。
Q6:系统性打磨有哪些代价和局限?
– **前期投入**:行为清单和测试集的建设需要时间,短期看不到“新功能”;
– **调用成本**:回归测试会反复调用模型,计费以所用平台价格页为准;
– **组织要求**:需要有人对整体体验拍板,否则边界规则会因各方妥协而不一致;
– **局限**:打磨不能弥补模型能力的硬缺口,能力明显不足时仍需换模型。
AI agent 打磨核心要点 Key Takeaways
- 打磨可以测试:Muse 上线前调整了一百多项具体模型行为;
- 好用不等于最聪明:Muse 的优势是减少使用摩擦,不是模型能力最强;
- 边界要有人拍板:自主执行和先行确认的规则需要统一,不能各模块各自决定;
- 状态必须可见:用信号回答用户“它懂了没、在做没、做完没”;
- 边角同样重要:报错、中断、第二个标签页和演示流程同等对待;
- 多模型对照更稳:可通过 API易 统一接口,用同一测试集比较不同模型。
总结
AI agent 打磨的核心要点:
- 行为调校:把判断点整理成清单,每项写明触发条件、期望行为和反例,并用测试集持续回归;
- 状态可见性:把内部状态归并成少数用户能看懂的信号,贯穿理解、执行、确认、完成和出错全流程;
- 持续迭代:从真实使用记录中找摩擦点,坚持做第二遍、第三遍,而不是不断重做第一版。
Muse 的经验对中小团队同样适用:小团队负责关键决策,把枯燥的细节当回事,失败后改变真正重要的做法再来一次。这些都不需要先亏掉上百亿。
如果你准备为自己的 agent 建立行为测试集,可以通过 API易 apiyi.com 在多个模型上快速做对照。平台兼容 OpenAI 与 Anthropic 接口格式,接入说明见 docs.apiyi.com,计费以价格页 https://docs.apiyi.com/models 为准。
📚 参考资料
- MindStudio – Meta’s Muse 案例分析:Muse 的背景、团队与打磨细节
- 链接:
mindstudio.ai/blog/meta-muse-ai-companion-lessons -
说明:本文案例事实的主要来源,发布于 2026 年 11 月 4 日
-
API易 文档中心:多模型统一接入说明
- 链接:
docs.apiyi.com -
说明:OpenAI 与 Anthropic 兼容格式的接入方式
-
API易 模型价格页:各模型计费口径与单价
- 链接:
docs.apiyi.com/models - 说明:输入、输出单价及缓存价格以此页面实际数据为准
作者:APIYI 技术团队
技术交流:欢迎在 API易 官网 apiyi.com 联系我们交流 agent 打磨实践,更多资料可访问 docs.apiyi.com 文档中心