Примечание автора: на примере Muse от Meta показываю, что именно приходится доводить в AI-агенте. Главное — настройка поведения и видимость состояния. В конце — шаги, которые можно повторить.
Многие команды, которые делают AI-агентов, упираются в одну и ту же историю: возможностей модели уже хватает, демо проходит гладко, но пользователи работают с продуктом несколько дней — и уходят. Проблема обычно не в самой модели, а в том, что настройка поведения и видимость состояния не доведены до ума. В этой статье разбираю, что именно шлифуют, когда «шлифуют» AI-агента, на примере Muse от Meta.
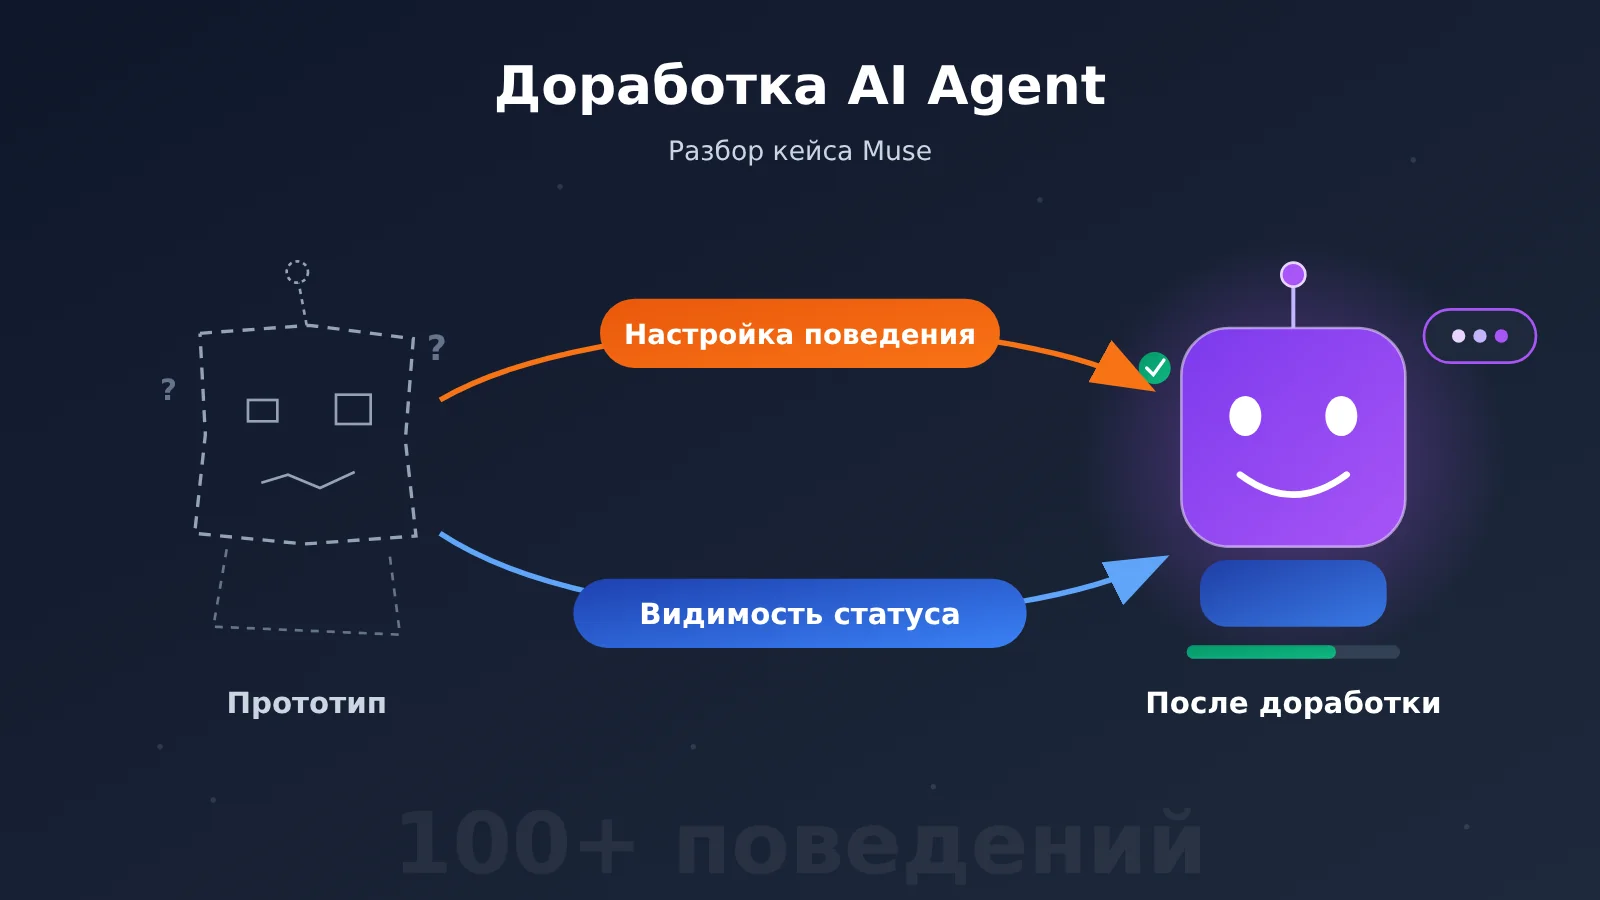
Это не очередные абстрактные рассуждения в духе «всё решают детали». По публичным сообщениям, перед запуском команда Muse протестировала и скорректировала более сотни конкретных вариантов поведения модели, а ещё сделала так, чтобы аватар с помощью мимики и движений показывал, чем агент занят прямо сейчас. И то и другое раскладывается на конкретные инженерные задачи.
Главная ценность: после этой статьи вы сможете превратить «доводку» в чек-лист поведений, таблицу сигналов состояния и процесс тестирования — и сразу применить всё это в своём продукте с AI-агентом.
Предыстория доводки AI-агента: почему Muse стоит разобрать
Для начала — контекст. По сообщениям, подразделение Reality Labs, которое в Meta отвечает за VR/AR, только за 2025 год потеряло около 19,2 млрд долларов, а сам метавселенский путь внешние наблюдатели в основном считают очень дорогим провалом. После этого Цукерберг не стал уходить в основную рекламную деятельность, а продолжил вкладываться в направление AI-агентов. Примерно через шесть недель после запуска Muse, по сообщениям, достиг 10 миллионов пользователей.
В этом проекте есть две детали, которые напрямую связаны с «доводкой». Во-первых, команду возглавляют Александр Ван и Нэт Фридман из Scale AI; по словам самого Вана, в обеих линиях — модели и продукте — вместе меньше 200 человек. Маленькая команда — это осознанное решение: так удаётся избежать компромиссов и разрозненности опыта, которые возникают, когда большая команда принимает решения через консенсус. Во-вторых, Muse не позиционируется как «самая умная модель на рынке». Его преимущество — в сокращении разрыва между тем, «что модель технически умеет», и тем, «как обычный человек ощущает это на практике», например в таких повседневных задачах, как отмена подписки или отслеживание счетов.
Для разработчиков выручка и масштаб Muse — не самый полезный ориентир. А вот его понимание «доводки» — да: доводка — это набор конкретных проверяемых действий, а не маркетинговый слоган.
Ключевые аспекты доводки AI-агента
Если абстрагироваться от того, как это делала Muse, доводку AI-агента можно свести к нескольким направлениям:
| Аспект | Что это значит | Что получает пользователь |
|---|---|---|
| Настройка поведения | Перед запуском протестировать и скорректировать конкретные модели поведения по пунктам (у Muse — больше сотни) | Реакции агента предсказуемы, без перепадов |
| Границы решений | Чётко определить, когда агент действует сам, а когда сначала спрашивает пользователя | Меньше лишних вмешательств — и при этом никакого самоуправства |
| Видимость состояния | Показывать визуальными или текстовыми сигналами, что агент делает прямо сейчас | Пользователю не нужно гадать: «Он меня понял? Он вообще работает?» |
| Согласованность опыта | Поведение остаётся одинаковым в разных точках входа и на разных страницах | Мелкие шероховатости не накапливаются в заметные издержки |
| Краевые сценарии | Ответственно обрабатывать ошибки, прерывания, вторую и третью вкладки | При ежедневном повторном использовании всё остаётся удобным |
Первый аспект доводки AI-агента: настройка поведения — не то же самое, что «модель стала умнее»
«Модель умная» и «агентом удобно пользоваться» — разные вещи. Если у сильной модели нет понимания, когда остановиться и попросить подтверждение, когда можно действовать сразу, а как сообщать о прогрессе, она всё равно будет раздражать. Больше сотни поведений, которые настраивала команда Muse, — как раз про это.
Настройка поведения касается того, как агент реагирует в конкретном сценарии, а не параметров модели. Например, пользователь говорит: «Помоги отменить ту подписку». Должен ли агент сначала показать найденные подписки и попросить подтверждение — или сразу выполнить действие? А когда доходит до страницы оплаты, нужно ли подтверждать ещё раз? Каждая такая точка решения — отдельный паттерн поведения, который нужно протестировать и зафиксировать.
Второй аспект доводки AI-агента: видимость состояния — это дизайнерская задача
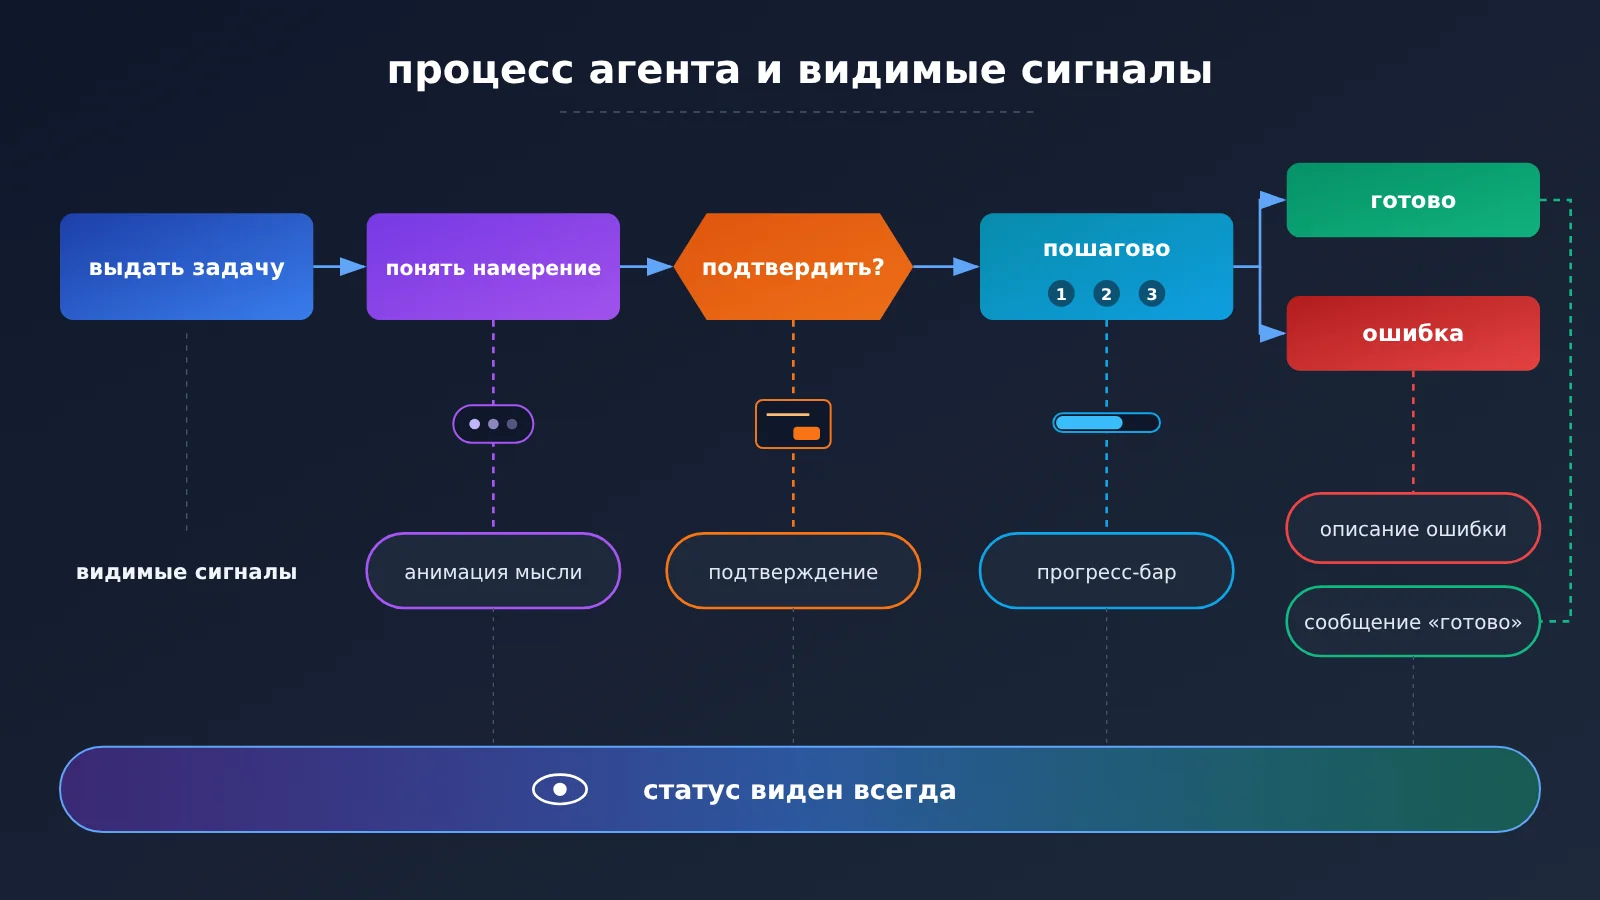
Аватар Muse с помощью небольшой анимации показывает, что именно он «делает прямо сейчас»; пользователю не нужно читать технические статусные сообщения. Это отвечает на вопрос, который возникает у каждого, кто передаёт задачу AI: он понял, что я имею в виду? Он действительно работает?
Снимать эту неопределённость — задача дизайна, причём по всему продукту, а не только в демо-сценарии. По сообщениям, Meta перед выпуском мобильного приложения уже разрабатывала технологию генерации мимики и движений, синхронизированных с голосом, готовясь к опыту голосового общения в реальном времени и будущим носимым устройствам. Большинство компаний откладывают этот слой до «после проверки основной идеи». Muse сделала это заранее.
Быстрый старт по шлифовке AI-агента: 6 практических шагов
Ниже подход Muse переписан в процесс, который под силу и небольшой команде. Не нужны сотни людей, не нужны бюджеты в десятки миллиардов — нужно терпение снова и снова делать «второй и третий проход».
Шаг 1: Составьте список поведения AI-агента
Сначала выпишите точки принятия решений, с которыми агент столкнётся в реальных задачах, и для каждой чётко опишите «условие срабатывания, ожидаемое поведение, контрпример». Для начала хватит 30–50 пунктов, дальше дополняйте их по мере тестирования и обратной связи. Ниже — справочная классификация:
| Категория поведения | Типичные точки решения | Критерий шлифовки |
|---|---|---|
| Уточнение намерения | Команда неоднозначна, например «отмени ту подписку» | Если есть несколько кандидатов, перечислите их и дайте пользователю выбрать — не угадывайте сами |
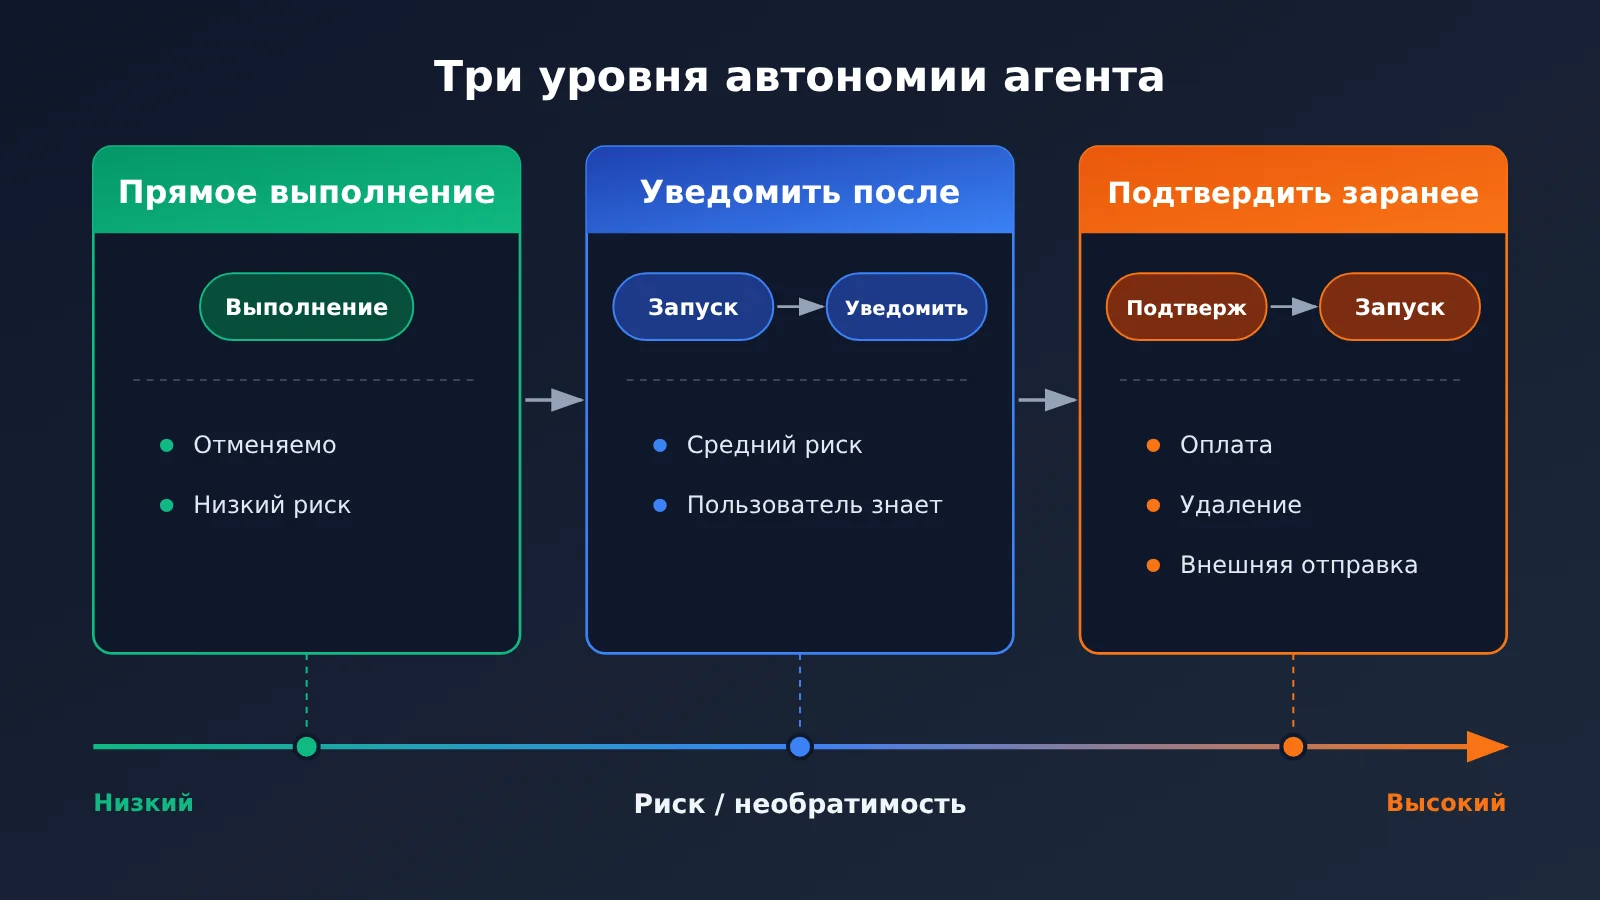
| Самостоятельное выполнение | Операции с низким риском и возможностью отмены | Выполняйте сразу, по завершении коротко отчитайтесь |
| Блокировка высокого риска | Оплата, удаление, отправка вовне | Обязательное повторное подтверждение с объяснением последствий |
| Отчёт о прогрессе | Многошаговые, длительные задачи | На каждом ключевом шаге давайте видимую обратную связь |
| Обработка ошибок | Сайт не открывается, недостаточно прав | Объясните причину и предложите следующий шаг, не «молчите» при сбое |
| Завершение задачи | Задача выполнена | Дайте явный сигнал «готово» и краткое резюме результата |
Шаг 2: Определяем границы самостоятельности и подтверждений для AI-агента
Когда список готов, для каждого типа операций нужно задать «уровень самостоятельности». Обычно используют три уровня: выполнять сразу, выполнить и сообщить, подтверждать перед выполнением. Решение опирается на два критерия: можно ли отменить операцию и насколько дорога ошибка.
Именно на этом шаге чаще всего возникают разногласия внутри команды. Поэтому Muse и работает небольшой командой: за границы должен отвечать один человек, который видит общий пользовательский опыт и принимает финальное решение. Нельзя позволять каждому модулю решать «локально логично». Иначе получится, что одна и та же операция на странице A требует подтверждения, а на странице B выполняется сразу.
Шаг 3: Превращаем внутренние состояния AI-агента в понятные пользователю сигналы
Внутри агента много состояний, но пользователю важны лишь несколько. На практике внутренние состояния сводят к 5–6 понятным пользователю состояниям, а для каждого состояния задают постоянный сигнал:
| Внутреннее состояние агента | Видимый сигнал для пользователя | Типичный антипаттерн |
|---|---|---|
| Разбор намерения / планирование | Анимация размышления или «Понимаю ваш запрос» | Пустой экран на несколько секунд — пользователь думает, что всё зависло |
| Вызов инструмента / обращение к внешнему сервису | Показывать название текущего шага, например «Открываю страницу подписки» | Показывать сырое имя инструмента или JSON |
| Ожидание подтверждения пользователя | Подсветить карточку подтверждения и явно описать последствия | Прятать вопрос о подтверждении внутри длинного ответа |
| Выполнение (несколько шагов) | Пошаговый прогресс с отметками, что уже сделано и что в процессе | Один крутящийся индикатор |
| Завершено | Явная отметка о завершении и краткий итог | Ответ закончился, но не сказано, успешно ли выполнена задача |
| Ошибка / прерывание | Объяснить причину человеческим языком и предложить возможные действия | Техническая ошибка или вообще никакой обратной связи |
С инженерной точки зрения эти сигналы можно приводить в действие через потоковый вывод API модели. В OpenAI-совместимом формате при включении stream контент и вызовы инструментов возвращаются по частям; потоковые события формата Anthropic Messages разделяют текстовые блоки и блоки tool_use. Фронтенду достаточно слушать эти события и переключать видимое состояние — ждать окончания всего ответа не нужно.
Шаг 4: Разработка набора тестов поведения AI-агента
Для каждого поведения нужен свой тест-кейс, который покрывает как минимум три ситуации: «нормальный ввод», «неоднозначный ввод» и «нештатное окружение». При тестировании смотрите не только на правильность ответа, но и на то:
- запрашивает ли агент подтверждение там, где оно нужно, и не задаёт ли лишних вопросов там, где пользователя не стоит беспокоить;
- появляются ли сигналы состояния вовремя на каждом этапе;
- одинаково ли ведёт себя агент, если одну и ту же задачу запускать из разных точек входа;
- понятна ли пользователю ошибка и знает ли он, что делать дальше.
Советую зафиксировать набор тестов и полностью прогонять его после каждого изменения промпта, смены модели или настройки инструментов — чтобы не вышло «починили одно, сломали три».
Шаг 5: Сравнение на разных базовых моделях AI-агента
Muse показывает важную вещь: ценность слоя доводки не зависит от «самой мощной модели». Один и тот же чек-лист поведения на разных моделях проявляется по-разному, поэтому нужно сравнить их между собой и найти комбинацию, которая укладывается в стандарты поведения и подходит по цене.
| Этап доводки | Что важно от модели | Как выбирать | Доступная платформа |
|---|---|---|---|
| Разбор намерения и планирование | Стабильные рассуждения, следование инструкциям | Сначала брать флагманские модели или модели рассуждений | APIYI apiyi.com, официальный API |
| Выполнение вызовов инструментов | Стабильный формат вызова функций | Выбирать модель с надёжным вызовом инструментов | APIYI apiyi.com, официальный API |
| Тексты прогресса / оповещения о статусе | Быстрый отклик, низкая стоимость | Выбирать лёгкую быструю модель | APIYI apiyi.com, официальный API |
| Пакетная оценка набора тестов | Большой объём, воспроизводимость | Выбирать модель с хорошим соотношением цены и качества для оценки | APIYI apiyi.com, официальный API |
🎯 Техническая рекомендация: при сравнении нескольких моделей можно вызывать их через APIYI apiyi.com. APIYI предоставляет API ведущих больших языковых моделей, упомянутых в статье, и совместим с двумя форматами интерфейсов — OpenAI и Anthropic. В одном и том же коде агента достаточно переключить параметр
model, чтобы сравнивать модели, — не нужно писать отдельный слой адаптера под каждого провайдера. Способ подключения и адрес интерфейса смотрите в центре документации APIYI — docs.apiyi.com.
Шаг 6. Доводим опыт AI-агента до «второго и третьего прохода»
В справочных материалах есть такая метафора: недостаточно отремонтировать витрину ресторана — надо ещё и туалет вымыть. Сегодняшние AI-инструменты позволяют быстро сделать красивую первую версию, и как раз поэтому так и тянет всё время делать новую первую версию, вместо того чтобы доделывать в существующем продукте те места, которые «работают, но неудобно».
Совет: раз в неделю отбирайте из реальной истории использования моменты, где пользователь замялся, переспросил или бросил всё на полпути, и возвращайтесь к шагу 1 — дополнять список поведений. Продукты, в которые возвращаются снова и снова, как раз и делаются в этих незаметных вторых и третьих проходах.
💰 О стоимости: набор поведенческих тестов приходится прогонять много раз, и объём вызовов получается приличным. Что касается цены за вход и выход у каждой модели и правил тарификации кэша — ориентируйтесь на фактические данные со страницы цен APIYI https://docs.apiyi.com/models; конкретные цифры в этой статье не приводятся.
Сравнение подходов к доводке AI-агента
| Подход | Ключевая идея | Когда подходит | Основные ограничения |
|---|---|---|---|
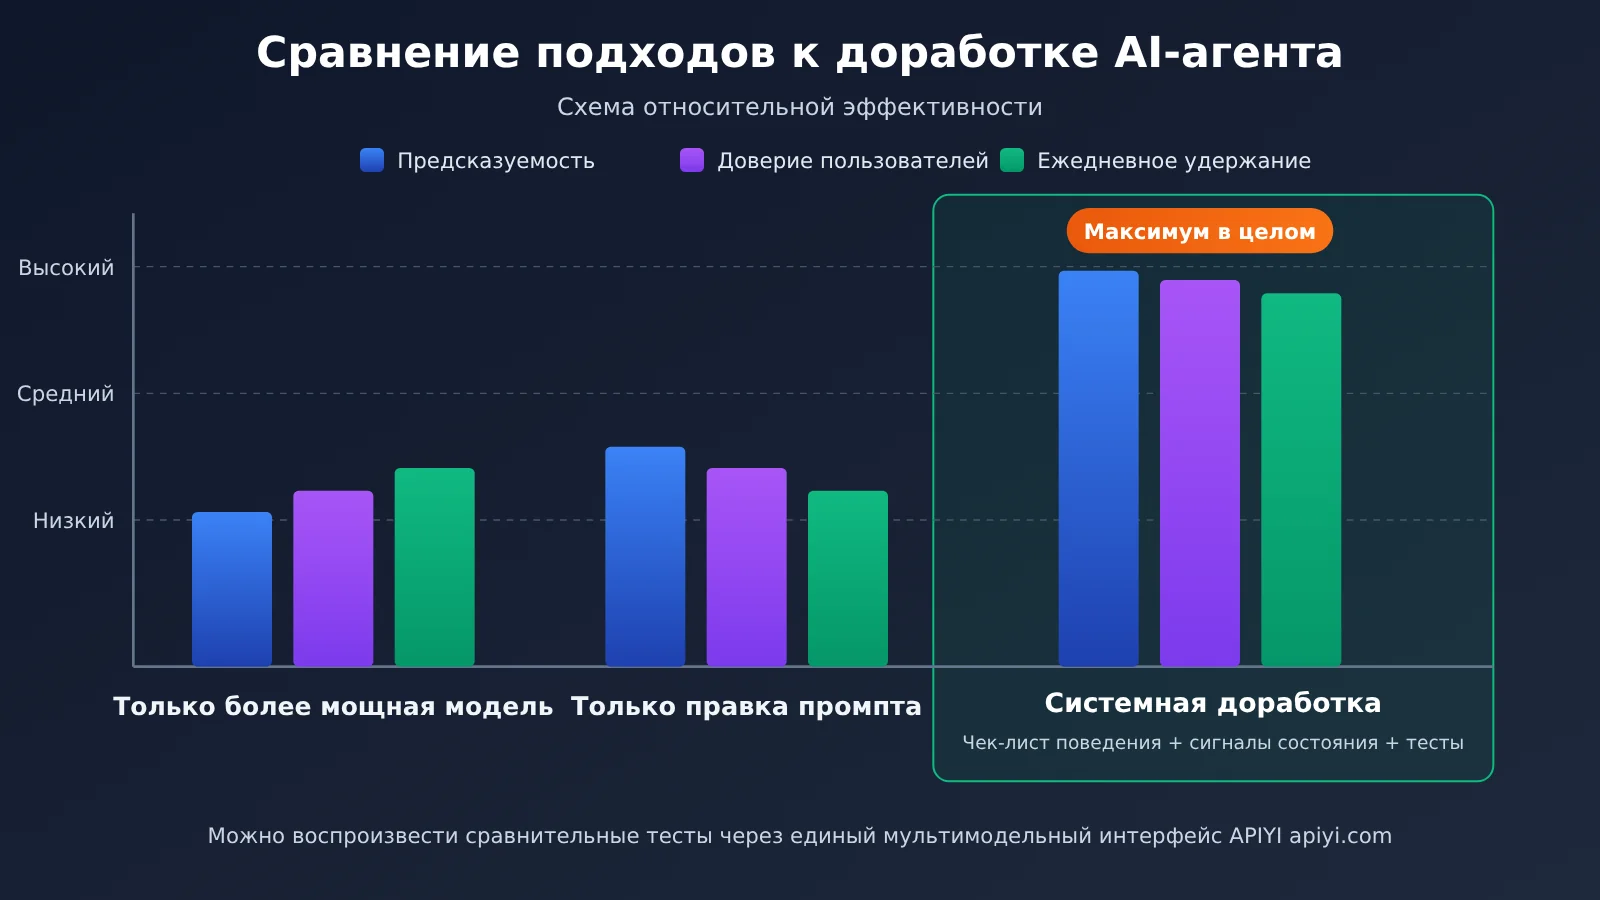
| Заменить только на более сильную модель | Обновить базовую модель в надежде, что опыт сам станет лучше | Ранние прототипы с явной нехваткой возможностей | Растёт стоимость, а проблемы поведения — подтверждения, отчёты о ходе работы и т. п. — остаются |
| Изменить только промпт | Накидывать правила в системный промпт | Точечные правки отдельных проблем | Правила накапливаются хаотично и без тестов легко конфликтуют друг с другом |
| Системная доводка | Чек-лист поведения + границы автономности + сигналы состояния + тестовый набор | Повседневный агент для задач, работающий с реальными пользователями | Большие первоначальные вложения; нужен человек, отвечающий за общий опыт |
Разбор сравнения подходов к доводке AI-агента
Разбор подхода «только заменить модель»: более сильная модель действительно выигрывает в сложных рассуждениях, но сама по себе не знает, какие действия в вашем продукте нужно сначала подтверждать и как показывать прогресс. Для сравнения, системная доводка напрямую работает с трением, которое чувствует пользователь; Muse — пример того, как можно добиться неплохого раннего роста, не опираясь на самую сильную модель.
Разбор подхода «только править промпт»: правки промпта быстро дают эффект и хорошо подходят для точечных проблем. Но без чек-листа поведения и тестового набора правила легко конфликтуют: исправляешь одно — страдает другое. Для агента, который будет работать долго, системная доводка надёжнее.
💡 Пояснение к сравнению: различия между подходами лучше проверять на собственных бизнес-данных. Через APIYI apiyi.com можно прогнать один и тот же тестовый набор на нескольких моделях и сравнить результаты, а затем вместе с данными со страницы цен оценить затраты и отдачу.
Частые вопросы о доработке AI-агентов
Вопрос 1: Что конкретно означает «доработка AI-агента»?
Это когда поведение агента в реальных задачах по пунктам тестируют, корректируют и фиксируют: когда он спрашивает подтверждение, когда действует самостоятельно, как сообщает о прогрессе, как объясняет ошибку, — и при этом пользователь в любой момент видит текущее состояние агента. Это измеримая инженерная работа, а не расплывчатое «улучшение опыта».
Вопрос 2: Чем настройка поведения отличается от промпт-инжиниринга?
Промпт-инжиниринг — лишь один из инструментов, а настройка поведения — это цель и методология. Сначала определяют «список ожидаемого поведения» и тестовый набор, затем реализуют его промптами, дизайном инструментов, фронтенд-взаимодействием и другими способами, и постоянно прогоняют регрессию. Менять только промпты, не создавая тестовый набор, — сложно гарантировать согласованность.
Вопрос 3: Каковы масштаб пользователей и размер команды Muse?
По сообщениям, примерно за шесть недель после запуска Muse набрал 10 миллионов пользователей. По словам Alexander Wang, команды модели и продукта вместе — менее 200 человек. Для привычного для Meta масштаба в миллиарды пользователей это лишь ранний результат; впереди ещё снижение стоимости обслуживания и расширение.
Вопрос 4: Для каких сценариев агента лучше всего подходит видимость состояния?
В основном для следующих сценариев:
— **Поручения и задачи**: отмена подписок, отслеживание счетов, заполнение форм и другие многошаговые операции;
— **Длительные задачи**: нужно зайти на несколько сайтов или вызвать несколько инструментов, выполнение занимает много времени;
— **Операции с высоким риском**: платежи, удаление, отправка вовне — процессы, где нужно явное подтверждение пользователя.
Вопрос 5: Как быстро развернуть тестовую среду для доработки агента с несколькими моделями?
Можно действовать так:
1. Зарегистрируйтесь в APIYI apiyi.com и получите API-ключ;
2. Сверьтесь с центром документации docs.apiyi.com и подключитесь в формате, совместимом с OpenAI или Anthropic;
3. Используя один и тот же набор поведенческих тестов, последовательно переключайте параметр `model` и прогоняйте сравнение;
4. Опираясь на фактические данные о тарификации со страницы цен https://docs.apiyi.com/models, выберите подходящую комбинацию моделей.
Вопрос 6: Каковы издержки и ограничения системной доработки?
— **Начальные вложения**: на составление списка поведения и тестового набора нужно время, и поначалу «новых фич» не видно;
— **Стоимость вызовов**: регрессионные тесты раз за разом вызывают модели, тарификация — по странице цен используемой платформы;
— **Организационные требования**: нужен человек, который принимает решения по общему опыту, иначе граничные правила из-за компромиссов разных сторон будут несогласованными;
— **Ограничения**: доработка не закрывает жёсткие пробелы в возможностях модели; если способностей явно не хватает, всё равно придётся менять модель.
Ключевые выводы: как довести AI-агента до ума
- Доводку можно тестировать: перед запуском Muse команда настроила больше сотни конкретных моделей поведения;
- Удобство — не то же самое, что максимальный интеллект: преимущество Muse в снижении трения при использовании, а не в самой сильной модели;
- Границы должны утверждаться людьми: правила автономного выполнения и предварительного подтверждения нужно унифицировать, нельзя позволять каждому модулю решать самому;
- Состояние должно быть видимым: сигналы должны отвечать пользователю на вопросы «она поняла? она делает? она сделала?»;
- Мелочи тоже важны: к ошибкам, прерываниям, второй вкладке и демонстрационному сценарию нужно относиться так же серьёзно;
- Сравнение нескольких моделей надёжнее: через единый интерфейс APIYI можно сравнивать разные модели на одном и том же наборе тестов.
Итог
Ключевые моменты доводки AI-агента:
- Настройка поведения: соберите точки принятия решений в чек-лист, для каждого пункта укажите условие срабатывания, ожидаемое поведение и контрпример, а затем постоянно прогоняйте регрессию на тестовом наборе;
- Видимость состояния: сведите внутренние состояния к нескольким сигналам, которые пользователь способен понять, и проведите их через весь процесс — понимание, выполнение, подтверждение, завершение и ошибка;
- Постоянные итерации: ищите точки трения в записях реального использования и доводите до второго, третьего прохода, вместо того чтобы бесконечно переделывать первую версию.
Опыт Muse применим и к небольшим командам: маленькая команда отвечает за ключевые решения, относится к скучным деталям серьёзно, а после провала меняет то, что действительно важно, и пробует снова. Для всего этого не нужно сначала потерять десятки миллиардов.
Если вы собираетесь построить набор поведенческих тестов для своего агента, через APIYI apiyi.com можно быстро сравнить несколько моделей. Платформа совместима с форматами API OpenAI и Anthropic, инструкция по подключению — на docs.apiyi.com, тарифы смотрите на странице цен https://docs.apiyi.com/models.
📚 Справочные материалы
- MindStudio — разбор кейса Meta’s Muse: предыстория Muse, команда и детали доводки продукта
- Ссылка:
mindstudio.ai/blog/meta-muse-ai-companion-lessons -
Пояснение: основной источник фактов для этого кейса, опубликован 4 ноября 2026 года
-
Центр документации APIYI: инструкция по единому подключению разных моделей
- Ссылка:
docs.apiyi.com -
Пояснение: как подключаться в форматах, совместимых с OpenAI и Anthropic
-
Страница цен на модели APIYI: принципы тарификации и стоимость каждой модели
- Ссылка:
docs.apiyi.com/models - Пояснение: цены на входные и выходные токены, а также стоимость кеширования — по фактическим данным на этой странице
Автор: техническая команда APIYI
Обсудить технические вопросы: будем рады пообщаться о практике доработки агентов — пишите нам на официальном сайте APIYI apiyi.com. Больше материалов — в центре документации docs.apiyi.com