Nota do autor: invocação de gpt-6.1-sol bem-sucedida, mas o texto principal veio vazio? A documentação registra completion_tokens 300, todos reasoning_tokens, sem uma única palavra no texto principal. Este artigo explica o motivo e duas soluções.
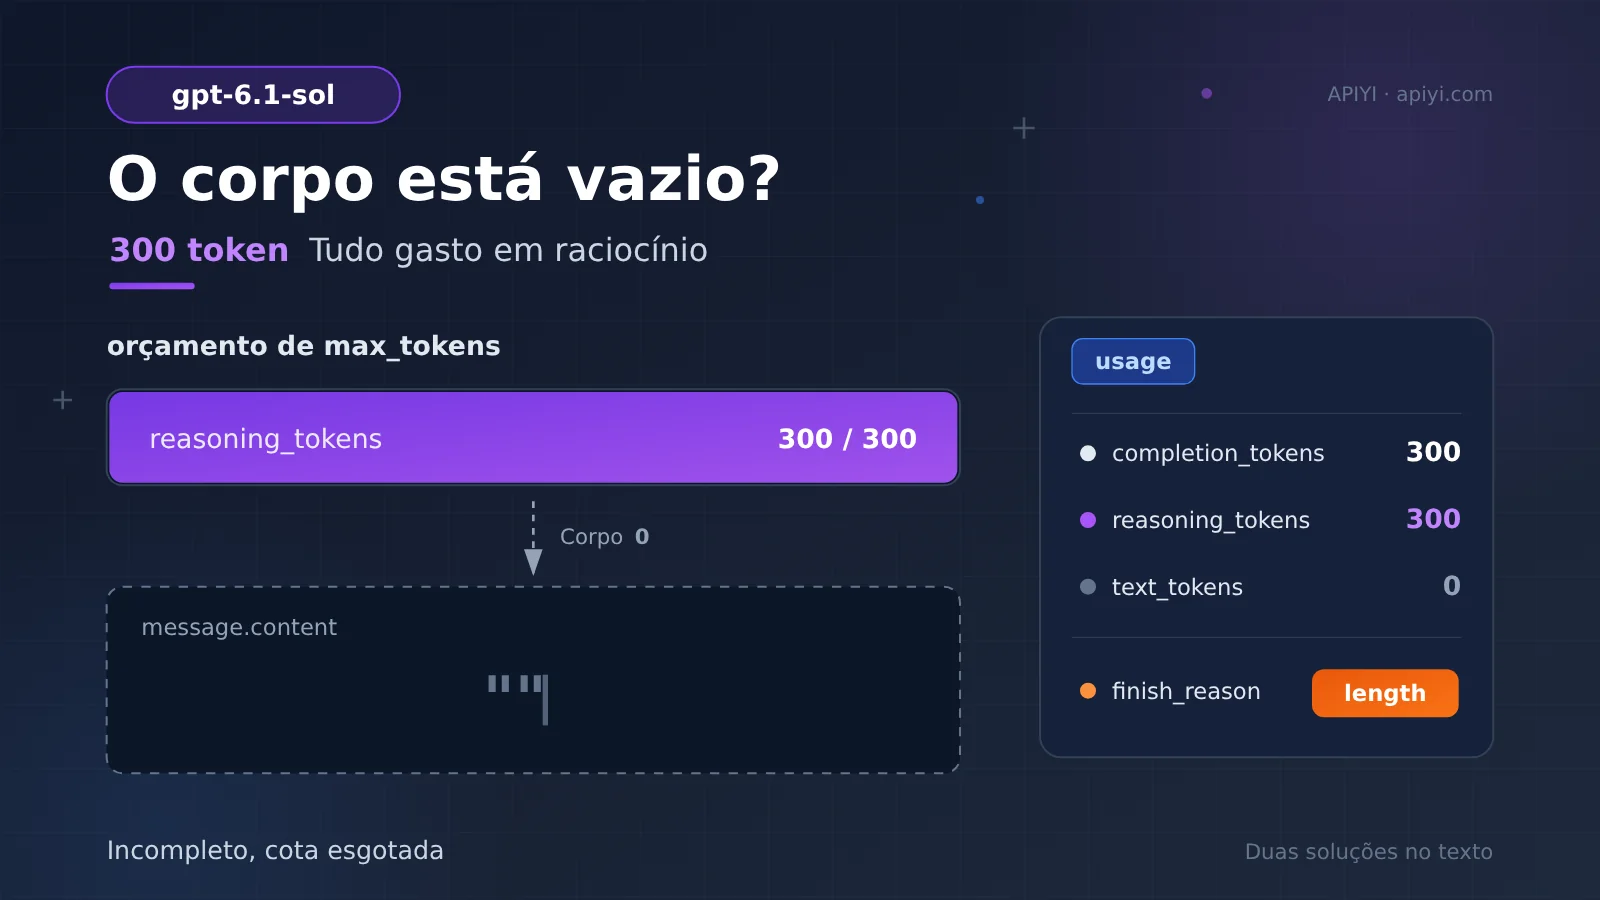
Se você acabou de invocar gpt-6.1-sol, a API não retornou erro, mas o message.content recebido é uma string vazia, não pense logo que a rede ou o modelo quebrou. Dê uma olhada no usage da resposta: completion_tokens é 300, reasoning_tokens também é 300, text_tokens é 0. Ou seja, esses 300 tokens foram todos gastos no raciocínio, e nenhuma palavra foi escrita no texto principal.
Não se trata de um problema místico ocasional, nem de o modelo estar com preguiça. A documentação registra que o processo de raciocínio e o texto final do gpt-6.1-sol compartilham a mesma cota de max_tokens; quando o raciocínio ainda não terminou e a cota acaba primeiro, o texto principal é truncado por completo. Muitos desenvolvedores que invocam gpt-6.1-sol na APIYI (apiyi.com), ao se depararem com esse fenômeno pela primeira vez, pensam que a plataforma apresentou falha.
Este não é mais um artigo genérico de introdução a modelos de raciocínio, e sim um guia de diagnóstico para o sintoma específico de “conteúdo vazio”. Depois de ler este artigo, você vai entender o que aqueles números no usage estão dizendo e, com duas mudanças no nível dos parâmetros, fazer o texto principal ser gerado normalmente.
Pontos principais do corpo vazio do gpt-6.1-sol
Primeiro a conclusão; os detalhes ficam para depois. Algumas informações-chave registradas na documentação determinam como você deve investigar em seguida:
| Ponto | O que a documentação diz | Por que isso importa |
|---|---|---|
| Cota compartilhada entre raciocínio e corpo da resposta | Tanto o processo de raciocínio quanto a resposta final do gpt-6.1-sol são descontados de max_tokens |
Entender a raiz do corpo vazio |
| 300 tokens só no raciocínio | completion_tokens 300 é igual a reasoning_tokens 300, e text_tokens é 0 |
Identificar o tipo de problema de imediato |
| Duas manifestações externas | Retorna o código de erro empty_response, ou HTTP 200 mas com o corpo sendo uma string vazia |
Não se deixar enganar pelo “falso sucesso” |
| Tentar novamente quase não adianta | Mesmo comando, mesmo max_tokens, enviar de novo dá praticamente o mesmo resultado |
Evita perder tempo |
Onde foram parar esses 300 tokens
Para entender o corpo vazio, é preciso primeiro entender como o gpt-6.1-sol responde. Ele é um modelo de raciocínio: antes de começar a escrever de fato, ele faz um “rascunho” interno — decompõe o problema, testa caminhos e se autoavalia. Esse rascunho é justamente a parte contabilizada em reasoning_tokens.
O ponto central é que, segundo a documentação, o rascunho e o corpo da resposta não usam duas cotas independentes, mas compartilham o mesmo max_tokens. Quando max_tokens é definido na faixa de aproximadamente 200 a 500 e a tarefa realmente exige raciocínio, é fácil a cota se esgotar na fase de pensamento: o raciocínio ainda não terminou, o corpo da resposta nem começou e a cota já acabou. O que volta para você é, naturalmente, um corpo vazio.
O conjunto de números da documentação é bastante explícito:
completion_tokens: 300 — volume total de geração concluído nesta chamadareasoning_tokens: 300 — a parte disso gasta em raciocíniotext_tokens: 0 — a parte efetivamente escrita no corpo da respostafinish_reason:length— o motivo da parada foi atingir o limite de comprimento, e não um encerramento normal
completion_tokens exatamente igual a reasoning_tokens e text_tokens zerado: essa é praticamente a assinatura padrão de “cota toda consumida pelo raciocínio”. Somado a finish_reason em length, dá para confirmar que o modelo não é que “não quer responder”; é que “não tem cota para responder”. O limite atingido nesta chamada também cai justamente na faixa de 200 a 500 que a documentação aponta como fácil de esgotar.
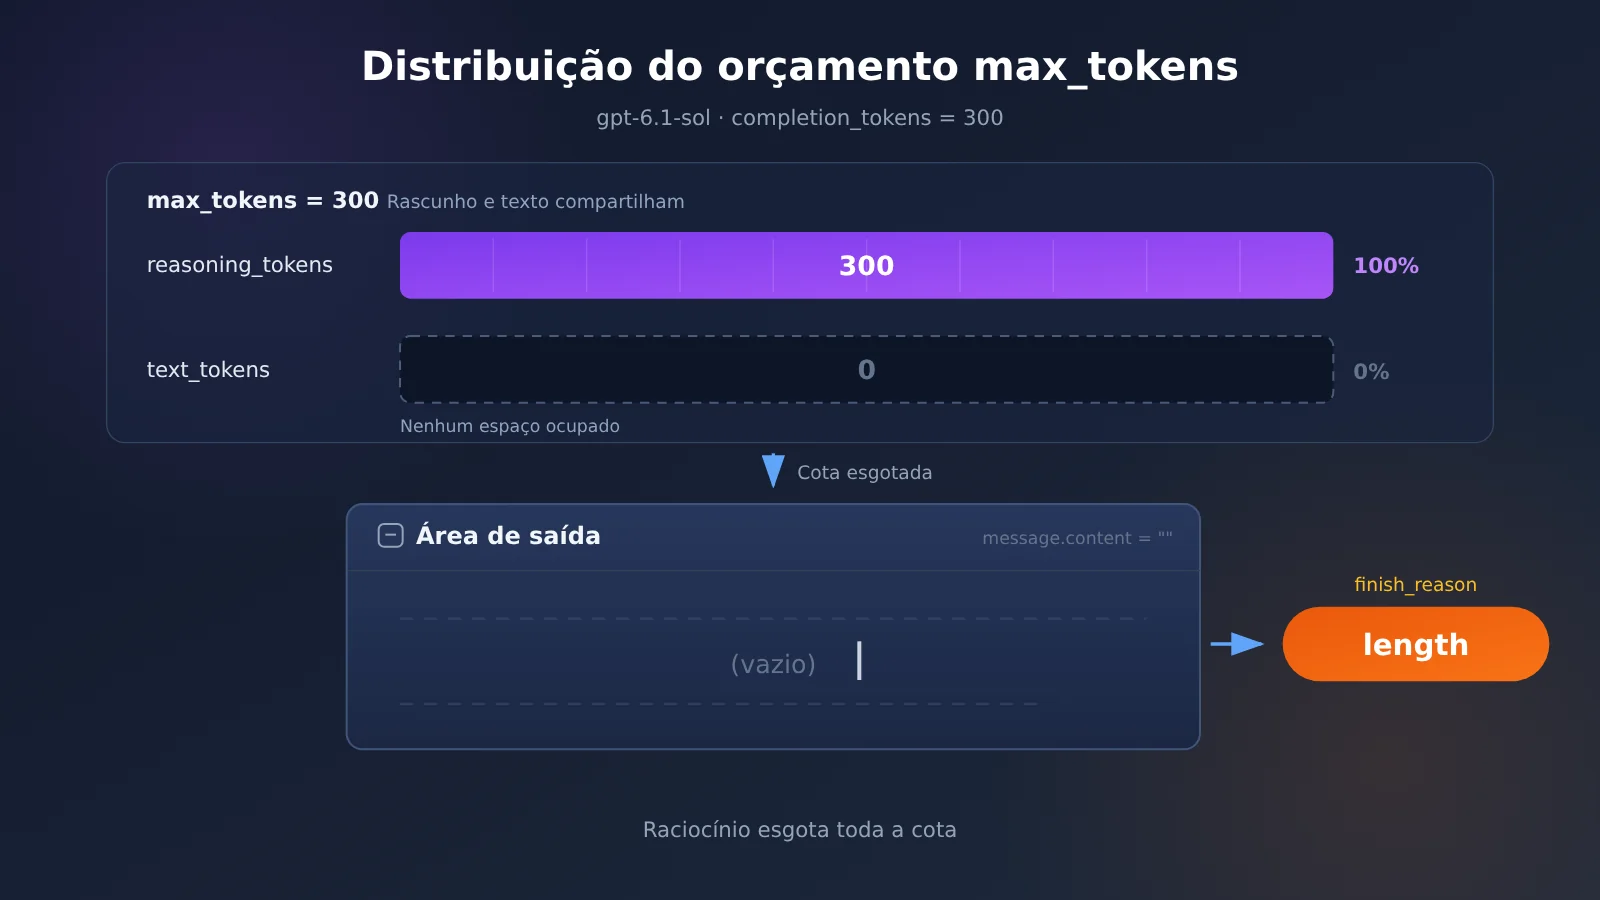
A imagem acima descreve exatamente como o orçamento desta chamada foi distribuído. O texto original completo com o significado dos campos está no centro de documentação da APIYI; vale conferir o original mais uma vez para confirmar os detalhes e evitar mudar parâmetros de memória.
As duas manifestações externas do corpo vazio
A mesma causa tem duas manifestações na camada da API, e a documentação registra ambas. Uma é o erro direto, retornando o código de erro empty_response, com a requisição explicitamente marcada como anômala. A outra é o “falso sucesso”: HTTP 200, tudo parece normal, mas message.content é uma string vazia.
A segunda é bem mais enganosa. O status code é de sucesso, o tempo de execução é normal e, sem olhar o usage, não dá para descobrir que o corpo está vazio. Por isso, ao se deparar com “API respondeu com sucesso, mas o conteúdo está vazio”, a primeira reação deve ser verificar o usage, não a rede.
| Manifestação externa | Conteúdo retornado | Critério de diagnóstico |
|---|---|---|
| Erro direto | Código de erro empty_response |
Visível de imediato |
| Falso sucesso | HTTP 200, message.content é uma string vazia |
É preciso verificar o usage e o finish_reason |
Como confirmar a causa do corpo vazio no gpt-6.1-sol
O diagnóstico não é complicado: quatro passos bastam. A ordem recomendada é começar pelo usage:
- Verifique se
completion_tokensereasoning_tokenssão iguais. Se forem iguais, isso indica que todo o volume gerado foi usado para raciocínio, e o corpo da resposta não recebeu nenhuma cota. - Verifique se
text_tokensé 0. Se estiver zerado, significa que nenhum texto do corpo foi escrito; é a evidência mais direta. - Verifique se
finish_reasonélength. Se forlengthem vez de um encerramento normal, isso indica que o modelo foi interrompido pelo limite. - Relembre sua configuração de
max_tokens. Se estiver na faixa de 200 a 500 e a tarefa também exigir raciocínio, basicamente já dá para identificar o problema.
Depois de confirmar, há uma coisa que você pode eliminar de imediato: repetir a chamada exatamente como está. A documentação registra que, com o mesmo comando e o mesmo max_tokens, repetir praticamente não resolve. Porque não se trata de instabilidade de rede, mas de um resultado inevitável da distribuição de cota — se enviar de novo, o orçamento continua o mesmo e o raciocínio vai continuar consumindo tudo primeiro.
Se você chama o gpt-6.1-sol por uma plataforma agregadora, os pontos de diagnóstico normalmente ficam assim:
- Endereço da plataforma: APIYI apiyi.com
- URL da API:
https://api.apiyi.com/v1 - Nome do modelo:
gpt-6.1-sol - Padrão da API: compatível com OpenAI, com a mesma semântica de parâmetros da API oficial
Sugestão: obtenha uma cota gratuita de teste pela APIYI apiyi.com, compare as respostas com o mesmo comando em diferentes valores de
max_tokense, em poucos minutos, você confirma que o problema está na distribuição de cota, e não no modelo em si.
A causa está clara, então a solução flui naturalmente — e as direções são apenas duas: dar espaço para o corpo do texto, ou fazer o modelo pensar um pouco menos. Cada solução atende a um tipo diferente de tarefa; não misture as duas.
Solução um: aumentar max_tokens. O valor de referência da documentação é: conversas comuns a partir de 2000; tarefas de raciocínio complexo ou textos longos, 16000 ou mais. Essa ordem de grandeza não é chute — o próprio rascunho de raciocínio pode ser longo, e o corpo do texto ainda precisa de espaço adicional; 2000 é só a linha de partida para uma conversa comum.
Solução dois: reduzir reasoning_effort. Se a tarefa não exige raciocínio profundo — por exemplo, uma reescrita simples, conversão de formato, uma pergunta e resposta de uma frase — dá para pedir ao modelo que “pense menos”. O consumo da fase de raciocínio cai, e a mesma cota passa a ser suficiente.
| Solução | Abordagem | Cenário aplicável | Efeito esperado |
|---|---|---|---|
Aumentar max_tokens |
Conversa comum a partir de 2000; raciocínio complexo e textos longos, 16000+ | Tarefas que exigem qualidade completa de raciocínio | Resolve na raiz |
Reduzir reasoning_effort |
Reduzir a intensidade de raciocínio | Tarefas leves, com baixa exigência de profundidade de raciocínio | Reduz o consumo de raciocínio |
| Repetir com os parâmetros originais | Não mudar nada e enviar de novo | Basicamente ineficaz | Não recomendado |
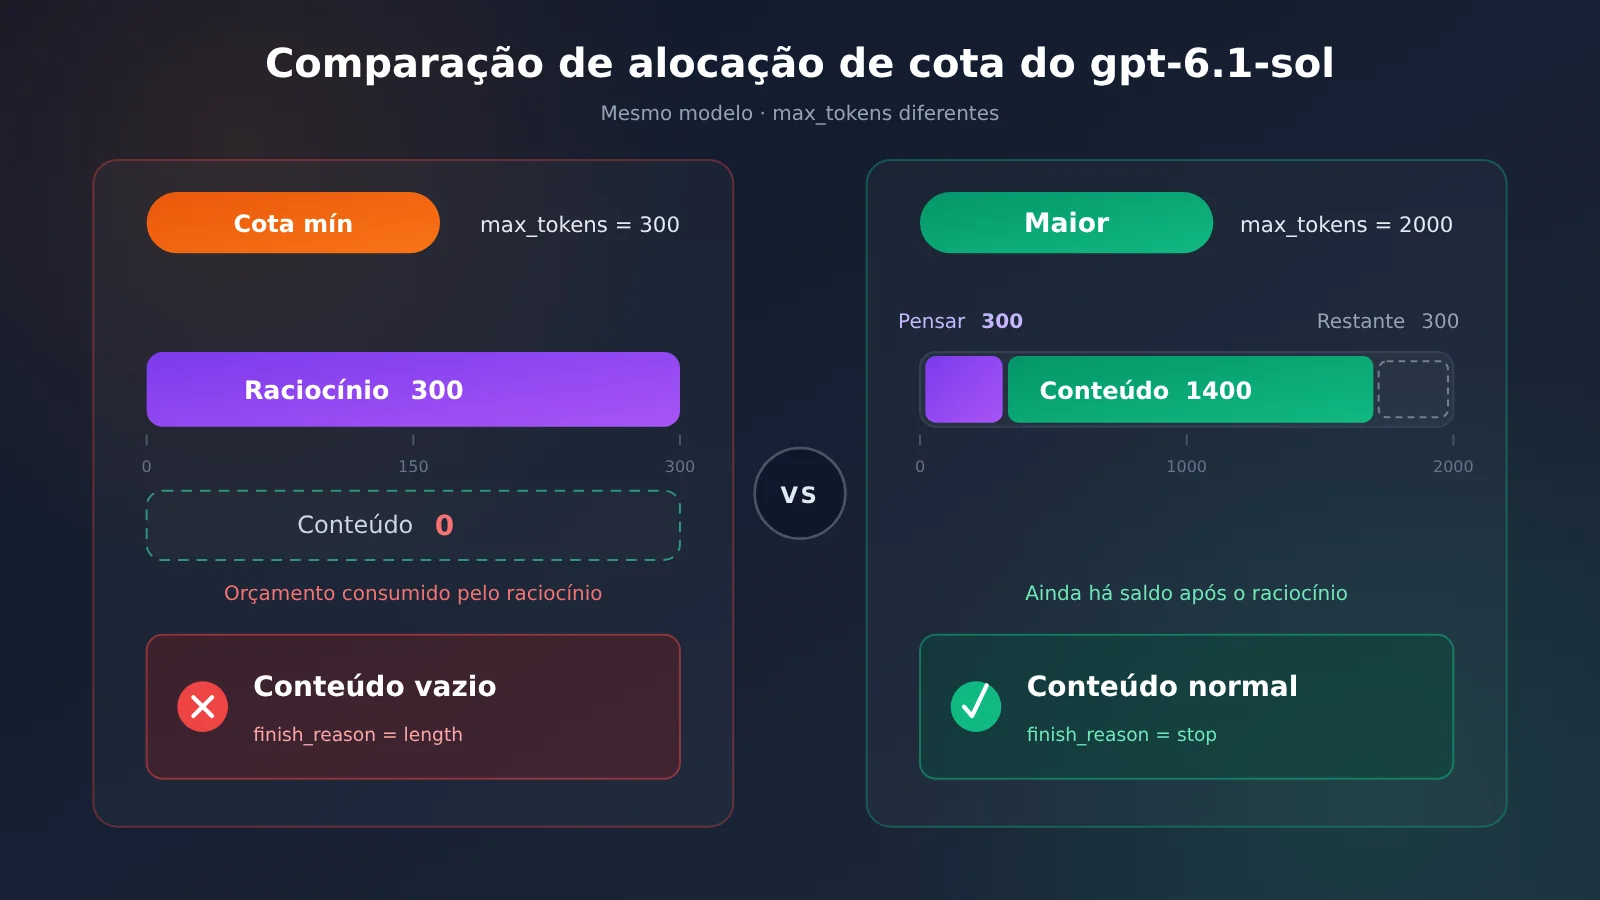
Leitura comparativa das soluções
Aumentar max_tokens é a opção preferida. Não muda a forma como o modelo pensa, apenas troca o “rascunho” por um maior, e a qualidade do raciocínio não é afetada. Depois de aumentar o limite, o raciocínio segue normalmente, o corpo do texto também recebe sua cota, e text_tokens deixa naturalmente de ser 0.
Reduzir reasoning_effort serve para outra classe de cenários: a tarefa em si não exige raciocínio profundo, mas o modelo rodou o raciocínio completo por padrão. Depois de reduzir, o consumo de raciocínio diminui e a resposta fica mais rápida; mas para tarefas complexas não é recomendável fazer isso, porque comprimir a profundidade do raciocínio pode prejudicar a qualidade da resposta.
Repetir com os parâmetros originais merece menção separada porque é a reação errada mais comum. A documentação registra que, com o mesmo comando e o mesmo max_tokens, repetir basicamente não adianta — não é questão de sorte, é questão de aritmética. A diferença entre os dois cenários da imagem acima também pode ser reproduzida na plataforma APIYI apiyi.com com o mesmo comando, e em dois minutos você vê o resultado comparativo.
Aumentar max_tokens deixa mais caro?
Muita gente não ousa aumentar max_tokens com medo de a conta explodir. Aqui a documentação traz uma observação fundamental: max_tokens é um limite, não o consumo real; a cobrança é feita pelos tokens realmente gerados.
Em outras palavras, mudar max_tokens de 300 para 2000 não significa que cada chamada será cobrada como 2000. Cobra-se pelo quanto o raciocínio usou e pelo quanto o corpo escreveu; a parte não utilizada do limite não gera custo. Aumentar o limite, no fundo, é dar espaço de sobrevivência ao corpo do texto, e não pré-pagar uma despesa maior. A APIYI apiyi.com adota o modelo de cobrança por uso; o preço unitário específico deve ser consultado na página de preços da plataforma, e este artigo não cita números concretos.
Perguntas frequentes sobre o corpo vazio do gpt-6.1-sol
Q1: O que é o “corpo vazio” do gpt-6.1-sol?
Ao chamar o `gpt-6.1-sol`, o processo de raciocínio e o corpo da resposta compartilham o mesmo `max_tokens`. O raciocínio consome todo o limite primeiro, o corpo é cortado por inteiro e o resultado fica vazio. Nos números registrados na documentação, os 300 `completion_tokens` são todos `reasoning_tokens`, e `text_tokens` é 0.
Q2: HTTP 200 também conta como anomalia?
Conta. A documentação registra que o corpo vazio tem duas manifestações: o código de erro `empty_response`, ou HTTP 200 com `message.content` sendo uma string vazia. Um status code de sucesso não significa que o conteúdo está normal — é preciso avaliar em conjunto com `text_tokens` e `finish_reason` no usage.
Q3: Por que tentar de novo não resolve?
A documentação registra que, com o mesmo comando e o mesmo `max_tokens`, tentar de novo praticamente não muda nada. Isso porque a distribuição do limite é determinística: se o orçamento não muda, o raciocínio continua consumindo tudo primeiro. Para mudar o resultado, é preciso alterar os parâmetros, não apostar na sorte.
Q4: Então o modelo não respondeu?
Não é que ele tenha se recusado a responder — é que não sobrou orçamento para responder. `finish_reason` igual a `length` indica que o modelo foi interrompido pelo limite, não que ele parou por conta própria. Depois de aumentar o `max_tokens`, a mesma pergunta passa a retornar o corpo da resposta.
Q5: Que tipo de configuração cai mais fácil nessa armadilha?
A documentação registra que, quando `max_tokens` é definido em torno de 200 a 500 e a tarefa exige raciocínio, o limite se esgota já na fase de pensamento. Essa faixa pode ser suficiente para modelos de conversa comuns, mas para modelos de raciocínio como o `gpt-6.1-sol`, muitas vezes nem dá para terminar o rascunho.
Q6: Como verificar rapidamente se a correção funcionou?
Recomendo fazer uma validação comparativa na APIYI apiyi.com: registre uma conta e obtenha crédito gratuito de teste, preencha o endereço da interface com `https://api.apiyi.com/v1`, selecione o modelo `gpt-6.1-sol` e então:
1. Use o mesmo comando, ajuste o `max_tokens` para 2000 e envie novamente
2. Verifique se `text_tokens` é maior que 0
3. Verifique se `message.content` contém o corpo da resposta
Comparando na mesma plataforma e com o mesmo comando, a única variável é o parâmetro — e a conclusão fica mais limpa.
Q7: Aumentar o max_tokens encarece a chamada?
Não há cobrança pelo limite máximo. A documentação registra que `max_tokens` é um teto, não o consumo real; a cobrança é feita pelos tokens efetivamente gerados. O que for realmente produzido — raciocínio mais corpo — é o que se paga. Os preços unitários específicos estão na página de preços da APIYI.
Q8: Modelos não raciocinadores também apresentam isso?
A documentação registra que modelos não raciocinadores não apresentam esse corpo vazio. Como não há fase de pensamento, todo o `max_tokens` fica disponível para o corpo; com limite pequeno, o resultado é apenas uma resposta truncada, não um conteúdo totalmente vazio. Esse também é um dos critérios para decidir se vale trocar de modelo.
gpt-6.1-sol corpo vazio: pontos-chave (Key Takeaways)
- Raiz do corpo vazio: o raciocínio (reasoning) e o texto compartilham o
max_tokens, e o raciocínio consome primeiro toda a cota - Sinal de diagnóstico:
completion_tokensé igual areasoning_tokensetext_tokensé 0 - Duas manifestações: código de erro
empty_responseou HTTP 200 com string vazia - Solução preferida: conversas normais a partir de 2000; raciocínio complexo e textos longos, 16000 ou mais
- Alternativa leve: reduzir o
reasoning_effortpara comprimir o consumo de raciocínio - Não faça trabalho inútil: tentar novamente com os mesmos parâmetros é basicamente ineficaz
- Lógica de cobrança:
max_tokensé o limite superior; a cobrança é pelo que de fato foi gerado
Resumo
Olhando para trás, os pontos-chave do corpo vazio do gpt-6.1-sol são na verdade bem claros:
- Causa: o raciocínio e o texto compartilham o
max_tokens. Aquela série de 300 números era toda dereasoning_tokens, comtext_tokensem 0 efinish_reasonemlength. - Correção: aumente o
max_tokens(conversas normais a partir de 2000; raciocínio complexo, 16000 ou mais) ou reduza oreasoning_effort; tentar novamente com os parâmetros originais é basicamente ineficaz. - Cobrança:
max_tokensé o limite superior, não o consumo; a cobrança é pelos tokens realmente gerados, então não se preocupe em aumentar.
Da próxima vez que aparecer “a interface funcionou, mas o corpo está vazio”, primeiro dê uma olhada no usage e depois no finish_reason — em geral você localiza o problema em dez segundos. Recomendo verificar rapidamente o efeito da correção pelo serviço proxy de API APIYI apiyi.com: a plataforma oferece cota gratuita de teste e uma interface unificada para vários modelos, então basta mudar um parâmetro para comparar na hora.
Materiais de referência
- Central de documentação da APIYI: explicação sobre corpo vazio em modelos de raciocínio
- Link:
docs.apiyi.com/faq/reasoning-model-empty-response.md -
Descrição: registro original sobre as causas do corpo vazio, suas duas manifestações e as soluções
-
Boletim de documentação da APIYI: caso de corpo vazio do gpt-6.1-sol (2026-11)
- Link:
docs.apiyi.com/live/2026-11/reasoning-model-empty-response.md - Descrição: fonte dos números daquele grupo com
completion_tokens300 e dos valores sugeridos paramax_tokens
Autor: equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI; mais materiais estão disponíveis na central de documentação em docs.apiyi.com