Conclusão
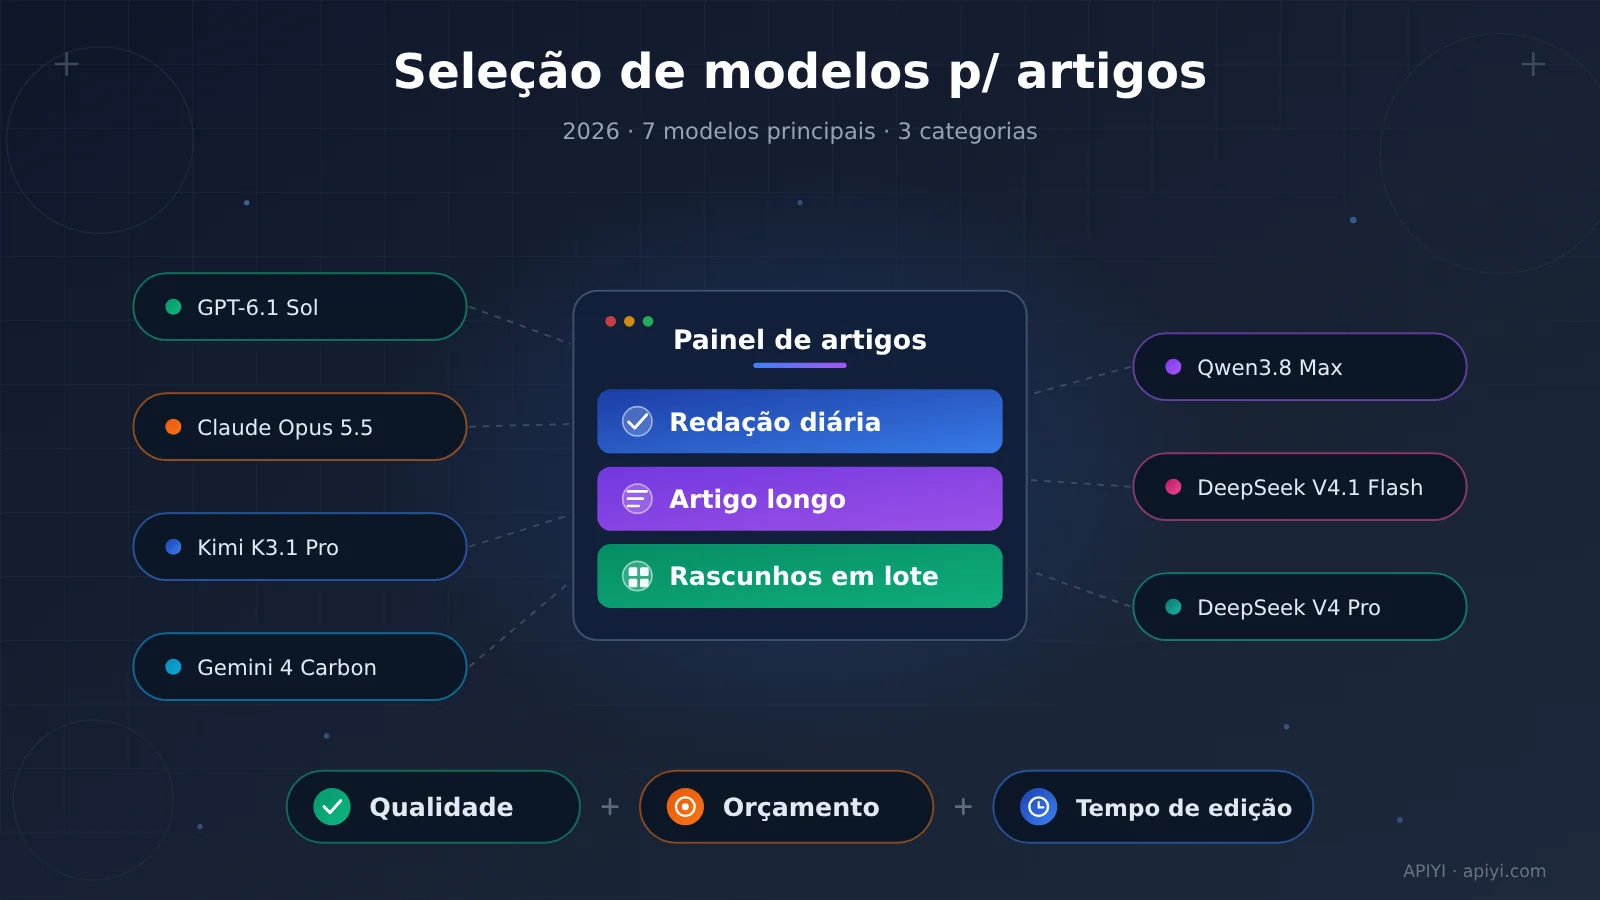
Para artigos do dia a dia, teste primeiro o GPT-6.1 Sol; para textos longos e importantes, teste primeiro o Claude Opus 5.5; para primeiros rascunhos em lote, teste primeiro o DeepSeek V4.1 Flash. Em tarefas com muita densidade de informação, acrescente Kimi e Gemini; na produção estruturada, acrescente Qwen; e o DeepSeek Pro deve ser validado conforme a tarefa específica.
Esses são candidatos a teste, não uma lista de campeões de escrita em chinês. A combinação realmente vantajosa precisa considerar ao mesmo tempo a compreensão do material, a qualidade do artigo, o custo das invocações e o tempo gasto na edição e revisão.
O que este texto ainda vai abordar
- O que cada um dos três tipos de teste de escrita pode revelar.
- Quais são as diferenças práticas entre os sete modelos.
- Como definir o modelo principal e a alternativa para diferentes tarefas de operação.
- Como calcular custos e realizar testes cegos com uma interface unificada.
Qual Modelo de Linguagem Grande escolher para escrever artigos de operação: comece entendendo os critérios de teste
Um benchmark de modelo é um conjunto de testes que mede o desempenho dos modelos em tarefas padronizadas. Na escolha para operação, a prioridade deve ser dada aos testes mais próximos do fluxo real de produção: mesmos materiais, mesmo planejamento, mesma extensão e, só então, comparar o texto final.
Qual modelo escolher para escrever artigos de operação: notas em inglês servem para filtrar candidatos
O AI Writing Benchmark foi atualizado em 11 de novembro de 2026 e passou a usar tarefas comuns de redação em inglês, com nomes de modelos ocultos na comparação, cobrindo 115 modelos e 131,507 avaliações cegas.
A pontuação geral de inglês do GPT-6.1 Sol é 95.3, e a nota em artigos, blogs e conteúdo editorial é 98.5. Claude Opus 5.5 e Kimi K3.1 Pro ficaram com 92.9 e 91.9, respectivamente, todas dentro da faixa de referência.
Falando sem rodeios: vale a pena colocar o GPT no pool de candidatos para escrever blogs; já se o artigo para conta oficial em chinês vai exigir menos rodadas de revisão, isso ainda precisa ser testado localmente. O projeto é mantido por uma pessoa física, então o idioma e o método de avaliação também precisam entrar na decisão.
Atenção especial às versões: quem lidera na categoria de explicação e divulgação científica é o Kimi K3; no ToneBench, o item “menos cara de template” com 89.0 corresponde ao GPT-6 Sol. São duas notas que pertencem a nomes de versões antigas.
Qual modelo escolher para escrever artigos de operação: o teste de roteiro chega mais perto da escrita a partir de um pacote de materiais
O snapshot do ToneBench de 10 de novembro de 2026 avalia roteiros longos de vídeo em inglês: o modelo lê os requisitos de criação e um pacote de materiais de pesquisa, gera com o “livro fechado”, e o teste cobre 87 modelos, 151 configurações e 7,550 roteiros.
A tabela abaixo reproduz o Writing Score das configurações selecionadas. Claude usa a configuração xhigh; cada linha segue a configuração de raciocínio do respectivo teste, sem unificar o orçamento de computação. Por isso aqui listamos apenas as notas, sem misturar rankings de modelos com rankings de configurações.
| Modelo | Writing Score | Custo estimado por roteiro no teste |
|---|---|---|
| GPT-6.1 Sol | 82.4 | $0.239 |
| Claude Opus 5.5, xhigh | 85.8 | $1.003 |
| Kimi K3.1 Pro | 82.5 | $0.251 |
| Gemini 4 Carbon | 80.1 | $0.586 |
| Qwen3.8 Max | 76.8 | $0.207 |
| DeepSeek V4.1 Flash, versão 1017 | 81.6 | $0.014 |
| DeepSeek V4 Pro | 80.1 | $0.077 |
O sinal principal é: o Opus é o indicado para testar primeiro manuscritos longos de alta qualidade, e o Flash mostrou competitividade com custo baixo. Os valores da tabela correspondem à carga de trabalho de roteiro desse teste e não podem ser aplicados diretamente como preço de um artigo de operação em chinês.
Esse teste usa avaliação feita por modelos, então existe preferência por fornecedor; os intervalos de confiança das configurações líderes se sobrepõem, e mudanças nos roteiros de referência também podem mexer no topo da lista. Ele serve para estreitar o leque de candidatos, que depois devem ser validados por um editor.
Nota sobre a ilustração: a seguir, mostramos a distribuição dos candidatos por qualidade e custo; os dados vêm do snapshot do ToneBench citado acima. Ao refazer o teste via APIYI apiyi.com, registre separadamente seus próprios tokens, configuração e tempo de edição.
Qual Modelo de Linguagem Grande escolher para escrever artigos para operações: evidências em chinês para avaliar o escopo de aplicação
A OmniTools testou, entre 26 de outubro e 3 de novembro de 2026, matérias financeiras aprofundadas em chinês: 10 modelos geraram, no total, 26 artigos. A pontuação do Opus 5.5 na avaliação cega por IA foi 8,25; a do GPT-6.1 Sol, 6,33.
Isso dá ao Opus uma base para ser considerado candidato a textos longos em chinês. Mas a amostra é pequena, o número de artigos varia entre os modelos e a parte responsável pelo teste tem histórico em serviços comerciais de roteamento; por isso, a conclusão deve ficar limitada a esse caso de textos longos de finanças.
Qual Modelo de Linguagem Grande escolher para escrever artigos para operações: sete modelos analisados um a um
Qual Modelo de Linguagem Grande escolher para escrever artigos para operações: como dividir tarefas entre GPT e Claude
GPT-6.1 Sol: candidato prioritário para a produção diária de textos. Teve desempenho destacado na categoria de artigos em inglês, sendo adequado testá-lo primeiro em blogs de tecnologia, análises de produtos e análise de notícias. A naturalidade em chinês e a precisão das citações devem ser pontuadas separadamente.
Claude Opus 5.5: candidato prioritário para textos longos importantes. Tanto o teste de script quanto o caso financeiro em chinês oferecem apoio. Para especiais e textos longos de marca, pode-se testá-lo primeiro; já para textos curtos de alta frequência, convém comparar se o ganho incremental de qualidade vale o custo mais alto.
Qual Modelo de Linguagem Grande escolher para escrever artigos para operações: como usar Kimi, Gemini e Qwen
Kimi K3.1 Pro: candidato para tarefas com materiais longos. Cerca de 1M de tokens de janela de contexto e os resultados em escrita geral em inglês apoiam sua inclusão em testes de artigos intensivos em conhecimento. O desempenho da K3 na categoria de divulgação científica precisa ser visto separadamente.
Gemini 4 Carbon: candidato para análise de materiais complexos. Pode-se primeiro pedir que ele organize problemas de várias etapas, relações entre evidências e o esboço do artigo, e depois comparar o resultado da redação direta. As evidências atuais são mais adequadas para sustentar uma decisão de candidato.
Qwen3.8 Max: candidato para produção estruturada. Pode testar descrições de produtos, colunas fixas e conteúdo padronizado. Seu limite de contexto por requisição na inferência em lote é de 256K; antes da integração, é preciso verificar o suporte por região.
Qual Modelo de Linguagem Grande escolher para escrever artigos para operações: como escolher entre DeepSeek Flash e Pro
DeepSeek V4.1 Flash: candidato prioritário para rascunhos de baixo custo. No teste de script mencionado, equilibrou pontuação e custo, sendo adequado para rascunhos em lote, reescrita e explicações de conhecimento. Mantenha a revisão humana de fatos antes de publicar.
DeepSeek V4 Pro: candidato para tarefas específicas. A API continua disponível, mas, nesse teste de script, o Flash obteve pontuação mais alta. Só vale aumentar o orçamento se testes cegos em tarefas concretas comprovarem o benefício.
Qual Modelo de Linguagem Grande escolher para escrever artigos de operação: um plano em camadas por tarefa
A seguir está a ordem de testes definida com base nas evidências disponíveis; os resultados em chinês serão decididos por avaliação cega da equipe.
| Tarefa de operação | Candidato prioritário | Alternativa ou apoio |
|---|---|---|
| Notícias de tecnologia e blogs do dia a dia | GPT-6.1 Sol | Flash gera o rascunho inicial; GPT revisa |
| Análise aprofundada do setor e artigos longos de marca | Claude Opus 5.5 | Teste cego do GPT com o mesmo tema |
| Tutoriais técnicos e divulgação de conhecimento | GPT, Kimi K3.1 Pro | Flash como referência de baixo custo |
| Síntese de materiais longos e temas complexos | Kimi, Gemini | Primeiro organize as evidências; depois passe para o modelo de redação final |
| Artigos de marketing e conteúdo curto para redes sociais | GPT para testar primeiro conteúdo curto | Inclua o Opus nos artigos longos de marca |
| Conteúdo estruturado em lote | Qwen, Flash | Defina o principal pela taxa de adoção |
| Plataformas disponíveis | Interfaces oficiais correspondentes | APIYI apiyi.com para chamadas unificadas e comparação |
O modelo líder em inglês para as categorias de marketing e vendas é o Claude Sonnet 5.5, que está fora desses sete. Se os textos de marketing forem o negócio principal, vale expandir o conjunto de candidatos em vez de escolher o campeão apenas entre os modelos de texto longo.
Dica de início rápido: a APIYI apiyi.com oferece uma chave API para chamar vários modelos por meio de uma interface compatível com OpenAI, e novos usuários têm cota de teste gratuita. Primeiro compare três modelos com o mesmo tema e depois amplie o escopo dos testes.
Qual modelo escolher para escrever artigos de operações: calcular o custo até o rascunho aprovado
Token é a unidade de medida que o modelo usa para processar texto; os tokens de entrada incluem o comando, os materiais e o contexto, e os tokens de saída incluem o conteúdo gerado. Já a janela de contexto indica o intervalo que pode ser processado em uma única invocação.
A seguir, usamos o snapshot de preços da APIYI de 12 de novembro de 2026, 10:45, UTC+8, com valores em dólares por milhão de tokens. Os exemplos seguem o padrão de 10.000 tokens de entrada e 3.000 tokens de saída.
| Modelo | Preço de entrada | Preço de saída | Custo do exemplo por chamada |
|---|---|---|---|
| GPT-6.1 Sol | $2 | $10 | $0,05000 |
| Claude Opus 5.5 | $4 | $20 | $0,10000 |
| Kimi K3.1 Pro | $2 | $10 | $0,05000 |
| Gemini 4 Carbon | $2 | $10 | $0,05000 |
| Qwen3.8 Max | $1,65 | $4,95 | $0,03135 |
| DeepSeek V4.1 Flash | $0,30 | $1,20 | $0,00660 |
| DeepSeek V4 Pro | $1,32 | $3,96 | $0,02508 |
O cálculo é “quantidade de entrada ÷ milhão × preço de entrada + quantidade de saída ÷ milhão × preço de saída”. Essa tabela compara o custo básico de uma geração; novas tentativas, revisão e tempo de edição devem ser contabilizados à parte.
As diferenças de rota também mudam a fatura e os recursos disponíveis:
- Preço regional oficial do Qwen: Singapura fica em $2/$6; Pequim e Virgínia (EUA) ficam em $1,65/$4,951.
- Conexão direta oficial do Gemini: período de introdução até 30 de novembro; a partir de 1º de dezembro passa a $4/$20, e os tokens de raciocínio entram no custo de saída. Para terceiros, confira os comunicados de cada um.
- Conexão direta oficial do DeepSeek: o preço cai pela metade fora do horário de pico, e o período aplicável deve ser conferido nas regras oficiais.
- Recurso de lote do Kimi: as regras de lote do canal Moonshot precisam ser confirmadas separadamente; a documentação do K3.1 Pro no Alibaba Cloud indica que não há suporte a inferência em lote.
O cache de comandos consiste em reaproveitar entradas repetidas e cobrar conforme as regras do provedor. A interface unificada facilita a troca, mas cache, busca, modos de raciocínio e capacidade de lote ainda precisam ser confirmados rota por rota.
Qual Modelo de Linguagem Grande escolher para escrever artigos de operação: como fazer um teste cego de verdade
Chamadas mínimas servem para verificar se a interface está conectada. O exemplo abaixo demonstra apenas geração de texto, sem habilitar busca ou outras ferramentas.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
result = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "根据给定资料写运营文章大纲。"}],
)
print(result.choices[0].message.content)
Uma comparação completa deve usar o mesmo material e a mesma tarefa, com cada modelo gerando de forma independente pelo menos três vezes. A seguir, guarde os textos e o consumo; na avaliação, esconda os rótulos dos modelos e depois peça aos editores que registrem o tempo de edição e se o texto foi adotado.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
models = ["gpt-6.1-sol", "claude-opus-5-5", "kimi-k3.1-pro"]
packet = "在此粘贴同一份已核验资料包。"
results = []

for model in models:
    for trial in range(3):
        response = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system",
                 "content": "仅依据资料写作,缺少依据的观点请省略。"},
                {"role": "user",
                 "content": f"写一篇运营文章,先回答问题,再展开论证。\n资料:{packet}"},
            ],
        )
        results.append({
            "model": model,
            "trial": trial,
            "text": response.choices[0].message.content,
            "usage": response.usage.model_dump() if response.usage else None,
        })
Sugiro avaliar precisão factual, execução do planejamento, naturalidade do texto em português, legibilidade e ganho de conteúdo. Registre também a taxa de retenção pelos editores e o custo por artigo aprovado: se um rascunho barato precisa ser reescrito do zero, o que você economiza são centavos, e o que você gasta é a tarde inteira.
Qual Modelo de Linguagem Grande escolher para escrever artigos de operação: perguntas frequentes
Orçamento apertado: quais modelos testar primeiro?
Comece comparando Flash, GPT e Opus, cobrindo assim baixo custo, redação do dia a dia e textos longos importantes. Alternar modelos pelo APIYI apiyi.com reduz o trabalho de configuração de integrações separadas.
Uma única interface basta para que a comparação seja totalmente justa?
O APIYI apiyi.com consegue unificar a forma de invocação; para a justiça, ainda é preciso padronizar material, permissões de ferramentas, extensão do texto e configuração de raciocínio. Registre a versão do modelo e o endpoint, para não misturar condições de trabalho diferentes.
Qual Modelo de Linguagem Grande escolher para escrever artigos de operação: recomendações finais
Adote uma seleção em camadas: use candidatos de baixo custo para rascunhos de rotina, candidatos de alta qualidade para artigos importantes, deixe a revisão factual para um fluxo de verificação independente e mantenha a validação humana. A recomendação final de modelo deve estar subordinada à taxa real de adoção da equipe.
Recomenda-se validar a combinação acima por meio da APIYI apiyi.com, testar conforme o volume de uso e conferir os preços mais recentes. O objetivo final da seleção é produzir artigos aceitáveis de forma consistente, e não delegar todo o trabalho ao campeão do ranking.
Referências
- AI Writing Benchmark: aiwritingbenchmark.com, atualizado em 11 de novembro de 2026.
- ToneBench: benchmark.towardsai.com/models/, snapshot de 10 de novembro de 2026.
- Teste prático do OmniTools com textos longos em chinês: omnitools.ai/evals/longform-writing.
- Preços oficiais da Alibaba Cloud: alibabacloud.com/help/en/model-studio/model-pricing, consultado em 12 de novembro de 2026.
- Ajuste oficial de preços do Gemini: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
Autor: equipe de conteúdo técnico da APIYI. Fique à vontade para trocar ideias sobre invocação de modelos e avaliação de artigos de operação no apiyi.com; ao comparar, inclua versão, configuração e definição da tarefa.