결론
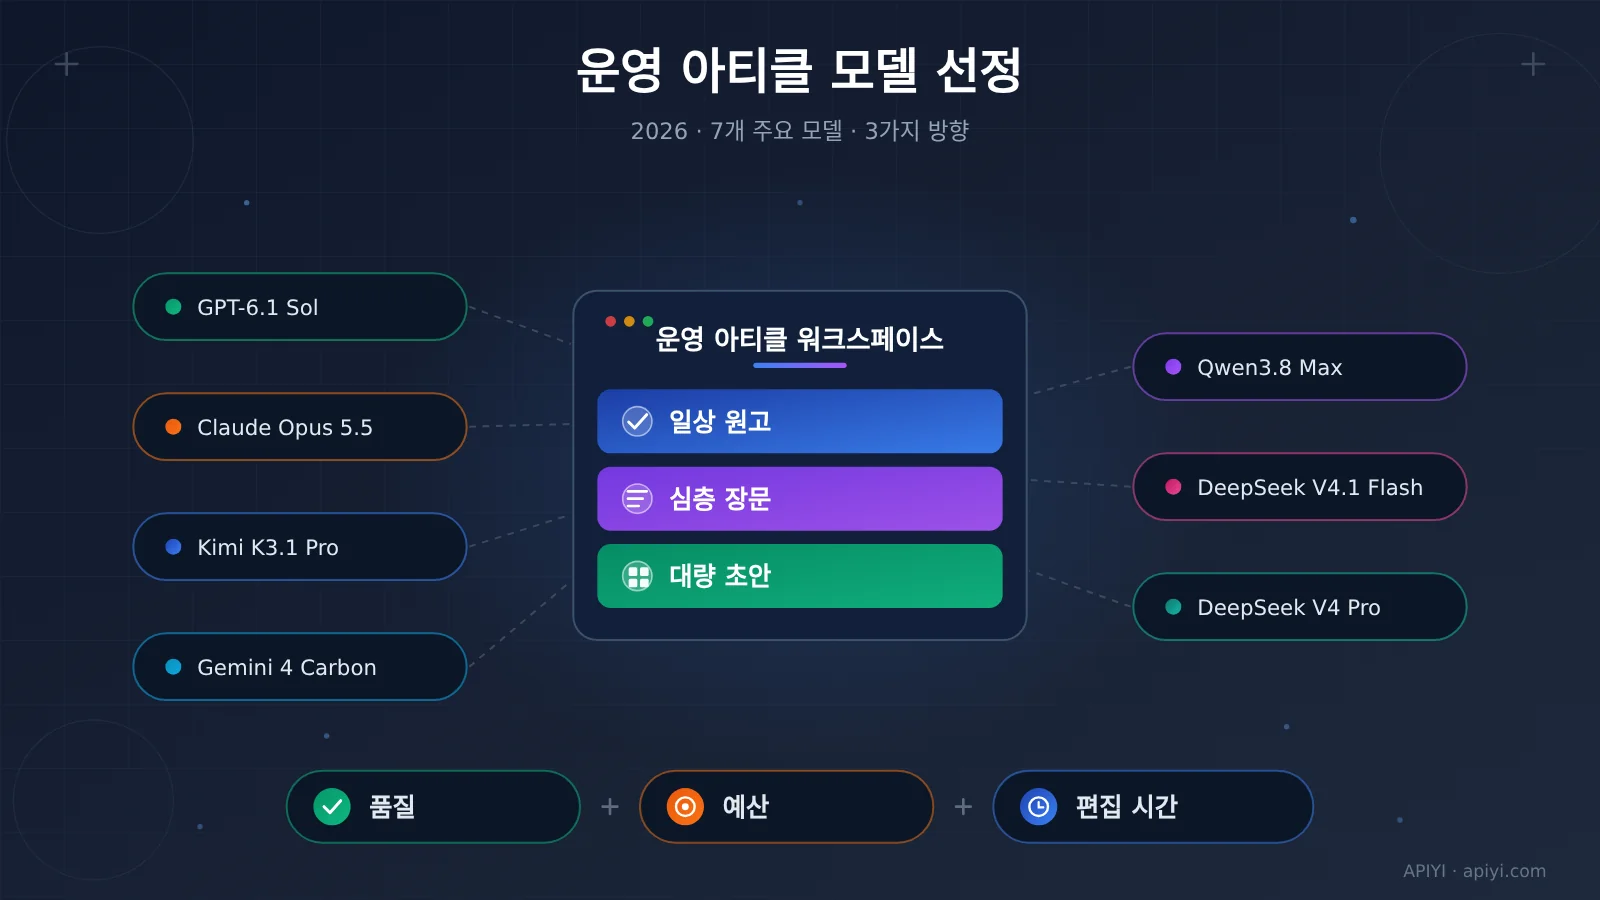
일상적인 글은 GPT-6.1 Sol을 먼저 테스트하고, 중요한 장문은 Claude Opus 5.5를 먼저 테스트하며, 대량 초안은 DeepSeek V4.1 Flash를 먼저 테스트하세요. 자료 집약적인 작업에는 Kimi, Gemini를 더하고, 구조화된 생산에는 Qwen을 더하며, DeepSeek Pro는 구체적인 작업에 따라 검증하세요.
이것들은 테스트 후보이지, 중국어 글쓰기 챔피언 명단이 아니에요. 정말 가성비 좋은 조합은 자료 이해, 글 품질, 호출 비용, 편집 수정 시간을 동시에 살펴봐야 해요.
이어서 다룰 내용
- 세 가지 글쓰기 테스트가 각각 무엇을 보여주는지.
- 일곱 개 모델의 실제 차이는 무엇인지.
- 운영 업무별로 주 모델과 대체 모델을 어떻게 배치할지.
- 비용을 어떻게 산정하고, 통합 인터페이스로 블라인드 테스트를 어떻게 진행할지.
운영 글 작성에 어떤 대규모 언어 모델을 고를까: 먼저 테스트 기준부터 이해하기
모델 벤치마크는 동일한 과제로 모델 성능을 측정하는 일련의 테스트예요. 운영 관점에서 모델을 고를 때는 실제 생산 흐름에 가까운 테스트를 우선 봐야 해요. 같은 자료, 같은 기획, 같은 분량으로 조건을 맞춘 뒤에 완성된 원고를 비교하는 방식이죠.
운영 글 작성에 어떤 대규모 언어 모델을 쓸까: 영어 성적으로 후보 압축하기
AI Writing Benchmark는 2026년 11월 11일에 업데이트됐고, 공통 영어 작문 과제를 쓰면서 모델 이름을 숨긴 비교 방식을 채택했어요. 115개 모델, 131,507회 블라인드 평가를 포괄하죠.
GPT-6.1 Sol의 영어 종합 점수는 95.3, 아티클·블로그·편집 부문 점수는 98.5예요. Claude Opus 5.5와 Kimi K3.1 Pro의 종합 점수는 각각 92.9, 91.9로 모두 기준 점수 수준이에요.
솔직히 말하면 GPT는 블로그 작성 후보군에 넣어볼 만해요. 다만 중국어 위챗 공식 계정 글을 몇 번 덜 고쳐도 되는지는 로컬에서 직접 테스트해봐야 하죠. 이 프로젝트는 개인이 유지하고 있으니, 언어와 평가 방식도 판단에 함께 넣어야 해요.
버전은 특히 잘 봐야 해요. 설명·교양 카테고리에서 앞선 건 Kimi K3이고, ToneBench의 “템플릿 투 최소” 단일 항목 89.0은 GPT-6 Sol에 해당해요. 두 성적은 각각 예전 버전 명칭에 속한 거예요.
운영 글 작성에 어떤 대규모 언어 모델을 쓸까: 스크립트 테스트가 자료 패키지 작성에 더 가까워요
ToneBench의 2026년 11월 10일 스냅숏은 영어 장편 영상 스크립트를 평가해요. 모델이 창작 요구 사항과 리서치 자료 패키지를 읽고, 클로즈드 북 방식으로 생성하는데 87개 모델, 151개 구성, 7,550편의 원고를 포괄해요.
아래 표는 선택한 구성의 Writing Score를 발췌한 거예요. Claude는 xhigh 구성이고, 각 행은 해당 테스트의 추론 구성을 그대로 따르며 계산 예산을 통일하지 않았어요. 그래서 여기서는 점수만 나열하고 모델 순위와 구성 순위를 섞어 쓰지 않아요.
| 모델 | Writing Score | 테스트에서 추정한 편당 스크립트 비용 |
|---|---|---|
| GPT-6.1 Sol | 82.4 | $0.239 |
| Claude Opus 5.5, xhigh | 85.8 | $1.003 |
| Kimi K3.1 Pro | 82.5 | $0.251 |
| Gemini 4 Carbon | 80.1 | $0.586 |
| Qwen3.8 Max | 76.8 | $0.207 |
| DeepSeek V4.1 Flash, 1017 버전 | 81.6 | $0.014 |
| DeepSeek V4 Pro | 80.1 | $0.077 |
핵심 신호는 이거예요. Opus는 고품질 장문을 우선 테스트하는 데 적합하고, Flash는 저비용 경쟁력을 보여줬어요. 표의 비용은 해당 테스트의 스크립트 작업량 기준이라, 중국어 운영 글 견적에 그대로 갖다 쓸 수는 없어요.
이 테스트는 모델 심사를 써서 벤더 편향이 있을 수 있고, 선두 구성의 신뢰구간이 겹치며 참조 스크립트가 달라지는 것도 1위에 영향을 줘요. 후보 범위를 좁힌 다음 편집자에게 검증을 맡기는 용도로 적합하죠.
이미지 설명: 아래에서는 품질과 비용으로 후보 분포를 보여줘요. 데이터는 위 ToneBench 스냅숏에서 가져왔어요. APIYI(apiyi.com)에서 다시 측정할 때는 자신의 토큰, 구성, 편집 시간을 따로 기록해야 해요.
운영 글 작성에 어떤 대규모 언어 모델을 선택할까: 중국어 증거로 보는 적용 범위
OmniTools는 2026년 10월 26일부터 11월 3일까지 중국어 금융 심층 기사를 테스트했으며, 10개 모델이 총 26편의 글을 생성했어요. Opus 5.5의 AI 블라인드 평가 점수는 8.25, GPT-6.1 Sol은 6.33이었습니다.
이것은 Opus가 중국어 장문 후보가 될 수 있는 근거를 제공해요. 하지만 표본이 적고 모델별 편수가 다르며, 테스트 주체가 상업적 라우팅 서비스 배경을 가지고 있어서 결론은 이 금융 장문 사례로 한정하는 게 좋아요.
운영 글 작성에 어떤 대규모 언어 모델을 선택할까: 7개 모델 하나씩 살펴보기
운영 글 작성에 어떤 대규모 언어 모델을 선택할까: GPT와 Claude는 어떻게 역할을 나눌까
GPT-6.1 Sol: 일상적인 원고 작성 우선 후보. 영어 기사 카테고리에서 성적이 눈에 띄어서, 기술 블로그, 제품 분석, 뉴스 해설부터 테스트하기에 적합해요. 중국어 자연스러움과 인용 정확성은 별도로 점수를 매겨야 해요.
Claude Opus 5.5: 중요한 장문 우선 후보. 스크립트 테스트와 중국어 금융 사례 모두 뒷받침해 줘요. 기획 기사, 브랜드 장문은 먼저 이것으로 테스트할 수 있고, 고빈도 단문은 추가 품질이 더 높은 비용을 감당할 만한지 비교해야 해요.
운영 글 작성에 어떤 대규모 언어 모델을 선택할까: Kimi, Gemini, Qwen은 어떻게 활용할까
Kimi K3.1 Pro: 대용량 자료 작업 후보. 약 1M 토큰 컨텍스트와 영어 종합 작문 결과를 바탕으로, 지식 집약형 기사 테스트에 포함시킬 수 있어요. K3의 과학 교양 카테고리 성적은 별도로 봐야 해요.
Gemini 4 Carbon: 복잡한 자료 분석 후보. 먼저 여러 단계의 문제, 증거 관계, 기사 개요를 정리하게 한 다음, 직접 원고를 작성했을 때의 효과를 비교할 수 있어요. 현재 증거는 후보 판단을 뒷받침하는 데 더 적합해요.
Qwen3.8 Max: 구조화된 생산 후보. 제품 설명, 고정 코너, 템플릿화된 콘텐츠를 테스트할 수 있어요. 배치 추론의 단일 요청 컨텍스트 제한은 256K이므로, 연동 전에 지역 지원 여부를 확인해야 해요.
운영 글 작성에 어떤 대규모 언어 모델을 선택할까: DeepSeek Flash와 Pro는 어떻게 선택할까
DeepSeek V4.1 Flash: 저비용 초안 우선 후보. 위 스크립트 테스트에서 점수와 비용을 모두 고려했을 때 적합했으며, 대량 초안, 재작성, 지식 설명에 알맞아요. 게시 전에는 사람이 사실을 검수하는 절차를 유지해야 해요.
DeepSeek V4 Pro: 작업 전용 후보. API는 여전히 서비스를 제공하고 있지만, 해당 스크립트 테스트에서는 Flash가 더 높은 점수를 받았어요. 특정 작업의 블라인드 테스트로 이점이 입증될 때만 예산을 올릴 만해요.
운영 글 작성, 어떤 대규모 언어 모델을 골라야 할까: 작업별 계층화 방안
아래는 현재 확보한 근거를 바탕으로 정한 테스트 순서이며, 중국어 결과물의 채택 여부는 팀 블라인드 평가로 결정합니다.
| 운영 작업 | 우선 후보 | 대체 또는 병행 방안 |
|---|---|---|
| 기술 뉴스, 일상 블로그 | GPT-6.1 Sol | Flash로 초안 작성, GPT로 퇴고 |
| 심층 업계 분석, 브랜드 장문 콘텐츠 | Claude Opus 5.5 | GPT로 동일 주제 블라인드 테스트 |
| 기술 튜토리얼, 지식 대중화 | GPT, Kimi K3.1 Pro | Flash로 저비용 대조 실험 |
| 장문 자료 종합, 복잡한 이슈 | Kimi, Gemini | 먼저 근거를 정리한 뒤 완성 모델에 전달 |
| 마케팅 글, 소셜 짧은 콘텐츠 | GPT로 짧은 콘텐츠 먼저 테스트 | 브랜드 장문 콘텐츠에 Opus 추가 |
| 대량 구조화 콘텐츠 | Qwen, Flash | 채택률에 따라 주력 모델 결정 |
| 사용 가능 플랫폼 | 각사 공식 인터페이스 | APIYI apiyi.com에서 통합 호출로 비교 |
마케팅·영업 카테고리에서 영어 기준 선두 모델은 Claude Sonnet 5.5이며, 이는 위 일곱 모델 외에 있습니다. 마케팅 카피가 핵심 사업이라면 장문 모델 중에서만 최고를 고르기보다 후보군을 확장하는 편이 좋습니다.
빠른 시작 가이드: APIYI apiyi.com은 하나의 API 키로 여러 모델을 호출할 수 있는 OpenAI 호환 인터페이스를 제공하며, 신규 사용자에게는 무료 테스트 쿼터가 있습니다. 먼저 동일한 주제로 세 가지 모델을 비교한 뒤 테스트 범위를 넓혀 보세요.
운영 글 작성, 어떤 대규모 언어 모델을 골라야 할까: ‘통과 원고’까지 비용 계산하기
Token은 모델이 텍스트를 처리할 때 쓰는 측정 단위예요. 입력 Token에는 프롬프트, 자료, 컨텍스트가 포함되고, 출력 Token에는 생성된 내용이 포함돼요. 컨텍스트 윈도우는 한 번의 호출로 처리할 수 있는 범위를 뜻해요.
아래는 APIYI 2026년 11월 12일 10:45, UTC+8 가격 스냅숏을 기준으로 했어요. 단위는 미국 달러/백만 Token이에요. 예시는 모두 입력 10,000, 출력 3,000 Token으로 통일해서 계산했어요.
| 모델 | 입력 단가 | 출력 단가 | 1회 예시 비용 |
|---|---|---|---|
| GPT-6.1 Sol | $2 | $10 | $0.05000 |
| Claude Opus 5.5 | $4 | $20 | $0.10000 |
| Kimi K3.1 Pro | $2 | $10 | $0.05000 |
| Gemini 4 Carbon | $2 | $10 | $0.05000 |
| Qwen3.8 Max | $1.65 | $4.95 | $0.03135 |
| DeepSeek V4.1 Flash | $0.30 | $1.20 | $0.00660 |
| DeepSeek V4 Pro | $1.32 | $3.96 | $0.02508 |
계산 방식은 ‘입력량÷백만×입력 단가+출력량÷백만×출력 단가’예요. 이 표는 한 번 생성할 때의 기본 비용을 비교한 거고, 재시도, 검수, 편집 시간은 따로 계산해야 해요.
라우팅 차이에 따라 청구 금액과 기능도 달라져요:
- Qwen 공식 리전 가격: 싱가포르는 $2/$6이고, 베이징과 미국 버지니아는 $1.65/$4.951이에요.
- Gemini 공식 직결: 프로모션 기간은 11월 30일까지이고, 12월 1일부터는 $4/$20이며 추론 Token은 출력 비용에 포함돼요. 서드파티는 각자 공지로 확인해야 해요.
- DeepSeek 공식 직결: 비피크 시간대에는 가격이 절반이에요. 적용 시간대는 공식 규칙으로 확인하세요.
- Kimi 배치 기능: Moonshot 채널의 배치 규칙은 별도로 확인해야 하고, 알리바바 클라우드 K3.1 Pro 문서에는 배치 추론을 지원하지 않는다고 표시돼 있어요.
프롬프트 캐싱은 서비스 제공자의 규칙에 따라 반복되는 입력을 재사용하고 과금하는 방식이에요. 통합 인터페이스 덕분에 모델 전환은 편하지만, 캐싱, 검색, 추론 모드, 배치 기능은 라우팅별로 하나하나 확인해야 해요.
운영 콘텐츠를 작성할 때 어떤 대규모 언어 모델을 선택할까: 실제 블라인드 테스트 진행 방법
최소 호출은 인터페이스 연결 여부를 검증하는 데 적합해요. 아래에서는 텍스트 생성만 보여 주고 검색이나 다른 도구는 사용하지 않아요.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
result = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "根据给定资料写运营文章大纲。"}],
)
print(result.choices[0].message.content)
전체 비교에는 같은 자료, 같은 작업을 사용하고 각 모델을 독립적으로 최소 3회 생성해야 해요. 아래에서는 원고와 사용량을 보존하고, 평가 시에는 모델 레이블을 숨긴 뒤 편집자가 수정 시간과 채택 여부를 기록해요.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
models = ["gpt-6.1-sol", "claude-opus-5-5", "kimi-k3.1-pro"]
packet = "在此粘贴同一份已核验资料包。"
results = []

for model in models:
    for trial in range(3):
        response = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system",
                 "content": "仅依据资料写作,缺少依据的观点请省略。"},
                {"role": "user",
                 "content": f"写一篇运营文章,先回答问题,再展开论证。\n资料:{packet}"},
            ],
        )
        results.append({
            "model": model,
            "trial": trial,
            "text": response.choices[0].message.content,
            "usage": response.usage.model_dump() if response.usage else None,
        })
사실 정확성, 기획 실행력, 중국어 자연스러움, 가독성, 콘텐츠 증분을 평가하는 걸 권장해요. 동시에 편집자 채택률과 편당 합격 원고 비용을 기록하세요. 저렴한 초안이 전체 재작성을 필요로 한다면 아끼는 건 잔돈이고, 쓰는 건 오후 시간이에요.
운영 콘텐츠 작성에 어떤 대규모 언어 모델을 선택할까: 자주 묻는 질문
예산이 제한적이라면 먼저 어떤 모델을 테스트해야 할까요?
먼저 Flash, GPT, Opus를 비교해 저비용, 일상 초안, 중요한 장문을 아우르세요. APIYI apiyi.com에서 모델을 전환하면 각각 따로 연결할 때의 설정 작업을 줄일 수 있어요.
하나의 인터페이스로 비교가 완전히 공정해질 수 있을까요?
APIYI apiyi.com은 호출 형식을 통일할 수 있어요. 공정성은 같은 자료, 도구 권한, 분량, 추론 설정도 통일해야 확보돼요. 모델 버전과 엔드포인트를 기록해 서로 다른 작업 조건을 섞지 마세요.
운영 글 작성, 어떤 대규모 언어 모델을 고를까: 마무리 제안
계층별 모델 선택을 적용하세요. 일반적인 초안은 저비용 후보로, 중요한 글은 고품질 후보로 작성하고, 사실 검토는 별도의 점검 프로세스에 맡기며 사람이 직접 확인하는 단계도 남겨 두세요. 결국 모델 추천은 팀의 실제 채택률에 맞춰야 해요.
위 조합은 APIYI(apiyi.com)에서 검증해 보시길 권해요. 사용량 기준으로 테스트하고 최신 가격을 확인하세요. 선택의 종착점은 벤치마크 1위 모델에 모든 작업을 맡기는 게 아니라, 양질의 글을 안정적으로 생산하는 것이에요.
참고 자료
- AI Writing Benchmark: aiwritingbenchmark.com, 2026년 11월 11일 업데이트.
- ToneBench: benchmark.towardsai.com/models/, 2026년 11월 10일 스냅샷.
- OmniTools 중국어 장문 실측: omnitools.ai/evals/longform-writing.
- 알리바바 클라우드 공식 가격: alibabacloud.com/help/en/model-studio/model-pricing, 2026년 11월 12일 조회.
- Gemini 공식 가격 조정: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
작성자: APIYI 기술 콘텐츠 팀. apiyi.com의 모델 호출과 운영 글 평가에 관한 이야기를 나누고 싶으니, 비교할 때는 버전과 설정, 작업 기준을 함께 적어 주세요.