Fazit
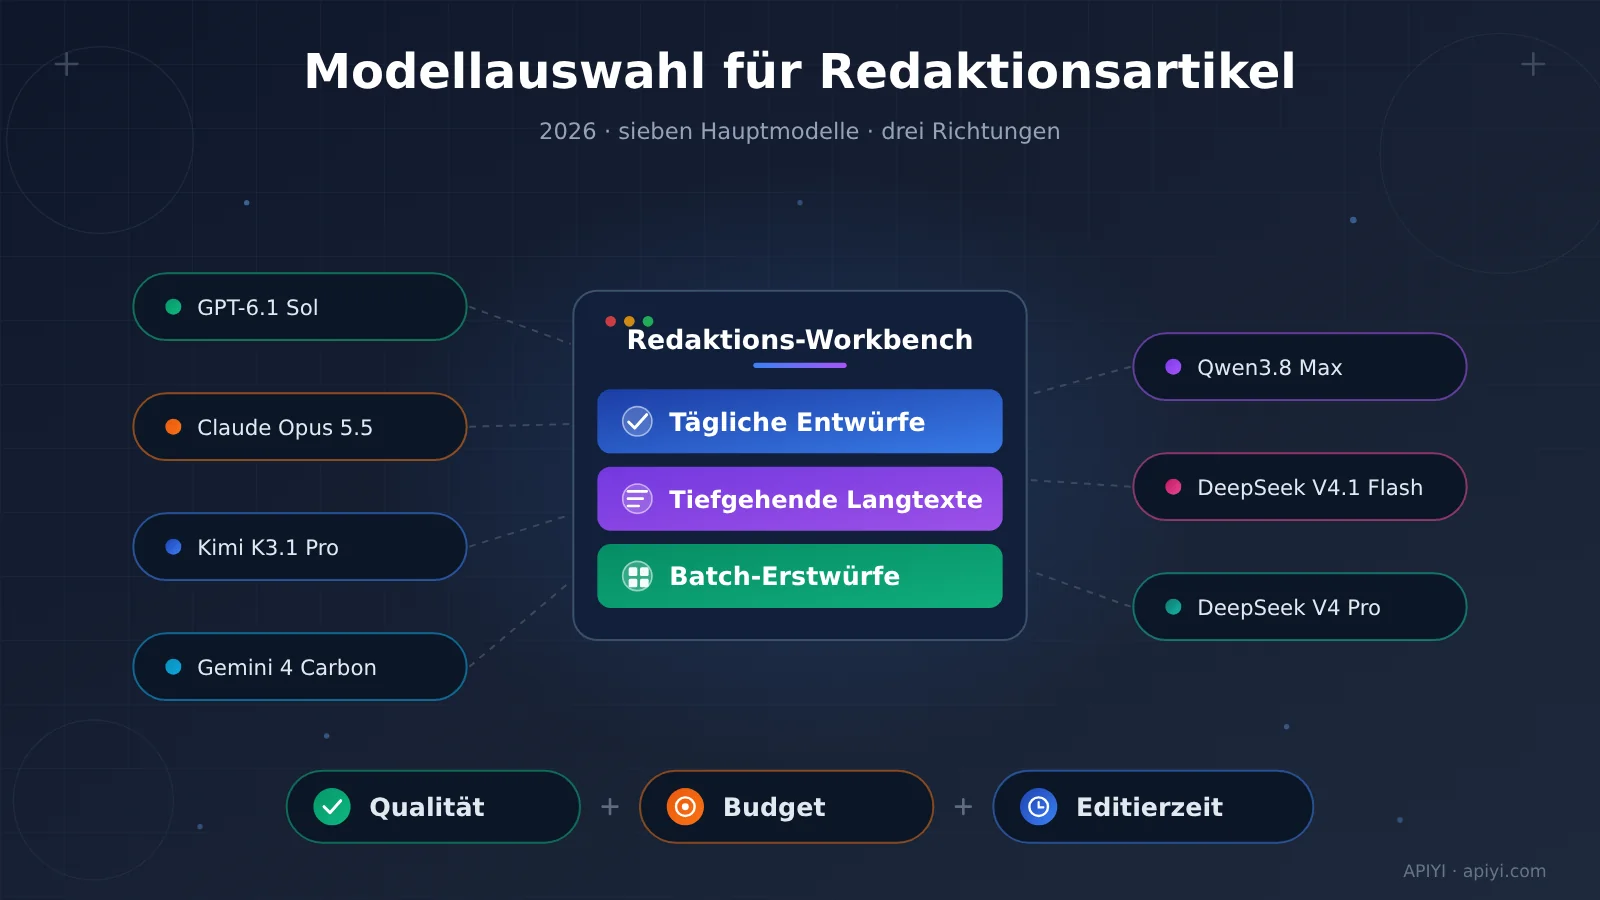
Für alltägliche Artikel testen Sie zuerst GPT-6.1 Sol, für wichtige Longtexte zuerst Claude Opus 5.5, für Massen-Erstentwürfe zuerst DeepSeek V4.1 Flash. Bei datenintensiven Aufgaben ergänzen Sie Kimi und Gemini, für strukturierte Produktion Qwen, und DeepSeek Pro verifizieren Sie je nach konkreter Aufgabe.
Das sind Testkandidaten, keine Liste der Meister im chinesischen Schreiben. Eine wirklich lohnende Kombination muss gleichzeitig Materialverständnis, Artikelqualität, Aufrufkosten und Redaktionszeit berücksichtigen.
Was in den folgenden Abschnitten behandelt wird
- Was die drei Arten von Schreibtest jeweils aussagen können.
- Worin sich die sieben Modelle in der Praxis unterscheiden.
- Wie man für verschiedene Betriebsaufgaben Haupt- und Ersatzmodell festlegt.
- Wie man Kosten kalkuliert und mit einer einheitlichen Schnittstelle Blindtests durchführt.
Welches große Sprachmodell für Artikel im Redaktionsbetrieb? Zuerst die Testmethodik verstehen
Ein Modell-Benchmark ist eine Reihe von Tests, mit denen die Leistung von Modellen anhand einheitlicher Aufgaben gemessen wird. Bei der Auswahl für den Betrieb sollte man vor allem Tests betrachten, die dem tatsächlichen Produktionsablauf nahekommen: gleiche Materialien, gleiche Planung, gleiche Länge – und erst dann die fertigen Entwürfe vergleichen.
Welches Großsprachige Modell für Marketing-Artikel: Englische Scores als Vorauswahl für Kandidaten
Das AI Writing Benchmark wurde am 11. November 2026 aktualisiert und arbeitet mit gemeinsamen englischen Schreibaufgaben sowie Vergleichen, bei denen die Modellnamen verdeckt sind. Es umfasst 115 Modelle und 131.507 Blindbewertungen.
GPT-6.1 Sol kommt auf einen englischen Gesamtwert von 95,3, in der Kategorie Artikel, Blogs und Lektorat sogar auf 98,5. Claude Opus 5.5 und Kimi K3.1 Pro liegen mit 92,9 bzw. 91,9 jeweils auf dem Basiswert.
Offen gesagt: GPT gehört in die Kandidatenliste für Blogtexte. Ob chinesische WeChat-Artikel damit weniger Nachbearbeitung brauchen, muss man lokal testen. Das Projekt wird von einer Einzelperson gepflegt, deshalb sollten auch Sprache und Bewertungsmethode in die Beurteilung einfließen.
Auf die Versionen kommt es besonders an: In der Kategorie Erklär- und Wissensvermittlung führt Kimi K3; im ToneBench entfällt der Einzelwert 89,0 für „weniger Template-Sprache“ auf GPT-6 Sol. Beide Ergebnisse gehören jeweils zu älteren Versionsbezeichnungen.
Welches Großsprachige Modell für Marketing-Artikel: Skript-Tests kommen dem Schreiben aus dem Recherchepaket näher
Der Snapshot des ToneBench vom 10. November 2026 prüft englische Langvideo-Skripte: Die Modelle lesen die kreativen Vorgaben und das Recherchepaket und generieren dann ohne weitere Hilfsmittel, also „closed book“. Abgedeckt sind 87 Modelle, 151 Konfigurationen und 7.550 Skripte.
Die folgende Tabelle zeigt auszugsweise den Writing Score der ausgewählten Konfigurationen. Claude läuft in der Konfiguration xhigh; jede Zeile folgt der jeweiligen Inferenzkonfiguration des Tests, ohne einheitliches Rechenbudget. Deshalb stehen hier nur die Scores, ohne Ranglisten von Modellen und Konfigurationen zu vermischen.
| Modell | Writing Score | Geschätzte Kosten pro Skript im Test |
|---|---|---|
| GPT-6.1 Sol | 82,4 | $0,239 |
| Claude Opus 5.5, xhigh | 85,8 | $1,003 |
| Kimi K3.1 Pro | 82,5 | $0,251 |
| Gemini 4 Carbon | 80,1 | $0,586 |
| Qwen3.8 Max | 76,8 | $0,207 |
| DeepSeek V4.1 Flash, Version 1017 | 81,6 | $0,014 |
| DeepSeek V4 Pro | 80,1 | $0,077 |
Das Kernsignal: Opus eignet sich für einen ersten Test bei hochwertigen Langtexten, Flash zeigt Wettbewerbsfähigkeit bei niedrigen Kosten. Die Kosten in der Tabelle beziehen sich auf den Skriptumfang dieses Tests und lassen sich nicht direkt als Preis für chinesische Marketing-Artikel übernehmen.
Der Test setzt Modellbewertungen ein, eine Anbieterpräferenz ist also möglich; die Konfidenzintervalle der führenden Konfigurationen überschneiden sich, und Änderungen an den Referenzskripten können die Spitzenreiter verschieben. Der Test eignet sich, um die Kandidatenliste zu verkleinern und dann Redakteure zur Prüfung heranzuziehen.
Hinweis zur Grafik: Die folgende Darstellung zeigt die Verteilung der Kandidaten nach Qualität und Kosten; die Daten stammen aus dem oben genannten ToneBench-Snapshot. Bei einer Nachprüfung über APIYI apiyi.com sollten Token, Konfiguration und Bearbeitungszeit separat erfasst werden.
Welches große Sprachmodell für Marketing-Artikel? Chinesische Belege zeigen die Einsatzbereiche
OmniTools testete vom 26. Oktober bis 3. November 2026 tiefgehende chinesische Finanzbeiträge; zehn Modelle erzeugten insgesamt 26 Artikel. Opus 5.5 erreichte in der KI-Blindbewertung 8,25 Punkte, GPT-6.1 Sol 6,33.
Das liefert eine Grundlage dafür, Opus als Kandidat für lange chinesische Texte zu sehen. Allerdings ist die Stichprobe klein, die Artikelzahl je Modell unterschiedlich, und der Testanbieter betreibt selbst einen kommerziellen Routing-Dienst – die Schlussfolgerung sollte man daher auf dieses Finanzlangtext-Beispiel begrenzen.
Welches große Sprachmodell für Marketing-Artikel? Sieben Modelle im Einzelnen
GPT und Claude: Wie teilt man die Aufgaben auf?
GPT-6.1 Sol: bevorzugter Kandidat für den täglichen Redaktionsalltag. In der Kategorie englischsprachige Artikel schneidet es besonders gut ab und eignet sich für erste Tests mit Tech-Blogs, Produktanalysen und Nachrichtenaufbereitung. Natürlichkeit im Chinesischen und Zitiergenauigkeit sollten separat bewertet werden.
Claude Opus 5.5: bevorzugter Kandidat für wichtige Langtexte. Sowohl der Skript-Test als auch der chinesische Finanzfall stützen das. Für Reportagen und Markenlangtexte kann man es zuerst testen; bei kurzen, häufig produzierten Texten sollte man dagegen prüfen, ob der Qualitätszuwachs die höheren Kosten rechtfertigt.
Kimi, Gemini, Qwen: So setzt man sie ein
Kimi K3.1 Pro: Kandidat für Aufgaben mit langem Material. Ein Kontextfenster von rund 1 Mio. Token und die Ergebnisse beim englischen allgemeinen Schreiben sprechen dafür, es in Tests für wissensintensive Artikel einzubeziehen. Die Ergebnisse der K3 in der Kategorie populärwissenschaftliche Texte sind separat zu betrachten.
Gemini 4 Carbon: Kandidat für die Analyse komplexer Materialien. Man kann es zunächst mehrstufige Fragestellungen, Beziehungen zwischen Belegen und Artikelgliederungen strukturieren lassen und dann mit dem direkt erzeugten Text vergleichen. Die derzeitige Beleglage stützt eher eine Kandidatenbewertung.
Qwen3.8 Max: Kandidat für strukturierte Produktion. Geeignet für Tests mit Produktbeschreibungen, festen Rubriken und vorlagenbasierten Inhalten. Bei der Batch-Inferenz liegt das Kontextlimit pro Anfrage bei 256K; vor der Integration sollte man die regionale Verfügbarkeit prüfen.
DeepSeek Flash oder Pro: Welche Variante passt?
DeepSeek V4.1 Flash: bevorzugter Kandidat für günstige Erstentwürfe. Im oben genannten Skript-Test überzeugte es sowohl bei der Punktzahl als auch bei den Kosten und eignet sich für Erstentwürfe in Serie, Umschreibungen und Wissensvermittlung. Vor der Veröffentlichung bleibt eine manuelle Faktenprüfung Pflicht.
DeepSeek V4 Pro: Kandidat für spezielle Aufgaben. Die API wird weiterhin angeboten, doch im Skript-Test erzielte Flash die höhere Punktzahl. Ein Budget-Upgrade lohnt sich erst, wenn ein Blindtest mit der konkreten Aufgabe den Nutzen belegt.
Welches große Sprachmodell für Content-Artikel: ein gestuftes Vorgehen nach Aufgabe
Die folgende Testreihenfolge stützt sich auf die vorhandenen Erkenntnisse; ob chinesische Ergebnisse übernommen werden, entscheidet ein Blindreview im Team.
| Content-Aufgabe | Bevorzugte Kandidaten | Alternativen oder ergänzende Ansätze |
|---|---|---|
| Tech-News, alltägliche Blogbeiträge | GPT-6.1 Sol | Flash erstellt den ersten Entwurf, GPT überarbeitet |
| Tiefgehende Branchenanalysen, Marken-Longforms | Claude Opus 5.5 | GPT-Blindtest zum selben Thema |
| Technische Tutorials, Wissensvermittlung | GPT, Kimi K3.1 Pro | Flash als kostengünstige Vergleichsoption |
| Zusammenfassung umfangreicher Materialien, komplexe Themen | Kimi, Gemini | Zuerst Belege aufbereiten, dann an das Modell für den fertigen Text geben |
| Marketingtexte, kurze Social-Media-Inhalte | GPT zuerst für Kurzinhalte testen | Marken-Longforms mit Opus ergänzen |
| Strukturierte Inhalte in Serie | Qwen, Flash | Hauptmodell nach Übernahmequote festlegen |
| Verfügbare Plattformen | Offizielle entsprechende APIs | Einheitlicher Vergleichsaufruf über APIYI apiyi.com |
Das führende englischsprachige Modell für Marketing und Vertrieb ist Claude Sonnet 5.5; es liegt außerhalb dieser sieben. Wenn Marketingtexte zum Kerngeschäft gehören, kann man den Kandidatenpool erweitern, statt nur unter den Longform-Modellen einen Sieger zu suchen.
Schnellstart-Empfehlung: APIYI apiyi.com bietet einen API-Schlüssel, mit dem man über eine OpenAI-kompatible Schnittstelle mehrere Modelle aufrufen kann; neue Nutzer erhalten ein kostenloses Testkontingent. Vergleichen Sie zuerst drei Modelle am selben Thema und erweitern Sie dann den Testumfang.
Welches große Sprachmodell für Marketing-Artikel? Die Kosten bis zum brauchbaren Entwurf durchrechnen
Token ist die Maßeinheit, mit der ein Modell Text verarbeitet. Eingabe-Token umfassen die Eingabeaufforderung, Hintergrundmaterial und Kontext; Ausgabe-Token den generierten Inhalt. Das Kontextfenster beschreibt dagegen den Umfang, den ein einzelner Aufruf verarbeiten kann.
Im Folgenden gilt der APIYI Preis-Snapshot vom 12. November 2026, 10:45 Uhr UTC+8, Einheit US-Dollar pro Million Token. Die Beispiele rechnen einheitlich mit 10.000 Eingabe- und 3.000 Ausgabe-Token.
| Modell | Eingabepreis | Ausgabepreis | Kosten je Beispielaufruf |
|---|---|---|---|
| GPT-6.1 Sol | $2 | $10 | $0.05000 |
| Claude Opus 5.5 | $4 | $20 | $0.10000 |
| Kimi K3.1 Pro | $2 | $10 | $0.05000 |
| Gemini 4 Carbon | $2 | $10 | $0.05000 |
| Qwen3.8 Max | $1.65 | $4.95 | $0.03135 |
| DeepSeek V4.1 Flash | $0.30 | $1.20 | $0.00660 |
| DeepSeek V4 Pro | $1.32 | $3.96 | $0.02508 |
Die Rechnung lautet „Eingabemenge ÷ Million × Eingabepreis + Ausgabemenge ÷ Million × Ausgabepreis“. Diese Tabelle vergleicht die Grundkosten einer einzelnen Generierung; Wiederholungsversuche, Korrekturlesen und Redaktionszeit sind separat zu kalkulieren.
Auch Routing-Unterschiede verändern Rechnung und Funktionsumfang:
- Qwen offizieller Regionalpreis: Singapur $2/$6; Peking und US-Virginia $1.65/$4.951.
- Gemini offizielle Direktanbindung: Einführungspreis bis 30. November; ab 1. Dezember $4/$20, Reasoning-Token werden als Ausgabe-Token berechnet. Bei Drittanbietern die jeweiligen Ankündigungen prüfen.
- DeepSeek offizielle Direktanbindung: Preise außerhalb der Stoßzeiten halbiert; die Zeitfenster nach den offiziellen Regeln prüfen.
- Kimi Batch-Fähigkeit: Die Batch-Regeln des Moonshot-Kanals müssen separat bestätigt werden; die Alibaba-Cloud-Dokumentation zu K3.1 Pro weist keine Unterstützung für Batch-Inferenz aus.
Prompt-Caching bedeutet, wiederholte Eingaben nach den Regeln des Anbieters wiederzuverwenden und abzurechnen. Eine einheitliche Schnittstelle erleichtert das Umschalten, doch Caching, Suche, Reasoning-Modus und Batch-Fähigkeit müssen weiterhin für jede Route einzeln bestätigt werden.
Welches große Sprachmodell für Marketing-Artikel? So führen Sie einen echten Blindtest durch
Ein minimaler Aufruf eignet sich gut, um die Erreichbarkeit der Schnittstelle zu prüfen. Das folgende Beispiel zeigt nur die Textgenerierung – ohne Suche oder andere Tools.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
result = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "根据给定资料写运营文章大纲。"}],
)
print(result.choices[0].message.content)
Für einen vollständigen Vergleich sollten alle Modelle mit demselben Material und derselben Aufgabe arbeiten und mindestens drei Mal unabhängig voneinander generieren. Im Folgenden werden Entwurf und Tokenverbrauch mitgespeichert; beim Bewerten werden die Modellnamen ausgeblendet, anschließend halten die Redakteurinnen und Redakteure Bearbeitungszeit und Übernahme fest.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
models = ["gpt-6.1-sol", "claude-opus-5-5", "kimi-k3.1-pro"]
packet = "在此粘贴同一份已核验资料包。"
results = []

for model in models:
    for trial in range(3):
        response = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system",
                 "content": "仅依据资料写作,缺少依据的观点请省略。"},
                {"role": "user",
                 "content": f"写一篇运营文章,先回答问题,再展开论证。\n资料:{packet}"},
            ],
        )
        results.append({
            "model": model,
            "trial": trial,
            "text": response.choices[0].message.content,
            "usage": response.usage.model_dump() if response.usage else None,
        })
Bewertet werden am besten faktische Genauigkeit, Umsetzung der Planung, Natürlichkeit des Chinesischen, Lesbarkeit und inhaltlicher Mehrwert. Gleichzeitig sollten Sie die Übernahmerate der Redaktion und die Kosten pro brauchbarem Artikel erfassen: Wenn ein billiger Erstentwurf komplett neu geschrieben werden muss, spart man ein paar Cent und verliert einen ganzen Nachmittag.
Welches große Sprachmodell für Marketing-Artikel? Häufige Fragen
Das Budget ist knapp – welche Modelle sollte ich zuerst testen?
Vergleichen Sie zuerst Flash, GPT und Opus – damit decken Sie kostengünstige Entwürfe, alltägliche Artikel und wichtige lange Texte ab. Wenn Sie die Modelle über APIYI apiyi.com wechseln, entfällt ein Großteil der Konfigurationsarbeit für getrennte Anbindungen.
Kann ein einziger Endpunkt den Vergleich vollkommen fair machen?
APIYI apiyi.com kann die Aufrufform vereinheitlichen; für echte Fairness müssen aber auch Material, Tool-Berechtigungen, Textlänge und Inferenz-Konfiguration identisch sein. Halten Sie Modellversion und Endpunkt fest, damit nicht versehentlich unterschiedliche Arbeitsbedingungen miteinander verglichen werden.
Welches große Sprachmodell für Content-Artikel: eine abschließende Empfehlung
Setzen Sie auf eine mehrstufige Auswahl: Für routinemäßige Erstentwürfe sollten Sie kostengünstige Kandidaten einsetzen, für wichtige Artikel hochwertige Kandidaten, die Faktenprüfung einem unabhängigen Prüfprozess überlassen und die manuelle Verifikation beibehalten. Modellempfehlungen sollten sich letztlich an der tatsächlichen Nutzungsquote im Team orientieren.
Es empfiehlt sich, die oben genannte Kombination über APIYI apiyi.com zu validieren, mit realem Nutzungsvolumen zu testen und die aktuellen Preise zu prüfen. Das Ziel der Auswahl ist es, zuverlässig brauchbare Artikel zu produzieren – nicht, dem Sieger der Rangliste sämtliche Aufgaben zu übertragen.
Referenzen
- AI Writing Benchmark: aiwritingbenchmark.com, aktualisiert am 11. November 2026.
- ToneBench: benchmark.towardsai.com/models/, Snapshot vom 10. November 2026.
- OmniTools-Praxistest für lange chinesische Texte: omnitools.ai/evals/longform-writing.
- Offizielle Preise von Alibaba Cloud: alibabacloud.com/help/en/model-studio/model-pricing, abgerufen am 12. November 2026.
- Offizielle Preisanpassung von Gemini: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
Autor: Technisches Content-Team von APIYI. Wir freuen uns über den Austausch zu Modellaufrufen und zur Bewertung von Content-Artikeln rund um apiyi.com. Bei Vergleichen bitte Version, Konfiguration und Aufgabenstellung angeben.