Conclusión
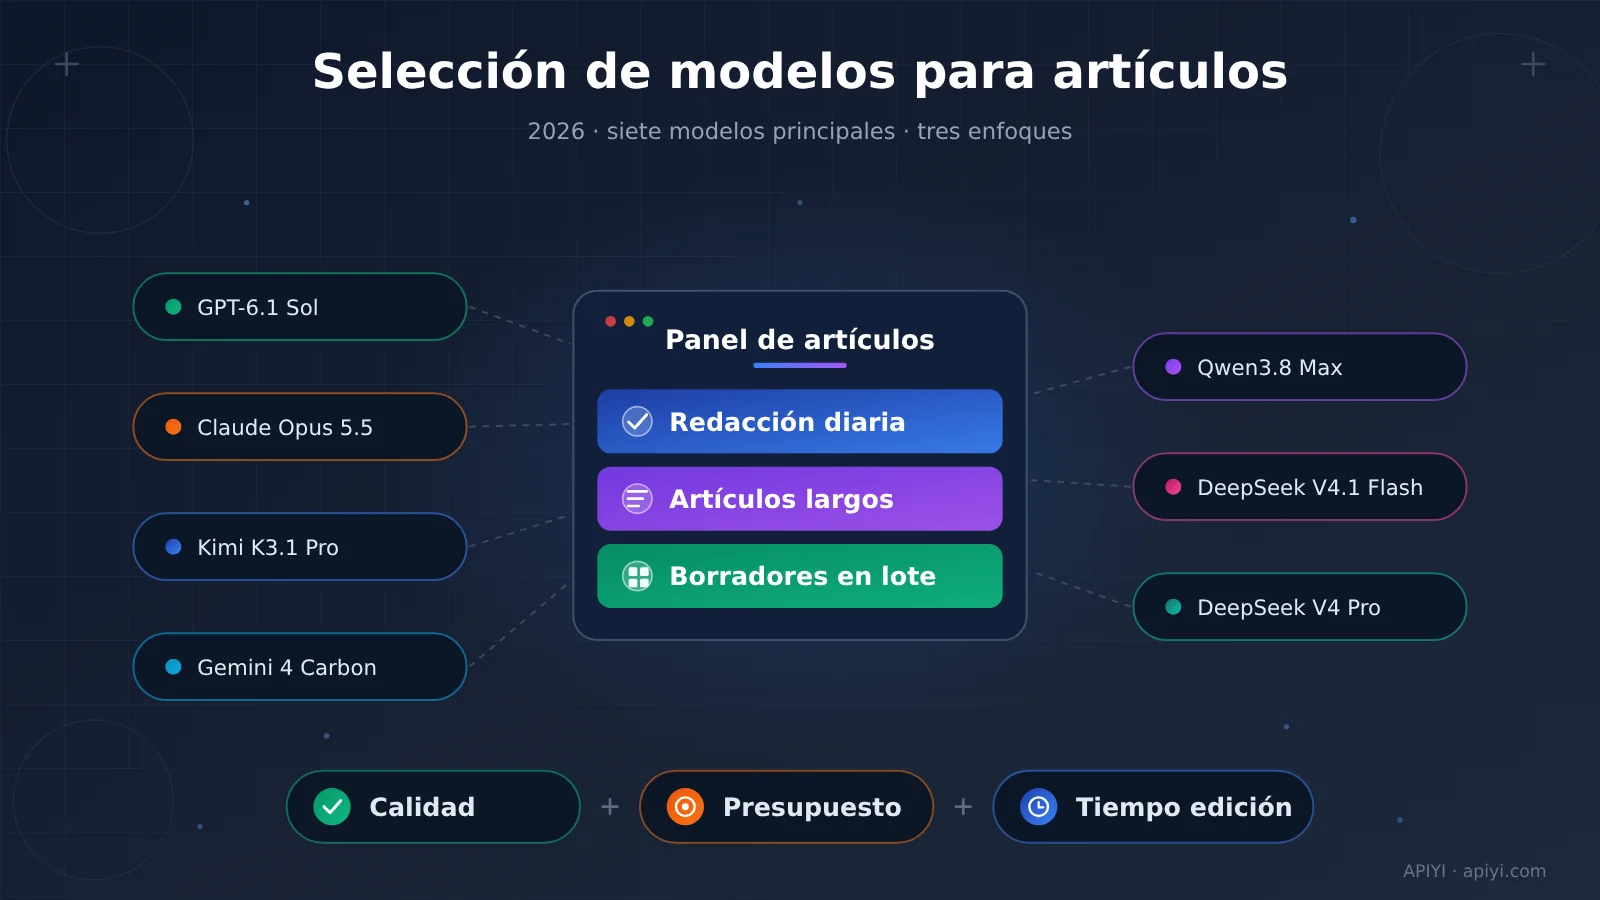
Para artículos diarios, prueba primero GPT-6.1 Sol; para artículos largos importantes, prueba primero Claude Opus 5.5; para borradores iniciales por lotes, prueba primero DeepSeek V4.1 Flash. Para tareas intensivas en material de referencia, añade además Kimi y Gemini; para producción estructurada, añade Qwen; y DeepSeek Pro, valídalo según la tarea concreta.
Estos son candidatos para hacer pruebas, no una lista de campeones de la escritura en chino. Una combinación realmente rentable debe considerar a la vez la comprensión del material, la calidad del artículo, el costo de invocación y el tiempo de edición y revisión.
De qué hablaremos a continuación
- Qué puede explicar cada uno de los tres tipos de pruebas de escritura.
- Cuáles son las diferencias reales entre los siete modelos.
- Cómo organizar el modelo principal y los modelos sustitutos según las distintas tareas operativas.
- Cómo calcular los costos y completar una prueba a ciegas con una interfaz unificada.
Qué Modelo de Lenguaje Grande elegir para redactar artículos de operación: primero, entiende los criterios de evaluación
Un benchmark de modelos es un conjunto de pruebas que mide el rendimiento de los modelos con tareas unificadas. Al seleccionar modelos para operaciones, conviene priorizar las pruebas que se acercan al flujo real de producción: los mismos materiales, la misma planificación, la misma extensión y, después, comparar el borrador final.
¿Qué Modelo de Lenguaje Grande elegir para escribir artículos de operación: las puntuaciones en inglés sirven para filtrar candidatos
El AI Writing Benchmark se actualizó el 11 de noviembre de 2026 y usa tareas comunes de escritura en inglés junto con comparaciones en las que se ocultan los nombres de los modelos; cubre 115 modelos y 131,507 evaluaciones a ciegas.
La puntuación global en inglés de GPT-6.1 Sol es 95.3, y en la categoría de artículos, blogs y edición llega a 98.5. Claude Opus 5.5 y Kimi K3.1 Pro obtienen puntuaciones globales de 92.9 y 91.9 respectivamente, ambas de referencia.
Dicho sin rodeos: GPT merece entrar en la lista de candidatos para escribir blogs; si permite dar menos repasos a una cuenta de WeChat en chino, eso todavía hay que probarlo en local. El proyecto lo mantiene una sola persona, así que tanto el idioma como la forma de evaluar deberían entrar en la valoración.
Hay que fijarse especialmente en las versiones: en la categoría de explicación y divulgación, quien lidera es Kimi K3; en ToneBench, la puntuación de 89.0 en el apartado «menos tono de plantilla» corresponde a GPT-6 Sol. Ambas puntuaciones pertenecen a nombres de versiones antiguas.
¿Qué Modelo de Lenguaje Grande elegir para escribir artículos de operación: la prueba de guiones se acerca más a escribir con un paquete de materiales
La instantánea de ToneBench del 10 de noviembre de 2026 evalúa guiones de videos largos en inglés: el modelo lee los requisitos de creación y el paquete de materiales de investigación, y genera a libro cerrado; cubre 87 modelos, 151 configuraciones y 7,550 guiones.
La siguiente tabla recoge el Writing Score de las configuraciones seleccionadas. Claude usa la configuración xhigh; cada fila mantiene la configuración de razonamiento de su propia prueba y no se unificó el cálculo del presupuesto, así que aquí solo se listan las puntuaciones, sin mezclar los rankings de modelos con los de configuraciones.
| Modelo | Writing Score | Coste estimado por guion según la prueba |
|---|---|---|
| GPT-6.1 Sol | 82.4 | $0.239 |
| Claude Opus 5.5, xhigh | 85.8 | $1.003 |
| Kimi K3.1 Pro | 82.5 | $0.251 |
| Gemini 4 Carbon | 80.1 | $0.586 |
| Qwen3.8 Max | 76.8 | $0.207 |
| DeepSeek V4.1 Flash, versión 1017 | 81.6 | $0.014 |
| DeepSeek V4 Pro | 80.1 | $0.077 |
La señal clave es esta: Opus es el indicado para probar primero textos largos de alta calidad, mientras que Flash muestra una competitividad de bajo coste. Los costes de la tabla corresponden a la carga de trabajo de guiones de esa prueba y no se pueden trasladar directamente como tarifa para artículos de operación en chino.
Esta prueba usa evaluación por modelos, así que existe preferencia de proveedor; los intervalos de confianza de las configuraciones líderes se solapan, y cambios en los guiones de referencia también pueden alterar el primer puesto. Sirve para reducir el abanico de candidatos y luego dejar que un editor lo valide.
Nota sobre la ilustración: a continuación se presenta la distribución de candidatos según calidad y coste; los datos provienen de la instantánea de ToneBench mencionada. Al replicar la prueba a través de APIYI apiyi.com, conviene registrar por separado los propios tokens, la configuración y el tiempo de edición.
Qué Modelo de Lenguaje Grande elegir para escribir artículos para operaciones de contenido: evidencia en chino y ámbito de aplicación
OmniTools probó artículos financieros en profundidad en chino del 26 de octubre al 3 de noviembre de 2026; 10 modelos generaron 26 artículos en total. La puntuación de Opus 5.5 en la evaluación ciega por IA fue de 8.25, y la de GPT-6.1 Sol, de 6.33.
Esto proporciona a Opus una base como candidato para textos largos en chino. Pero la muestra es pequeña, el número de artículos varía entre modelos y el equipo de pruebas tiene antecedentes en servicios comerciales de enrutamiento, así que conviene limitar la conclusión a este caso de artículos financieros extensos.
Qué Modelo de Lenguaje Grande elegir para escribir artículos para operaciones de contenido: 7 modelos, uno por uno
Qué Modelo de Lenguaje Grande elegir para escribir artículos para operaciones de contenido: cómo repartir el trabajo entre GPT y Claude
GPT-6.1 Sol: candidato prioritario para la redacción diaria. Destaca en la categoría de artículos en inglés, así que conviene probarlo primero en blogs de tecnología, análisis de productos y comentarios de noticias. La naturalidad en chino y la precisión de las citas deben puntuarse por separado.
Claude Opus 5.5: candidato prioritario para textos largos importantes. Tanto las pruebas de script como el caso financiero en chino lo respaldan. Para artículos especiales y textos largos de marca, se puede probar primero; en cambio, para piezas cortas de alta frecuencia, conviene comparar si la mejora de calidad justifica un precio más alto.
Qué Modelo de Lenguaje Grande elegir para escribir artículos para operaciones de contenido: cómo usar Kimi, Gemini y Qwen
Kimi K3.1 Pro: candidato para tareas con materiales extensos. Su ventana de contexto de aproximadamente 1M de tokens y los resultados de redacción general en inglés respaldan incluirlo en pruebas de artículos intensivos en conocimiento. El desempeño de K3 en la categoría de divulgación científica debe considerarse por separado.
Gemini 4 Carbon: candidato para el análisis de documentación compleja. Se le puede pedir primero que estructure problemas de varios pasos, relaciones entre evidencias y esquemas de artículos, y luego comparar el resultado de la redacción directa. La evidencia actual sirve más para respaldar una decisión de candidato.
Qwen3.8 Max: candidato para producción estructurada. Se puede probar con descripciones de productos, secciones fijas y contenido basado en plantillas. Su límite de contexto por solicitud en inferencia por lotes es de 256K; antes de integrarlo, hay que verificar el soporte regional.
Qué Modelo de Lenguaje Grande elegir para escribir artículos para operaciones de contenido: cómo elegir entre DeepSeek Flash y Pro
DeepSeek V4.1 Flash: candidato prioritario para borradores de bajo costo. En las pruebas de script mencionadas, equilibra puntuación y costo, y resulta adecuado para borradores por lotes, reescritura y explicación de conocimientos. Antes de publicar, mantenga la revisión humana de los hechos.
DeepSeek V4 Pro: candidato para tareas específicas. La API sigue prestando servicio, pero en esa prueba de script Flash obtuvo una puntuación más alta. Solo cuando una prueba ciega de la tarea concreta demuestre un beneficio vale la pena aumentar el presupuesto.
Qué Modelo de Lenguaje Grande elegir para escribir artículos de operaciones: un plan por capas según la tarea
Este es el orden de pruebas elaborado a partir de la evidencia disponible. Los resultados de adopción en chino los decide el equipo mediante evaluación ciega.
| Tarea de operaciones | Candidato prioritario | Alternativa o plan complementario |
|---|---|---|
| Noticias tecnológicas, blogs del día a día | GPT-6.1 Sol | Flash redacta el borrador, GPT lo pule |
| Análisis profundo de sector, artículos de marca extensos | Claude Opus 5.5 | Prueba ciega con GPT sobre el mismo tema |
| Tutoriales técnicos, divulgación de conocimiento | GPT, Kimi K3.1 Pro | Flash como referencia de bajo costo |
| Síntesis de materiales extensos, temas complejos | Kimi, Gemini | Primero ordenar la evidencia, luego pasarla al modelo de redacción final |
| Artículos de marketing, contenido corto para redes | GPT para probar primero el contenido corto | Sumar Opus en los artículos de marca extensos |
| Contenido estructurado por lotes | Qwen, Flash | Definir el modelo principal según la tasa de adopción |
| Plataformas disponibles | Interfaces oficiales correspondientes | APIYI apiyi.com para invocar y comparar de forma unificada |
El modelo líder en inglés dentro de la categoría de marketing y ventas es Claude Sonnet 5.5, que queda fuera de estos siete. Si los textos de marketing son el negocio central, conviene ampliar el grupo de candidatos en lugar de buscar al campeón solo entre los modelos de artículos largos.
Consejo para arrancar rápido: APIYI apiyi.com ofrece una interfaz compatible con OpenAI con la que una sola clave API invoca varios modelos, y los usuarios nuevos tienen crédito de prueba gratuito. Empiece comparando tres modelos sobre un mismo tema y después amplíe el alcance de las pruebas.
Qué modelo de lenguaje grande elegir para escribir artículos de marketing operativo: calcular el costo hasta obtener un borrador aceptable
El token es la unidad de medida que utiliza el modelo para procesar texto; los tokens de entrada incluyen las indicaciones, los materiales y el contexto, mientras que los tokens de salida incluyen el contenido generado. La ventana de contexto indica el rango que puede procesarse en una sola invocación.
A continuación se utiliza la instantánea de precios de APIYI del 12 de noviembre de 2026 a las 10:45, UTC+8, en dólares por millón de tokens. El ejemplo se calcula de forma uniforme con 10,000 tokens de entrada y 3,000 tokens de salida.
| Modelo | Precio de entrada | Precio de salida | Costo del ejemplo por invocación |
|---|---|---|---|
| GPT-6.1 Sol | $2 | $10 | $0.05000 |
| Claude Opus 5.5 | $4 | $20 | $0.10000 |
| Kimi K3.1 Pro | $2 | $10 | $0.05000 |
| Gemini 4 Carbon | $2 | $10 | $0.05000 |
| Qwen3.8 Max | $1.65 | $4.95 | $0.03135 |
| DeepSeek V4.1 Flash | $0.30 | $1.20 | $0.00660 |
| DeepSeek V4 Pro | $1.32 | $3.96 | $0.02508 |
El método de cálculo es «cantidad de entrada ÷ millón × precio unitario de entrada + cantidad de salida ÷ millón × precio unitario de salida». Esta tabla compara el costo base de una generación; los reintentos, la revisión y el tiempo de edición deben calcularse aparte.
Las diferencias de ruta también modifican la factura y las funcionalidades:
- Precio regional oficial de Qwen: Singapur es $2/$6; Pekín y Virginia, EE. UU., son $1.65/$4.951.
- Conexión directa oficial de Gemini: el período introductorio dura hasta el 30 de noviembre; a partir del 1 de diciembre es $4/$20, y los tokens de razonamiento se incluyen en el costo de salida. Los terceros deben verificarlo según sus propios anuncios.
- Conexión directa oficial de DeepSeek: el precio fuera de horas pico se reduce a la mitad; los horarios aplicables deben verificarse según las reglas oficiales.
- Capacidad de procesamiento por lotes de Kimi: las reglas de lotes del canal Moonshot deben confirmarse por separado; la documentación de Alibaba Cloud K3.1 Pro señala que no admite inferencia por lotes.
La caché de indicaciones consiste en reutilizar entradas repetidas y facturarlas según las reglas del proveedor. Una interfaz unificada facilita el cambio, pero la caché, la búsqueda, el modo de razonamiento y la capacidad por lotes aún deben confirmarse ruta por ruta.
¿Qué Modelo de Lenguaje Grande elegir para escribir artículos de operaciones? Cómo montar una prueba ciega de verdad
Una llamada mínima basta para comprobar que la interfaz responde. Aquí solo mostramos la generación de texto, sin activar búsqueda ni otras herramientas.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
result = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "根据给定资料写运营文章大纲。"}],
)
print(result.choices[0].message.content)
Para una comparación completa, usa los mismos materiales y la misma tarea, y pide al menos tres generaciones independientes por modelo. Abajo guardamos los borradores y el consumo; a la hora de evaluar, oculta las etiquetas de modelo y deja que el editor anote el tiempo de edición y si el texto se adoptó o no.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
models = ["gpt-6.1-sol", "claude-opus-5-5", "kimi-k3.1-pro"]
packet = "在此粘贴同一份已核验资料包。"
results = []

for model in models:
    for trial in range(3):
        response = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system",
                 "content": "仅依据资料写作,缺少依据的观点请省略。"},
                {"role": "user",
                 "content": f"写一篇运营文章,先回答问题,再展开论证。\n资料:{packet}"},
            ],
        )
        results.append({
            "model": model,
            "trial": trial,
            "text": response.choices[0].message.content,
            "usage": response.usage.model_dump() if response.usage else None,
        })
Te sugiero evaluar cinco cosas: precisión de los datos, ejecución del planteamiento, naturalidad del chino, legibilidad y valor añadido del contenido. Anota también la tasa de retención editorial y el coste por pieza aceptable: si un borrador barato acaba necesitando una reescritura completa, lo que te ahorras son céntimos y lo que te gastas es la tarde entera.
¿Qué Modelo de Lenguaje Grande elegir para escribir artículos de operaciones? Preguntas frecuentes
Con presupuesto ajustado, ¿qué modelos pruebo primero?
Empieza comparando Flash, GPT y Opus: cubren el tramo de bajo coste, el texto diario y las piezas largas que de verdad importan. Cambiar de modelo a través de APIYI apiyi.com te ahorra tener que configurar una integración para cada uno.
¿Basta una sola interfaz para que la comparación sea del todo justa?
APIYI apiyi.com puede unificar la forma de invocación; para que la comparación sea justa también hace falta igualar materiales, permisos de herramientas, extensión y configuración de razonamiento. Anota la versión del modelo y el endpoint, para no acabar mezclando condiciones de trabajo distintas.
Qué modelo de lenguaje grande elegir para escribir artículos de operaciones: recomendaciones finales
Adopte una selección por niveles: para borradores habituales, use candidatos de bajo costo; para artículos importantes, candidatos de alta calidad; la verificación factual déjela a un proceso de revisión independiente y mantenga la validación humana. Al final, la recomendación de modelos debe supeditarse a la tasa real de adopción del equipo.
Se recomienda validar la combinación anterior a través de APIYI apiyi.com, probar según el consumo y verificar los precios más recientes. El objetivo final de la selección es producir artículos aceptables de forma estable, no asignar todo el trabajo al campeón de la clasificación.
Referencias
- AI Writing Benchmark: aiwritingbenchmark.com, actualizado el 11 de noviembre de 2026.
- ToneBench: benchmark.towardsai.com/models/, instantánea del 10 de noviembre de 2026.
- Prueba práctica de OmniTools con textos largos en chino: omnitools.ai/evals/longform-writing.
- Precios oficiales de Alibaba Cloud: alibabacloud.com/help/en/model-studio/model-pricing, consultado el 12 de noviembre de 2026.
- Ajuste oficial de precios de Gemini: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
Autor: equipo de contenido técnico de APIYI. Estamos abiertos a intercambiar ideas sobre la invocación de modelos y la evaluación de artículos de operaciones en apiyi.com; al comparar, incluya la versión, la configuración y los criterios de la tarea.