الخلاصة
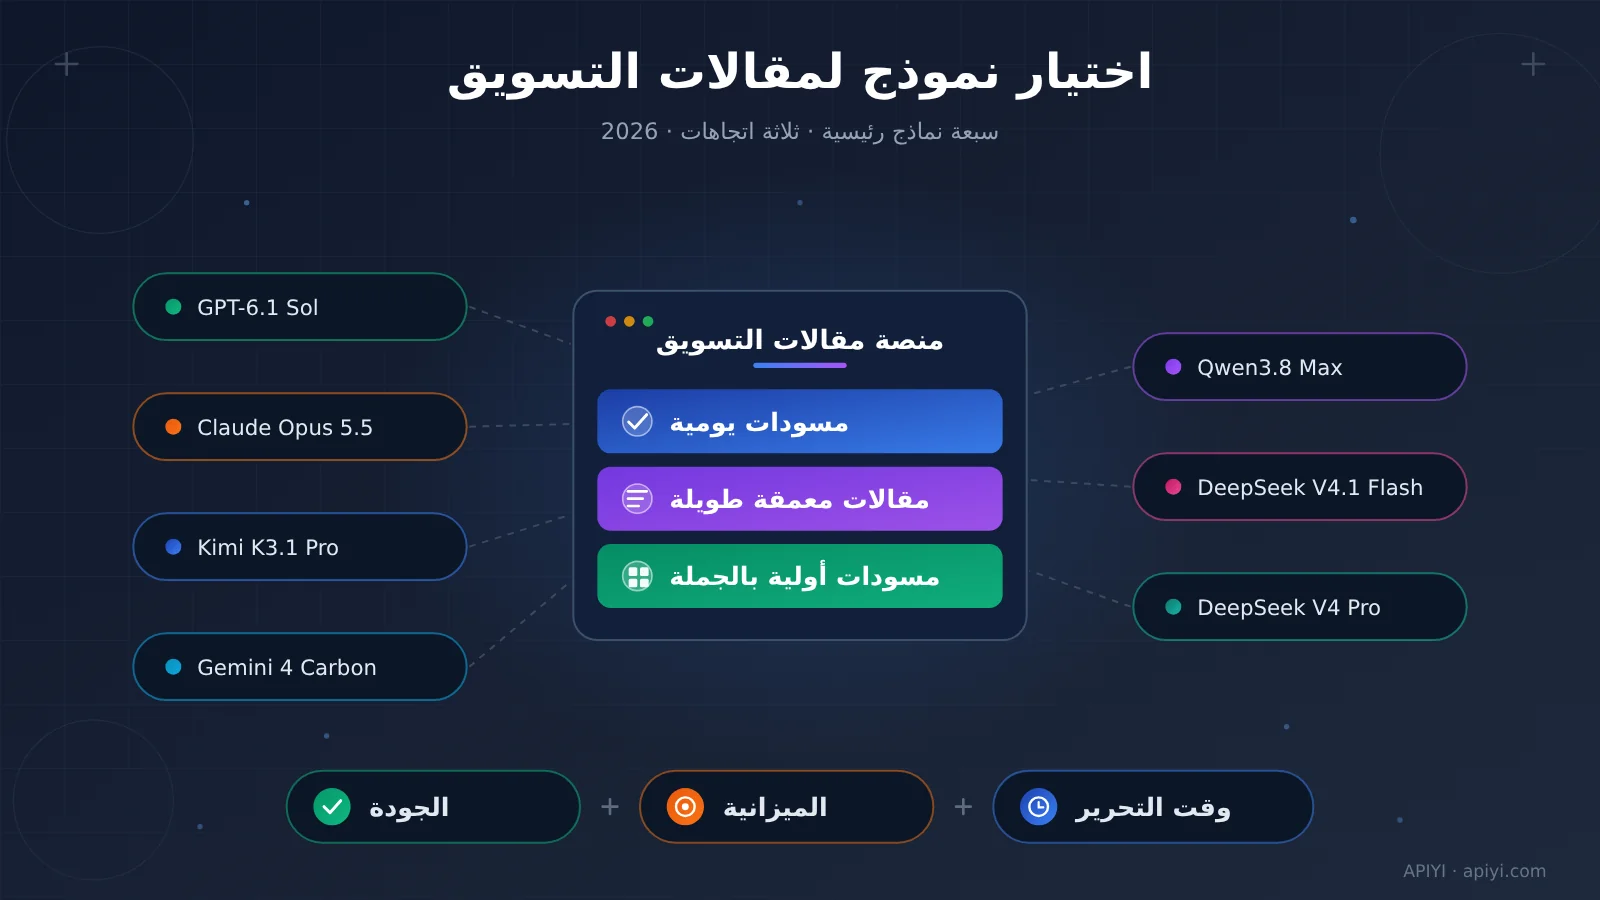
للمقالات اليومية ابدأ بتجربة GPT-6.1 Sol، وللمقالات الطويلة المهمة ابدأ بتجربة Claude Opus 5.5، وللمسودات الأولية بالجملة ابدأ بتجربة DeepSeek V4.1 Flash. أما المهام كثيفة المعلومات فأضف إليها Kimi وGemini، والإنتاج المنظم أضف إليه Qwen، بينما DeepSeek Pro فتحقّق منه حسب المهمة المحددة.
هذه مرشحات للاختبار، وليست قائمة أبطال الكتابة بالصينية. والتركيبة المُجزية فعلاً لا بد أن تنظر في الوقت نفسه إلى فهم المواد، وجودة المقال، وتكلفة استدعاء النموذج، ووقت التحرير والتعديل.
ما الذي ستتناوله الأجزاء التالية
- ماذا يوضح كل نوع من اختبارات الكتابة الثلاثة.
- ما الفروق العملية بين النماذج السبعة.
- كيف تُرتّب النماذج الأساسية والبديلة لمهام التشغيل المختلفة.
- كيف تُحسب التكلفة، وكيف يُنفَّذ اختبار أعمى عبر واجهة موحّدة.
أي نموذج لغة كبير تختار لكتابة مقالات التشغيل: افهم منهجية الاختبار أولاً
معيار قياس النماذج هو مجموعة اختبارات تقيس أداء النموذج عبر مهام موحّدة. وعند اختيار النموذج لمهام التشغيل، ينبغي إعطاء الأولوية للاختبارات القريبة من سير العمل الفعلي: المواد نفسها، والتخطيط نفسه، وحجم النص نفسه، ثم مقارنة المسودة النهائية.
أي نموذج لغة كبير تختاره لكتابة مقالات العمليات: درجات الإنجليزية أولاً لتصفية المرشحين
تم تحديث AI Writing Benchmark في 11 نوفمبر 2026، وهو يعتمد مهام كتابة إنجليزية موحّدة ومقارنة بأسماء نماذج مخفية، ويغطي 115 نموذجًا و131,507 تقييمًا أعمى.
حصل GPT-6.1 Sol على درجة إجمالية في الإنجليزية قدرها 95.3، ودرجة 98.5 في فئة المقالات والمدونات والتحرير. أما Claude Opus 5.5 وKimi K3.1 Pro فجاءت درجاتهما الإجمالية 92.9 و91.9 على التوالي، وكلها درجات أساسية.
بصراحة، يستحق GPT أن يدخل قائمة المرشحين لكتابة المدونات؛ لكن هل يمكن تقليل عدد مرات التعديل عند كتابة محتوى لحساب WeChat الرسمي بالصينية؟ هذا يحتاج إلى اختبار محلي. المشروع يُصانه شخص واحد، لذا ينبغي أن تُوضع اللغة وطريقة التقييم أيضًا في الحسبان عند اتخاذ القرار.
ويجب الانتباه جيدًا إلى الإصدارات: المتصدّر في فئة الشرح والتوعية العلمية هو Kimi K3؛ وفي ToneBench، درجة 89.0 في بند «أقل قالبية» تعود إلى GPT-6 Sol. والدرجتان تخصان اسمَي إصدارين قديمين.
أي نموذج لغة كبير تختاره لكتابة مقالات العمليات: اختبار السيناريو أقرب إلى كتابة حزمة المواد
لقطة ToneBench بتاريخ 10 نوفمبر 2026 تدرس سيناريوهات الفيديوهات الطويلة بالإنجليزية: يقرأ النموذج متطلبات الكتابة وحزمة مواد البحث، ثم يكتب دون مصادر مفتوحة، وتغطي 87 نموذجًا و151 إعدادًا و7,550 مسودة.
الجدول التالي يقتطف Writing Score للإعدادات المختارة. إعداد Claude هو xhigh؛ وكل صف يتبع إعداد الاستدلال الخاص باختباره، ولم تُوحّد ميزانية الحساب، لذلك نكتفي هنا بذكر الدرجات دون خلط ترتيب قائمة النماذج بترتيب قائمة الإعدادات.
| النموذج | Writing Score | التكلفة المقدّرة للسيناريو الواحد في الاختبار |
|---|---|---|
| GPT-6.1 Sol | 82.4 | $0.239 |
| Claude Opus 5.5، xhigh | 85.8 | $1.003 |
| Kimi K3.1 Pro | 82.5 | $0.251 |
| Gemini 4 Carbon | 80.1 | $0.586 |
| Qwen3.8 Max | 76.8 | $0.207 |
| DeepSeek V4.1 Flash، إصدار 1017 | 81.6 | $0.014 |
| DeepSeek V4 Pro | 80.1 | $0.077 |
الإشارة الأساسية هي: Opus مناسب للاختبار الأولي للمسودات الطويلة عالية الجودة، وFlash يُظهر قدرة تنافسية بتكلفة منخفضة. التكاليف في الجدول تخص حجم عمل السيناريو في ذلك الاختبار، ولا يمكن تحويلها مباشرة إلى سعر لكتابة مقالة عمليات بالصينية.
يعتمد هذا الاختبار على تقييم نموذج، وفيه تحيّز لجهة معينة؛ كما أن فترات الثقة للإعدادات المتصدرة متداخلة، وتغيّر السيناريوهات المرجعية يؤثر أيضًا في المتصدر. لذا فهو مناسب لتضييق نطاق المرشحين، ثم يُترك التحقق للمحرر.
توضيح الرسم: فيما يلي توزيع المرشحين حسب الجودة والتكلفة؛ البيانات من لقطة ToneBench المذكورة أعلاه. عند إعادة الاختبار عبر APIYI apiyi.com، ينبغي تسجيل الـ Token والإعدادات ووقت التحرير الخاصة بك بشكل منفصل.
أي نموذج لغة كبير لكتابة مقالات المحتوى التشغيلي: أدلة صينية حول مجال الاستخدام
اختبر OmniTools بين 26 أكتوبر 2026 و3 نوفمبر 2026 مسودات مالية اقتصادية معمقة بالصينية، وأنتجت 10 نماذج ما مجموعه 26 مقالًا. حصل Opus 5.5 على 8.25 في التقييم الأعمى بالذكاء الاصطناعي، بينما حصل GPT-6.1 Sol على 6.33.
يمنح هذا Opus أساسًا لترشيحه للمقالات الطويلة بالصينية. لكن العينة صغيرة، وعدد المقالات يختلف من نموذج لآخر، ولدى الجهة القائمة على الاختبار خلفية في خدمات التوجيه التجاري؛ لذا يُستحسن حصر الاستنتاج في حالة المقالات المالية الطويلة هذه.
أي نموذج لغة كبير لكتابة مقالات المحتوى التشغيلي: اختيار 7 نماذج واحدًا واحدًا
أي نموذج لغة كبير لكتابة مقالات المحتوى التشغيلي: كيف نقسم المهام بين GPT وClaude
GPT-6.1 Sol: مرشح مفضل للمسودات اليومية. نتائجه بارزة في فئة المقالات الإنجليزية، وهو مناسب لاختبار المدونات التقنية وتحليلات المنتجات وتفسير الأخبار أولًا. ويجب تقييم الطبيعية في اللغة الصينية ودقة الاقتباسات كل على حدة.
Claude Opus 5.5: مرشح مفضل للمقالات الطويلة المهمة. تدعمه اختبارات السكربتات وحالة المقالات المالية الصينية. يمكن اختباره أولًا في الملفات الخاصة والمقالات الطويلة للعلامات التجارية؛ أما المسودات القصيرة المتكررة، فينبغي مقارنة ما إذا كانت الزيادة في الجودة تستحق التكلفة الأعلى.
أي نموذج لغة كبير لكتابة مقالات المحتوى التشغيلي: كيف نستخدم Kimi وGemini وQwen
Kimi K3.1 Pro: مرشح لمهام المواد الطويلة. يدعم سياقه الذي يبلغ نحو 1M Token ونتائجه في الكتابة الإنجليزية الشاملة إدراجه في اختبارات المقالات كثيفة المعرفة. أما نتائج K3 في فئة التوعية العلمية فيجب النظر إليها بشكل منفصل.
Gemini 4 Carbon: مرشح لتحليل المواد المعقدة. يمكن أولًا أن نجعله يرتب المشكلات متعددة الخطوات وعلاقات الأدلة ومخطط المقال، ثم نقارن فعالية الإنتاج المباشر للمسودة. الأدلة الحالية أنسب لدعم قرار الترشيح.
Qwen3.8 Max: مرشح للإنتاج المنظم. يمكن اختبار أوصاف المنتجات والأقسام الثابتة والمحتوى القائم على القوالب. حد السياق في الطلب الواحد للاستدلال بالدفعات لديه هو 256K، لذا يجب التحقق من دعم المنطقة قبل الدمج.
أي نموذج لغة كبير لكتابة مقالات المحتوى التشغيلي: كيف نختار بين DeepSeek Flash وPro
DeepSeek V4.1 Flash: مرشح مفضل للمسودات منخفضة التكلفة. في اختبار السكربتات المذكور أعلاه يوازن بين النتيجة والتكلفة، وهو مناسب للمسودات بالجملة وإعادة الصياغة وتفسير المعرفة. احتفظ بمراجعة بشرية للوقائع قبل النشر.
DeepSeek V4 Pro: مرشح للمهام المتخصصة. لا تزال API تقدم الخدمة، لكن Flash حصل على درجة أعلى في اختبار السكربتات هذا. لا يستحق زيادة الميزانية إلا إذا أثبت اختبار أعمى لمهمة محددة وجود عائد.
أي نموذج لغة كبير تختار لكتابة مقالات التشغيل: خطة متدرجة حسب المهمة
فيما يلي ترتيب الاختبارات المبني على الأدلة المتاحة، ويُترك قرار اعتماد النتائج باللغة الصينية للتقييم الأعمى من الفريق.
| مهمة التشغيل | المرشح المفضل | البديل أو الخطة المساندة |
|---|---|---|
| أخبار التقنية والمدونات اليومية | GPT-6.1 Sol | Flash يُعدّ المسودة، وGPT يراجع |
| تحليل صناعي معمّق ومقالات العلامة التجارية الطويلة | Claude Opus 5.5 | اختبار أعمى لـGPT على الموضوع نفسه |
| الدروس التقنية والتبسيط المعرفي | GPT وKimi K3.1 Pro | Flash كمرجع منخفض التكلفة |
| تجميع المواد الطويلة والمواضيع المعقدة | Kimi وGemini | نظّم الأدلة أولاً، ثم سلّمها لنموذج إعداد المسودة |
| المقالات التسويقية والمحتوى القصير لوسائل التواصل | اختبر GPT أولاً في المحتوى القصير | أضف Opus إلى مقالات العلامة التجارية الطويلة |
| المحتوى المهيكل بالجملة | Qwen وFlash | حدّد النموذج الأساسي وفق معدل الاعتماد |
| المنصات المتاحة | الواجهات الرسمية المقابلة | استدعاء موحّد ومقارنة عبر APIYI apiyi.com |
النموذج الإنجليزي الرائد في فئة التسويق والمبيعات هو Claude Sonnet 5.5، وهو خارج هذه السبعة. وإذا كانت نصوص التسويق هي العمل الأساسي، فيمكن توسيع مجموعة المرشحين، بدلاً من اختيار الأفضل من بين نماذج المقالات الطويلة فقط.
نصيحة للبدء السريع: يوفّر APIYI apiyi.com واجهة متوافقة مع OpenAI تتيح استدعاء عدة نماذج بمفتاح API واحد، وللمستخدمين الجدد رصيد اختبار مجاني. قارن ثلاثة نماذج على الموضوع نفسه أولاً، ثم وسّع نطاق الاختبار.
أي نموذج لغة كبير تختار لكتابة مقالات التسويق: احسب التكلفة حتى تصل إلى مسودة مقبولة
الـ Token هو وحدة القياس التي تعالج بها النماذج النصوص؛ وتشمل رموز الإدخال الموجهَ والموادَ والسياق، بينما تشمل رموز الإخراج المحتوى المُولَّد. أما نافذة السياق فتعبر عن حجم ما يمكن معالجته في استدعاء واحد.
نستخدم فيما يلي لقطة أسعار APIYI بتاريخ 12 نوفمبر 2026، الساعة 10:45 بتوقيت UTC+8، والوحدة هي الدولار لكل مليون Token. وجميع الأمثلة محسوبة على أساس إدخال 10,000 Token وإخراج 3,000 Token.
| النموذج | سعر الإدخال | سعر الإخراج | تكلفة المثال الواحد |
|---|---|---|---|
| GPT-6.1 Sol | $2 | $10 | $0.05000 |
| Claude Opus 5.5 | $4 | $20 | $0.10000 |
| Kimi K3.1 Pro | $2 | $10 | $0.05000 |
| Gemini 4 Carbon | $2 | $10 | $0.05000 |
| Qwen3.8 Max | $1.65 | $4.95 | $0.03135 |
| DeepSeek V4.1 Flash | $0.30 | $1.20 | $0.00660 |
| DeepSeek V4 Pro | $1.32 | $3.96 | $0.02508 |
طريقة الحساب هي «حجم الإدخال ÷ المليون × سعر الإدخال + حجم الإخراج ÷ المليون × سعر الإخراج». ويقارن هذا الجدول التكلفة الأساسية لعملية توليد واحدة؛ أما إعادة المحاولة والمراجعة والتحرير ووقت التحرير فتُحسب على حدة.
كما أن اختلاف مسار الاستدعاء (Route) يغيّر الفاتورة والمزايا المتاحة:
- الأسعار الإقليمية الرسمية لـ Qwen: سنغافورة $2/$6؛ وبكين وفرجينيا الأمريكية $1.65/$4.951.
- الاتصال المباشر الرسمي بـ Gemini: سعر الفترة التعريفية سارٍ حتى 30 نوفمبر؛ وابتداءً من 1 ديسمبر يصبح $4/$20، وتُحتسب رموز الاستدلال ضمن تكلفة الإخراج. أما المزوّدون الخارجيون فتُراجع أسعارهم حسب إعلان كلٍّ منهم.
- الاتصال المباشر الرسمي بـ DeepSeek: السعر خارج ساعات الذروة يُخفَّض إلى النصف، وتُتحقق الفترات السارية وفق القواعد الرسمية.
- قدرة الدفعات في Kimi: تحتاج قواعد الدفعات في قناة Moonshot إلى تأكيد منفصل؛ وتوثيق Alibaba Cloud لـ K3.1 Pro يشير إلى عدم دعم الاستدلال بالدفعات.
أما تخزين الموجه المؤقت (Prompt Caching) فهو إعادة استخدام المدخلات المكررة واحتسابها وفق قواعد المزوّد. والواجهة الموحّدة تسهّل التبديل بين النماذج، لكن التخزين المؤقت والبحث وأوضاع الاستدلال وقدرات الدفعات لا تزال بحاجة إلى تحقق لكل مسار استدعاء على حدة.
أي نموذج لغة كبير تختاره لكتابة المقالات التشغيلية: كيف تُجري اختبارًا أعمى فعليًا
الاستدعاء البسيط جدًا مناسب للتحقق من اتصال الواجهة. المثال التالي يعرض توليد النص فقط، دون تفعيل البحث أو أي أدوات أخرى.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
result = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "根据给定资料写运营文章大纲。"}],
)
print(result.choices[0].message.content)
المقارنة الكاملة تتطلب استخدام المصادر نفسها والمهمة نفسها، مع توليد ثلاث مرات مستقلة على الأقل لكل نموذج. المثال التالي يحتفظ بالنص المُنتج وببيانات الاستخدام؛ وعند التقييم تُخفى بطاقات النماذج، ثم يسجّل المحرر وقت التعديل وحالة الاعتماد.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
models = ["gpt-6.1-sol", "claude-opus-5-5", "kimi-k3.1-pro"]
packet = "在此粘贴同一份已核验资料包。"
results = []

for model in models:
    for trial in range(3):
        response = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system",
                 "content": "仅依据资料写作,缺少依据的观点请省略。"},
                {"role": "user",
                 "content": f"写一篇运营文章,先回答问题,再展开论证。\n资料:{packet}"},
            ],
        )
        results.append({
            "model": model,
            "trial": trial,
            "text": response.choices[0].message.content,
            "usage": response.usage.model_dump() if response.usage else None,
        })
يُستحسن أن يغطي التقييم دقة الوقائع، وجودة التنفيذ التحريري، وطبيعية اللغة الصينية، وسهولة القراءة، والقيمة المضافة للمحتوى. وسجّل في الوقت نفسه نسبة ما يحتفظ به المحرر وتكلفة المقال المقبول الواحد: فإذا كانت المسودة الرخيصة تحتاج إلى إعادة كتابة كاملة، فما توفره هو بضع دراهم، وما يضيع هو يوم عمل كامل.
أي نموذج لغة كبير لكتابة المقالات التشغيلية: أسئلة شائعة
الميزانية محدودة، فأي النماذج أبدأ باختبارها؟
ابدأ بمقارنة Flash وGPT وOpus، لتغطية الخيار منخفض التكلفة، والكتابة اليومية، والمقالات الطويلة المهمة. والتبديل بين النماذج عبر APIYI apiyi.com يقلل جهد الإعداد المطلوب لكل مزوّل على حدة.
هل تكفي واجهة واحدة لجعل المقارنة عادلة تمامًا؟
يستطيع APIYI apiyi.com توحيد شكل الاستدعاء؛ لكن العدالة تتطلب أيضًا توحيد المصادر وصلاحيات الأدوات وطول النص وإعدادات الاستدلال. سجّل إصدار النموذج ونقطة النهاية، كي لا تخلط بين ظروف عمل مختلفة.
أي نموذج لغة كبير تختار لكتابة المقالات التشغيلية: توصيات ختامية
اعتمد اختيارًا متعدد الطبقات: استخدم نماذج منخفضة التكلفة للمسودات الأولية العادية، ونماذج عالية الجودة للمقالات المهمة، وأسند تدقيق الحقائق إلى عملية فحص مستقلة، مع الإبقاء على التحقق البشري. وفي النهاية، ينبغي أن تخضع توصيات النماذج لمعدل التبني الفعلي لدى الفريق.
نوصي بالتحقق من هذه التركيبة عبر APIYI على apiyi.com، واختبارها حسب حجم الاستخدام والتحقق من أحدث الأسعار. غاية الاختيار هي إنتاج مقالات مقبولة بثبات، لا تكليف متصدر لوحة الترتيب بكل العمل.
مراجع
- AI Writing Benchmark: aiwritingbenchmark.com، محدَّث في 11 نوفمبر 2026.
- ToneBench: benchmark.towardsai.com/models/، لقطة بتاريخ 10 نوفمبر 2026.
- اختبار OmniTools للنصوص الطويلة بالصينية: omnitools.ai/evals/longform-writing.
- الأسعار الرسمية من Alibaba Cloud: alibabacloud.com/help/en/model-studio/model-pricing، تم الاستعلام في 12 نوفمبر 2026.
- تعديل أسعار Gemini الرسمي: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
الكاتب: فريق المحتوى التقني في APIYI. نرحب بالتواصل حول استدعاء النماذج وتقييم المقالات التشغيلية على apiyi.com؛ وعند المقارنة يُرجى إرفاق الإصدار والإعدادات ونطاق المهمة.