Nota do autor: a partir da metáfora de Lai Jie, da Stardust Intelligence — “não me cobre uma taxa de tokens por cada parafuso apertado” —, vamos analisar quais etapas de um fluxo de trabalho de IA devem ficar a cargo de programas fixos e quais realmente exigem o julgamento de um Modelo de Linguagem Grande.
Em 5 de novembro de 2026, a coluna “Empresas Diversificadas”, do 爱范儿, publicou uma entrevista exclusiva com Lai Jie, fundador e CEO da Stardust Intelligence. Uma frase passou a ser repetida por muita gente que desenvolve aplicações de IA: “Quero que um programa fixo aperte os parafusos, funcionando 24 horas por dia, sem me cobrar uma taxa de tokens por cada parafuso apertado.”
Não é só uma frase de efeito. Na entrevista, Lai Jie falava da divisão de tarefas entre robôs: o modelo de IA incorporada cuida das ações físicas e, quando surge um problema, consulta o Modelo de Linguagem Grande de base em linguagem natural. Aplicada a fluxos de trabalho de software, essa ideia aponta para uma questão prática: afinal, em quais etapas de uma aplicação de IA não deveríamos invocar um Modelo de Linguagem Grande?
O que você vai encontrar aqui: este artigo adapta a visão sobre robôs apresentada na entrevista para definir os limites de invocação em fluxos de trabalho de software. Você vai conhecer 5 tipos de etapas que não precisam de um Modelo de Linguagem Grande, critérios de decisão em camadas e um exemplo de código de roteamento pronto para adaptar. Vale esclarecer que robôs e software são sistemas diferentes: a aplicação da ideia a seguir é uma analogia, e os resultados precisam ser verificados com seus próprios dados de uso.
“Não me cobre uma taxa em tokens por cada parafuso”: resumo
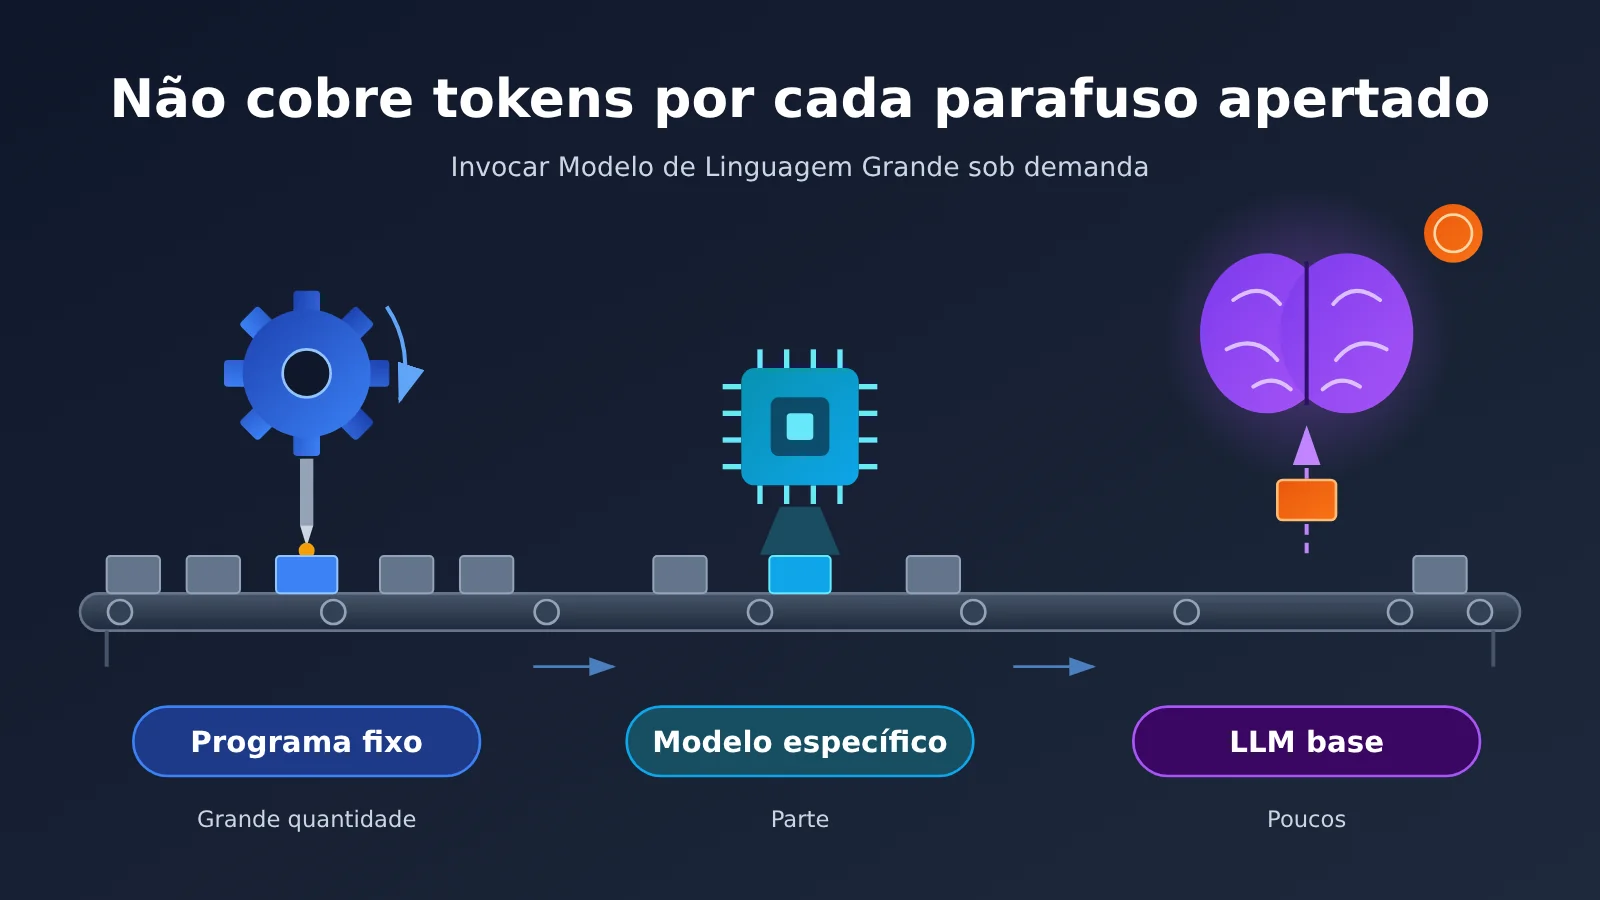
A frase veio na última pergunta da entrevista. Ao ser questionado sobre do que gostaria que os robôs libertassem os humanos, Lai Jie deixou claro que não quer vê-los “apertando parafusos em fábricas”. Por um lado, ele acredita que o valor dos robôs está na variedade de suas capacidades; por outro, do ponto de vista dos custos, não vale a pena pagar uma taxa em tokens por cada movimento de uma tarefa repetitiva.
| Item | Detalhes |
|---|---|
| Fonte | 15ª entrevista da coluna “Empresa da Diversidade”, da 爱范儿 |
| Data de publicação | 5 de novembro de 2026 |
| Entrevistado | Lai Jie, fundador e CEO da 星尘智能 e primeiro funcionário do laboratório de robótica Tencent Robotics X |
| Ideia central | Movimentos repetitivos devem ficar a cargo de programas predefinidos, sem pagar uma taxa em tokens a cada execução |
| Divisão de tarefas | O modelo de IA incorporada cuida da execução física e, ao encontrar um problema, consulta um Modelo de Linguagem Grande de base em linguagem natural |
| Lição para software | Os fluxos de trabalho de IA precisam definir quando invocar programas predefinidos, modelos especializados e Modelos de Linguagem Grande de base |
Vale destacar que a entrevista apresenta a opinião do fundador, sem dados de testes de custo ou validação por terceiros. O que aproveitamos aqui é a lógica de divisão de tarefas, não uma conclusão específica.
A analogia de Lai Jie: “ligar por vídeo para a mãe” para complementar o contexto
Na entrevista, Lai Jie usa uma analogia que explica a divisão de tarefas ainda melhor do que “apertar parafusos”. Ele diz que não sabe cozinhar, mas, se quiser aprender, pode fazer uma chamada de vídeo para a mãe. Ela diria: “Primeiro, coloque um pouco de óleo na panela quente”, sem precisar explicar qual garrafa contém o óleo. Se surgir alguma dúvida, ele pode perguntar. O ponto central é que a mãe complementa o conhecimento contextual, mas ele precisa saber colocar o óleo na panela, pois ela não pode fazer isso por ele do outro lado da chamada.
No caso de um robô, o modelo incorporado precisa perceber por conta própria parâmetros físicos como peso, força da pinça e estabilidade da pegada. Ele recorre ao Modelo de Linguagem Grande de base apenas para questões como: “Não consigo segurar direito, está um pouco instável. O que faço?”. Lai Jie acredita que treinar o Modelo de Linguagem Grande de base também com informações táteis “não é impossível, mas o custo não compensa, e a largura de banda da comunicação também seria um problema”. Ele acrescenta que não se trata de uma simples divisão em camadas, mas de uma organização em agentes parecida com a de uma colônia de formigas: cada agente pode não ser muito capaz sozinho, mas o conjunto é poderoso.
| Papel no sistema robótico | Responsabilidade na entrevista | Papel equivalente em um fluxo de trabalho de software |
|---|---|---|
| Programa fixo | Apertar parafusos repetidamente, 24 horas por dia | Motor de regras, expressões regulares, scripts, consultas a bancos de dados |
| Modelo incorporado | Execução física, percepção de parâmetros e tradução do estado para linguagem natural | Modelos pequenos especializados em classificação, extração e busca vetorial |
| Modelo de Linguagem Grande de base | Complementar o conhecimento contextual e oferecer soluções para problemas difíceis | Raciocínio complexo, geração aberta e decisões diante de exceções |
| Sistema operacional AOS | Encapsular capacidades em módulos de habilidades e integrá-los ao Modelo de Linguagem Grande e aos agentes | Camada de orquestração de fluxos de trabalho, camada de chamada de ferramentas e roteador |
Essa tabela é uma interpretação deste artigo, não uma citação direta da entrevista. Robôs lidam com controle em tempo real no mundo físico e limites de largura de banda na comunicação. Já os fluxos de trabalho de software são mais afetados por custos de tokens, latência e estabilidade. Portanto, os gargalos não são exatamente os mesmos.
Em quais etapas de uma aplicação de IA não usar um Modelo de Linguagem Grande: 5 critérios
Ao criar a primeira versão de um agente, muitas equipes costumam deixar todas as etapas nas mãos de um Modelo de Linguagem Grande: validação de formato, conversão de datas e até a verificação de campos vazios viram comandos para o modelo. Isso agiliza a criação do protótipo, mas, depois da implantação, cada requisição passa a pagar por tarefas determinísticas e ainda introduz uma imprevisibilidade desnecessária.
Seguindo a lógica de “apertar parafusos”, podemos usar os 5 critérios abaixo para decidir se vale a pena invocar o modelo em determinada etapa.
| Critério | Melhor usar um programa com regras fixas | Melhor usar um modelo especializado | Melhor usar um modelo de linguagem de base |
|---|---|---|---|
| A entrada é estruturada? | Campos fixos, formato definido | Texto semiestruturado | Linguagem natural aberta |
| Há uma única saída correta? | Sim | Número limitado de categorias | Várias respostas possíveis |
| É possível enumerar todas as regras? | Sim, com if/else | Muitas regras, mas padrões estáveis | Não |
| Qual é o custo de um erro? | Não pode haver erros | Alguns erros são aceitáveis, com revisão | É preciso ponderar vários fatores |
| Qual é a frequência de execução? | Muito alta, em toda requisição | Alta | Baixa, sob demanda |
Etapas do tipo “apertar parafusos” que cabem a programas com regras fixas
As etapas abaixo costumam ser altamente determinísticas e repetitivas. Usar um Modelo de Linguagem Grande nelas pode até reduzir a estabilidade:
- Validação e limpeza de formato: e-mails, números de celular, estruturas JSON e campos obrigatórios podem ser verificados com expressões regulares e validação de Schema.
- Consultas e cálculos: para status de pedidos, quantidades em estoque e somas de valores, consulte diretamente o banco de dados ou chame a interface do sistema. Não peça ao modelo para “deduzir” o resultado.
- Saída com modelo fixo: para SMS de notificação, comprovantes padronizados e cabeçalhos de relatórios, basta preencher as variáveis com um mecanismo de templates.
- Controle de fluxo e novas tentativas: desvios de fluxo, novas tentativas após timeout e filas para limitar a taxa de requisições são tarefas da camada de orquestração e não precisam da participação do modelo.
- Consultas frequentes atendidas pelo cache: quando a mesma pergunta aparece repetidamente, consulte primeiro o cache ou a base de perguntas frequentes e retorne o resultado diretamente se houver uma correspondência.
Etapas que realmente exigem o julgamento de um Modelo de Linguagem Grande
Por outro lado, vale a pena invocar um modelo de linguagem de base para responder às “perguntas que só a mãe do outro lado da linha consegue responder”: esclarecer uma intenção ambígua do usuário, reunir informações de várias fontes para chegar a uma conclusão, lidar com exceções não cobertas pelas regras ou gerar conteúdo criativo. Essas etapas têm algo em comum: não há uma única resposta, não é possível enumerar todas as regras e elas ocorrem com frequência relativamente baixa.
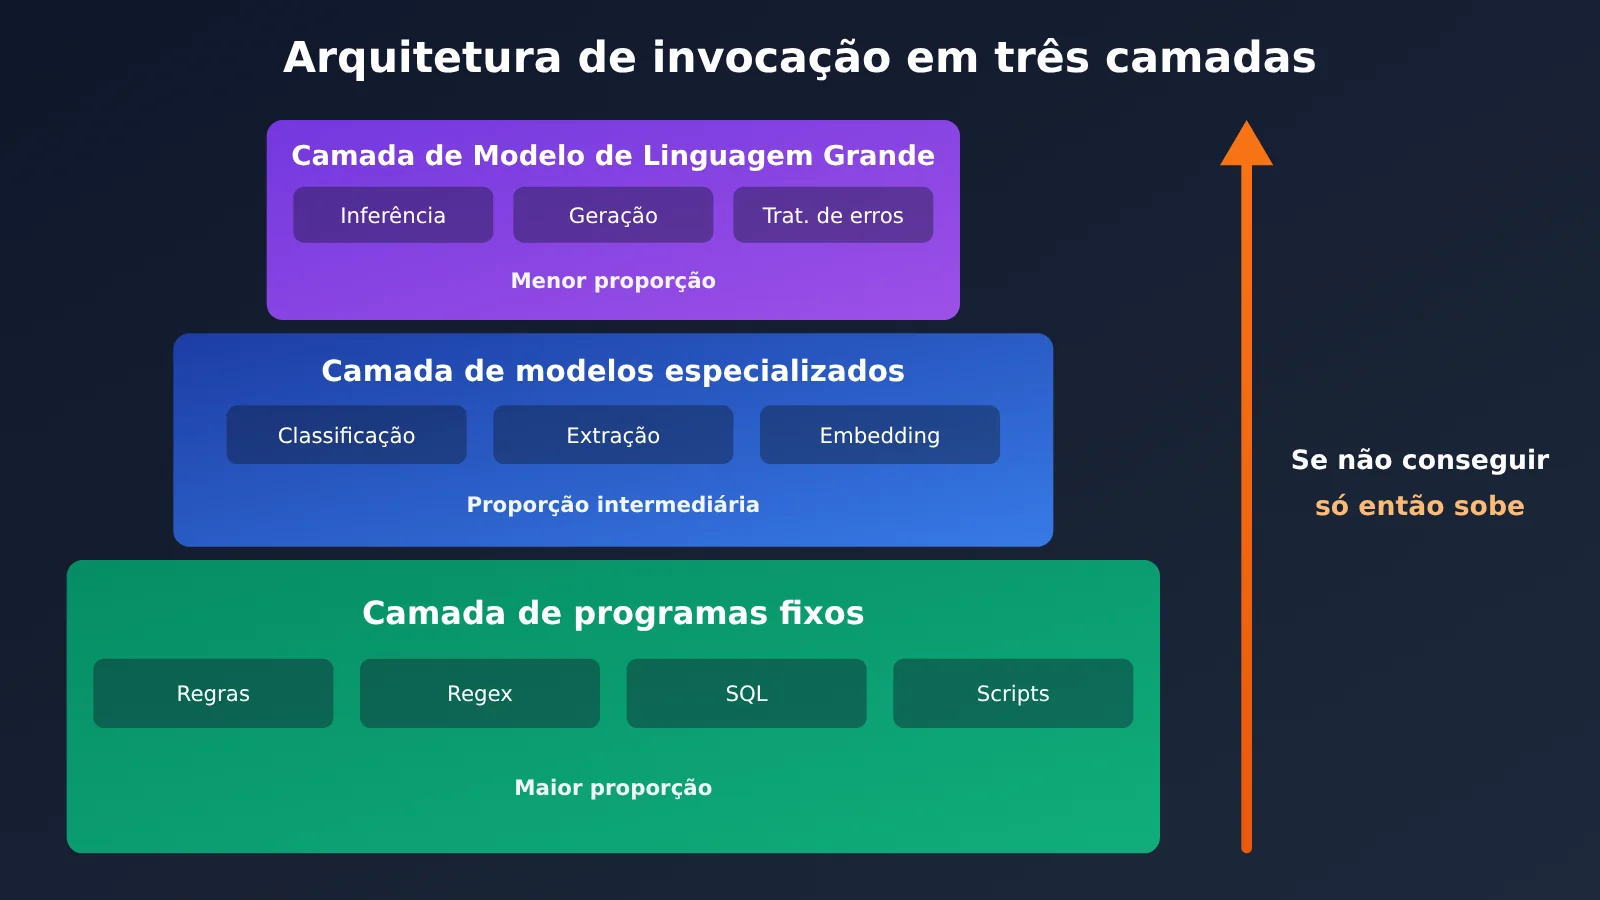
Os modelos especializados ficam entre os dois extremos. Para tarefas como classificação de intenção, extração de entidades, análise de sentimento e vetorização de texto, modelos menores muitas vezes dão conta do recado. Podemos entendê-los como a versão em software de um “modelo corporificado”: eles resolvem o que conseguem e organizam os casos que não conseguem tratar em perguntas claras para encaminhar à camada superior.
Exemplo de design em camadas para um fluxo de trabalho de IA: filtre primeiro as etapas que não precisam de um Modelo de Linguagem Grande
Vamos usar como exemplo um fluxo comum de “processamento automático de chamados de atendimento” para mostrar como definir, em cada etapa, quando invocar o modelo. Este é um exemplo de design, não um resultado medido em um projeto real.
| Etapa do fluxo de trabalho | Camada responsável | Forma de processamento | Consome tokens? |
|---|---|---|---|
| Validação dos campos do chamado | Programa convencional | Validação de schema; chamados com campos ausentes são devolvidos diretamente | Não |
| Consulta do pedido e do status de entrega | Programa convencional | Chamada à interface do banco de dados da empresa | Não |
| Correspondência com perguntas frequentes | Programa convencional / modelo especializado | Prioriza regras de palavras-chave, com busca vetorial como alternativa | Poucos |
| Classificação de intenção | Modelo especializado | Um modelo pequeno retorna uma entre poucas categorias | Poucos |
| Tratamento de reclamações complexas e situações excepcionais | Modelo de Linguagem Grande de base | Gera sugestões de encaminhamento com base no contexto do pedido | Sim |
| Preenchimento do modelo de resposta | Programa convencional | Um mecanismo de templates gera o texto final | Não |
Como dá para ver, apenas uma das seis etapas exige a invocação de um Modelo de Linguagem Grande de base. A economia de tokens, uma possível queda na taxa de sucesso e as mudanças na latência dependem do perfil do seu tráfego e da cobertura das regras. Para avaliar esses resultados, é necessário usar logs reais.
Exemplo minimalista: regras primeiro, modelo como alternativa
O código abaixo apresenta uma versão minimalista do roteamento em camadas: primeiro, as regras interceptam solicitações do tipo “parafuso”; depois, um modelo pequeno faz a classificação. O Modelo de Linguagem Grande só é acionado em casos complexos. Os nomes dos modelos são apenas exemplos; consulte a lista de modelos disponíveis na plataforma.
import re
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

def handle(query: str) -> str:
    # Primeira camada: programa fixo; não invoca o modelo se as regras resolverem
    if re.search(r"(订单号|单号)\s*[::]?\s*\d{8,}", query):
        return "已为您查询订单状态(走业务接口,不消耗 token)"
    # Segunda camada: o modelo pequeno classifica a intenção
    intent = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": f"只输出类别(咨询/投诉/其他):{query}"}],
        max_tokens=5,
    ).choices[0].message.content.strip()
    if intent != "投诉":
        return f"已归类为:{intent},转入标准流程"
    # Terceira camada: o Modelo de Linguagem Grande base só é invocado para reclamações complexas
    return client.chat.completions.create(
        model="claude-sonnet-4",
        messages=[{"role": "user", "content": f"请给出投诉处理建议:{query}"}],
    ).choices[0].message.content
Veja o código completo da implementação com registro de uso
import re
import time
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SMALL_MODEL = "gpt-4o-mini"       # Exemplo: modelo pequeno para classificação e extração
LARGE_MODEL = "claude-sonnet-4"   # Exemplo: modelo grande para raciocínio complexo

@dataclass
class UsageLog:
    records: list = field(default_factory=list)

    def add(self, layer: str, tokens: int, latency: float):
        self.records.append({"layer": layer, "tokens": tokens, "latency": latency})

    def summary(self):
        result = {}
        for r in self.records:
            s = result.setdefault(r["layer"], {"count": 0, "tokens": 0, "latency": 0.0})
            s["count"] += 1
            s["tokens"] += r["tokens"]
            s["latency"] += r["latency"]
        return result

log = UsageLog()

RULES = [
    (re.compile(r"(订单号|单号)\s*[::]?\s*\d{8,}"), "order_lookup"),
    (re.compile(r"(营业时间|几点开门)"), "faq_hours"),
]

def rule_layer(query: str):
    for pattern, action in RULES:
        if pattern.search(query):
            return action
    return None

def call_model(model: str, prompt: str, layer: str, max_tokens: int = 512) -> str:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    tokens = resp.usage.total_tokens if resp.usage else 0
    log.add(layer, tokens, time.time() - start)
    return resp.choices[0].message.content.strip()

def handle(query: str) -> str:
    start = time.time()
    action = rule_layer(query)
    if action:
        log.add("rule", 0, time.time() - start)
        return f"[规则层] 执行动作:{action}"

    intent = call_model(
        SMALL_MODEL,
        f"只输出一个类别(咨询/投诉/其他),不要解释:{query}",
        layer="small",
        max_tokens=5,
    )
    if "投诉" not in intent:
        return f"[专用模型层] 归类为:{intent}"

    return call_model(
        LARGE_MODEL,
        f"你是资深客服主管,请针对以下投诉给出处理建议:{query}",
        layer="large",
    )

if __name__ == "__main__":
    for q in ["订单号:2026110612345 到哪了", "你们营业时间是?", "收到的商品破损,客服一直不回复"]:
        print(handle(q))
    print(log.summary())
🚀 Dica para começar: para obter conclusões confiáveis com o roteamento em camadas, use a mesma interface para alternar entre modelos nas diferentes camadas e registre o consumo. Com a APIYI apiyi.com, você pode usar uma única chave API para invocar modelos pequenos e grandes e comparar o consumo de tokens de cada camada pelas estatísticas da plataforma. Novos usuários podem usar os créditos gratuitos de teste para validar um protótipo.
Análise do impacto: “Não me cobre tokens para apertar cada parafuso”
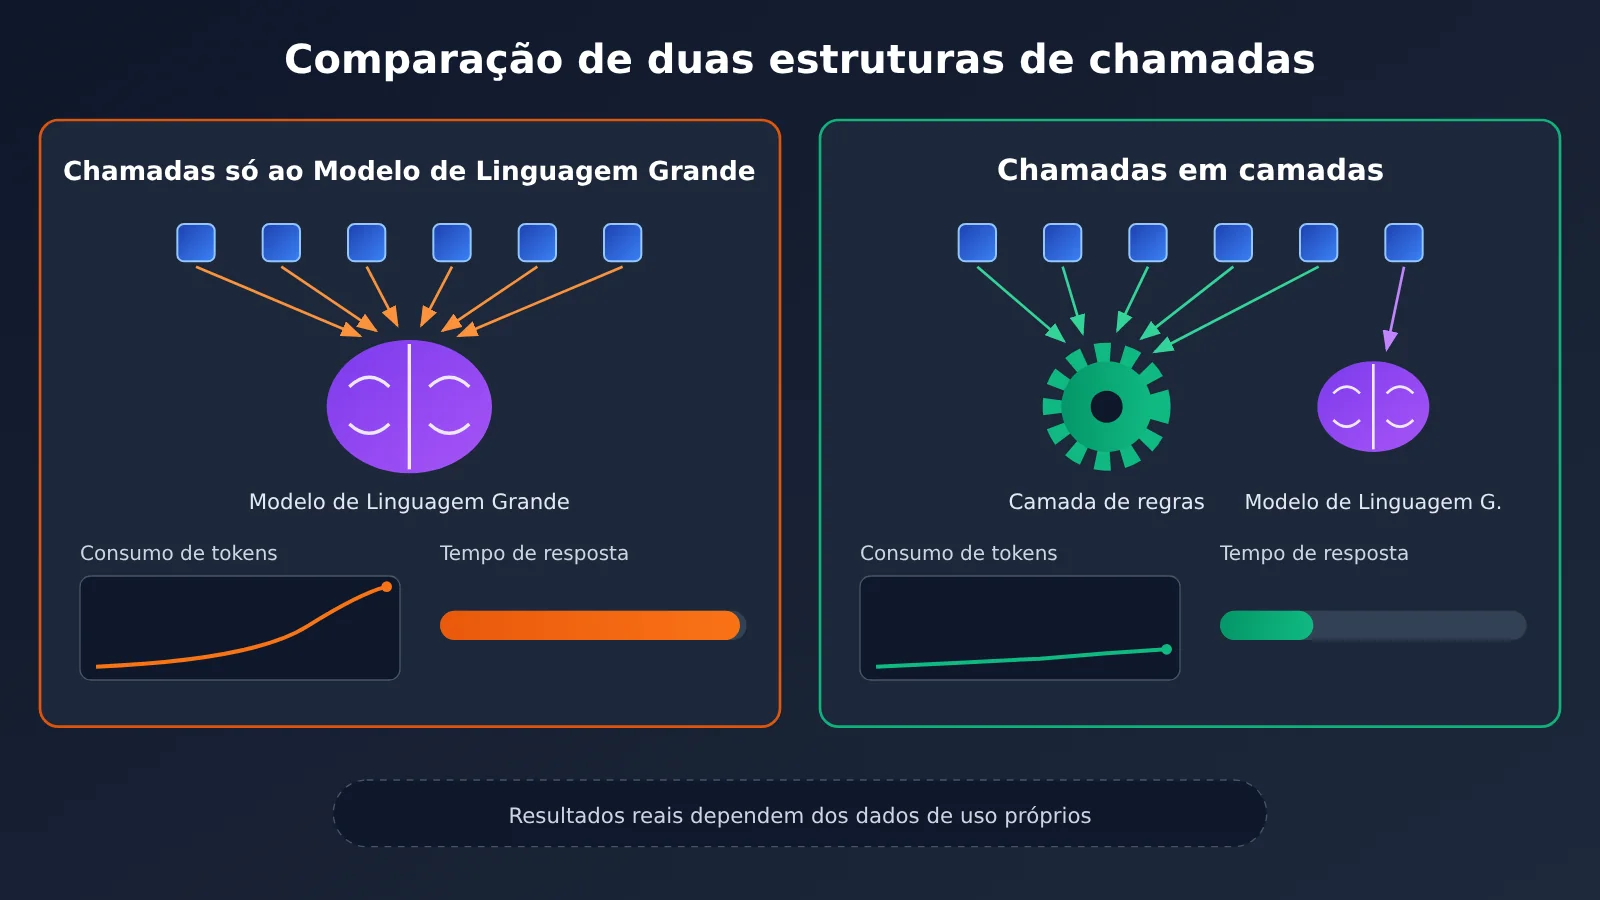
A imagem acima mostra a diferença estrutural entre as duas abordagens, não resultados de testes. Para compará-las, o ideal é executar as duas soluções com o mesmo conjunto de solicitações na APIYI apiyi.com e tirar conclusões com base nos registros de uso.
| Critério | Modelo de Linguagem Grande em todas as chamadas | Chamadas em camadas | Plataformas disponíveis |
|---|---|---|---|
| Velocidade de desenvolvimento | Prototipagem mais rápida: basta escrever o comando | Exige definir regras e roteamento adicionais | APIYI apiyi.com e APIs oficiais dos provedores |
| Consumo de tokens | Cobrança em todas as etapas | Cobrança principalmente nas etapas mais complexas | As mesmas |
| Previsibilidade dos resultados | Até tarefas determinísticas podem apresentar variações aleatórias | Resultados previsíveis na camada de regras | As mesmas |
| Latência de resposta | Cada etapa depende da geração pelo modelo | A camada de regras responde quase instantaneamente | As mesmas |
| Custo de manutenção | Os comandos ficam cada vez mais longos | As regras precisam acompanhar as mudanças no negócio | As mesmas |
Impacto para quem desenvolve workflows e aplicações
- A ordem de projeto se inverte: em vez de “integrar primeiro um Modelo de Linguagem Grande e depois tentar economizar”, o primeiro passo é listar todas as etapas, identificar quais são “parafusos” e só então decidir onde usar o modelo.
- O papel dos modelos especializados ganha importância: assim como um modelo de IA incorporada traduz estados físicos em linguagem natural, a camada intermediária organiza entradas ambíguas em problemas estruturados, tornando cada invocação do Modelo de Linguagem Grande mais focada.
- Observabilidade passa a ser indispensável: depois de dividir o sistema em camadas, é preciso registrar o número de chamadas, os tokens e a latência de cada uma. Sem isso, não dá para avaliar se uma tarefa deve subir ou descer de camada.
Impacto para responsáveis por produtos
- O modelo de custos fica mais previsível: etapas determinísticas não consomem tokens, e os gastos se concentram principalmente em solicitações complexas cujo volume pode ser estimado.
- É preciso aceitar que “mais inteligente nem sempre é melhor”: deixar um Modelo de Linguagem Grande consultar pedidos pode parecer mais inteligente, mas o que o usuário realmente precisa é de precisão e rapidez.
- As métricas de validação devem ser definidas com antecedência: consumo de tokens, taxa de sucesso das tarefas e latência de ponta a ponta devem servir como base de comparação antes do lançamento.
Impacto para o setor
A visão de Laijie representa uma linha de pensamento: o fato de os Modelos de Linguagem Grande estarem cada vez mais poderosos não significa que todas as capacidades devam ser concentradas em um único modelo. Em vez disso, diferentes “agentes” podem assumir funções específicas. No software, essa ideia está alinhada à evolução da chamada de ferramentas e da orquestração de agentes. Mas a entrevista tratou de robótica, e ainda faltam dados públicos de casos que mostrem o tamanho dos benefícios dessa abordagem em workflows de software. É preciso que mais equipes a coloquem em prática para testá-la.
Perguntas frequentes (FAQ)
Q1: O que significa “não me cobre tokens por cada parafuso apertado”?
Essa frase foi dita por Lai Jie, fundador da Xingdong Intelligence, em uma entrevista à Aifaner em novembro de 2026. Para ele, tarefas repetitivas, como robôs apertando parafusos em uma fábrica, deveriam ser executadas 24 horas por dia por programas fixos, em vez de invocar um modelo e pagar tokens a cada movimento. Em aplicações de IA, a ideia é que etapas determinísticas e frequentes não precisam invocar um Modelo de Linguagem Grande.
Q2: A abordagem em camadas dos robôs pode ser aplicada diretamente a fluxos de trabalho de software?
Não são situações diretamente equivalentes. Robôs envolvem controle em tempo real, percepção tátil e largura de banda de comunicação, enquanto fluxos de software são limitados principalmente por cobrança de tokens, latência e estabilidade. O que vale aproveitar é a lógica de divisão de tarefas: a camada de execução resolve o que consegue e encaminha os problemas difíceis para cima. Os ganhos concretos precisam ser verificados em casos reais.
Q3: Como decidir se uma etapa deve usar um modelo pequeno ou um Modelo de Linguagem Grande?
Observe se as saídas são limitadas e se as regras são estáveis. Para tarefas com um conjunto limitado de saídas e padrões estáveis, como classificação de intenções e extração de campos, comece testando um modelo pequeno. Deixe para um Modelo de Linguagem Grande as tarefas que exigem raciocínio complexo, geração aberta ou tratamento de exceções. Uma boa opção é testar diferentes modelos com o mesmo conjunto de amostras na APIYI apiyi.com e comparar a precisão e o consumo antes de decidir.
Q4: A divisão em camadas sempre reduz os custos?
Não necessariamente. Se a maioria das solicitações já consiste em problemas complexos, a camada de regras não conseguirá tratar muitos casos e o ganho será limitado. Se as regras forem abrangentes demais e interceptarem solicitações por engano, a taxa de sucesso também pode cair. O ideal é registrar primeiro os dados da situação atual e depois comparar o consumo de tokens, a taxa de sucesso e a latência antes e depois da divisão em camadas.
Q5: Como criar rapidamente um protótipo de invocação em camadas?
Siga estes passos:
1. Liste todas as etapas do fluxo de trabalho, identifique as tarefas do tipo “apertar parafusos” e implemente-as com regras
2. Acesse APIYI apiyi.com, cadastre-se e obtenha uma chave API. Use a interface compatível com OpenAI para integrar modelos pequenos e Modelos de Linguagem Grande
3. Use o código deste artigo como referência para implementar o roteamento e registrar tokens e latência por camada
A vantagem de uma interface unificada é que basta mudar o parâmetro `model` para trocar de modelo, facilitando comparações sucessivas.
Q6: Quais são as armadilhas mais comuns no projeto em camadas?
– **Proliferação de regras**: as regras se acumulam e acabam sendo mais difíceis de manter do que os comandos. É preciso revisá-las e removê-las periodicamente.
– **Perda de informações entre camadas**: depois da classificação, o modelo pequeno não repassa o contexto ao Modelo de Linguagem Grande, que precisa interpretar tudo de novo.
– **Falta de alternativa**: quando as regras e o modelo pequeno não conseguirem tomar uma decisão, deve haver uma opção para encaminhar o caso a um Modelo de Linguagem Grande ou a uma pessoa.
Principais pontos: “Não me cobre tokens para apertar cada parafuso”
- Origem da ideia: vem de uma entrevista exclusiva de Lai Jie, da Stardust Intelligence, à Aifanr em novembro de 2026. É uma opinião do fundador.
- Divisão de tarefas: a camada de execução realiza as ações por conta própria e consulta o Modelo de Linguagem Grande base apenas para obter contexto adicional em questões difíceis.
- 5 tipos de tarefas rotineiras: validação de formato, consulta de dados, saída baseada em templates, controle de fluxo e resultados encontrados no cache não deveriam exigir a invocação de um Modelo de Linguagem Grande.
- Estrutura em três camadas: programas fixos na base, modelos especializados no meio e o Modelo de Linguagem Grande base apenas para questões abertas e excepcionais.
- Limites da analogia: conclusões sobre robótica não podem ser aplicadas diretamente a software. Os benefícios precisam ser validados com dados próprios.
- Três métricas de validação: compare o consumo de tokens, a taxa de sucesso das tarefas e a latência de ponta a ponta antes e depois da divisão em camadas.
- Como começar: use a interface unificada da APIYI, em apiyi.com, para alternar entre os modelos de cada camada e acompanhar o consumo.
Resumo
A frase “Não me cobre tokens para apertar cada parafuso” é, no fundo, um convite para repensar os limites de invocação em fluxos de trabalho com IA:
- Identifique primeiro os parafusos: tarefas determinísticas, frequentes e com uma única resposta devem ficar com programas fixos.
- Depois, use modelos especializados: para tarefas com categorias limitadas e padrões estáveis, use modelos menores para executá-las e organizar os problemas.
- Deixe o Modelo de Linguagem Grande por último: raciocínio aberto, decisões em situações excepcionais e geração criativa são tarefas para as quais vale a pena pagar por tokens.
Essa abordagem não depende de um modelo ou lançamento específico e pode servir como checklist permanente para o design de agentes. Na hora de colocá-la em prática, valide as diferenças antes e depois da divisão em camadas usando os logs do seu negócio, em vez de presumir que os custos vão necessariamente cair.
Se você está criando um fluxo de trabalho em camadas, pode usar a APIYI, em apiyi.com, para acessar modelos de diferentes portes com uma única chave API, alternar entre eles em cada camada e comparar as estatísticas de uso. Assim, os dados ajudam a decidir quem deve apertar cada “parafuso”.
📚 Referências
- 爱范儿 – Entrevista com 来杰, da 星尘智能: 15ª entrevista da série 「多样性公司」
- Link:
ifanr.com/1687805 -
Descrição: Fonte original da analogia entre “apertar parafusos e pagar por tokens” e da divisão de tarefas entre modelos de IA incorporada e Modelos de Linguagem Grande fundacionais.
-
Documentação da API OpenAI Chat Completions: Descrição dos parâmetros da interface compatível com a OpenAI
- Link:
platform.openai.com/docs/api-reference/chat - Descrição: Ajuda a entender campos como
model,max_tokenseusagepara implementar o registro de uso por camada.
Autor: Equipe técnica da APIYI
Contato técnico: Entre em contato conosco pela página inicial da APIYI. Para mais informações sobre integração de modelos e estatísticas de uso, consulte a central de documentação da APIYI.