Nota do autor: este artigo analisa os vídeos de 15 segundos do Gemini Omni 1.2 Flash, o uso de referências, a edição em várias rodadas, os controles de voz e câmera, a redução de preço de 30% e as limitações reconhecidas pelo Google. A ideia é ajudar desenvolvedores a decidir se vale incluir o modelo na avaliação de soluções de geração de vídeo.
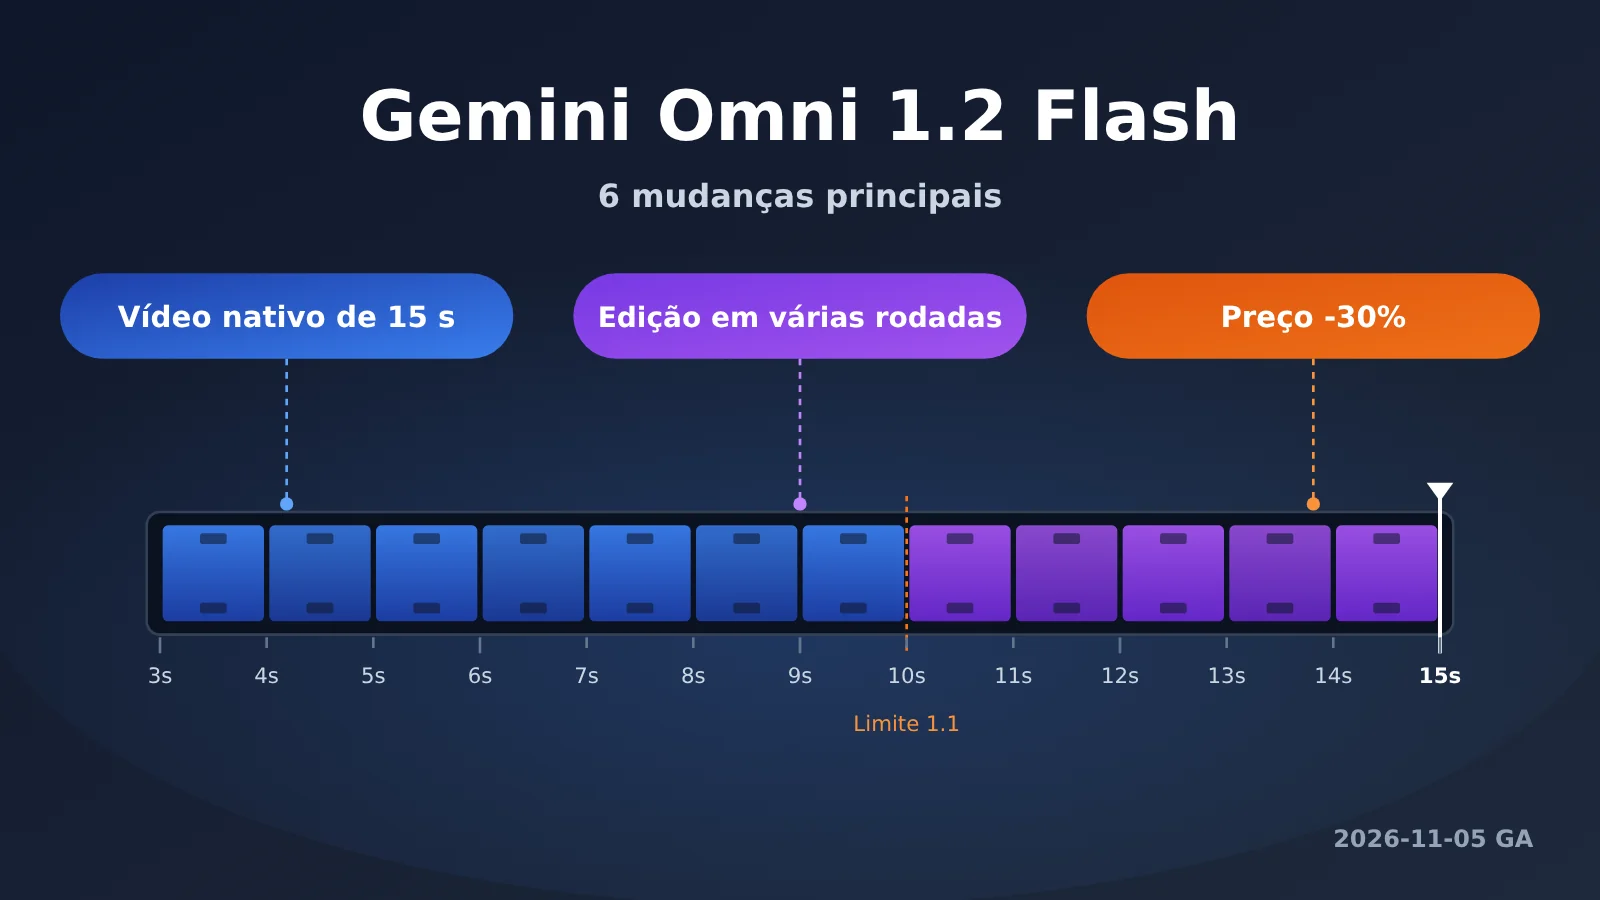
O Google lançou o Gemini Omni 1.2 Flash em 5 de novembro de 2026, com disponibilidade geral (GA) simultânea na Gemini API e no Gemini for business. Esta versão traz três novidades principais: vídeos nativos de 15 segundos, edição conversacional em várias rodadas e preço de US$ 0,07 por segundo em 720p (30% menos que a versão 1.1). Também há melhorias no uso de referências, na consistência e nos controles de voz e câmera.
Isso não é rumor: todas as informações acima vêm do anúncio no blog oficial do Google, assinado por um gerente de produto do Google DeepMind. O artigo oficial, porém, se concentra em demonstrar os resultados e traz poucos detalhes sobre parâmetros, ID do modelo e limites de taxa, que são importantes para desenvolvedores. Aqui, vamos traduzir o discurso de marketing em especificações e limitações, além de destacar o que ainda precisa ser testado com seus próprios materiais.
O que você vai encontrar aqui: em poucos minutos, entenda o que mudou no Gemini Omni 1.2 Flash em relação à versão 1.1, quais recursos estão disponíveis pela API, quais existem apenas nos aplicativos do Google e se vale a pena avaliar o modelo agora.
Gemini Omni 1.2 Flash: principais informações
Para começar, reunimos os destaques do lançamento em uma tabela. Todas as informações vêm do anúncio oficial. Os parâmetros que não foram mencionados, como ID do modelo, formato da interface e limites de requisições, ficaram de fora e serão abordados na seção “a verificar”, mais adiante.
| Item | Detalhes do Gemini Omni 1.2 Flash |
|---|---|
| Data de lançamento | 2026-11-05, com disponibilidade geral (GA) no mesmo dia |
| Responsável pelo lançamento | Google / Google DeepMind |
| Duração do vídeo | De 3 a 15 segundos, ajustável em intervalos de 1 segundo (o limite da versão 1.1 era de 10 segundos) |
| Preço | US$ 0,07 por segundo em 720p (calculado com base em US$ 12 por 1 milhão de tokens de saída de vídeo e 5.792 tokens por segundo em 720p), uma redução de 30% em relação ao Omni 1.1 |
| Fluxo de resolução | Gere uma primeira versão rapidamente em 360p / 720p e depois amplie os resultados desejados para 1080p ou 4K |
| Entradas de referência | Imagens de personagens, produtos ou estilos, clipes de movimento de até 3 segundos e comandos de áudio |
| Edição | Edição por conversa em várias rodadas, cobrindo clipes completos de até 15 segundos |
| Recursos empresariais | Provisioned Throughput, com base na infraestrutura do Google Cloud |
| Identificação de conteúdo | Marca d’água SynthID imperceptível incorporada às saídas |
| Limitações reconhecidas oficialmente | Movimentos esportivos rápidos, mudanças rápidas de roteiro e física complexa ainda estão sendo aprimorados |
O que significam GA e Provisioned Throughput para o Gemini Omni 1.2 Flash
O anúncio destaca que esta é a primeira vez que o Gemini Omni chega à disponibilidade geral, ou GA. Para desenvolvedores, isso significa que o modelo saiu da fase de prévia ou experimental e pode ser usado em produção. Em geral, também indica que a interface e o comportamento do modelo serão mais estáveis do que nas versões de prévia.
Provisioned Throughput é a capacidade de processamento reservada do Google Cloud: empresas compram antecipadamente uma quantidade de capacidade para ter disponibilidade e latência mais previsíveis nos horários de pico. Se seu negócio precisa gerar peças publicitárias em lote ou cumprir um SLA de prazo de entrega dos vídeos, esse recurso pode ser mais importante que o preço unitário. O anúncio não detalha como é feita a cobrança, então é preciso consultar a página de preços do Google Cloud.
6 mudanças importantes no Gemini Omni 1.2 Flash em relação ao 1.1
O artigo oficial usa vários vídeos de exemplo para mostrar os avanços. Reunimos essas descrições em uma lista de mudanças sob a perspectiva de quem desenvolve, separando as alterações quantificáveis nas especificações das melhorias nos resultados. As primeiras podem entrar diretamente no planejamento técnico; as outras precisam ser testadas na prática.
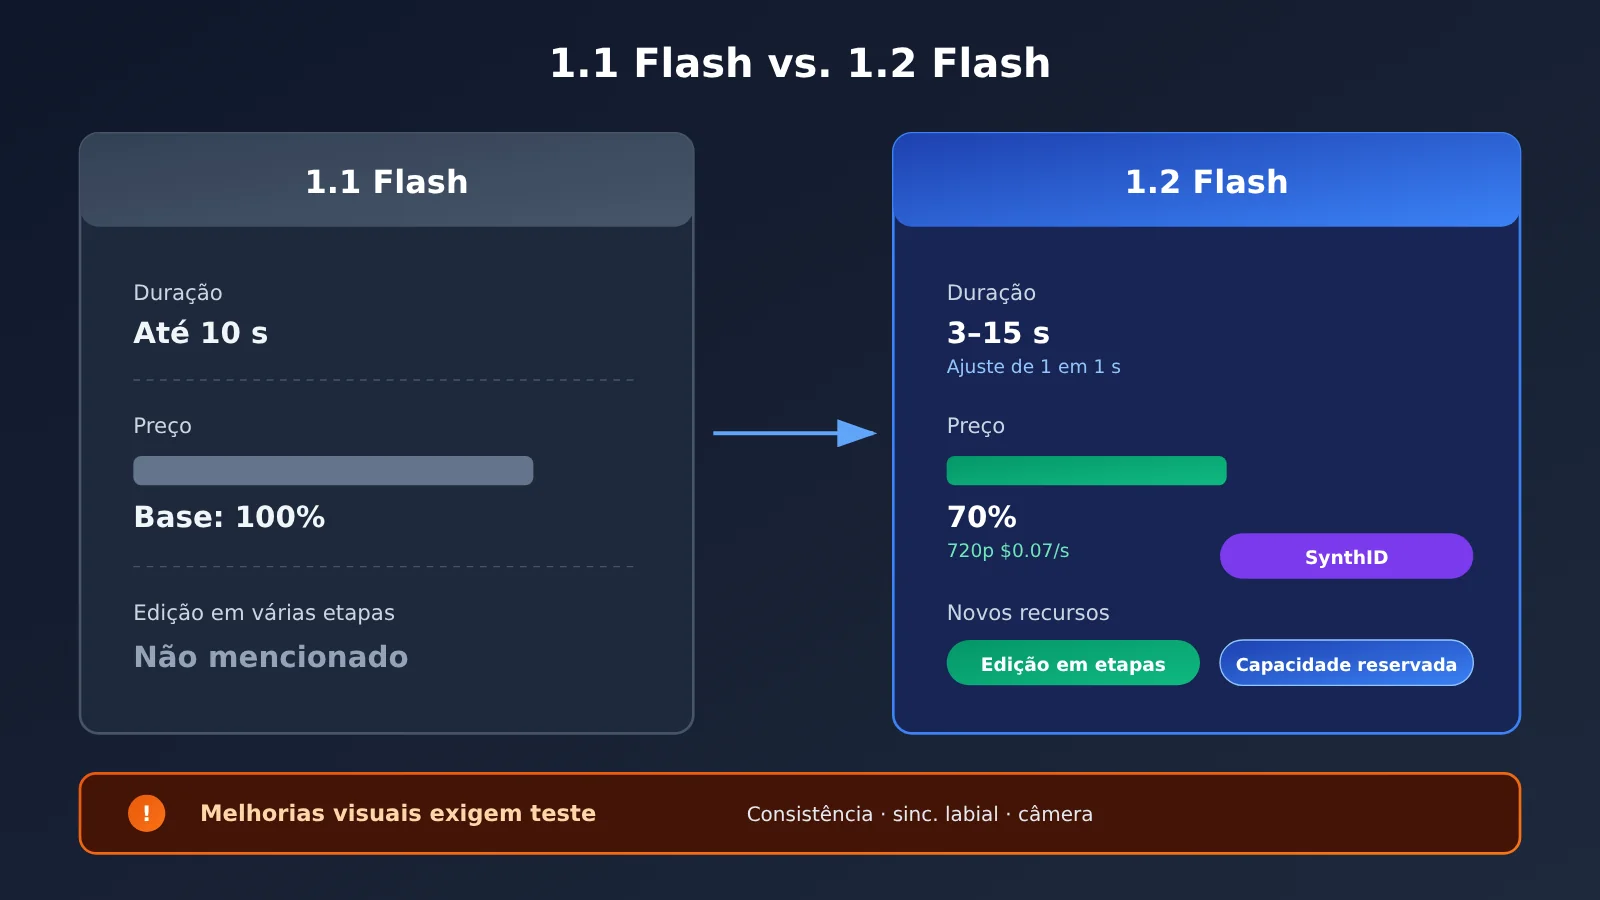
| Aspecto | Gemini Omni 1.1 Flash | Gemini Omni 1.2 Flash | Tipo de mudança |
|---|---|---|---|
| Duração máxima | 10 segundos | 15 segundos, configurável de 3 a 15 segundos em incrementos de 1 segundo | Mudança de especificação |
| Preço em 720p | US$ 0,10/segundo (US$ 17,50 por 1 milhão de tokens de saída de vídeo) | US$ 0,07/segundo (US$ 12 por 1 milhão de tokens de saída de vídeo) | Mudança de preço |
| Fidelidade à referência | Menor fidelidade à imagem de referência nos exemplos oficiais | Rostos, roupas, fontes nas embalagens e cores da marca permanecem consistentes entre diferentes ângulos de câmera | Melhoria nos resultados |
| Consistência entre o primeiro e o último quadro | Os exemplos apresentam desvios em detalhes, como um gato no telhado e uma colher que vira hashi | Menos desvios e deformações nos detalhes | Melhoria nos resultados |
| Edição em várias rodadas | Não mencionada no artigo de lançamento | Permite alterar produtos, fundos, iluminação, clima e proporção do quadro a cada rodada | Nova capacidade |
| Status GA | Não disponível em GA | Primeira versão em GA, com suporte a Provisioned Throughput | Mudança de especificação |
💡 Sobre os preços: o Google cobra a saída de vídeo por token, não por segundo. Por isso, os valores por segundo citados aqui são conversões. Os dois valores vêm da página de preços da Gemini API: a saída de vídeo do 1.1 custa US$ 17,50 por 1 milhão de tokens, enquanto a do 1.2 custa US$ 12. Considerando 5.792 tokens de saída por segundo em 720p, isso equivale a aproximadamente US$ 0,10/segundo e US$ 0,07/segundo, respectivamente — uma redução de cerca de 30%. A página também informa que, a partir de 3 de dezembro de 2026, as solicitações enviadas a gemini-omni-1.1-flash serão automaticamente redirecionadas para o 1.2 e cobradas pelo preço do 1.2.
Mudança 1: Gemini Omni 1.2 Flash oferece duração flexível de 3 a 15 segundos
O aumento de 10 para 15 segundos parece pequeno, mas faz muita diferença em vários cenários. Um anúncio completo para redes sociais, uma explicação de funcionalidade de produto ou uma história curta com começo, meio e fim costuma precisar de 12 a 15 segundos. Antes, era preciso juntar dois trechos; agora, dá para gerar tudo de uma vez.
Outro detalhe fácil de deixar passar é a possibilidade de definir a duração em intervalos de 1 segundo. Em modelos cobrados por segundo, poder escolher exatamente 7 segundos significa não precisar pagar por 10 — uma vantagem importante para controlar custos na geração em lote.
Mudança 2: referências incluem imagens, trechos de movimento e áudio
O 1.2 Flash permite combinar diferentes tipos de referência: imagens de personagens, produtos ou estilos, trechos de movimento de até 3 segundos e comandos de áudio. Em um exemplo oficial, uma foto de uma modelo e imagens de frente e verso de três conjuntos de roupas foram usadas para gerar um vídeo de prova virtual de 15 segundos. Durante uma volta de 360 graus, a identidade da modelo e o corte, o caimento e os detalhes das costas de cada peça permaneceram consistentes.
A aplicação mais direta desse recurso é no e-commerce: transformar fotos de produtos ou imagens de personagens já existentes em vídeos de prova virtual, apresentações de produtos em 360 graus e anúncios de marca. Vale lembrar que o limite de 3 segundos para trechos de movimento é obrigatório. Se o material de referência for mais longo, será preciso cortá-lo antes.
Mudança três: mais consistência entre quadros inicial e final e na extensão de clipes
Segundo a equipe, personagens, objetos e cenários ficam mais estáveis do primeiro ao último quadro, com menos desvios visuais e deformações durante movimentos e mudanças de câmera. Isso vale para dois usos: interpolar entre os quadros inicial e final e estender clipes existentes para criar sequências mais longas.
Um detalhe interessante é que a equipe apontou diferenças sutis na comparação entre as versões 1.1 e 1.2, como um gato no telhado e uma colher que vira hashis. Isso mostra que a consistência “melhorou bastante”, mas não foi “totalmente resolvida”. Cenas em que os detalhes são importantes ainda precisam de revisão humana.
Mudança quatro: edição conversacional em múltiplas rodadas com o Gemini Omni 1.2 Flash
Esta é a mudança com maior impacto no fluxo de trabalho. Você pode editar o mesmo vídeo em várias rodadas, trocando produtos ou fundos, alterando a iluminação ou o clima e mudando a proporção do quadro, sem precisar gerar tudo do zero. Em um exemplo oficial, o fundo de um vídeo gerado é trocado em cinco rodadas consecutivas, enquanto a atuação dos dois personagens, os reflexos nas armaduras e o enquadramento permanecem iguais.
A edição em múltiplas rodadas cobre o clipe completo de 15 segundos. Um uso típico apresentado pela equipe é criar, em lote, variações de anúncios para diferentes públicos e canais de veiculação. Outro exemplo é a “transferência de movimento”: na primeira rodada, é gerado um polvo que se balança; na segunda, ele é substituído por uma dançarina, cujo vestido reproduz o movimento fluido do polvo.
Mudança cinco: vozes mais naturais e diálogos com vários personagens
Os diálogos do 1.2 Flash são mais fluidos, a sincronização labial é mais precisa e o modelo consegue distinguir diferentes falantes. Em um exemplo oficial, uma imagem da cena é combinada com quatro conjuntos de referências de personagem, movimento labial e áudio de 1 segundo, para atribuir cada amostra de voz ao personagem correto.
Vale notar que, nessa seção, a maioria dos usos apresentados oficialmente está em aplicativos do Google: diálogos com vários personagens no Flow, vídeos explicativos no Gemini for business e vídeos finalizados com avatar e narração no Google Vids. O artigo de lançamento não explica como usar os recursos de voz pela API nem como passar os parâmetros.
Mudança seis: movimentos contínuos de câmera com mais controle
Segundo o anúncio oficial, movimentos contínuos e complexos de câmera — como travessias em FPV, afastamentos dramáticos e movimentos ao redor de um objeto — apresentam bem menos cortes inesperados e proporções mais estáveis. Os exemplos incluem um voo em FPV sem cortes, criado a partir de duas fotos de uma construção, que atravessa uma praça e uma porta de bronze antes de subir até a cúpula do Panteão. Outro exemplo é uma tomada contínua de 10 segundos que sai de um close da costa e se afasta até mostrar a ilha inteira.
Como funciona o fluxo de trabalho de custos do Gemini Omni 1.2 Flash
A redução de 30% no preço é só parte da história. O principal destaque é um fluxo para controlar o custo total: criar um rascunho rápido em baixa resolução → ajustar os detalhes com várias rodadas de edição → ampliar apenas a versão final aprovada. Em comparação com a prática de gerar o vídeo inteiro novamente a cada resultado insatisfatório, isso pode reduzir bastante o gasto com versões descartadas.
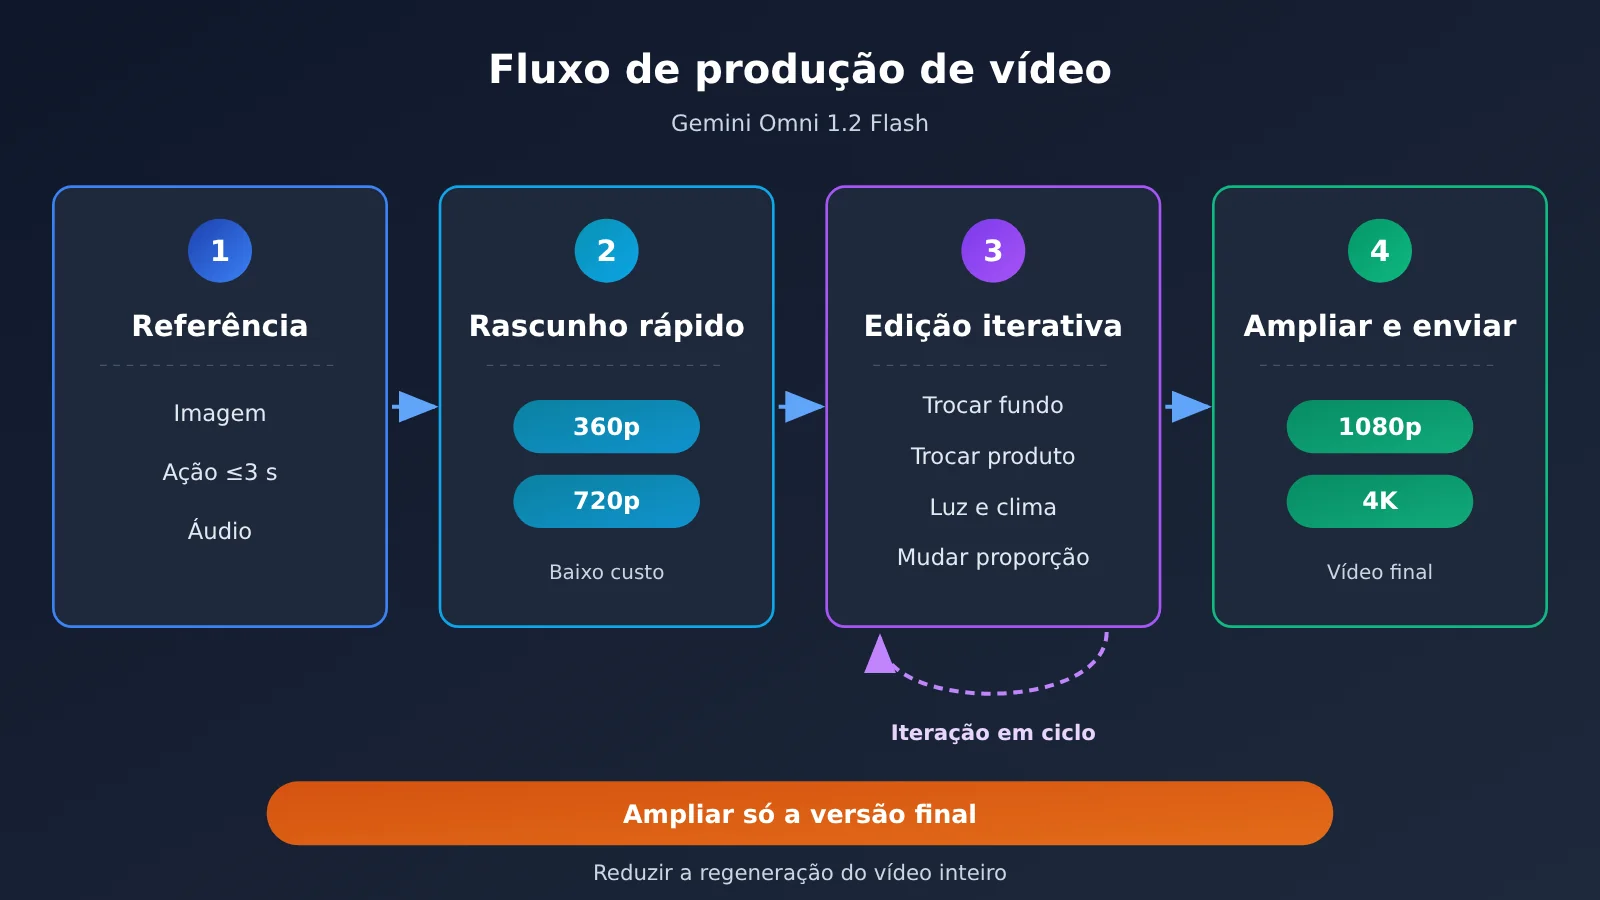
No Google AI Studio, o cartão do modelo mostra os preços por token: US$ 1,50 por 1 milhão de tokens de entrada, US$ 9 por 1 milhão de tokens de saída de texto e US$ 12 por 1 milhão de tokens de saída de vídeo. É a mesma conta dos US$ 0,07 por segundo mencionados acima, apenas com uma unidade de cobrança diferente. A página oficial de preços converte os 5.792 tokens de saída por segundo em 720p para um preço por segundo e também apresenta os valores para outras resoluções:
- 360p: 1.931 tokens de saída por segundo, cerca de US$ 0,023/segundo
- 720p: 5.792 tokens de saída por segundo, cerca de US$ 0,07/segundo
- 1080p (ampliação): 8.688 tokens de saída por segundo, cerca de US$ 0,104/segundo
- 4K (ampliação): 17.376 tokens de saída por segundo, cerca de US$ 0,209/segundo
Com base no preço de 720p, o custo aproximado de cada vídeo fica assim:
| Duração | Custo por vídeo em 720p (US$ 0,07/segundo) | Uso típico |
|---|---|---|
| 3 segundos | Cerca de US$ 0,21 | Teste de cena, capa animada |
| 6 segundos | Cerca de US$ 0,42 | Anúncio curto para feed |
| 10 segundos | Cerca de US$ 0,70 | Apresentação dos destaques de um produto |
| 15 segundos | Cerca de US$ 1,05 | Anúncio completo, explicação de produto |
O artigo de lançamento não informa se cada rodada de edição é cobrada pela duração completa do vídeo. Isso determina diretamente o quanto editar pode sair mais barato do que gerar tudo de novo. Vale registrar o valor cobrado em cada rodada durante os testes em pequena escala.
Outro custo importante na geração de vídeos vem das tentativas e erros com comandos. Muitas equipes usam primeiro um Modelo de Linguagem Grande de texto para transformar o brief criativo em um roteiro de cenas e instruções para cada rodada de edição. Depois, passam o resultado para o modelo de vídeo, reduzindo as gerações que não aproveitam. Na versão mais simples, uma interface compatível com a OpenAI chama um modelo de texto para produzir de uma vez os comandos para várias rodadas de edição:
- Instale o SDK: no Python, use
import openaie crie um cliente comopenai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1"). Obase_urlaponta para a interface compatível com OpenAI da APIYI, e a chave é aquela disponível no console. - Escolha o modelo que vai escrever os comandos: substitua
YOUR_TEXT_MODELpor um modelo de texto Gemini, GPT ou Claude disponível na lista de modelos da plataforma. Ele só vai escrever os comandos; o modelo de vídeo será invocado separadamente. - Envie o brief como uma mensagem user: passe
messages=[{"role": "user", "content": "为一段 15 秒运动鞋广告写 4 轮编辑指令:换背景、换天气、换灯光、切 9:16"}]junto com o ID do modelo paraclient.chat.completions.create(...). - Leia o resultado:
print(resp.choices[0].message.content)mostra as instruções de cada rodada. Envie-as ao modelo de vídeo em sequência, para que cada rodada edite o resultado da anterior, em vez de gerar o vídeo inteiro novamente.
Para usar o mesmo script com diferentes briefs, veja esta versão com uma estrutura de saída definida.
- Escreva o comando de sistema: defina uma string em Python para que o modelo atue como responsável pelo storyboard de anúncios em vídeo e retorne apenas JSON, com três chaves:
duration_sec(um número inteiro de 3 a 15),base_prompt(comando de geração da primeira rodada) eedit_turns(instruções de edição da segunda rodada em diante). Acrescente também uma regra: cada rodada deve alterar apenas uma variável (fundo, produto, iluminação, clima ou formato), mantendo os personagens e a câmera inalterados. - Defina a função
build_video_plan(brief, variants, model="YOUR_TEXT_MODEL"), que recebe o brief criativo e a lista de variantes desejadas. - Monte a mensagem user: use uma f-string para colocar o brief depois de
创意简报:e as variantes, separadas por vírgulas, depois de需要的变体:. - Envie duas mensagens de uma vez ao modelo de texto: coloque o comando de sistema em
systeme a string montada emuser. Adicioneresponse_format={"type": "json_object"}para que a resposta possa ser interpretada diretamente como JSON. - Faça o parsing e limite a duração: primeiro, use
plan = json.loads(resp.choices[0].message.content)e depoisplan["duration_sec"] = max(3, min(15, int(plan.get("duration_sec", 15)))), pois esse modelo aceita durações de 3 a 15 segundos, em incrementos de 1 segundo. - Faça um teste com um brief real: por exemplo, «lançamento de tênis de corrida, corrida matinal na cidade, com destaque para leveza e retorno de energia». Como variantes, use «rua em dia chuvoso», «praia ao entardecer» e «mudar para o formato vertical 9:16». Imprima o resultado com
json.dumps(plan, ensure_ascii=False, indent=2). - Passe o resultado ao modelo de vídeo: envie
base_prompteedit_turnsà API de vídeo que você usa e execute cada rodada em sequência. Antes de processar muitas rodadas em lote, registre o valor efetivamente cobrado em cada uma.
🚀 Dica para começar: a geração de storyboards e instruções de edição é uma boa tarefa para modelos de texto em lote. Pela APIYI apiyi.com, você pode usar a mesma chave API para comparar a qualidade dos comandos escritos por diferentes modelos de texto. Novos usuários recebem créditos gratuitos para teste. Quanto ao modelo de vídeo Gemini Omni, consulte os canais oficiais do Google; para saber se ele já está disponível na APIYI, confira a lista de modelos da plataforma.
Análise do impacto do Gemini Omni 1.2 Flash para desenvolvedores
Como diferenciar os recursos da API do Gemini Omni 1.2 Flash dos recursos dos aplicativos Google
O artigo oficial apresenta API, plataforma de nuvem e vários aplicativos Google juntos. Por isso, é fácil interpretar errado se um recurso está ou não disponível via API. A tabela abaixo separa as informações por canal para facilitar a comparação.
| Canal | Público | Recursos descritos oficialmente | Pontos de atenção |
|---|---|---|---|
| Gemini API / Google AI Studio | Desenvolvedores | Disponibilidade geral (GA), prototipagem no AI Studio, aplicativos iniciais interativos e documentação para desenvolvedores | Consulte a documentação oficial para conferir parâmetros, ID do modelo e limites de taxa |
| Console do Google Cloud | Empresas | Disponibilidade geral (GA), infraestrutura e segurança corporativas, Provisioned Throughput | Indicado para equipes que precisam de SLA e processamento em lote |
| Flow | Criadores | Direção de cenas, edição em várias etapas e diálogos com vários personagens | Recurso do aplicativo, não equivale a um recurso da API |
| Google Vids | Usuários com conta Google / Workspace | Clipes de 15 segundos, sem custo adicional | Recurso do aplicativo, adequado para equipes não técnicas testarem os resultados |
| Aplicativo Gemini | Assinantes do Google AI Ultra | Vídeos de 15 segundos, em liberação gradual | O ritmo de liberação pode variar conforme a região e a conta |
| Google Ads | Equipes de publicidade | Expansão de campanhas de marketing em vídeo | Voltado para campanhas publicitárias |
| Apoio textual (storyboards/comandos) | Desenvolvedores | Fora dos canais oficiais do Omni: uso de modelos de texto para gerar roteiros e instruções de edição | É possível invocar vários modelos de texto por plataformas como APIYI apiyi.com |
Impacto para desenvolvedores de aplicativos
- O design dos fluxos de trabalho vai mudar: a edição em múltiplas rodadas torna viável o modelo de “gerar uma vez, editar várias”. Os produtos podem oferecer uma interface de edição de vídeo parecida com um chat, em vez de exigir que o usuário reescreva o comando completo a cada tentativa.
- O modelo de custos precisa ser recalculado: a cobrança por segundo e o ajuste de duração em incrementos de 1 segundo, combinados com rascunhos de baixa resolução, podem reduzir o custo unitário. Mas é importante entender primeiro como cada rodada de edição é cobrada.
- Conformidade com menos preocupações: a marca d’água SynthID é incorporada por padrão, uma vantagem para plataformas que precisam identificar conteúdo gerado por IA.
Impacto para criadores de conteúdo e responsáveis por produtos
- Materiais para e-commerce e marcas são os mais beneficiados: a melhor aderência às imagens de referência e a maior consistência atendem a demandas frequentes, como provadores virtuais, visualizações de produtos em 360 graus e várias versões de anúncios.
- Vale esperar antes de apostar nos cenários mais frágeis: segundo a documentação oficial, movimentos esportivos rápidos, mudanças rápidas de roteiro e física complexa ainda estão sendo aprimorados. Por enquanto, essa não é a melhor opção principal para conteúdo esportivo, cenas de ação ou tomadas com interações físicas complexas.
Checklist para avaliar o Gemini Omni 1.2 Flash
Os exemplos oficiais foram selecionados para demonstração, e ainda há poucos testes independentes de qualidade. Antes de decidir se o modelo entra na sua solução, vale verificar cada ponto abaixo usando seus próprios materiais.
| Item a verificar | Por que testar | Como testar |
|---|---|---|
| Consistência com a imagem de referência | Os exemplos oficiais não representam necessariamente as imagens dos seus produtos e personagens | Gere de 10 a 20 imagens usando fotos dos seus produtos e embalagens com texto; registre a taxa de deformação |
| Movimentos rápidos e física complexa | São limitações reconhecidas pelo próprio Google | Prepare cenas específicas com corrida, saltos, colisões e líquidos |
| Estabilidade em edições sucessivas | Quanto mais rodadas, maior a chance de acumular desvios | Faça mais de 5 rodadas de edição e verifique se os personagens e a composição se mantêm |
| Regras de cobrança por edição | Determinam a economia real | Faça um teste com um valor baixo e registre a cobrança em cada rodada |
| Parâmetros da interface e limites de taxa | O artigo de lançamento não informou esses detalhes | Consulte a documentação para desenvolvedores da Gemini API e faça testes de carga |
| Voz e sincronização labial | A qualidade de diálogos em idiomas além do inglês, como o chinês, ainda é desconhecida | Teste diálogos com várias pessoas no idioma desejado |
Perguntas frequentes (FAQ)
Q1: O que é o Gemini Omni 1.2 Flash?
O Gemini Omni 1.2 Flash é um modelo de geração de vídeos lançado pelo Google em 05/11/2026 com disponibilidade geral (GA). Seu foco é a rapidez e o baixo custo: ele gera vídeos nativos de 3 a 15 segundos, aceita diferentes tipos de entrada como referência e permite edições em várias rodadas de conversa. Em 720p, o preço é de US$ 0,07 por segundo.
Q2: Qual é a diferença entre o Gemini Omni 1.2 Flash e a versão 1.1?
A versão 1.1 gera vídeos de até 10 segundos; a 1.2 chega a 15 segundos, com duração ajustável em incrementos de 1 segundo. O preço caiu 30%, e a nova versão ganhou edição por conversa em várias rodadas. Também houve melhorias na fidelidade às referências, na consistência entre o primeiro e o último quadro, na sincronização labial e nos movimentos contínuos de câmera. Além disso, o modelo chegou pela primeira vez à disponibilidade geral (GA) e oferece Provisioned Throughput.
Q3: O Gemini Omni 1.2 Flash já está disponível?
Sim. Ele já está disponível em GA na Gemini API e no Google Cloud, e desenvolvedores podem testar protótipos no Google AI Studio. O modelo também chegou ao Google Vids, Flow e Google Ads, enquanto sua disponibilização no aplicativo Gemini está sendo gradual para assinantes do Google AI Ultra.
Q4: Para quais cenários o Gemini Omni 1.2 Flash é mais indicado?
– **Prova virtual e apresentação de produtos para e-commerce**: use fotos de modelos e imagens de produtos para gerar vídeos de prova virtual e visualizações em 360 graus
– **Produção em escala de variações de anúncios**: edite um mesmo material em várias rodadas para criar versões com diferentes fundos, condições climáticas e formatos
– **Vídeos curtos de explicação de produtos e divulgação científica**: crie explicações com várias cenas em até 15 segundos; no exemplo oficial, os textos exibidos têm ortografia correta
– **Apresentação de espaços com movimentos contínuos de câmera**: crie tomadas FPV atravessando edifícios ou pontos turísticos, além de planos de afastamento
Q5: É possível invocar o Gemini Omni 1.2 Flash pela APIYI?
A APIYI já oferece acesso aos modelos de texto da família Gemini. Quanto aos modelos de vídeo Gemini Omni, consulte a lista de modelos da plataforma para verificar a disponibilidade; este artigo não faz essa promessa. Enquanto isso, você pode usar os modelos de texto da APIYI em apiyi.com para gerar roteiros de storyboard e instruções de edição em várias rodadas, deixando a geração de vídeo para os canais oficiais do Google.
Q6: Quais são as limitações conhecidas do Gemini Omni 1.2 Flash?
O Google reconhece que movimentos esportivos rápidos, mudanças rápidas no roteiro e situações com física complexa ainda estão sendo aprimorados. Também é possível notar pequenas diferenças nos detalhes dos exemplos com primeiro e último quadros. Além disso, o artigo de lançamento não informa os parâmetros da API, o ID do modelo nem os limites de taxa; é preciso consultar a documentação oficial. O aumento de resolução para 1080p custa cerca de US$ 0,104 por segundo e para 4K, cerca de US$ 0,209 por segundo; ambos os valores estão na página de preços.
Q7: Como reduzir o custo de tentativa e erro com comandos para geração de vídeos?
Primeiro, use um modelo de texto para transformar o briefing em um storyboard estruturado e em instruções de edição que alterem apenas uma variável por rodada. Depois, passe essas instruções ao modelo de vídeo. Isso pode reduzir bastante o número de vídeos descartados. Com a interface unificada da APIYI em apiyi.com, você pode comparar rapidamente como diferentes modelos de texto escrevem comandos e escolher o mais adequado para o seu negócio.
Gemini Omni 1.2 Flash: principais pontos
- Vídeos mais longos: até 15 segundos, com duração de 3 a 15 segundos ajustável em incrementos de 1 segundo. Dá para gerar um anúncio completo de uma só vez.
- Preço menor: US$ 0,07 por segundo em 720p, uma redução de 30% em relação à versão 1.1.
- Fluxo de trabalho econômico: rascunho em baixa resolução + várias rodadas de edição + ampliação apenas da versão final.
- Referências mais estáveis: imagens, clipes de movimento de até 3 segundos e áudio orientam a geração em conjunto, mantendo a consistência entre diferentes ângulos de câmera.
- Primeira versão GA: suporte a Provisioned Throughput e marca d’água SynthID incorporada à saída.
- Limitações claras: movimentos rápidos e física complexa ainda exigem cautela. Teste sempre com seus próprios materiais.
- Fluxo de apoio: storyboards e instruções de edição podem ser gerados em lote por modelos de texto acessados via APIYI apiyi.com.
Resumo: vale a pena avaliar o Gemini Omni 1.2 Flash agora?
Os principais pontos do Gemini Omni 1.2 Flash são:
- Melhorias concretas nas especificações: 15 segundos de duração, ajustes de 1 em 1 segundo, redução de preço de 30% e primeira versão GA são dados que já podem entrar no planejamento técnico.
- Edições em várias rodadas mudam o fluxo de trabalho: em vez de gerar o vídeo inteiro novamente, é possível modificá-lo aos poucos. Isso é especialmente útil para variações de anúncios e materiais de e-commerce.
- As melhorias precisam ser testadas: os avanços em consistência, sincronização labial e movimentos de câmera vêm de exemplos oficiais. Você ainda precisa verificar como funcionam com seus próprios materiais.
Se você produz vídeos para e-commerce, anúncios de marca ou apresentações de produtos, já vale fazer uma rodada de testes comparativos no Google AI Studio com seus próprios materiais. Se o foco for esportes, ação em alta velocidade ou interações físicas complexas, talvez seja melhor aguardar as próximas versões.
Durante a avaliação, vale usar a APIYI apiyi.com para acessar vários modelos de texto com a mesma chave e gerar storyboards e instruções de edição. Isso ajuda a reduzir o custo de tentativa e erro com comandos. A plataforma oferece créditos gratuitos para testes de novos usuários.
📚 Referências
- Blog oficial do Google – Artigo de lançamento do Gemini Omni 1.2 Flash: fonte de todos os fatos apresentados neste artigo
- Link:
blog.google/innovation-and-ai/technology/developers-tools/introducing-gemini-omni-1-2-flash/ -
Descrição: inclui informações oficiais sobre duração, preços, entradas de referência, edição em várias rodadas, canais de acesso e limitações conhecidas
-
Google AI Studio: ponto de partida para testar protótipos com a API Gemini
- Link:
aistudio.google.com - Descrição: canal recomendado pelo Google para desenvolvedores experimentarem a API e consultarem os aplicativos iniciais e a documentação
Autor: Equipe técnica APIYI
Contato técnico: entre em contato conosco pela página inicial do site APIYI apiyi.com. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com