Nota do autor: com uma única chave, um conjunto fixo de scripts e uma falha injetada, comparamos lado a lado a capacidade de chamadas de ferramentas em múltiplas rodadas de vários modelos, chegando a conclusões reproduzíveis e verificáveis.
Ao escolher um modelo para atuar como agente, muitas equipes esbarram no mesmo problema. Em perguntas e respostas de uma única rodada, o desempenho dos modelos até se parece; mas quando começa o ciclo de múltiplas rodadas “chamar ferramenta → obter resultado → chamar de novo → tratar erro → entregar uma resposta estruturada”, as diferenças aparecem. Este artigo apresenta um pequeno teste de chamadas de ferramentas em múltiplas rodadas com uma única chave para vários modelos, para ajudar você, com custo bem baixo, a transformar essas diferenças em dados que dá para registrar e revisar.
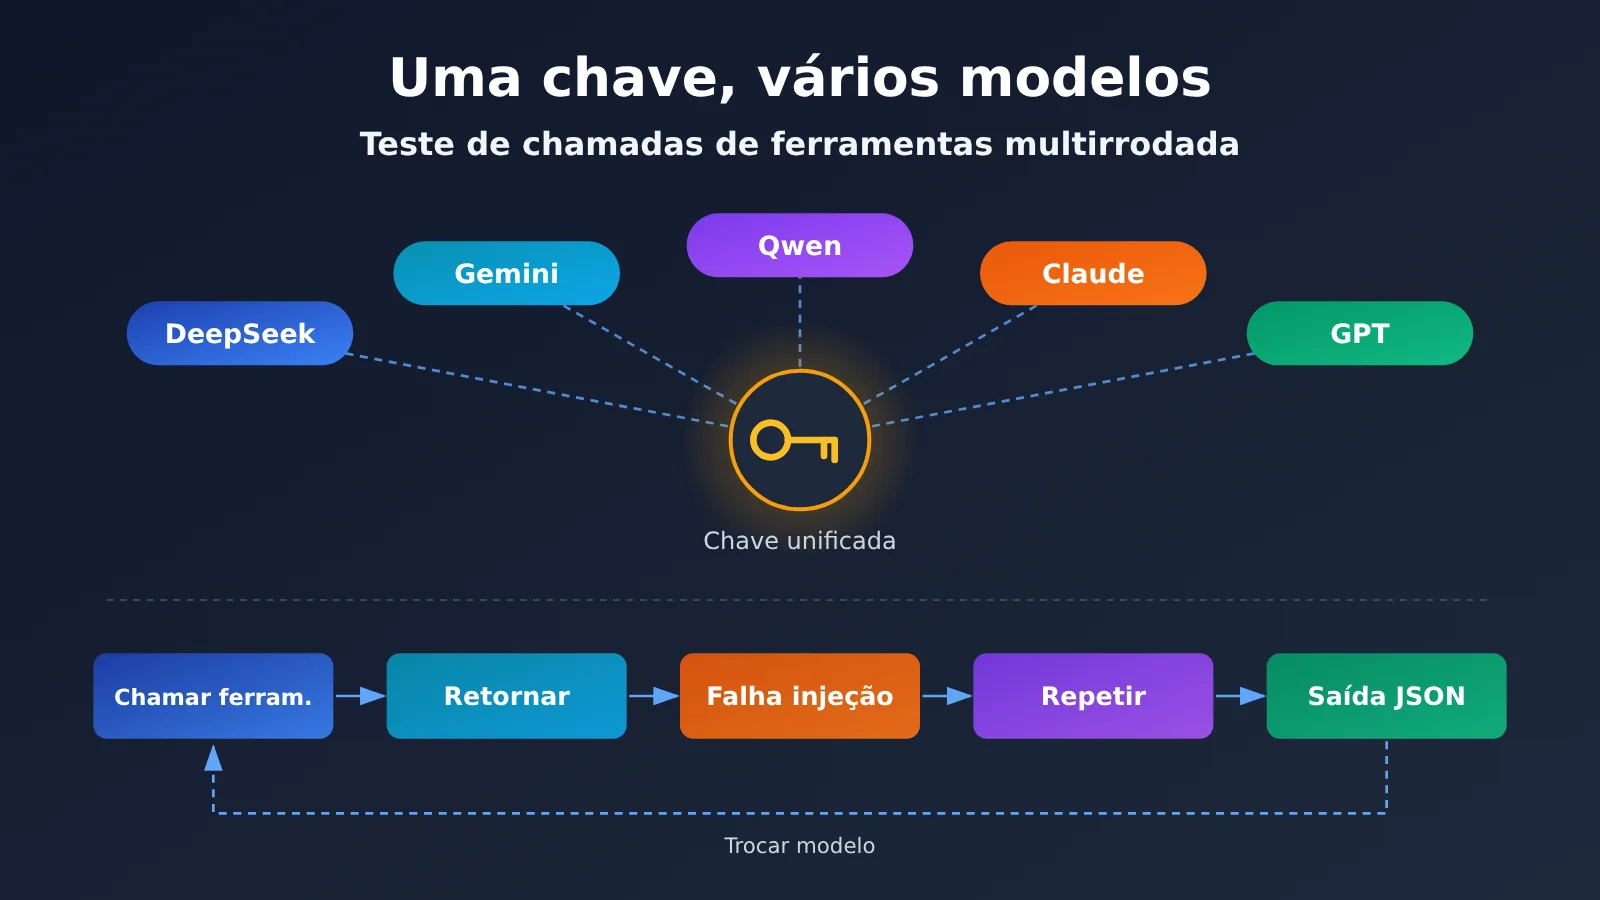
Isto não é um ranking de modelos. Este artigo não traz nenhuma pontuação de benchmark que não tenha sido medida na prática; ele só mostra como projetar o teste para você chegar às suas próprias conclusões no seu cenário de negócio. O ponto central do teste é controlar as variáveis: mesma chave, mesmo conjunto de definições de ferramentas, mesmos dados Mock, mudando apenas o nome do modelo. Com plataformas agregadoras como a APIYI (apiyi.com), uma única chave permite invocar modelos como DeepSeek, Gemini, Qwen, Claude e GPT, o que reduz bastante o custo de troca na comparação lado a lado.
Valor central: ao terminar a leitura, você será capaz de montar um teste reproduzível de chamadas de ferramentas em múltiplas rodadas em 5 etapas. Ele cobre cinco pontos críticos: seleção da ferramenta, validação de parâmetros, devolução do ID de chamada, nova tentativa após falha e validação final do JSON.
Pontos essenciais do teste pequeno de chamadas de ferramentas em múltiplas rodadas
Antes de projetar um teste de chamadas de ferramentas em múltiplas rodadas, é preciso deixar claro o que significa “reproduzível”. A mesma entrada, executada em momentos diferentes e por pessoas diferentes, deve produzir o mesmo tipo de resultado comparável. Uma saída bonita isolada não serve como conclusão. A tabela abaixo é o esqueleto de todo o teste.
| Ponto | Descrição | Valor |
|---|---|---|
| Uma chave, vários modelos | Todos os modelos passam pelo mesmo ponto de entrada de interface, alterando apenas o campo model | Elimina interferências de rede, autenticação e versão do SDK |
| Ferramentas Mock fixas | Os valores de retorno das ferramentas são fixos, sem conectar a bancos de dados reais ou serviços externos | Os resultados das ferramentas vistos a cada execução são idênticos |
| Injetar uma falha | A primeira chamada de uma ferramenta retorna sempre um erro que permite nova tentativa | Observar se o modelo tenta novamente corretamente e se inventa dados |
| Ponto final estruturado | A resposta final deve ser um JSON que atenda ao Schema | Permite que um programa determine automaticamente aprovação ou falha |
| Registro completo | Salvar parâmetros da requisição, resposta bruta, usage e tempo de execução | As conclusões podem ser revisadas e é possível fazer regressão após trocar a versão do modelo |
Por que o teste de chamadas de ferramentas em múltiplas rodadas precisa ser “pequeno”
O teste precisa ser pequeno porque testes grandes são difíceis de reproduzir. Em cenários reais, uma cadeia de ferramentas pode ter mais de dez ferramentas e depender de sistemas externos; qualquer oscilação acaba sendo erroneamente atribuída ao modelo. Um bom teste pequeno precisa de apenas 2 a 3 ferramentas somente leitura e de uma falha injetada manualmente para cobrir as partes do ciclo de múltiplas rodadas mais propensas a erro.
O teste também precisa ser “completo”. Ele deve percorrer todo o ciclo; não basta olhar se o modelo inicia uma chamada de ferramenta na primeira rodada. Muitos modelos vão bem na primeira rodada, mas o problema aparece na segunda ou terceira: não carregam o ID de chamada correto, desistem ao receber um erro, ou inventam um número de rastreio quando não há dados. Esses problemas só ficam visíveis quando o ciclo é executado até a última rodada.
Princípios de design para testar vários modelos com uma única chave
Controlar as variáveis é premissa de um teste comparativo. Se o modelo A usa o SDK oficial, o modelo B usa um SDK de terceiros e o modelo C usa outro endereço de proxy, no fim não dá para saber se a diferença vem do modelo ou da cadeia. Com a entrada unificada, o método de autenticação, a política de retry, as configurações de timeout e o formato de log permanecem consistentes; a única variável é o próprio modelo.
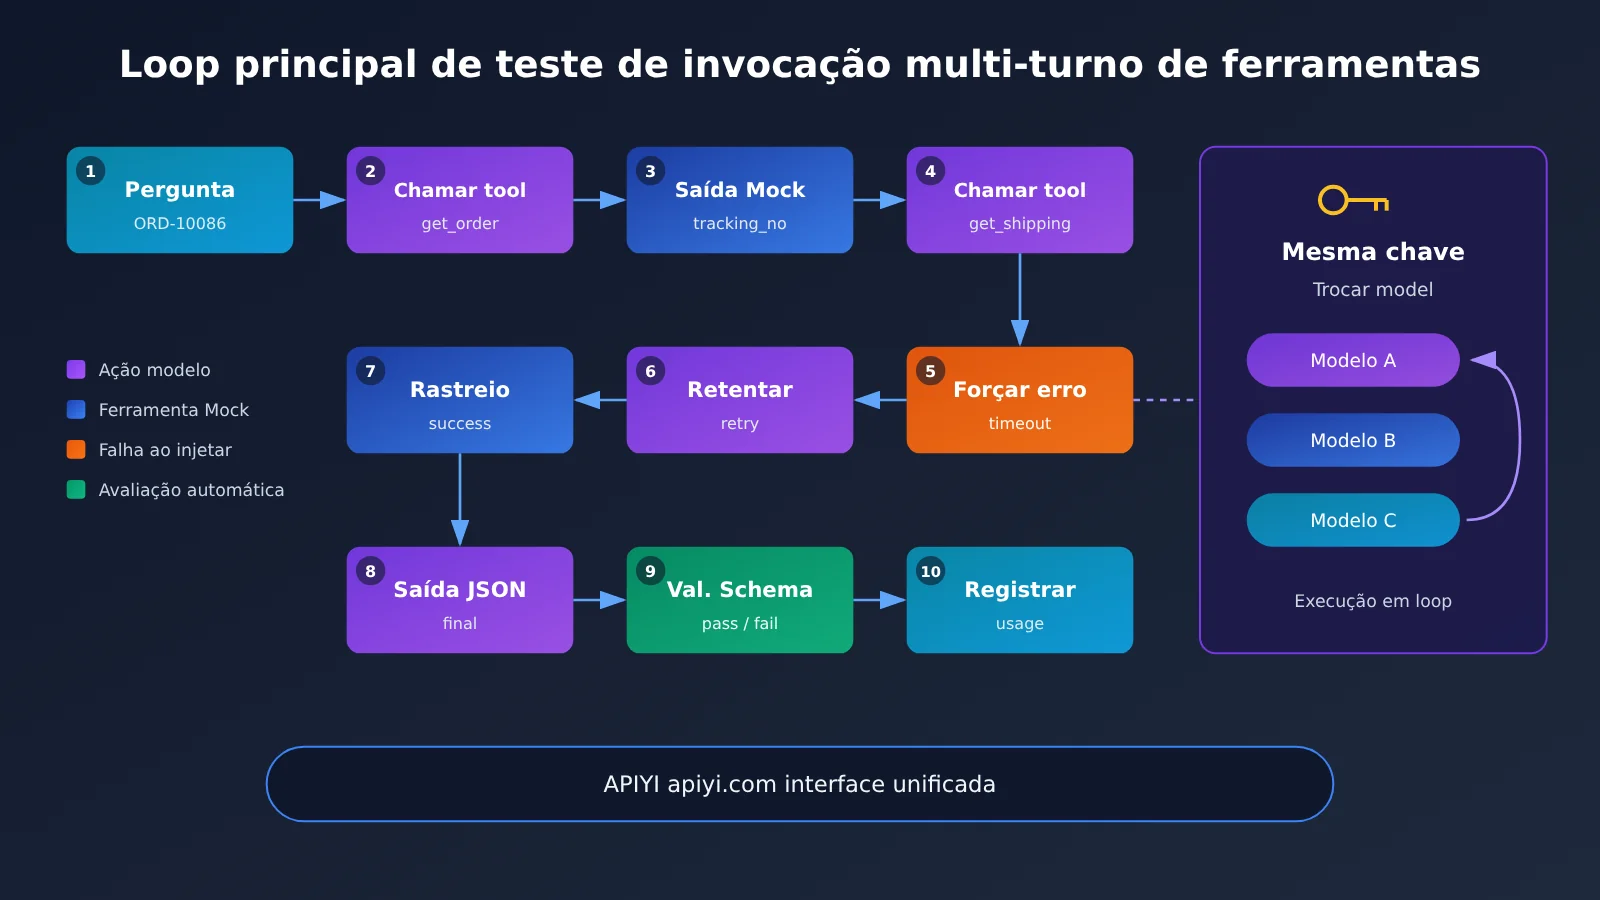
Teste rápido de invocação de ferramentas em múltiplas rodadas
Esta seção não inclui código, apenas lista parâmetros, definições de ferramentas e passos de execução. Você pode implementar em qualquer linguagem que conheça: Python, Node.js ou script Shell. O importante é que cada configuração seja escrita em um arquivo de configuração fixo e salva junto com os resultados do teste.
Passo 1: Interface unificada e parâmetros de execução
Primeiro, defina o ponto de entrada da interface e os parâmetros de amostragem. A APIYI é compatível simultaneamente com os formatos de interface da OpenAI e da Anthropic; a mesma chave pode ser usada tanto para chamadas no estilo Chat Completions quanto no estilo Messages. A tabela abaixo lista os itens de configuração recomendados para fixar.
| Item de configuração | Valor sugerido | Descrição |
|---|---|---|
| base_url (formato OpenAI) | https://api.apiyi.com/v1 |
Chamada através do ponto de entrada unificado da APIYI; o endereço específico deve seguir a documentação em docs.apiyi.com |
| base_url (formato Anthropic) | Consulte o endereço compatível com Anthropic na documentação da APIYI | Usado para testar o protocolo tool_use / tool_result |
| api_key | A mesma chave | Compartilhada por todos os modelos, eliminando diferenças de autenticação |
| temperature | 0 ou o mais baixo possível | Reduz a aleatoriedade; se algum modelo de raciocínio não suportar, registre o valor real |
| max_tokens | Valor fixo | Evita julgamentos errados por saída truncada |
| tool_choice | auto | Observa a decisão autônoma do modelo, sem forçar a invocação |
| Número máximo de rodadas de loop | Limite superior fixo, por exemplo 6 rodadas | Evita que o modelo entre em repetição infinita |
| Número de execuções por modelo | Número fixo, por exemplo 5 vezes | Usa múltiplos resultados para avaliar estabilidade, sem olhar o desempenho de uma única vez |
🚀 Sugestão para começar rápido: você pode primeiro se registrar na APIYI apiyi.com e obter uma chave, e usar a mesma chave para invocar os modelos candidatos em sequência. Depois de confirmar que cada modelo retorna uma resposta normal de invocação de ferramentas, comece o teste oficial. As instruções de integração estão em docs.apiyi.com.
Etapa 2: Definir de 2 a 3 ferramentas somente leitura
O design das ferramentas tem dois requisitos: somente leitura e determinístico. O somente leitura serve para evitar que operações de escrita sejam acionadas por engano durante os testes, e o determinístico garante que o valor retornado seja sempre o mesmo. Recomenda-se usar um cenário fictício de consulta de pedidos, com duas ferramentas:
- get_order: o parâmetro é order_id (string, formato fixo “ORD-” seguido de números). Retorna sempre o status do pedido, o nome do produto e o número de rastreamento tracking_no.
- get_shipping: o parâmetro é tracking_no (string). Na primeira chamada, retorna sempre um erro com error igual a timeout e retryable igual a true; da segunda chamada em diante, retorna o status logístico e a data prevista de entrega fixos.
- Ferramenta de distração opcional get_coupon: não tem relação com a pergunta e serve para observar se o modelo fará chamadas desnecessárias.
O Schema dos parâmetros deve ser escrito de forma rigorosa: o tipo do campo, os campos obrigatórios e o formato de expressão regular devem ser explícitos. Os parâmetros gerados pelo modelo devem passar primeiro pela validação do Schema antes de serem passados para a função Mock. Falhas de validação devem ser registradas como um “erro de parâmetro”, sem correção silenciosa.
Etapa 3: Escrever o comando fixo e a pergunta do usuário
O comando System deve conter apenas regras, não respostas. Pode-se exigir que o modelo responda apenas com base nos dados retornados pelas ferramentas; se a ferramenta retornar erro e a nova tentativa for possível, no máximo 2 tentativas; ao final, deve produzir apenas um objeto JSON com os campos order_status, shipping_status, eta e data_source. A pergunta do usuário deve ser fixa, em uma frase, por exemplo: “me ajuda a verificar onde está o pedido ORD-10086 agora”.
Depois de definido, o comando não deve mais ser alterado. Se durante os testes algum modelo falhar por causa de ambiguidade no comando, o procedimento correto é abrir um novo número de versão e retestar todos os modelos com a nova versão, em vez de alterar o comando apenas para esse modelo.
Etapa 4: Executar o loop e injetar uma falha
A lógica de execução segue esta ordem:
- Enviar as mensagens system e user, além das definições das ferramentas.
- Se a resposta contiver chamadas de ferramenta, validar os parâmetros em ordem, executar a função Mock correspondente e devolver o resultado conforme exigido pelo protocolo.
- Na primeira chamada a
get_shipping, retornar sempre um erro passível de nova tentativa. - Repetir a etapa 2 até o modelo dar uma resposta final sem chamadas de ferramenta, ou até atingir o número máximo de rodadas.
- Validar a resposta final com JSON Schema e salvar todas as mensagens, a resposta bruta e o
usagede cada rodada.
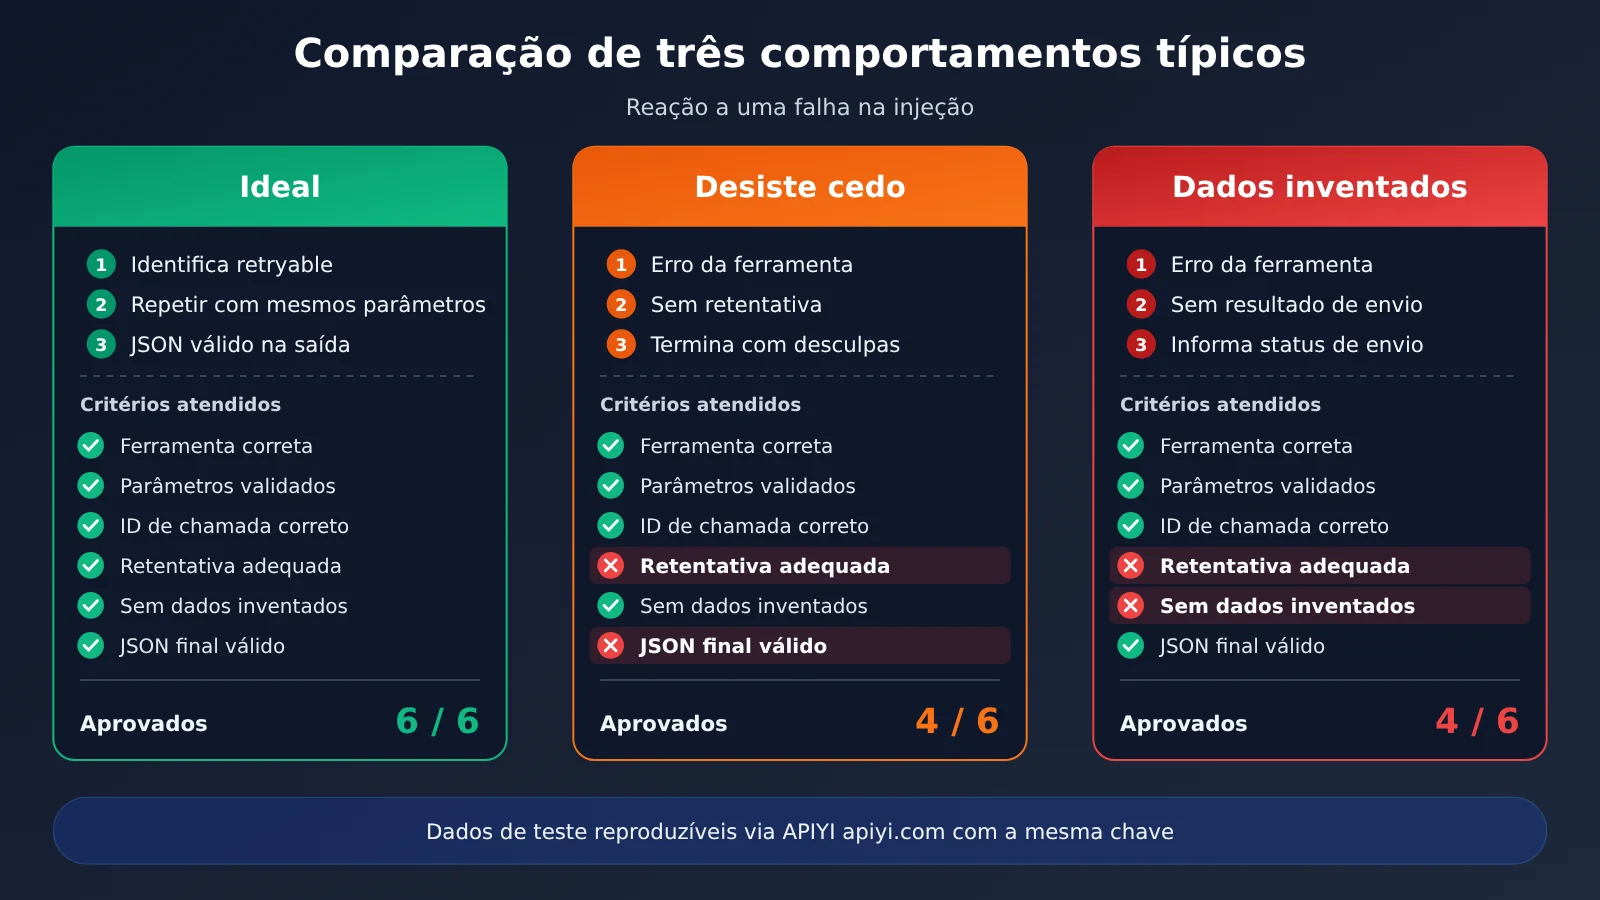
A injeção de falha é o ponto que mais diferencia os comportamentos em todo o teste. O comportamento ideal é o modelo identificar que retryable é true e chamar get_shipping de novo com os mesmos parâmetros. Há três comportamentos problemáticos comuns: pedir desculpas ao usuário e encerrar; inventar um status de envio; alterar os parâmetros e ficar tentando de novo até ultrapassar o limite de rodadas.
Etapa 5: Pontuar conforme a lista de verificação e registrar a trilha de auditoria
Ao final de cada execução, avalie item por item por meio de um programa, evitando ao máximo depender de pontuação subjetiva humana. A revisão humana fica só para reexaminar as amostras que o programa marcou como anormais.
Diferenças no protocolo de chamadas de ferramentas em múltiplos turnos: formatos OpenAI e Anthropic
Para que o mesmo teste rode nos dois formatos de interface, primeiro é preciso entender as diferenças nos detalhes do protocolo. Até diferenças mínimas no protocolo podem causar problemas do tipo “funciona no curl, mas não no cliente”. A recomendação é confirmar o protocolo com uma requisição mínima antes de começar a comparar a capacidade dos modelos.
| Etapa | Formato compatível com OpenAI | Formato compatível com Anthropic |
|---|---|---|
| Definição da ferramenta | array tools, cada item com type igual a function, parâmetros escritos em parameters |
array tools, o Schema dos parâmetros fica em input_schema |
| O modelo inicia a chamada | tool_calls na mensagem assistant, cada um com id |
tool_use nos blocos de conteúdo do assistant, cada um com id |
| Formato dos parâmetros | arguments normalmente é uma string JSON e precisa ser analisado por conta própria |
input já é diretamente um objeto JSON |
| Retorno do resultado | mensagem com role igual a tool, carregando tool_call_id |
bloco de conteúdo tool_result na mensagem user, carregando tool_use_id |
| Marcação de erro | em geral, um campo de erro personalizado dentro do conteúdo do resultado | tool_result suporta a marcação is_error |
| Chamadas paralelas | uma resposta pode conter vários tool_calls |
uma resposta pode conter vários blocos tool_use |
Existem algumas armadilhas fáceis de pisar. Primeira: no formato OpenAI, arguments é uma string, e alguns modelos ocasionalmente emitem caracteres extras, o que faz a análise falhar. Isso por si só já deveria entrar na pontuação, e não ser tratado com tolerância no código. Segunda: ao retornar o resultado, o ID precisa corresponder exatamente ao ID da chamada que o originou — atenção especial à ordem nas chamadas paralelas. Terceira: alguns modelos, na mesma resposta, emitem texto e também iniciam chamadas de ferramentas; a lógica de processamento precisa lidar com os dois tipos de conteúdo ao mesmo tempo.
💡 Dica técnica: pelo ponto de entrada unificado da APIYI apiyi.com, é possível usar a mesma chave API para rodar o mesmo conjunto de testes tanto no formato OpenAI quanto no formato Anthropic. Assim dá para distinguir se o problema está no próprio modelo ou na camada de adaptação do protocolo.
Checklist de pontuação e modelo de registro para chamadas de ferramentas em múltiplas rodadas
O checklist de pontuação é o que torna as conclusões reproduzíveis. Cada item precisa poder ser verificado por programa e estar ligado a um risco real de negócio. A tabela abaixo traz os itens recomendados; você pode adicionar ou remover de acordo com o seu contexto.
| Item de verificação | Critério de avaliação | Risco de negócio correspondente |
|---|---|---|
| Seleção correta da ferramenta | Na primeira rodada, chama get_order e não aciona ferramentas irrelevantes | Chamadas extras aumentam latência e custo |
| Parâmetros validados | Parâmetros atendem ao Schema, incluindo tipo, campos obrigatórios e formato | Parâmetros errados chegam a sistemas reais |
| ID da chamada corresponde corretamente | O resultado retornado corresponde ao ID da chamada iniciada | Contexto de múltiplas rodadas fica confuso |
| Comportamento de retry razoável | Após receber um erro passível de retry, tenta novamente com os mesmos parâmetros e respeita o limite máximo | Desistir cedo demais ou tentar indefinidamente |
| Sem dados inventados | Todos os campos da resposta final podem ser encontrados no retorno da ferramenta | Alucinação afeta diretamente o usuário |
| JSON final válido | Passa na validação de JSON Schema, sem texto extra | Falha de parsing downstream |
| Número de rodadas e uso de tokens | Registra o total de rodadas, tokens de entrada e tokens de saída | Avaliar custo e latência |
Depois que cada modelo rodar um número fixo de vezes, consolide os resultados em uma tabela. As colunas sugeridas incluem: ID do modelo, formato da interface, número da execução, quantidade de itens aprovados, detalhes dos itens com falha, total de rodadas, tokens de entrada, tokens de saída, tempo de execução e data do teste. Coloque o cabeçalho da tabela junto com os arquivos de configuração no controle de versão. Quando o modelo for atualizado ou trocado por uma nova versão, basta rodar o mesmo conjunto de scripts novamente para fazer uma comparação de regressão.
Como contabilizar o custo de chamadas de ferramentas em múltiplas rodadas
O uso de tokens precisa ser registrado rodada a rodada, não apenas na última. No loop de múltiplas rodadas, cada rodada reenvia as mensagens anteriores e os resultados das ferramentas como entrada, então os tokens de entrada se acumulam a cada rodada. Quanto mais retries, maior o custo. É por isso que o item “comportamento de retry razoável” merece uma pontuação separada.
Para calcular o custo, multiplique os tokens de entrada e de saída do campo usage (e também os tokens de cache, se houver acerto de cache) pelos preços unitários correspondentes. Os preços unitários de entrada, de saída e de cache de todos os modelos, assim como a base de cobrança, devem seguir os dados reais da página de preços da APIYI em docs.apiyi.com/models. Este artigo não lista números específicos porque os preços mudam, e valores fixados no texto ficam facilmente desatualizados.
Uma única chave de API para testar vários modelos: lista de modelos candidatos
Sugere-se que os modelos candidatos cubram diferentes fornecedores e posicionamentos, por exemplo: um modelo com boa relação custo-benefício, um modelo principal e um modelo com raciocínio mais forte. A tabela abaixo lista apenas as séries de modelos e os pontos de atenção dos testes, sem apresentar conclusões. As conclusões devem vir dos seus dados reais de teste.
| Série de modelo | Pontos de atenção sugeridos para teste | Formato de interface recomendado | Plataformas disponíveis |
|---|---|---|---|
| Série DeepSeek | Estabilidade na análise de parâmetros em formato de string; nova tentativa após falha de injeção | Compatível com OpenAI | APIYI apiyi.com, API oficial |
| Série Gemini | Tendência a chamadas paralelas; se o JSON final inclui texto extra | Compatível com OpenAI | APIYI apiyi.com, API oficial |
| Série Qwen | Chamadas acidentais a ferramentas de distração; correspondência de IDs em múltiplos turnos | Compatível com OpenAI | APIYI apiyi.com, API oficial |
| Série Claude | Tratamento de is_error em tool_result; controle do número de rodadas |
Compatível com Anthropic | APIYI apiyi.com, API oficial |
| Série GPT | Aderência estrita ao Schema; uso de tokens | Compatível com OpenAI | APIYI apiyi.com, API oficial |
Os IDs e versões específicos disponíveis devem seguir a lista de modelos da APIYI. Ao registrar os resultados, escreva sempre o ID completo do modelo, não apenas o nome da série. Versões diferentes da mesma série podem ter desempenho bem distinto em chamadas de ferramentas.
💡 Sugestão de escolha: A escolha do modelo depende da complexidade das suas ferramentas, da sua tolerância a alucinações e do seu orçamento. Recomendo usar a mesma chave na APIYI apiyi.com para rodar uma rodada de testes com cada modelo candidato e, depois, combinar com os dados de preço em docs.apiyi.com/models para uma avaliação abrangente.
Perguntas frequentes (FAQ)
Q1: O que é o pequeno teste de invocação de ferramentas em múltiplas rodadas?
É um teste bem pequeno e com resultado determinístico. Com 2 a 3 ferramentas Mock e uma falha injetada, fazemos o modelo percorrer o ciclo completo de “chamar a ferramenta, tratar o resultado, tentar de novo e produzir uma resposta estruturada”, e depois um programa avalia item por item se passou. O foco é se o ciclo consegue rodar de forma estável até o fim, e não o nível de conhecimento do modelo.
Q2: Por que insistir em testar vários modelos com uma única chave?
Para controlar as variáveis. Chaves, SDKs e endereços de proxy diferentes trazem diferenças de autenticação, timeout e adaptação de protocolo, o que distorce o resultado da comparação. Com uma entrada unificada, a única coisa que muda é o campo model, então as diferenças medidas podem ser atribuídas ao próprio modelo.
Q3: Definir temperature como 0 garante reprodução perfeita?
Não garante. Mesmo com temperature 0, a saída de alguns modelos ainda tem pequenas oscilações, e modelos de raciocínio podem não aceitar reduzir esse parâmetro. Por isso o teste precisa rodar várias vezes de forma fixa, observando a taxa de aprovação e a distribuição das falhas, em vez de olhar só o resultado de uma execução. Os valores de parâmetro realmente usados também devem ser registrados.
Q4: Para quais cenários esse teste é adequado?
– **Seleção de Agent**: comparar a estabilidade dos modelos candidatos no ciclo de ferramentas antes de ir para produção.
– **Regressão de upgrade de modelo**: depois que uma nova versão é lançada, rodar de novo o mesmo conjunto de scripts para confirmar que não houve degradação.
– **Validação de migração de protocolo**: ao mudar do formato OpenAI para o formato Anthropic, confirmar que a camada de adaptação está ok.
Q5: Como começar rápido a invocar esses modelos?
1. Acesse APIYI apiyi.com, registre uma conta e obtenha a chave.
2. Leia o docs.apiyi.com e confirme o endereço compatível com OpenAI e o endereço compatível com Anthropic.
3. Configure conforme a tabela de parâmetros do passo 1 deste artigo e, primeiro, faça uma requisição mínima para confirmar que cada modelo retorna uma chamada de ferramenta.
A APIYI permite o acesso unificado a vários dos modelos citados neste artigo; para trocar de modelo, basta alterar o campo model.
Q6: Como estimar o custo do teste?
O custo é aproximadamente “número de modelos × número de execuções × total de Tokens acumulados por execução × preço unitário”. Em ciclos de múltiplas rodadas, os Tokens de entrada se acumulam rodada a rodada, e as retentativas aumentam ainda mais o consumo. O preço unitário e as regras de cobrança de cache devem seguir os dados reais da página de preços da APIYI, docs.apiyi.com/models. A recomendação é rodar 1 vez por modelo para estimar o consumo e só então decidir quantas execuções oficiais fazer.
Q7: Quais são as limitações desse teste?
Um teste pequeno só cobre os modos de falha típicos e não representa todos os negócios complexos. Os dados retornados pelas ferramentas Mock são bem limpos; sistemas reais podem devolver dados com formato confuso ou muito longos. Depois que o teste passar, vale a pena adicionar amostras de anomalias que realmente apareceram no negócio e ir ampliando os casos de teste aos poucos.
Pontos-chave do teste rápido de invocação de ferramentas em múltiplas rodadas
- Controle de variáveis em primeiro lugar: use uma única chave API, um único conjunto de configuração, e altere somente o campo
model. - Ferramentas somente leitura e determinísticas: valores de retorno do Mock fixos no código, garantindo que cada execução veja os mesmos dados.
- Injeção de falha obrigatória: um erro que permita retry é o que melhor diferencia a capacidade do modelo de lidar com loops.
- Pontuação programática: cada item de verificação pode ser julgado automaticamente; a revisão humana fica só para os casos anômalos.
- Rastreabilidade completa: guarde a resposta bruta, o
usagede cada rodada e o ID completo do modelo, para facilitar a regressão. - Preço conforme a página oficial: o cálculo de custo deve seguir a página de preços do APIYI em docs.apiyi.com/models.
- Entrada unificada poupa trabalho: como o APIYI é compatível com os formatos OpenAI e Anthropic, um único script cobre os dois protocolos.
Resumo
Um teste rápido de invocação de ferramentas em múltiplas rodadas com uma chave para vários modelos — o núcleo está em três pontos:
- Reprodutível: configuração fixa, dados Mock fixos, versão do comando fixa, e várias execuções.
- Julgável: use validação de Schema e checklist de pontuação no lugar de impressão subjetiva.
- Regressível: rastreabilidade completa — quando o modelo for atualizado, dá para retestar rapidamente com o mesmo script.
Esse método não vai dizer “qual modelo é o melhor”, mas vai dizer, na sua cadeia de ferramentas, qual modelo é mais estável, economiza mais tokens e tem comportamento mais controlável quando falha. Sugiro primeiro rodar o fluxo completo com o cenário de consulta de pedidos deste artigo, e depois substituir pelas ferramentas do seu próprio negócio.
Recomendo usar o APIYI em apiyi.com para fazer a verificação transversal de múltiplos modelos com a mesma chave. Para o modo de integração, veja docs.apiyi.com; preços e critérios de cobrança seguem docs.apiyi.com/models.
📚 Referências
- Documentação de chamada de funções da OpenAI: descrição do protocolo para tools, tool_calls e mensagens com papel tool
- Link:
platform.openai.com/docs/guides/function-calling -
Descrição: entender como as strings de parâmetros e o tool_call_id são tratados no formato compatível com OpenAI
-
Documentação de uso de ferramentas da Anthropic: descrição dos blocos de conteúdo tool_use e tool_result
- Link:
docs.anthropic.com/en/docs/build-with-claude/tool-use -
Descrição: entender o uso de input_schema, tool_use_id e is_error
-
Central de documentação APIYI: instruções de integração da interface unificada
- Link:
docs.apiyi.com -
Descrição: consultar os endereços compatíveis com OpenAI e Anthropic e os exemplos de chamada
-
Página de modelos e preços do APIYI: lista de modelos e critérios de cobrança
- Link:
docs.apiyi.com/models - Descrição: todos os preços unitários de entrada, saída e cache têm como base os dados reais desta página
Autor: Equipe técnica APIYI
Contato técnico: fale conosco pela página inicial do site APIYI apiyi.com; mais materiais de integração podem ser encontrados na central de documentação docs.apiyi.com