Nota do autor: Entenda por que o LongCat-2.5 não depende apenas de uma janela de contexto de 1M, mas reforça em seis frentes de treinamento a capacidade dos agentes de concluir projetos inteiros em tarefas de longa duração. Veja também quais práticas de engenharia os desenvolvedores podem aproveitar.
Quem já desenvolveu um agente de IA provavelmente conhece estas situações: a tarefa falha no meio do caminho, o agente repete o mesmo comando que deu erro e, no fim, apresenta um resumo aparentemente completo, mas deixa de fora algumas entregas essenciais. Lançado oficialmente pela Meituan em 2026-11-02, o LongCat-2.5 coloca o foco em agentes capazes de concluir projetos inteiros em tarefas de longa duração, em vez de apenas continuar destacando a janela de contexto de 1M.
Este não é um artigo promocional sobre parâmetros. O blog técnico da Meituan já detalhou como foi estruturado o treinamento por aprendizado por reforço para tarefas de longa duração, e terceiros também fizeram testes práticos com tarefas longas no dia do lançamento da versão oficial. Neste artigo, vamos separar três tipos de informação: o treinamento descrito pela empresa, os resultados oficiais de benchmark e a experiência prática de terceiros. Também vamos explicar o que cada um pode — e não pode — comprovar.
O que você vai aprender: por que uma janela de contexto de um milhão de tokens não garante o sucesso de um projeto, quais métodos o LongCat-2.5 usa para melhorar sua capacidade em tarefas de longa duração e como aplicar essas ideias à engenharia dos seus próprios agentes.
LongCat-2.5: informações principais
O LongCat-2.5 é um Modelo de Linguagem Grande nativamente multimodal lançado pela equipe LongCat da Meituan, voltado para tarefas de agentes de longa duração (Long-Horizon Agentic Tasks). Com base no LongCat-2.0, ele incorpora mais trajetórias de tarefas longas e reforça sua capacidade de desenvolver bases de código complexas e construir projetos completos.
| Item | Detalhes |
|---|---|
| Lançamento | Preview em 2026-09-25; versão oficial em 2026-11-02 |
| Responsável | Equipe LongCat da Meituan |
| Tamanho do modelo | 1.6T de parâmetros no total, com ativação esparsa MoE de cerca de 48B por Token |
| Janela de contexto | 1,048,576 Tokens (cerca de 1M), incluindo entrada e saída |
| Foco principal | Agentes de longa duração, Agentic Coding, programação visual e chamadas de ferramentas em várias etapas |
| Disponibilidade | Página oficial e API disponíveis; a publicação dos pesos da versão oficial ainda não foi confirmada |
Vale destacar que, até 2026-11-03, a APIYI já havia publicado um artigo sobre o LongCat-2.5, mas informou na época que o modelo ainda não estava disponível na plataforma e que sua integração estava planejada para depois. Para saber quais modelos estão disponíveis para invocação, consulte a lista atualizada em APIYI apiyi.com. Os exemplos de código deste artigo usam o padrão genérico compatível com OpenAI e podem ser adaptados a qualquer modelo já integrado.
Por que uma janela de contexto de um milhão de tokens não basta para concluir tarefas de agente de longa duração
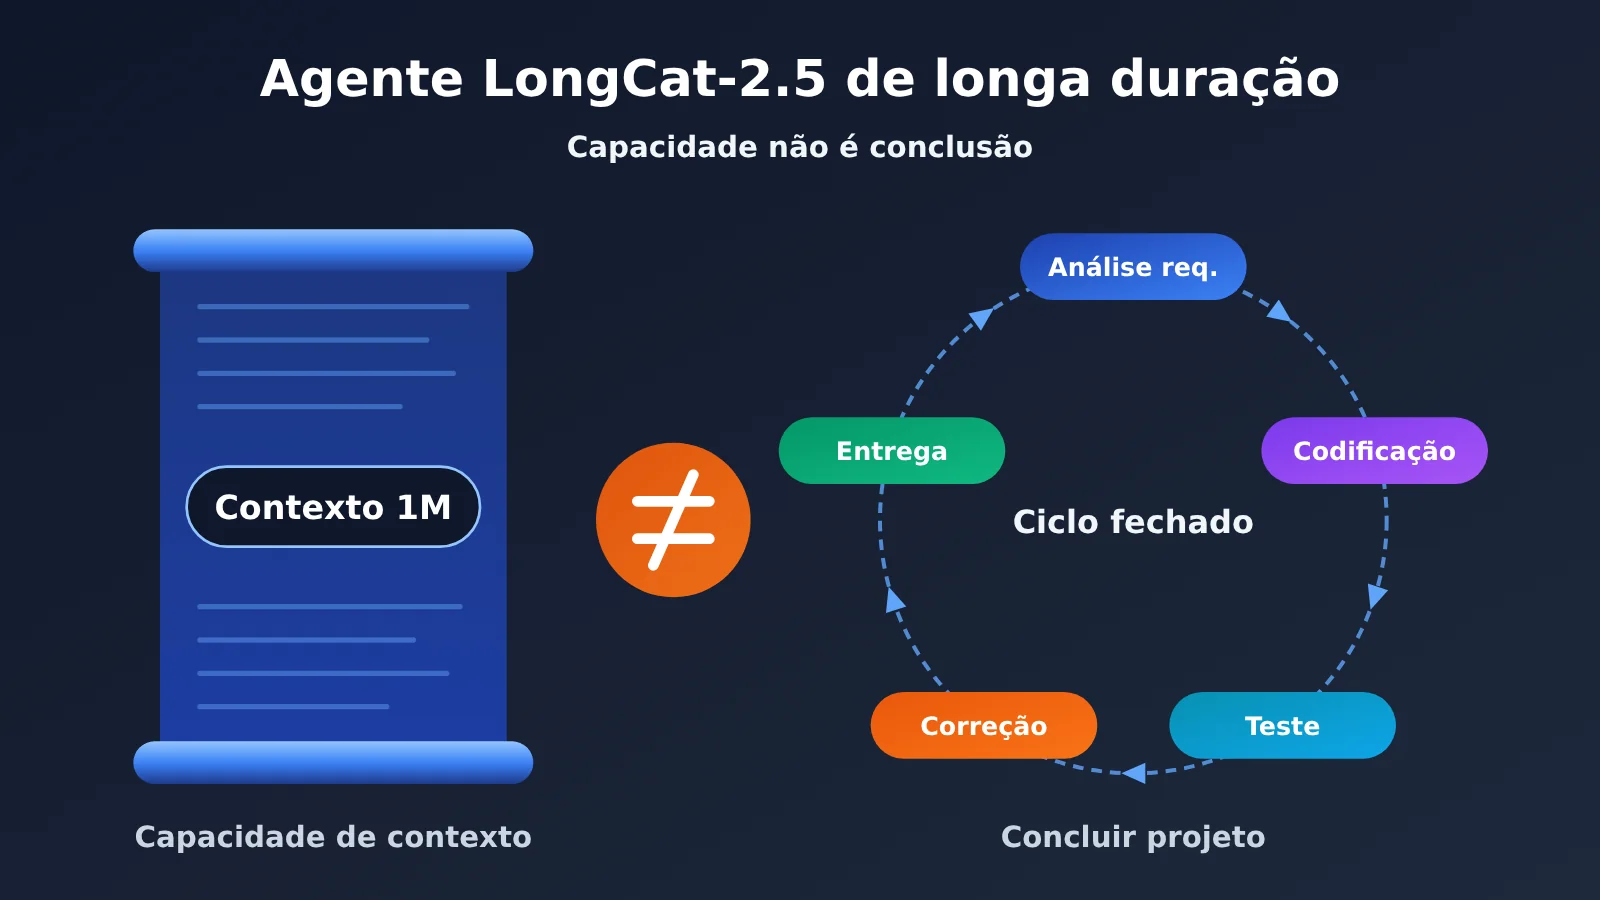
Contexto longo (Long Context) é a quantidade total de tokens que uma única requisição pode comportar. Uma janela de 1M permite que o modelo leia mais código-fonte, documentos e mensagens anteriores de uma só vez, o que ajuda a entender repositórios grandes. Mas esse número, por si só, não garante que “a busca em documentos longos será sempre precisa”, que “as chamadas de ferramentas continuarão funcionando” ou que “os arquivos gerados estarão corretos”.
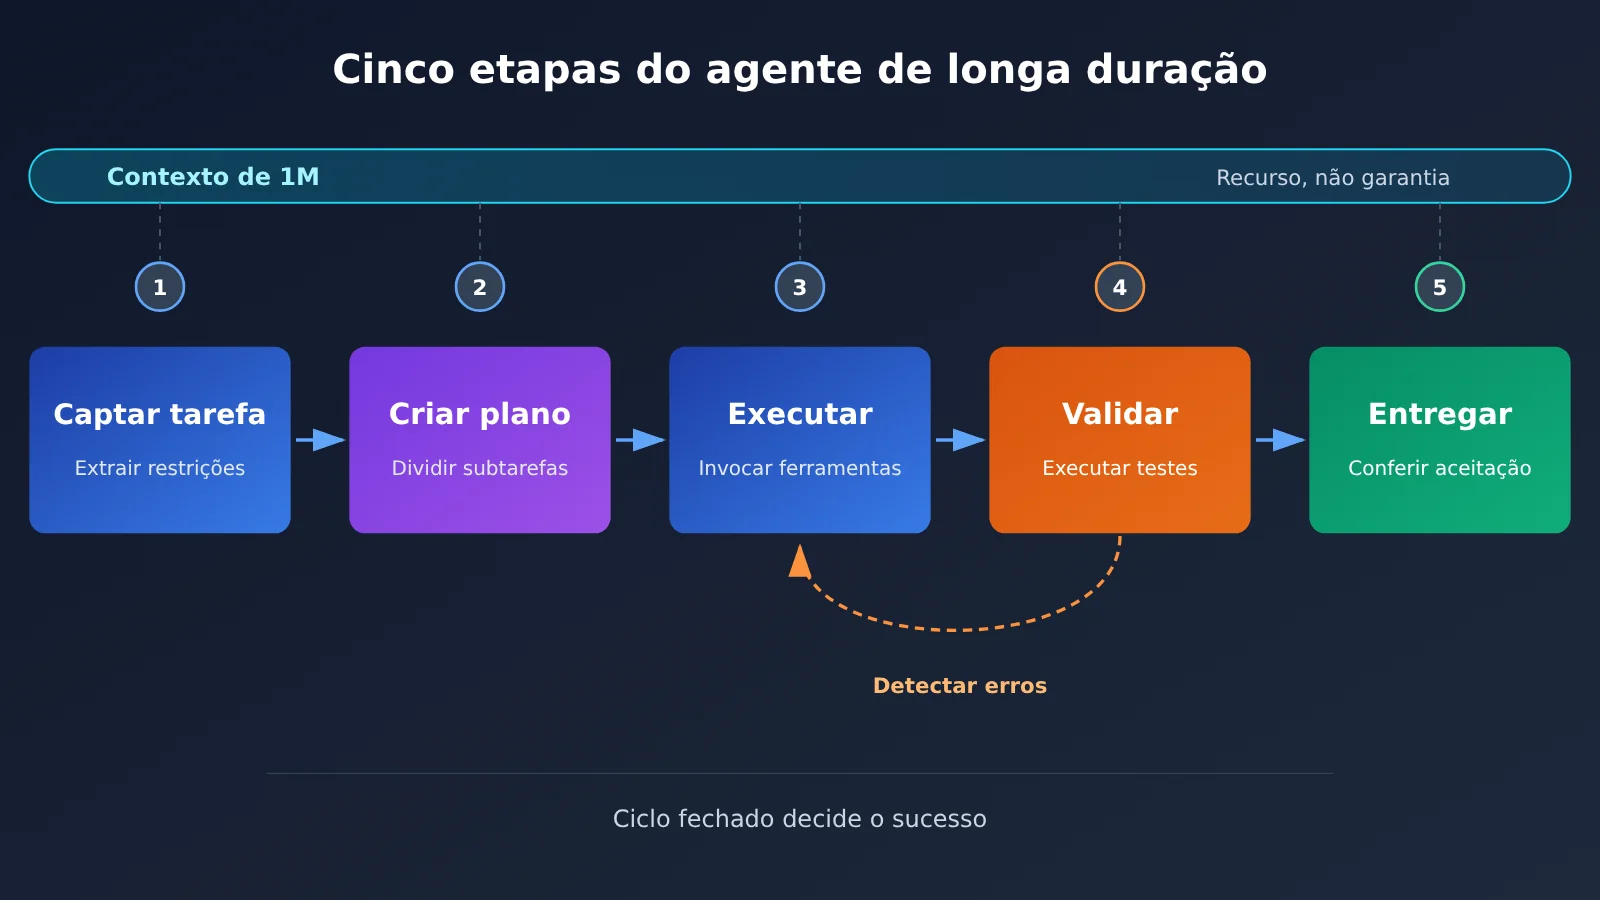
Um agente de longa duração (Long-Horizon Agent) é outra coisa. Ele precisa executar, em um ambiente externo, várias etapas interdependentes: ler o repositório, escrever código, chamar ferramentas, executar testes, encontrar erros, corrigir, validar novamente e, por fim, entregar o resultado. Se uma etapa falhar, as seguintes podem se apoiar em um estado incorreto.
| Dimensão | Capacidade de contexto longo | Capacidade de agente de longa duração |
|---|---|---|
| Essência | Capacidade de uma única requisição | Confiabilidade na execução contínua de várias etapas |
| Como medir | Quantos tokens cabem na janela | Se a tarefa atende aos critérios de aceitação |
| Dependências principais | Mecanismo de atenção e treinamento com textos longos | Planejamento, chamadas de ferramentas, uso do feedback de erros e decisão de quando encerrar |
| Falhas típicas | Omissões na busca em textos longos | Desvio do objetivo, chamadas repetidas, entregas incompletas |
| Relação com o sucesso do projeto | Um dos recursos necessários | Fator mais direto para o sucesso ou fracasso |
Em outras palavras, o contexto determina “o tamanho da bancada de trabalho”; a capacidade de longa duração determina “se o trabalho chega ao fim”. Por maior que seja a bancada, o projeto ainda pode fracassar no meio do caminho se o modelo não souber ajustar o plano após uma falha nos testes ou esquecer as restrições originais. Esse é o principal motivo pelo qual o LongCat-2.5 concentra seu treinamento em tarefas de longa duração.
Evolução dos resultados do LongCat-2.5 em benchmarks de agentes de longa duração
A Meituan divulgou uma comparação entre o LongCat-2.5 e a geração anterior em vários benchmarks de agentes de longa duração. Os números da tabela vêm da divulgação oficial, e a coluna de avanço mostra a diferença entre as pontuações, não uma porcentagem relativa.
| Benchmark | LongCat-2.0 | LongCat-2.5 | Avanço | O que avalia |
|---|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | +17.6 | Execução de tarefas reais em um ambiente de terminal |
| Terminal Bench v4.0 | 3.0 | 38.5 | +35.5 | Tarefas de terminal mais longas e difíceis |
| DeepSWE v1.1 | 9.7 | 64.6 | +54.9 | Tarefas de engenharia de software de longa duração |
| Program Bench Almost Resolved | 2.5 | 25.5 | +23.0 | Grau de conclusão na construção de programas |
| NL2Repo | 40.9 | 60.5 | +19.6 | Geração de repositórios a partir de requisitos em linguagem natural |
| MCP Atlas | 61.8 | 83.1 | +21.3 | Uso de múltiplas ferramentas |
| JobBench | 44.4 | 65.4 | +21.0 | Entregas profissionais em tarefas de trabalho |
O avanço nesses resultados é evidente, mas há alguns limites a considerar na interpretação. No DeepSWE, a pontuação saltou de 9.7 para 64.6, mas ainda ficou abaixo dos 72.7 do GPT-5.6-Sol na comparação oficial. No Terminal Bench v4.0, os 38.5 pontos ficaram ligeiramente acima dos 37.3 do GPT-5.6-Sol, mas 15.4 pontos abaixo dos 53.9 do Claude Opus 5 — sinal de que tarefas difíceis no terminal ainda estão longe de ser um problema resolvido.
As condições de avaliação também importam. O Terminal Bench usa o Claude Code Harness, o DeepSWE usa o mini-swe-agent e o JobBench usa LLM-as-Judge para atribuir notas. Todas essas pontuações estão vinculadas aos respectivos frameworks de execução. Na tabela oficial, alguns resultados de concorrentes vêm de relatórios públicos e outros foram obtidos em testes da própria Meituan; portanto, não devem ser tratados como um ranking independente com condições uniformes. O benchmark interno LongCat AppDev (47.7 → 73.7) também não pode ser reproduzido publicamente.
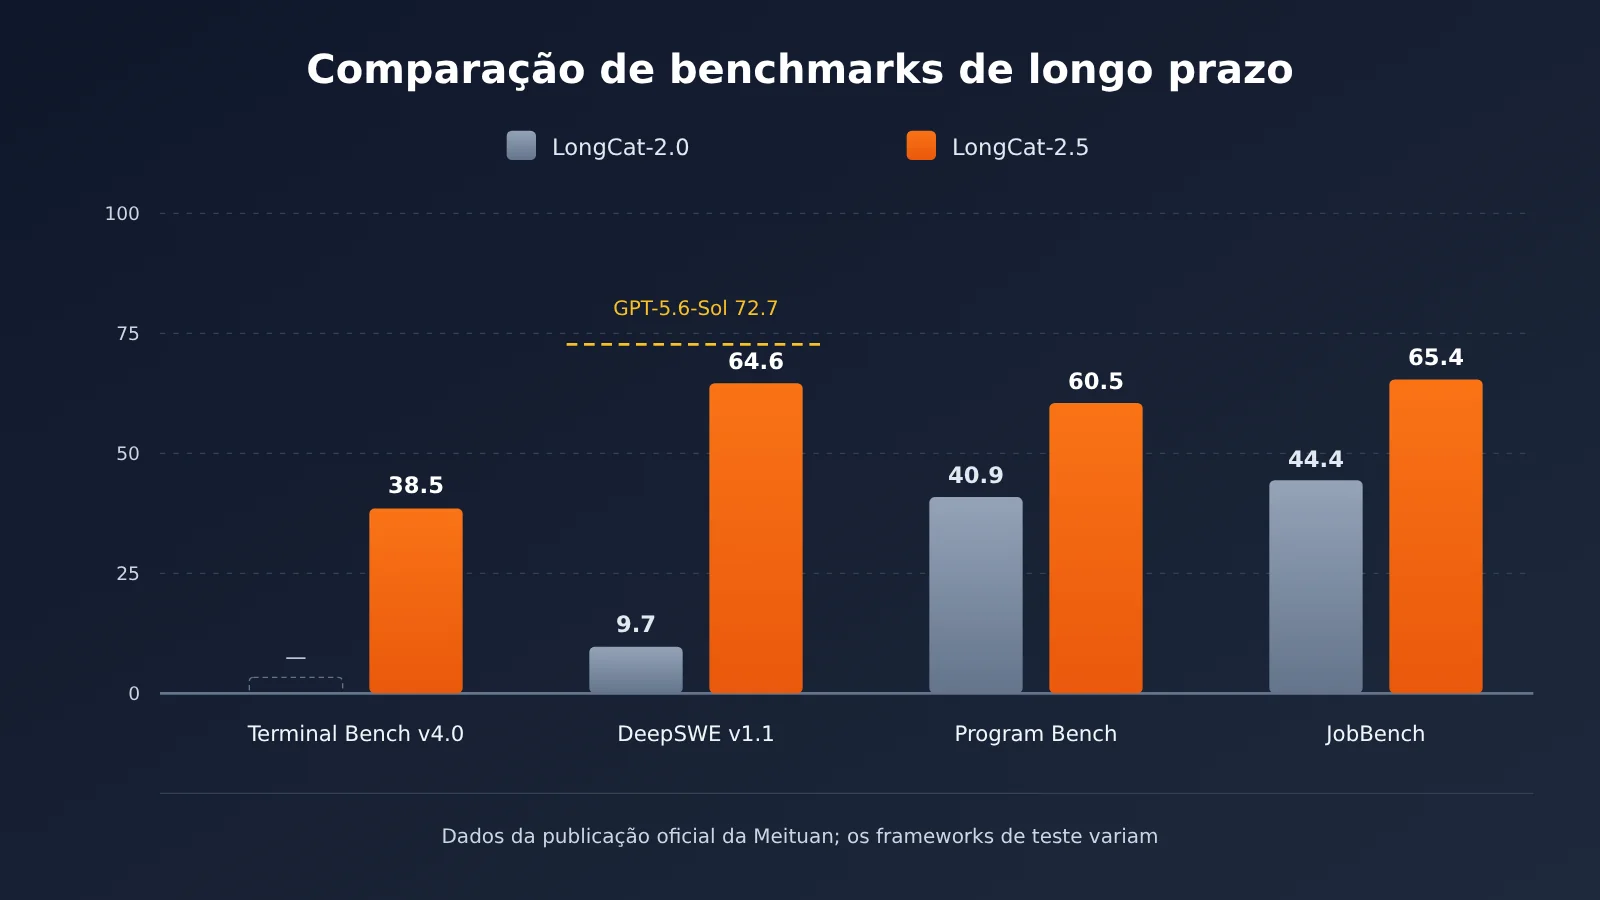
📊 Sobre a comparação: Benchmarks refletem apenas o desempenho em frameworks específicos. No fim das contas, é preciso validar os modelos nas suas próprias tarefas. Você pode usar a APIYI em apiyi.com para comparar vários modelos disponíveis com o mesmo conjunto de scripts de teste e, depois, combinar os resultados com as pontuações oficiais para escolher o modelo.
Como o LongCat-2.5 treina agentes para concluir projetos inteiros
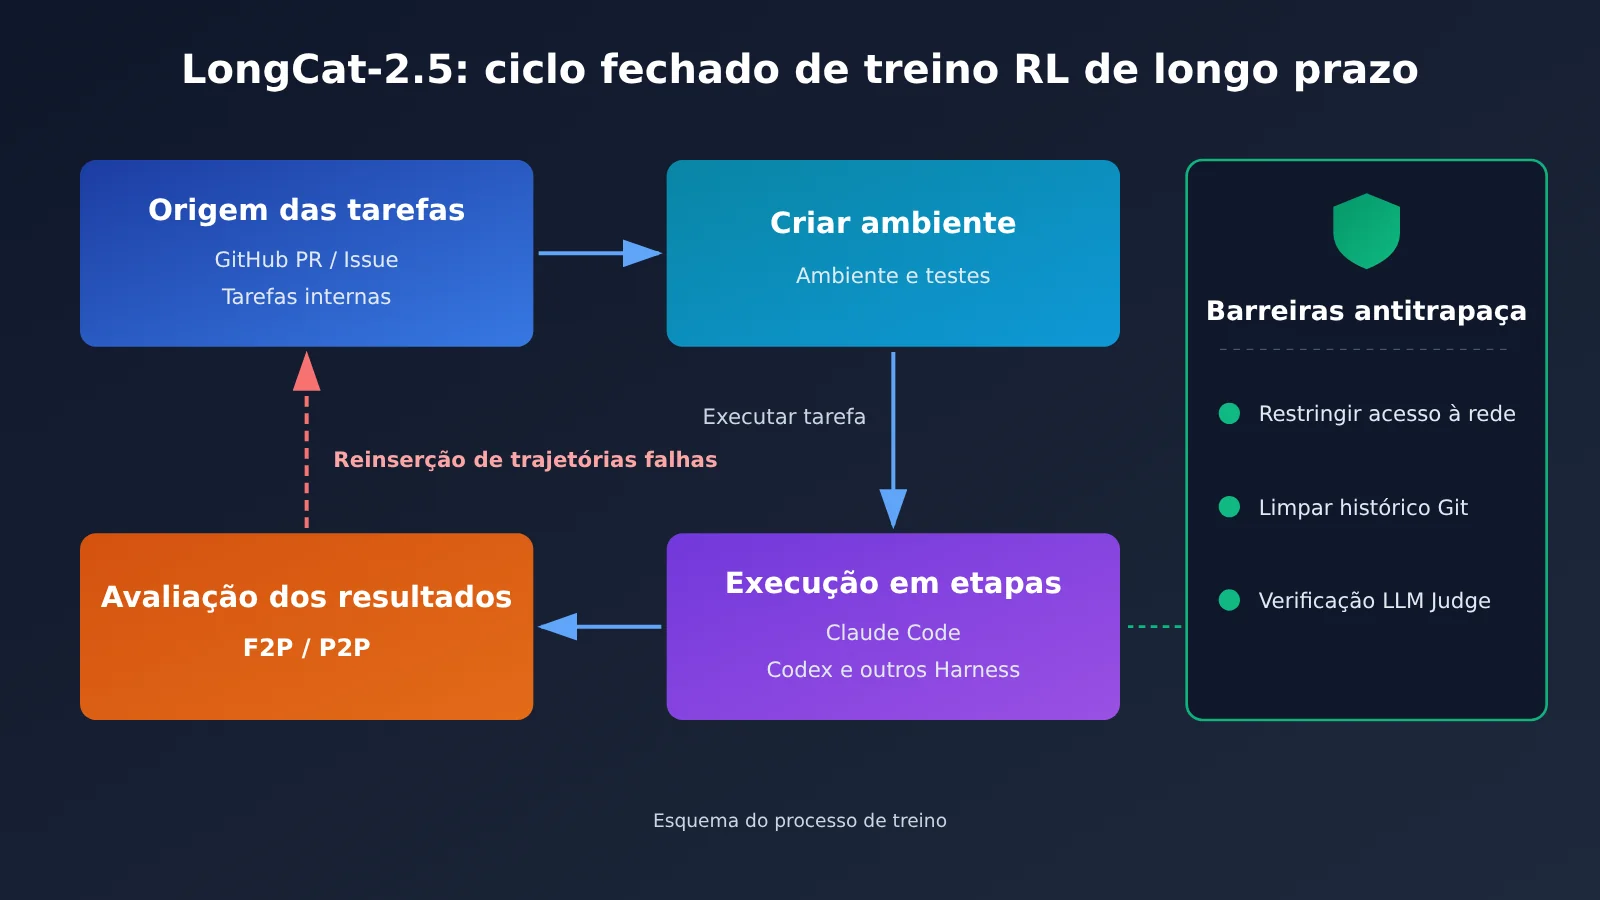
Os métodos de treinamento para tarefas de longa duração divulgados no blog técnico do Meituan podem ser agrupados em 6 frentes. Para entendê-las, vale observar que tipo de falha real em tarefas longas cada uma procura resolver.
Ambientes de tarefas reais e validação F2P/P2P do LongCat-2.5
Os dados de treinamento vêm de PRs e Issues relacionadas em repositórios públicos do GitHub, além de tarefas reais de programação internas do Meituan. O processo consiste em selecionar tarefas, usar agentes para anotá-las automaticamente, preparar o ambiente de código, gerar testes executáveis e deixar o modelo trabalhar. O resultado da execução mostra se o problema foi resolvido. Ao contrário de simplesmente alimentar o modelo com grandes volumes de código, essa abordagem gera feedback sobre se a solução realmente funcionou.
A validação usa dois tipos de teste: F2P (Fail-to-Pass) verifica se os testes que falhavam passam após a correção; P2P (Pass-to-Pass) verifica se os testes que já passavam continuam passando. O primeiro evita que o problema fique sem solução; o segundo evita que uma correção cause novos problemas. O Meituan também usa as trajetórias de treinamento e as taxas de aprovação para investigar falsos positivos e falsos negativos nos próprios testes. Ainda assim, a eficácia depende de quanto os casos de teste cobrem os requisitos.
LongCat-2.5: aprendizado com trajetórias de falha e Partial Rollout assíncrono
A equipe do LongCat-2.5 transforma trajetórias de falha de agentes reais em tarefas reproduzíveis e verificáveis, para identificar pontos fracos e ampliar os ambientes de treinamento. É como reunir os exercícios em que o modelo errou para revisá-los, em vez de aprender apenas com os acertos. Os materiais públicos não informam quantas trajetórias de falha foram usadas nem a taxa de correção de cada tipo de erro.
O tempo necessário para tarefas longas varia muito, e uma trajetória complexa pode atrasar todo o lote de treinamento. O Partial Rollout assíncrono funciona assim: várias tarefas são amostradas em paralelo e, quando o lote está completo, as trajetórias ainda não concluídas são interrompidas e salvas para continuar na próxima rodada. Ao mesmo tempo, são filtrados grupos de amostras em que todas as tentativas tiveram sucesso ou todas falharam, pois não fornecem gradientes úteis. Isso traz uma questão: os tokens de uma mesma trajetória podem vir de versões do modelo em diferentes etapas de treinamento. Para controlar o viés, a equipe limita as diferenças de logprob e ajusta a contribuição ao gradiente conforme as diferenças acumuladas ao longo do histórico. Essa técnica melhora a eficiência do treinamento, mas não permite concluir que as tarefas do usuário serão executadas proporcionalmente mais rápido.
LongCat-2.5: prevenção de Reward Hacking e treinamento entre Harnesses
Reward Hacking acontece quando o modelo explora brechas no sistema de recompensas para obter uma pontuação alta sem realmente concluir a tarefa, por exemplo, espiando a resposta ou contornando os testes. As medidas da Meituan incluem restringir o acesso à internet no ambiente de treinamento, limpar o histórico do Git e o cache de arquivos, usar um LLM Judge para verificar trajetórias e aplicar penalidades por raciocínio repetitivo, chamadas repetidas a ferramentas e raciocínio excessivo. São medidas de controle de risco, não uma garantia de que o problema foi totalmente resolvido.
O Harness é o sistema que organiza a execução das tarefas pelo modelo, incluindo ferramentas, gerenciamento de contexto e regras do ciclo de execução. Na fase de inicialização, o LongCat-2.5 recebe um pequeno conjunto de amostras para adaptação a frameworks. Na fase de RL, combina diferentes frameworks, como Claude Code e Codex, e tipos de tarefas. Isso reduz o risco de adaptação a um único modelo de comando, mas não garante um comportamento idêntico entre diferentes versões das ferramentas.
| Método de treinamento | Problema real que busca resolver | Limite conhecido |
|---|---|---|
| Ambientes de tarefas reais | O modelo sabe escrever código, mas não consegue fazê-lo funcionar no ambiente | Depende da qualidade da construção do ambiente |
| Verificação F2P / P2P | Conclusão apenas aparente ou introdução de erros de regressão | Limitada pela cobertura dos testes |
| Aprendizado com trajetórias de falha | Repetição de erros do mesmo tipo | Quantidade e taxa de correção não divulgadas |
| Partial Rollout assíncrono | Baixa eficiência no treinamento de tarefas longas | Não equivale a acelerar a inferência |
| Prevenção de Reward Hacking | Falsos sucessos obtidos ao explorar brechas | Não há alegação de solução definitiva |
| Treinamento combinado entre Harnesses | Falhas ao mudar de framework de agente | Não garante consistência entre versões |
Testes independentes: por que o LongCat-2.5 conclui tarefas longas apenas parcialmente
Além do treinamento oficial e dos benchmarks, testes independentes oferecem outra perspectiva. Em 2 de novembro de 2026, a TOKRACE integrou a versão final do LongCat-2.5 ao Claude Code e usou ferramentas como Blender e navegador para realizar 15 tarefas criativas.
Um dos casos bem-sucedidos foi o de uma estante paramétrica: as versões de 0,8 metro com três compartimentos e de 1 metro com quatro compartimentos atenderam às dimensões e à espessura de 18 mm das placas. O modelo também entregou seis imagens de diferentes ângulos. O processo levou cerca de 36 minutos e 47 requisições. Outras tarefas, porém, revelaram falhas típicas em trabalhos de longa duração:
- Erros de estrutura e unidade: um redutor planetário deveria medir 140 mm, mas o projeto gerado usou 140 m. O vídeo também não foi entregue.
- Entrega parcial: em uma tarefa de 60 minutos para criar o pátio de um templo chinês, foram entregues apenas três imagens finais; faltaram alguns ângulos e o vídeo.
- Problemas de relação espacial: em um modelo de apartamento de dois quartos, portas e janelas não tinham aberturas, e a cama se sobrepunha a uma divisória.
- Interrupção de uma tarefa longa: um vídeo educativo de matemática não foi concluído após sucessivos tempos limite nas requisições.
Esses casos mostram que, em tarefas longas, não basta verificar se houve algum resultado: é preciso conferir cada requisito. Também vale lembrar que os testes tinham limites de requisições, tempo ou orçamento de execução. Por isso, não dá para atribuir todas as entregas incompletas à capacidade do modelo; além disso, não se tratou de um experimento rigoroso de comparação entre modelos.
Análise do impacto da abordagem de treinamento do LongCat-2.5 para tarefas de longa duração
Impacto para desenvolvedores de agentes
- Mudança nos critérios de escolha: ao avaliar modelos, o tamanho da janela de contexto está perdendo peso. Vale prestar mais atenção aos benchmarks de tarefas de longa duração e à taxa de entrega completa em tarefas reais.
- A validação continua indispensável: mesmo que o modelo tenha passado por treinamento F2P/P2P, ainda é necessário criar testes e critérios de aceitação próprios para o ambiente de produção. Testes independentes já demonstraram isso.
- O design do harness também é fundamental: as pontuações estão fortemente relacionadas ao framework de execução. O mesmo modelo pode apresentar resultados bem diferentes com outro ciclo de execução de tarefas.
Impacto para o setor de Modelos de Linguagem Grande
- O foco do treinamento se volta para o “processo”: a geração de código em uma única rodada dá lugar a projetos completos e tarefas de engenharia com várias etapas. A capacidade de criar ambientes de aprendizado por reforço se torna um novo diferencial competitivo.
- Os métodos de avaliação ganham mais atenção: o Terminal-Bench 2.1 corrigiu 28 das 89 tarefas em relação à versão 2.0. Isso mostra que a própria versão do teste pode influenciar significativamente os resultados e que o setor precisa de mais transparência sobre as condições de avaliação.
Projetando agentes para tarefas longas com ideias do LongCat-2.5
O método de treinamento do LongCat-2.5 traz uma lição direta para desenvolvedores de aplicações: se o modelo é treinado para validar etapas, recuperar-se de falhas e evitar atalhos, a arquitetura do agente também deve incorporar esses mecanismos de forma explícita. As sugestões de engenharia abaixo são baseadas nos métodos de treinamento públicos, não em funcionalidades que a equipe oficial afirma ter implementado.
| Mecanismo de engenharia | Ideia de treinamento correspondente | Como implementar |
|---|---|---|
| Validação por etapa | Validação F2P | Executar um script de verificação ao final de cada subtarefa |
| Proteção contra regressões | Validação P2P | Executar todos os testes de regressão após cada alteração |
| Registro de falhas | Aprendizado com trajetórias de falha | Salvar os erros no arquivo de progresso e incluí-los na próxima rodada |
| Limite de orçamento | Penalização por chamadas repetidas | Limitar o número de rodadas, o tempo de execução e as chamadas de ferramentas |
| Aceitação da entrega | Prevenção de Reward Hacking | Verificar os arquivos reais, em vez de confiar apenas no resumo do modelo |
A seguir, um exemplo mínimo de loop de agente com validação por etapa, registro de progresso, reaproveitamento dos erros e limite de orçamento:
import json, subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface da APIYI compatível com OpenAI
)
MODEL = "gpt-4o-mini"  # Use o ID de um modelo disponível na lista da plataforma
MAX_ROUNDS = 8         # Limite de orçamento para evitar loops infinitos

def run_check(cmd: str) -> tuple[bool, str]:
    r = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=300)
    return r.returncode == 0, (r.stdout + r.stderr)[-2000:]

def run_stage(stage: dict, progress: dict) -> bool:
    failures = []
    for i in range(MAX_ROUNDS):
        prompt = (f"阶段目标:{stage['goal']}\n"
                  f"已完成阶段:{progress['done']}\n"
                  f"历史失败(请避免重复):{failures[-3:]}")
        resp = client.chat.completions.create(
            model=MODEL, messages=[{"role": "user", "content": prompt}])
        # Omitido aqui: interpretar a saída do modelo e gravá-la nos arquivos de código
        ok, log = run_check(stage["check"])          # Validação da etapa (semelhante a F2P)
        reg_ok, reg_log = run_check("pytest -q")     # Teste de regressão (semelhante a P2P)
        if ok and reg_ok:
            progress["done"].append(stage["name"])
            return True
        failures.append(log if not ok else reg_log)
    progress["blocked"] = stage["name"]
    return False

progress = {"done": [], "blocked": None}
stages = [{"name": "api", "goal": "实现用户接口", "check": "pytest tests/test_api.py -q"}]
for s in stages:
    if not run_stage(s, progress):
        break
json.dump(progress, open("progress.json", "w"), ensure_ascii=False)
O ponto central dessa estrutura é que cada etapa tem um comando de aceitação executável, os logs de falha são incluídos no comando da rodada seguinte e o progresso é gravado em um arquivo, em vez de ficar apenas no contexto. Mesmo com uma janela de contexto grande o suficiente, manter o progresso e as restrições como um estado estruturado externo reduz significativamente o risco de perder o rumo durante tarefas longas.
🚀 Dica para começar: ao criar um protótipo de agente, você pode obter créditos de teste pela APIYI em apiyi.com e usar a mesma chave API para alternar entre modelos no loop de validação por etapa. Assim, fica mais fácil observar qual deles entrega o resultado mais completo para sua tarefa.
Se o projeto exigir alta confiabilidade, você também pode adotar a “validação cruzada”: outro modelo confere o resultado final item por item, com base na lista de requisitos. Com a interface unificada da APIYI em apiyi.com, os modelos de execução e de validação podem ser invocados no mesmo código, com pouco esforço para alternar entre eles.
Perguntas frequentes
Q1: A janela de contexto de 1M do LongCat-2.5 significa que ele consegue concluir projetos grandes?
Não necessariamente. A janela de contexto de 1M é a capacidade de uma única requisição, incluindo entrada e saída, e permite que o modelo leia mais código e documentos. Concluir um projeto também depende de planejamento, chamadas de ferramentas, correção de erros e verificação da entrega. Essas são justamente as habilidades para as quais o LongCat-2.5 foi treinado com aprendizado por reforço de longo horizonte.
Q2: Como o LongCat-2.5 se compara ao GPT-5.6-Sol e ao Claude Opus 5 em tarefas de longo horizonte?
Segundo a tabela oficial, o LongCat-2.5 supera ligeiramente o GPT-5.6-Sol no BrowseComp (91.9) e no Terminal Bench v4.0 (38.5). Já no DeepSWE, seus 64.6 pontos ficam abaixo dos 72.7 do GPT-5.6-Sol. No Terminal Bench v4.0, ele também fica 15.4 pontos atrás do Claude Opus 5. Como os testes usam estruturas diferentes, não é recomendável tratá-los como um ranking único.
Q3: Quando a versão final do LongCat-2.5 foi lançada? Os pesos são abertos?
A versão Preview chegou à plataforma de API em 2026-09-25, e a versão final foi lançada em 2026-11-02. A página oficial e a API já estão disponíveis, mas, até 2026-11-03, a publicação dos pesos da versão final ainda não havia sido confirmada. Segundo a equipe oficial, eles serão disponibilizados posteriormente no GitHub e no Hugging Face.
Q4: Já é possível invocar o LongCat-2.5 via APIYI?
Segundo o comunicado público de 2026-11-02, o LongCat-2.5 ainda não estava disponível na APIYI naquela data, mas havia planos de integrá-lo posteriormente. Consulte a lista de modelos da APIYI em apiyi.com para verificar a disponibilidade atual. Enquanto isso, você pode usar os modelos já disponíveis na plataforma para criar estruturas de agentes com validação por etapas e reaproveitamento de falhas. Quando o novo modelo estiver disponível, basta substituir o ID do modelo.
Q5: Como avaliar a baixo custo a capacidade de um modelo como agente em tarefas de longo horizonte?
Uma boa opção é preparar de 3 a 5 tarefas com várias etapas, próximas da realidade do seu negócio e acompanhadas de scripts de validação automática. Registre a taxa de entregas completas, o número médio de rodadas e os tipos de falha de cada modelo. Com a interface compatível com OpenAI da APIYI em apiyi.com, uma única chave API permite comparar vários modelos no mesmo conjunto de scripts. Novos usuários também recebem créditos gratuitos para testes iniciais.
Q6: Quais são as limitações conhecidas do LongCat-2.5 em tarefas de longo horizonte?
Testes independentes identificaram problemas como erros em unidades de medida, erros em relações espaciais, vídeos não entregues e interrupções por tempo limite de requisição. A equipe oficial também não afirmou ter resolvido completamente o Reward Hacking, e a escala das trajetórias de falha e sua taxa de correção ainda não foram divulgadas. Medidas de engenharia, precisão das informações e integridade das entregas ainda precisam de verificação humana.
LongCat-2.5: principais pontos sobre agentes de longo prazo
- Contexto ≠ conclusão: 1 milhão de tokens é capacidade, não garantia de sucesso do projeto. A capacidade de executar tarefas longas precisa de treinamento específico.
- Treinamento em ambientes reais: PRs, issues e tarefas internas do GitHub servem de base para criar ambientes executáveis que fornecem feedback.
- Validação com dois tipos de teste: F2P verifica se o problema foi resolvido; P2P verifica se houve regressões.
- Aprendizado com falhas: trajetórias reais de falha de agentes são transformadas em tarefas de treinamento verificáveis.
- Resultados dependem das condições: benchmarks estão fortemente vinculados ao harness usado, e testes independentes ainda mostram falhas na entrega completa.
- Projeto de engenharia alinhado: validação por etapas, registro de falhas, limites de orçamento e critérios de aceitação da entrega são indispensáveis. A APIYI apiyi.com pode ajudar a comparar e validar diferentes modelos.
Resumo
O principal sinal trazido pelo lançamento do LongCat-2.5 não é mais uma janela de 1 milhão de tokens, mas a mudança de foco no treinamento: de “quanto o modelo consegue ler” para “se ele consegue concluir um projeto inteiro”:
- Definição mais precisa do problema: falhas de agentes em tarefas longas costumam acontecer na execução, validação e entrega, não por falta de contexto.
- Métodos de treinamento direcionados: ambientes de tarefas reais, F2P/P2P, trajetórias de falha, Partial Rollout, prevenção de soluções oportunistas e uso de diferentes harnesses tratam, cada um, de um tipo de falha real.
- Limites das evidências: os resultados oficiais mostram avanços significativos, mas ainda há uma distância em relação aos modelos de ponta. Testes independentes também indicam que a entrega completa ainda exige supervisão humana.
Para desenvolvedores, o caminho mais prático é aplicar a mesma lógica aos próprios sistemas de agentes e avaliar os modelos com critérios de aceitação executáveis, em vez de olhar apenas para parâmetros e rankings. Vale usar a APIYI apiyi.com para comparar e validar modelos em tarefas reais por uma interface unificada, antes de definir a combinação de modelos para produção.
📚 Referências
- Equipe técnica do Meituan – Artigo técnico sobre o LongCat-2.5: explicação detalhada dos métodos de treinamento de agentes para tarefas de longa duração
- Link:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
Descrição: fonte original dos métodos de treinamento, como F2P/P2P, Partial Rollout e prevenção de Reward Hacking
-
Blog oficial do LongCat: dados de benchmarks e métodos de avaliação
- Link:
longcat.ai/blog/longcat-2.5 -
Descrição: tabelas completas de avaliação e configurações de harness e parâmetros para cada benchmark
-
Documentação de parâmetros do modelo LongCat: contexto e parâmetros de saída
- Link:
longcat.ai/platform/docs/zh/api/model-params -
Descrição: parâmetros de invocação, como tamanho do contexto, max_tokens e orçamento de raciocínio
-
Terminal-Bench: benchmark para agentes de terminal
- Link:
tbench.ai -
Descrição: entenda a relação entre as pontuações e o harness do agente, além das diferenças entre versões
-
DeepSWE: benchmark para agentes de engenharia de software em tarefas de longa duração
- Link:
deepswe.datacurve.ai -
Descrição: metodologia de testes com 113 tarefas originais e 91 repositórios de código aberto
-
TOKRACE – Registro de testes práticos do LongCat-2.5: testes independentes com 15 tarefas criativas
- Link:
tokrace.com/zh-CN/guides/longcat-2-5-release - Descrição: exemplos reais de tarefas longas concluídas parcialmente, erros de unidade e outros problemas
Autor: Equipe técnica da APIYI
Intercâmbio técnico: acesse a página inicial da APIYI em apiyi.com e entre em contato para trocar experiências sobre práticas de engenharia de agentes para tarefas de longa duração e escolha entre modelos