Resumo: Os pesos da versão oficial do Hy4 já estão disponíveis publicamente. Este artigo ajuda você a decidir qual conjunto de pesos usar, de que escala de GPU precisa para implantar por conta própria e como fazer uma comparação justa com o custo de chamar a API diretamente.
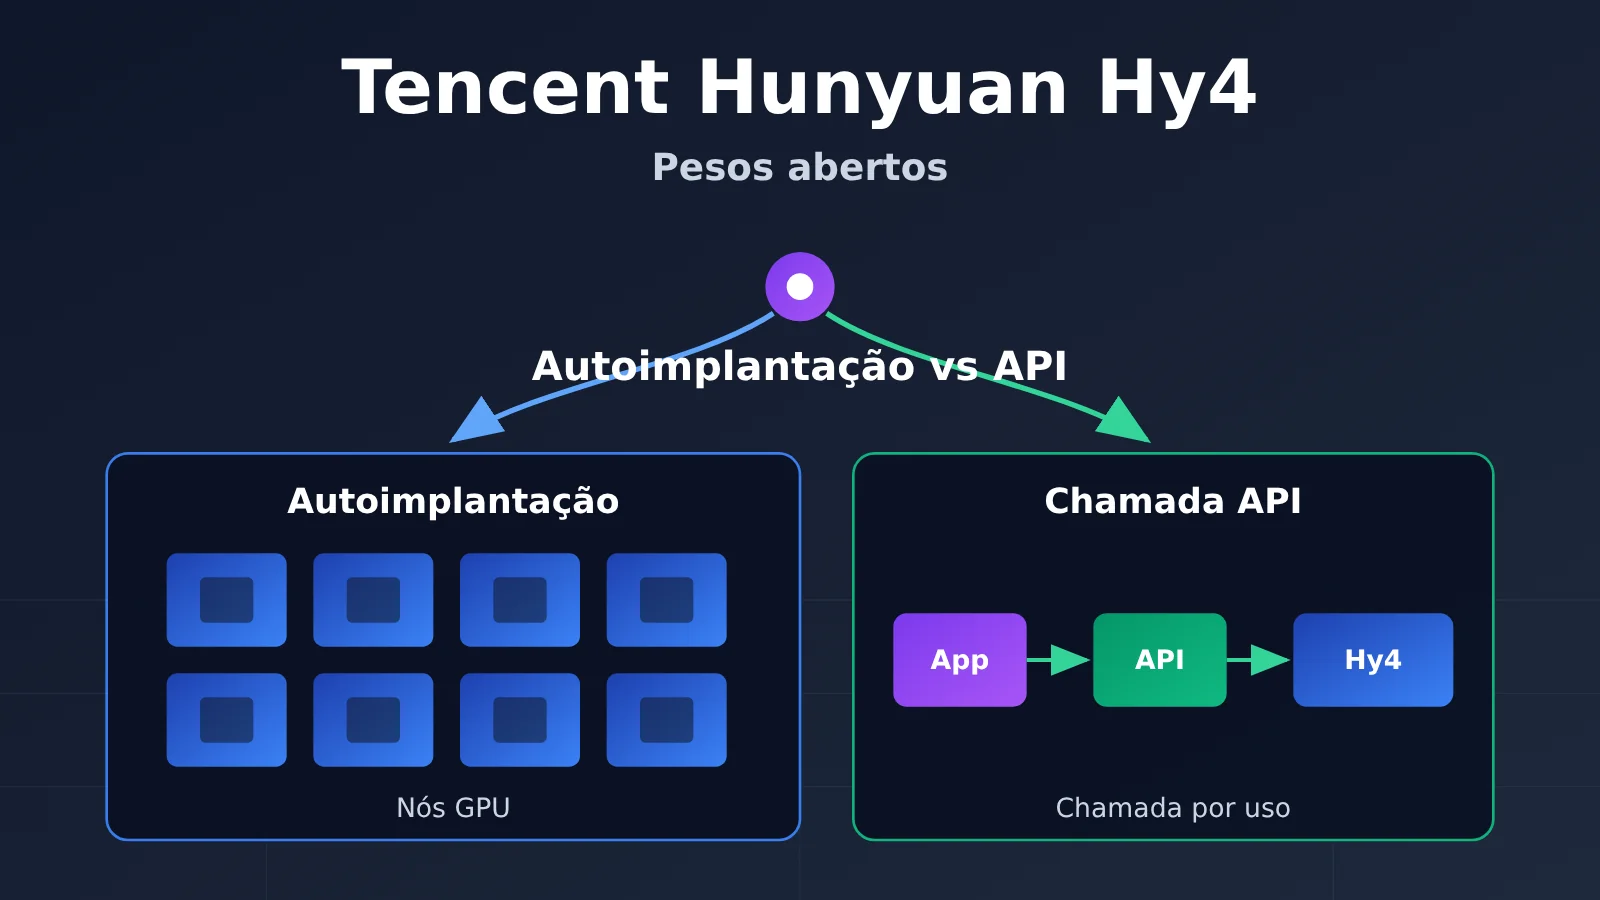
Direto ao ponto: Se as regras de conformidade permitirem e sua necessidade for testar primeiro tarefas de texto puro, chamar a API diretamente é o caminho de menor barreira. Só vale a pena implantar por conta própria quando você precisa de isolamento forte de dados ou realmente quer controlar a configuração de inferência. O ponto de partida da implantação própria não é baixo: a configuração de exemplo em FP8 fornecida pelo framework oficial de inferência fica no nível de 4 GPUs B300/GB300 ou 8 GPUs H200/B200. Além disso, esses exemplos não são o requisito mínimo em todas as configurações, nem significam que seja possível usar a janela de contexto de 1M por completo. Se os recursos disponíveis não chegarem a esse nível, em vez de forçar o Hy4, é melhor reavaliar modelos menores.
Mapa de conhecimento e índice de leitura dos pesos abertos do Hy4
| Nº | O que conferir primeiro | Por que conferir primeiro | O que você obtém ao final |
|---|---|---|---|
| 1 | Versão e escolha dos pesos | Se errar os pesos, toda a estimativa de hardware seguinte fica invalidada | Definir se usa Instruct BF16, Instruct FP8 ou Base |
| 2 | Quantas GPUs são necessárias para a implantação | O hardware é a maior barreira da implantação própria | Uma tabela comparativa de hardware e um checklist dos recursos disponíveis |
| 3 | Custo do mesmo conjunto de tarefas | Só faz sentido comparar com a mesma qualidade e a mesma latência | O método de cálculo do custo por tarefa na API e os itens que compõem o custo da implantação própria |
| 4 | Decisão | Aplicar as conclusões das três seções anteriores ao seu cenário | Seguir com a API, validar com implantação própria ou trocar por um modelo menor |
1→2→3 formam uma progressão: a versão determina os arquivos de pesos, os arquivos de pesos determinam o hardware, e o hardware determina o custo. A seção 4 consolida as conclusões das três seções anteriores. Quem se interessa apenas por custo pode começar direto pela seção 3.
Para saber: termos necessários para entender a implantação do Hy4
| Termo | Explicação breve |
|---|---|
| Pesos abertos | Os arquivos de parâmetros do modelo podem ser baixados e implantados por conta própria; as condições de uso são regidas pela licença |
| Instruct / Base | Instruct é a versão alinhada a instruções, que permite conversar diretamente; Base é a base pré-treinada, adequada para continuar o treinamento |
| BF16 / FP8 | Precisão numérica dos parâmetros. No FP8, cada parâmetro ocupa cerca de 1 byte; no BF16, cerca de 2 bytes |
| TP (paralelismo de tensores) | Divide um modelo entre várias GPUs para computação conjunta; TP8 significa dividir em 8 partes |
| KV cache | Estado intermediário salvo durante a inferência para o contexto; cresce com o tamanho do contexto e o número de solicitações simultâneas |
| Leitura de cache | Tokens de entrada que acertam o cache de comandos na cobrança da API; o preço unitário é menor que o da entrada sem cache |
1. Como escolher entre as versões do Hy4 e os pesos abertos
1.1 Os três momentos-chave do Hy4
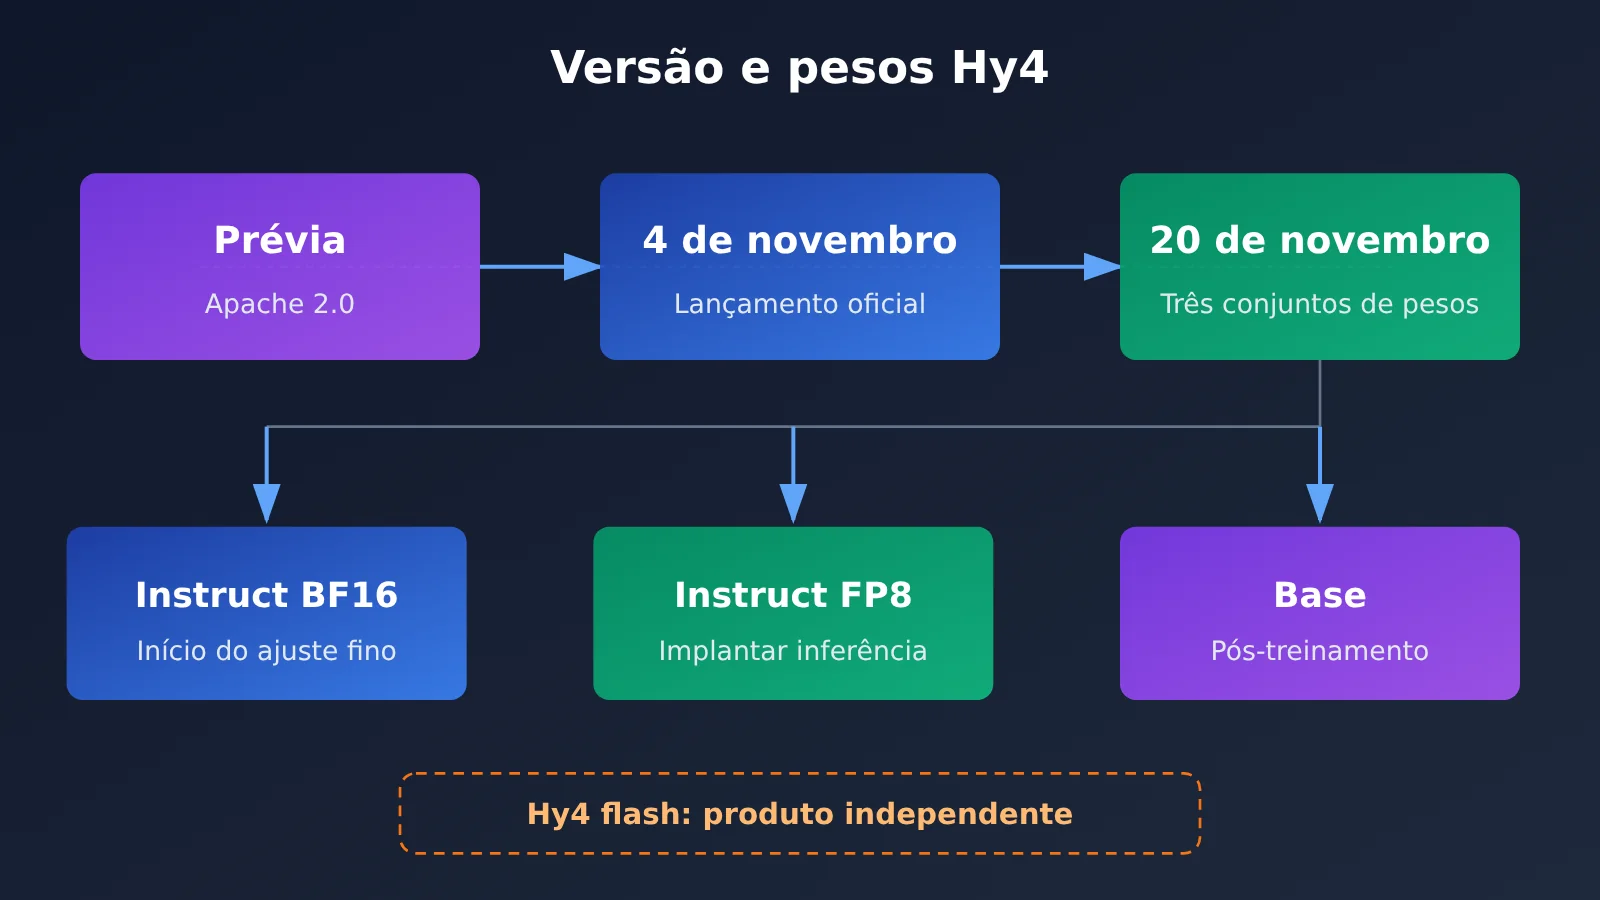
O processo de publicação do Hy4 aconteceu em três etapas. A primeira versão disponibilizada foi a Preview, publicada na página tencent/Hy4-preview no Hugging Face, com licença Apache 2.0. Em 4 de novembro de 2026, a Tencent publicou um anúncio oficializando o lançamento do Hy4. Em 20 de novembro, os três conjuntos de pesos da versão oficial foram disponibilizados publicamente no Hugging Face.
A diferença entre esses três momentos afeta diretamente a sua escolha. A licença da Preview é diferente da versão oficial: a versão oficial usa a Tencent Hy License 1.0, cuja seção 10 estabelece condições adicionais para alguns serviços de inferência de uso geral oferecidos externamente. Se você pretende implantar o Hy4 como um serviço oferecido externamente, peça ao time jurídico para avaliar o texto original da licença; este artigo não dá conclusões jurídicas sobre a prática de nenhuma empresa específica.
1.2 Condições de uso dos três conjuntos de pesos oficiais do Hy4
| Repositório de pesos | Conteúdo | Condições de uso |
|---|---|---|
tencent/Hy4 |
Instruct, BF16 | Precisa da maior precisão numérica, ou serve como ponto de partida para fine-tuning e quantização; é o mais exigente em memória de GPU |
tencent/Hy4-FP8 |
Instruct, FP8 | Usado diretamente para implantação de inferência; as configurações de exemplo do SGLang e do vLLM são baseadas nele |
tencent/Hy4-base |
Base pré-treinado | Para fazer pós-treinamento e treinamento continuado de domínio por conta própria; não é adequado para conversação direta |
É preciso distinguir especialmente: a versão oficial do Hy4 não é a mesma coisa que o Hy4 flash; este último é uma linha de produtos separada. O hardware e os custos discutidos neste artigo se aplicam apenas à versão oficial e não podem ser transferidos para o flash.
2. Quantas GPUs são necessárias para implantar o Hy4 por conta própria
2.1 Comparação das configurações de exemplo do SGLang e do vLLM
Os dois principais frameworks de inferência trazem exemplos de implantação do Hy4. Vamos colocá-los lado a lado abaixo:
| Framework | Pesos | Modo de paralelismo | GPU de exemplo | Observações do exemplo |
|---|---|---|---|---|
| SGLang | FP8 | TP4 | 4×B300 ou 4×GB300 | O tamanho do pool de KV determina a capacidade real de contexto disponível |
| SGLang | FP8 | TP8 | 8×H200 ou 8×B200 | O mesmo que acima |
| vLLM | FP8 (padrão) | TP8 | 8×B300 | A janela de contexto do exemplo é 131,072; suporta apenas imagem única e vídeo desativado |
Ao ler esta tabela, vale observar três pontos:
- Estas são configurações de exemplo, não configurações mínimas. A documentação do SGLang explica que o pool de KV limita o contexto que realmente pode ser acomodado, e essas configurações também não representam o limite mínimo para qualquer combinação de parâmetros.
- Não há garantia de que 1M seja totalmente utilizado. O contexto máximo declarado no model card é de 1,048,576 tokens, mas o comprimento disponível sob uma configuração de serviço específica precisa ser calculado à parte. O exemplo do vLLM só vai até 131,072, e nenhum dos dois documentos promete 1M totalmente disponível.
- Os números das duas documentações não podem ser aplicados indiscriminadamente. A VRAM de referência fornecida na documentação do vLLM se aplica apenas a essa configuração do vLLM.
2.2 A relação entre 770B, 49B e a VRAM
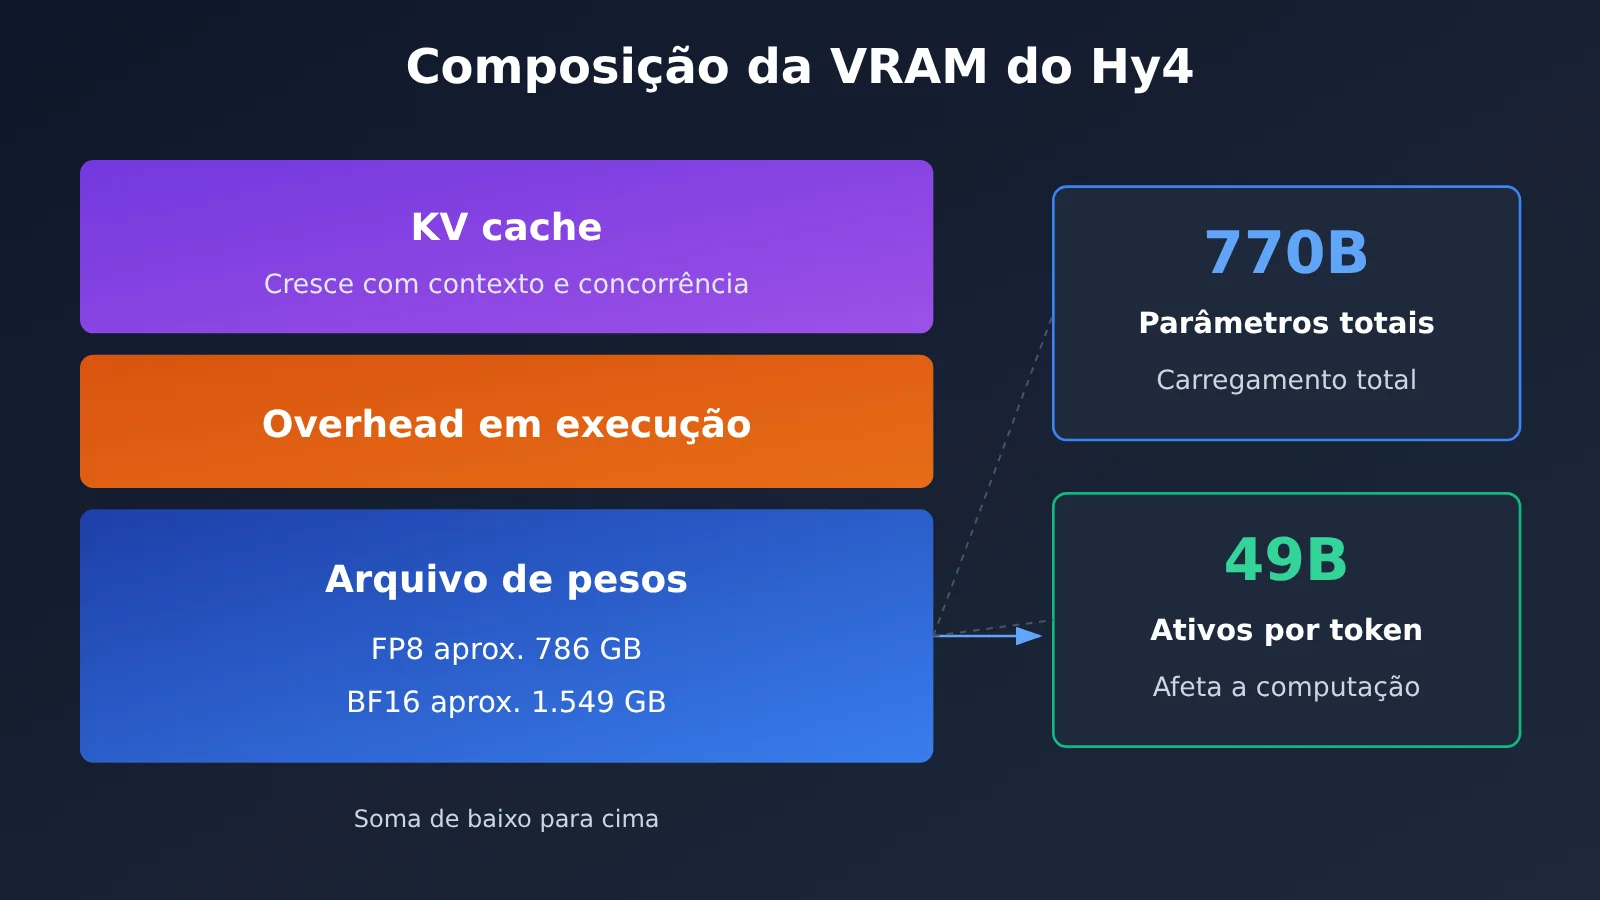
Dois números são frequentemente mencionados para o Hy4: 770B é o total de parâmetros do backbone de linguagem, e 49B é a quantidade de parâmetros de texto ativados por token. Muitas pessoas interpretam erroneamente 49B como requisito de VRAM, o que está errado. 49B determina a quantidade de computação por token; para poder invocar qualquer especialista a qualquer momento, todos os 770B de parâmetros precisam ser carregados na VRAM.
A necessidade de VRAM deve ser dividida em três camadas:
- Tamanho do arquivo de pesos: de acordo com a documentação do vLLM, aproximadamente 786 GB em FP8 e 1,549 GB em BF16. Isso é, antes de tudo, uma questão de disco e de largura de banda de carregamento.
- VRAM em tempo de execução: a VRAM de referência no exemplo do vLLM é de cerca de 944 GB (FP8) e 1,859 GB (BF16), maior que o próprio arquivo, porque também inclui a sobrecarga de execução e a reserva de KV cache.
- KV cache e concorrência: quanto mais longo o contexto e quanto mais requisições atendidas simultaneamente, maior o uso de KV cache. Essa parte determina quanta carga o mesmo conjunto de hardware ainda consegue atender depois de “acomodar o modelo”.
Antes da implantação, você pode fazer um levantamento com a seguinte lista de verificação:
- [ ] Modelo, quantidade e VRAM por GPU das GPUs disponíveis, e se é possível formar TP4 ou TP8
- [ ] A interconexão entre as GPUs atende aos requisitos de comunicação do paralelismo de tensor
- [ ] O armazenamento local consegue acomodar cerca de 786 GB (FP8) ou cerca de 1,549 GB (BF16) de pesos, e qual é a velocidade de carregamento
- [ ] Comprimento de contexto desejado: 131K é suficiente ou precisa ser maior
- [ ] Número de concorrência de pico e se o pool de KV é suficiente sob essa concorrência
- [ ] É necessário entrada visual (o exemplo do vLLM só habilitou imagem única)
- [ ] A versão do framework de inferência escolhida está de acordo com o cookbook ou recipe oficial
3. Calcule o custo do Hy4 usando o mesmo lote de tarefas
3.1 Cálculo da cobrança por uso da API
Tomando como exemplo a página do modelo na APIYI: em 21 de novembro de 2026, o ID do modelo da versão oficial do Hy4 é hy4, que oferece dois grupos, Default e SVIP, e usa a interface Chat Completions. O preço de tabela é calculado por milhão de tokens: entrada sem cache $0.85, saída $2.55, leitura de cache $0.045; a cobrança efetiva prevalece no console. Vale explicar que a APIYI disponibilizou o Hy4 antes desta liberação de pesos; o anúncio menciona suporte a visão, mas o exemplo de cálculo abaixo assume apenas texto e não equipara a janela de contexto de 1M, vídeo ou recursos de Computer Use do model card ao desempenho medido do serviço gerenciado.
No faturamento, os três tipos de token são calculados separadamente e não se sobrepõem: um mesmo token de entrada é cobrado como entrada sem cache ou como leitura de cache, nunca nos dois. O exemplo abaixo é hipotético, não medido:
| Item | Uso assumido | Preço unitário (por milhão) | Custo |
|---|---|---|---|
| Entrada sem cache | 10 milhões de tokens | $0.85 | $8.50 |
| Saída | 3 milhões de tokens | $2.55 | $7.65 |
| Leitura de cache | 0 | $0.045 | $0 |
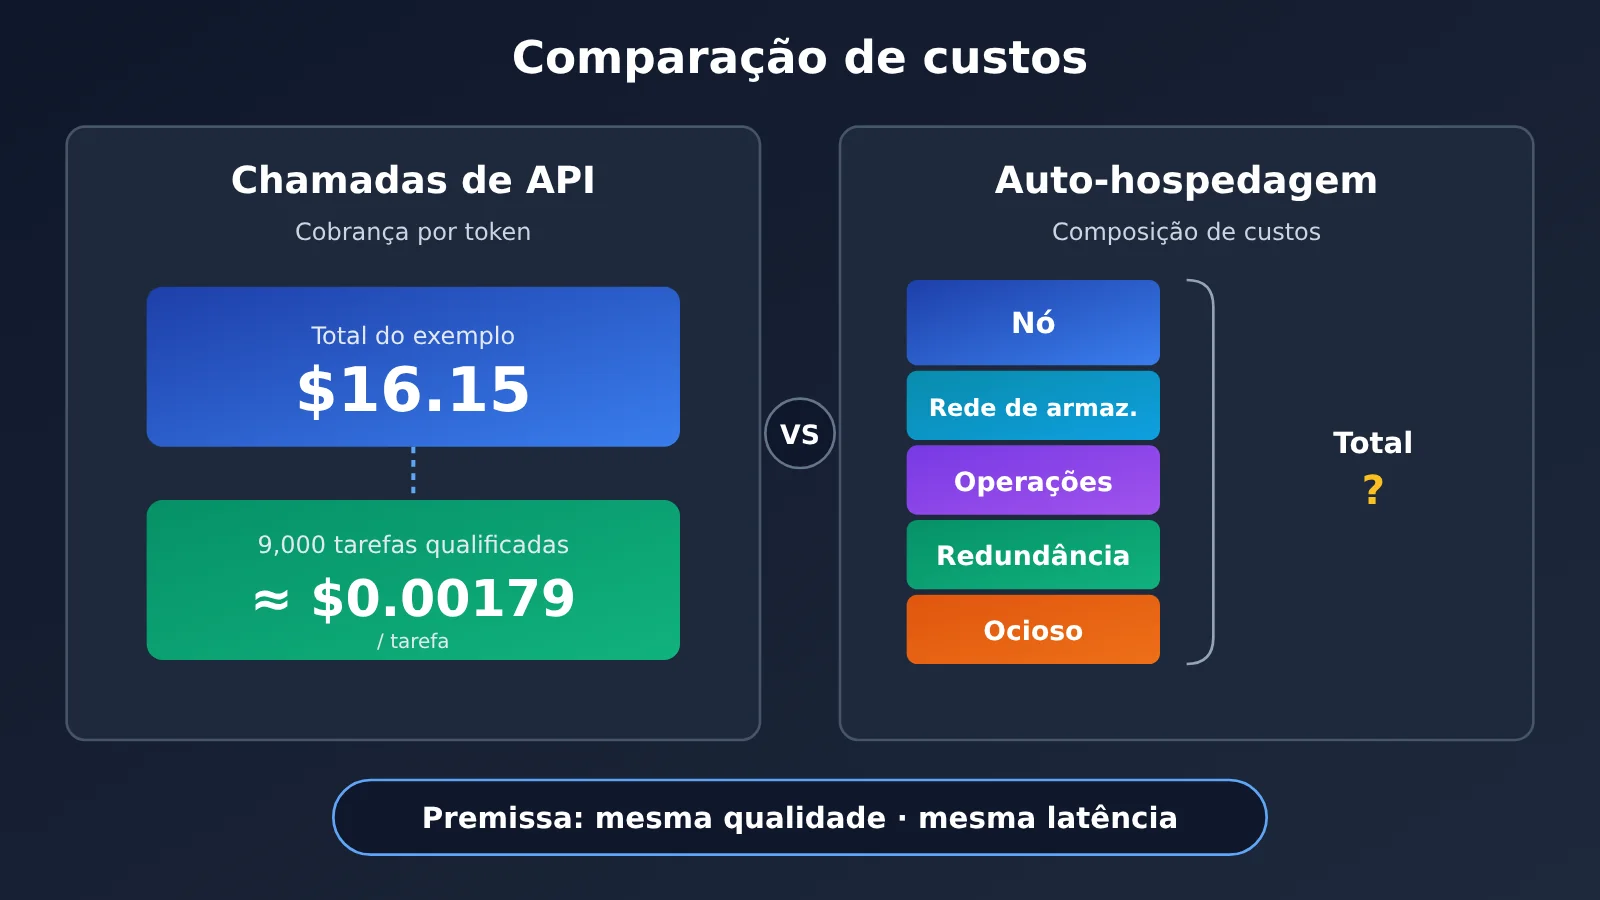
| Total | — | — | $16.15 |
Suponha que, desse lote de chamadas, 9.000 resultados tenham passado na sua validação. Nesse caso, o custo por tarefa qualificada fica em torno de $16.15 ÷ 9.000 ≈ $0.00179. Recomenda-se medir pelo “custo por tarefa qualificada”, e não pelo “custo por chamada”, porque os custos de novas tentativas com falha e de retrabalho também devem entrar na conta. Esse número também precisa ser registrado junto com a latência observada na prática e a concorrência que dá para suportar; caso contrário, não será possível comparar com a solução de implantação própria.
3.2 A composição real dos custos de implantação própria
O custo da implantação própria vai muito além da GPU em si. A tabela abaixo lista os itens que precisam ser considerados:
| Item de custo | Conteúdo |
|---|---|
| Nós de computação | Custos de compra ou aluguel de nós com GPU de alto desempenho com 4 ou 8 placas |
| Armazenamento e rede | Armazenamento de pesos na casa de TB, largura de banda de carregamento, interconexão entre placas e entre nós |
| Operação e manutenção | Mão de obra necessária para atualizar o framework de inferência, monitorar e alertar, e tratar falhas |
| Redundância | Nós de reserva preparados para garantir disponibilidade, que podem ficar ociosos na maior parte do tempo |
| Utilização | Custo de ociosidade nos períodos de baixo tráfego, que eleva diretamente o preço unitário de cada tarefa |
Ao comparar as duas soluções, faça isso sob a premissa de mesma qualidade e mesma latência: use o mesmo lote de tarefas e o mesmo conjunto de critérios de aceitação, com metas semelhantes de latência e concorrência, e calcule separadamente o custo por tarefa qualificada. Como os preços de hardware, a taxa de utilização e o custo de mão de obra variam muito de equipe para equipe, este artigo não oferece um “ponto de equilíbrio” universal. Você precisa calcular com seus próprios orçamentos e curvas de tráfego.
4. Decisão de implantação do Hy4: API, autoimplantação ou trocar por um modelo menor
Combinando as conclusões das três seções anteriores, é possível dividir em três caminhos conforme as condições:
- Conformidade permitida + começar com tarefas de texto puro → usar API. Sem precisar preparar hardware, primeiro use tarefas reais para calcular o custo e a latência por tarefa qualificada, como linha de base para decisões posteriores.
- Necessidade de forte isolamento de dados, ou realmente precisar controlar a configuração de inferência por conta própria → inventariar o hardware e validar com autoimplantação. Primeiro faça o inventário de recursos conforme a lista da seção 2.2, valide com as configurações de exemplo do SGLang ou vLLM, e depois compare qualidade, latência e custo usando o mesmo conjunto de tarefas da API. Antes de oferecer o serviço externamente, peça ao jurídico para verificar a seção 10 da licença.
- Recursos que não atingem a escala dos exemplos → reavaliar modelos menores. Quando não for possível reunir 4 ou 8 GPUs de alto desempenho, forçar a compressão do contexto ou da concorrência provavelmente não atingirá as metas de qualidade e latência; trocar por um modelo menor costuma ser mais realista.
Cartão de ação
- Selecione os pesos: use
Hy4-FP8para implantação de inferência,Hy4-basese precisar continuar treinando, e confirme que não está usando o flash. - Prepare de 200 a 500 tarefas reais e defina os critérios de aceitação.
- Se os dados puderem ser enviados externamente, primeiro execute uma rodada com a API; caso contrário, teste primeiro com amostras públicas ou sintéticas, mantendo os dados reais no ambiente interno. Registre o uso de tokens, a taxa de aprovação, a latência e o desempenho de concorrência.
- Se precisar de autoimplantação, faça o inventário de hardware conforme a lista e reteste com o mesmo lote de tarefas.
- Tome a decisão final usando um único critério: “custo por tarefa qualificada + latência”.
Referências
- Anúncio de lançamento oficial do Tencent Hy4: https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/
- Pesos do Hy4 Instruct (BF16): https://huggingface.co/tencent/Hy4
- Pesos do Hy4 Instruct (FP8): https://huggingface.co/tencent/Hy4-FP8
- Pesos do Hy4 Base: https://huggingface.co/tencent/Hy4-base
- Licença Tencent Hy 1.0: https://huggingface.co/tencent/Hy4/blob/main/LICENSE
- Hy4 Preview (Apache 2.0): https://huggingface.co/tencent/Hy4-preview
- Cookbook do SGLang para Hy4: https://docs.sglang.io/cookbook/autoregressive/Tencent/Hy4
- Receita do vLLM para Hy4: https://recipes.vllm.ai/tencent/Hy4
- Nota de lançamento do Hy4 na APIYI: https://docs.apiyi.com/news/hy4-launch
- Lista de modelos da APIYI (Tencent): https://docs.apiyi.com/models#腾讯
- Visão geral do contexto do Hy4 (snapshot histórico; use este artigo como referência para pesos e informações de disponibilização): https://help.apiyi.com/tencent-hy4-770b-vision-computer-use-pricing.html