Resumen: Los pesos oficiales de Hy4 ya se han publicado. Este artículo te ayuda a decidir qué conjunto de pesos usar, qué nivel de GPU necesitas para desplegarlo por tu cuenta y cómo comparar de forma justa el costo frente a llamar directamente a la API.
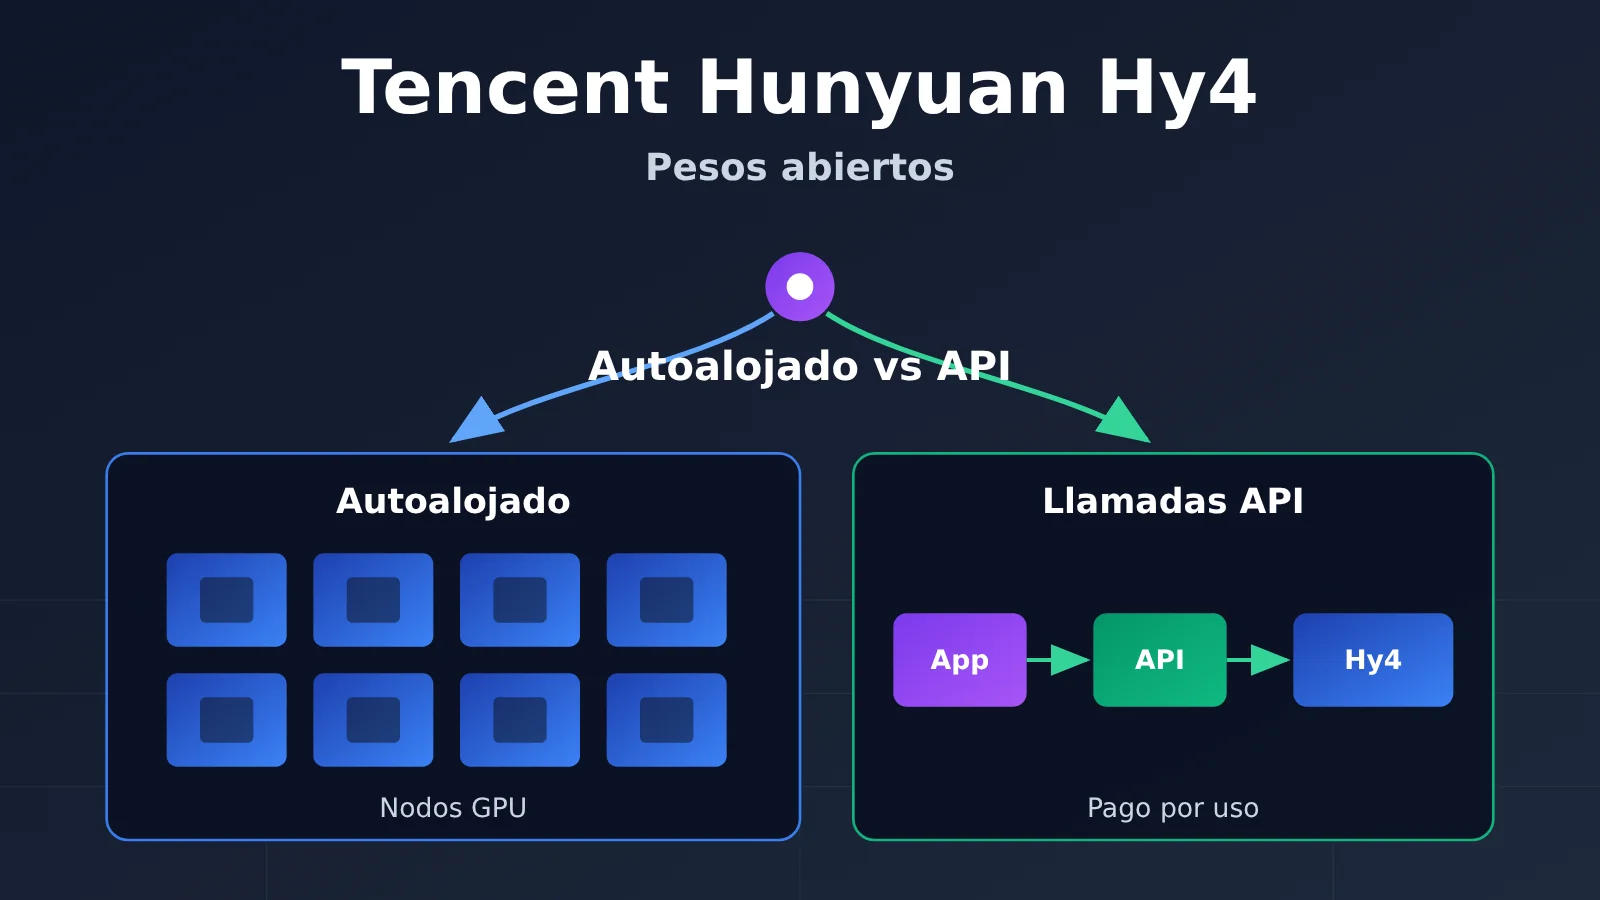
Conclusión primero: Si la normativa lo permite y tu necesidad inicial es probar tareas de solo texto, llamar directamente a la API es la opción con menor barrera de entrada. Solo vale la pena autodesplegar cuando necesitas un aislamiento de datos estricto o cuando de verdad quieres controlar tú mismo la configuración de inferencia. El punto de partida del autodespliegue no es bajo: las configuraciones de ejemplo en FP8 que proporciona el framework oficial de inferencia están en el nivel de 4 GPU B300/GB300 u 8 GPU H200/B200. Además, estos ejemplos no son el mínimo exigido en todas las configuraciones ni implican que se pueda aprovechar al máximo un contexto de 1M. Si los recursos de los que dispones no llegan a ese nivel, en lugar de forzarte con Hy4, conviene reevaluar un modelo más pequeño.
Mapa de conocimiento e índice de lectura para los pesos abiertos de Hy4
| N.º | Qué revisar primero | Por qué revisarlo primero | Qué obtienes al terminar |
|---|---|---|---|
| 1 | Versión y elección de pesos | Si eliges mal los pesos, toda la estimación de hardware posterior queda invalidada | Determinar si usarás Instruct BF16, Instruct FP8 o Base |
| 2 | Cuántas GPU se necesitan para el despliegue | El hardware es la mayor barrera del autodespliegue | Una tabla comparativa de hardware y una lista de verificación |
| 3 | Costo del mismo lote de tareas | Solo tiene sentido comparar con la misma calidad y latencia | El algoritmo de costo por tarea de la API y los componentes del costo del autodespliegue |
| 4 | Decisión | Aplicar las conclusiones de las tres secciones anteriores a tu escenario | Usar la API, validar el autodespliegue o cambiar a un modelo más pequeño |
1→2→3 es una relación progresiva: la versión determina los archivos de pesos, los archivos de pesos determinan el hardware y el hardware determina el costo. La sección 4 reúne los criterios de las tres secciones anteriores. Quienes solo se preocupan por el costo pueden empezar directamente por la sección 3.
Para entender: términos necesarios para leer sobre el despliegue de Hy4
| Término | Explicación breve |
|---|---|
| Pesos abiertos | Los archivos de parámetros del modelo se pueden descargar y desplegar por cuenta propia; las condiciones de uso están sujetas a la licencia |
| Instruct / Base | Instruct es la versión alineada con instrucciones y lista para conversar directamente; Base es la base preentrenada, adecuada para continuar entrenando |
| BF16 / FP8 | Precisión numérica de los parámetros. En FP8 cada parámetro ocupa aproximadamente 1 byte; en BF16, aproximadamente 2 bytes |
| TP (paralelismo de tensores) | Divide un modelo entre varias GPU para que calculen en colaboración; TP8 significa dividirlo en 8 partes |
| KV cache | Estado intermedio que se guarda durante la inferencia para el contexto; crece con la longitud del contexto y el número de peticiones concurrentes |
| Lectura de caché | Tokens de entrada que aciertan la caché de indicaciones en la facturación de la API; su precio unitario es inferior al de la entrada no cacheada |
1. Cómo elegir entre las versiones de Hy4 y los pesos abiertos
1.1 Los tres hitos temporales de Hy4
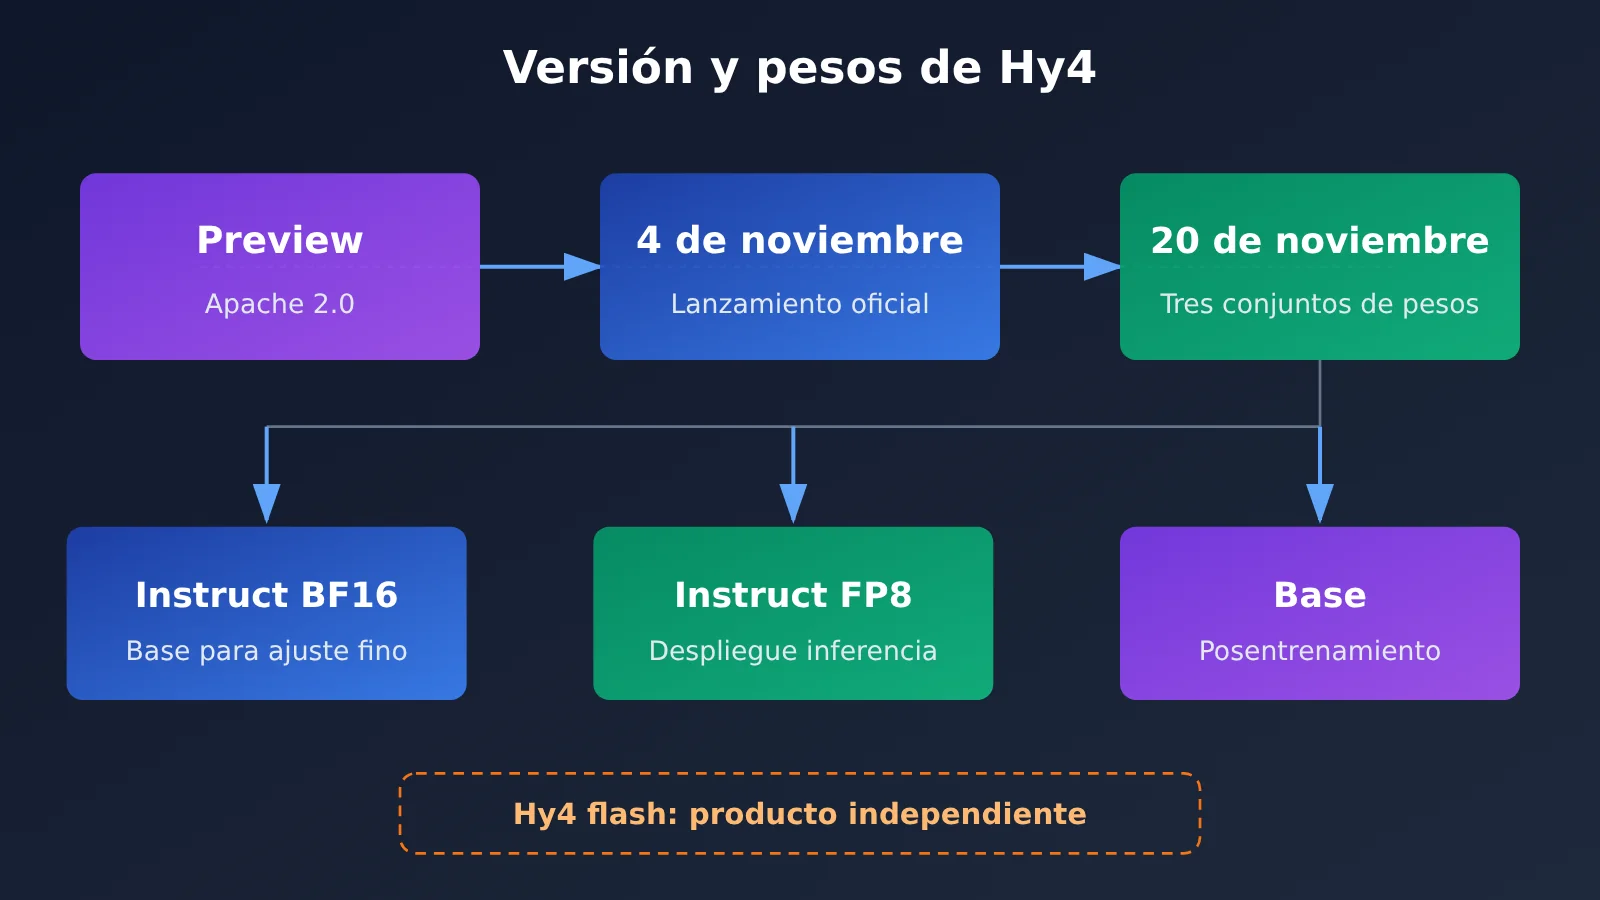
El proceso de publicación de Hy4 se divide en tres etapas. La primera en abrirse fue la versión Preview, publicada en la página tencent/Hy4-preview de Hugging Face, con licencia Apache 2.0. El 4 de noviembre de 2026, Tencent publicó un comunicado para anunciar el lanzamiento oficial de Hy4. El 20 de noviembre, los tres conjuntos de pesos de la versión oficial se hicieron públicos en Hugging Face.
Las diferencias entre estos tres hitos afectan directamente tu elección. La licencia de Preview y la de la versión oficial son distintas: la versión oficial usa Tencent Hy License 1.0, cuya sección 10 establece condiciones adicionales para algunos servicios de inferencia general ofrecidos a terceros. Si planeas desplegar Hy4 como servicio externo, pide a tu equipo legal que lo evalúe por su cuenta contrastándolo con el texto original de la licencia; este artículo no emite conclusiones legales sobre las prácticas de ninguna empresa concreta.
1.2 Condiciones de uso de los tres conjuntos de pesos oficiales de Hy4
| Repositorio de pesos | Contenido | Condiciones de uso |
|---|---|---|
tencent/Hy4 |
Instruct, BF16 | Requiere la máxima precisión numérica, o se usa como punto de partida para fine-tuning o cuantización; es el que exige más VRAM |
tencent/Hy4-FP8 |
Instruct, FP8 | Se usa directamente para el despliegue de inferencia; las configuraciones de ejemplo de SGLang y vLLM se basan en él |
tencent/Hy4-base |
Base preentrenado | Si quieres hacer tu propio entrenamiento posterior o continuar entrenando en un dominio; no es adecuado para conversar directamente |
Hay que distinguir especialmente un punto: la versión oficial de Hy4 no es lo mismo que Hy4 flash, que es una línea de producto independiente. El hardware y los costos que se analizan en este artículo corresponden solo a la versión oficial y no pueden aplicarse a flash.
2. ¿Cuántas GPU necesitas para desplegar Hy4 por tu cuenta?
2.1 Comparativa de configuraciones de ejemplo entre SGLang y vLLM
Los dos frameworks de inferencia más usados incluyen ejemplos de despliegue de Hy4. Aquí los ponemos uno al lado del otro:
| Framework | Pesos | Paralelización | GPU de ejemplo | Notas del ejemplo |
|---|---|---|---|---|
| SGLang | FP8 | TP4 | 4×B300 o 4×GB300 | El tamaño del pool de KV determina la capacidad de contexto realmente disponible |
| SGLang | FP8 | TP8 | 8×H200 o 8×B200 | Igual que arriba |
| vLLM | FP8 (por defecto) | TP8 | 8×B300 | La ventana de contexto del ejemplo es 131.072; solo admite una imagen y el vídeo está desactivado |
Al leer esta tabla hay tres cosas que conviene tener en cuenta:
- Son configuraciones de ejemplo, no mínimos. La documentación de SGLang indica que el pool de KV limita el contexto que realmente se puede alojar, y estas configuraciones tampoco representan el mínimo para cualquier combinación de parámetros.
- No hay garantía de llegar a 1M. La model card declara un contexto máximo de 1.048.576 tokens, pero la longitud disponible con una configuración de servicio concreta hay que calcularla aparte. El ejemplo de vLLM solo llega a 131.072, y ninguno de los dos documentos promete 1M plenamente usable.
- Las cifras de uno y otro no se pueden mezclar. La VRAM de referencia que da la documentación de vLLM solo aplica a esa configuración de vLLM.
2.2 La relación entre 770B, 49B y la VRAM
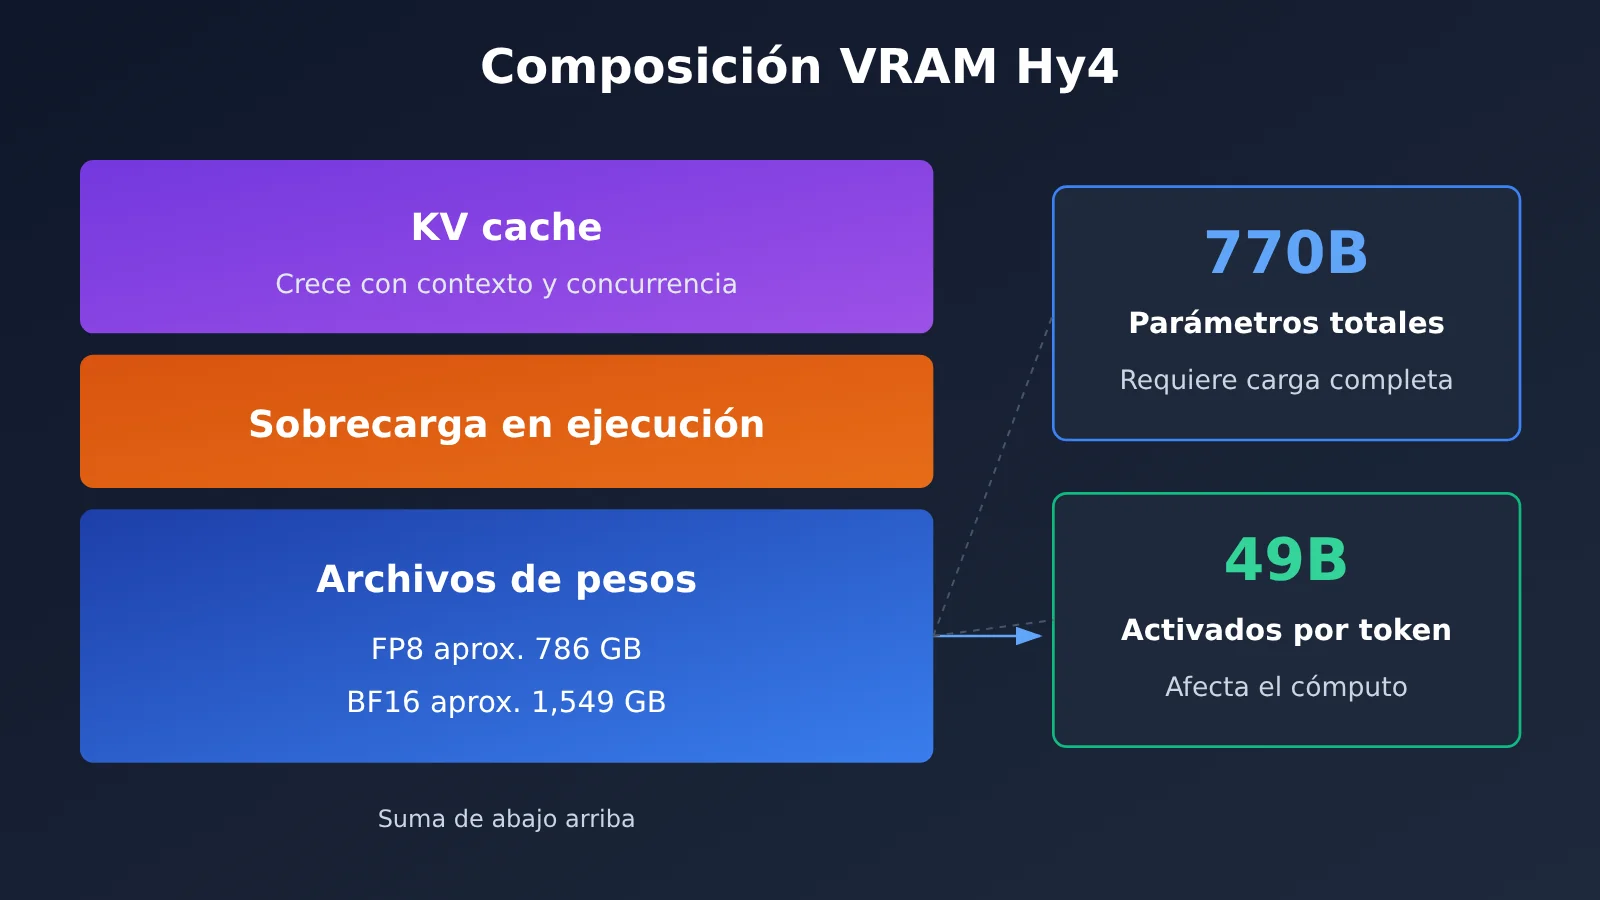
Cuando se habla de Hy4 suelen aparecer dos números: 770B es el total de parámetros del tronco de lenguaje, y 49B son los parámetros de texto que se activan por token. Mucha gente malinterpreta los 49B como si fueran el requisito de VRAM, y eso es un error. Los 49B determinan la cantidad de cómputo por token; para poder invocar cualquier experto en cualquier momento, los 770B parámetros completos tienen que estar cargados en la VRAM.
El requisito de VRAM se puede descomponer en tres capas:
- Tamaño del archivo de pesos: según la documentación de vLLM, unos 786 GB en FP8 y unos 1.549 GB en BF16. Esto, en primer lugar, es un problema de disco y de ancho de banda de carga.
- VRAM en tiempo de ejecución: la VRAM de referencia del ejemplo de vLLM ronda los 944 GB (FP8) y 1.859 GB (BF16), más que el archivo en sí, porque también incluye la sobrecarga del runtime y la reserva de KV cache.
- KV cache y concurrencia: cuanto más largo es el contexto y más peticiones se atienden a la vez, mayor es el consumo de KV cache. Esta parte determina, una vez que el hardware ya «alberga el modelo», cuánto tráfico se puede seguir sirviendo.
Antes del despliegue puedes repasar esta lista:
- [ ] Modelo, cantidad y VRAM por tarjeta de las GPU disponibles, y si pueden formar un TP4 o TP8
- [ ] Si la interconexión entre tarjetas cumple los requisitos de comunicación del paralelismo de tensores
- [ ] Si el almacenamiento local puede alojar unos 786 GB (FP8) o unos 1.549 GB (BF16) de pesos, y la velocidad de carga
- [ ] Longitud de contexto objetivo: ¿bastan 131K o hace falta algo más?
- [ ] Pico de concurrencia y si el pool de KV alcanza con esa concurrencia
- [ ] Si se necesita entrada visual (el ejemplo de vLLM solo habilita una imagen)
- [ ] Si la versión elegida del framework de inferencia coincide con el cookbook o la recipe oficiales
3. Calcular el costo de Hy4 con el mismo lote de tareas
3.1 Cómo se factura por consumo en la API
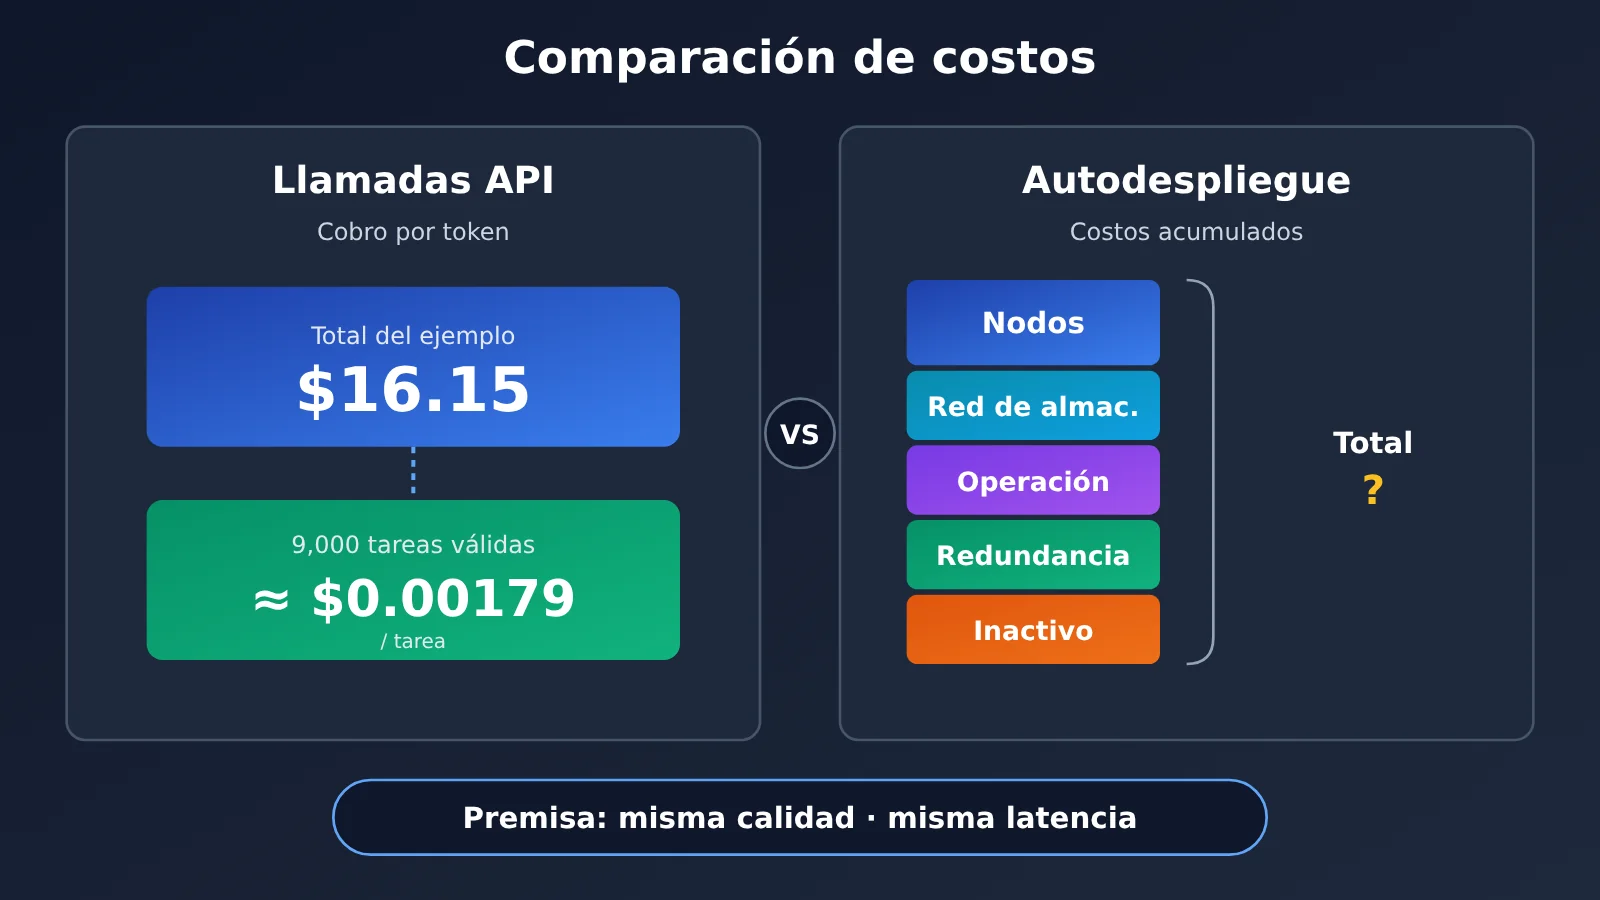
Tomemos como ejemplo la página del modelo en APIYI: al 21 de noviembre de 2026, el ID del modelo de la versión oficial de Hy4 es hy4, ofrece dos grupos, Default y SVIP, y utiliza la interfaz Chat Completions. El precio se calcula por millón de tokens: entrada sin caché $0.85, salida $2.55, lectura de caché $0.045; el cobro real es el que aparece en la consola. Cabe aclarar que APIYI publicó Hy4 antes de esta liberación de pesos; el anuncio menciona compatibilidad con visión, pero los cálculos de ejemplo de abajo solo asumen texto puro y no equiparan las capacidades de 1M de contexto, video o Computer Use que figuran en la ficha del modelo con el rendimiento medido del servicio gestionado.
Al facturar, los tres tipos de tokens se calculan por separado y no se duplican: un mismo token de entrada se cobra como entrada sin caché o como lectura de caché, nunca por ambos lados. El siguiente es un ejemplo hipotético, no una medición real:
| Concepto | Uso supuesto | Precio unitario (por millón) | Costo |
|---|---|---|---|
| Entrada sin caché | 10 millones de tokens | $0.85 | $8.50 |
| Salida | 3 millones de tokens | $2.55 | $7.65 |
| Lectura de caché | 0 | $0.045 | $0 |
| Total | — | — | $16.15 |
Supongamos que de este lote de invocaciones, 9,000 resultados pasaron tu validación; entonces el costo por tarea aprobada ronda los $16.15 ÷ 9,000 ≈ $0.00179. Conviene medir con el «costo por tarea aprobada» y no con el «costo por invocación», porque los reintentos fallidos y el retrabajo también deben entrar en la cuenta. Ese número hay que registrarlo junto con la latencia realmente observada y la concurrencia que puedes sostener; de lo contrario, no hay forma de compararlo con la opción de autodespliegue.
3.2 La verdadera estructura de costos del autodespliegue
El costo del autodespliegue va mucho más allá de la GPU en sí. La siguiente tabla enumera las partidas que deben incluirse:
| Partida de costo | Contenido |
|---|---|
| Nodos de cómputo | Costo de compra o alquiler de nodos GPU de gama alta con 4 u 8 tarjetas |
| Almacenamiento y red | Almacenamiento de pesos del orden de casi TB, ancho de banda de carga, interconexión entre tarjetas y entre nodos |
| Operación y mantenimiento | Personal necesario para actualizar el framework de inferencia, monitorear y alertar, y resolver fallos |
| Redundancia | Nodos de respaldo preparados para garantizar disponibilidad, que en tiempos normales pueden estar inactivos |
| Utilización | Costo de inactividad durante los valles de tráfico, que eleva directamente el precio unitario por tarea |
Al comparar las dos opciones, hay que hacerlo bajo la misma calidad y la misma latencia: con el mismo lote de tareas y el mismo conjunto de criterios de validación, calcula el costo por tarea aprobada en cada caso, con objetivos de latencia y concurrencia similares. Como los precios del hardware, la utilización y los costos de personal varían mucho de un equipo a otro, este artículo no ofrece una «línea de recuperación de la inversión» única. Tienes que calcularla con tus propias cotizaciones y tu curva de tráfico.
4. Decisión de despliegue de Hy4: API, autodespliegue o cambiar a un modelo más pequeño
Combinando las conclusiones de las tres secciones anteriores, podemos dividir la decisión en tres rutas según las condiciones:
- Cumplimiento normativo permitido + probar primero tareas de solo texto → tirar por la API. No hace falta preparar hardware: primero calcula con tareas reales el coste y la latencia por tarea válida, y usa esos números como línea base para las decisiones siguientes.
- Necesitas un aislamiento de datos fuerte, o de verdad quieres controlar tú la configuración de inferencia → inventariar hardware y validar con autodespliegue. Primero revisa los recursos con la lista de la sección 2.2, pon en marcha la configuración de ejemplo de SGLang o vLLM, y luego compara calidad, latencia y coste con el mismo conjunto de tareas que usaste en la API. Antes de abrir el servicio al exterior, pide a legal que revise la cláusula 10 de la licencia.
- Los recursos no llegan a la escala del ejemplo → replantea un modelo más pequeño. Cuando no se consiguen reunir 4 u 8 GPU de gama alta, forzar a la baja el contexto o la concurrencia probablemente no alcanzará los objetivos de calidad y latencia; cambiar a un modelo más pequeño suele ser lo más realista.
Tarjeta de acción
- Elige los pesos: para el despliegue de inferencia usa
Hy4-FP8; si necesitas seguir entrenando, usaHy4-base; y confirma que no estás usando flash. - Prepara entre 200 y 500 tareas reales y define bien los criterios de aceptación.
- Si los datos se pueden enviar fuera, primero pásalos por la API; si no, empieza con muestras públicas o sintéticas y deja los datos reales en el entorno interno. Registra el consumo de tokens, la tasa de aprobación, la latencia y el comportamiento en concurrencia.
- Si necesitas autodespliegue, inventaría el hardware según la lista y vuelve a medir con el mismo lote de tareas.
- Toma la decisión final con un único criterio: «coste por tarea válida + latencia».
Referencias
- Anuncio oficial del lanzamiento de Tencent Hy4: https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/
- Pesos de Hy4 Instruct (BF16): https://huggingface.co/tencent/Hy4
- Pesos de Hy4 Instruct (FP8): https://huggingface.co/tencent/Hy4-FP8
- Pesos de Hy4 Base: https://huggingface.co/tencent/Hy4-base
- Licencia Tencent Hy 1.0: https://huggingface.co/tencent/Hy4/blob/main/LICENSE
- Hy4 Preview (Apache 2.0): https://huggingface.co/tencent/Hy4-preview
- Cookbook de SGLang para Hy4: https://docs.sglang.io/cookbook/autoregressive/Tencent/Hy4
- Receta de vLLM para Hy4: https://recipes.vllm.ai/tencent/Hy4
- Nota de lanzamiento de Hy4 en APIYI: https://docs.apiyi.com/news/hy4-launch
- Lista de modelos de APIYI (Tencent): https://docs.apiyi.com/models#腾讯
- Resumen de contexto de Hy4 (instantánea histórica; la información sobre pesos y disponibilidad se rige por este artículo): https://help.apiyi.com/tencent-hy4-770b-vision-computer-use-pricing.html