摘要:Hy4 正式版權重已經公開,本文幫你判斷該用哪套權重、自己部署需要什麼量級的 GPU,以及怎樣和直接調用 API 的成本做公平比較。
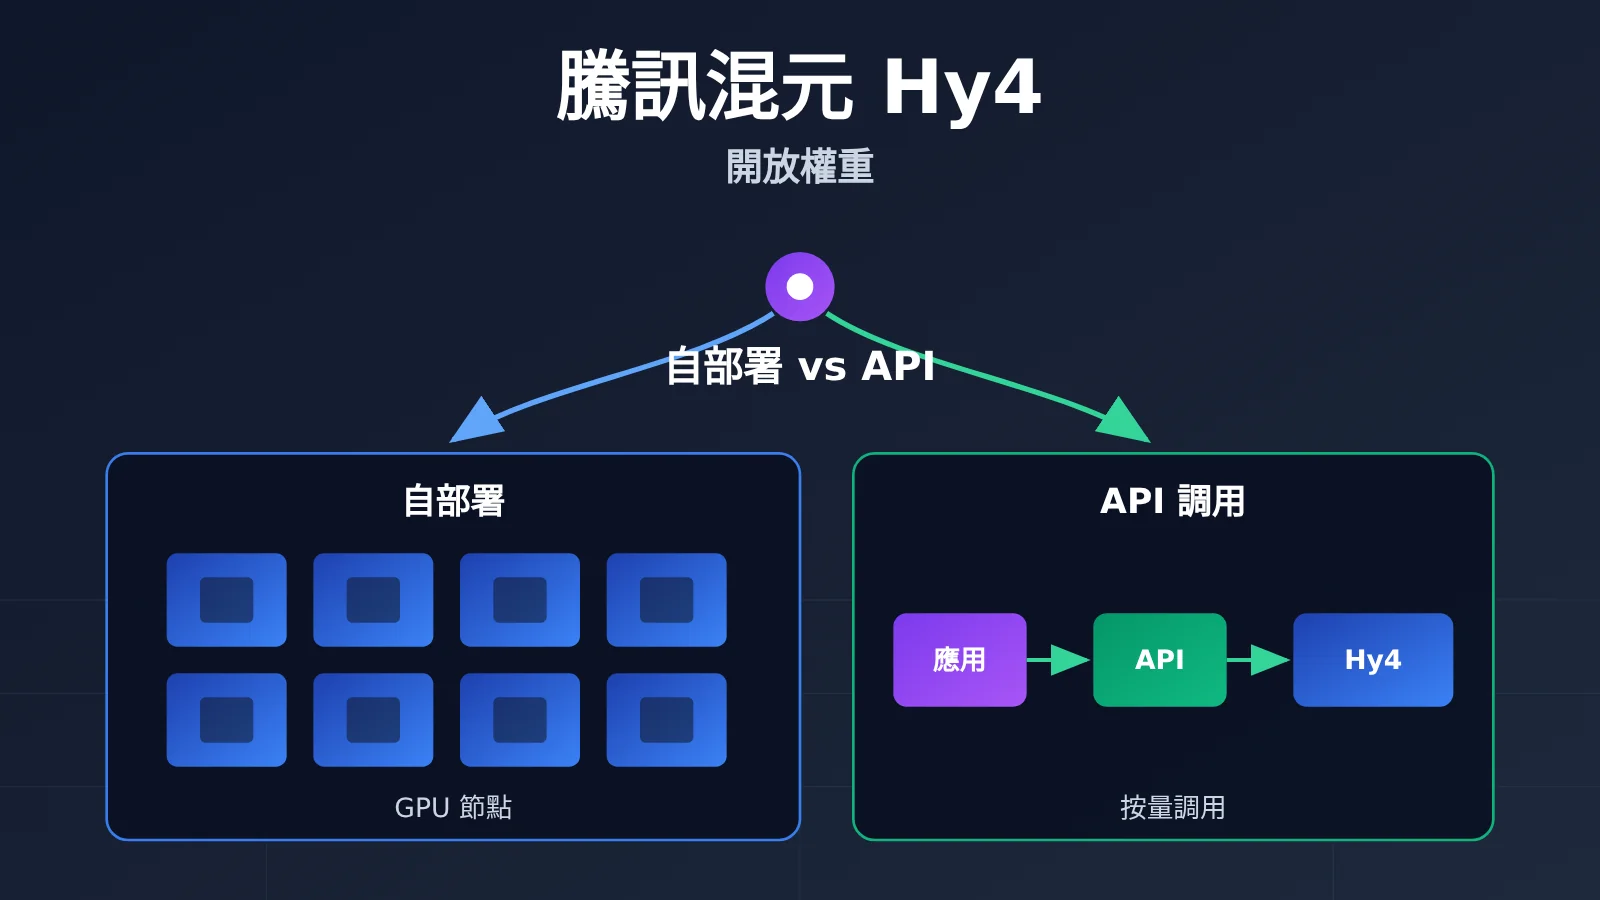
結論先行:如果合規允許,並且你的需求是先試純文本任務,直接調用 API 的門檻最低。只有在需要強數據隔離,或者確實要自己控制推理配置時,才值得自部署。自部署的起點不低:官方推理框架給出的 FP8 示例配置是 4 張 B300/GB300 或 8 張 H200/B200 這一級別。另外,這些示例不是所有配置下的最低門檻,也不代表能跑滿 1M 上下文。如果手頭資源達不到,與其硬上 Hy4,不如重新評估更小的模型。
Hy4 開放權重知識地圖與閱讀索引
| 編號 | 先看什麼 | 爲什麼先看 | 看完得到什麼 |
|---|---|---|---|
| 1 | 版本與權重選擇 | 權重選錯,後面的硬件估算就全部作廢 | 確定用 Instruct BF16、Instruct FP8 還是 Base |
| 2 | 部署要幾張卡 | 硬件是自部署的最大門檻 | 一張硬件對照表和一份盤點清單 |
| 3 | 同一批任務的成本 | 只有在同質量、同延遲下比較纔有意義 | API 單任務成本算法,以及自部署成本的構成項 |
| 4 | 決策 | 把前三節的結論落到你的場景 | 走 API、自部署驗證,還是換用小模型 |
1→2→3 是遞進關係:版本決定權重文件,權重文件決定硬件,硬件決定成本。第 4 節彙總前三節的判斷。只關心成本的讀者可以直接從第 3 節讀起。
To Know:讀懂 Hy4 部署需要的術語
| 術語 | 簡明解釋 |
|---|---|
| 開放權重 | 模型參數文件可以下載並自行部署,使用條件由許可證約束 |
| Instruct / Base | Instruct 是經過指令對齊、可以直接對話的版本;Base 是預訓練底座,適合繼續訓練 |
| BF16 / FP8 | 參數的數值精度。FP8 每個參數約佔 1 字節,BF16 約佔 2 字節 |
| TP(張量並行) | 把一個模型切分到多張 GPU 上協同計算,TP8 表示切成 8 份 |
| KV cache | 推理時爲上下文保存的中間狀態,隨上下文長度和併發數增長 |
| 緩存讀 | API 計費中命中提示緩存的輸入 token,單價低於未緩存輸入 |
1. Hy4 版本與開放權重怎麼選
1.1 Hy4 的三個時間節點
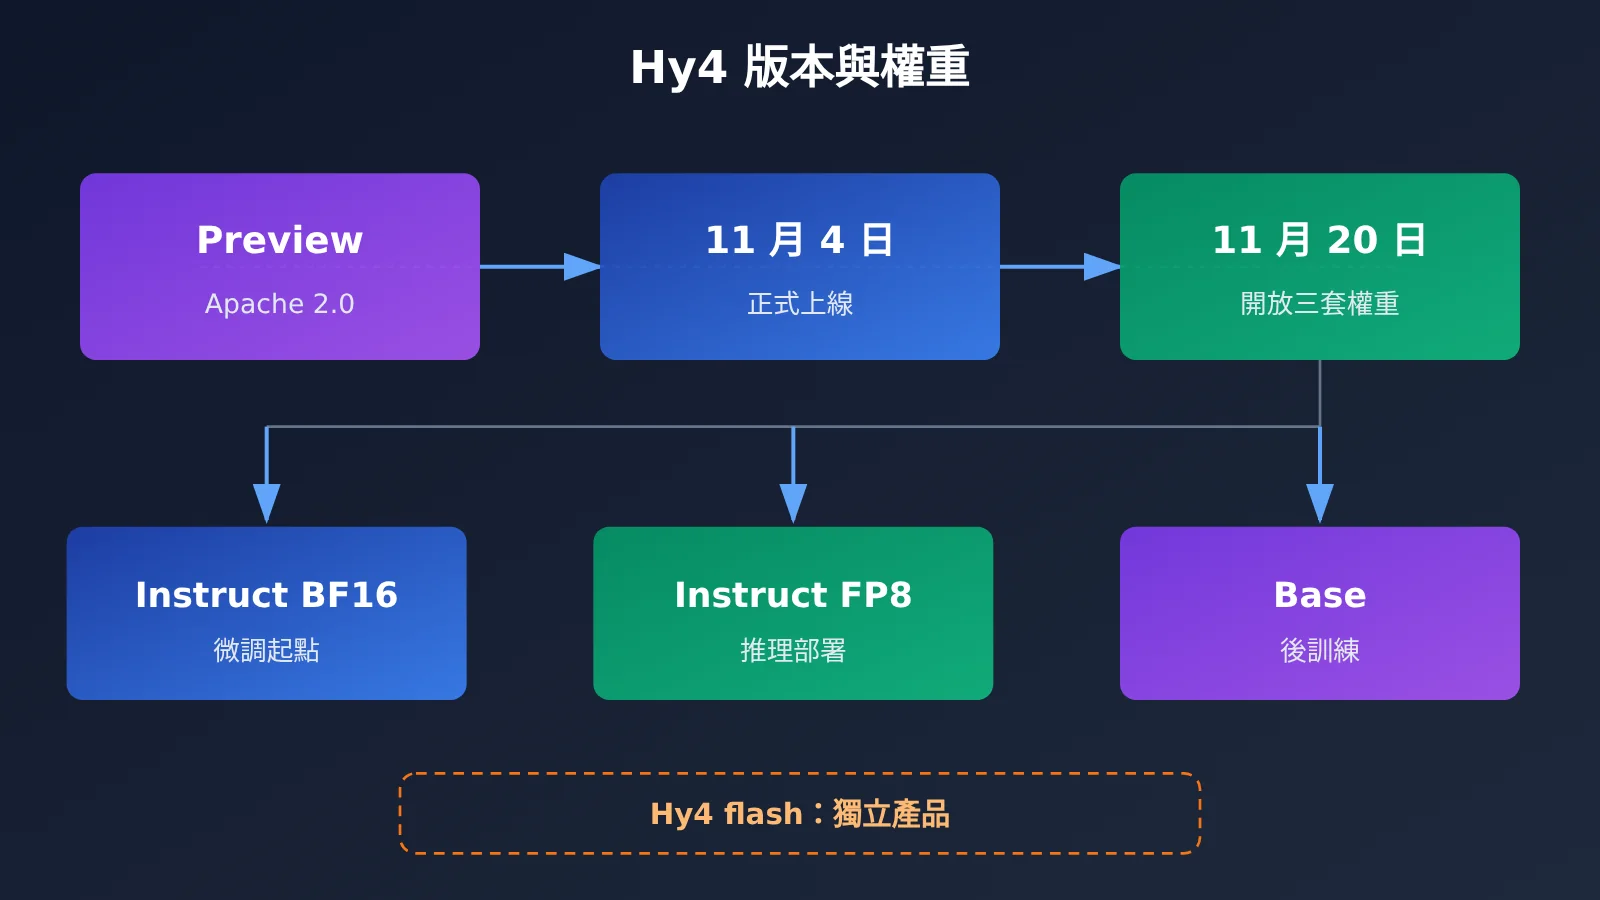
Hy4 的公開過程分三步。最早開放的是 Preview 版本,它在 Hugging Face 的 tencent/Hy4-preview 頁面發佈,許可證爲 Apache 2.0。2026 年 11 月 4 日,騰訊發佈公告,宣佈 Hy4 正式上線。11 月 20 日,正式版的三套權重在 Hugging Face 公開。
這三個節點的差別直接影響你的選擇。Preview 與正式版的許可證不同:正式版採用 Tencent Hy License 1.0,其中第 10 節針對部分對外提供的通用推理服務設置了附加條件。如果你打算把 Hy4 部署成對外服務,請讓法務團隊對照許可證原文自行判斷,本文不對任何具體企業的做法給出法律結論。
1.2 Hy4 三套正式權重的適用條件
| 權重倉庫 | 內容 | 適用條件 |
|---|---|---|
tencent/Hy4 |
Instruct,BF16 | 需要最高數值精度,或用作微調、量化的起點;對顯存要求最高 |
tencent/Hy4-FP8 |
Instruct,FP8 | 直接用於推理部署;SGLang 和 vLLM 的示例配置都基於它 |
tencent/Hy4-base |
預訓練 Base | 要自己做後訓練、領域繼續訓練;不適合直接拿來對話 |
需要特別區分的是:Hy4 正式版不等於 Hy4 flash,後者是獨立的產品線。本文討論的硬件和成本都只針對正式版,不能套用到 flash 上。
2. 自己部署 Hy4 要幾張卡
2.1 SGLang 與 vLLM 示例配置對照
兩大主流推理框架都給出了 Hy4 的部署示例。下面把它們並排列出:
| 框架 | 權重 | 並行方式 | 示例 GPU | 示例說明 |
|---|---|---|---|---|
| SGLang | FP8 | TP4 | 4×B300 或 4×GB300 | KV 池大小決定實際可用的上下文容量 |
| SGLang | FP8 | TP8 | 8×H200 或 8×B200 | 同上 |
| vLLM | FP8(默認) | TP8 | 8×B300 | 示例上下文窗口爲 131,072;只支持單圖,視頻關閉 |
閱讀這張表時要注意三點:
- 這些是示例配置,不是最低配置。SGLang 文檔說明,KV 池限制了實際能容納的上下文,這些配置也不代表任何參數組合下的最低門檻。
- 不能保證跑滿 1M。模型卡聲明的最大上下文是 1,048,576 token,但具體服務配置下的可用長度需要另算。vLLM 的示例只開到 131,072,兩份文檔都沒有承諾滿 1M 可用。
- 兩家的數字不能互相套用。vLLM 文檔給出的參考顯存,只適用於 vLLM 的這套配置。
2.2 770B、49B 與顯存的關係
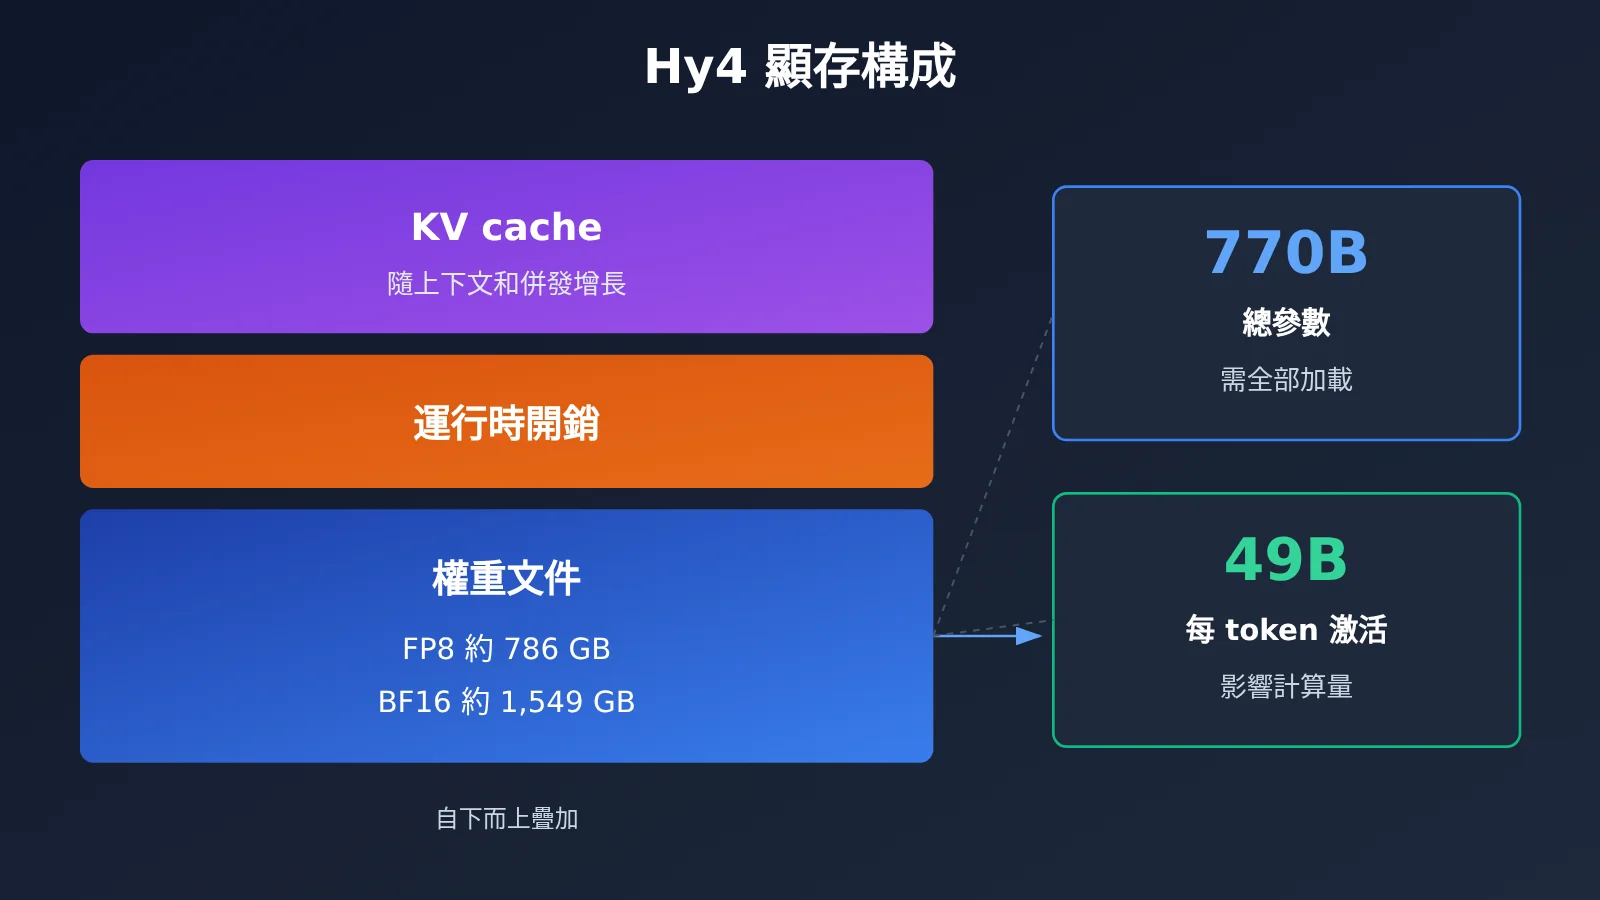
Hy4 常被提到兩個數字:770B 是語言主幹的總參數量,49B 是每個 token 激活的文本參數量。很多人會把 49B 誤讀成顯存需求,這是錯誤的。49B 決定的是每個 token 的計算量;爲了隨時調用任意專家,全部 770B 參數都必須加載進顯存。
顯存需求要拆成三層來看:
- 權重文件大小:按 vLLM 文檔,FP8 約 786 GB,BF16 約 1,549 GB。這首先是磁盤和加載帶寬的問題。
- 運行時顯存:vLLM 示例的參考顯存約爲 944 GB(FP8)和 1,859 GB(BF16),比文件本身大,因爲還包括運行時開銷和 KV cache 預留。
- KV cache 與併發:上下文越長、同時服務的請求越多,KV cache 佔用越大。這部分決定了同一套硬件“能裝下模型”之後還能服務多少流量。
部署前可以按下面的清單盤點:
- [ ] 可用 GPU 的型號、數量和單卡顯存,能否組成 TP4 或 TP8
- [ ] 卡間互聯是否滿足張量並行的通信要求
- [ ] 本地存儲能否容納約 786 GB(FP8)或約 1,549 GB(BF16)的權重,以及加載速度
- [ ] 目標上下文長度:131K 夠用,還是必須更長
- [ ] 峯值併發數,以及在該併發下 KV 池是否夠用
- [ ] 是否需要視覺輸入(vLLM 示例只開了單圖)
- [ ] 選定的推理框架版本,是否與官方 cookbook 或 recipe 一致
3. 用同一批任務算 Hy4 的成本
3.1 API 按量計費的算法
以 API易 的模型頁爲例:截至 2026 年 11 月 21 日,Hy4 正式版的模型 ID 爲 hy4,提供 Default 和 SVIP 兩個分組,採用 Chat Completions 接口。標價按每百萬 token 計算:未緩存輸入 $0.85,輸出 $2.55,緩存讀 $0.045,實際扣費以控制檯爲準。需要說明的是,API易 上架 Hy4 的時間早於本次權重開放;公告提到支持視覺,但下面的算例只按純文本假設計算,不把模型卡上的 1M 上下文、視頻或 Computer Use 能力等同於託管服務的實測表現。
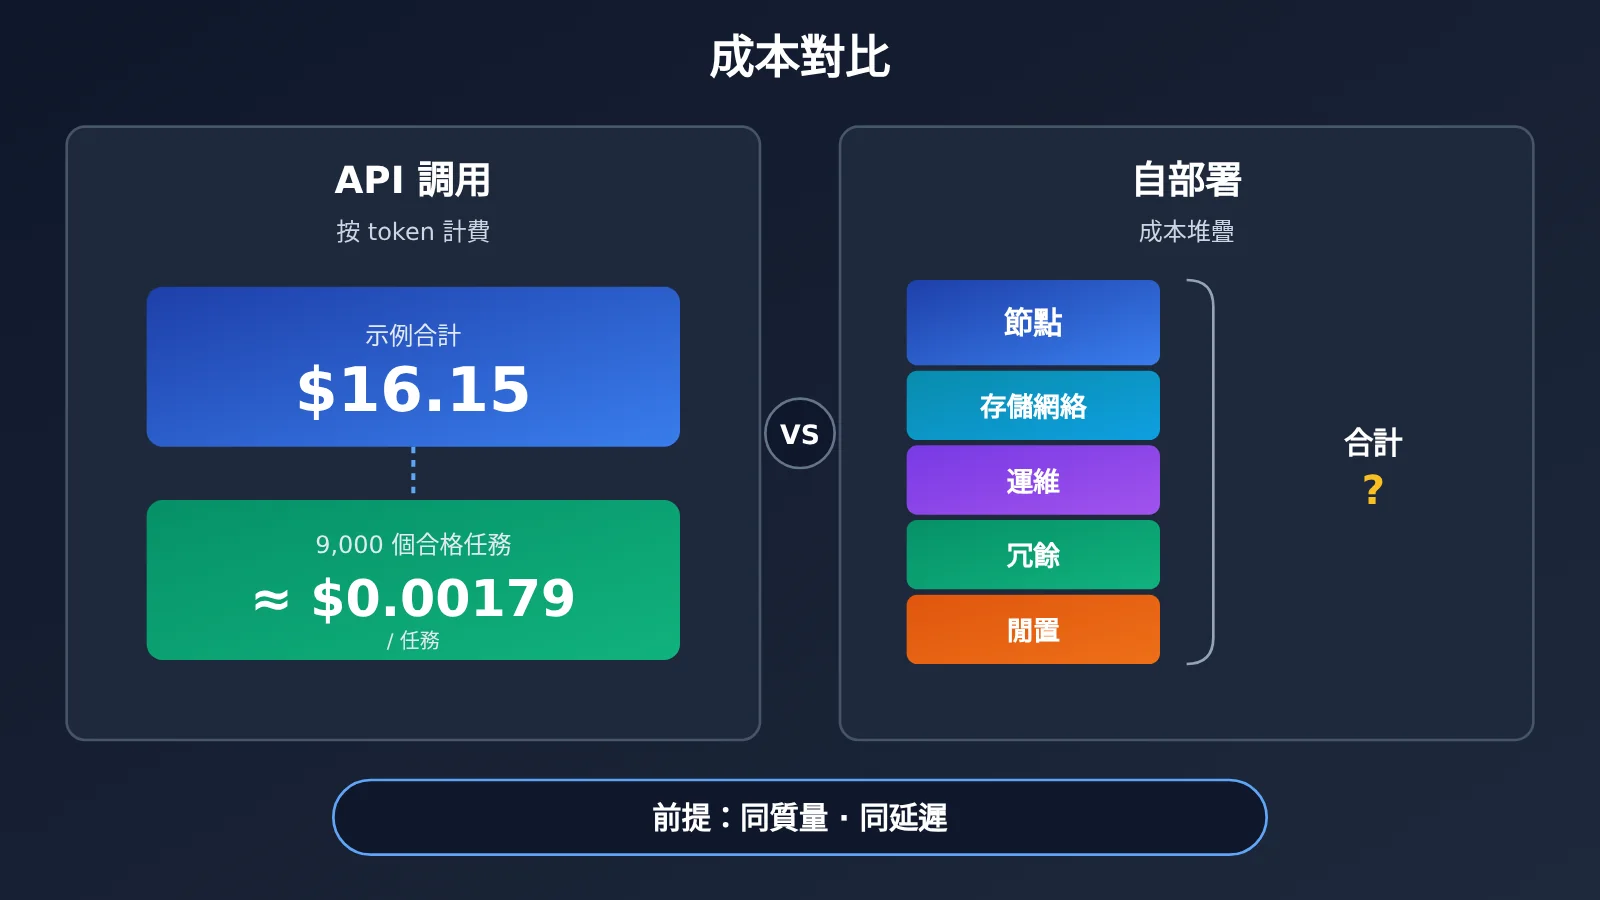
計費時,三類 token 各算各的、互不重複:同一個輸入 token 要麼按未緩存輸入計,要麼按緩存讀計,不會兩邊都收。下面是一個假設算例,並非實測:
| 項目 | 假設用量 | 單價(每百萬) | 費用 |
|---|---|---|---|
| 未緩存輸入 | 1,000 萬 token | $0.85 | $8.50 |
| 輸出 | 300 萬 token | $2.55 | $7.65 |
| 緩存讀 | 0 | $0.045 | $0 |
| 合計 | — | — | $16.15 |
假設這批調用中有 9,000 次結果通過了你的驗收,那麼每個合格任務的成本約爲 $16.15 ÷ 9,000 ≈ $0.00179。建議用“每個合格任務的成本”而不是“每次調用的成本”來衡量,因爲失敗重試、返工的費用都應該算進去。這個數字還要和實際觀測到的延遲、能承受的併發一起記錄,否則無法和自部署方案對比。
3.2 自部署的真實成本構成
自部署的成本遠不止 GPU 本身。下表列出需要計入的各項:
| 成本項 | 內容 |
|---|---|
| 計算節點 | 4 卡或 8 卡高端 GPU 節點的購置或租用費用 |
| 存儲與網絡 | 近 TB 級的權重存儲、加載帶寬、卡間和節點間互聯 |
| 運維 | 推理框架升級、監控告警、故障處理所需的人力 |
| 冗餘 | 爲保障可用性準備的備用節點,平時可能處於閒置狀態 |
| 利用率 | 流量低谷期的閒置成本,它會直接拉高每個任務的單價 |
比較兩種方案時,要在同等質量和同等延遲的前提下進行:用同一批任務、同一套驗收標準,在相近的延遲和併發目標下,分別算出每個合格任務的成本。由於硬件價格、利用率和人力成本因團隊差異很大,本文不給出統一的“回本線”。你需要用自己的報價和流量曲線來算。
4. Hy4 部署決策:API、自部署還是換小模型
把前三節的結論合起來,可以按條件分成三條路徑:
- 合規允許 + 先試純文本任務 → 走 API。不用準備硬件,先用真實任務算出每個合格任務的成本和延遲,作爲後續決策的基線。
- 需要強數據隔離,或確需自己控制推理配置 → 盤點硬件後自部署驗證。先對照第 2.2 節的清單盤點資源,按 SGLang 或 vLLM 的示例配置跑通,再用和 API 相同的任務集比較質量、延遲和成本。對外提供服務前,先請法務覈對許可證第 10 節。
- 資源達不到示例量級 → 重新評估更小的模型。湊不齊 4 張或 8 張高端 GPU 時,強行壓縮上下文或併發很可能達不到質量和延遲目標,換用更小的模型往往更現實。
行動卡
- 選定權重:推理部署用
Hy4-FP8,需要繼續訓練用Hy4-base,並確認用的不是 flash。 - 準備 200~500 條真實任務,寫好驗收標準。
- 如數據允許外發,先用 API 跑一遍;否則先用公開或合成樣本測試,真實數據留在內部環境。記錄 token 用量、合格率、延遲和並發表現。
- 如需自部署,按清單盤點硬件,用同一批任務複測。
- 用“每個合格任務的成本 + 延遲”這一個口徑做最終決定。
參考資料
- 騰訊 Hy4 正式上線公告: https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/
- Hy4 Instruct(BF16)權重: https://huggingface.co/tencent/Hy4
- Hy4 Instruct(FP8)權重: https://huggingface.co/tencent/Hy4-FP8
- Hy4 Base 權重: https://huggingface.co/tencent/Hy4-base
- Tencent Hy License 1.0: https://huggingface.co/tencent/Hy4/blob/main/LICENSE
- Hy4 Preview(Apache 2.0): https://huggingface.co/tencent/Hy4-preview
- SGLang Hy4 Cookbook: https://docs.sglang.io/cookbook/autoregressive/Tencent/Hy4
- vLLM Hy4 Recipe: https://recipes.vllm.ai/tencent/Hy4
- API易 Hy4 上線說明: https://docs.apiyi.com/news/hy4-launch
- API易 模型列表(騰訊): https://docs.apiyi.com/models#騰訊
- Hy4 背景綜述(歷史快照,權重與上架信息以本文爲準): https://help.apiyi.com/tencent-hy4-770b-vision-computer-use-pricing.html