En résumé : les poids officiels de Hy4 sont désormais publics. Cet article vous aide à déterminer quel jeu de poids utiliser, quelle puissance de GPU est nécessaire pour un déploiement autonome, et comment comparer équitablement le coût avec un appel direct à l’API.
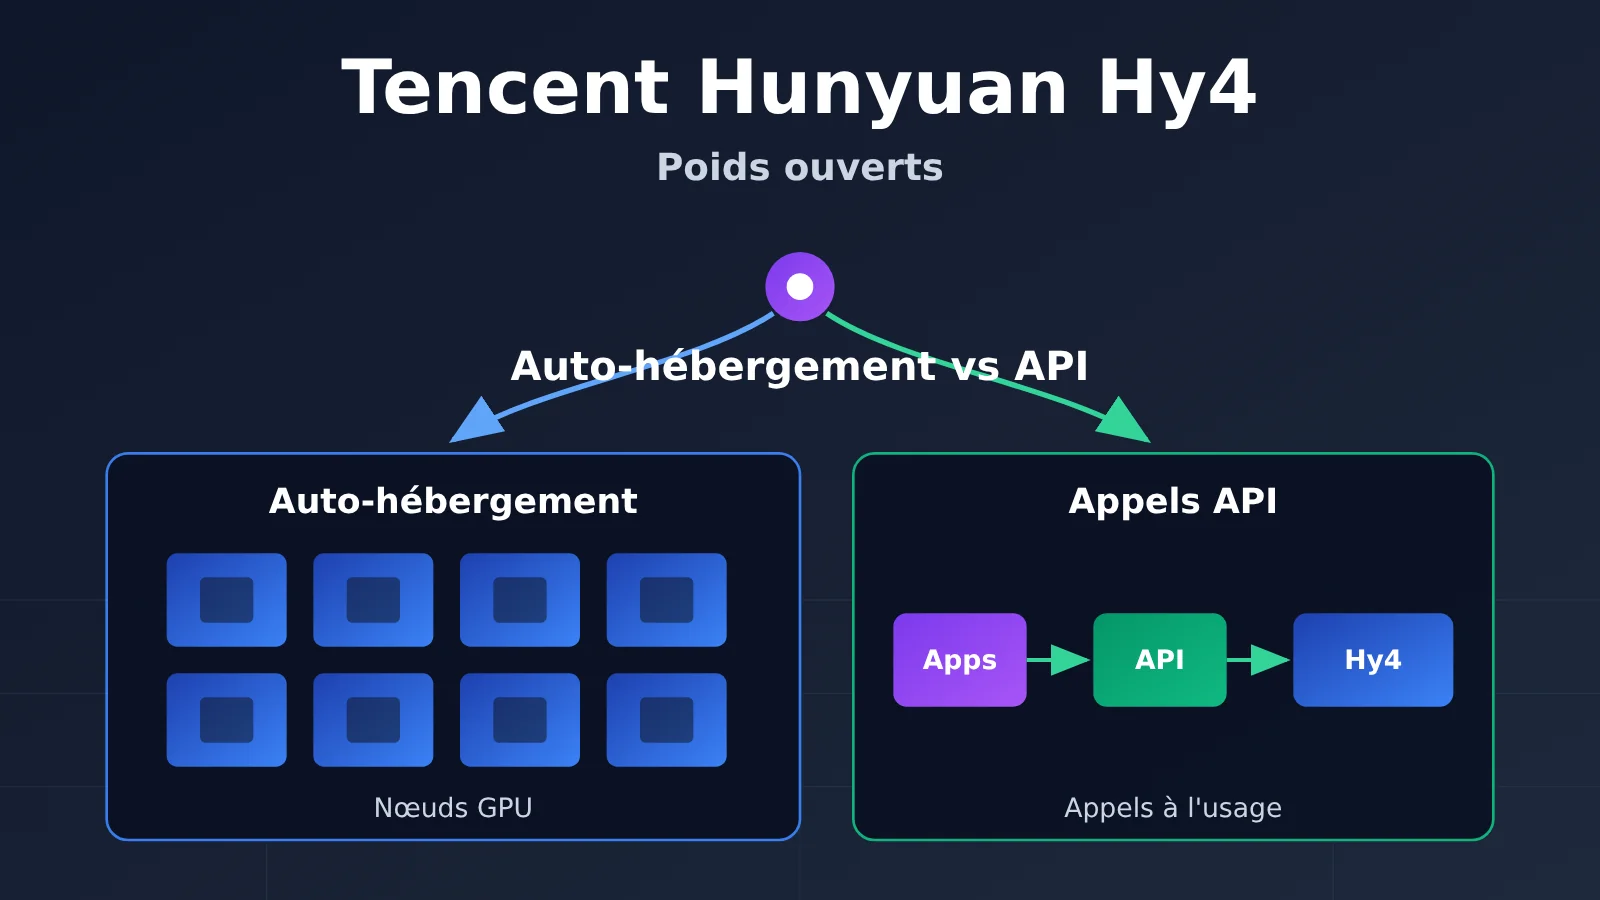
L’essentiel d’abord : si la conformité le permet et que votre besoin est d’abord de tester des tâches purement textuelles, l’appel direct à l’API est la solution la moins exigeante. L’auto-hébergement ne vaut vraiment le coup que si vous avez besoin d’une isolation forte des données ou si vous voulez réellement maîtriser la configuration d’inférence. Le point de départ de l’auto-hébergement n’est pas anodin : la configuration FP8 donnée en exemple par le framework d’inférence officiel est de l’ordre de 4 cartes B300/GB300 ou 8 cartes H200/B200. Par ailleurs, ces exemples ne correspondent pas au seuil minimal dans toutes les configurations et ne signifient pas non plus que vous pourrez exploiter pleinement un contexte de 1M. Si vos ressources disponibles n’atteignent pas ce niveau, plutôt que de forcer avec Hy4, mieux vaut réévaluer un modèle plus petit.
Carte des connaissances et index de lecture sur les poids ouverts de Hy4
| Numéro | Quoi regarder en premier | Pourquoi commencer par là | Ce que vous en retirez |
|---|---|---|---|
| 1 | Version et choix des poids | Un mauvais choix de poids rend caduques toutes les estimations matérielles qui suivent | Déterminer si vous utilisez Instruct BF16, Instruct FP8 ou Base |
| 2 | Combien de cartes pour le déploiement | Le matériel est le principal frein à l’auto-hébergement | Un tableau comparatif du matériel et une checklist d’inventaire |
| 3 | Le coût d’un même ensemble de tâches | Une comparaison n’a de sens qu’à qualité et latence égales | La méthode de calcul du coût par tâche via API, ainsi que les postes de coût de l’auto-hébergement |
| 4 | Décision | Appliquer les conclusions des trois premières sections à votre scénario | Passer par l’API, valider en auto-hébergement ou opter pour un modèle plus petit |
La séquence 1→2→3 est progressive : la version détermine les fichiers de poids, les fichiers de poids déterminent le matériel, et le matériel détermine le coût. La section 4 récapitule les jugements des trois sections précédentes. Les lecteurs qui ne s’intéressent qu’au coût peuvent commencer directement par la section 3.
À savoir : les termes à comprendre pour le déploiement de Hy4
| Terme | Explication concise |
|---|---|
| Poids ouverts | Les fichiers de paramètres du modèle peuvent être téléchargés et déployés par vous-même, les conditions d’utilisation étant encadrées par la licence |
| Instruct / Base | Instruct est la version alignée sur les instructions, directement utilisable en conversation ; Base est la base pré-entraînée, adaptée à la poursuite de l’entraînement |
| BF16 / FP8 | Précision numérique des paramètres. En FP8, chaque paramètre occupe environ 1 octet ; en BF16, environ 2 octets |
| TP (parallélisme tensoriel) | Répartir un modèle sur plusieurs GPU pour un calcul collaboratif ; TP8 signifie un découpage en 8 parties |
| KV cache | État intermédiaire conservé pour le contexte lors de l’inférence, qui augmente avec la longueur du contexte et le nombre de requêtes simultanées |
| Lecture du cache | Dans la facturation API, les tokens d’entrée qui touchent le cache d’invite, dont le prix unitaire est inférieur à celui des entrées non mises en cache |
1. Comment choisir entre les versions Hy4 et les poids ouverts
1.1 Les trois dates clés de Hy4
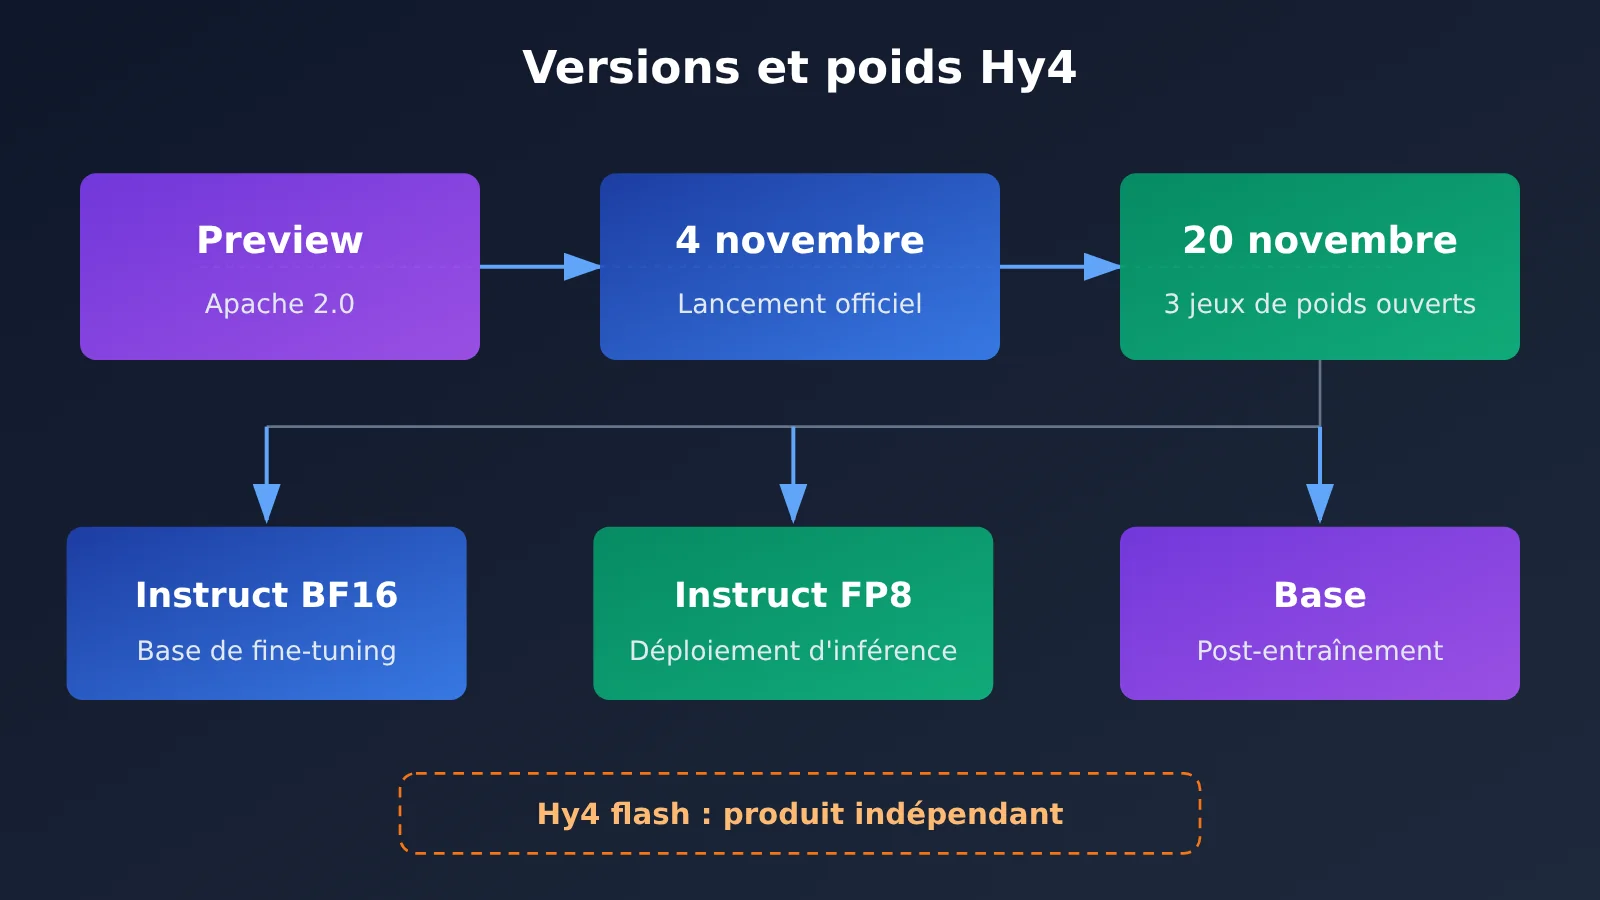
La publication de Hy4 s’est déroulée en trois étapes. La première version rendue publique a été la Preview, publiée sur la page tencent/Hy4-preview de Hugging Face sous licence Apache 2.0. Le 4 novembre 2026, Tencent a publié une annonce officialisant le lancement de Hy4. Le 20 novembre, les trois ensembles de poids de la version officielle ont été rendus publics sur Hugging Face.
Les différences entre ces trois dates ont une incidence directe sur votre choix. Les licences de la Preview et de la version officielle ne sont pas les mêmes : la version officielle utilise la Tencent Hy License 1.0, dont la section 10 prévoit des conditions supplémentaires pour certains services d’inférence générique fournis à des tiers. Si vous envisagez de déployer Hy4 comme service destiné à des tiers, demandez à votre équipe juridique d’évaluer la situation par elle-même à partir du texte original de la licence. Cet article ne formule aucune conclusion juridique sur les pratiques d’une entreprise en particulier.
1.2 Conditions d’utilisation des trois ensembles de poids officiels de Hy4
| Dépôt de poids | Contenu | Conditions d’utilisation |
|---|---|---|
tencent/Hy4 |
Instruct, BF16 | Nécessite la plus haute précision numérique, ou sert de point de départ pour le fine-tuning ou la quantification ; c’est l’option la plus gourmande en mémoire GPU |
tencent/Hy4-FP8 |
Instruct, FP8 | À utiliser directement pour le déploiement d’inférence ; les exemples de configuration de SGLang et vLLM s’appuient dessus |
tencent/Hy4-base |
Base pré-entraîné | Pour effectuer soi-même le post-entraînement ou poursuivre l’entraînement sur un domaine ; ne convient pas à un usage conversationnel direct |
Il faut faire attention à une distinction importante : la version officielle de Hy4 n’est pas Hy4 flash, qui appartient à une gamme de produits distincte. Le matériel et les coûts évoqués dans cet article ne concernent que la version officielle et ne s’appliquent pas à flash.
2. Combien de GPU faut-il pour déployer Hy4 soi-même
2.1 Comparaison des exemples de configuration SGLang et vLLM
Les deux principaux frameworks d’inférence proposent tous deux un exemple de déploiement pour Hy4. Voici les deux côte à côte :
| Framework | Poids | Mode de parallélisme | GPU d’exemple | Remarque sur l’exemple |
|---|---|---|---|---|
| SGLang | FP8 | TP4 | 4×B300 ou 4×GB300 | La taille du pool KV détermine la capacité de contexte réellement disponible |
| SGLang | FP8 | TP8 | 8×H200 ou 8×B200 | Idem |
| vLLM | FP8 (par défaut) | TP8 | 8×B300 | Fenêtre de contexte de l’exemple : 131 072 ; une seule image prise en charge, vidéo désactivée |
Trois points à garder en tête en lisant ce tableau :
- Ce sont des configurations d’exemple, pas des minimums. La documentation SGLang précise que le pool KV limite le contexte réellement absorbable, et ces configurations ne constituent en rien un seuil minimal pour n’importe quelle combinaison de paramètres.
- Rien ne garantit de tenir le 1M. La fiche du modèle annonce une fenêtre de contexte maximale de 1 048 576 tokens, mais la longueur utilisable dépend de la configuration de service retenue. L’exemple vLLM ne monte qu’à 131 072, et aucune des deux documentations ne promet un 1M pleinement exploitable.
- Les chiffres des deux camps ne se transposent pas. La mémoire GPU de référence donnée par la documentation vLLM ne vaut que pour cette configuration vLLM précise.
2.2 Le rapport entre 770B, 49B et la mémoire GPU
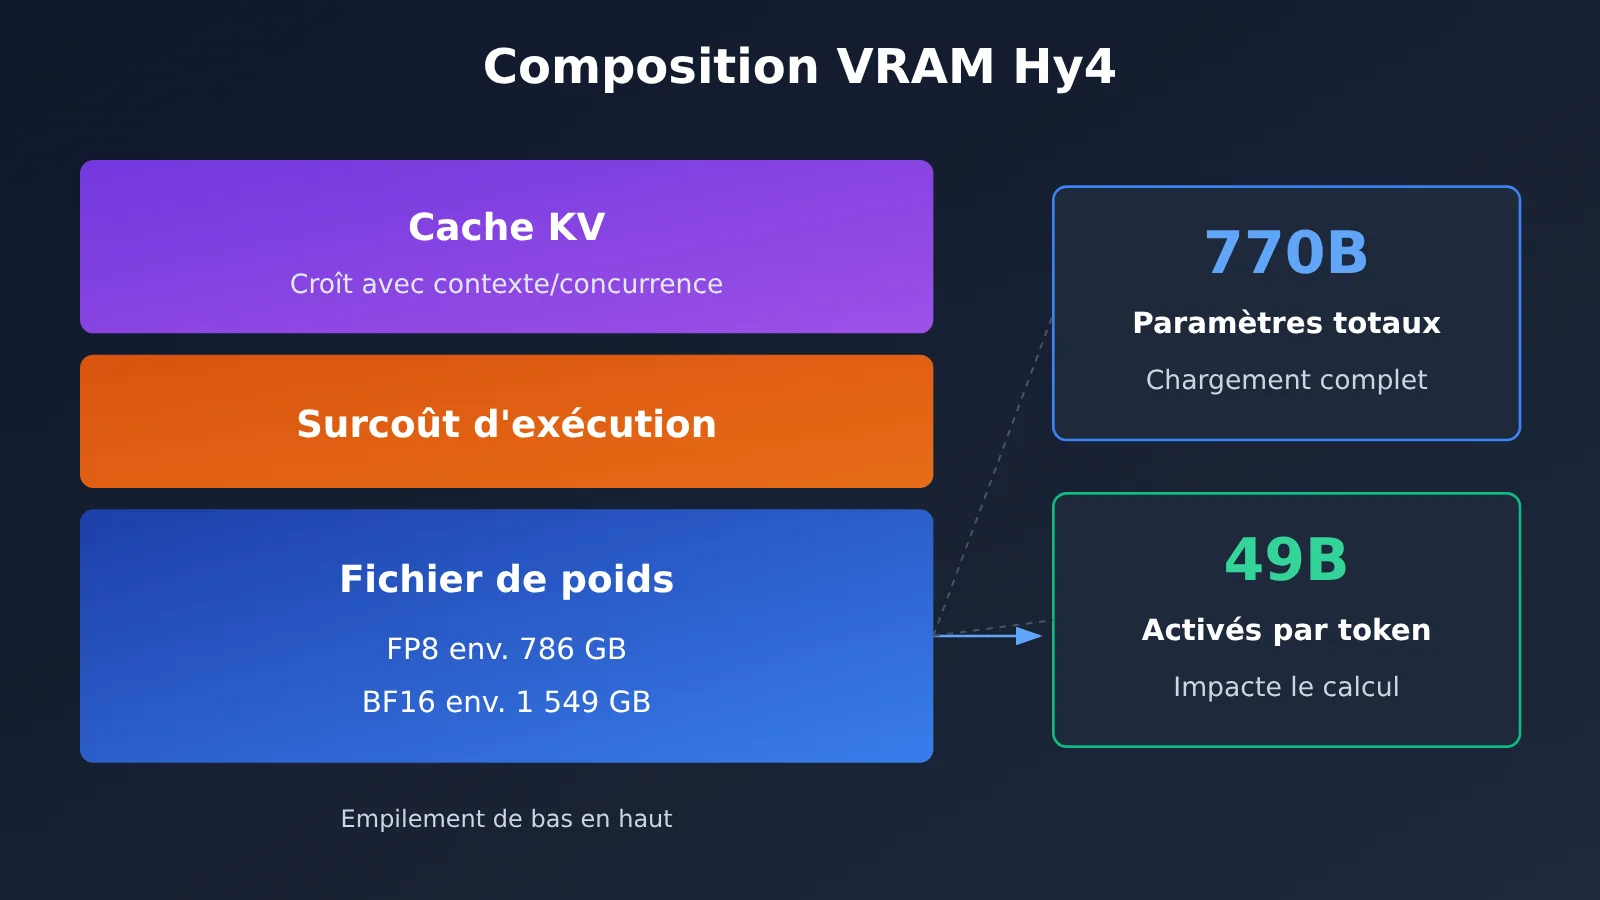
Deux chiffres reviennent souvent à propos de Hy4 : 770B est le nombre total de paramètres du socle linguistique, et 49B le nombre de paramètres texte activés par token. Beaucoup lisent 49B comme un besoin en mémoire GPU, ce qui est faux. Les 49B déterminent la quantité de calcul par token ; pour pouvoir appeler n’importe quel expert à tout moment, les 770B de paramètres doivent tous être chargés en mémoire GPU.
Le besoin en mémoire se décompose en trois couches :
- Taille des fichiers de poids : d’après la documentation vLLM, environ 786 GB en FP8 et environ 1 549 GB en BF16. C’est d’abord une question de disque et de bande passante de chargement.
- Mémoire GPU à l’exécution : la mémoire de référence des exemples vLLM est d’environ 944 GB (FP8) et 1 859 GB (BF16), soit plus que les fichiers eux-mêmes, car elle inclut les frais d’exécution et la réservation du cache KV.
- Cache KV et concurrence : plus le contexte est long et plus les requêtes servies simultanément sont nombreuses, plus le cache KV occupe de mémoire. C’est ce qui détermine, une fois que « le modèle tient » sur un matériel donné, le trafic qu’il peut encore absorber.
Avant de déployer, on peut faire l’inventaire avec cette liste :
- [ ] Modèle, nombre et mémoire par carte des GPU disponibles, et possibilité de former un TP4 ou TP8
- [ ] L’interconnexion entre GPU satisfait-elle les exigences de communication du parallélisme tensoriel
- [ ] Le stockage local peut-il accueillir environ 786 GB (FP8) ou environ 1 549 GB (BF16) de poids, et à quelle vitesse de chargement
- [ ] Longueur de contexte visée : 131K suffit-il, ou faut-il aller plus loin
- [ ] Nombre de requêtes simultanées en pic, et le pool KV suffit-il à cette concurrence
- [ ] Faut-il des entrées visuelles (l’exemple vLLM n’active qu’une seule image)
- [ ] La version du framework d’inférence retenue correspond-elle bien au cookbook ou à la recipe officielle
3. Calculer le coût de Hy4 avec le même lot de tâches
3.1 Calcul de la facturation à l’usage de l’API
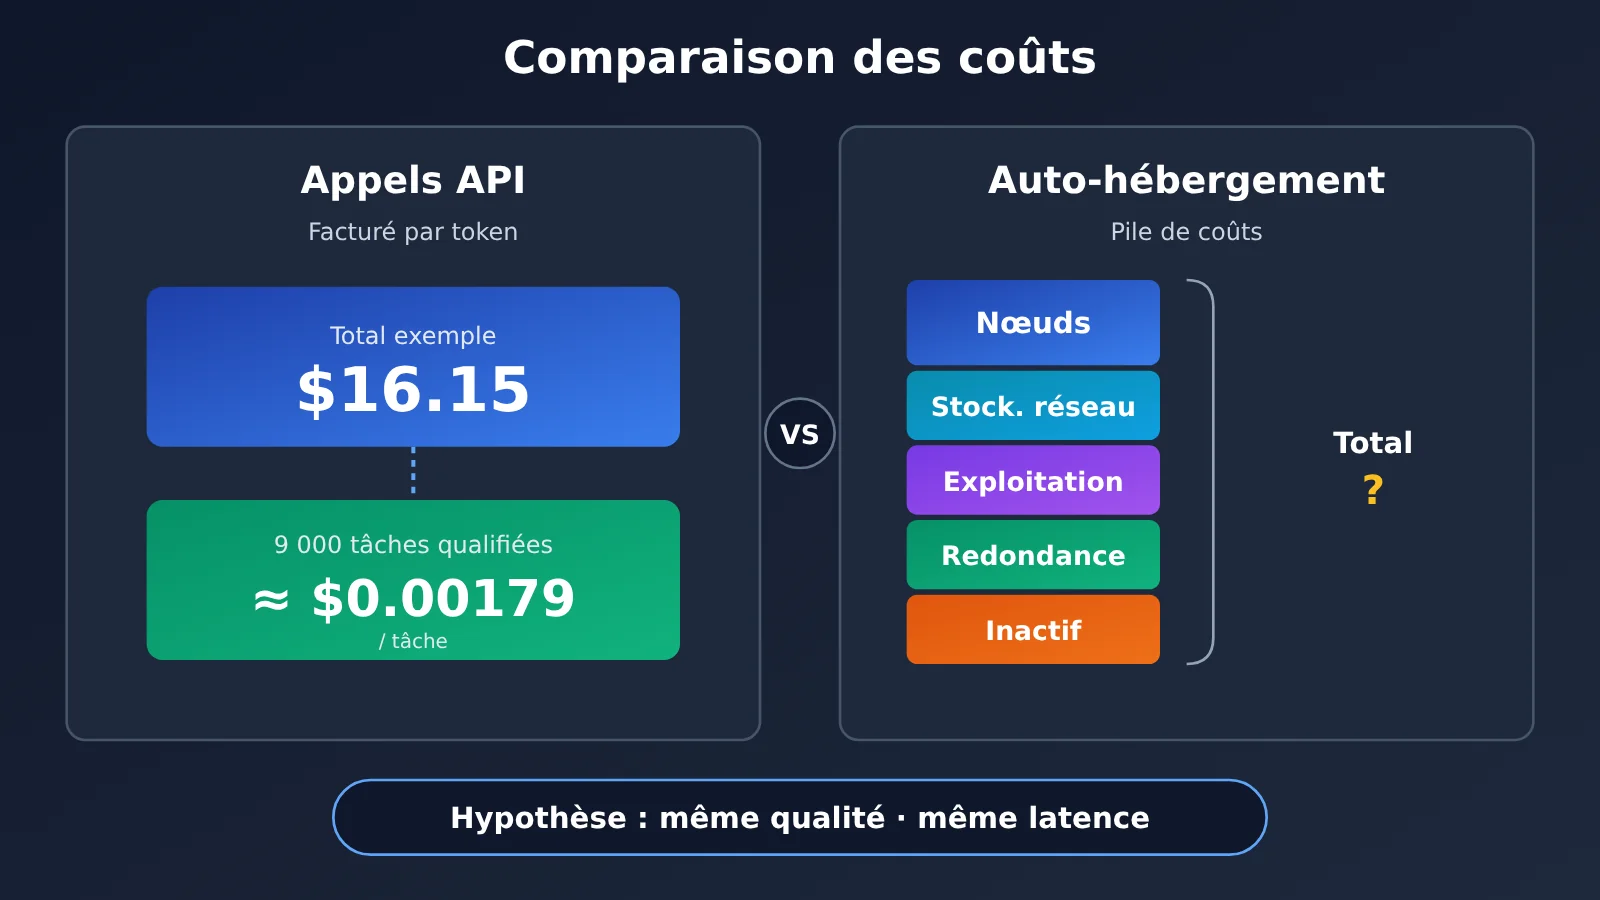
Prenons l’exemple de la page modèle d’APIYI : au 21 novembre 2026, la version officielle de Hy4 porte l’ID de modèle hy4 et propose deux groupes, Default et SVIP, via l’interface Chat Completions. Les tarifs sont indiqués par million de tokens : entrée non mise en cache $0.85, sortie $2.55, lecture de cache $0.045 ; le montant réellement débité fait foi dans la console. Il faut préciser qu’APIYI a mis Hy4 en ligne avant cette ouverture des poids ; l’annonce mentionne la prise en charge de la vision, mais l’exemple de calcul ci-dessous repose uniquement sur une hypothèse de texte pur. Il ne faut pas assimiler la fenêtre de contexte de 1 M, la vidéo ou les capacités Computer Use indiquées sur la fiche du modèle aux performances réellement mesurées du service hébergé.
Lors de la facturation, les trois types de tokens sont comptés séparément et ne se recoupent pas : un même token d’entrée est facturé soit comme entrée non mise en cache, soit comme lecture de cache, jamais les deux. Voici un exemple de calcul hypothétique, et non une mesure réelle :
| Élément | Utilisation hypothétique | Prix unitaire (par million) | Coût |
|---|---|---|---|
| Entrée non mise en cache | 10 millions de tokens | $0.85 | $8.50 |
| Sortie | 3 millions de tokens | $2.55 | $7.65 |
| Lecture de cache | 0 | $0.045 | $0 |
| Total | — | — | $16.15 |
Si 9 000 résultats de ce lot d’appels ont passé votre validation, le coût par tâche validée est d’environ $16.15 ÷ 9 000 ≈ $0.00179. Il est préférable de mesurer le « coût par tâche validée » plutôt que le « coût par appel », car les coûts des nouvelles tentatives après échec et des reprises doivent entrer dans le calcul. Ce chiffre doit aussi être consigné avec la latence réellement observée et la concurrence supportable ; sinon, la comparaison avec une solution d’auto-hébergement n’est pas possible.
3.2 Les coûts réels d’un déploiement auto-hébergé
Le coût de l’auto-hébergement dépasse largement le seul GPU. Le tableau ci-dessous liste les postes à prendre en compte :
| Poste de coût | Contenu |
|---|---|
| Nœuds de calcul | Achat ou location de nœuds GPU haut de gamme à 4 ou 8 cartes |
| Stockage et réseau | Stockage des poids de l’ordre du TB, bande passante de chargement, interconnexion entre cartes et entre nœuds |
| Exploitation | Main-d’œuvre nécessaire pour les mises à jour du framework d’inférence, la surveillance et les alertes, et le traitement des incidents |
| Redondance | Nœuds de secours prévus pour garantir la disponibilité, souvent inactifs en temps normal |
| Taux d’utilisation | Coût de l’inactivité pendant les creux de trafic, qui augmente directement le prix unitaire de chaque tâche |
Pour comparer les deux solutions, il faut se placer à qualité et latence égales : avec le même lot de tâches et les mêmes critères de validation, et pour des objectifs de latence et de concurrence proches, calculez séparément le coût par tâche validée. Comme le prix du matériel, le taux d’utilisation et le coût de la main-d’œuvre varient fortement d’une équipe à l’autre, cet article ne donne pas de « seuil de rentabilité » unique. Il vous faut faire le calcul avec vos propres devis et votre courbe de trafic.
4. Décision de déploiement pour Hy4 : API, auto-hébergement ou modèle plus petit
En combinant les conclusions des trois sections précédentes, on peut distinguer trois parcours selon les conditions :
- Conformité OK + commencer par des tâches purement textuelles → passer par l’API. Pas besoin de préparer du matériel : commencez par mesurer, sur des tâches réelles, le coût et la latence par tâche conforme, afin d’établir une référence pour les décisions suivantes.
- Besoin d’une isolation forte des données, ou de contrôler soi-même la configuration d’inférence → faire l’inventaire du matériel puis valider en auto-hébergement. Commencez par inventorier vos ressources à l’aide de la liste de la section 2.2, faites tourner la configuration d’exemple de SGLang ou de vLLM, puis comparez qualité, latence et coût sur le même jeu de tâches que celui utilisé avec l’API. Avant d’exposer le service à l’extérieur, faites vérifier par le service juridique la section 10 de la licence.
- Des ressources inférieures à l’ordre de grandeur des exemples → réévaluer un modèle plus petit. Si vous ne pouvez pas réunir 4 ou 8 GPU haut de gamme, comprimer de force la fenêtre de contexte ou la concurrence ne permettra probablement pas d’atteindre les objectifs de qualité et de latence ; passer à un modèle plus petit est souvent plus réaliste.
Fiche d’action
- Choisir les poids :
Hy4-FP8pour le déploiement d’inférence,Hy4-basesi vous devez poursuivre l’entraînement, et vérifier que ce n’est pas la variante flash. - Préparer 200 à 500 tâches réelles et rédiger les critères d’acceptation.
- Si les données peuvent sortir de votre périmètre, faites d’abord un passage via l’API ; sinon, testez d’abord avec des échantillons publics ou synthétiques et gardez les données réelles dans l’environnement interne. Notez la consommation de tokens, le taux de conformité, la latence et le comportement en concurrence.
- Si l’auto-hébergement est nécessaire, inventoriez le matériel selon la liste et refaites le test avec le même lot de tâches.
- Prenez la décision finale avec un seul indicateur : « coût par tâche conforme + latence ».
Références
- Annonce officielle du lancement de Tencent Hy4 : https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/
- Poids Hy4 Instruct (BF16) : https://huggingface.co/tencent/Hy4
- Poids Hy4 Instruct (FP8) : https://huggingface.co/tencent/Hy4-FP8
- Poids Hy4 Base : https://huggingface.co/tencent/Hy4-base
- Licence Tencent Hy 1.0 : https://huggingface.co/tencent/Hy4/blob/main/LICENSE
- Hy4 Preview (Apache 2.0) : https://huggingface.co/tencent/Hy4-preview
- Cookbook SGLang pour Hy4 : https://docs.sglang.io/cookbook/autoregressive/Tencent/Hy4
- Recette vLLM pour Hy4 : https://recipes.vllm.ai/tencent/Hy4
- Note de lancement de Hy4 sur APIYI : https://docs.apiyi.com/news/hy4-launch
- Liste des modèles APIYI (Tencent) : https://docs.apiyi.com/models#腾讯
- Présentation du contexte de Hy4 (instantané historique ; pour les poids et les informations de mise en ligne, c’est le présent article qui fait foi) : https://help.apiyi.com/tencent-hy4-770b-vision-computer-use-pricing.html