ملخص: أصبحت أوزان Hy4 الرسمية متاحة للعموم، ويساعدك هذا المقال على تحديد مجموعة الأوزان التي يجب استخدامها، وما مستوى GPU الذي يحتاجه النشر الذاتي، وكيف تعقد مقارنة عادلة مع تكلفة استدعاء الـ API مباشرة.
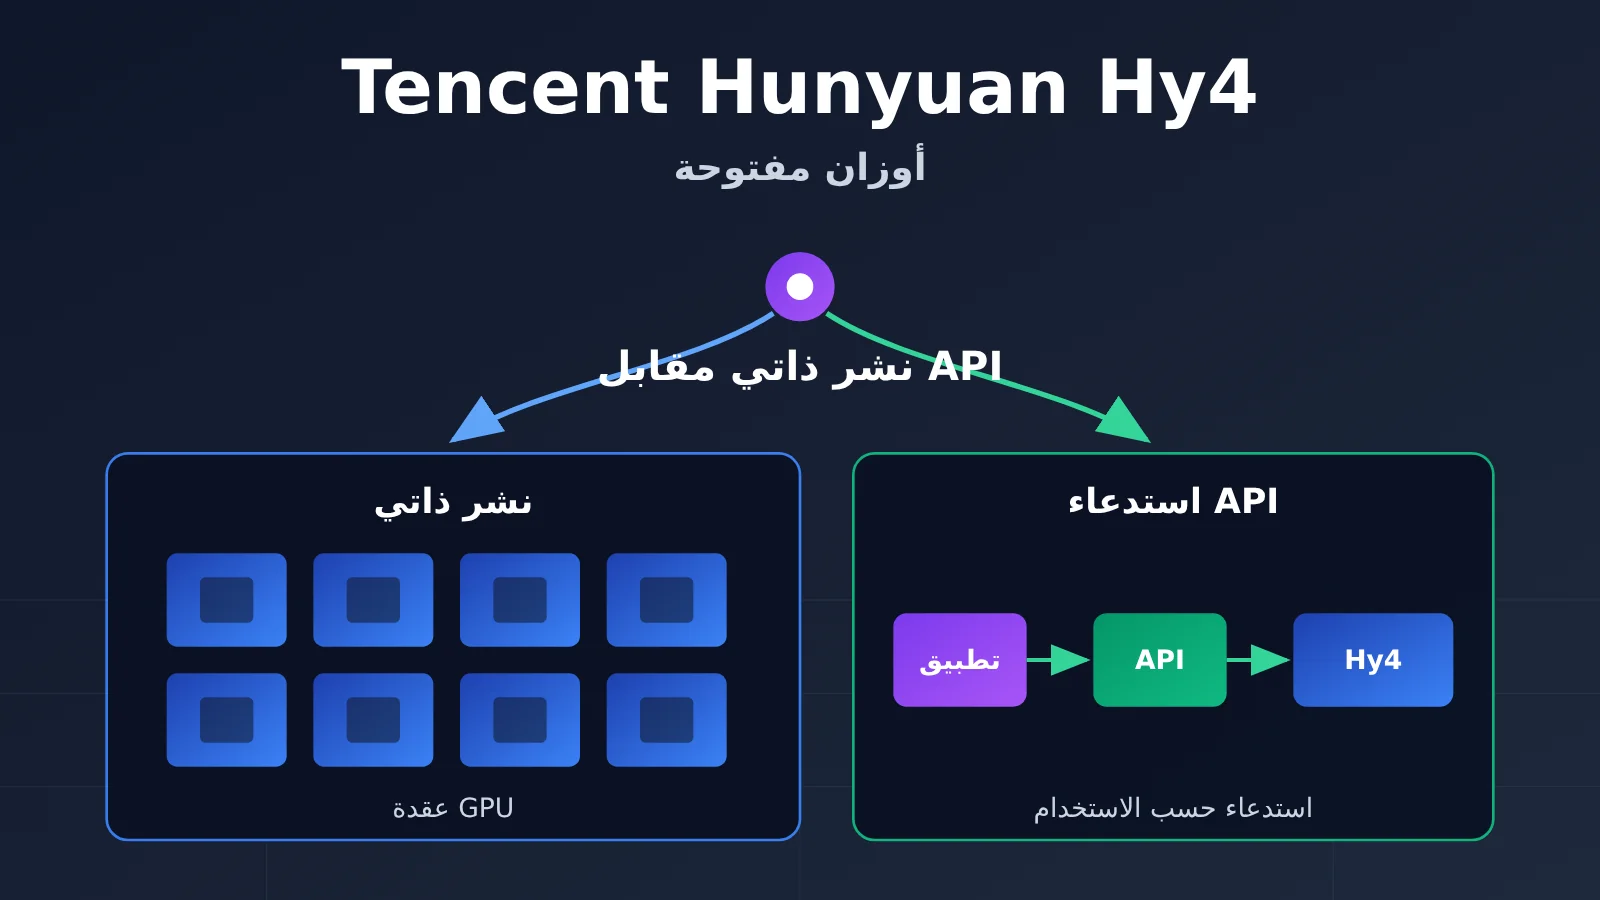
الخلاصة أولاً: إذا كانت المتطلبات التنظيمية تسمح، وكانت حاجتك الأولى هي تجربة مهام نصية بحتة، فإن استدعاء الـ API مباشرة هو الخيار الأقل عتبةً. أما النشر الذاتي فلا يستحق التفكير فيه إلا عند الحاجة إلى عزل قوي للبيانات، أو عندما تحتاج فعلاً إلى التحكم في إعدادات الاستدلال بنفسك. ونقطة البداية في النشر الذاتي ليست منخفضة: فإعداد FP8 النموذجي الذي يقدّمه إطار الاستدلال الرسمي يقع في مستوى 4 بطاقات B300/GB300 أو 8 بطاقات H200/B200. إضافة إلى ذلك، هذه الأمثلة ليست الحد الأدنى في جميع الإعدادات، ولا تعني القدرة على تشغيل سياق بطول 1M كامل. وإذا كانت الموارد المتاحة لديك لا تكفي، فبدلاً من محاولة تشغيل Hy4 بالقوة، من الأفضل إعادة تقييم نموذج أصغر.
خريطة معرفية وفهرس قراءة لـ Hy4 مفتوح الأوزان
| الرقم | ما تقرأه أولاً | لماذا تقرأه أولاً | ما تحصل عليه بعد القراءة |
|---|---|---|---|
| 1 | اختيار الإصدار والأوزان | اختيار الأوزان الخطأ يُبطل كل تقديرات العتاد اللاحقة | تحديد ما إذا كنت ستستخدم Instruct BF16 أو Instruct FP8 أو Base |
| 2 | كم بطاقة يحتاجها النشر | العتاد هو أكبر عائق أمام النشر الذاتي | جدول مقارنة للعتاد وقائمة جرد |
| 3 | تكلفة الدفعة نفسها من المهام | المقارنة لا تكون ذات معنى إلا عند تساوي الجودة وزمن الاستجابة | طريقة حساب تكلفة المهمة الواحدة عبر API، ومكوّنات تكلفة النشر الذاتي |
| 4 | القرار | تحويل استنتاجات الأقسام الثلاثة الأولى إلى حالتك | استخدام API، أو التحقق عبر النشر الذاتي، أو الانتقال إلى نموذج أصغر |
العلاقة بين 1→2→3 علاقة تراكمية: الإصدار يحدد ملفات الأوزان، وملفات الأوزان تحدد العتاد، والعتاد يحدد التكلفة. القسم الرابع يجمع استنتاجات الأقسام الثلاثة الأولى. أما من يهتم بالتكلفة فقط، فيمكنه البدء مباشرة من القسم الثالث.
To Know: المصطلحات التي تحتاجها لفهم نشر Hy4
| المصطلح | شرح موجز |
|---|---|
| الأوزان المفتوحة | ملفات معاملات النموذج قابلة للتنزيل والنشر الذاتي، وتنظّم شروط الاستخدام بموجب الترخيص |
| Instruct / Base | Instruct نسخة خضعت لمحاذاة التوجيهات ويمكن محاورتها مباشرة؛ أما Base فهي قاعدة مُدرَّبة مسبقاً، مناسبة لمواصلة التدريب |
| BF16 / FP8 | دقة تمثيل القيم للمعاملات. يشغل FP8 نحو بايت واحد لكل معامل، بينما يشغل BF16 نحو بايتين |
| TP (التوازي التنسوري) | تقسيم النموذج على عدة وحدات GPU لتُحسب بالتعاون؛ ويعني TP8 التقسيم إلى 8 أجزاء |
| KV cache | حالة وسيطة تُحفظ للسياق أثناء الاستدلال، وتنمو مع طول السياق وعدد الطلبات المتزامنة |
| قراءة من الذاكرة المؤقتة | رموز الإدخال التي تُصيب ذاكرة الموجه المؤقتة في فواتير API، وسعر الوحدة فيها أقل من الإدخال غير المخزَّن |
1. كيف تختار إصدار Hy4 والأوزان المفتوحة
1.1 المحطات الزمنية الثلاث لإصدار Hy4
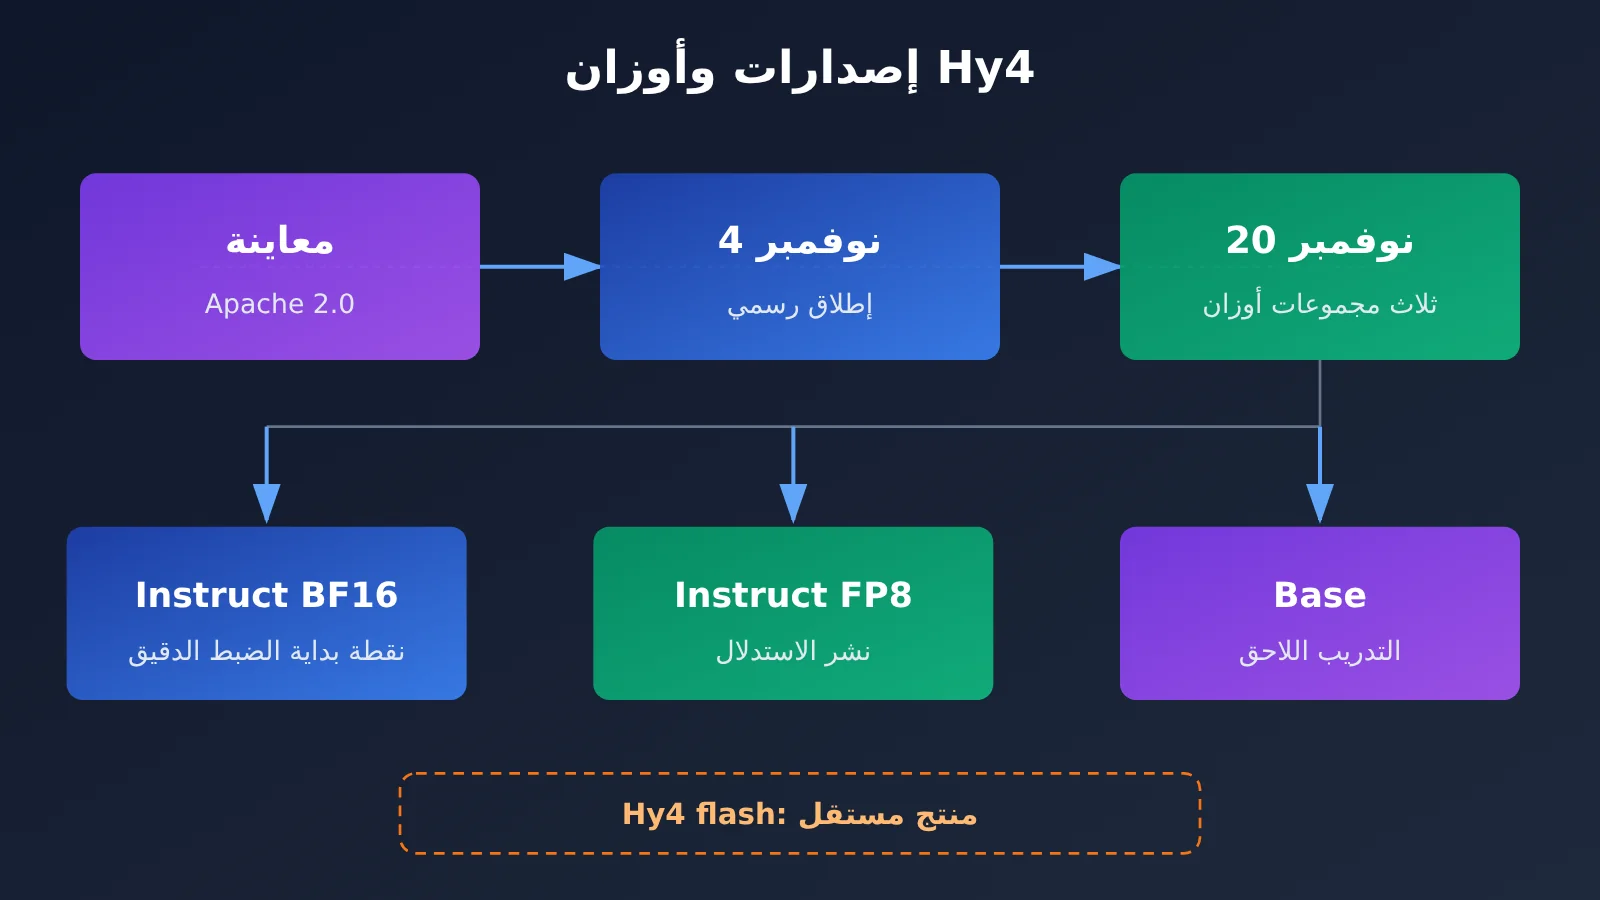
مرّت عملية إتاحة Hy4 للجمهور بثلاث مراحل. أول ما صدر كان إصدار Preview، وقد نُشر على صفحة tencent/Hy4-preview في Hugging Face بترخيص Apache 2.0. وفي 4 نوفمبر 2026، أصدرت Tencent إعلانًا أعلنت فيه الإطلاق الرسمي لـ Hy4. وفي 20 نوفمبر، نُشرت الأوزان الثلاثة الرسمية على Hugging Face.
الفرق بين هذه المحطات الثلاث يؤثر مباشرة في اختيارك. ترخيص إصدار Preview يختلف عن ترخيص الإصدار الرسمي: يستخدم الإصدار الرسمي ترخيص Tencent Hy License 1.0، وفيه يضع القسم 10 شروطًا إضافية على بعض خدمات الاستدلال العامة المقدمة للجمهور. إذا كنت تخطط لنشر Hy4 كخدمة متاحة للجمهور، فاطلب من فريقك القانوني تقييم الأمر بنفسه بالرجوع إلى النص الأصلي للترخيص؛ ولا تقدم هذه المقالة أي استنتاج قانوني بشأن ممارسات أي شركة بعينها.
1.2 شروط استخدام الأوزان الرسمية الثلاثة لـ Hy4
| مستودع الأوزان | المحتوى | متى تستخدمه |
|---|---|---|
tencent/Hy4 |
Instruct، BF16 | عندما تحتاج إلى أعلى دقة عددية، أو تريد استخدامه كنقطة انطلاق للتدريب الدقيق أو التكميم؛ وهو الأعلى متطلبات في الذاكرة الرسومية |
tencent/Hy4-FP8 |
Instruct، FP8 | للاستخدام المباشر في نشر الاستدلال؛ إذ تستند إليه إعدادات SGLang وvLLM النموذجية |
tencent/Hy4-base |
Base مُدرَّب مسبقًا | إذا كنت تريد تنفيذ التدريب اللاحق أو مواصلة التدريب في مجال معين بنفسك؛ لا يصلح للاستخدام المباشر في المحادثة |
من الضروري التمييز بين أمرين: الإصدار الرسمي من Hy4 ليس هو Hy4 flash، فالأخير خط منتجات مستقل. جميع متطلبات العتاد والتكلفة التي تناقشها هذه المقالة تخص الإصدار الرسمي فقط، ولا يمكن تطبيقها على flash.
2. كم بطاقة تحتاج لنشر Hy4 بنفسك
2.1 مقارنة إعدادات الأمثلة بين SGLang وvLLM
قدّم الإطاران الرئيسيان للاستدلال أمثلة نشر لـ Hy4. وفيما يلي نعرضهما جنبًا إلى جنب:
| الإطار | الأوزان | طريقة التوازي | GPU في المثال | ملاحظات المثال |
|---|---|---|---|---|
| SGLang | FP8 | TP4 | 4×B300 أو 4×GB300 | حجم مخزن KV هو ما يحدد سعة السياق المتاحة فعليًا |
| SGLang | FP8 | TP8 | 8×H200 أو 8×B200 | كما هو مذكور أعلاه |
| vLLM | FP8 (الافتراضي) | TP8 | 8×B300 | نافذة السياق في المثال هي 131,072؛ يدعم صورة واحدة فقط، والفيديو معطّل |
هناك ثلاث نقاط يجب الانتباه إليها عند قراءة هذا الجدول:
- هذه إعدادات أمثلة، وليست الحد الأدنى. توضح وثائق SGLang أنّ مخزن KV يحدّ من السياق الذي يمكن استيعابه فعليًا، كما أنّ هذه الإعدادات لا تمثّل الحد الأدنى المطلوب تحت أي مزيج من المعاملات.
- لا يمكن ضمان تشغيل 1M كاملة. الحد الأقصى للسياق المعلن في بطاقة النموذج هو 1,048,576 token، لكن الطول المتاح في إعداد خدمة معيّن يحتاج إلى حساب منفصل. مثال vLLM يفتح فقط 131,072، ولم تعِد أي من الوثيقتين بإتاحة 1M كاملة.
- أرقام الجانبين لا يمكن تطبيقها على بعضها البعض. ذاكرة GPU المرجعية التي تقدّمها وثائق vLLM تنطبق فقط على هذه المجموعة من إعدادات vLLM.
2.2 علاقة 770B و49B بذاكرة GPU
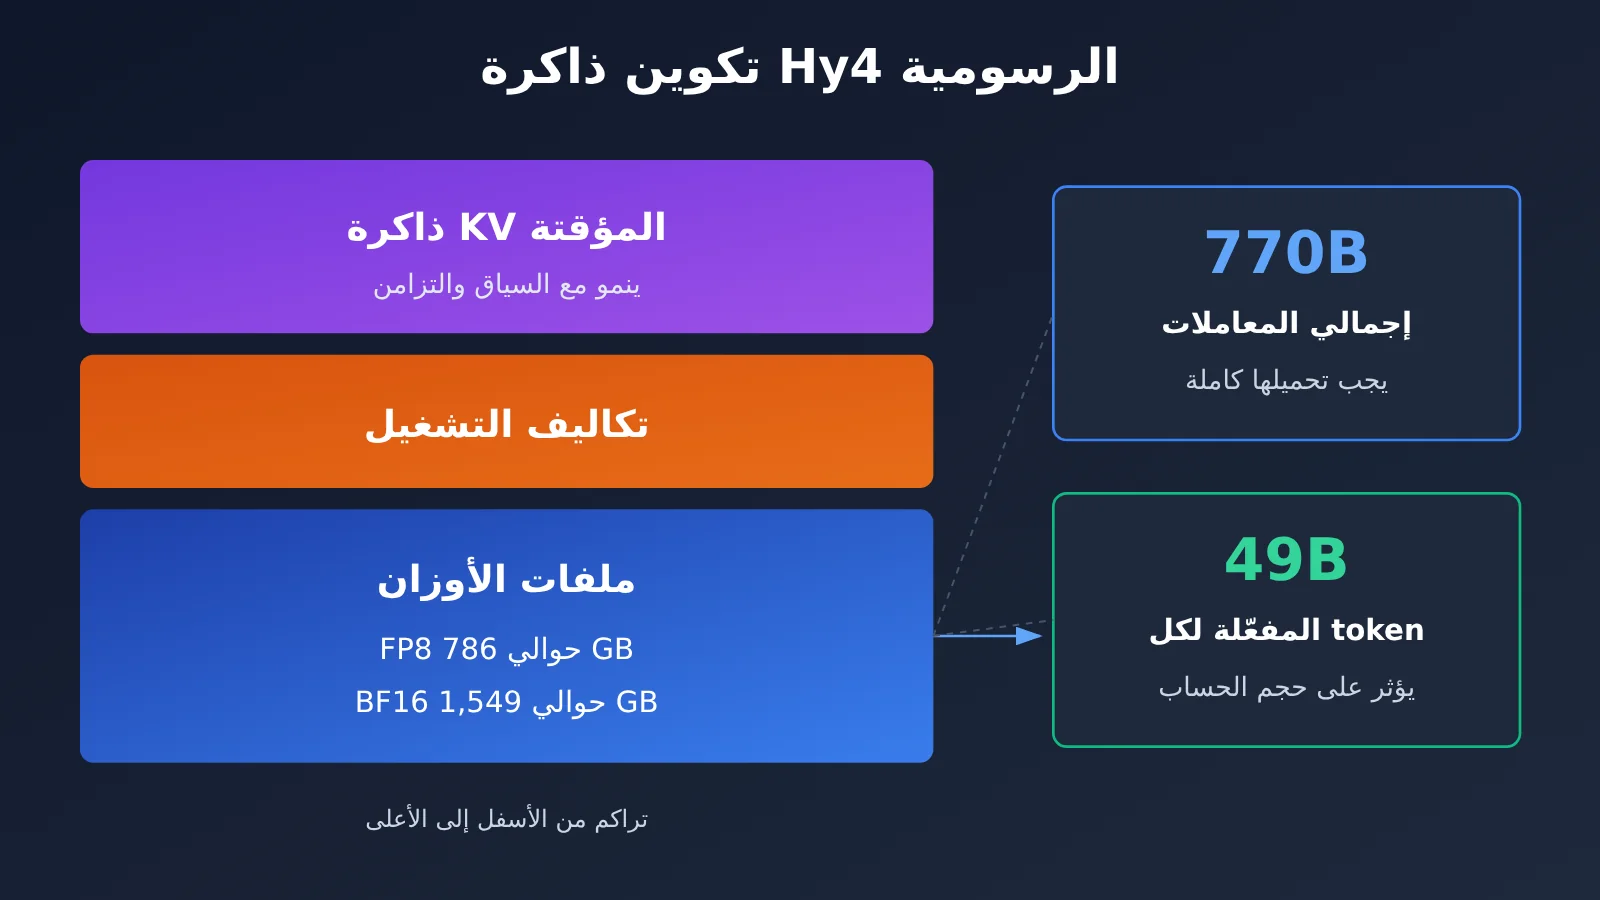
عادةً ما يُذكر رقمَان عند الحديث عن Hy4: 770B هو إجمالي عدد المعاملات في العمود الفقري اللغوي، و49B هو عدد معاملات النص التي تُنشَّط لكل token. كثيرون يقرؤون 49B خطأً على أنه متطلب ذاكرة GPU، وهذا غير صحيح. فالـ 49B يحدد حجم الحساب لكل token؛ أما لكي نستدعي أي خبير في أي لحظة، فلا بد من تحميل كامل معاملات 770B في ذاكرة GPU.
ينبغي تقسيم متطلب ذاكرة GPU إلى ثلاث طبقات:
- حجم ملف الأوزان: بحسب توثيق vLLM، نحو 786 GB بصيغة FP8 ونحو 1,549 GB بصيغة BF16. وهذه في المقام الأول مسألة تتعلق بالقرص وعرض نطاق التحميل.
- ذاكرة GPU وقت التشغيل: تشير أمثلة vLLM إلى ذاكرة GPU مرجعية تبلغ نحو 944 GB (FP8) ونحو 1,859 GB (BF16)، وهي أكبر من حجم الملف نفسه لأنها تضم أيضًا تكاليف التشغيل والمساحة المحفوظة لـ KV cache.
- KV cache والتزامن: كلما طال السياق وزاد عدد الطلبات المخدومة في الوقت نفسه، كبر حجم KV cache. وهذه الطبقة هي التي تحدد مقدار حركة المرور التي يمكن خدمتها بعد أن «تستوعب» البطاقات نفسها النموذج.
قبل النشر يمكنك مراجعة القائمة التالية:
- [ ] طرازات بطاقات GPU المتاحة وأعدادها وذاكرة كل بطاقة، وهل تكفي لتشكيل TP4 أو TP8
- [ ] هل يلبي الترابط بين البطاقات متطلبات الاتصال في التوازي التنسوري
- [ ] هل يستوعب التخزين المحلي أوزانًا بحجم نحو 786 GB (FP8) أو نحو 1,549 GB (BF16)، وما سرعة التحميل
- [ ] طول السياق المستهدف: هل يكفي 131K أم لا بد من طول أكبر
- [ ] عدد الطلبات المتزامنة في الذروة، وهل يكفي تجمّع KV عند هذا المستوى
- [ ] هل تحتاج إلى إدخال بصري (مثال vLLM لا يُفعّل سوى صورة واحدة)
- [ ] هل إصدار إطار الاستدلال المختار مطابق لما ورد في cookbook أو recipe الرسمي
3. حساب تكلفة Hy4 باستخدام الدفعة نفسها من المهام
3.1 طريقة حساب الفوترة حسب الاستخدام في API
لنأخذ صفحة النماذج في APIYI كمثال: حتى 21 نوفمبر 2026، معرّف النموذج للإصدار الرسمي من Hy4 هو hy4، ويوفّر مجموعتين هما Default وSVIP، ويعتمد واجهة Chat Completions. الأسعار المعلنة تُحسب لكل مليون token: الإدخال غير المخزَّن مؤقتًا $0.85، والإخراج $2.55، وقراءة الذاكرة المؤقتة $0.045، والخصم الفعلي يُرجع إلى لوحة التحكم. وتجدر الإشارة إلى أن APIYI أتاح Hy4 قبل هذا الإصدار من الأوزان؛ ويذكر الإعلان دعم الرؤية، لكن الأمثلة الحسابية أدناه تفترض النص فقط، ولا نُساوي بين نافذة السياق البالغة 1M أو الفيديو أو قدرات Computer Use المذكورة في بطاقة النموذج وبين الأداء الفعلي المُقاس للخدمة المستضافة.
عند الفوترة، يُحسب كل نوع من أنواع الـ token الثلاثة على حدة دون تكرار: الـ token الواحد في الإدخال إما يُحسب إدخالًا غير مخزَّن مؤقتًا أو قراءةً من الذاكرة المؤقتة، ولا يُحصّل مرتين. وفيما يلي مثال حسابي افتراضي، وليس قياسًا فعليًا:
| البند | الاستخدام المفترض | سعر الوحدة (لكل مليون) | التكلفة |
|---|---|---|---|
| إدخال غير مخزَّن مؤقتًا | 10 ملايين token | $0.85 | $8.50 |
| إخراج | 3 ملايين token | $2.55 | $7.65 |
| قراءة من الذاكرة المؤقتة | 0 | $0.045 | $0 |
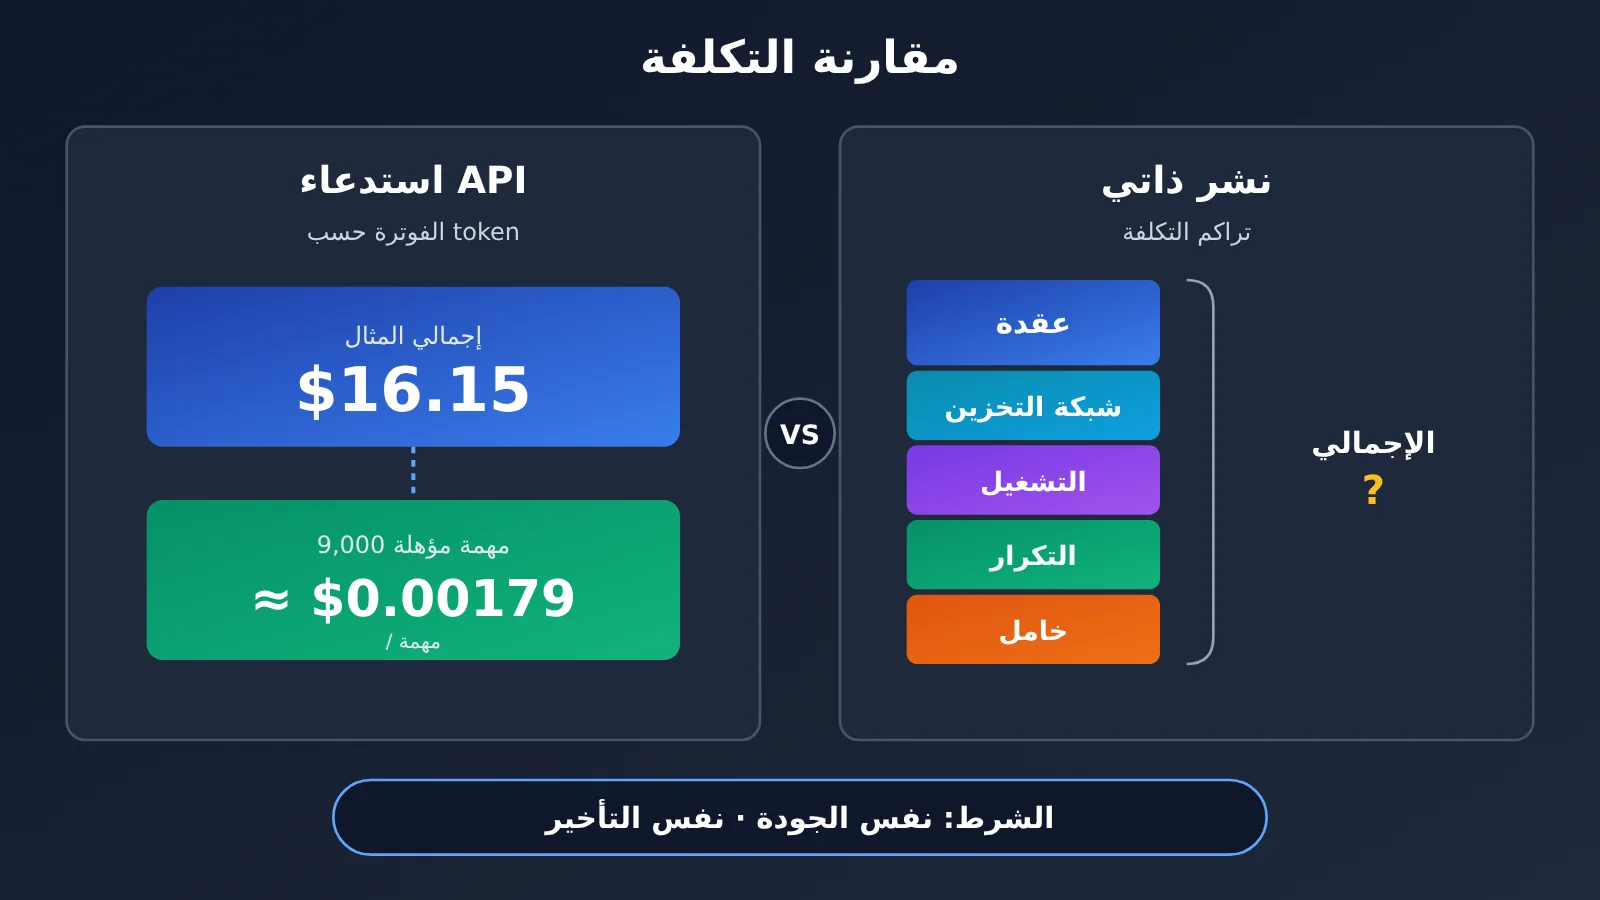
| الإجمالي | — | — | $16.15 |
بافتراض أن 9,000 نتيجة من هذه الاستدعاءات اجتازت معايير القبول لديك، فإن تكلفة كل مهمة مقبولة تبلغ نحو $16.15 ÷ 9,000 ≈ $0.00179. يُنصح بالقياس بـ«تكلفة كل مهمة مقبولة» بدلًا من «تكلفة كل استدعاء»، لأن تكاليف إعادة المحاولة بعد الفشل وإعادة العمل يجب أن تُحتسب ضمن الحساب. وينبغي تسجيل هذا الرقم إلى جانب زمن التأخير المرصود فعليًا والتزامن الذي يمكن تحمّله، وإلا فسيكون من المتعذّر مقارنته بخيار النشر الذاتي.
3.2 مكونات التكلفة الفعلية للنشر الذاتي
تكلفة النشر الذاتي لا تقتصر على وحدات GPU، بل تتجاوزها بكثير. يوضح الجدول التالي البنود التي يجب أن تُحتسب:
| بند التكلفة | المحتوى |
|---|---|
| عقد الحوسبة | تكلفة شراء أو استئجار عقدة GPU عالية الأداء بأربع بطاقات أو ثماني بطاقات |
| التخزين والشبكة | تخزين الأوزان بحجم يقترب من تيرابايت، وعرض النطاق اللازم لتحميلها، والربط بين البطاقات وبين العقد |
| التشغيل والصيانة | القوى البشرية اللازمة لترقية أطر الاستدلال والمراقبة والتنبيه ومعالجة الأعطال |
| التكرار الاحتياطي | عقد احتياطية تُجهّز لضمان التوفر، وقد تظل خاملة في الظروف العادية |
| معدل الاستخدام | تكلفة الخمول خلال فترات انخفاض الطلب، وهي ترفع سعر الوحدة لكل مهمة مباشرةً |
عند مقارنة الخيارين، ينبغي أن تتم المقارنة عند نفس مستوى الجودة ونفس مستوى زمن التأخير: استخدم الدفعة نفسها من المهام ومعايير القبول نفسها، واحسب تكلفة كل مهمة مقبولة على حدة في ظل أهداف متقاربة لزمن التأخير والتزامن. وبما أن أسعار العتاد ومعدلات الاستخدام وتكاليف القوى البشرية تختلف اختلافًا كبيرًا بين الفرق، فإن هذه المقالة لا تقدّم «نقطة استرداد تكلفة» موحّدة. عليك أن تحسبها بنفسك اعتمادًا على أسعارك ومنحنى حركة الطلبات لديك.
4. قرار نشر Hy4: الاعتماد على API أم النشر الذاتي أم الانتقال إلى نموذج أصغر
بجمع استنتاجات الأقسام الثلاثة السابقة معًا، يمكن تقسيم المسارات إلى ثلاثة وفقًا للظروف:
- الامتثال يسمح + البدء بمهام نصية بحتة → استخدام API. لا حاجة لتجهيز عتاد، بل احسب أولًا باستخدام مهام حقيقية تكلفة كل مهمة مقبولة وزمن استجابتها، لتكون خط الأساس للقرارات اللاحقة.
- الحاجة إلى عزل قوي للبيانات، أو الحاجة الفعلية للتحكم في إعدادات الاستدلال → جرد العتاد ثم التحقق عبر النشر الذاتي. ابدأ بجرد الموارد وفق قائمة القسم 2.2، وشغّل النموذج باستخدام إعدادات نموذجية لـ SGLang أو vLLM، ثم قارن الجودة وزمن الاستجابة والتكلفة باستخدام مجموعة المهام نفسها المستخدمة مع API. وقبل تقديم الخدمة للخارج، اطلب من الفريق القانوني مراجعة القسم 10 من الترخيص.
- الموارد أقل من المستوى الوارد في الأمثلة → إعادة تقييم نماذج أصغر. عندما لا يتوفر 4 أو 8 من وحدات GPU عالية الأداء، فإن محاولة ضغط نافذة السياق أو زيادة التزامن غالبًا لن تحقق أهداف الجودة وزمن الاستجابة، ويكون الانتقال إلى نموذج أصغر أكثر واقعية.
بطاقة الإجراءات
- حدّد الأوزان: استخدم
Hy4-FP8للنشر الاستدلالي، وHy4-baseإذا كنت بحاجة إلى مواصلة التدريب، وتأكد من أنك لا تستخدم إصدار flash. - جهّز من 200 إلى 500 مهمة حقيقية، واكتب معايير القبول بوضوح.
- إذا كان يُسمح بإرسال البيانات خارجيًا، فشغّل الاختبار عبر API أولًا؛ وإلا فاختبر بعينات عامة أو مُصنّعة، واحتفظ بالبيانات الحقيقية داخل البيئة الداخلية. وسجّل استهلاك الـ tokens ومعدل النجاح وزمن الاستجابة وأداء التزامن.
- إذا كنت بحاجة إلى النشر الذاتي، فاجرد العتاد وفق القائمة، وأعد الاختبار باستخدام الدفعة نفسها من المهام.
- اتخذ القرار النهائي بمعيار واحد: «تكلفة كل مهمة مقبولة + زمن الاستجابة».
المراجع
- الإعلان الرسمي عن إطلاق Tencent Hy4: https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/
- أوزان Hy4 Instruct (BF16): https://huggingface.co/tencent/Hy4
- أوزان Hy4 Instruct (FP8): https://huggingface.co/tencent/Hy4-FP8
- أوزان Hy4 Base: https://huggingface.co/tencent/Hy4-base
- رخصة Tencent Hy License 1.0: https://huggingface.co/tencent/Hy4/blob/main/LICENSE
- إصدار Hy4 Preview (Apache 2.0): https://huggingface.co/tencent/Hy4-preview
- دليل SGLang الخاص بـ Hy4: https://docs.sglang.io/cookbook/autoregressive/Tencent/Hy4
- وصفة vLLM لنموذج Hy4: https://recipes.vllm.ai/tencent/Hy4
- توضيح APIYI حول إطلاق Hy4: https://docs.apiyi.com/news/hy4-launch
- قائمة نماذج APIYI (تنسنت): https://docs.apiyi.com/models#腾讯
- نظرة عامة على خلفية Hy4 (لقطة تاريخية؛ معلومات الأوزان والتوفر تُعتمد من هذا المقال): https://help.apiyi.com/tencent-hy4-770b-vision-computer-use-pricing.html