Ringkasan: Bobot versi resmi Hy4 sudah dipublikasikan. Artikel ini membantu Anda menentukan set bobot mana yang sebaiknya dipakai, seberapa besar GPU yang dibutuhkan untuk deployment mandiri, dan bagaimana membandingkan biayanya secara adil dengan memanggil API secara langsung.
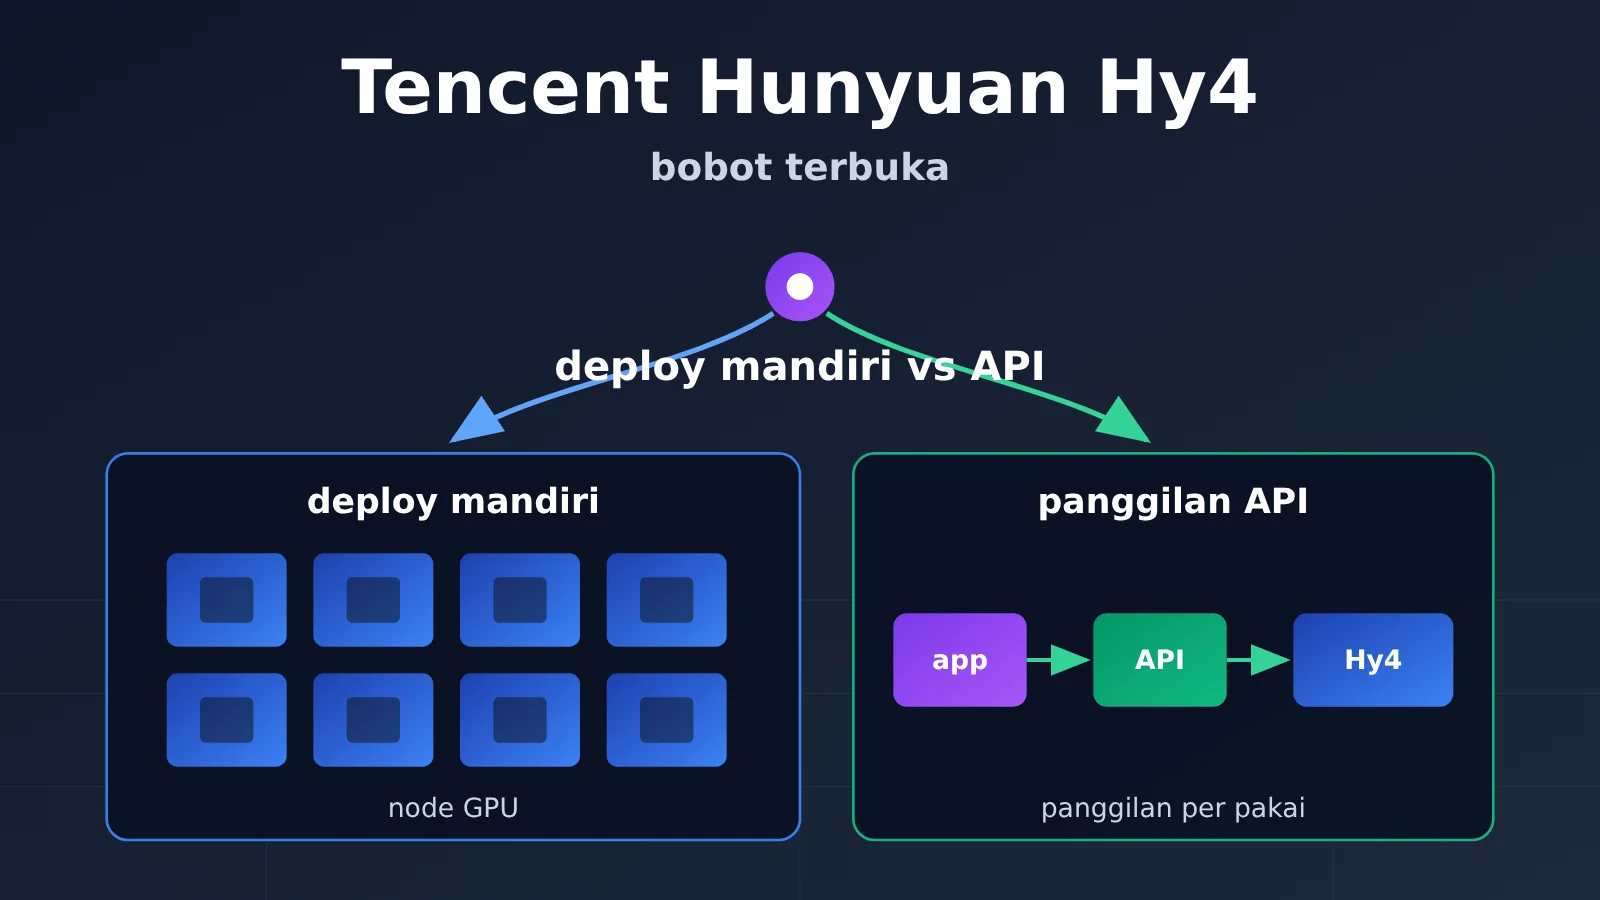
Kesimpulan di awal: Jika kepatuhan memungkinkan dan kebutuhan Anda adalah mencoba tugas teks murni terlebih dahulu, memanggil API adalah jalur dengan hambatan paling rendah. Deployment mandiri baru layak dipertimbangkan ketika Anda benar-benar butuh isolasi data yang kuat, atau memang perlu mengontrol konfigurasi inferensi sendiri. Titik awal deployment mandiri tidaklah rendah: contoh konfigurasi FP8 dari framework inferensi resmi berada di level 4 GPU B300/GB300 atau 8 GPU H200/B200. Perlu dicatat, contoh-contoh itu bukan ambang minimum untuk semua konfigurasi, dan juga tidak berarti mampu menjalankan konteks 1M secara penuh. Jika sumber daya yang tersedia belum mencukupi, daripada memaksakan Hy4, lebih baik mengevaluasi ulang model yang lebih kecil.
Peta pengetahuan dan indeks bacaan bobot terbuka Hy4
| No | Apa yang dibaca lebih dulu | Mengapa harus dibaca dulu | Hasil yang didapat |
|---|---|---|---|
| 1 | Versi dan pemilihan bobot | Salah memilih bobot, seluruh estimasi hardware setelahnya jadi tidak valid | Menentukan apakah memakai Instruct BF16, Instruct FP8, atau Base |
| 2 | Berapa kartu yang dibutuhkan untuk deployment | Hardware adalah hambatan terbesar dalam deployment mandiri | Satu tabel perbandingan hardware dan satu daftar inventaris |
| 3 | Biaya untuk batch tugas yang sama | Perbandingan hanya bermakna pada kualitas dan latensi yang sama | Algoritma biaya per tugas API, serta komponen biaya deployment mandiri |
| 4 | Keputusan | Menerapkan kesimpulan tiga bagian sebelumnya ke skenario Anda | Pakai API, validasi deployment mandiri, atau beralih ke model yang lebih kecil |
1→2→3 bersifat berurutan: versi menentukan file bobot, file bobot menentukan hardware, hardware menentukan biaya. Bagian 4 merangkum pertimbangan dari tiga bagian sebelumnya. Pembaca yang hanya peduli soal biaya bisa langsung mulai dari bagian 3.
To Know: istilah yang perlu dipahami untuk deployment Hy4
| Istilah | Penjelasan singkat |
|---|---|
| Bobot terbuka | File parameter model dapat diunduh dan di-deploy sendiri, dengan syarat penggunaan yang diatur oleh lisensi |
| Instruct / Base | Instruct adalah versi yang sudah melalui penyelarasan instruksi dan bisa langsung diajak berdialog; Base adalah basis pra-latih yang cocok untuk pelatihan lanjutan |
| BF16 / FP8 | Presisi numerik parameter. FP8 memakan sekitar 1 byte per parameter, BF16 sekitar 2 byte |
| TP (paralelisme tensor) | Memecah satu model ke beberapa GPU untuk dihitung bersama; TP8 berarti dipecah menjadi 8 bagian |
| KV cache | Status perantara yang disimpan untuk konteks saat inferensi, tumbuh seiring panjang konteks dan jumlah konkurensi |
| Pembacaan cache | Input token dalam penagihan API yang mengenai cache petunjuk, harga satuannya lebih rendah daripada input tanpa cache |
1. Cara memilih versi Hy4 dan bobot terbuka
1.1 Tiga tonggak waktu Hy4
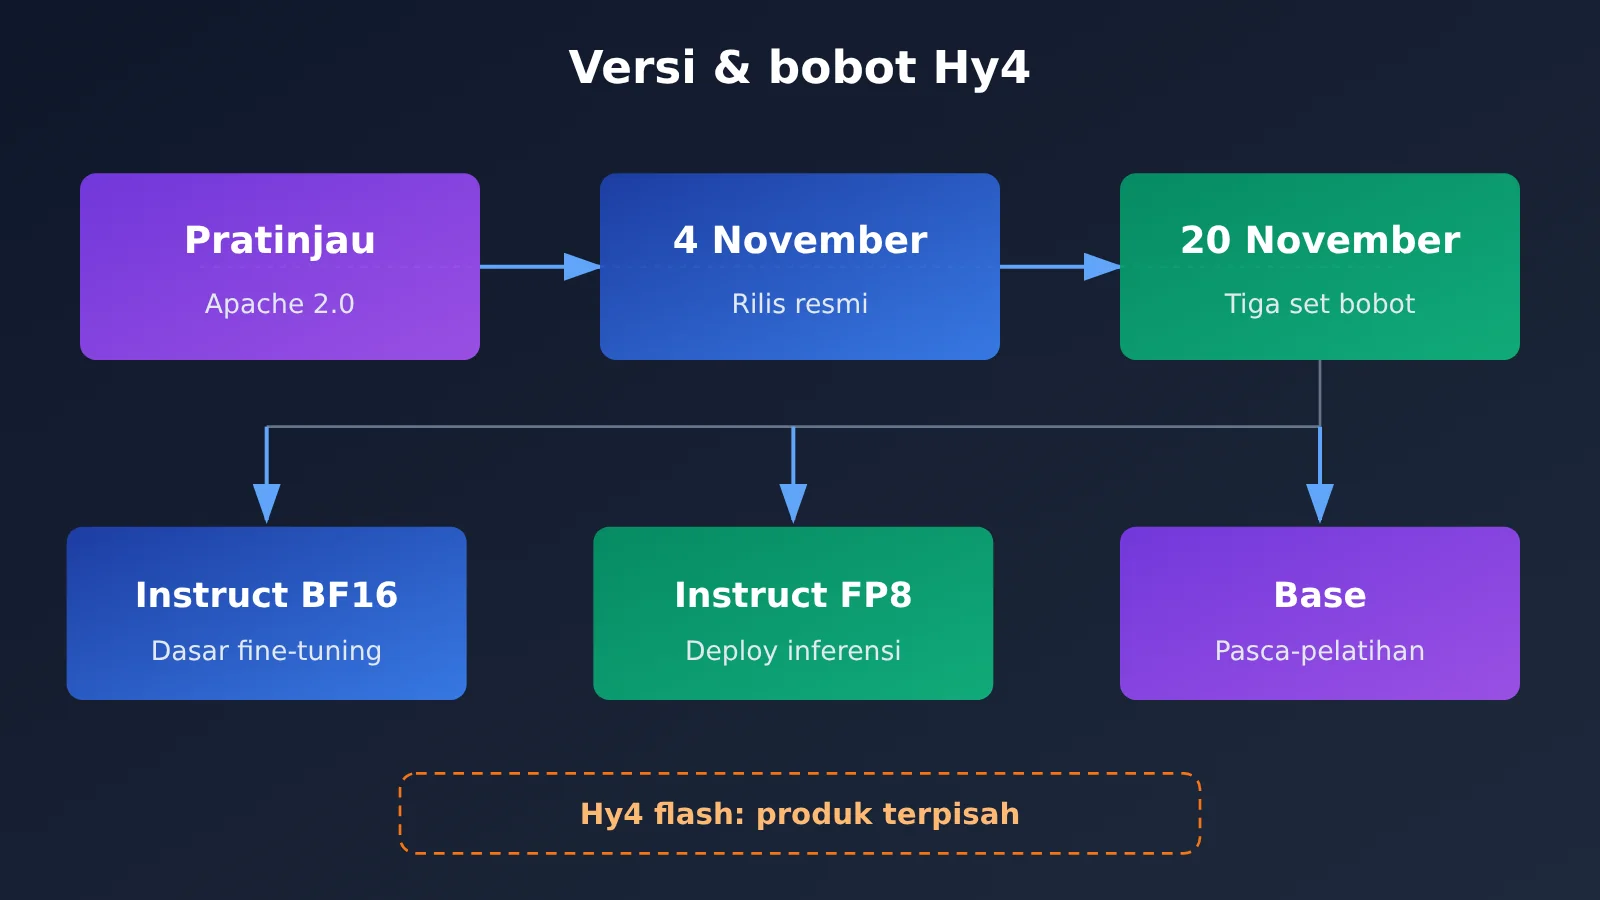
Proses publikasi Hy4 terbagi dalam tiga langkah. Versi yang pertama kali dibuka adalah Preview, yang dirilis di halaman tencent/Hy4-preview di Hugging Face dengan lisensi Apache 2.0. Pada 4 November 2026, Tencent menerbitkan pengumuman bahwa Hy4 resmi diluncurkan. Pada 20 November, tiga set bobot versi resmi dipublikasikan di Hugging Face.
Perbedaan antara ketiga tonggak ini berdampak langsung pada pilihan Anda. Lisensi Preview dan versi resmi berbeda: versi resmi memakai Tencent Hy License 1.0, yang Pasal 10-nya menetapkan syarat tambahan bagi sebagian layanan inferensi umum yang disediakan untuk pihak eksternal. Jika Anda berencana menyebarkan Hy4 sebagai layanan eksternal, mintalah tim hukum menilai sendiri berdasarkan teks lisensi asli; artikel ini tidak memberikan kesimpulan hukum atas praktik perusahaan tertentu.
1.2 Kondisi penggunaan tiga set bobot resmi Hy4
| Repositori bobot | Isi | Kondisi penggunaan |
|---|---|---|
tencent/Hy4 |
Instruct, BF16 | Membutuhkan presisi numerik tertinggi, atau dipakai sebagai titik awal fine-tuning dan kuantisasi; kebutuhan VRAM paling tinggi |
tencent/Hy4-FP8 |
Instruct, FP8 | Langsung dipakai untuk deployment inferensi; contoh konfigurasi SGLang dan vLLM keduanya berbasis pada bobot ini |
tencent/Hy4-base |
Base pra-pelatihan | Untuk melakukan pasca-pelatihan sendiri, pelatihan lanjutan domain; tidak cocok langsung dipakai untuk percakapan |
Yang perlu dibedakan secara khusus: Hy4 versi resmi tidak sama dengan Hy4 flash, yang merupakan lini produk terpisah. Perangkat keras dan biaya yang dibahas dalam artikel ini hanya berlaku untuk versi resmi dan tidak dapat diterapkan pada flash.
2. Berapa GPU yang Dibutuhkan untuk Men-deploy Hy4 Sendiri
2.1 Perbandingan Konfigurasi Contoh SGLang dan vLLM
Dua framework inferensi utama sama-sama menyediakan contoh deployment Hy4. Berikut perbandingan keduanya secara berdampingan:
| Framework | Bobot | Metode paralel | Contoh GPU | Keterangan contoh |
|---|---|---|---|---|
| SGLang | FP8 | TP4 | 4×B300 atau 4×GB300 | Ukuran pool KV menentukan kapasitas konteks yang benar-benar tersedia |
| SGLang | FP8 | TP8 | 8×H200 atau 8×B200 | Sama seperti di atas |
| vLLM | FP8 (default) | TP8 | 8×B300 | Jendela konteks contoh 131.072; hanya mendukung satu gambar, video dimatikan |
Ada tiga hal yang perlu diperhatikan saat membaca tabel ini:
- Ini konfigurasi contoh, bukan konfigurasi minimum. Dokumentasi SGLang menjelaskan bahwa pool KV membatasi konteks yang benar-benar bisa ditampung, dan konfigurasi ini juga bukan ambang minimum untuk sembarang kombinasi parameter.
- Tidak ada jaminan bisa menjalankan 1M penuh. Kartu model menyatakan konteks maksimum 1.048.576 token, tetapi panjang yang tersedia pada konfigurasi layanan tertentu harus dihitung terpisah. Contoh vLLM hanya membuka 131.072, dan kedua dokumen tidak menjanjikan 1M penuh bisa dipakai.
- Angka dari kedua vendor tidak bisa saling dipakai. Referensi memori GPU yang diberikan dokumentasi vLLM hanya berlaku untuk konfigurasi vLLM tersebut.
2.2 Hubungan 770B, 49B, dan Memori GPU
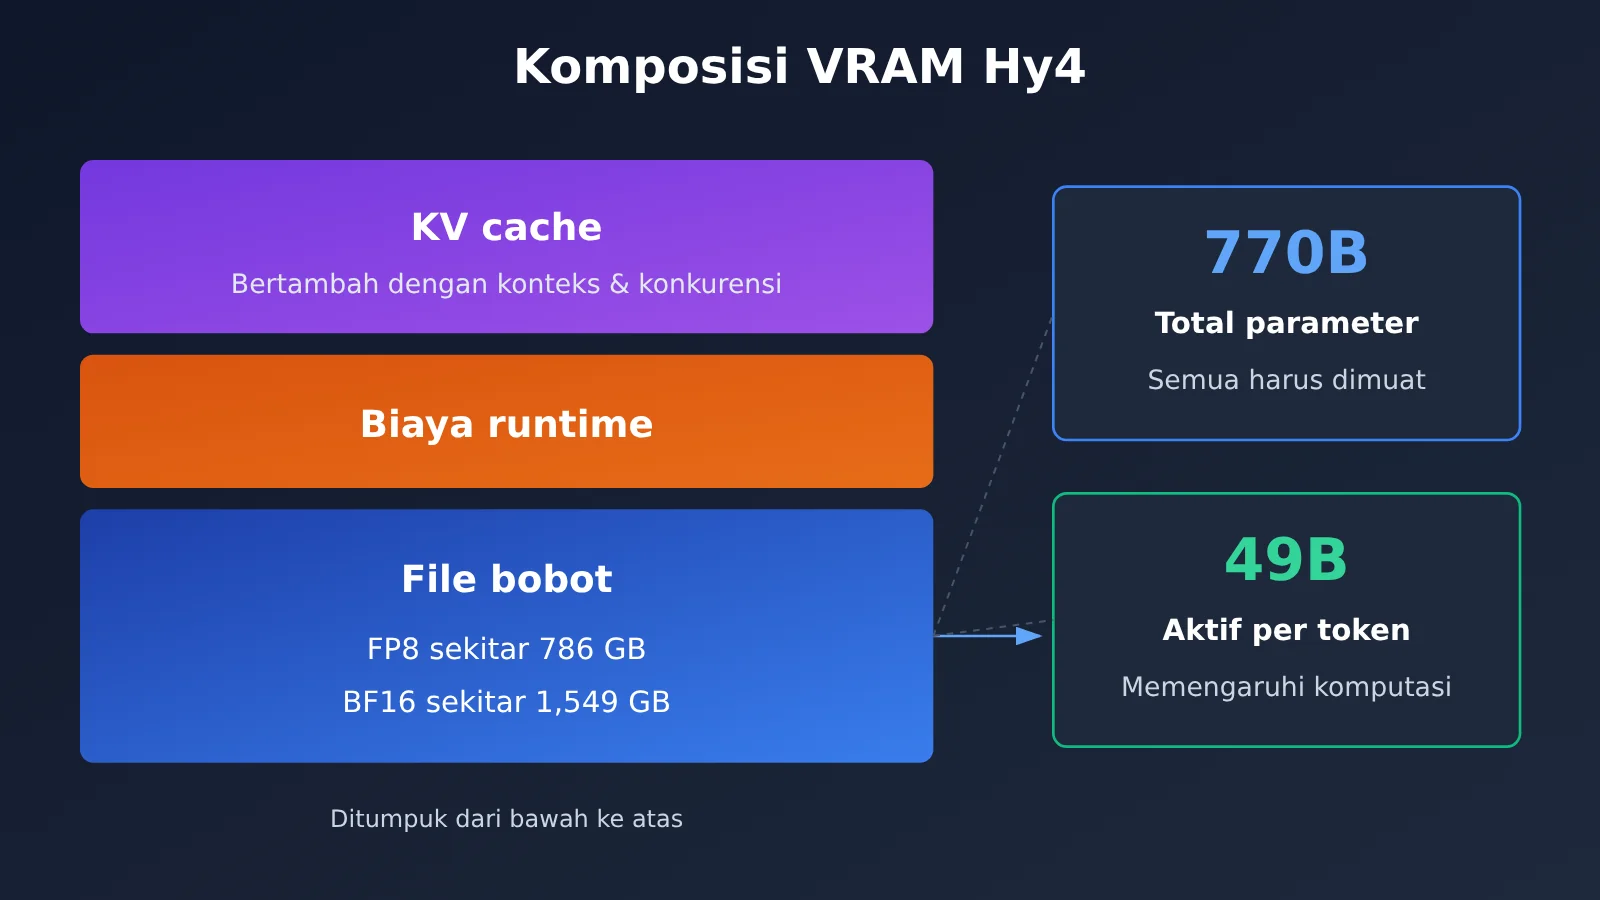
Hy4 sering disebut dengan dua angka: 770B adalah total parameter backbone bahasa, sedangkan 49B adalah jumlah parameter teks yang diaktifkan per token. Banyak orang salah membaca 49B sebagai kebutuhan memori GPU — itu keliru. 49B menentukan jumlah komputasi per token; untuk bisa memanggil expert mana pun kapan saja, seluruh 770B parameter harus dimuat ke memori GPU.
Kebutuhan memori GPU perlu dilihat dalam tiga lapisan:
- Ukuran file bobot: menurut dokumentasi vLLM, sekitar 786 GB untuk FP8 dan sekitar 1.549 GB untuk BF16. Ini pertama-tama soal kapasitas disk dan bandwidth pemuatan.
- Memori GPU saat runtime: referensi memori GPU pada contoh vLLM sekitar 944 GB (FP8) dan 1.859 GB (BF16), lebih besar dari ukuran file karena sudah mencakup overhead runtime dan reservasi KV cache.
- KV cache dan konkurensi: semakin panjang konteks dan semakin banyak permintaan yang dilayani bersamaan, semakin besar pemakaian KV cache. Bagian inilah yang menentukan berapa banyak trafik yang bisa dilayani setelah model “muat” di perangkat keras yang sama.
Sebelum deployment, Anda bisa memeriksa daftar berikut:
- [ ] Model, jumlah, dan memori per kartu GPU yang tersedia — apakah bisa membentuk TP4 atau TP8
- [ ] Apakah interkoneksi antar-GPU memenuhi kebutuhan komunikasi paralelisasi tensor
- [ ] Apakah penyimpanan lokal bisa menampung bobot sekitar 786 GB (FP8) atau sekitar 1.549 GB (BF16), beserta kecepatan pemuatannya
- [ ] Panjang konteks target: apakah 131K sudah cukup, atau harus lebih panjang
- [ ] Jumlah konkurensi puncak, dan apakah pool KV cukup pada tingkat konkurensi tersebut
- [ ] Apakah perlu input visual (contoh vLLM hanya mengaktifkan satu gambar)
- [ ] Versi framework inferensi yang dipilih, apakah sesuai dengan cookbook atau recipe resmi
3. Menghitung biaya Hy4 dengan kumpulan tugas yang sama
3.1 Algoritma penagihan API sesuai pemakaian
Dengan mengambil contoh halaman model APIYI: per 21 November 2026, ID model versi resmi Hy4 adalah hy4, menyediakan dua grup, Default dan SVIP, serta menggunakan antarmuka Chat Completions. Harga yang tercantum dihitung per juta token: input tanpa cache $0.85, output $2.55, baca cache $0.045; biaya yang benar-benar ditagih mengikuti konsol. Perlu dicatat bahwa APIYI sudah menayangkan Hy4 lebih awal daripada rilis bobot kali ini; pengumuman menyebut dukungan visual, tetapi contoh perhitungan di bawah hanya memakai asumsi teks murni, dan tidak menganggap kemampuan konteks 1M, video, atau Computer Use di kartu model setara dengan performa terukur layanan terkelola.
Saat penagihan, tiga jenis token dihitung masing-masing dan tidak saling tumpang tindih: token input yang sama dihitung sebagai input tanpa cache atau baca cache, tidak ditagih di kedua sisi. Berikut adalah contoh perhitungan hipotetis, bukan hasil pengukuran:
| Item | Asumsi penggunaan | Harga satuan (per juta) | Biaya |
|---|---|---|---|
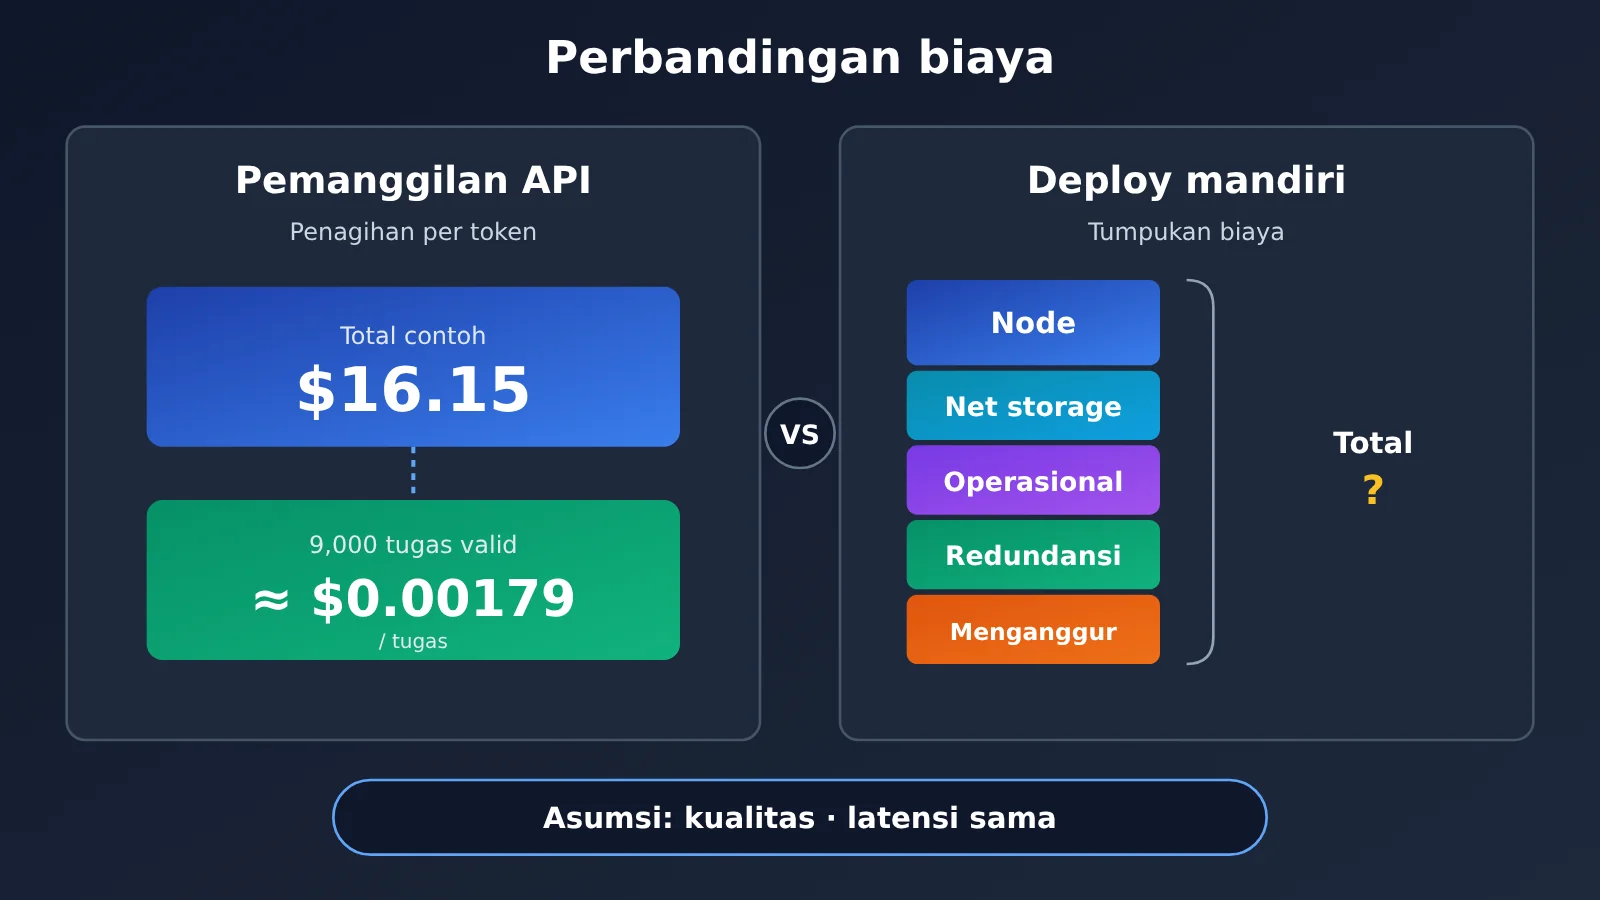
| Input tanpa cache | 10 juta token | $0.85 | $8.50 |
| Output | 3 juta token | $2.55 | $7.65 |
| Baca cache | 0 | $0.045 | $0 |
| Total | — | — | $16.15 |
Jika dari kumpulan panggilan ini ada 9,000 hasil yang lolos penerimaan Anda, maka biaya per tugas yang lolos sekitar $16.15 ÷ 9,000 ≈ $0.00179. Sebaiknya ukur dengan “biaya per tugas yang lolos”, bukan “biaya per panggilan”, karena biaya percobaan ulang yang gagal dan pengerjaan ulang juga harus dimasukkan. Angka ini juga perlu dicatat bersama latensi yang teramati secara aktual dan konkurensi yang mampu ditangani; jika tidak, tidak akan bisa dibandingkan dengan opsi penerapan mandiri.
3.2 Komposisi biaya nyata penerapan mandiri
Biaya penerapan mandiri jauh lebih dari sekadar GPU. Tabel berikut mencantumkan berbagai item yang perlu diperhitungkan:
| Item biaya | Rincian |
|---|---|
| Node komputasi | Biaya pembelian atau penyewaan node GPU kelas atas dengan 4 atau 8 kartu |
| Penyimpanan dan jaringan | Penyimpanan bobot berukuran mendekati TB, bandwidth pemuatan, interkoneksi antarkartu dan antar-node |
| Operasi dan pemeliharaan | Tenaga kerja untuk peningkatan framework inferensi, pemantauan dan peringatan, serta penanganan gangguan |
| Redundansi | Node cadangan yang disiapkan untuk menjaga ketersediaan, yang pada kondisi normal mungkin menganggur |
| Utilisasi | Biaya menganggur selama periode lalu lintas rendah, yang langsung menaikkan harga satuan per tugas |
Saat membandingkan kedua opsi, lakukan dengan asumsi kualitas dan latensi yang sama: gunakan kumpulan tugas yang sama dan standar penerimaan yang sama, lalu hitung biaya per tugas yang lolos untuk masing-masing opsi pada target latensi dan konkurensi yang serupa. Karena harga perangkat keras, tingkat utilisasi, dan biaya tenaga kerja sangat bervariasi antar tim, artikel ini tidak memberikan “titik impas” yang seragam. Anda perlu menghitungnya dengan penawaran harga dan kurva lalu lintas Anda sendiri.
4. Keputusan Deployment Hy4: API, Self-Deployment, atau Beralih ke Model Lebih Kecil
Menggabungkan kesimpulan dari tiga bagian sebelumnya, kita dapat membaginya menjadi tiga jalur berdasarkan kondisi:
- Kepatuhan mengizinkan + tugas teks murni untuk percobaan awal → gunakan API. Tidak perlu menyiapkan perangkat keras; gunakan dulu tugas nyata untuk menghitung biaya dan latensi per tugas yang lolos sebagai garis dasar untuk keputusan berikutnya.
- Butuh isolasi data yang kuat, atau memang perlu mengontrol konfigurasi inferensi sendiri → inventarisasi perangkat keras lalu self-deployment dan validasi. Cocokkan dulu inventaris sumber daya dengan daftar periksa di bagian 2.2, jalankan konfigurasi contoh SGLang atau vLLM hingga berhasil, lalu bandingkan kualitas, latensi, dan biaya menggunakan kumpulan tugas yang sama seperti pada API. Sebelum menyediakan layanan ke publik, minta tim legal memeriksa bagian 10 lisensi.
- Sumber daya tidak mencapai skala contoh → evaluasi ulang model yang lebih kecil. Ketika tidak bisa mengumpulkan 4 atau 8 GPU kelas atas, memaksakan pemangkasan konteks atau konkrensi kemungkinan besar tidak akan mencapai target kualitas dan latensi; beralih ke model yang lebih kecil biasanya lebih realistis.
Kartu Aksi
- Tetapkan bobot: untuk deployment inferensi gunakan
Hy4-FP8, jika perlu melanjutkan pelatihan gunakanHy4-base, dan pastikan yang dipakai bukan flash. - Siapkan 200~500 tugas nyata, tulis kriteria penerimaan dengan jelas.
- Jika data diizinkan untuk dikirim ke luar, jalankan dulu dengan API; jika tidak, uji dulu menggunakan sampel publik atau sintetis, dan simpan data nyata di lingkungan internal. Catat penggunaan token, tingkat kelulusan, latensi, dan performa konkrensi.
- Jika perlu self-deployment, inventarisasi perangkat keras sesuai daftar periksa, lalu uji ulang dengan kumpulan tugas yang sama.
- Gunakan satu metrik tunggal “biaya per tugas yang lolos + latensi” untuk membuat keputusan akhir.
Referensi
- Pengumuman resmi peluncuran Tencent Hy4: https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/
- Bobot Hy4 Instruct (BF16): https://huggingface.co/tencent/Hy4
- Bobot Hy4 Instruct (FP8): https://huggingface.co/tencent/Hy4-FP8
- Bobot Hy4 Base: https://huggingface.co/tencent/Hy4-base
- Tencent Hy License 1.0: https://huggingface.co/tencent/Hy4/blob/main/LICENSE
- Hy4 Preview (Apache 2.0): https://huggingface.co/tencent/Hy4-preview
- Cookbook SGLang untuk Hy4: https://docs.sglang.io/cookbook/autoregressive/Tencent/Hy4
- Resep vLLM untuk Hy4: https://recipes.vllm.ai/tencent/Hy4
- Penjelasan peluncuran Hy4 di APIYI: https://docs.apiyi.com/news/hy4-launch
- Daftar model APIYI (Tencent): https://docs.apiyi.com/models#腾讯
- Ulasan latar belakang Hy4 (snapshot historis; informasi bobot dan ketersediaan mengacu pada artikel ini): https://help.apiyi.com/tencent-hy4-770b-vision-computer-use-pricing.html