要約:Hy4 の正式版の重みが公開されました。本記事では、どの重みを使うべきか、セルフデプロイにどの規模の GPU が必要か、そして API を直接呼び出すコストとどう公平に比較すればよいかを整理します。
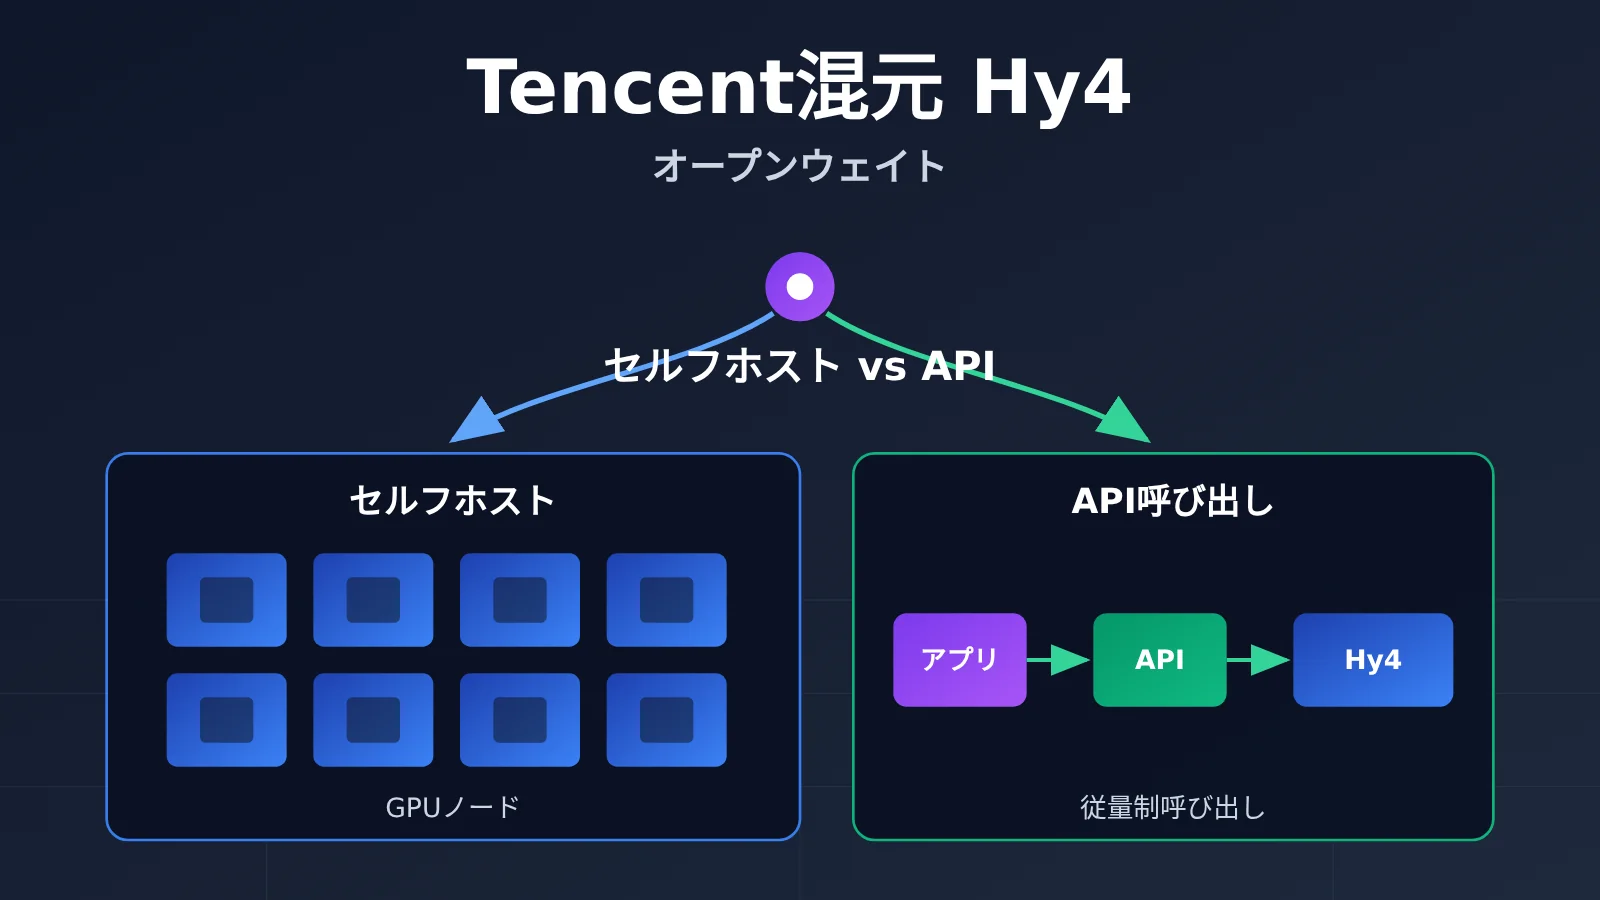
結論から先に:コンプライアンス上問題がなく、まず純粋なテキストタスクを試したいのであれば、API を直接呼び出すのが最もハードルが低い方法です。自前でデプロイする価値があるのは、強力なデータ分離が必要な場合、あるいは推論設定を自分で制御したい場合に限られます。セルフデプロイの出発点は低くありません。公式の推論フレームワークが示す FP8 のサンプル設定は、B300/GB300 を 4 枚、または H200/B200 を 8 枚というレベルです。また、これらのサンプルはあらゆる構成における最低要件ではなく、1M コンテキストを使い切れることを保証するものでもありません。手元のリソースがそこまで達しない場合は、無理に Hy4 を動かすよりも、より小さなモデルを再検討したほうがよいでしょう。
Hy4 オープンウェイトの知識マップと読む順序
| 番号 | まず見るもの | なぜ先に見るのか | 読むと得られるもの |
|---|---|---|---|
| 1 | バージョンと重みの選択 | 重みを間違えると、以降のハードウェア試算がすべて無駄になる | Instruct BF16、Instruct FP8、Base のどれを使うかを確定できる |
| 2 | デプロイに必要な GPU 枚数 | ハードウェアはセルフデプロイ最大のハードル | ハードウェア対照表とチェックリスト |
| 3 | 同一タスク群のコスト | 同じ品質・同じレイテンシでの比較でなければ意味がない | API の 1 タスクあたりコストの算出方法と、セルフデプロイコストの構成項目 |
| 4 | 意思決定 | 前三節の結論を自分のシナリオに落とし込む | API を選ぶか、セルフデプロイで検証するか、より小さなモデルに切り替えるか |
1→2→3 は段階的な関係です。バージョンが重みファイルを決め、重みファイルがハードウェアを決め、ハードウェアがコストを決めます。第 4 節では前三節の判断をまとめます。コストだけが気になる読者は、第 3 節から読み始めても構いません。
To Know:Hy4 のデプロイを理解するための用語
| 用語 | かんたんな説明 |
|---|---|
| オープンウェイト | モデルのパラメータファイルをダウンロードして自前でデプロイできる。利用条件はライセンスで規定される |
| Instruct / Base | Instruct は指示チューニング済みで、そのまま対話に使えるバージョン。Base は事前学習済みのベースモデルで、継続学習に向く |
| BF16 / FP8 | パラメータの数値精度。FP8 は 1 パラメータあたり約 1 バイト、BF16 は約 2 バイト |
| TP(テンソル並列) | 1 つのモデルを複数の GPU に分割して協調計算する方式。TP8 は 8 分割を意味する |
| KV cache | 推論時にコンテキスト用に保持する中間状態。コンテキスト長と同時実行数に応じて増える |
| キャッシュ読み | API 課金のうち、プロンプトキャッシュにヒットした入力トークン。単価は未キャッシュ入力より低い |
1. Hy4 のバージョンとオープンウェイトの選び方
1.1 Hy4 の3つのタイムライン
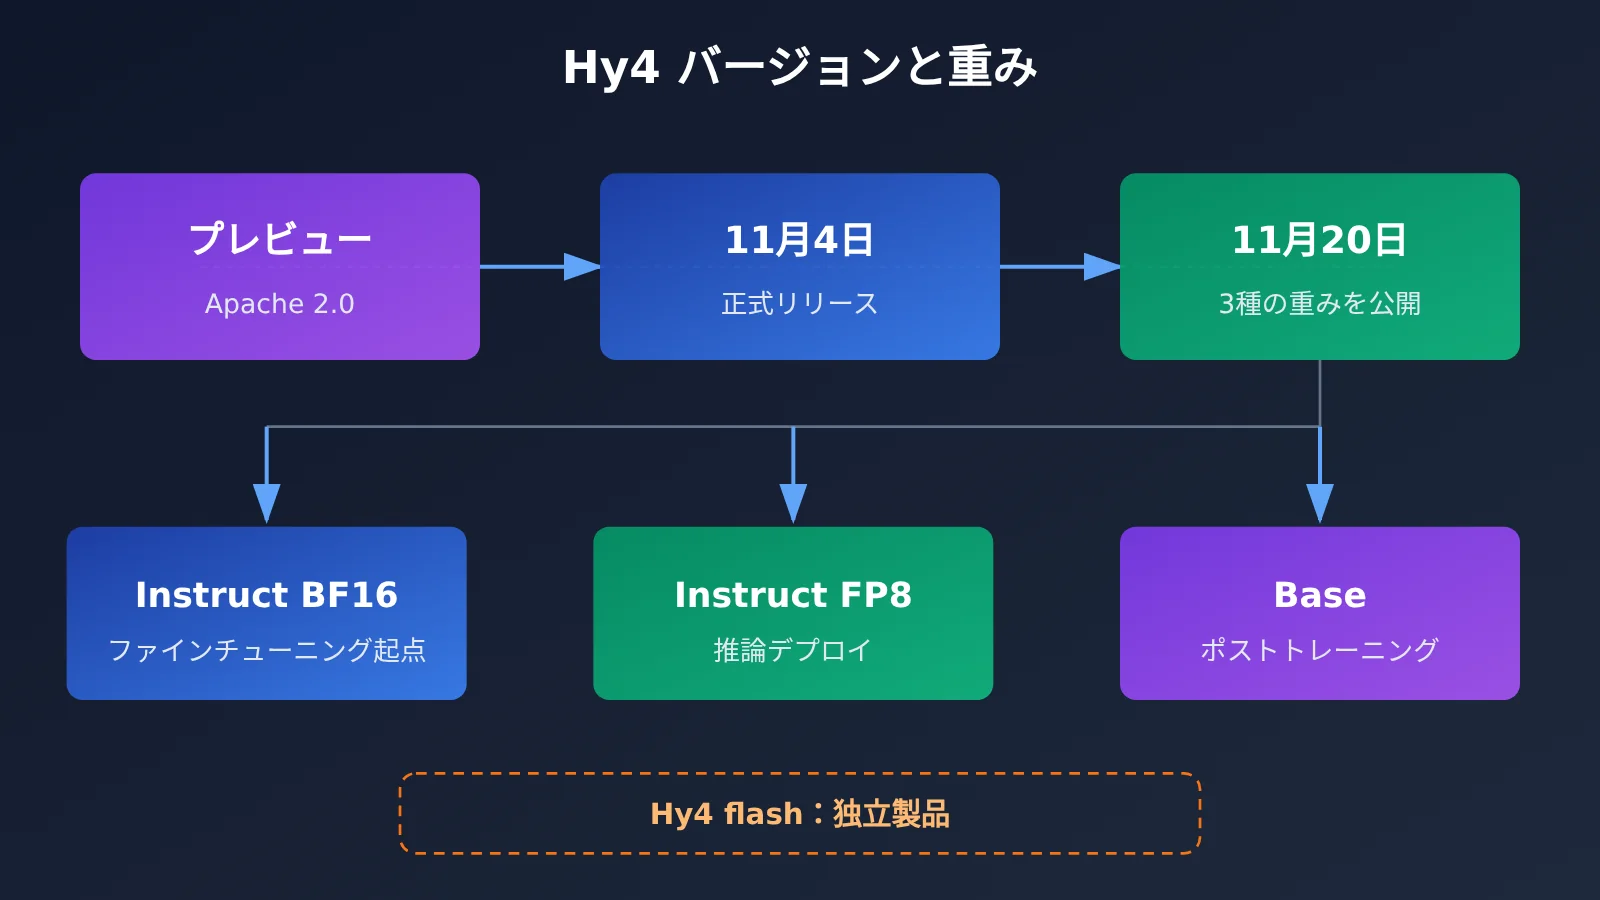
Hy4 の公開プロセスは3段階に分かれています。最初に公開されたのは Preview 版で、Hugging Face の tencent/Hy4-preview ページでリリースされ、ライセンスは Apache 2.0 です。2026年11月4日、Tencent は公式リリースを発表し、Hy4 の正式サービス開始を告知しました。11月20日には、正式版の3セットのウェイトが Hugging Face で公開されました。
これら3つのタイミングの違いは、選択に直接影響します。Preview 版と正式版ではライセンスが異なります。正式版は Tencent Hy License 1.0 を採用しており、その第10節では、外部に提供される一部の汎用推論サービスに対して追加条件を定めています。Hy4 を外部向けサービスとしてデプロイする予定がある場合は、法務チームにライセンス原文と照らし合わせて独自に判断してもらってください。本記事は、特定企業の具体的な対応について法的な結論を示すものではありません。
1.2 Hy4 の3セットの正式ウェイトの適用条件
| ウェイトリポジトリ | 内容 | 適用条件 |
|---|---|---|
tencent/Hy4 |
Instruct、BF16 | 最高の数値精度が必要な場合、またはファインチューニングや量子化の起点として使う場合。VRAM 要件が最も高い |
tencent/Hy4-FP8 |
Instruct、FP8 | 推論デプロイにそのまま使う場合。SGLang と vLLM のサンプル設定はいずれもこれをベースにしている |
tencent/Hy4-base |
事前学習済み Base | 自分でポストトレーニングやドメイン継続学習を行う場合。そのまま対話に使うのには向かない |
特に区別すべきなのは、Hy4 の正式版は Hy4 flash とイコールではないという点です。後者は独立した製品ラインです。本記事で扱うハードウェアとコストは正式版のみを対象としており、flash に当てはめることはできません。
2. Hy4 を自前でデプロイするには何枚の GPU が必要か
2.1 SGLang と vLLM のサンプル構成を比較する
代表的な2つの推論フレームワークは、いずれも Hy4 のデプロイ例を公開しています。以下に並べてみましょう。
| フレームワーク | 重み精度 | 並列方式 | サンプル GPU | サンプル構成の説明 |
|---|---|---|---|---|
| SGLang | FP8 | TP4 | 4×B300 または 4×GB300 | KV プールのサイズが、実際に利用できるコンテキスト容量を決める |
| SGLang | FP8 | TP8 | 8×H200 または 8×B200 | 同上 |
| vLLM | FP8(デフォルト) | TP8 | 8×B300 | サンプルのコンテキストウィンドウは 131,072。単一画像のみ対応、動画は無効 |
この表を読む際には、3つの点に注意してください。
- これらはサンプル構成であり、最低構成ではありません。SGLang のドキュメントでは、KV プールが実際に収容できるコンテキストを制限すること、およびこれらの構成がどのパラメータの組み合わせにおいても最低ラインを示すものではないことが説明されています。
- 1M まで使い切れる保証はありません。モデルカードが宣言する最大コンテキストは 1,048,576 トークンですが、実際のサービス構成で利用可能な長さは別途計算する必要があります。vLLM のサンプルは 131,072 までしか設定されておらず、両方のドキュメントとも 1M がフルに使えるとは明言していません。
- 両者の数値を互いに当てはめることはできません。vLLM のドキュメントが示す参考メモリ量は、あくまで vLLM のこの構成にのみ当てはまるものです。
2.2 770B・49B と GPU メモリの関係
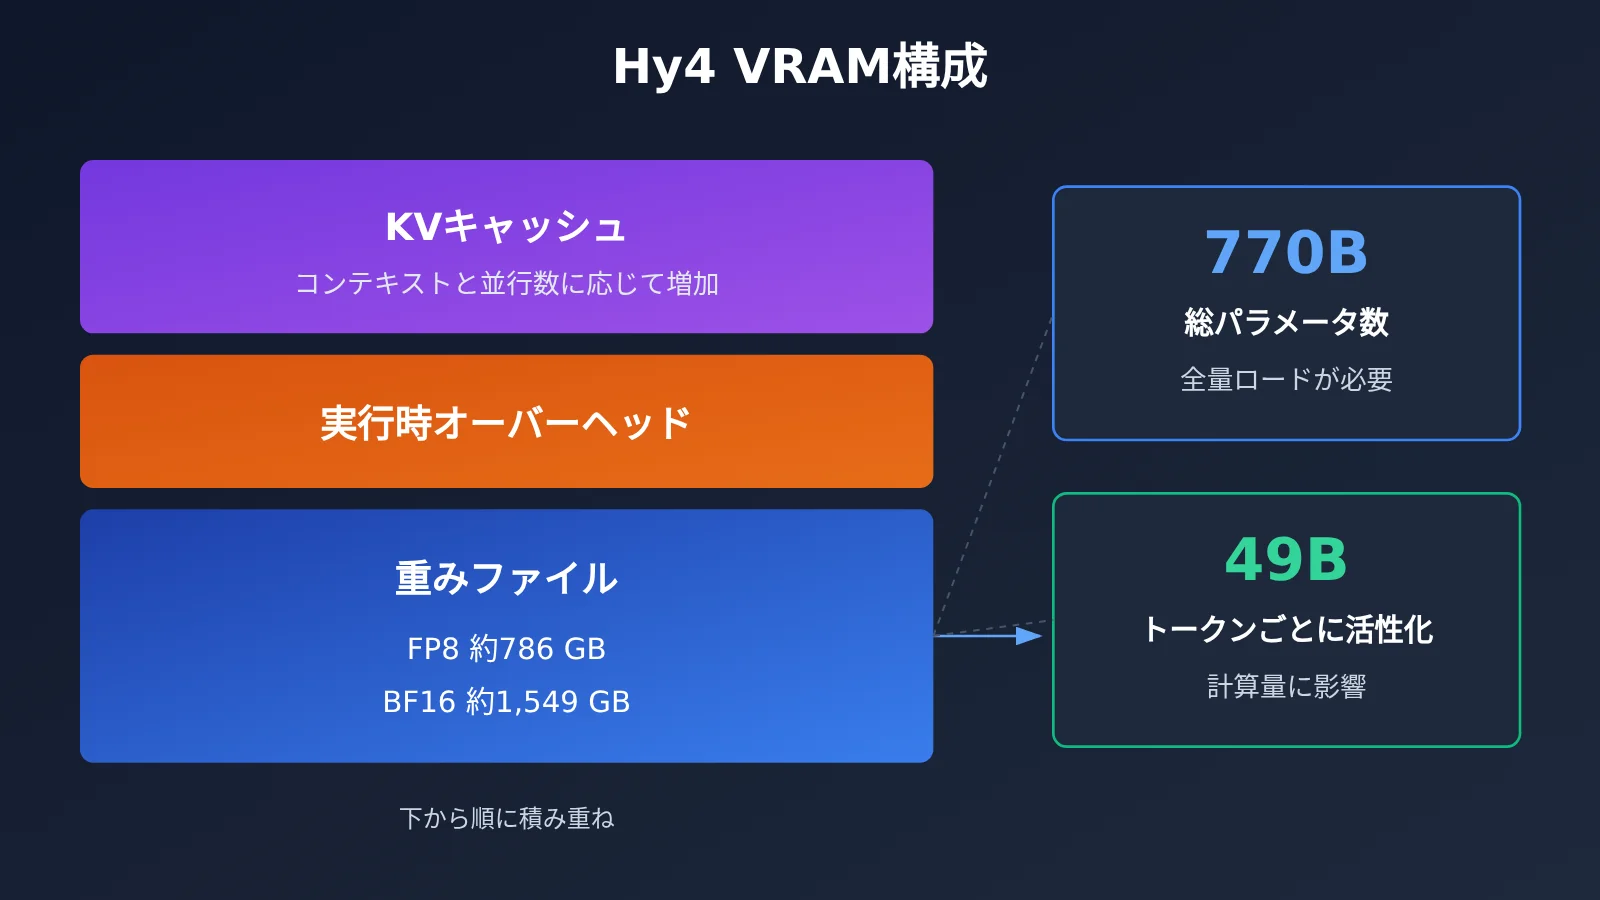
Hy4 ではよく2つの数字が挙げられます。770B は言語バックボーンの総パラメータ数、49B はトークンあたりにアクティベートされるテキストパラメータ数です。49B をそのまま GPU メモリ要件と読み取ってしまう人が多くいますが、これは誤りです。49B が決めるのはトークンあたりの計算量であり、任意のエキスパートをいつでも呼び出せるようにするには、770B のパラメータすべてを GPU メモリに読み込む必要があります。
GPU メモリ要件は3つの層に分けて考えます。
- 重みファイルのサイズ:vLLM のドキュメントによると、FP8 で約 786 GB、BF16 で約 1,549 GB です。これはまずディスク容量と読み込み帯域の問題になります。
- 実行時の GPU メモリ:vLLM のサンプルにおける参考メモリ量は約 944 GB(FP8)と約 1,859 GB(BF16)で、ファイル自体より大きくなります。実行時のオーバーヘッドと KV キャッシュの確保分も含まれるためです。
- KV キャッシュと同時実行数:コンテキストが長くなるほど、同時に処理するリクエストが増えるほど、KV キャッシュの占有量は大きくなります。この部分が、同じハードウェアで「モデルを載せたうえで」どれだけのトラフィックを処理できるかを決めます。
デプロイ前に、次のチェックリストで確認しておくとよいでしょう。
- [ ] 利用可能な GPU の型番・枚数・単カードあたりのメモリで、TP4 または TP8 を構成できるか
- [ ] カード間インターコネクトがテンソル並列の通信要件を満たしているか
- [ ] ローカルストレージに約 786 GB(FP8)または約 1,549 GB(BF16)の重みを収容できるか、またその読み込み速度は十分か
- [ ] 目標とするコンテキスト長:131K で足りるのか、それともより長い必要があるのか
- [ ] ピーク時の同時実行数と、その同時実行数で KV プールが足りるか
- [ ] 視覚入力が必要か(vLLM のサンプルは単一画像のみ有効)
- [ ] 選択した推論フレームワークのバージョンが、公式の cookbook や recipe と一致しているか
3. 同じタスクセットで Hy4 のコストを計算する
3.1 API 従量課金の計算方法
APIYI のモデルページを例にします。2026 年 11 月 21 日時点で、Hy4 正式版のモデル ID は hy4 で、Default と SVIP の 2 つのグループを提供し、Chat Completions インターフェースを採用しています。料金は 100 万 token あたりで計算され、未キャッシュ入力 $0.85、出力 $2.55、キャッシュ読み取り $0.045 です。実際の請求額はコンソールを基準とします。補足すると、APIYI が Hy4 を提供開始した時期は今回の重み公開より前です。アナウンスではビジョン対応が言及されていますが、以下の計算例は純粋なテキストのみを前提として計算しており、モデルカード上の 1M コンテキスト、動画、Computer Use の能力をホスティングサービスの実測パフォーマンスと同一視しているわけではありません。
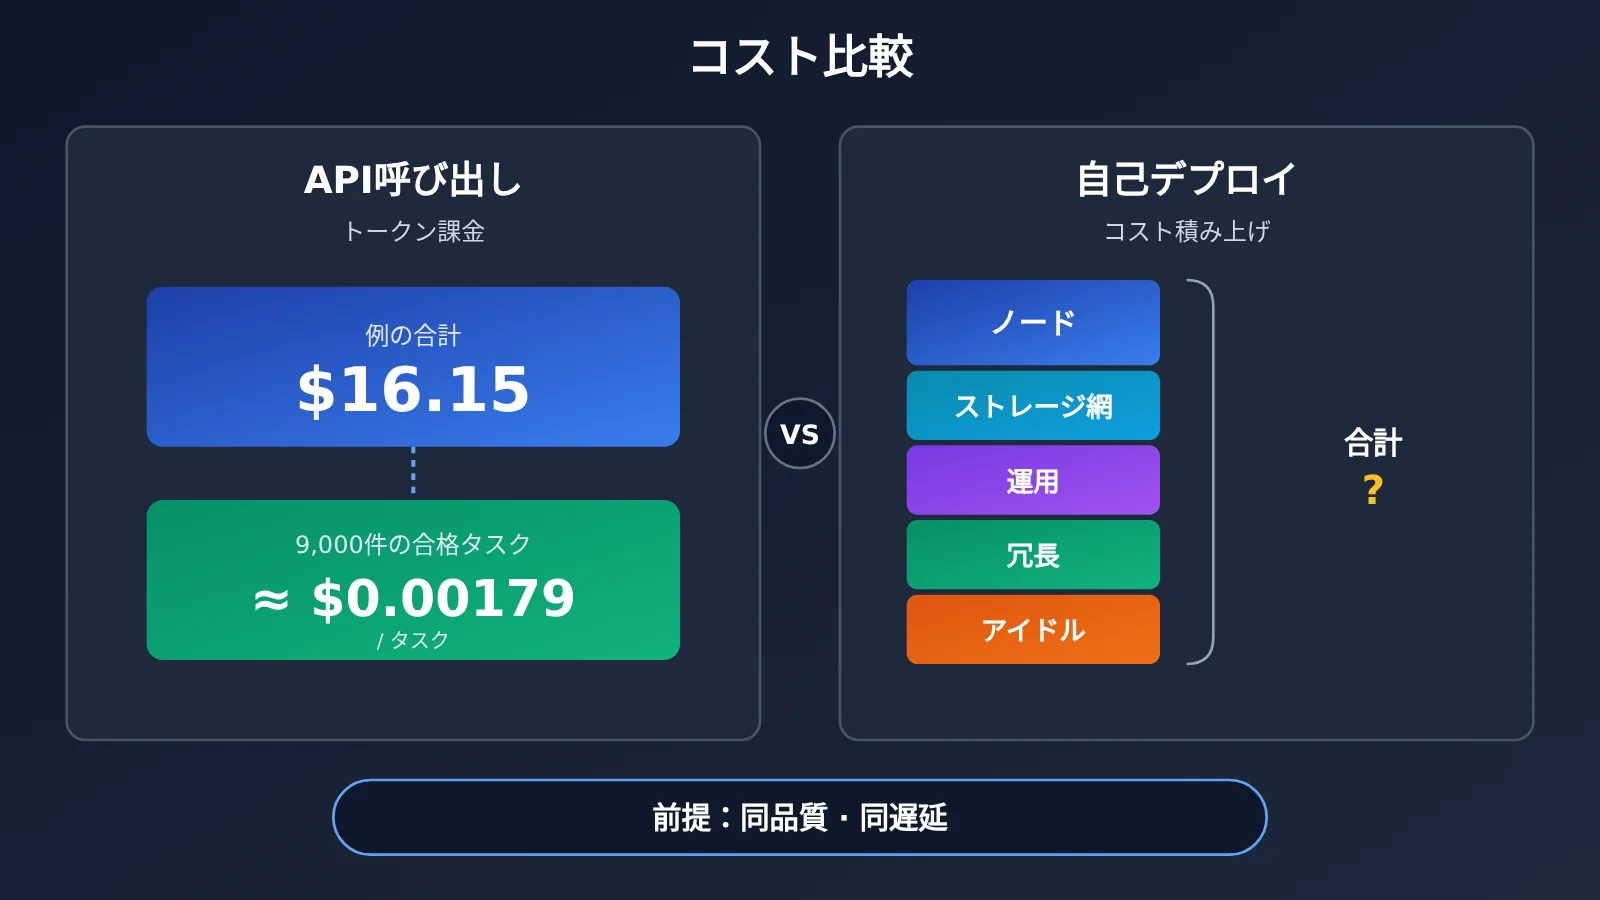
課金の際、3 種類の token はそれぞれ独立して計算され、重複はありません。同じ入力 token は、未キャッシュ入力として計算されるか、キャッシュ読み取りとして計算されるかのどちらかで、両方で請求されることはありません。以下は仮定に基づく計算例であり、実測ではありません。
| 項目 | 想定使用量 | 単価(100 万あたり) | 費用 |
|---|---|---|---|
| 未キャッシュ入力 | 1,000 万 token | $0.85 | $8.50 |
| 出力 | 300 万 token | $2.55 | $7.65 |
| キャッシュ読み取り | 0 | $0.045 | $0 |
| 合計 | — | — | $16.15 |
このバッチの呼び出しのうち 9,000 件の結果があなたの検収に合格したと仮定すると、合格タスク 1 件あたりのコストは約 $16.15 ÷ 9,000 ≈ $0.00179 になります。「呼び出し 1 回あたりのコスト」ではなく「合格タスク 1 件あたりのコスト」で測ることをおすすめします。失敗による再試行ややり直しの費用もすべて含めるべきだからです。この数値は、実際に観測されたレイテンシや許容できる同時実行数とあわせて記録する必要があります。そうしないと、セルフデプロイ方式と比較できません。
3.2 セルフデプロイの実際のコスト構成
セルフデプロイのコストは GPU そのものだけでは済みません。以下の表に、計上すべき各項目を示します。
| コスト項目 | 内容 |
|---|---|
| 計算ノード | 4 基または 8 基のハイエンド GPU ノードの購入費またはレンタル費 |
| ストレージとネットワーク | 数 TB 規模の重みストレージ、ロード帯域、GPU 間およびノード間の相互接続 |
| 運用 | 推論フレームワークのアップグレード、監視アラート、障害対応に必要な人的コスト |
| 冗長性 | 可用性を確保するために用意する予備ノード。通常はアイドル状態になっている可能性がある |
| 稼働率 | トラフィックが少ない時間帯のアイドルコスト。タスク単価を直接押し上げる |
2 つの方式を比較する際は、同等の品質と同等のレイテンシを前提に行う必要があります。同じタスクセット、同じ検収基準を使い、近いレイテンシと同時実行目標のもとで、それぞれ合格タスク 1 件あたりのコストを算出します。ハードウェアの価格、稼働率、人的コストはチームによって大きく異なるため、本記事では一律の「損益分岐点」を示しません。ご自身の見積もりとトラフィック曲線を使って計算してください。
4. Hy4 のデプロイ判断:API、セルフデプロイ、それとも小さいモデルへの切り替えか
前の 3 節の結論をまとめると、条件に応じて次の 3 つの道筋に分けられます。
- コンプライアンス上問題なく、まず純テキストのタスクを試す → API を利用。ハードウェアを用意する必要はありません。まず実際のタスクで「合格したタスクあたりのコストと遅延」を算出し、以降の判断のベースラインにします。
- 強力なデータ分離が必要、または推論設定を自分で制御したい → ハードウェアを棚卸ししてからセルフデプロイで検証。まず 2.2 節のチェックリストに沿ってリソースを棚卸しし、SGLang または vLLM のサンプル設定で動作確認したうえで、API と同じタスクセットを使って品質・遅延・コストを比較します。外部にサービスを提供する前に、法務にライセンス第 10 節の確認を依頼してください。
- リソースがサンプルの規模に届かない → より小さいモデルを再検討。ハイエンド GPU を 4 枚または 8 枚揃えられない場合、コンテキストや並列数を無理に圧縮しても品質と遅延の目標を達成できる可能性は低く、より小さいモデルに切り替えるほうが現実的です。
アクションカード
- 重みを選択:推論デプロイには
Hy4-FP8、継続学習が必要ならHy4-baseを使い、flash ではないことを確認します。 - 実タスクを 200~500 件用意し、受け入れ基準をまとめておきます。
- データの外部送信が許容される場合は、まず API で一通り実行します。そうでない場合は、まず公開データまたは合成サンプルでテストし、実データは内部環境に残します。token 使用量、合格率、遅延、並列性能を記録します。
- セルフデプロイが必要な場合は、チェックリストに沿ってハードウェアを棚卸しし、同じタスク群で再テストします。
- 「合格したタスクあたりのコスト + 遅延」という単一の基準で最終判断を行います。
参考資料
- テンセント Hy4 正式リリースのお知らせ: https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/
- Hy4 Instruct(BF16)の重み: https://huggingface.co/tencent/Hy4
- Hy4 Instruct(FP8)の重み: https://huggingface.co/tencent/Hy4-FP8
- Hy4 Base の重み: https://huggingface.co/tencent/Hy4-base
- Tencent Hy License 1.0: https://huggingface.co/tencent/Hy4/blob/main/LICENSE
- Hy4 Preview(Apache 2.0): https://huggingface.co/tencent/Hy4-preview
- SGLang Hy4 Cookbook: https://docs.sglang.io/cookbook/autoregressive/Tencent/Hy4
- vLLM Hy4 Recipe: https://recipes.vllm.ai/tencent/Hy4
- APIYI Hy4 提供開始の説明: https://docs.apiyi.com/news/hy4-launch
- APIYI モデル一覧(テンセント): https://docs.apiyi.com/models#腾讯
- Hy4 背景概要(過去のスナップショット。重みと掲載情報については本文を基準とします): https://help.apiyi.com/tencent-hy4-770b-vision-computer-use-pricing.html