Nota do autor: quando a sessão WebRTC do GPT-Live-1.1 entra em standby, o preço unitário da voz cai de US$ 0,05 por minuto para US$ 0,02. Este artigo mostra como configurar, como conferir a fatura e quanto uma ligação realmente economiza na prática.
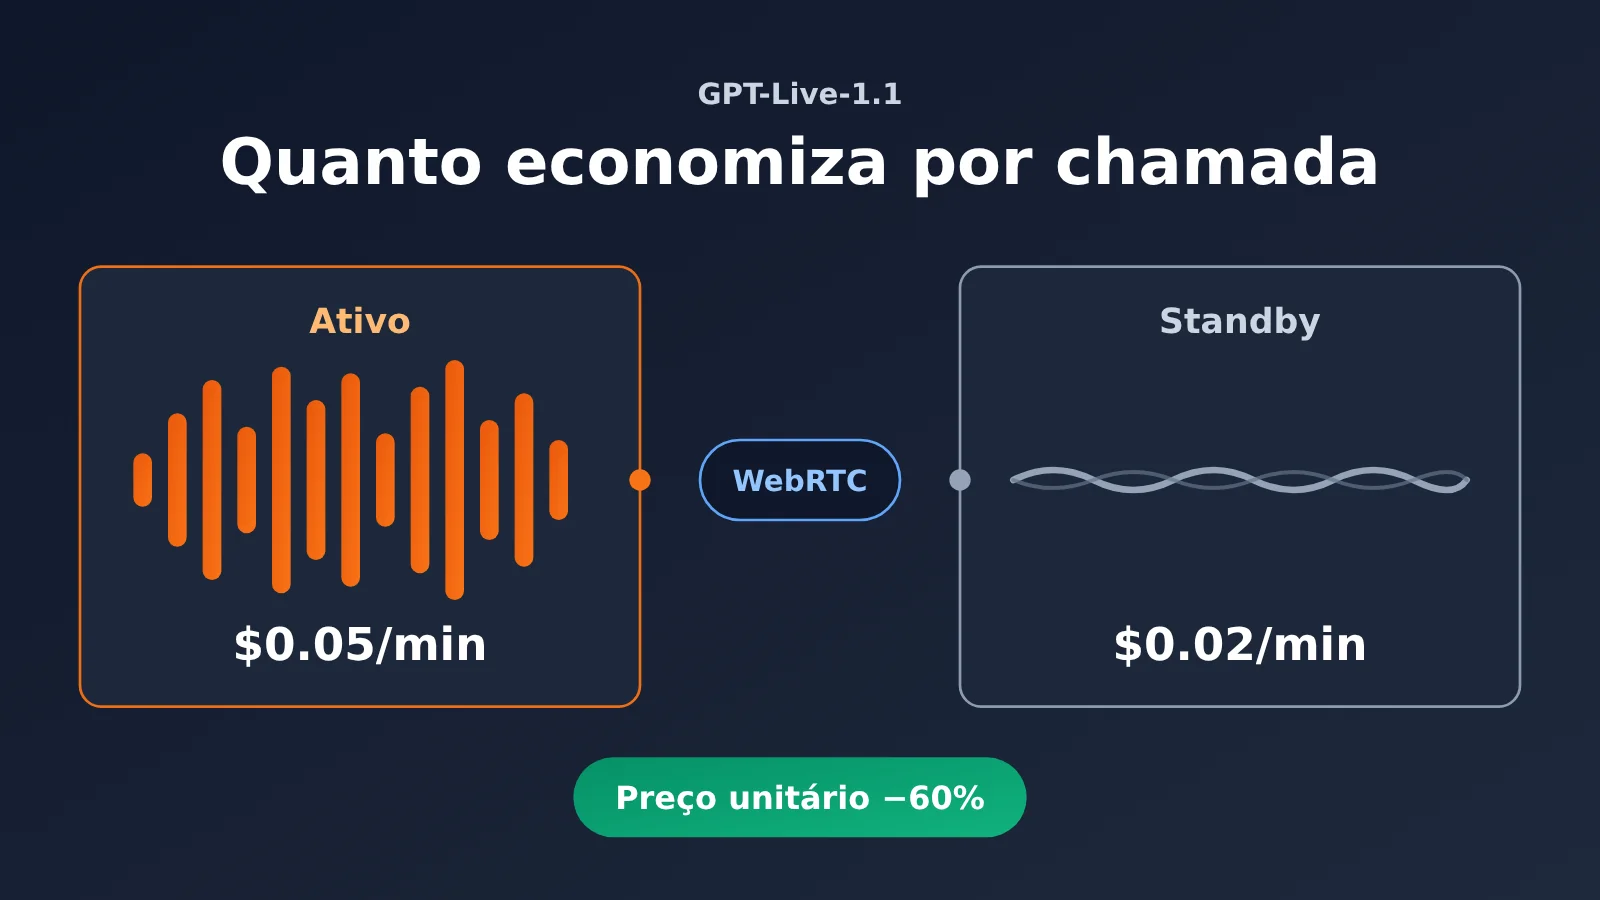
Resumo em uma frase: depois que a sessão WebRTC do GPT-Live-1.1 cumpre os requisitos e entra em standby, o preço da voz cai de US$ 0,05 por minuto para US$ 0,02. Quanto você economiza de fato depende de quanto tempo fica ativo e quanto tempo fica em standby — e também do consumo do modelo de backend e das ferramentas.
A conclusão tem pré-requisitos. Só em sessões WebRTC com standby configurado e inferência pausada é possível obter o preço de standby de US$ 0,02 por minuto. Dentro dessa premissa, a proporção de economia é mais ou menos «proporção de tempo em standby × 60%». Se a sessão tem alguém falando o tempo todo, ou se o transporte é WebSocket ou a conexão principal via SIP, esse desconto praticamente não se aplica. Além disso, a inferência de backend e as chamadas de ferramentas são cobradas à parte — em ligações longas, essa fatia costuma sair mais cara que a própria tarifa de voz.
Este não é um resumo apressado de uma tabela de preços. A seguir eu destrincho as condições de cobrança e os campos de configuração com base na documentação oficial da OpenAI, e apresento um método de cálculo que dá para conferir na fatura. Todos os exemplos de cenário citados aqui são hipotéticos, servem apenas para ilustrar a forma de cálculo e não representam uma fatura real.
Termos de standby via WebRTC do GPT-Live-1.1 (Para conhecer)
Vamos alinhar alguns termos primeiro. A cobrança e a configuração usadas mais adiante seguem estas definições:
- WebRTC: conjunto de tecnologias de comunicação para transmitir mídia, como áudio, em tempo real entre navegadores e dispositivos. É também a única forma de transporte aplicável ao standby nativo do GPT-Live.
- WebSocket: uma conexão bidirecional persistente. A aplicação pode usá-la para transmitir áudio, eventos de sessão ou mensagens de controle sideband.
- SIP: protocolo comum em redes telefônicas para estabelecer e controlar sessões. O acesso telefônico do GPT-Live usa esse caminho.
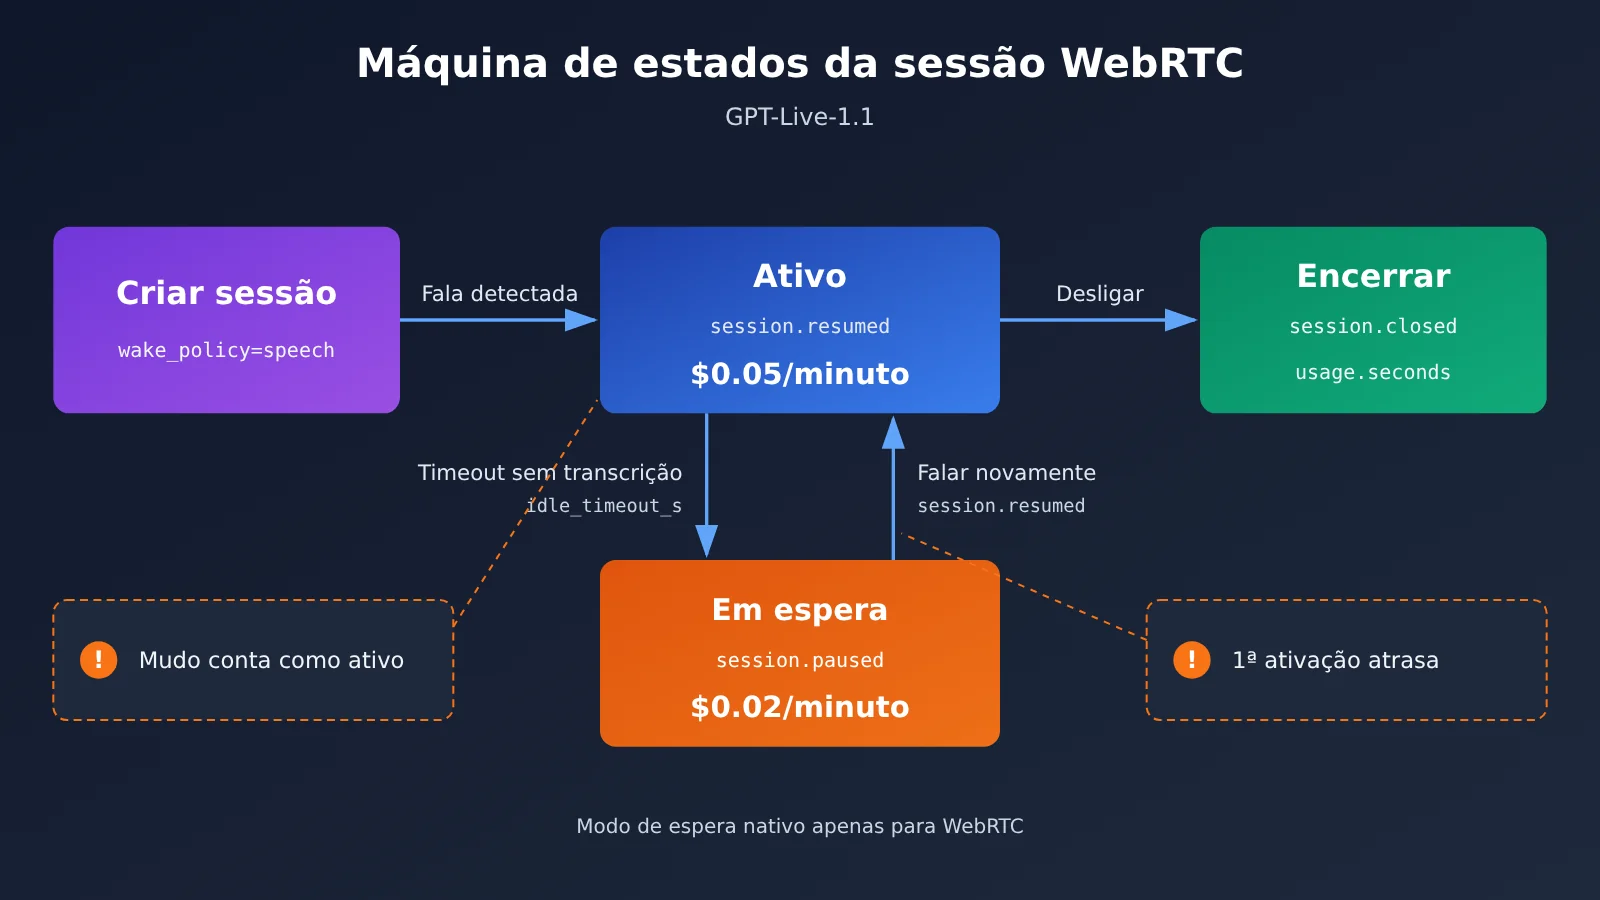
- Standby: neste artigo, refere-se especificamente ao estado de cobrança em que uma sessão WebRTC que atende aos requisitos permanece conectada, mas a inferência é interrompida.
- Tempo ativo: fase cobrada pela tarifa de atividade, que pode incluir o período de silêncio antes de a condição de pausa ser atingida.
- Ativação por voz: quando o serviço detecta que alguém está falando e começa ou retoma a inferência.
- Limite de inatividade: define após quanto tempo sem fala a sessão entra em standby; é configurável.
- Conexão sideband: conexão separada da conexão principal de voz, usada para controle do servidor e monitoramento de eventos; a forma mais comum é um WebSocket sideband.
Principais pontos do standby via WebRTC do GPT-Live-1.1
| Ponto | Descrição | Valor para desenvolvedores |
|---|---|---|
| Duas faixas de preço | Ativo a $0.05/minuto; standby via WebRTC elegível a $0.02/minuto (OpenAI Pricing) | Preço por minuto 60% menor nos períodos de silêncio |
| Cobrança por segundo | As duas faixas são cobradas por segundo, sem arredondar para o minuto cheio | Pausas curtas também entram na economia |
| Somente WebRTC | O standby de baixo custo nativo só vale para sessões WebRTC configuradas para standby e com inferência pausada | O custo já precisa entrar na escolha do transporte |
| Backend à parte | O uso do modelo de backend e das ferramentas é cobrado separadamente | O standby otimiza apenas um item da fatura |
| Latência do primeiro turno | Depois de acordar do standby, a primeira resposta a uma fala curta pode demorar mais | É preciso ponderar custo e experiência |
Entendendo o denominador dos 60% do standby do GPT-Live-1.1 na tabela de cobrança
Antes de tudo, a referência de data. O OpenAI API Changelog registra esta atualização em 2026-11-19, enquanto a página de anúncio de lançamento na comunidade de desenvolvedores da OpenAI mostra 2026-11-20. A diferença de um dia provavelmente vem de fusos horários diferentes; sempre que este artigo mencionar datas, indicamos a fonte. De acordo com a página OpenAI Pricing, a voz ativa dos dois modelos GPT-Live custa $0.05/minuto, e o standby via WebRTC elegível custa $0.02/minuto, com cobrança por segundo; o uso do modelo de backend e das ferramentas é cobrado à parte.
A ideia de “redução de 60%” costuma ser mal interpretada como “economia de 60% na ligação inteira”. O denominador dos 60% é o preço por minuto ativo: (0.05 − 0.02) ÷ 0.05 = 60%; isso descreve apenas a queda do preço por minuto depois de entrar em standby. A porcentagem de economia da ligação inteira ainda precisa ser multiplicada pela proporção do tempo em standby.
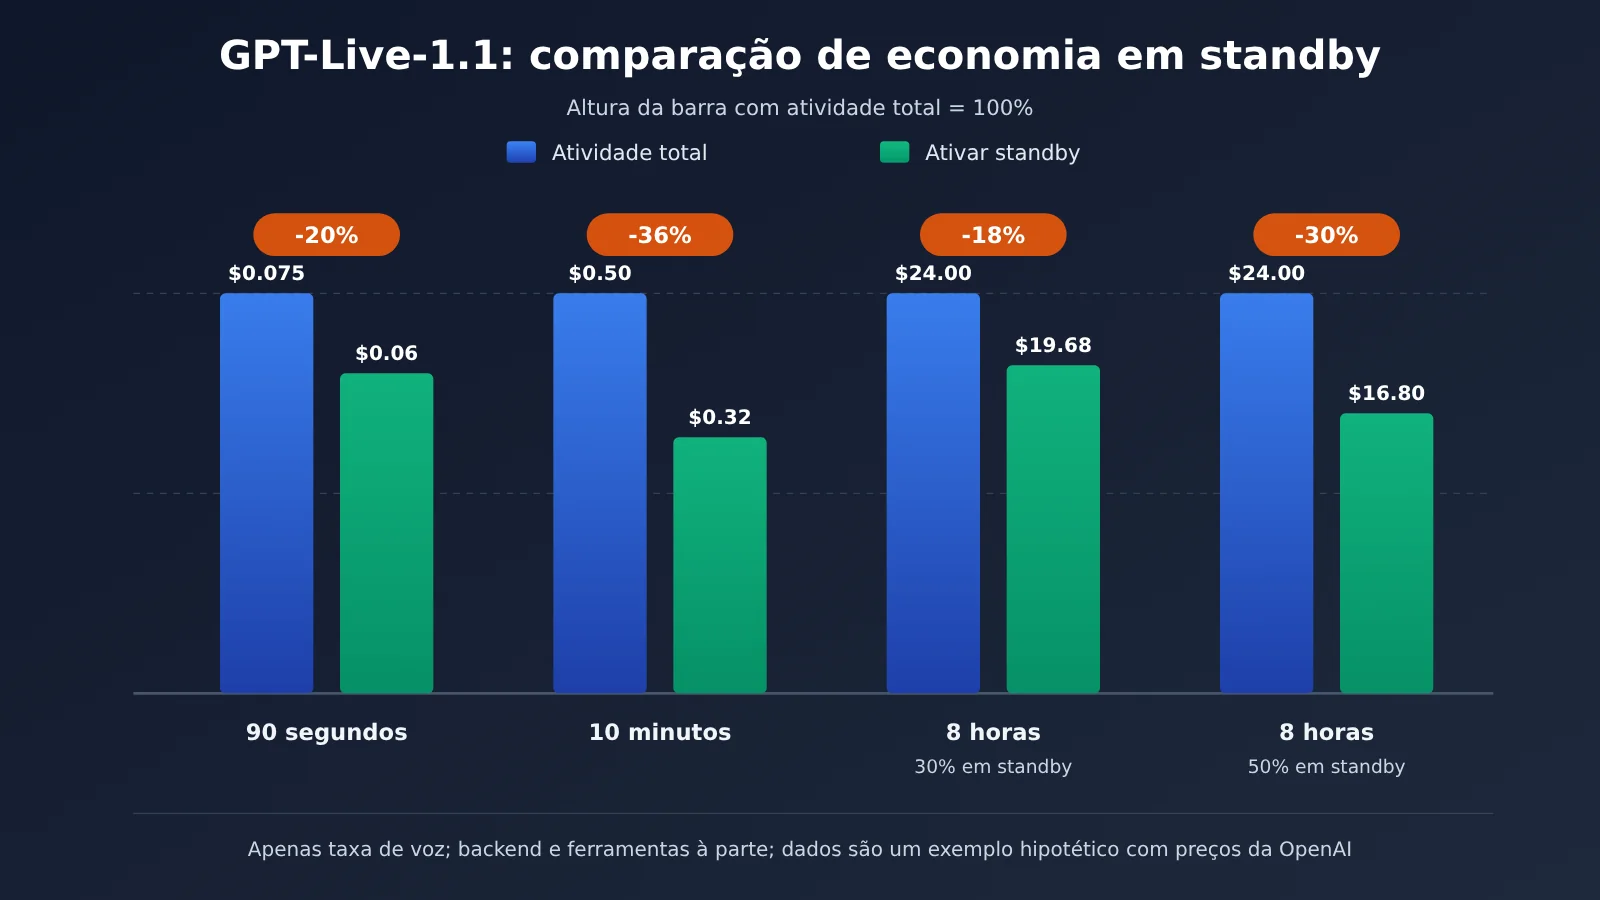
Um exemplo hipotético. Em uma sessão de 10 minutos, com 4 minutos ativos e 6 minutos em standby no tempo cobrado, a taxa de voz é 4×0.05 + 6×0.02 = $0.32. Os mesmos 10 minutos totalmente ativos custam $0.50. Na comparação, a taxa de voz cai 36%, exatamente igual a 60% × 60% da proporção em standby.
| Item de cobrança | Preço unitário (tabela oficial da OpenAI) | Granularidade da cobrança | Afetado pelo standby? |
|---|---|---|---|
| Voz ativa | $0.05/minuto | Por segundo | Sim, parcialmente substituída pelo standby |
| Voz em standby via WebRTC | $0.02/minuto | Por segundo | Apenas WebRTC elegível |
| Tokens do modelo de backend | Conforme o preço do modelo escolhido | Por token | Não |
| Chamadas de ferramentas | Conforme o preço da ferramenta | Por chamada ou por volume | Não |
Como configurar o standby do GPT-Live-1.1 via WebRTC: das configurações de sessão à conferência da cobrança
Segundo o guia “Managing GPT-Live sessions” da OpenAI, o standby via WebRTC tem poucas opções de configuração, mas cada uma delas afeta diretamente como as fases de cobrança são divididas.
| Campo / evento | Valor ou significado | Ponto de configuração |
|---|---|---|
session.wake_policy.type |
Definir como "speech" |
A sessão só começa a inferir depois que detecta fala; não inferir logo ao conectar |
session.idle_timeout_s |
Inteiro de 5–60 (segundos) | Se não for definido, depois da primeira ativação a inferência permanece ativa o tempo todo |
session.wake_policy.vad_threshold |
0–1, padrão 0.5 (resumo da documentação feito pela OrcaRouter, de terceiros) | Aumentar em ambientes barulhentos ou com ativações falsas frequentes |
session.paused |
Inferência pausada após o tempo limite de inatividade | Marcado como início do standby |
session.resumed |
Inferência pronta para retomar; a primeira ativação também dispara | Marcado como início do período ativo |
session.closed |
Fim da sessão, incluindo o usage.seconds final |
Usado para conferir com a fatura |
4 etapas para configurar o standby do GPT-Live-1.1
- Ative a ativação por fala ao criar a sessão WebRTC: defina
session.wake_policy.type = "speech". - Defina o limite de inatividade:
session.idle_timeout_sdeve ser um inteiro entre 5 e 60. Quanto menor o limite, mais cedo o sistema entra em standby, mas uma pausa um pouco mais longa do usuário pode disparar a pausa. - Mantenha o track de microfone ativo: durante o standby, o track de microfone precisa continuar ativo para que o serviço consiga detectar a fala e ativar a sessão. A conexão e o ID da sessão permanecem os mesmos e, ao retomar, o histórico da conversa é mantido.
- Escute os eventos e registre os timestamps: use
session.pausedesession.resumedpara saber em qual fase o servidor está no momento.
Abaixo há um trecho ilustrativo da configuração da sessão. Os caminhos dos campos vêm da documentação oficial; a estrutura completa da requisição deve seguir o documento “Create session” da OpenAI:
{
  "session": {
    "wake_policy": {
      "type": "speech",
      "vad_threshold": 0.5
    },
    "idle_timeout_s": 15
  }
}
Quais períodos de silêncio ainda entram na cobrança de tempo ativo
Três tipos de “silêncio” são os mais fáceis de calcular errado:
- Silêncio antes do timeout: entre o fim da última fala e o vencimento de
idle_timeout_s, a sessão continua sendo cobrada como ativa. Com o limite em 30 segundos, toda pausa terá pelo menos 30 segundos cobrados pela tarifa ativa. - Microfone mudo: quando o usuário clica em mudo no cliente, a sessão não entra em standby por causa disso; ela continua ativa.
- Espera pelo retorno do backend: o tempo em que a inferência não está pausada e está esperando o modelo de backend ou o resultado de uma ferramenta também é cobrado como fase ativa.
Há também uma taxa de inicialização. Segundo a compilação da OrcaRouter com base na documentação oficial, ao criar uma sessão WebRTC com POST /v1/live/sessions, são cobrados 15 segundos de duração de voz antecipadamente; depois que a sessão começa a rodar, esse valor é abatido da tarifa de duração. Para aplicações que criam sessões de teste com frequência, isso é um custo real; o valor efetivo deve seguir o OpenAI Pricing.
Conferindo a cobrança pelo horário dos eventos
A ideia para conferir a cobrança é estimar a duração de cada fase pelos timestamps dos eventos e depois comparar o usage.seconds final dentro de session.closed com a fatura real. Abaixo está um exemplo de registrador de eventos. Por qual canal os eventos chegam (canal de dados WebRTC ou conexão sideband), consulte a documentação oficial:
const timeline = [];
function onServerEvent(evt) {
  if (["session.resumed", "session.paused", "session.closed"].includes(evt.type)) {
    timeline.push({ type: evt.type, t: Date.now() / 1000 });
  }
  if (evt.type === "session.closed") {
    console.log("usage.seconds =", evt.usage?.seconds, timeline);
  }
}
Nos testes, rode separadamente o mesmo roteiro, o mesmo backend e a mesma gravação com “standby ativado” e “standby desativado”, e registre ainda o horário de retorno do primeiro trecho de áudio, para quantificar o custo de latência da primeira rodada depois do despertar.
Há ainda uma observação sobre o fluxo de trabalho. A CellCog publicou um conjunto de experimentos controlados com a mesma configuração: primeiro rodou 560 reuniões com roteiro e depois acrescentou 120 reuniões de reteste. No roteiro original, a pergunta era feita cedo; a versão antiga encaminhou 134 de 160 perguntas ao backend, e a versão 1.1 encaminhou 91 — cerca de 84% contra 57%. No reteste, com a primeira pergunta colocada depois do 10º segundo, as duas versões ficaram em 48/60 (80%). Esse é apenas o comportamento de delegação de uma única equipe em reuniões curtas e com comandos específicos; eles não mediram o custo de standby, mas isso mostra uma coisa: o número de delegações ao backend varia conforme o roteiro, e o custo de backend não é afetado pelo standby.
Limites de implementação do standby do GPT-Live-1.1 em WebSocket e SIP
A OpenAI oferece suporte a três tipos de conexão Live: WebRTC, WebSocket e telefonia SIP, mas o standby nativo de baixo custo só se aplica ao WebRTC. Vale fazer uma distinção: uma sessão WebRTC ou SIP pode ter um WebSocket paralelo separado para controle e monitoramento, e isso é diferente de “usar WebSocket para carregar o áudio principal”. Mesmo quando a conexão principal WebRTC tem um WebSocket paralelo anexado, o standby continua disponível.
| Transporte do áudio principal | Standby nativo $0.02 | Tratamento de ociosidade recomendado pela documentação | Ponto de atenção de custo |
|---|---|---|---|
| WebRTC | ✅ aplicável quando as condições são atendidas | wake_policy + idle_timeout_s | O período silencioso antes do timeout conta como ativo |
| WebRTC + WebSocket paralelo | ✅ aplicável à conexão principal | O paralelo cuida apenas de controle e eventos | O paralelo em si não altera a fase de cobrança |
| WebSocket principal | ❌ sem base documental | Detecção de ociosidade no lado da aplicação, fechar e recriar | Recriar a sessão tem custo de inicialização |
| Telefonia SIP | ❌ sem base documental | Confirme primeiro o impacto de encerrar a sessão nas chamadas recebidas | Orçar como ativo durante a manutenção da chamada |
Como proceder com o WebSocket principal: gerencie o estado de ociosidade no lado da aplicação, acompanhando entrada e saída de áudio, estado de reprodução e tarefas pendentes no backend. Só quando houver silêncio prolongado e a desconexão for permitida é que você chama session.close e aguarda session.closed. Quando o usuário voltar, recrie a sessão: é possível fazer fork de uma sessão antiga que permita salvamento e já tenha o registro concluído, ou restaurar o contexto a partir do estado textual salvo pela própria aplicação. Se a ativação por voz local estiver habilitada, coloque em buffer o áudio do início antes de tudo, para não perder palavras durante o estabelecimento da conexão.
Como proceder com SIP: encerrar a sessão pode afetar a própria conexão da chamada recebida, então “desligar e reconectar” não pode ser tratado como standby no local. Se a ligação precisar ser mantida, a aplicação ou o sistema telefônico deve lidar com o fluxo de espera e incluir as tarifas de voz ativa da OpenAI no orçamento. Outra alternativa é construir uma ponte de mídia própria e realmente usar e validar o standby WebRTC no lado da OpenAI. Tudo isso são limites de implementação no nível de transporte e de estado de sessão, e não há nenhuma base que indique que transportes não-WebRTC também possam usufruir do preço de standby de $0.02.
Quanto uma ligação inteira economiza: primeiros passos com o custo de standby do GPT-Live-1.1
Cálculo de custo minimalista
A função abaixo transforma a regra “proporção de economia = proporção em standby × 60%” em código, com entradas em segundos:
ACTIVE, STANDBY = 0.05, 0.02  # preço oficial da OpenAI, em dólares por minuto

def voice_cost(active_s: float, standby_s: float) -> tuple[float, float]:
    with_standby = active_s / 60 * ACTIVE + standby_s / 60 * STANDBY
    all_active = (active_s + standby_s) / 60 * ACTIVE
    return round(with_standby, 4), round(1 - with_standby / all_active, 4)

print(voice_cost(240, 360))      # 10 minutos: 4 minutos ativos + 6 minutos em standby
print(voice_cost(60, 30))        # 90 segundos: 60 segundos ativos + 30 segundos em standby
| Cenário hipotético | Ativo / standby | Tarifa de voz com standby | Tarifa de voz totalmente ativa | Queda na tarifa de voz |
|---|---|---|---|---|
| Exemplo oficial (reproduzido pelo OrcaRouter) | 60 segundos / 30 segundos | $0.06 | $0.075 | 20% |
| Consulta de 10 minutos (hipótese deste artigo) | 4 minutos / 6 minutos | $0.32 | $0.50 | 36% |
| 8 horas em plantão, 30% em standby (caso do OrcaRouter) | 5.6 horas / 2.4 horas | $19.68 | $24.00 | 18% |
| 8 horas em plantão, 50% em standby (caso do OrcaRouter) | 4 horas / 4 horas | $16.80 | $24.00 | 30% |
A tabela considera apenas a tarifa de voz. Em uma implantação real, os custos de modelo de backend e de ferramentas muitas vezes são o item maior da conta. O texto do OrcaRouter comenta que a documentação da OpenAI recomenda começar com gpt-6-luna e trocar para gpt-6-sol nas tarefas de backend mais complexas, ambos cobrados por token no padrão. Em ligações longas, o custo de backend pode muito bem passar do custo de voz.
💡 Dica de cálculo: os números da tabela acima são hipóteses estimadas a partir dos preços oficiais; a conta real deve seguir
usage.secondse o faturamento da plataforma. Se você também está avaliando outras soluções de voz em tempo real, pode usar a cota gratuita de testes da APIYI apiyi.com e comparar, com o mesmo roteiro, os modelos Realtime que cobram por token.
Separar a camada de voz do GPT-Live-1.1, o modelo de backend e o ponto de entrada da API
Até a data da consulta (2026-11-20), tanto o endpoint de sessão dedicado quanto a tarifa por minuto do GPT-Live-1.1 vêm da OpenAI oficial. Segundo a consolidação da terceira parte OrcaRouter, o GPT-Live só pode ser acessado pelo endpoint Live sessions, e não é suportado por Chat Completions, Responses, Realtime ou outros endpoints.
No caso da APIYI, o registro público de modelos (gerado em 2026-11-20 15:17, UTC+8, com 289 registros no total) não contém gpt-live-1 nem gpt-live-1.1, e o arquivo dinâmico também não traz nenhum anúncio de lançamento correspondente. Portanto, no momento não dá para considerar que a APIYI já oferece a série GPT-Live, o /v1/live/sessions ou cobrança por minuto. Também não se pode inferir que ela suporta esse tipo de sessão de voz dedicada só porque é compatível com a interface da OpenAI.
A opção de voz em tempo real que a APIYI já publicou é um produto Realtime independente:
| Solução | Forma de acesso | Forma de cobrança | Standby / WebRTC / SIP | Plataformas disponíveis |
|---|---|---|---|---|
| GPT-Live-1.1 | /v1/live/sessions, WebRTC / WebSocket / SIP |
Ativo US$ 0,05 e standby US$ 0,02 por minuto, backend cobrado à parte | WebRTC com standby nativo | OpenAI oficial |
| gpt-realtime-2.1 | /v1/realtime WebSocket |
Áudio de entrada/saída US$ 32/US$ 64 por milhão de tokens de áudio | WebRTC e SIP não liberados | APIYI apiyi.com |
| gpt-realtime-2.1-mini | /v1/realtime WebSocket |
Áudio de entrada/saída US$ 10/US$ 20 por milhão de tokens de áudio | WebRTC e SIP não liberados | APIYI |
Os preços do Realtime da APIYI vêm da documentação dela (a página indica conciliação em 2026-09-14), e a dimensão de cobrança são tokens de texto, áudio e imagem — não dá para converter diretamente para a cobrança por minuto do GPT-Live.
Exemplo minimalista de conexão com o Realtime da APIYI
import os, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # Interface unificada da APIYI
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1"

async def main():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        print(await ws.recv())  # Imprime o primeiro evento do servidor

asyncio.run(main())
Ver o código completo: fechamento por inatividade no lado da aplicação do WebSocket principal
import os, time, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # Entrada do Realtime da APIYI
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1-mini"
IDLE_LIMIT_S = 45          # Limite de inatividade no lado da aplicação, ajustável conforme o negócio
pending_backend_tasks = 0  # Mantido pela aplicação: número de tarefas pendentes no backend
is_playing = False         # Mantido pela aplicação: se está reproduzindo áudio

async def run_session():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    last_activity = time.monotonic()
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        async def reader():
            nonlocal last_activity
            async for _ in ws:
                last_activity = time.monotonic()  # Qualquer evento do servidor é considerado atividade

        task = asyncio.create_task(reader())
        while True:
            await asyncio.sleep(1)
            idle = time.monotonic() - last_activity
            busy = pending_backend_tasks > 0 or is_playing
            if idle > IDLE_LIMIT_S and not busy:
                print(f"空闲 {idle:.0f}s,主动关闭,用户回来后再重建")
                await ws.close()
                break
        task.cancel()

asyncio.run(run_session())
O formato dos eventos e os parâmetros de consulta seguem a documentação «Realtime – voz em tempo real (WebSocket)» da APIYI. Essa abordagem de fechar e recriar apenas elimina conexões ociosas na camada da aplicação, não correspondendo a nenhuma tarifa oficial de baixo custo de espera.
🚀 Recomendação de integração: para cenários WebRTC que precisam do modo de espera nativo do GPT-Live, por enquanto conecte-se diretamente à OpenAI. Se você precisa montar rapidamente um protótipo de voz em tempo real com WebSocket e gerenciar vários modelos de forma unificada, pode primeiro validar o fluxo com
gpt-realtime-2.1-minino apiyi.com da APIYI e depois decidir a solução definitiva com base no custo.
Perguntas Frequentes (FAQ)
Q1: O que é o standby do WebRTC no GPT-Live-1.1?
É um estado de cobrança das sessões WebRTC: depois de configurar a ativação por voz e o limiar de inatividade, a sessão deixa de fazer inferência nos períodos sem fala, mas a conexão continua ativa, com cobrança de $0.02 por minuto. Quando alguém volta a falar, a inferência é retomada junto com o histórico da conversa anterior.
Q2: Uma redução de 60% significa que a ligação inteira fica 60% mais barata?
Não. Os 60% são a queda do preço por minuto em standby em relação ao preço por minuto ativo. A redução do custo de voz da ligação inteira é igual à proporção de tempo em standby multiplicada por 60%: se o standby ocupa metade do tempo, o custo de voz cai cerca de 30%. Os custos de backend e de ferramentas não são afetados.
Q3: Quando o GPT-Live-1.1 entrou na API?
A data do item no OpenAI API Changelog é 2026-11-19, e a página de anúncio da comunidade de desenvolvedores da OpenAI mostra 2026-11-20; a diferença pode vir do critério de fuso horário. O GPT-Live-1 já estava disponível oficialmente em 2026-09-10 (conforme compilado pela OrcaRouter).
Q4: Em quais cenários vale mais a pena ativar o standby?
– **Clientes esperando na fila do atendimento**: o cliente fica na linha, mas passa longos períodos sem falar.
– **Assistentes automotivos ou de desktop**: conexão permanente, com ativação ocasional.
– **Agentes em plantão prolongado**: quanto maior a proporção de standby, maior a economia.
Em sessões curtas e com conversa intensa, a proporção de standby é baixa e ainda existe o custo da primeira resposta mais lenta depois da ativação — o ganho é limitado.
Q5: É possível chamar o GPT-Live-1.1 pela APIYI?
Até 2026-11-20, o registro público de modelos da APIYI não tem a linha GPT-Live, nem há anúncio de lançamento. Se você precisa de voz em tempo real, pode usar `gpt-realtime-2.1` / `gpt-realtime-2.1-mini`, já publicados em APIYI apiyi.com, conectando via WebSocket em `/v1/realtime` e com cobrança por tokens de áudio. Novos usuários têm crédito gratuito de teste para validar antes.
Q6: Quais são as limitações conhecidas do standby do GPT-Live-1.1?
– Vale apenas para WebRTC; nas conexões principais WebSocket e SIP não há base para os $0.02.
– O período silencioso antes do timeout, o microfone mutado e o tempo esperando o backend são cobrados como atividade.
– Após a ativação, a primeira resposta para falas curtas pode demorar mais.
– No momento faltam dados de terceiros sobre ativação em standby e conferência de faturas; além disso, as notas do ranking do Artificial Analysis correspondem apenas ao GPT-Live-1 e não podem ser aplicadas ao 1.1.
GPT-Live-1.1 WebRTC em standby: principais conclusões
- Preço unitário: US$ 0,05/minuto quando ativo e US$ 0,02/minuto no standby WebRTC elegível — ambos cobrados por segundo.
- Cálculo: a redução no custo de voz da chamada inteira é igual à proporção de standby multiplicada por 60%, e não 60% fixos.
- Configuração:
wake_policy.type="speech"mais umidle_timeout_sentre 5 e 60 segundos, mantendo a faixa do microfone ativa. - Conferência da fatura: estime a duração de cada fase pelos timestamps de paused/resumed e depois compare com
usage.secondsna fatura. - Limites: WebSocket e SIP só podem ser recriados no lado da aplicação depois de fechados — isso não conta como standby mais barato.
- Ponto de entrada: o GPT-Live exige conexão direta com a OpenAI; já a voz em tempo real via WebSocket pode ser testada com o modelo Realtime em APIYI apiyi.com.
Resumo
Os pontos centrais do standby WebRTC no GPT-Live-1.1:
- A redução tem condições: só sessões WebRTC configuradas para standby e com a inferência já pausada são cobradas a US$ 0,02/minuto.
- A economia depende da proporção: em 10 minutos com 6 minutos em standby, o custo de voz cai de US$ 0,50 para US$ 0,32 — cerca de 36% de economia.
- A fatura é global: o modelo de backend e as ferramentas são cobrados à parte; o standby otimiza apenas um desses itens.
A sugestão é começar com um teste A/B usando o mesmo roteiro, ligando e desligando o standby, registrando os horários dos eventos e a latência da primeira resposta — e só então decidir o limiar de ociosidade. Se você ainda está comparando diferentes soluções de voz em tempo real, vale a pena rodar um protótipo com o Realtime pela APIYI apiyi.com e usar a cota gratuita para comparar custo e experiência.
📚 Referências
-
OpenAI API Pricing: tarifas de atividade e de espera do GPT-Live
- Link:
developers.openai.com/api/docs/pricing - Descrição: fonte dos preços oficiais de $0,05 e $0,02
- Link:
-
OpenAI Managing GPT-Live sessions: configuração de espera e descrição dos eventos
- Link:
developers.openai.com/api/docs/guides/live-conversations - Descrição: wake_policy, idle_timeout_s e limites de transporte
- Link:
-
OpenAI API Changelog: entrada de atualização do GPT-Live-1.1
- Link:
developers.openai.com/api/docs/changelog - Descrição: data do item: 2026-11-19
- Link:
-
Teste comparativo CellCog: GPT-Live-1.1 vs GPT-Live-1
- Link:
cellcog.ai/blog/gpt-live-1-1-vs-gpt-live-1/ - Descrição: dados de delegação de 680 reuniões roteirizadas, sem custo de espera
- Link:
-
Análise do lançamento do OrcaRouter: análise da cobrança em espera do GPT-Live-1.1
- Link:
orcarouter.ai/blog/gpt-live-1-1-api-release-standby-pricing - Descrição: reprodução dos exemplos de cálculo oficiais e estimativa para turno de 8 horas
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Fique à vontade para nos contatar pela página inicial do site APIYI; para detalhes de integração do Realtime, consulte o centro de documentação em docs.apiyi.com