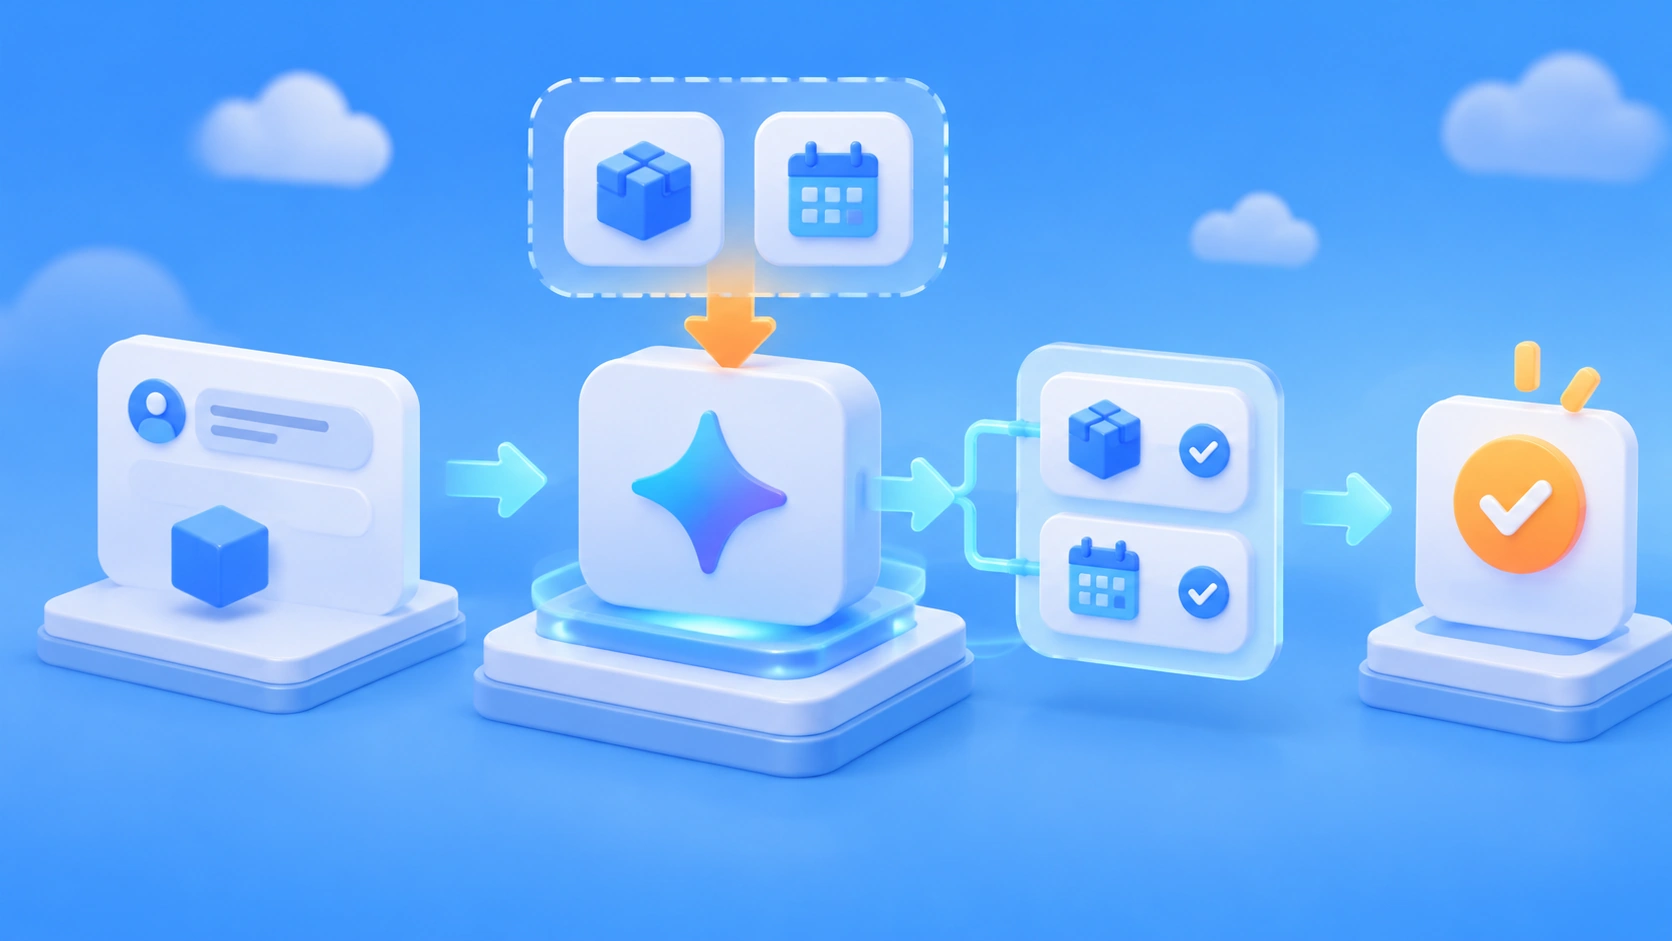
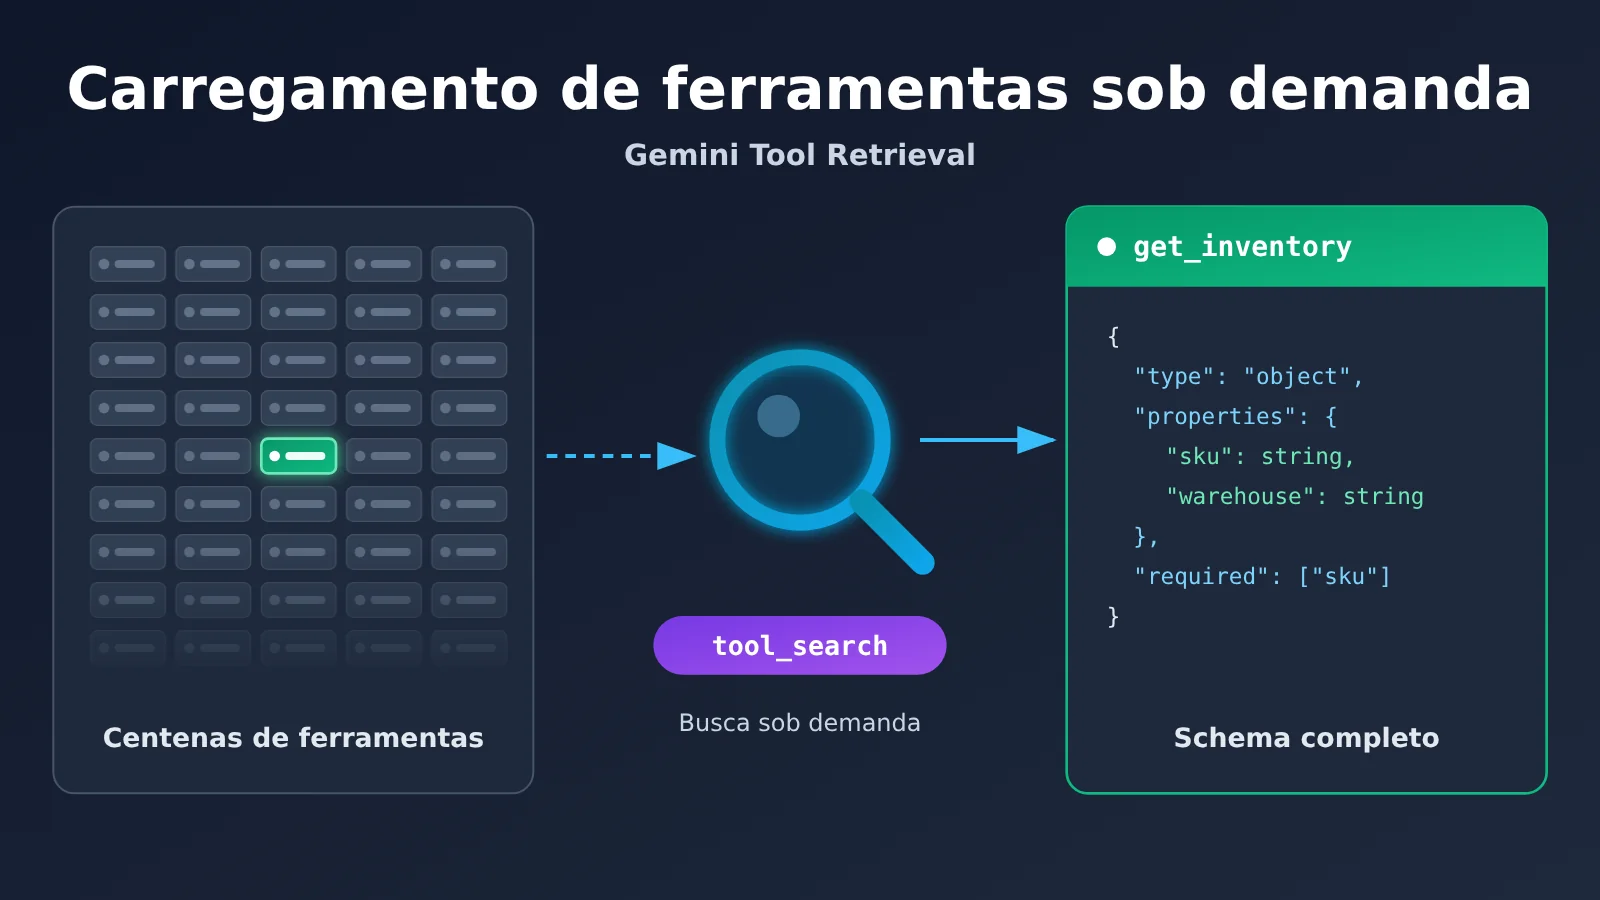
Integrar o Gemini Tool Retrieval exige três coisas. Primeiro, adicione {"type": "tool_search"} ao array tools e defina defer_loading: True para funções de negócio pouco usadas. Segundo, faça a requisição usando a Interactions API na versão v1beta e depois encontre o function_call em interaction.steps. Terceiro, execute a função localmente, monte o function_result com base no call_id e envie de volta junto com o array tools completo. Não é preciso criar seu próprio pesquisador de ferramentas: o servidor faz a busca de ferramentas e o carregamento do Schema de parâmetros.
Antes de mais nada, é importante deixar claro: o Tool Retrieval só muda “quando as definições dos parâmetros das ferramentas entram no contexto do modelo”; as funções continuam sendo executadas pelo desenvolvedor. Ele também não garante economia. Em cenários com poucas ferramentas e contexto longo, o consumo de tokens pode até aumentar.
O que você vai encontrar neste artigo?
- Quais modelos o Gemini Tool Retrieval suporta, qual versão do SDK é necessária e por que é obrigatório especificar
v1beta - Um exemplo Python completo com nomes de variáveis consistentes: duas ferramentas com carregamento adiado, inventário e pedidos, da busca até a resposta final
- Quem trata
tool_search_call,tool_search_result,function_callefunction_result - As diferenças entre três rotas de expansão: carregamento adiado via MCP remoto, busca no cliente e um Tool Registry próprio
- Como investigar erros comuns como HTTP 400 de forma centralizada, e como avaliar se vale a pena antes de habilitar
Índice: primeiro, uma tabela To Know para explicar os campos principais; depois, “Visão rápida de impacto” para mostrar o que esse recurso de preview significa para diferentes perfis. A seção “Fatos objetivos” segue a ordem de integração: preparar o ambiente, definir ferramentas, observar as etapas de busca, retornar os resultados das funções e, por fim, expandir para MCP e busca no cliente; a investigação de erros fica concentrada no final dessa parte. A seção “Análise e julgamento” usa dois exemplos hipotéticos fornecidos pelo Google para discutir cenários em que o Tool Retrieval é e não é adequado.
Conceitos-chave do Gemini Tool Retrieval (To Know)
| Conceito | Explicação resumida |
|---|---|
| google-genai | Nome do pacote do SDK oficial em Python do Google; a importação é feita com from google import genai |
| v1beta | Versão de interface de pré-visualização, obrigatória para o Tool Retrieval; neste artigo ela é especificada explicitamente na inicialização do cliente |
| Interactions API | Interface do Google voltada para fluxos de trabalho de agentes, com suporte a conversas com estado e etapas de execução observáveis |
tool_search |
Tipo especial de ferramenta que declara a ativação da recuperação de ferramentas; no máximo um por requisição |
defer_loading |
Faz com que a definição completa dos parâmetros de uma função ou servidor MCP especificado entre no contexto do modelo só mais tarde (carregamento adiado) |
short_description |
Breve descrição da função adiada que o modelo consegue ver no início; só pode ser usada em funções adiadas |
tool_search_call |
Etapa de busca iniciada pelo modelo dentro do fluxo de recuperação do lado do servidor |
tool_search_result |
Etapa em que o servidor retorna o Schema completo das ferramentas correspondentes |
function_call |
Quando o modelo pede que o código do desenvolvedor execute alguma função, informando os parâmetros |
function_result |
Tipo de entrada usado pela aplicação para devolver ao modelo o resultado da execução da função |
call_id |
Identificador que associa o resultado da execução da função ao function_call.id original |
previous_interaction_id |
Identificador que permite que as requisições seguintes continuem um registro de interação já salvo no servidor |
signature |
Campo de assinatura que precisa ser devolvido exatamente como está, junto com a etapa original, quando uma sessão sem estado reproduz etapas do histórico |
Visão rápida do impacto do Gemini Tool Retrieval
| Público | Impacto real |
|---|---|
| Desenvolvedores de Agents | Agents com muitas ferramentas podem carregar ferramentas de cauda longa sob demanda, sem precisar construir sua própria busca vetorial — mas precisam trocar para a Interactions API |
| Equipes que já usam generateContent | O método antigo não suporta Tool Retrieval, então é preciso migrar a interface e a análise da estrutura de retorno |
| Integradores de MCP | Podem definir defer_loading de uma vez no nível do mcp_server, sem precisar declarar ferramenta por ferramenta |
| Responsáveis por custos | Não existe uma taxa de recurso separada, mas cada busca no servidor gera uma chamada de modelo faturável adicional, então é preciso ficar de olho em total_tool_use_tokens |
| Projetos com pequenas bibliotecas de ferramentas | Cenários com uma dúzia de ferramentas e contexto longo talvez não valham a pena; o carregamento estático pode sair mais barato |
Fatos objetivos do Gemini Tool Retrieval: informações de lançamento e fluxo de integração
Status de lançamento e modelos compatíveis do Gemini Tool Retrieval
Em 19 de novembro de 2026 (madrugada de 20 de novembro no horário de Pequim), o Google publicou no blog oficial o artigo “Introducing Tool Retrieval in the Gemini API”, abrindo o Tool Retrieval em prévia na Interactions API. Os autores são Lucia Loher, gerente de produto da Gemini API, e Nora Kassner, pesquisadora do Google DeepMind. No momento, o recurso está em estado Preview, e a interface pode mudar antes do lançamento oficial.
A redação do anúncio é bastante ampla: “Gemini 3.6 e modelos mais recentes, incluindo todos os modelos Gemini 4”. Mas a documentação para desenvolvedores, até 20 de novembro de 2026, lista explicitamente apenas 4 IDs de modelo: gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, gemini-3.6-flash. Ao integrar, use a lista da documentação como referência. Definir defer_loading para um modelo sem suporte retorna diretamente HTTP 400.
Preparação antes da integração do Gemini Tool Retrieval: SDK e v1beta
O SDK oficial em Python do Google, googleapis/python-genai, lançou a versão v3.6.0 em 18 de novembro de 2026, adicionando esquemas públicos relacionados ao Tool Retrieval e a resultados de funções. O comando de instalação é o seguinte:
pip install -U "google-genai>=3.6.0"
export GEMINI_API_KEY="your-key"   # Não coloque a chave real no código
Há uma pegadinha comum com o número da versão. A partir da v3.0.0, o cliente da Gemini Developer API do SDK usa v1 por padrão, enquanto o Tool Retrieval exige v1beta; por isso, é obrigatório especificar explicitamente na inicialização:
from google import genai

client = genai.Client(
    http_options={"api_version": "v1beta"}
)
O SDK lê as credenciais da variável de ambiente GEMINI_API_KEY. Se usar REST, o endpoint correspondente é POST https://generativelanguage.googleapis.com/v1beta/interactions, e o cabeçalho de autenticação é x-goog-api-key.
Primeiro passo: definir ferramentas Gemini com tool_search e defer_loading
O cenário de demonstração tem apenas duas ferramentas de negócio: get_inventory, que consulta o estoque de produtos, e get_order_status, que consulta o status de pedidos. Ambas são configuradas com carregamento diferido. A função de cada campo no array tools é a seguinte:
{"type": "tool_search"}: ativa a busca no lado do servidor, comexecutionpadrãoserver. Sem ele, definirdefer_loadinggera o errodefer_loading requires tool_search.defer_loading: True: oparameterscompleto não entra no contexto inicial; no começo, o modelo vê apenas o nome e a descrição curta.short_description: descrição curta exibida na lista inicial. Se não for preenchida, usa a primeira frase dedescription. Preencher esse campo em uma função não diferida é considerado inválido.parameters: ainda precisa ser enviado por completo. O que é diferido é o momento em que o schema entra no contexto do modelo; o servidor ainda precisa receber a definição completa.
Que ferramentas fazem sentido para carregamento diferido? A recomendação do Google é usar uma combinação: manter as ferramentas de alta frequência com carregamento direto e deixar as ferramentas de cauda longa, especializadas e de baixa frequência para carregamento diferido. Além disso, não configure como diferidas as ferramentas citadas diretamente nas instruções do sistema. Caso contrário, o modelo pode ignorar a busca e chamá-las diretamente, falhando por não ter o contexto carregado. Para ferramentas com nomes parecidos, vale a pena adicionar um namespace comercial, por exemplo billing_get_customer e crm_get_customer, em vez de usar get_customer para ambas.
Etapa 2: enviar a requisição e observar as etapas de recuperação de ferramentas do Gemini
Abaixo está o código de demonstração completo. Tanto o estoque (“12 unidades”) quanto o status do pedido demo_pending são dados simulados localmente — nada consulta sistemas reais. Para rodar o código, você precisa de uma chave API do Gemini válida e de permissão de acesso ao modelo.
import json
from google import genai

MODEL = "gemini-4-hydrogen"

client = genai.Client(
    http_options={"api_version": "v1beta"}
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "short_description": "Check product inventory by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    },
    {
        "type": "function",
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "short_description": "Check an order's current status.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"]
        }
    }
]

def execute_demo_tool(name, arguments):
    """Função de negócio simulada localmente — não consulta estoque nem pedidos reais."""
    if name == "get_inventory":
        return {"sku": arguments["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": arguments["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(f"Unknown tool: {name}")

# Primeira requisição: o modelo descobre e escolhe as ferramentas de que precisa
interaction = client.interactions.create(
    model=MODEL,
    input="查询商品 SKU-42 的可用库存。",
    tools=tools
)

print("执行步骤:")
for step in interaction.steps:
    print(step.type, getattr(step, "name", ""))
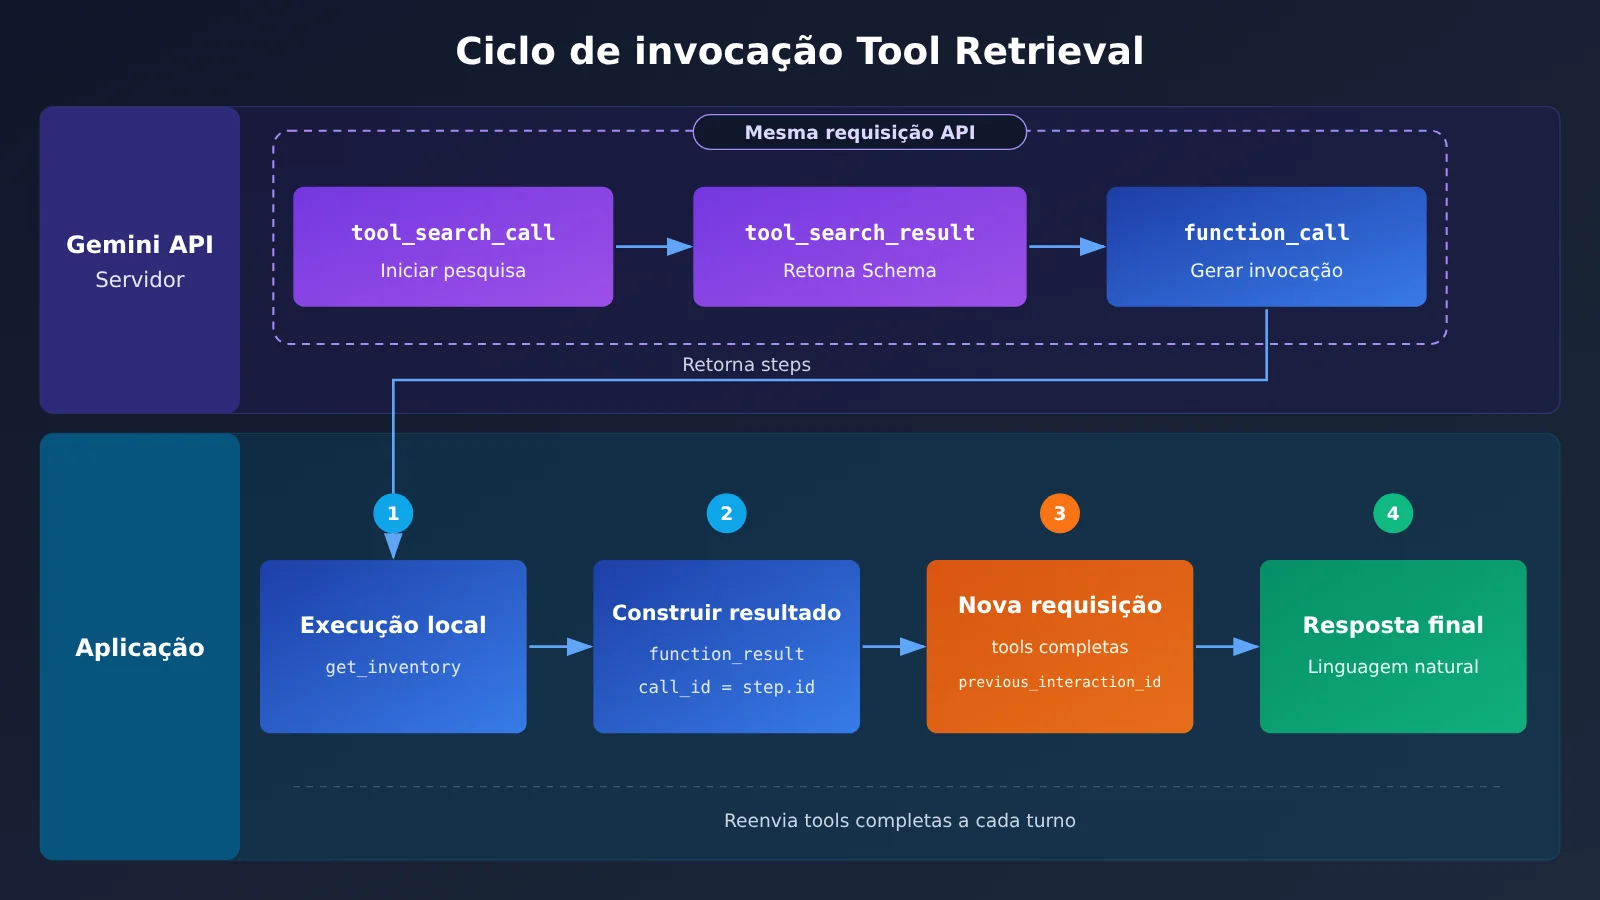
Os interaction.steps impressos costumam aparecer na seguinte ordem. A ordem exata e os resultados da busca são decididos pelo modelo, e uma única rodada pode disparar várias buscas.
tool_search_call: o modelo percebe que não tem, já carregada, uma ferramenta adequada para o momento e dispara uma busca do lado do servidor.tool_search_result: a API devolve o Schema completo de parâmetros doget_inventorycorrespondente.function_call: depois de ler o Schema, o modelo gera uma chamada comoget_inventory(sku="SKU-42").
Essas três etapas acontecem na mesma requisição externa de API — a aplicação não precisa escrever um buscador próprio nem enviar de novo uma requisição de recuperação. As duas primeiras etapas exigem apenas observação e registro; não repita a busca localmente. Mas “mesma requisição” não quer dizer “apenas uma inferência”: cada busca do lado do servidor dispara chamadas adicionais ao modelo, e esses tokens são cobrados normalmente. Ao depurar, tem mais um detalhe de atenção: não olhe só para interaction.status. Mesmo quando o status não é requires_action, os steps podem conter um function_call à espera de execução.
Terceiro passo: executar a função e retornar o function_result
O Tool Retrieval só é responsável por encontrar a ferramenta e carregar os parâmetros; a função de negócio real ainda é executada pela aplicação, seguindo o mecanismo padrão de Function Calling. Continuando o código acima:
# Executa apenas a chamada real de função de negócio; não execute tool_search_call no lado da aplicação
function_results = []

for step in interaction.steps:
    if step.type != "function_call":
        continue
    result = execute_demo_tool(step.name, step.arguments)
    function_results.append({
        "type": "function_result",
        "name": step.name,
        "call_id": step.id,
        "result": [{"type": "text", "text": json.dumps(result, ensure_ascii=False)}]
    })

# Envia os resultados das funções locais de volta ao Gemini
if function_results:
    followup = client.interactions.create(
        model=MODEL,
        previous_interaction_id=interaction.id,
        tools=tools,
        input=function_results
    )
    print("Resposta final: ", followup.output_text)
else:
    print("Resposta atual: ", interaction.output_text)
Há três pontos de atenção neste trecho de código. Primeiro, o call_id deve vir obrigatoriamente do step.id do function_call original. Quando há múltiplas chamadas em uma rodada, o modelo usa esse identificador para corresponder cada resultado. Segundo, previous_interaction_id=interaction.id faz com que o servidor continue o registro de interação já salvo, incluindo as ferramentas que já foram recuperadas. Terceiro, na segunda rodada ainda é preciso passar o array tools completo. A API mantém o histórico de passos, mas não mantém a declaração de ferramentas: tool_search, todas as ferramentas adiadas e não adiadas, e a configuração de MCP precisam ser reenviadas a cada rodada.
Este exemplo demonstra apenas um ciclo completo de uma chamada de função; ele não inclui um agendador genérico de Agent para múltiplas rodadas. Se ainda houver function_call no followup, basta continuar o processamento da mesma forma.
🎯 Dica técnica: O Tool Retrieval em si depende da API oficial
v1betaInteractions do Google. Se você quiser primeiro validar suas funções de negócio com o Function Calling padrão e comparar o desempenho de diferentes modelos na escolha de ferramentas e no preenchimento de parâmetros, pode usar a mesma chave no APIYI apiyi.com para alternar entre Gemini, Claude, GPT e outros modelos e fazer testes de linha de base.
Extensão: MCP remoto e recuperação de ferramentas no cliente Gemini
Servidores MCP remotos podem configurar o carregamento sob demanda na camada do servidor; as ferramentas que eles expõem são carregadas conforme necessário:
mcp_tools = [
    {"type": "tool_search"},
    {
        "type": "mcp_server",
        "name": "weather_service",
        "url": "https://gemini-api-demos.uc.r.appspot.com/mcp",
        "defer_loading": True
    }
]
Diferentemente das funções personalizadas, as ferramentas MCP remotas são executadas pela API em nome do aplicativo; nos steps aparecem mcp_server_tool_call e mcp_server_tool_result, e o aplicativo não precisa devolver o resultado. A documentação oficial ainda não informa o “número máximo de ferramentas com carregamento diferido”.
Se a empresa já tem seu próprio registro de ferramentas, busca vetorial ou filtragem de permissões por usuário, pode optar pela recuperação no cliente: defina "execution": "client" e forneça name, description e parameters completos. Nesse caso, a primeira rodada retorna um function_call comum para search_tool_registry. Depois que o aplicativo fizer a busca, retorne em function_result.result um array de objetos completos de declaração de ferramentas, sem serializar em uma única string JSON. O modo cliente não usa defer_loading, e a mesma requisição não pode misturar os dois modos.
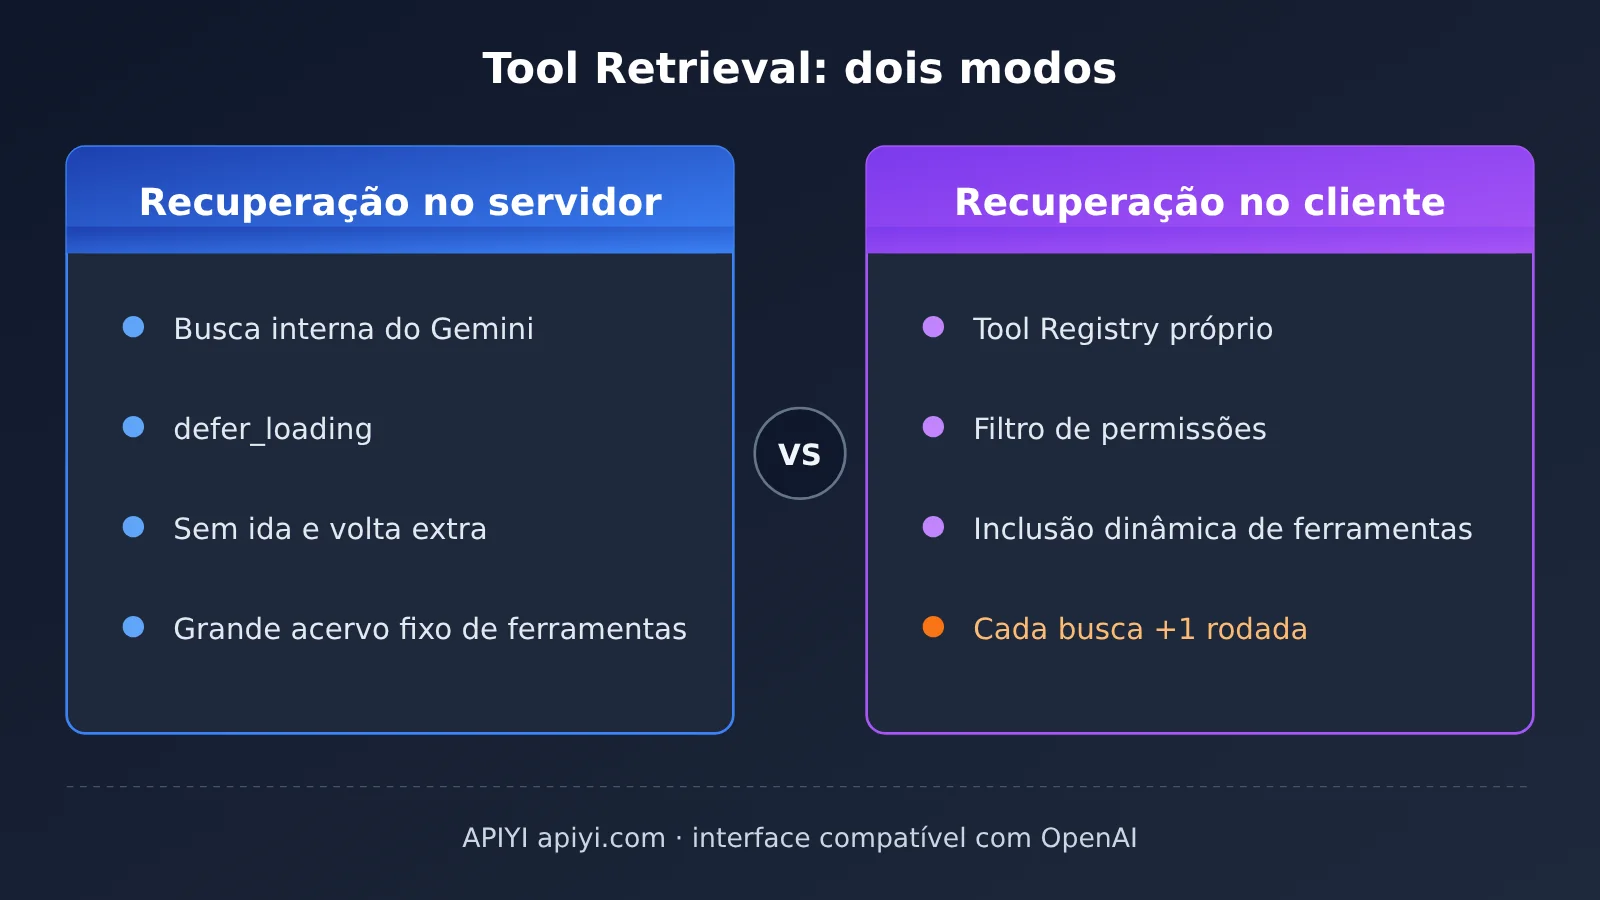
| Dimensão | Recuperação no servidor | Recuperação no cliente (Gemini) | Tool Registry próprio (solução genérica) |
|---|---|---|---|
| Executor da recuperação | Gemini API | Aplicativo do desenvolvedor | Aplicativo do desenvolvedor |
| Configuração principal | tool_search + defer_loading |
tool_search + execution: client |
Function Calling comum |
| Declarar todas as ferramentas com antecedência | Sim | Não | Não |
| Idas e voltas extras de rede | Nenhuma | +1 rodada a cada busca | +1 rodada a cada busca |
| Adição dinâmica de ferramentas | Inconveniente | Suportado | Suportado |
| Cenário típico | Bibliotecas grandes e relativamente fixas de ferramentas | Multi-inquilino, registro privado | Reutilização entre modelos, troca entre vários provedores |
| Plataforma disponível | v1beta oficial do Google | v1beta oficial do Google | APIYI apiyi.com e outras interfaces compatíveis com OpenAI |
A última coluna não é o Gemini Tool Retrieval, mas uma implementação de engenharia com abordagem semelhante: primeiro exponha apenas uma função de busca e, após uma busca bem-sucedida, adicione o Schema correspondente em tools. Ela é adequada para equipes que precisam alternar entre vários modelos. A implementação mínima é a seguinte:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)
MODEL = "your-model-name"  # Consulte a lista de modelos da plataforma

search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}
Ver a chamada completa em duas etapas do Tool Registry próprio
import json, os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"
)
MODEL = "your-model-name"  # consulte a lista de modelos da plataforma

TOOL_REGISTRY = {
    "get_inventory": {"type": "function", "function": {
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "parameters": {"type": "object", "properties": {"sku": {"type": "string"}}, "required": ["sku"]}}},
    "get_order_status": {"type": "function", "function": {
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "parameters": {"type": "object", "properties": {"order_id": {"type": "string"}}, "required": ["order_id"]}}},
}
search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools (inventory, orders) by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}

def search_registry(query):
    q = query.lower()
    return [name for name, t in TOOL_REGISTRY.items()
            if any(w in t["function"]["description"].lower() for w in q.split())]

def execute_demo_tool(name, args):
    if name == "get_inventory":
        return {"sku": args["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": args["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(name)

messages = [{"role": "user", "content": "查询商品 SKU-42 的可用库存。"}]
tools = [search_tool]

for _ in range(4):  # limite simples de iterações, para evitar loop infinito
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    if not msg.tool_calls:
        print("最终回答:", msg.content)
        break
    messages.append(msg)
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        if call.function.name == "search_tool_registry":
            names = search_registry(args["query"])
            tools += [TOOL_REGISTRY[n] for n in names if TOOL_REGISTRY[n] not in tools]
            content = json.dumps({"loaded_tools": names})
        else:
            content = json.dumps(execute_demo_tool(call.function.name, args), ensure_ascii=False)
        messages.append({"role": "tool", "tool_call_id": call.id, "content": content})
💡 Sugestão de escolha: a qualidade da busca na abordagem por registro depende da sua função de pesquisa; a correspondência por palavras-chave do exemplo serve apenas para demonstração. No APIYI apiyi.com, troque de modelo rodando o mesmo conjunto de tarefas e compare “conseguiu encontrar a ferramenta correta” e “os parâmetros foram preenchidos corretamente” — assim você descobre qual modelo se adapta melhor ao seu conjunto de ferramentas.
Investigação centralizada de erros comuns no Gemini Tool Retrieval
| Sintoma | Causa | Tratamento |
|---|---|---|
defer_loading requires tool_search |
Você declarou uma função adiada, mas não há tool_search no servidor |
Adicione {"type": "tool_search"} em tools |
short_description inválido |
Foi definido em uma função que não é adiada | Use apenas em funções com defer_loading=True |
| HTTP 400 unsupported model | O modelo não está na lista de suportados | Use os 4 IDs de modelo listados na documentação |
| A requisição não tem efeito ou acusa erro de versão | O SDK usa v1 por padrão, ou você chamou generateContent |
Defina explicitamente api_version="v1beta" e passe a usar a Interactions API |
| HTTP 400 na segunda rodada | Com store=False, faltou a etapa de busca ou o signature |
Reproduza literalmente tool_search_call/result e todas as assinaturas |
| O modelo usa ferramentas antigas por engano, ou a ferramenta fica indisponível | As requisições seguintes não enviam tools |
Reenvie o array tools completo a cada rodada |
| Parâmetros vazios após a busca | A ferramenta adiada enviou apenas o nome e a descrição curta | Ferramentas adiadas também precisam enviar parameters completos |
| Falha na configuração de busca do cliente | Faltam campos como name, description |
Complete a definição da função de busca do cliente |
O modo stateless (store=False) merece uma explicação à parte. Nesse caso, não dá para contar com previous_interaction_id: a aplicação precisa salvar e reproduzir literalmente a entrada do usuário, tool_search_call, tool_search_result, function_call, function_result e todos os signature. Se qualquer uma dessas etapas for removida ou alterada, o servidor pode não conseguir reconstruir o contexto de busca. Além disso, quando o servidor não encontra ferramentas compatíveis, ele pode simplesmente devolver um texto em vez de um erro estruturado. Então, “a requisição não deu erro” não significa “a busca funcionou” — na validação, confira item por item se as etapas de busca e as chamadas de função esperadas aparecem em steps.
Análise do Gemini Tool Retrieval: quando vale a pena integrar
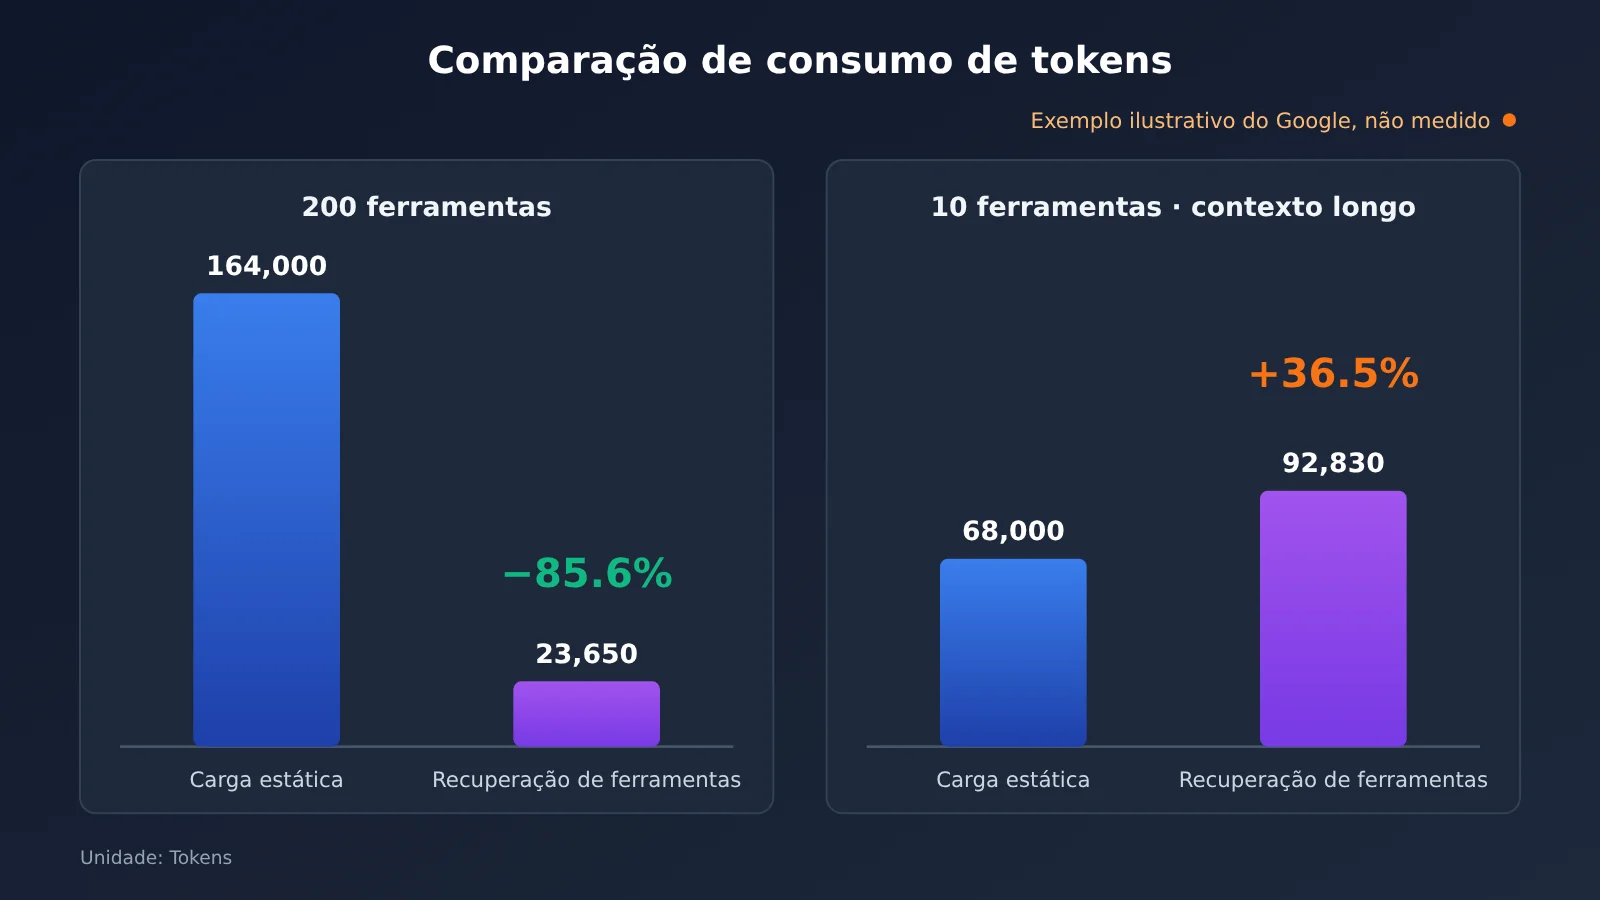
Julgamento 1: o ganho depende do tamanho da biblioteca de ferramentas e do comprimento do contexto — não basta ligar e economizar. A documentação do Google traz dois exemplos hipotéticos que apontam em direções opostas, deixando claro que não são benchmarks de produção. No primeiro: 200 ferramentas, 400 tokens cada, contexto base de 2.000 tokens e 2 requisições. O carregamento estático fica em cerca de 164.000 tokens e o Tool Retrieval em cerca de 23.650 — pela conta do exemplo, uma queda de aproximadamente 85,6%. No segundo: 10 ferramentas com contexto base de 30.000 tokens. O estático fica em 68.000 tokens e o Tool Retrieval chega a 92.830, um aumento de cerca de 36,5%. O motivo é que a inferência extra de busca precisa reprocessar todo aquele contexto longo. A recomendação de engenharia do Google é objetiva: com menos de aproximadamente 20 ferramentas estáveis, o carregamento estático costuma ser suficiente.
Julgamento 2: para avaliar custo, olhe para total_tool_use_tokens, não apenas para a entrada do primeiro turno. Nos testes iniciais oficiais, a descrição curta de cada ferramenta adiada ocupava em média cerca de 26 tokens; com 100 ferramentas, isso dá aproximadamente 2.600 tokens — valores aproximados. O que realmente precisa ser observado são as invocações extras do modelo provocadas pela busca, e o acúmulo dos Schemas já carregados ao longo da sessão. A documentação atual não oferece nenhum mecanismo para descarregar ferramentas já recuperadas: quanto mais ferramentas são recuperadas numa sessão longa, maior fica o contexto. O cache também não beneficia incondicionalmente: com o comando inicial mais curto, ele pode ficar abaixo do limite mínimo do cache implícito.
Julgamento 3: o carregamento de ferramentas sob demanda já é consenso no setor, mas os números de cada fornecedor não podem ser transplantados. A Anthropic lançou o Tool Search Tool em novembro de 2025 e a OpenAI lançou o Tool Search junto com o GPT-5.4 em março de 2026, e as duas divulgaram dados de economia medidos sob as próprias condições. O Google, desta vez, apresentou apenas exemplos hipotéticos. Até 20 de novembro de 2026, não existe nenhum teste independente em produção do Gemini Tool Retrieval que possa ser verificado. Portanto, afirmações do tipo “o Gemini mediu 85% de economia” não se sustentam por enquanto.
Recomendação para quem desenvolve: comece classificando as ferramentas do seu agente atual por frequência de uso — as de uso intenso entram no carregamento direto, as de cauda longa ficam para o carregamento sob demanda. Depois, rode o mesmo lote de tarefas comparando carregamento estático e Tool Retrieval em tokens totais, tempo de ponta a ponta, proporção de escolha da ferramenta correta e taxa de acerto dos parâmetros. O recurso ainda está em fase de preview, sem data de lançamento definida, então em produção é bom manter uma chave para voltar ao carregamento estático. Na fase de escolha do modelo, dá para subir primeiro uma linha de base de Function Calling padrão com a interface unificada do APIYI apiyi.com, a baixo custo, e depois migrar para o v1beta oficial para verificar o ganho líquido do Tool Retrieval.
Quanto mais ferramentas você tem, mais cedo precisa pensar em quando cada uma deve ser tirada da caixa. Como dizem os Analectos (Lunyu, Livro 15, Wei Ling Gong): “Para fazer bem o trabalho, é preciso primeiro afiar as ferramentas.”
📚 Materiais de Referência
-
Introducing Tool Retrieval in the Gemini API: anúncio oficial do Google
- Link:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - Descrição: data de publicação, objetivos de design, MCP e os dois modos de recuperação
- Link:
-
Documentação oficial do Tool retrieval: configuração, limites, cobrança e exemplos de cálculo
- Link:
aistudio.google.com/docs/tool-retrieval - Descrição: principal base para o código deste artigo, regras de erro, replay sem estado e exemplos de cálculo de tokens
- Link:
-
Documentação oficial do Function Calling: execução de funções e retorno de resultados
- Link:
aistudio.google.com/docs/function-calling - Descrição: uso padrão de
function_resultecall_id
- Link:
-
Documentação oficial da Interactions API: estrutura da interface e etapas de execução
- Link:
aistudio.google.com/docs/interactions-overview - Descrição: diferença entre conversas com estado, steps e generateContent
- Link:
-
python-genai v3.6.0 / v3.0.0 Release: registro de versões do SDK
- Link:
github.com/googleapis/python-genai/releases - Descrição: suporte ao Tool Retrieval Schema e mudança na versão padrão da API
- Link:
Autor: Equipe técnica da APIYI
Intercâmbio técnico: testes comparativos de Function Calling com múltiplos modelos podem ser acessados em APIYI apiyi.com; mais materiais de integração estão no centro de documentação docs.apiyi.com