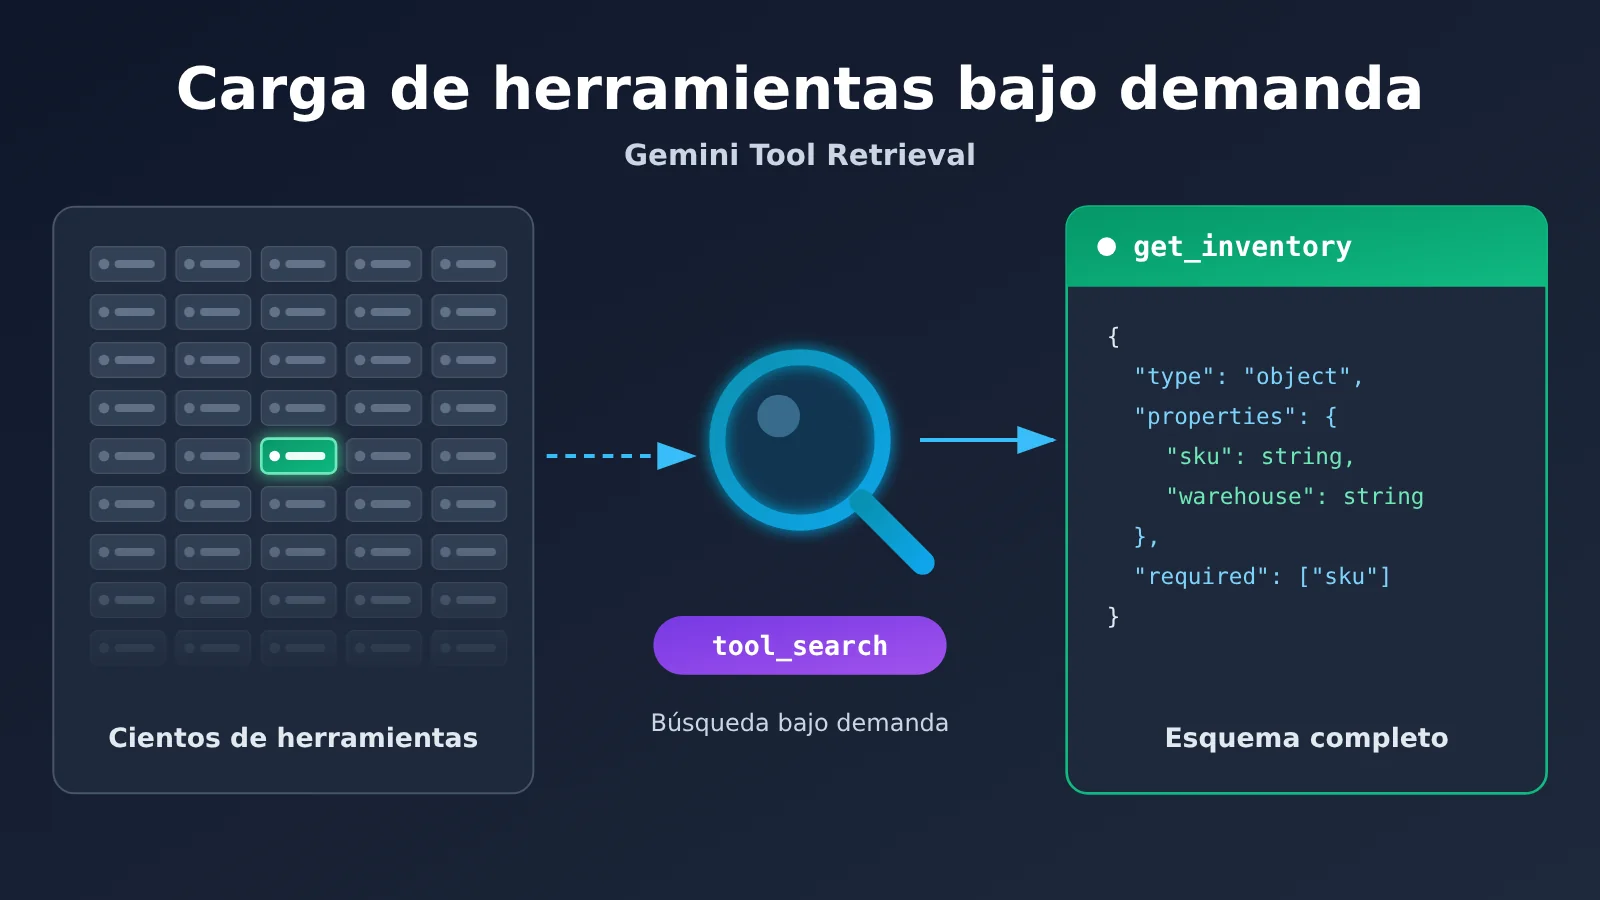
Integrar Gemini Tool Retrieval requiere tres pasos. Primero, añade {"type": "tool_search"} al array tools y define defer_loading: True para las funciones de negocio que se usan poco. Segundo, envía la solicitud con la API Interactions en la versión v1beta y, después, localiza function_call dentro de interaction.steps. Tercero, ejecuta la función en local, construye function_result usando call_id y devuélvelo junto con el array tools completo. No hace falta que escribas tu propio buscador de herramientas: el servidor se encarga de recuperar las herramientas y de cargar el Schema de parámetros.
Hay que dejar claro desde el principio: Tool Retrieval solo cambia «cuándo entra en el contexto del modelo la definición de los parámetros de una herramienta»; las funciones las sigue ejecutando el desarrollador. Tampoco garantiza que ahorres dinero. Cuando hay pocas herramientas y contextos largos, el consumo de tokens incluso podría aumentar.
¿Qué aprenderás al leer este artículo?
- Qué modelos admite Gemini Tool Retrieval, qué versión del SDK se necesita y por qué es obligatorio indicar
v1betade forma explícita. - Un ejemplo completo en Python, con nombres de variables coherentes de principio a fin: dos herramientas diferidas, inventario y pedidos, desde la recuperación hasta la respuesta final.
- Quién se encarga de
tool_search_call,tool_search_result,function_callyfunction_result. - Las diferencias entre las tres vías de extensión: carga diferida de MCP remoto, recuperación en el cliente y registro de herramientas propio (Tool Registry).
- Métodos para diagnosticar de forma centralizada errores comunes como HTTP 400 y cómo decidir antes de activarlo si realmente compensa.
Índice: primero, una tabla «To Know» explica los campos clave; después, «Impacto de un vistazo» aclara qué supone esta función en vista previa para cada tipo de perfil. La sección «Hechos objetivos» sigue el orden de integración: preparar el entorno, definir las herramientas, observar el paso de recuperación, devolver el resultado de la función y, por último, extenderse a MCP y a la recuperación en el cliente; el diagnóstico de errores se concentra al final de esa sección. La sección «Análisis y juicio», a partir de los dos casos de cálculo hipotéticos que ofrece Google, analiza en qué situaciones Tool Retrieval resulta adecuado y en cuáles no.
Conceptos clave de Gemini Tool Retrieval (Lo que hay que saber)
| Concepto | Explicación breve |
|---|---|
| google-genai | Nombre del paquete oficial del SDK de Python de Google; se importa con from google import genai |
| v1beta | Versión de la API de vista previa; es obligatoria para Tool Retrieval y, en este artículo, se especifica explícitamente al inicializar el cliente |
| Interactions API | Interfaz de Google orientada a flujos de trabajo de agentes; admite conversaciones con estado y pasos de ejecución observables |
tool_search |
Tipo especial de herramienta que declara la activación de la recuperación de herramientas; como máximo una por solicitud |
defer_loading |
Hace que la definición completa de los parámetros de una función o de un servidor MCP concreto se cargue de forma diferida en el contexto del modelo |
short_description |
Breve descripción de la función diferida que el modelo puede ver al principio; solo se puede usar con funciones diferidas |
tool_search_call |
Paso de búsqueda iniciado por el modelo durante el flujo de recuperación del lado del servidor |
tool_search_result |
Paso en el que el servidor devuelve el esquema completo de la herramienta coincidente |
function_call |
El modelo solicita al código del desarrollador que ejecute una función y le proporciona los argumentos |
function_result |
Tipo de entrada que usa la aplicación para devolver al modelo el resultado de la ejecución de la función |
call_id |
Identificador que relaciona el resultado de la ejecución de la función con el function_call.id original |
previous_interaction_id |
Identificador que permite que las solicitudes posteriores retomen la interacción ya guardada en el servidor |
signature |
Campo de firma que, al reproducir pasos del historial en una sesión sin estado, debe devolverse sin cambios junto con el paso original |
Gemini Tool Retrieval: resumen de impacto
| Perfil | Impacto real |
|---|---|
| Desarrolladores de agentes | Los agentes con muchas herramientas pueden cargar de forma diferida las herramientas menos usadas, sin tener que montar su propia búsqueda vectorial, pero deben cambiar a Interactions API |
| Equipos que ya usan generateContent | El método anterior no admite Tool Retrieval; necesitan migrar la interfaz y análisis de la estructura de respuesta |
| Integradores de MCP | Pueden establecer defer_loading de forma global en la capa mcp_server, sin tener que declarar cada herramienta |
| Responsables de costos | No hay una tarifa adicional por la función, pero cada búsqueda en el servidor genera una invocación de modelo facturable adicional; conviene vigilar total_tool_use_tokens |
| Proyectos con bibliotecas de herramientas pequeñas | En escenarios con una docena de herramientas y contextos largos puede no compensar; la carga estática podría salir más barata |
Gemini Tool Retrieval: hechos objetivos, información de lanzamiento y flujo de integración
Estado de lanzamiento y modelos compatibles de Gemini Tool Retrieval
El 19 de noviembre de 2026 (madrugada del 20 de noviembre, hora de Pekín), Google publicó en su blog oficial «Introducing Tool Retrieval in the Gemini API», abriendo una vista previa de Tool Retrieval en la Interactions API. Los autores son Lucia Loher, product manager de Gemini API, y Nora Kassner, investigadora científica de Google DeepMind. Actualmente, la función está en estado Preview, y la interfaz podría cambiar antes del lanzamiento oficial.
El anuncio es bastante amplio: «Gemini 3.6 y modelos más recientes, incluidos todos los modelos Gemini 4». Sin embargo, a fecha del 20 de noviembre de 2026, la documentación para desarrolladores solo enumera explícitamente cuatro ID de modelo: gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, gemini-3.6-flash. Al integrarlo, hay que guiarse por la lista de la documentación. Si configuras defer_loading en un modelo no compatible, la API devuelve directamente HTTP 400.
Preparación antes de integrar Gemini Tool Retrieval: SDK y v1beta
El SDK oficial de Python de Google, googleapis/python-genai, publicó la versión v3.6.0 el 18 de noviembre de 2026, que añade esquemas públicos relacionados con Tool Retrieval y los resultados de funciones. El comando de instalación es el siguiente:
pip install -U "google-genai>=3.6.0"
export GEMINI_API_KEY="your-key"   # No escribas la clave real en el código
Hay un detalle con la versión que es fácil pasar por alto. A partir de v3.0.0, el cliente de Gemini Developer API del SDK usa v1 de forma predeterminada, mientras que Tool Retrieval requiere v1beta; por eso, al inicializar, hay que especificarlo explícitamente:
from google import genai

client = genai.Client(
    http_options={"api_version": "v1beta"}
)
El SDK toma las credenciales de la variable de entorno GEMINI_API_KEY. Si usas REST, el endpoint correspondiente es POST https://generativelanguage.googleapis.com/v1beta/interactions, y el encabezado de autenticación es x-goog-api-key.
Paso 1: Definir las herramientas de Gemini con tool_search y defer_loading
El escenario de demostración tiene solo dos herramientas de negocio: get_inventory consulta el inventario de productos y get_order_status consulta el estado de los pedidos; ambas están configuradas para carga diferida. En el array tools, cada campo cumple una función concreta:
{"type": "tool_search"}: activa la búsqueda del lado del servidor; por defectoexecutionesserver. Si no está presente y se definedefer_loading, se produce el errordefer_loading requires tool_search.defer_loading: True: losparameterscompletos no entran en el contexto inicial; al principio el modelo solo ve el nombre y la descripción breve.short_description: la descripción breve que aparece en la lista inicial. Si no se rellena, se toma la primera frase dedescription. Rellenarlo en una función que no es de carga diferida se considera inválido.parameters: aun así deben enviarse completos. Lo que se difiere es el momento en que el esquema entra en el contexto del modelo; el servidor sigue necesitando la definición completa.
¿Qué herramientas convienen para la carga diferida? Google recomienda un uso mixto: las herramientas de alta frecuencia se mantienen con carga directa, y las herramientas de cola larga, especializadas y de baja frecuencia se cargan de forma diferida. Además, las herramientas que se mencionan directamente en las instrucciones del sistema no deberían configurarse como diferidas. De lo contrario, el modelo podría omitir la búsqueda y llamarlas directamente, lo que provocaría errores por falta de contexto de carga. Para herramientas con nombres parecidos, se recomienda añadir un espacio de nombres de negocio, por ejemplo, distinguir con billing_get_customer y crm_get_customer en lugar de llamar a ambas get_customer.
Paso 2: Enviar la solicitud y observar los pasos de recuperación de herramientas de Gemini
A continuación tienes el código de demostración completo. El inventario de «12 unidades» y el estado del pedido demo_pending son datos simulados localmente, no consultan sistemas reales. Para ejecutar el código necesitas una clave API de Gemini válida y permisos de acceso al modelo.
import json
from google import genai

MODEL = "gemini-4-hydrogen"

client = genai.Client(
    http_options={"api_version": "v1beta"}
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "short_description": "Check product inventory by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    },
    {
        "type": "function",
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "short_description": "Check an order's current status.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"]
        }
    }
]

def execute_demo_tool(name, arguments):
    """Función de negocio simulada localmente; no consulta inventario ni pedidos reales."""
    if name == "get_inventory":
        return {"sku": arguments["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": arguments["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(f"Unknown tool: {name}")

# Primera solicitud: el modelo descubre y selecciona las herramientas que necesita
interaction = client.interactions.create(
    model=MODEL,
    input="Consulta el inventario disponible del producto SKU-42.",
    tools=tools
)

print("Pasos de ejecución:")
for step in interaction.steps:
    print(step.type, getattr(step, "name", ""))
Los interaction.steps impresos suelen aparecer en el siguiente orden. El orden concreto y los resultados de la recuperación los decide el modelo, y es posible que en una misma ronda ocurran varias búsquedas.
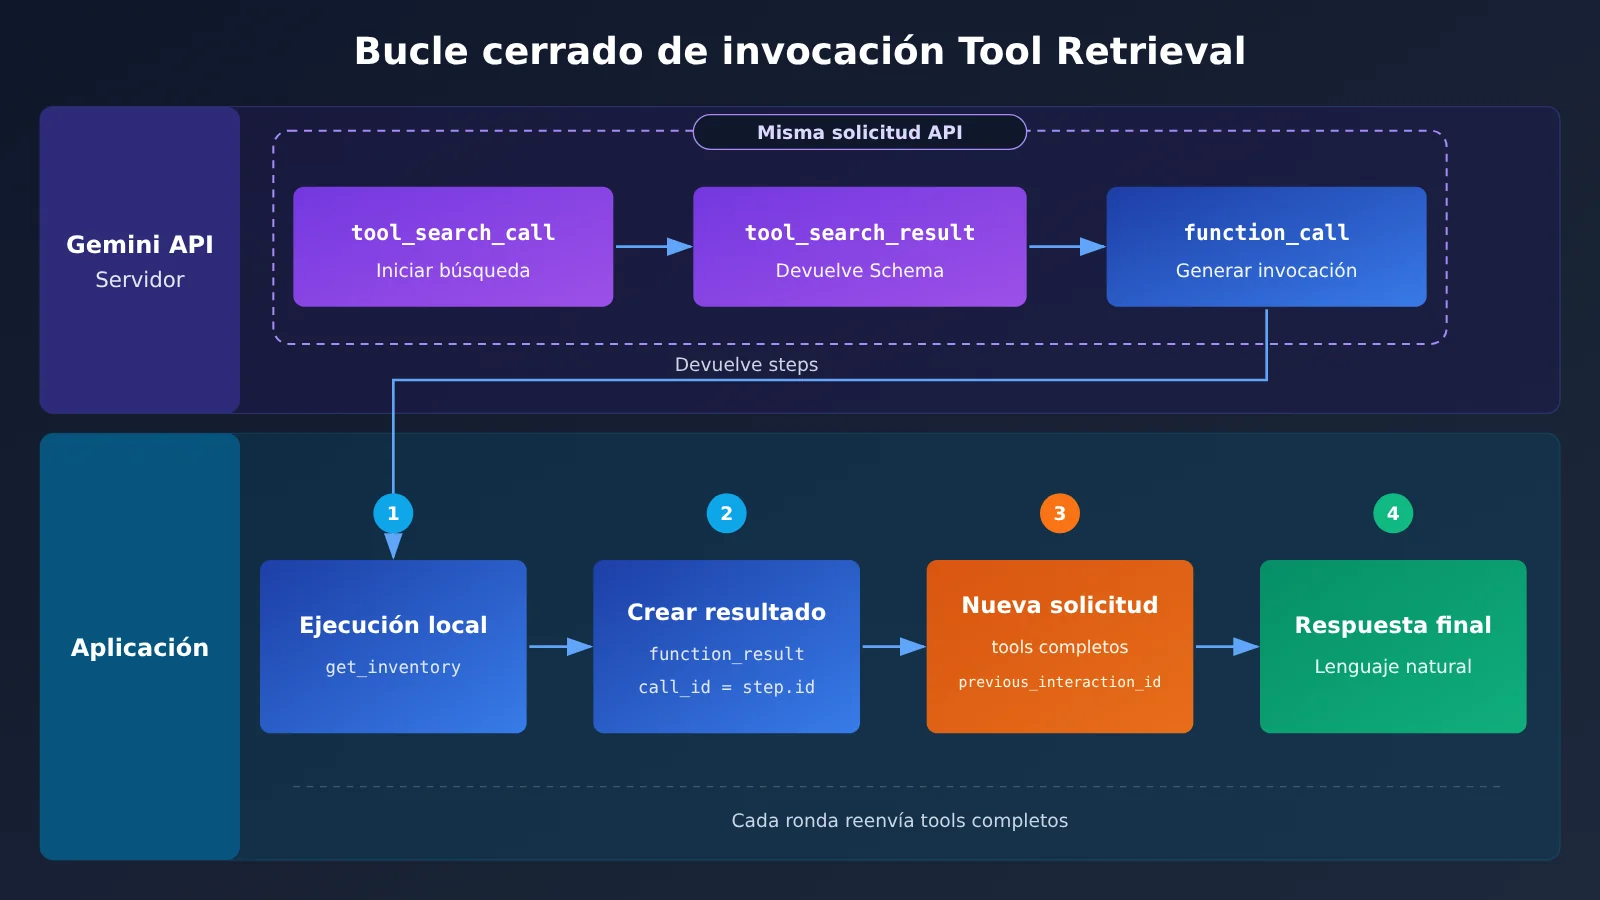
tool_search_call: el modelo detecta que no tiene ninguna herramienta cargada adecuada a mano e inicia una búsqueda del lado del servidor.tool_search_result: la API devuelve el Schema completo de parámetros deget_inventoryque coincide.function_call: tras leer el Schema, el modelo genera una llamada comoget_inventory(sku="SKU-42").
Estos tres pasos ocurren dentro de la misma solicitud externa a la API: la aplicación no necesita escribir un buscador aparte ni enviar otra solicitud de recuperación. Los dos primeros pasos solo hay que observarlos y registrarlos, no repetir la búsqueda localmente. Pero «la misma solicitud» no equivale a «una sola inferencia»: cada búsqueda del lado del servidor dispara invocaciones adicionales del modelo, y esos tokens se facturan con normalidad. Al depurar hay otro detalle que conviene tener en cuenta: no basta con mirar interaction.status. Aunque el estado no sea requires_action, los steps también pueden contener un function_call pendiente de ejecución.
Tercer paso: ejecutar la función y devolver function_result
Tool Retrieval solo se encarga de encontrar la herramienta y cargar los parámetros; la función de negocio real sigue siendo ejecutada por la aplicación, y esta parte mantiene el mecanismo estándar de Function Calling. Continuando con el código anterior:
# Solo ejecutar la llamada real a la función de negocio; no ejecutar tool_search_call del lado de la aplicación
function_results = []

for step in interaction.steps:
    if step.type != "function_call":
        continue
    result = execute_demo_tool(step.name, step.arguments)
    function_results.append({
        "type": "function_result",
        "name": step.name,
        "call_id": step.id,
        "result": [{"type": "text", "text": json.dumps(result, ensure_ascii=False)}]
    })

# Enviar los resultados de la función local de vuelta a Gemini
if function_results:
    followup = client.interactions.create(
        model=MODEL,
        previous_interaction_id=interaction.id,
        tools=tools,
        input=function_results
    )
    print("最终回答:", followup.output_text)
else:
    print("当前回答:", interaction.output_text)
Hay tres puntos que conviene tener en cuenta en este código. Primero, call_id debe tomarse del step.id del function_call original. Cuando hay varias llamadas en una ronda, el modelo se apoya en él para corresponder cada resultado. Segundo, previous_interaction_id=interaction.id permite que el servidor retome el registro de interacción ya guardado, incluidas las herramientas que ya se recuperaron. Tercero, la segunda ronda también debe pasar el array tools completo. La API conserva el historial de pasos, pero no conserva las declaraciones de herramientas; tool_search, todas las herramientas diferidas y no diferidas, y la configuración de MCP deben reenviarse en cada ronda.
Este ejemplo solo muestra un ciclo cerrado de una única llamada a función; no incluye un planificador de Agent multi-turno genérico. Si en followup todavía aparece un function_call, basta con seguir procesándolo de la misma manera.
🎯 Consejo técnico: Tool Retrieval en sí depende de la Interactions API oficial
v1betade Google. Si quieres primero validar tus funciones de negocio con el Function Calling estándar y comparar cómo distintos modelos eligen herramientas y rellenan parámetros, puedes usar la misma clave en APIYI apiyi.com para cambiar entre modelos como Gemini, Claude y GPT y hacer pruebas de línea base.
Extensión: MCP remoto y recuperación con el cliente de Gemini
Un servidor MCP remoto puede configurar la carga diferida en la propia capa del servidor, de modo que las herramientas que expone se cargan bajo demanda:
mcp_tools = [
    {"type": "tool_search"},
    {
        "type": "mcp_server",
        "name": "weather_service",
        "url": "https://gemini-api-demos.uc.r.appspot.com/mcp",
        "defer_loading": True
    }
]
A diferencia de las funciones personalizadas, las herramientas MCP remotas las ejecuta la API en su lugar; en los steps aparecen mcp_server_tool_call y mcp_server_tool_result, y la aplicación no necesita devolver el resultado. Por ahora, la documentación oficial no indica el «número máximo de herramientas que se pueden diferir».
Si la empresa ya cuenta con su propio registro de herramientas, recuperación vectorial o filtrado de permisos por usuario, puede optar por la recuperación del lado del cliente: configure "execution": "client" y proporcione name, description y parameters completos. En ese caso, la primera ronda devuelve una function_call normal a search_tool_registry. Tras la recuperación, la aplicación devuelve en function_result.result un array de objetos de declaración de herramientas completas, sin serializarlo como una cadena JSON. El modo cliente no usa defer_loading, y una misma solicitud no puede mezclar ambos modos.
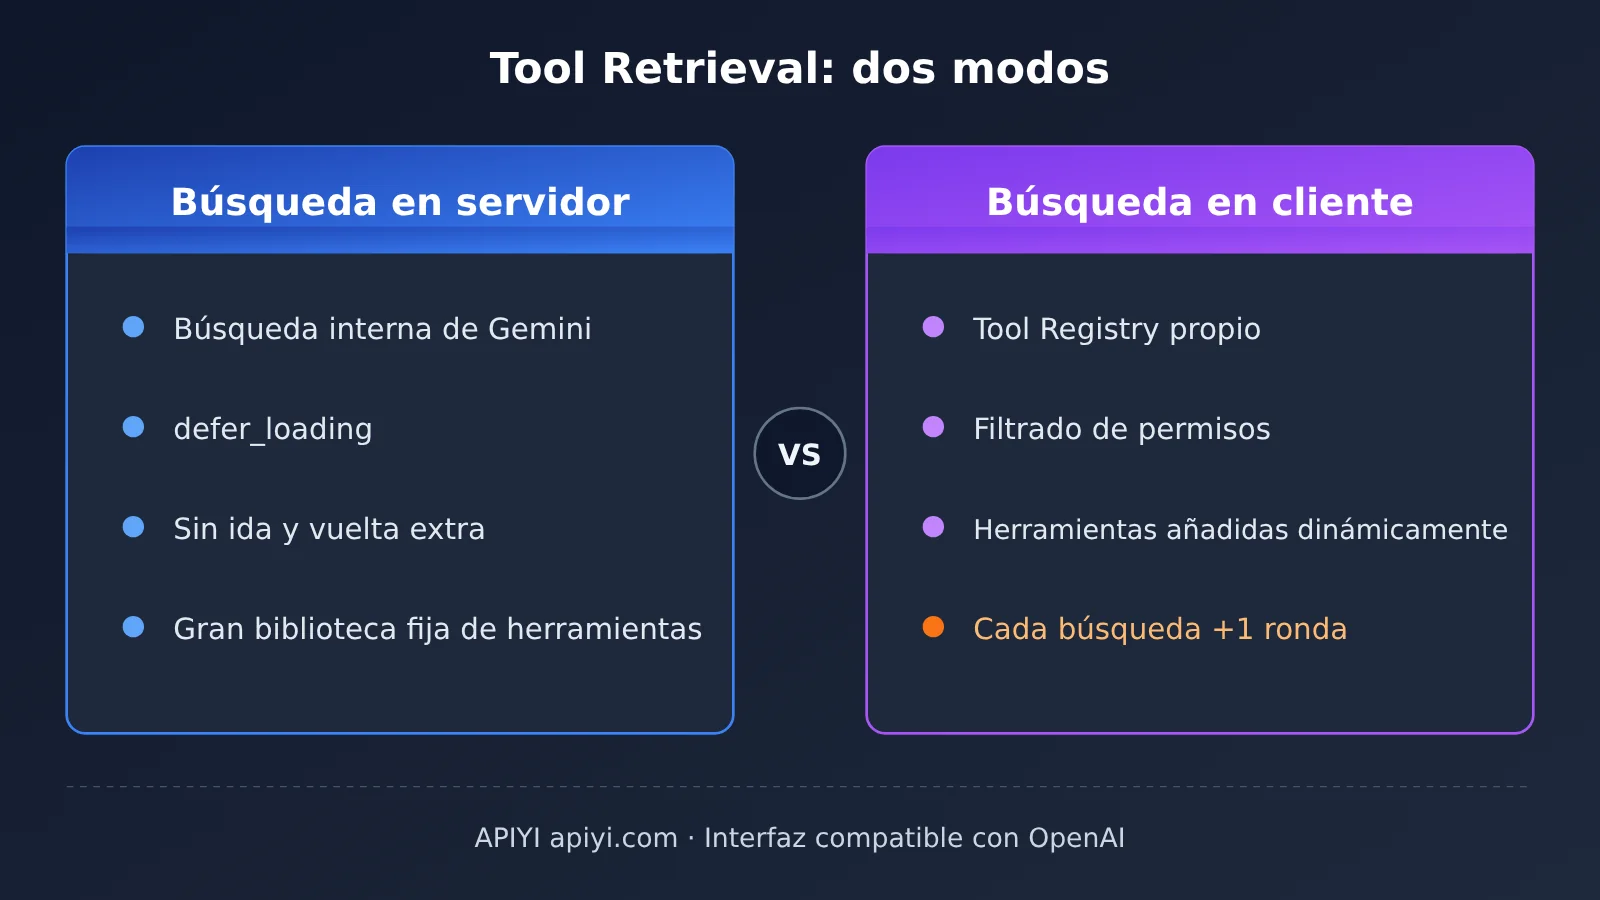
| Dimensión | Recuperación del lado del servidor | Recuperación del lado del cliente (Gemini) | Tool Registry propio (solución genérica) |
|---|---|---|---|
| Ejecutor de la recuperación | Gemini API | Aplicación del desarrollador | Aplicación del desarrollador |
| Configuración clave | tool_search + defer_loading |
tool_search + execution: client |
Function Calling normal |
| ¿Hay que declarar todas las herramientas de antemano? | Sí | No | No |
| Viajes de red adicionales | Ninguno | +1 ronda por búsqueda | +1 ronda por búsqueda |
| Añadir herramientas dinámicamente | Poco práctico | Compatible | Compatible |
| Escenarios típicos | Bibliotecas de herramientas grandes y relativamente fijas | Multi-tenant, registro privado | Reutilización entre modelos, cambio entre proveedores |
| Plataforma disponible | Google oficial v1beta | Google oficial v1beta | Interfaz compatible con OpenAI de APIYI apiyi.com, etc. |
La última columna no es Gemini Tool Retrieval, sino una implementación de ingeniería de enfoque similar: primero se expone solo una función de búsqueda y, cuando la recuperación encuentra coincidencias, se añaden los esquemas correspondientes a tools. Resulta adecuada para equipos que necesitan cambiar entre varios modelos. La implementación mínima es la siguiente:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)
MODEL = "your-model-name"  # Consulte la lista de modelos de la plataforma

search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}
Ver la llamada completa en dos etapas del Tool Registry propio
import json, os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"
)
MODEL = "your-model-name"  # Según la lista de modelos de la plataforma

TOOL_REGISTRY = {
    "get_inventory": {"type": "function", "function": {
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "parameters": {"type": "object", "properties": {"sku": {"type": "string"}}, "required": ["sku"]}}},
    "get_order_status": {"type": "function", "function": {
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "parameters": {"type": "object", "properties": {"order_id": {"type": "string"}}, "required": ["order_id"]}}},
}
search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools (inventory, orders) by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}

def search_registry(query):
    q = query.lower()
    return [name for name, t in TOOL_REGISTRY.items()
            if any(w in t["function"]["description"].lower() for w in q.split())]

def execute_demo_tool(name, args):
    if name == "get_inventory":
        return {"sku": args["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": args["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(name)

messages = [{"role": "user", "content": "查询商品 SKU-42 的可用库存。"}]
tools = [search_tool]

for _ in range(4):  # Límite simple de iteraciones para evitar un bucle infinito
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    if not msg.tool_calls:
        print("最终回答:", msg.content)
        break
    messages.append(msg)
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        if call.function.name == "search_tool_registry":
            names = search_registry(args["query"])
            tools += [TOOL_REGISTRY[n] for n in names if TOOL_REGISTRY[n] not in tools]
            content = json.dumps({"loaded_tools": names})
        else:
            content = json.dumps(execute_demo_tool(call.function.name, args), ensure_ascii=False)
        messages.append({"role": "tool", "tool_call_id": call.id, "content": content})
💡 Consejo de elección: La calidad de recuperación de la ruta de registro depende de tu función de búsqueda; la coincidencia por palabras clave del ejemplo solo sirve para demostración. En APIYI apiyi.com, cambia de modelo y ejecuta el mismo conjunto de tareas; compara «si se encontró la herramienta correcta» y «si los parámetros se completaron correctamente», y podrás ver qué modelo se adapta mejor a tu biblioteca de herramientas.
Errores comunes en la recuperación de herramientas de Gemini: revisión centralizada
| Síntoma | Causa | Solución |
|---|---|---|
defer_loading requires tool_search |
Se declaró una función diferida, pero no hay tool_search en el servidor |
Agregar {"type": "tool_search"} en tools |
short_description no es válido |
Se definió en una función que no es diferida | Usarlo solo en funciones con defer_loading=True |
| HTTP 400 unsupported model | El modelo no está en la lista de admitidos | Cambiar a los 4 ID de modelo indicados en la documentación |
| La solicitud no surte efecto o da error de versión | El SDK usa v1 por defecto, o se llamó a generateContent |
Establecer explícitamente api_version="v1beta" y cambiar a Interactions API |
| HTTP 400 en la segunda ronda | Con store=False se omitió el paso de recuperación o la signature |
Reenviar tal cual tool_search_call/result y todas las firmas |
| El modelo usa herramientas antiguas o las herramientas no están disponibles | En solicitudes posteriores se omitió tools |
Reenviar el arreglo completo de tools en cada ronda |
| Después de la recuperación, los parámetros están vacíos | Para la herramienta diferida solo se enviaron el nombre y una descripción breve | También hay que enviar los parameters completos para la herramienta diferida |
| Falla la configuración de recuperación en el cliente | Faltan campos como name y description |
Completar la definición de la función de búsqueda del cliente |
El modo sin estado (store=False) requiere una explicación aparte. En este caso no se puede depender de previous_interaction_id; la aplicación debe guardar y reenviar tal cual la entrada del usuario, tool_search_call, tool_search_result, function_call, function_result y todas las signature. Si se elimina o modifica cualquiera de estos pasos, es posible que el servidor no pueda reconstruir el contexto de recuperación. Además, cuando el servidor no encuentra una herramienta coincidente, puede devolver directamente un texto en lugar de un error estructurado. Por eso, que “la solicitud no haya dado error” no significa que “la recuperación haya sido exitosa”; al validar, hay que comprobar uno por uno si en steps aparecen el paso de recuperación y la llamada a función esperados.
Gemini Tool Retrieval: análisis y criterios para decidir cuándo conviene integrarlo
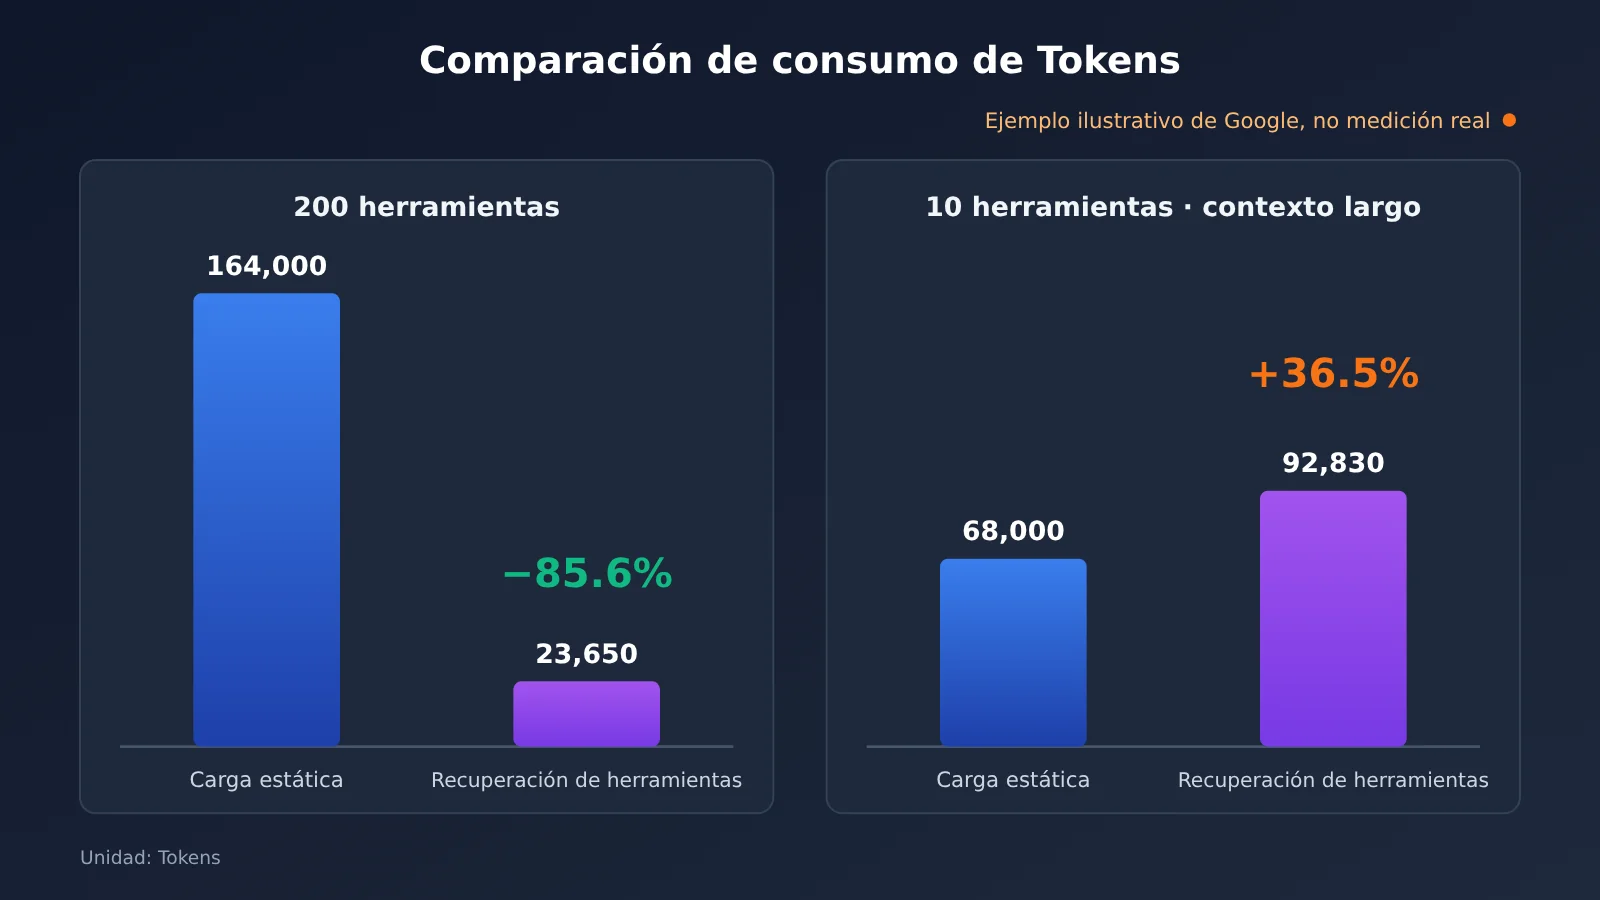
Punto clave 1: el beneficio depende del tamaño de la biblioteca de herramientas y de la longitud del contexto; no basta con activarlo para ahorrar. La documentación de Google ofrece dos ejemplos hipotéticos que apuntan en direcciones opuestas y aclara que no son benchmarks de producción. El primero: 200 herramientas, 400 tokens por herramienta, un contexto base de 2,000 tokens y 2 solicitudes; la carga estática ronda los 164,000 tokens y Tool Retrieval unos 23,650 tokens, lo que implica una reducción estimada de alrededor del 85.6%. El segundo: 10 herramientas y un contexto base de 30,000 tokens; la carga estática es de 68,000 tokens, mientras que Tool Retrieval llega a 92,830 tokens, un aumento de alrededor del 36.5%, porque la inferencia adicional de búsqueda tiene que procesar de nuevo todo el contexto largo. La recomendación de ingeniería de Google es que, con menos de unas 20 herramientas estables, la carga estática suele ser suficiente.
Punto clave 2: para evaluar el costo hay que fijarse en total_tool_use_tokens, no solo en la entrada de la primera ronda. En las primeras pruebas oficiales, la descripción breve de cada herramienta diferida ocupa de media unos 26 tokens; con 100 herramientas, unos 2,600 tokens, son valores aproximados. Lo que de verdad hay que vigilar son las invocaciones adicionales del modelo que dispara la búsqueda y la acumulación de esquemas ya cargados durante la sesión. La documentación actual no ofrece ningún mecanismo para descargar herramientas ya recuperadas; en sesiones largas, cuantas más herramientas se recuperan, más grande se vuelve el contexto. La caché tampoco es beneficiosa en todos los casos: cuando la indicación inicial se acorta, puede quedar por debajo del umbral mínimo de la caché implícita.
Punto clave 3: la carga de herramientas bajo demanda ya es un consenso del sector, pero los datos de cada proveedor no se pueden trasladar sin más. Anthropic lanzó Tool Search Tool en noviembre de 2025, y OpenAI lanzó Tool Search en marzo de 2026 junto con GPT-5.4; ambas han publicado datos de ahorro medidos en sus propias condiciones. Google esta vez solo ha presentado ejemplos hipotéticos. A 20 de noviembre de 2026, aún no hay mediciones independientes en producción de Gemini Tool Retrieval que se puedan verificar. Por eso, afirmaciones como «Gemini ahorra un 85% en mediciones reales» no se sostienen por ahora.
Recomendaciones para desarrolladores: primero ordenen las herramientas de sus agentes actuales por frecuencia de invocación: las de alta frecuencia se cargan directamente y las de cola larga de forma diferida; después, con el mismo conjunto de tareas, comparen la carga estática y Tool Retrieval en tokens totales, tiempo de extremo a extremo, proporción de herramientas elegidas correctamente y tasa de acierto en los parámetros. La función sigue en fase de vista previa y aún no tiene fecha de lanzamiento oficial; en producción, conviene mantener un interruptor para volver a la carga estática. Durante la fase de selección del modelo, pueden usar primero la interfaz unificada de APIYI (apiyi.com) para ejecutar a bajo costo una línea base estándar de Function Calling y, después, migrar a la v1beta oficial para verificar el beneficio neto de Tool Retrieval.
Cuantas más herramientas haya, más importante es tener claro cuándo sacar cada una. Como se dice en las Analectas (Lunyu), en el capítulo «Wei Ling Gong»: «Para hacer bien un trabajo, primero hay que afilar las herramientas.»
📚 Referencias
-
Introducing Tool Retrieval in the Gemini API: anuncio oficial de Google
- Enlace:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - Descripción: fecha de publicación, objetivos de diseño, MCP y los dos modos de recuperación
- Enlace:
-
Documentación oficial de Tool Retrieval: configuración, límites, facturación y ejemplos de cálculo
- Enlace:
aistudio.google.com/docs/tool-retrieval - Descripción: base principal del código de este artículo, las reglas de error, la reproducción sin estado y los ejemplos de cálculo de tokens
- Enlace:
-
Documentación oficial de Function Calling: ejecución de funciones y retorno de resultados
- Enlace:
aistudio.google.com/docs/function-calling - Descripción: uso estándar de
function_resultycall_id
- Enlace:
-
Documentación oficial de Interactions API: estructura de la interfaz y pasos de ejecución
- Enlace:
aistudio.google.com/docs/interactions-overview - Descripción: diferencias entre conversación con estado, steps y generateContent
- Enlace:
-
python-genai v3.6.0 / v3.0.0 Release: registro de versiones del SDK
- Enlace:
github.com/googleapis/python-genai/releases - Descripción: soporte del esquema de Tool Retrieval y cambios en la versión predeterminada de la API
- Enlace:
Autor: equipo técnico de APIYI
Intercambio técnico: para pruebas comparativas de Function Calling con múltiples modelos, visita APIYI apiyi.com; más material de integración en el centro de documentación docs.apiyi.com