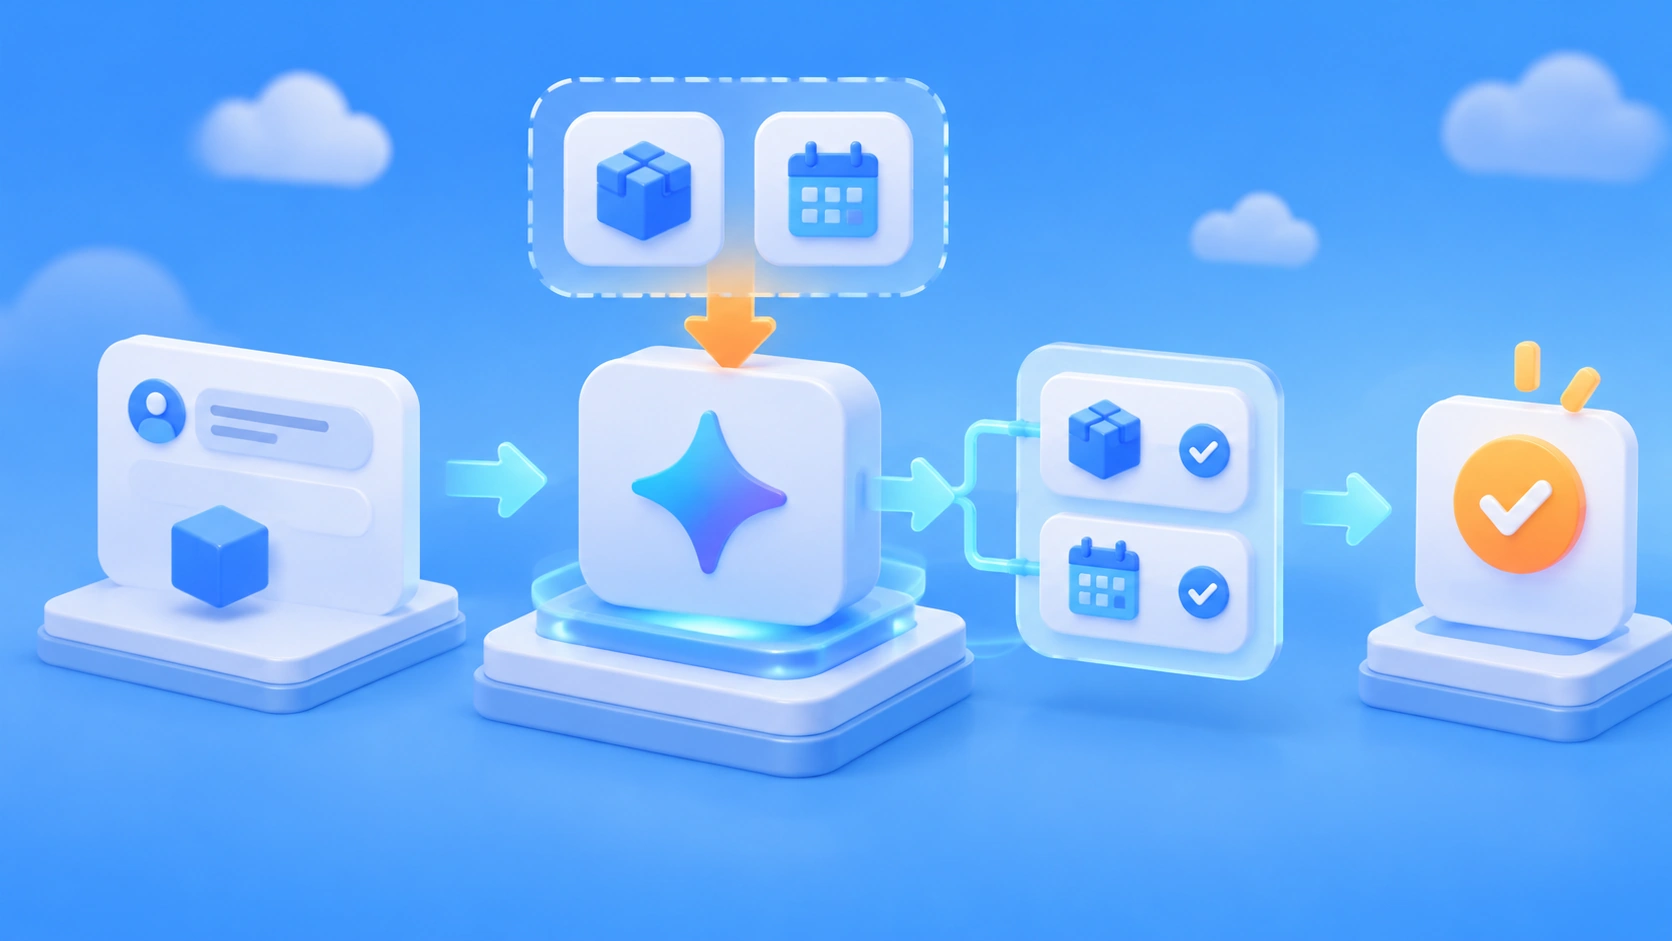
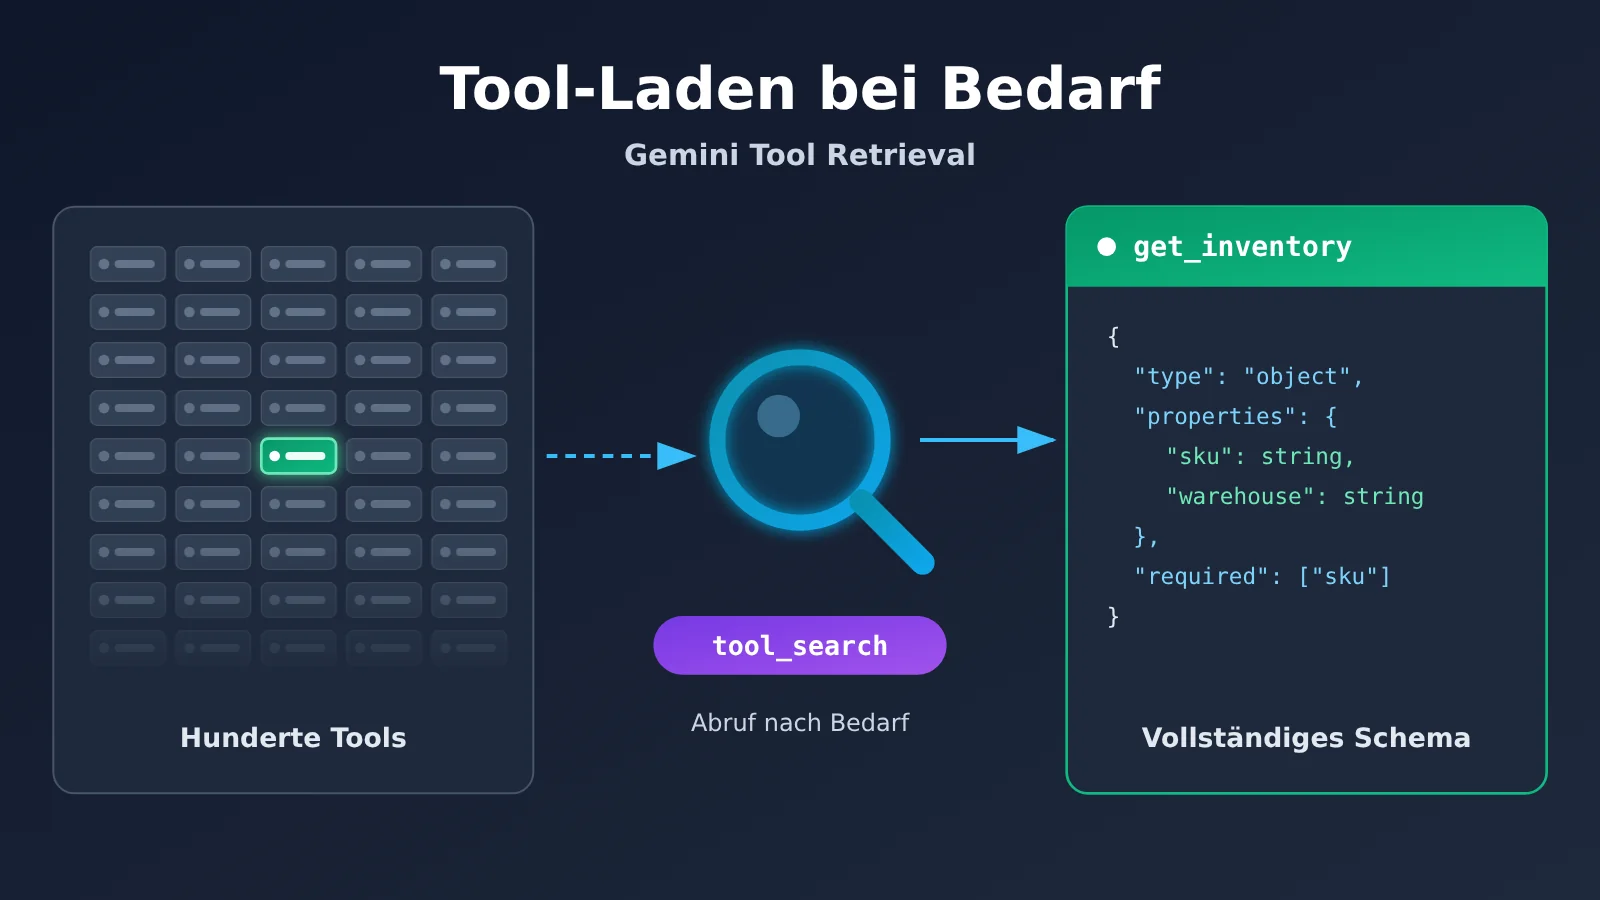
Für die Integration von Gemini Tool Retrieval sind drei Schritte nötig. Erstens: Fügen Sie dem tools-Array {"type": "tool_search"} hinzu und setzen Sie für selten genutzte Geschäftsfunktionen defer_loading: True. Zweitens: Senden Sie die Anfrage über die Interactions API in der Version v1beta und suchen Sie anschließend in interaction.steps nach dem function_call. Drittens: Führen Sie die Funktion lokal aus, konstruieren Sie anhand der call_id ein function_result und senden Sie dieses zusammen mit dem vollständigen tools-Array zurück. Sie müssen keinen eigenen Tool-Searcher schreiben; der Dienst übernimmt die Tool-Retrieval und das Laden der Parameter-Schemas.
Vorab eine klare Abgrenzung: Tool Retrieval ändert nur, wann die Definitionen der Tool-Parameter in den Kontext des Modells gelangen; die Funktionen müssen weiterhin von Entwicklern ausgeführt werden. Es garantiert auch keine Kosteneinsparung. In Szenarien mit wenigen Tools und langem Kontext kann der Token-Verbrauch sogar steigen.
Was Sie aus diesem Artikel mitnehmen können
- Welche Modelle Gemini Tool Retrieval unterstützen, welche SDK-Version erforderlich ist und warum
v1betaexplizit angegeben werden muss - Ein vollständiges Python-Beispiel mit durchgängig gleichen Variablennamen: zwei verzögerte Tools für Lagerbestand und Bestellungen, von der Suche bis zur endgültigen Antwort
- Wer
tool_search_call,tool_search_result,function_callundfunction_resultjeweils verarbeitet - Unterschiede zwischen drei Erweiterungswegen: verzögertes Laden über remote MCP, clientseitige Suche und ein selbst aufgebautes Tool Registry
- Zentrale Fehlersuche bei häufigen Fehlern wie HTTP 400 und wie Sie vor der Aktivierung einschätzen, ob es sich lohnt
Index: Zunächst erklärt eine To-Know-Tabelle die Kernfelder, danach zeigt der Abschnitt „Auswirkungen im Überblick“, was diese Vorschaufunktion für unterschiedliche Rollen bedeutet. Der Abschnitt „Sachliche Fakten“ folgt dem Integrationsablauf: Umgebung vorbereiten, Tools definieren, Retrieval-Schritte beobachten, Funktionsergebnisse zurückgeben und schließlich auf MCP und clientseitige Suche erweitern. Die Fehlersuche ist gesammelt am Ende dieses Abschnitts untergebracht. Der Abschnitt „Analyse und Einschätzung“ diskutiert anhand der zwei hypothetischen Rechenbeispiele von Google, für welche Szenarien Tool Retrieval geeignet ist und für welche nicht.
Gemini Tool Retrieval – Wichtige Konzepte (To Know)
| Konzept | Kurze Erklärung |
|---|---|
| google-genai | Offizieller Paketname des Google Python SDK, Import erfolgt über from google import genai |
| v1beta | Vorschau-Schnittstellenversion, für Tool Retrieval zwingend erforderlich; wird in diesem Artikel bei der Client-Initialisierung explizit angegeben |
| Interactions API | Google-Schnittstelle für Agent-Workflows, unterstützt zustandsbehaftete Dialoge und beobachtbare Ausführungsschritte |
tool_search |
Spezieller Tool-Typ, der die Tool-Suche aktiviert – maximal einer pro Anfrage |
defer_loading |
Lässt die vollständigen Parameterdefinitionen angegebener Funktionen oder MCP-Server verzögert in den Modellkontext eintreten |
short_description |
Kurzbeschreibung einer verzögerten Funktion, die das Modell zunächst sieht; nur für verzögerte Funktionen verwendbar |
tool_search_call |
Suchschritt, den das Modell im serverseitigen Retrieval-Prozess auslöst |
tool_search_result |
Schritt, in dem der Server das vollständige Schema der passenden Tools zurückgibt |
function_call |
Das Modell fordert den Entwicklercode auf, eine Funktion auszuführen, und übergibt die Parameter |
function_result |
Eingabetyp, mit dem die Anwendung das Funktionsergebnis an das Modell zurückliefert |
call_id |
Kennung, die das Funktionsergebnis mit der ursprünglichen function_call.id verknüpft |
previous_interaction_id |
Kennung, mit der nachfolgende Anfragen an die serverseitig gespeicherte Interaktionshistorie anknüpfen |
signature |
Signaturfeld, das bei der Wiedergabe von Verlaufsschritten in zustandslosen Sitzungen unverändert zusammen mit dem ursprünglichen Schritt zurückgegeben werden muss |
Gemini Tool Retrieval: Auswirkungen im Überblick
| Zielgruppe | Praktische Auswirkung |
|---|---|
| Agent-Entwickler | Agents mit vielen Tools können Long-Tail-Tools verzögert laden und müssen keine eigene Vektorsuche aufbauen, müssen aber auf die Interactions API umsteigen |
| Teams, die generateContent bereits nutzen | Die alte Methode unterstützt Tool Retrieval nicht; Schnittstelle und Parsing der Rückgabestruktur müssen migriert werden |
| MCP-Integratoren | defer_loading lässt sich auf der mcp_server-Ebene global setzen, ohne jedes Tool einzeln zu deklarieren |
| Kostenverantwortliche | Es gibt keine separate Funktionsgebühr, aber jede serverseitige Suche erzeugt zusätzliche kostenpflichtige Modellaufrufe; total_tool_use_tokens sollte im Auge behalten werden |
| Projekte mit kleinen Tool-Bibliotheken | Bei einem Dutzend Tools und langem Kontext lohnt es sich nicht unbedingt; statisches Laden kann sparsamer sein |
Gemini Tool Retrieval: Fakten zu Release-Informationen und Integrationsablauf
Gemini Tool Retrieval: Release-Status und unterstützte Modelle
Am 19. November 2026 (nach Pekinger Zeit am frühen Morgen des 20. November) veröffentlichte Google im offiziellen Blog den Beitrag „Introducing Tool Retrieval in the Gemini API“ und öffnete Tool Retrieval als Preview in der Interactions API. Die Autoren sind Lucia Loher, Produktmanagerin der Gemini API, und Nora Kassner, Forscherin bei Google DeepMind. Die Funktion befindet sich derzeit im Preview-Status; vor der offiziellen Veröffentlichung können sich die Schnittstellen noch ändern.
Die Ankündigung ist recht allgemein gehalten: „Gemini 3.6 und neuere Modelle, einschließlich aller Gemini 4-Modelle“. Die Entwicklerdokumentation führt jedoch mit Stand vom 20. November 2026 nur vier Modell-IDs explizit auf: gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash und gemini-3.6-flash. Bei der Integration sollte die Liste in der Dokumentation maßgeblich sein. Wird defer_loading für ein nicht unterstütztes Modell gesetzt, gibt die API direkt HTTP 400 zurück.
Gemini Tool Retrieval: Vorbereitung vor der Integration – SDK und v1beta
Das offizielle Google Python SDK googleapis/python-genai hat am 18. November 2026 die Version v3.6.0 veröffentlicht und neue öffentliche Schemas für Tool Retrieval und Funktionsergebnisse hinzugefügt. Der Installationsbefehl lautet:
pip install -U "google-genai>=3.6.0"
export GEMINI_API_KEY="your-key"   # Den echten Schlüssel nicht in den Code schreiben
Bei der Versionsnummer gibt es eine Stolperfalle. Seit v3.0.0 verwendet der Gemini-Developer-API-Client standardmäßig v1, während Tool Retrieval v1beta erfordert. Deshalb muss die Version bei der Initialisierung explizit angegeben werden:
from google import genai

client = genai.Client(
    http_options={"api_version": "v1beta"}
)
Das SDK liest die Zugangsdaten aus der Umgebungsvariable GEMINI_API_KEY. Bei Verwendung von REST lautet der entsprechende Endpoint POST https://generativelanguage.googleapis.com/v1beta/interactions, der Authentifizierungs-Header ist x-goog-api-key.
Schritt 1: Gemini-Tools mit tool_search und defer_loading definieren
Das Demo-Szenario hat nur zwei Business-Tools: get_inventory fragt den Produktbestand ab, get_order_status den Bestellstatus. Beide sind auf verzögertes Laden (Deferred Loading) gesetzt. Die Aufgabenverteilung der einzelnen Felder im tools-Array:
{"type": "tool_search"}: aktiviert die serverseitige Suche,executionist standardmäßig aufservergesetzt. Fehlt dieses Feld und man setzt trotzdemdefer_loading, kommt der Fehlerdefer_loading requires tool_search.defer_loading: True: Die vollständigenparametersgelangen nicht in den initialen Kontext; das Modell sieht anfangs nur Name und Kurzbeschreibung.short_description: die Kurzbeschreibung in der initialen Liste. Wird sie nicht angegeben, nimmt man den ersten Satz ausdescription. Bei nicht verzögerten Funktionen gilt das Ausfüllen als ungültig.parameters: müssen trotzdem vollständig übermittelt werden. Verzögert wird nur der Zeitpunkt, zu dem das Schema in den Modellkontext gelangt; der Server braucht weiterhin die vollständige Definition.
Welche Tools eignen sich für verzögertes Laden? Google empfiehlt eine Mischung: häufig genutzte Tools werden direkt geladen, seltene, spezialisierte Long-Tail-Tools verzögert. Außerdem sollten Tools, die in den Systemanweisungen direkt namentlich genannt werden, nicht auf verzögert gesetzt werden. Sonst könnte das Modell die Suche umgehen und das Tool direkt aufrufen – dann fehlt der geladene Kontext und es kommt zu Fehlern. Bei Tools mit ähnlichen Namen empfiehlt es sich, einen Business-Namespace hinzuzufügen, etwa billing_get_customer und crm_get_customer zur Unterscheidung, statt beide get_customer zu nennen.
Schritt 2: Anfrage senden und die Tool-Suchschritte von Gemini beobachten
Hier ist der vollständige Demo-Code. Der Lagerbestand „12 Stück“ und der Bestellstatus demo_pending sind lokal simulierte Daten; es werden keine echten Systeme abgefragt. Für die Ausführung des Codes braucht man einen gültigen Gemini-API-Schlüssel und Zugriff auf das Modell.
import json
from google import genai

MODEL = "gemini-4-hydrogen"

client = genai.Client(
    http_options={"api_version": "v1beta"}
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "short_description": "Check product inventory by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    },
    {
        "type": "function",
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "short_description": "Check an order's current status.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"]
        }
    }
]

def execute_demo_tool(name, arguments):
    """Lokale simulierte Geschäftsfunktion, die weder echte Lagerbestände noch Bestellungen abfragt."""
    if name == "get_inventory":
        return {"sku": arguments["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": arguments["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(f"Unknown tool: {name}")

# Erste Anfrage: Das Modell entdeckt und wählt die benötigten Tools aus
interaction = client.interactions.create(
    model=MODEL,
    input="查询商品 SKU-42 的可用库存。",
    tools=tools
)

print("执行步骤:")
for step in interaction.steps:
    print(step.type, getattr(step, "name", ""))
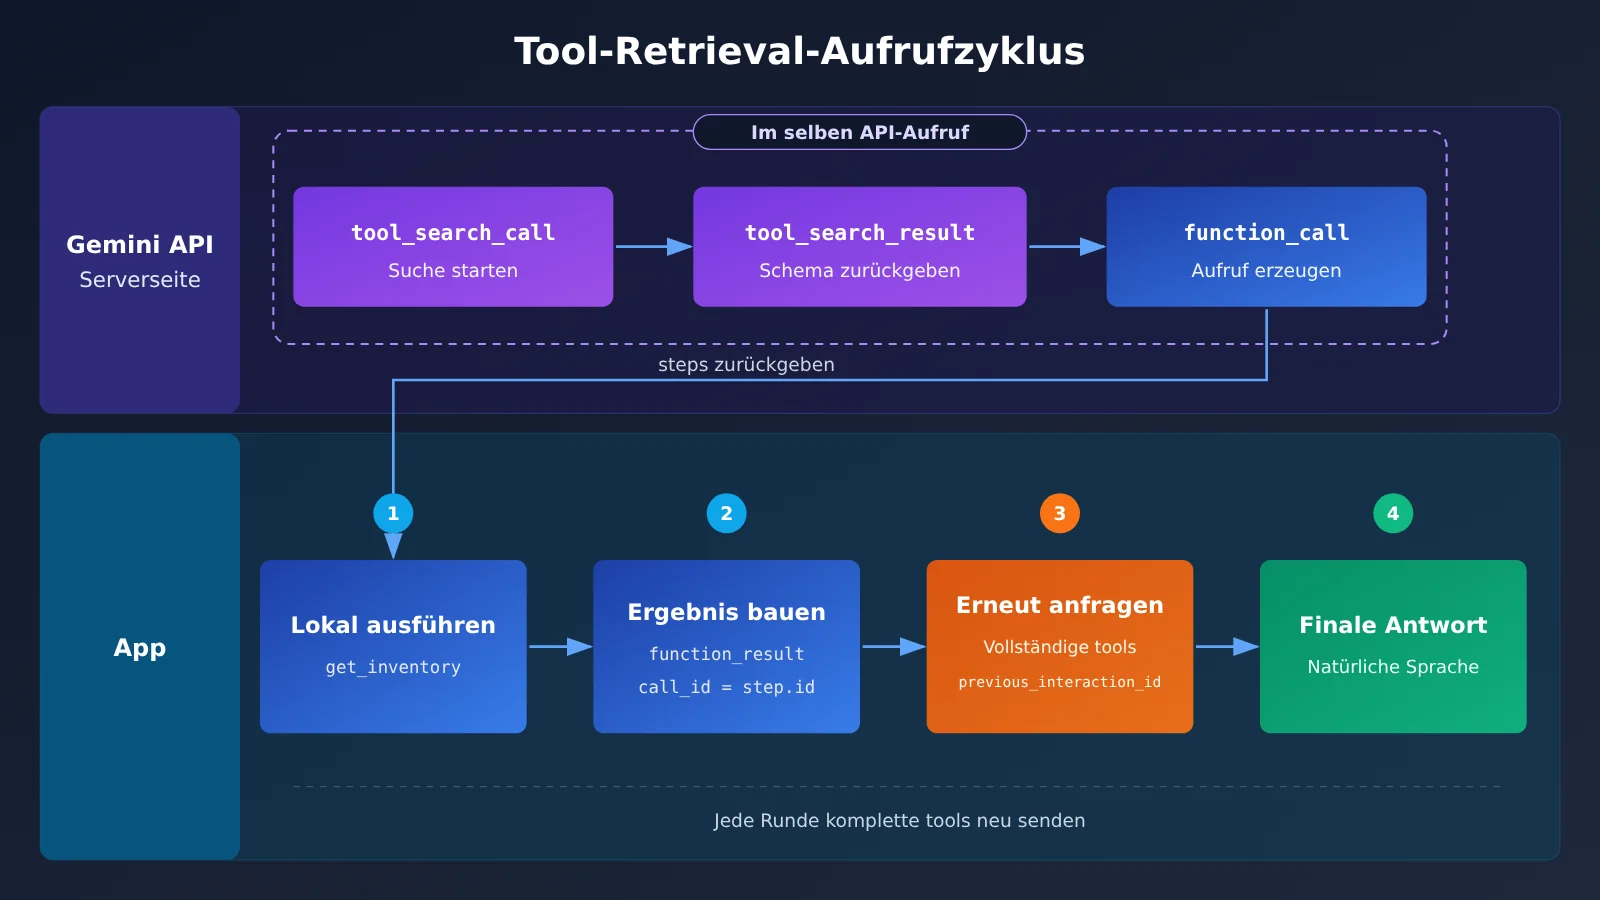
Die ausgegebenen interaction.steps erscheinen in der Regel in der folgenden Reihenfolge. Die konkrete Reihenfolge und die Suchergebnisse bestimmt das Modell; in einem Durchlauf kann es auch zu mehreren Suchen kommen.
tool_search_call: Das Modell stellt fest, dass kein passendes geladenes Tool vorhanden ist, und startet eine serverseitige Suche.tool_search_result: Die API liefert das vollständige Parameter-Schema vonget_inventoryzurück.function_call: Nachdem das Modell das Schema gelesen hat, erzeugt es einen Aufruf wieget_inventory(sku="SKU-42").
Diese drei Schritte finden innerhalb derselben externen API-Anfrage statt. Die Anwendung muss keinen eigenen Sucher schreiben und auch keine zweite Suchanfrage senden. Die ersten beiden Schritte gilt es nur zu beobachten und zu protokollieren – die Suche nicht lokal erneut ausführen. Aber „dieselbe Anfrage“ bedeutet nicht „nur eine einzige Inferenz“: Jede serverseitige Suche löst einen zusätzlichen Modellaufruf aus, und diese Token werden wie gewohnt abgerechnet. Beim Debugging gibt es noch einen Punkt zu beachten: Man darf nicht nur auf interaction.status schauen. Selbst wenn der Status nicht requires_action ist, können die Steps einen noch auszuführenden function_call enthalten.
Schritt 3: Funktion ausführen und function_result zurückgeben
Tool Retrieval ist nur dafür zuständig, die Werkzeuge zu finden und die Parameter zu laden. Die eigentliche Geschäftsfunktion wird weiterhin von der Anwendung ausgeführt – dieser Teil folgt dem standardmäßigen Function-Calling-Mechanismus. Schreiben Sie den Code im Anschluss an den obigen weiter:
# Nur die echten Geschäftsfunktionsaufrufe ausführen, tool_search_call nicht auf der Anwendungsseite ausführen
function_results = []

for step in interaction.steps:
    if step.type != "function_call":
        continue
    result = execute_demo_tool(step.name, step.arguments)
    function_results.append({
        "type": "function_result",
        "name": step.name,
        "call_id": step.id,
        "result": [{"type": "text", "text": json.dumps(result, ensure_ascii=False)}]
    })

# Die Ergebnisse der lokalen Funktionen an Gemini zurücksenden
if function_results:
    followup = client.interactions.create(
        model=MODEL,
        previous_interaction_id=interaction.id,
        tools=tools,
        input=function_results
    )
    print("最终回答:", followup.output_text)
else:
    print("当前回答:", interaction.output_text)
Bei diesem Code gibt es drei Dinge zu beachten. Erstens: Die call_id muss aus dem step.id des ursprünglichen function_call stammen. Wenn in einem Durchlauf mehrere Aufrufe vorkommen, ordnet das Modell darüber jedem Ergebnis seinen Aufruf zu. Zweitens: previous_interaction_id=interaction.id sorgt dafür, dass der Server an den gespeicherten Interaktionsdatensatz anknüpft – einschließlich der bereits abgerufenen Werkzeuge. Drittens: Im zweiten Durchlauf muss das gesamte tools-Array erneut übergeben werden. Die API behält den Schrittverlauf, aber nicht die Werkzeugdeklarationen; tool_search, alle verzögerten und nicht verzögerten Werkzeuge sowie die MCP-Konfiguration müssen in jeder Runde neu übermittelt werden.
Dieses Beispiel zeigt nur einen einzelnen geschlossenen Funktionsaufruf-Zyklus und enthält keinen allgemeinen Mehrrunden-Agent-Scheduler. Wenn im followup noch ein function_call steckt, verfahren Sie einfach auf dieselbe Weise weiter.
🎯 Technischer Hinweis: Tool Retrieval selbst hängt von der offiziellen
v1beta-Interactions-API von Google ab. Wenn Sie zuerst mit Standard-Function-Calling Ihre Geschäftsfunktionen zum Laufen bringen und vergleichen möchten, wie verschiedene Modelle Werkzeuge auswählen und Parameter befüllen, können Sie bei APIYI apiyi.com mit demselben Key zwischen Modellen wie Gemini, Claude und GPT wechseln und einen Basistest durchführen.
Erweiterung: Remote-MCP und clientseitiges Retrieval bei Gemini
Remote-MCP-Server können das Lazy Loading auf Serverebene einrichten – die von ihnen bereitgestellten Tools werden dann erst bei Bedarf geladen:
mcp_tools = [
    {"type": "tool_search"},
    {
        "type": "mcp_server",
        "name": "weather_service",
        "url": "https://gemini-api-demos.uc.r.appspot.com/mcp",
        "defer_loading": True
    }
]
Anders als bei benutzerdefinierten Funktionen werden Remote-MCP-Tools von der API selbst ausgeführt. In den steps tauchen dann mcp_server_tool_call und mcp_server_tool_result auf – die Anwendung muss das Ergebnis nicht zurückschicken. Eine offizielle Angabe zur „maximalen Anzahl an Tools, die sich verzögert laden lassen“ gibt es in der Dokumentation derzeit nicht.
Hat ein Unternehmen bereits eine eigene Tool-Registry, eine Vektorsuche oder eine Filterung nach Benutzerberechtigungen, kann es auf clientseitiges Retrieval umstellen: "execution": "client" setzen und vollständige Angaben zu name, description und parameters mitliefern. In der ersten Runde kommt dann ein ganz normaler function_call auf search_tool_registry zurück. Nachdem die Anwendung gesucht hat, gibt sie in function_result.result ein Array vollständiger Tool-Deklarationsobjekte zurück – und zwar nicht als serialisierten JSON-String. Der Client-Modus nutzt kein defer_loading, und beide Modi lassen sich nicht in derselben Anfrage mischen.
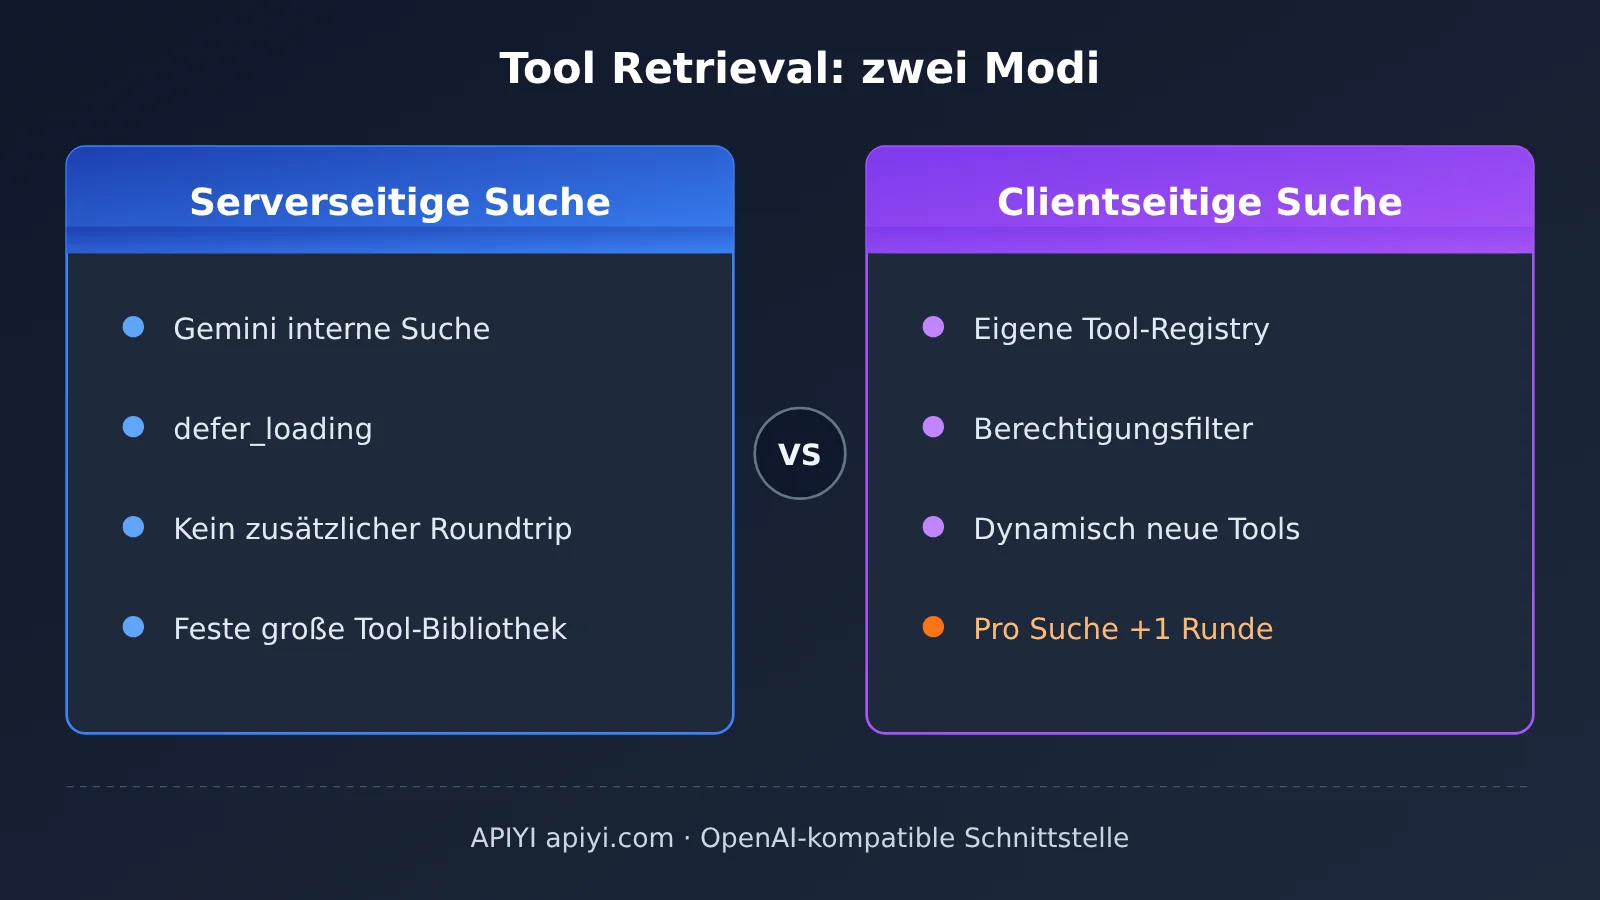
| Dimension | Serverseitiges Retrieval | Clientseitiges Retrieval (Gemini) | Eigene Tool Registry (allgemeiner Ansatz) |
|---|---|---|---|
| Wer die Suche ausführt | Gemini API | Entwickleranwendung | Entwickleranwendung |
| Zentrale Konfiguration | tool_search + defer_loading |
tool_search + execution: client |
normales Function Calling |
| Müssen alle Tools vorab deklariert werden | Ja | Nein | Nein |
| Zusätzlicher Netzwerk-Roundtrip | keiner | +1 Runde pro Suche | +1 Runde pro Suche |
| Tools dynamisch ergänzen | umständlich | unterstützt | unterstützt |
| Typische Szenarien | große, relativ feste Tool-Bibliotheken | Multi-Tenant, private Registries | Wiederverwendung über Modelle hinweg, Wechsel zwischen Anbietern |
| Verfügbare Plattform | Google offiziell v1beta | Google offiziell v1beta | OpenAI-kompatible Schnittstellen wie APIYI apiyi.com |
Die letzte Spalte ist kein Gemini Tool Retrieval, sondern eine technische Umsetzung mit ähnlicher Grundidee: Zuerst wird nur eine Suchfunktion bereitgestellt, und erst wenn die Suche fündig wird, kommt das passende Schema zu den tools dazu. Das eignet sich für Teams, die zwischen mehreren Modellen hin- und herwechseln müssen. Die Minimalvariante sieht so aus:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)
MODEL = "your-model-name"  # maßgeblich ist die Modellliste der Plattform

search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}
Vollständigen zweistufigen Aufruf der eigenen Tool Registry ansehen
import json, os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"
)
MODEL = "your-model-name"  # maßgeblich ist die Modellliste der Plattform

TOOL_REGISTRY = {
    "get_inventory": {"type": "function", "function": {
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "parameters": {"type": "object", "properties": {"sku": {"type": "string"}}, "required": ["sku"]}}},
    "get_order_status": {"type": "function", "function": {
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "parameters": {"type": "object", "properties": {"order_id": {"type": "string"}}, "required": ["order_id"]}}},
}
search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools (inventory, orders) by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}

def search_registry(query):
    q = query.lower()
    return [name for name, t in TOOL_REGISTRY.items()
            if any(w in t["function"]["description"].lower() for w in q.split())]

def execute_demo_tool(name, args):
    if name == "get_inventory":
        return {"sku": args["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": args["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(name)

messages = [{"role": "user", "content": "查询商品 SKU-42 的可用库存。"}]
tools = [search_tool]

for _ in range(4):  # einfache Schleifenobergrenze, um eine Endlosschleife zu verhindern
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    if not msg.tool_calls:
        print("最终回答:", msg.content)
        break
    messages.append(msg)
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        if call.function.name == "search_tool_registry":
            names = search_registry(args["query"])
            tools += [TOOL_REGISTRY[n] for n in names if TOOL_REGISTRY[n] not in tools]
            content = json.dumps({"loaded_tools": names})
        else:
            content = json.dumps(execute_demo_tool(call.function.name, args), ensure_ascii=False)
        messages.append({"role": "tool", "tool_call_id": call.id, "content": content})
💡 Auswahlhinweis: Die Retrieval-Qualität des Registry-Ansatzes hängt von Ihrer Suchfunktion ab – der Keyword-Abgleich im Beispiel dient nur der Demonstration. Wenn Sie auf APIYI apiyi.com das Modell wechseln und dieselbe Aufgabengruppe durchlaufen lassen, können Sie vergleichen, ob „das richtige Tool gefunden wird“ und ob „die Parameter korrekt ausgefüllt werden“ – so erkennen Sie, welches Modell besser zu Ihrer Tool-Bibliothek passt.
Häufige Fehler bei Gemini Tool Retrieval – gezielte Fehlersuche
| Symptom | Ursache | Vorgehen |
|---|---|---|
defer_loading requires tool_search |
Eine verzögerte Funktion wurde deklariert, aber es gibt kein serverseitiges tool_search. |
Fügen Sie {"type": "tool_search"} in tools ein. |
short_description ist ungültig |
Es wurde bei einer nicht verzögerten Funktion angegeben. | Nur für Funktionen mit defer_loading=True verwenden. |
| HTTP 400 unsupported model | Das Modell steht nicht auf der Liste der unterstützten Modelle. | Verwenden Sie stattdessen eine der vier in der Dokumentation aufgeführten Modell-IDs. |
| Anfrage zeigt keine Wirkung oder es wird ein Versionsfehler gemeldet | Das SDK verwendet standardmäßig v1, oder es wurde generateContent aufgerufen. |
Setzen Sie explizit api_version="v1beta" und wechseln Sie zur Interactions API. |
| HTTP 400 in der zweiten Runde | Bei store=False fehlt ein Suchschritt oder eine signature. |
Spielen Sie tool_search_call/result und alle Signaturen unverändert erneut ein. |
| Das Modell verwendet fälschlich alte Tools, oder Tools sind nicht verfügbar | In nachfolgenden Anfragen wurde tools nicht übermittelt. |
Übermitteln Sie in jeder Runde das vollständige tools-Array erneut. |
| Parameter sind nach der Suche leer | Für ein verzögertes Tool wurden nur Name und Kurzbeschreibung übermittelt. | Auch für verzögerte Tools müssen die vollständigen parameters übermittelt werden. |
| Clientseitige Suchkonfiguration schlägt fehl | Felder wie name und description fehlen. |
Ergänzen Sie die Definition der clientseitigen Suchfunktion. |
Der zustandslose Modus (store=False) verdient eine eigene Erläuterung. In diesem Fall kann sich die Anwendung nicht auf previous_interaction_id verlassen. Sie muss die Benutzereingabe, tool_search_call, tool_search_result, function_call, function_result sowie alle signature selbst speichern und unverändert erneut übermitteln. Wird einer dieser Schritte gelöscht oder geändert, kann der Server den Suchkontext möglicherweise nicht mehr rekonstruieren. Außerdem kann der Server, wenn er kein passendes Tool findet, direkt einen Text zurückgeben statt eines strukturierten Fehlers. „Die Anfrage hat keinen Fehler gemeldet“ heißt also nicht „die Suche war erfolgreich“. Bei der Validierung sollte daher Schritt für Schritt geprüft werden, ob in steps die erwarteten Suchschritte und Funktionsaufrufe auftauchen.
Gemini Tool Retrieval: Analyse und Einschätzung – wann sich die Integration lohnt
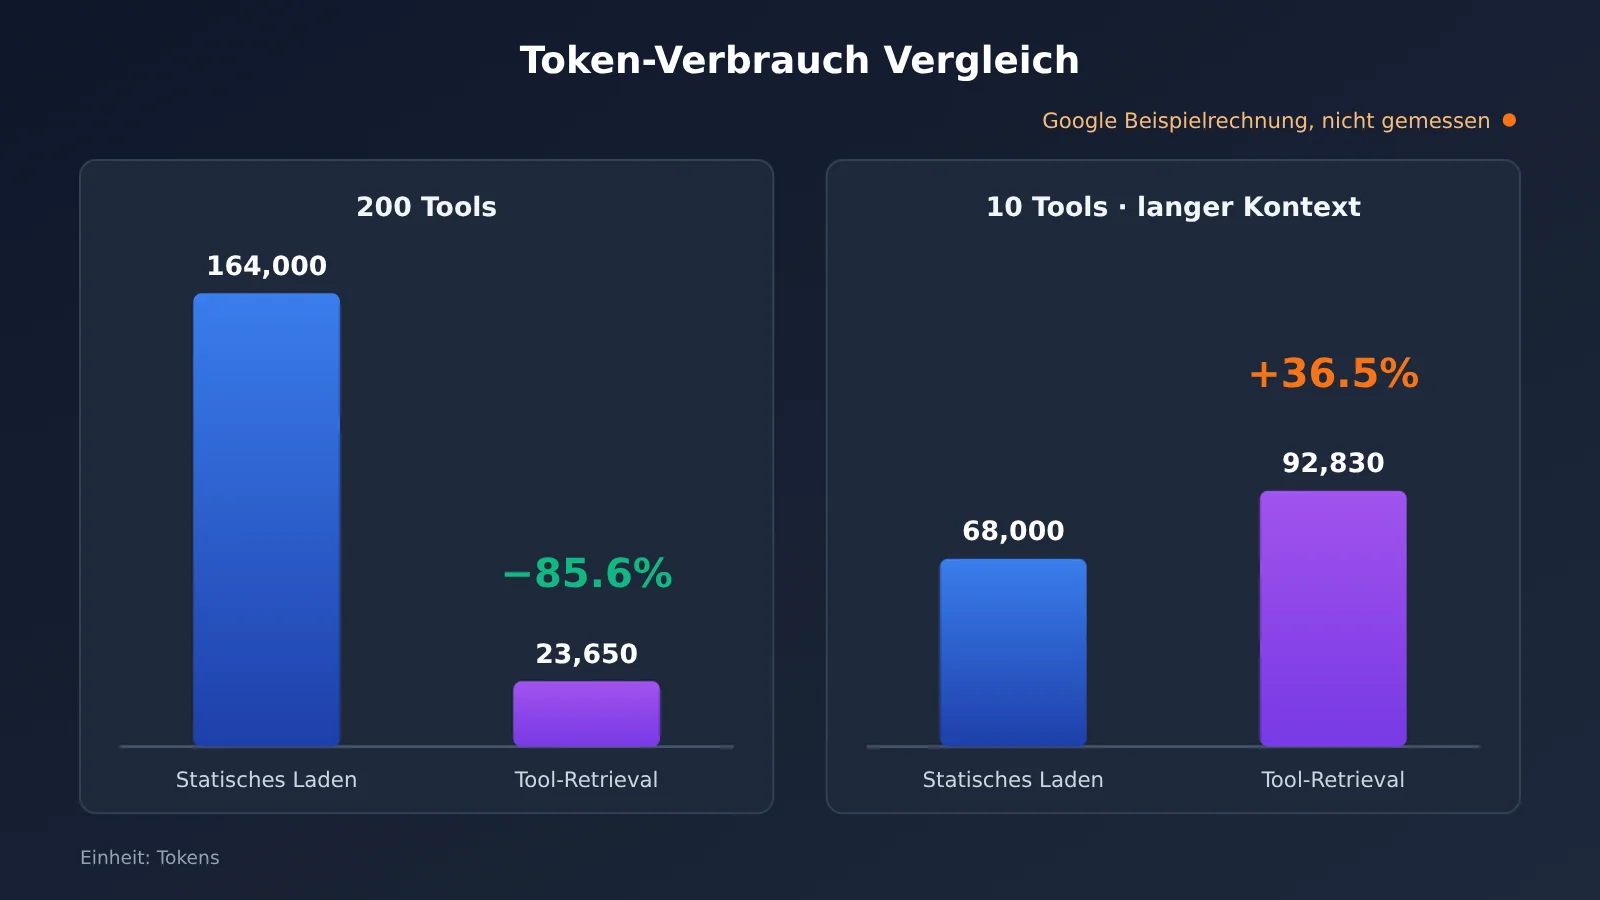
Einschätzung 1: Der Nutzen hängt von der Größe der Tool-Bibliothek und der Kontextlänge ab; bloßes Aktivieren spart kein Geld. Die Google-Dokumentation nennt zwei hypothetische Rechenbeispiele mit entgegengesetzter Tendenz und stellt ausdrücklich klar, dass es sich nicht um Produktions-Benchmarks handelt. Im ersten Fall: 200 Tools, je 400 Tokens, Grundkontext 2,000 Tokens, 2 Anfragen – statisches Laden etwa 164,000 Tokens, Tool Retrieval etwa 23,650 Tokens, daraus ergibt sich rechnerisch ein Rückgang von etwa 85.6 %. Im zweiten Fall: 10 Tools, Grundkontext 30,000 Tokens – statisches Laden 68,000 Tokens, Tool Retrieval dagegen 92,830 Tokens, ein Anstieg von etwa 36.5 %, weil die zusätzliche Such-Inferenz den gesamten langen Kontext erneut verarbeiten muss. Googles Engineering-Empfehlung lautet: Bei weniger als etwa 20 stabilen Tools reicht statisches Laden in der Regel aus.
Einschätzung 2: Für die Kostenbewertung muss man total_tool_use_tokens betrachten, nicht nur die Eingabe der ersten Runde. In den frühen offiziellen Tests machte die Kurzbeschreibung jedes verzögert geladenen Tools durchschnittlich etwa 26 Tokens aus; bei 100 Tools sind das ungefähr 2,600 Tokens – ein Näherungswert. Wirklich im Auge behalten muss man die durch die Suche ausgelösten zusätzlichen Modellaufrufe sowie die Ansammlung bereits geladener Schemas über eine Sitzung hinweg. Die aktuelle Dokumentation bietet keinen Mechanismus, um bereits abgerufene Tools wieder zu entladen; je mehr Tools in einer langen Sitzung abgerufen werden, desto größer wird der Kontext. Auch Caching bringt nicht automatisch Vorteile: Nachdem die anfängliche Eingabeaufforderung kürzer geworden ist, kann sie unter die Mindestschwelle für implizites Caching fallen.
Einschätzung 3: Bedarfsgerechtes Laden von Tools ist inzwischen Branchenkonsens, doch die Daten der Anbieter lassen sich nicht einfach aufeinander übertragen. Anthropic führte im November 2025 das Tool Search Tool ein, OpenAI im März 2026 zusammen mit GPT-5.4 das Tool Search; beide Unternehmen haben Messdaten zu Einsparungen unter ihren jeweiligen Bedingungen veröffentlicht. Google hat diesmal nur hypothetische Rechenbeispiele geliefert. Stand 20. November 2026 gibt es noch keine unabhängigen, überprüfbaren Produktionsmessungen zu Gemini Tool Retrieval. Aussagen wie „Gemini spart im Test 85 %“ sind daher derzeit nicht haltbar.
Empfehlung für Entwicklerinnen und Entwickler:** Zuerst sollten die Tools des bestehenden Agenten nach Aufrufhäufigkeit geschichtet werden: häufig genutzte Tools direkt laden, Long-Tail-Tools verzögert laden. Anschließend mit demselben Aufgabensatz statisches Laden und Tool Retrieval vergleichen – Gesamtzahl der Tokens, End-to-End-Laufzeit, Anteil der richtig ausgewählten Tools und Parameterrichtigkeit. Die Funktion befindet sich noch in der Vorschauphase, ein Termin für die allgemeine Verfügbarkeit steht nicht fest; in Produktionsumgebungen sollte man nach Möglichkeit einen Schalter für den Rückfall auf statisches Laden behalten. In der Modellauswahlphase kann man zunächst über die einheitliche Schnittstelle von APIYI apiyi.com mit geringen Kosten eine Standard-Function-Calling-Baseline zum Laufen bringen und dann auf das offizielle v1beta wechseln, um den Nettonutzen von Tool Retrieval zu validieren.
Je mehr Tools es gibt, desto genauer muss man vorher überlegen, wann welches Tool zum Einsatz kommt. Wie es in den „Gesprächen des Konfuzius“ (Lunyu), Kapitel Weiling Gong, heißt: „Will man seine Arbeit gut verrichten, muss man zuerst seine Werkzeuge schärfen.“
📚 Referenzen
-
Introducing Tool Retrieval in the Gemini API: Offizielle Ankündigung von Google
- Link:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - Beschreibung: Veröffentlichungsdatum, Designziele, MCP und die beiden Retrieval-Modi
- Link:
-
Offizielle Dokumentation zu Tool Retrieval: Konfiguration, Einschränkungen, Abrechnung und Rechenbeispiele
- Link:
aistudio.google.com/docs/tool-retrieval - Beschreibung: Hauptgrundlage für den Code in diesem Artikel, die Fehlerregeln, das zustandslose Replay und die Token-Rechenbeispiele
- Link:
-
Offizielle Dokumentation zu Function Calling: Funktionsausführung und Rückgabe der Ergebnisse
- Link:
aistudio.google.com/docs/function-calling - Beschreibung: Standardverwendung von
function_resultundcall_id
- Link:
-
Offizielle Dokumentation zur Interactions API: Schnittstellenstruktur und Ausführungsschritte
- Link:
aistudio.google.com/docs/interactions-overview - Beschreibung: Zustandsbehaftete Dialoge, der Unterschied zwischen
stepsundgenerateContent
- Link:
-
Release von python-genai v3.6.0 / v3.0.0: SDK-Versionshistorie
- Link:
github.com/googleapis/python-genai/releases - Beschreibung: Unterstützung des Tool-Retrieval-Schemas und Änderungen der Standard-API-Version
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Vergleichstests für Function Calling mit mehreren Modellen finden Sie unter APIYI apiyi.com; weitere Integrationsunterlagen gibt es im Dokumentationszentrum unter docs.apiyi.com