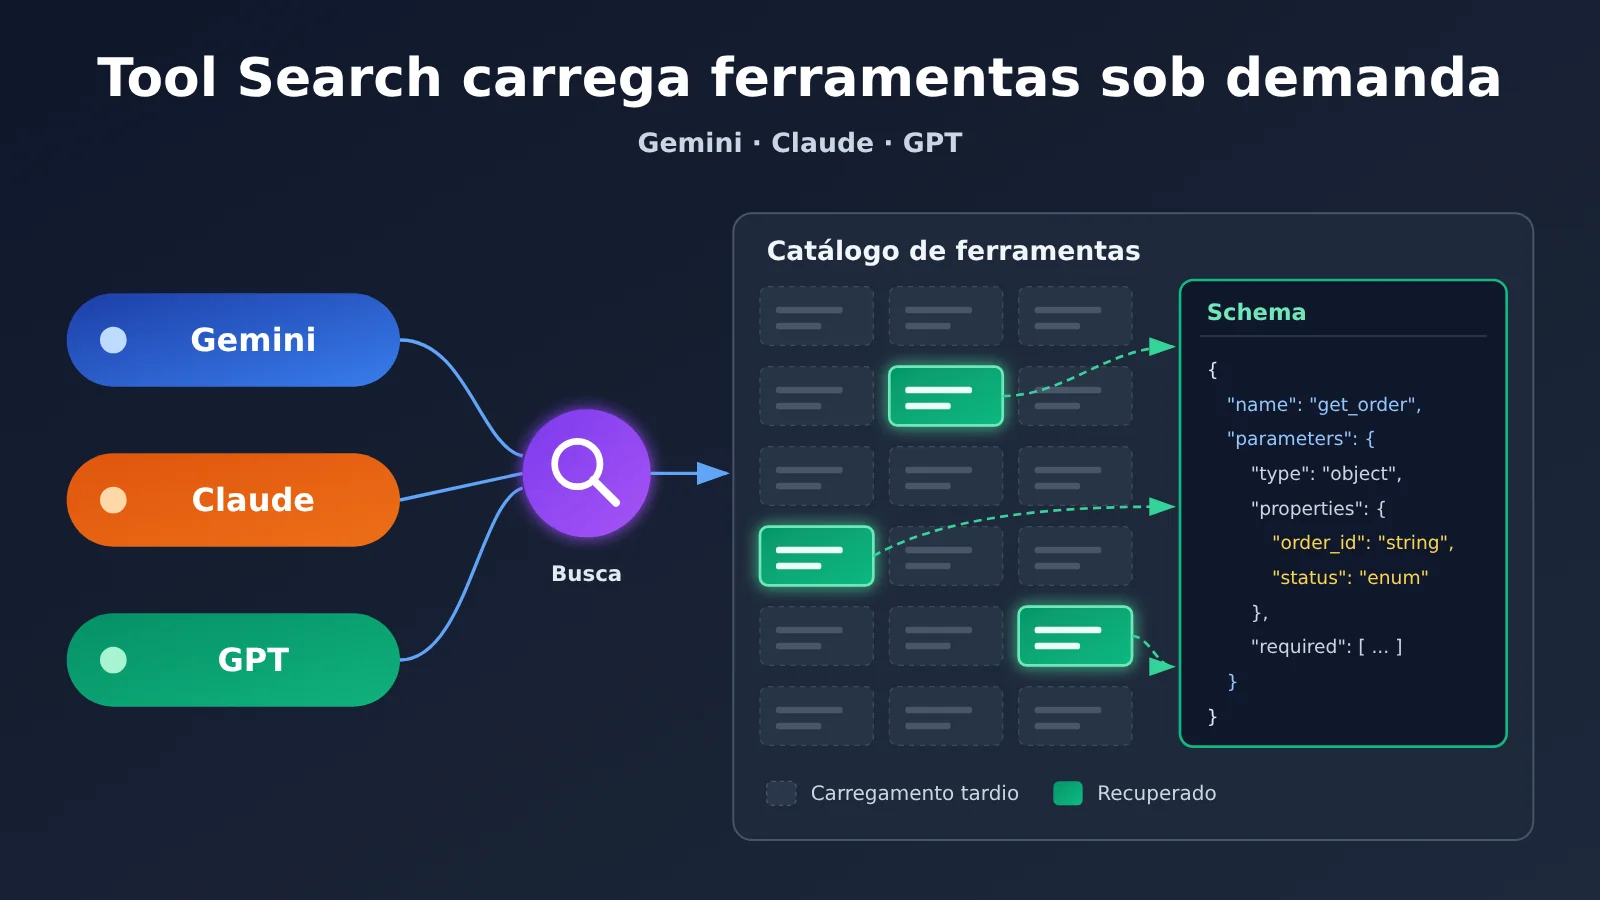
O Tool Search das três empresas resolve o mesmo problema, mas as rotas de implementação são muito diferentes. As três fazem o modelo ver, no início, apenas indicações resumidas das ferramentas, carregando o Schema completo de parâmetros somente quando for preciso chamá-las. As diferenças estão principalmente em três pontos: o Gemini tem dois modos de busca, no servidor e no cliente, e a busca no cliente pode introduzir novas ferramentas; a Claude expôs dois métodos de busca no servidor, Regex e BM25, e usa tool_reference para fazer descoberta dentro do conjunto de ferramentas já declarado; o GPT agrupa ferramentas com namespace, e o modo cliente pode injetar dinamicamente novas ferramentas via tool_search_output. Na escolha, considere se a biblioteca de ferramentas é fixa ou muda com frequência, além da arquitetura de API que a equipe já tem.
O que você vai descobrir neste artigo?
- A qual API pertence o Tool Search de cada uma e com qual campo ele é habilitado.
- O que muda no conteúdo mantido no contexto inicial do modelo e qual é o papel de
short_description,tool_referenceenamespace. - Como se compõe a cadeia de eventos entre a busca de ferramentas e a chamada real de função e onde é fácil errar na integração.
- Qual delas permite adicionar à conversa novas ferramentas que não estavam na solicitação inicial.
- Diante de agentes empresariais de pedidos e estoque, como escolher com base na estrutura da biblioteca de ferramentas.
Índice: O texto começa explicando as datas de lançamento e a ideia comum das três, depois detalha os mecanismos de busca e os campos nativos de Gemini, Claude e GPT, em seguida compara oito dimensões em uma tabela geral e demonstra as três rotas técnicas com um mesmo agente de pedidos e estoque. A parte final de análise apresenta princípios de escolha e discute pontos de atenção na adaptação de protocolo em gateways entre modelos.
Conceitos relacionados ao Tool Search que vale conhecer
| Conceito | Explicação breve |
|---|---|
| Catálogo de ferramentas | Conjunto de ferramentas de negócio disponíveis para busca, incluindo nome, descrição, definição de parâmetros e informações de permissão |
| Tool Search | Capacidade de buscar as ferramentas necessárias para a tarefa atual e importar sob demanda a definição completa de cada uma |
defer_loading |
Campo adotado pelas três empresas para marcar que a definição completa da ferramenta será carregada depois |
| Regex | Uso de expressões regulares para encontrar nomes, descrições ou pistas de parâmetros de ferramentas |
| BM25 | Algoritmo clássico que ordena resultados de busca pela relevância entre os termos da consulta e o texto |
tool_reference |
Bloco de conteúdo usado pelo Claude para referenciar uma ferramenta já declarada; depois, a API o expande para a definição completa |
namespace |
Declaração da OpenAI Responses API que agrupa funções relacionadas por capacidade de negócio |
| Injeção dinâmica de ferramentas | A aplicação entrega ao modelo definições de ferramentas que não foram declaradas na solicitação inicial, para que ele continue a usá-las |
tool_search_output |
Item de resposta devolvido pelo cliente OpenAI durante a busca, contendo declarações das ferramentas correspondentes |
| MCP remoto | Serviço remoto que oferece ferramentas descobríveis e executáveis por meio do Model Context Protocol |
| Prefixo de cache | Parte inicial da entrada que permanece igual entre várias chamadas ao modelo e pode ser reutilizada a partir do cache |
Impactos do Tool Search em resumo
- Desenvolvedores de agentes: com muitas ferramentas, não é mais preciso enfiar todos os schemas no contexto de uma vez. Mas os corpos de requisição e os eventos de resposta das três empresas são diferentes, então agentes que usam vários modelos precisam implementar lógicas de análise específicas para cada um.
- Plataformas empresariais e mantenedores de catálogos de ferramentas: a nomenclatura das ferramentas, as descrições curtas e a forma de agrupamento passam a afetar diretamente a qualidade da busca. O próprio catálogo de ferramentas se torna um ativo que precisa ser projetado.
- Responsáveis por custos e operações: o Tool Search não necessariamente economiza. O exemplo oficial do Google apresenta tanto casos de economia quanto de aumento de tokens; habilitar ou não deve ser decidido com base na conta real medida.
Fatos objetivos: cronologia de lançamento e mecanismo do Tool Search nas três empresas
Por que Gemini, Claude e GPT oferecem Tool Search
Quando um agente se conecta ao CRM, pedidos, estoque, logística, tickets e vários servidores MCP ao mesmo tempo, as próprias declarações de ferramentas já ocupam uma parte enorme do contexto. A documentação do Google menciona que algumas dezenas de declarações de funções podem consumir dezenas de milhares de Tokens. A Anthropic deu um exemplo: cinco servidores MCP — GitHub, Slack, Sentry, Grafana e Splunk — com 58 ferramentas no total; somente as definições das ferramentas somam cerca de 55.000 Tokens.
A linha do tempo de lançamento das três é a seguinte: a Anthropic lançou o Tool Search Tool em 24 de novembro de 2025; a OpenAI lançou o API Tool Search em 5 de março de 2026, junto com o GPT-5.4; o Google lançou o Tool Retrieval da Gemini API em formato de prévia em 19 de novembro de 2026. A ideia básica das três é a mesma: o modelo primeiro sabe quais capacidades existem e, quando realmente precisa usá-las, lê a definição completa dos parâmetros.
As três divulgaram dados de desempenho, mas as condições de teste são completamente diferentes, então não dá para usá-los para montar um ranking. No exemplo da Anthropic, o contexto inicial caiu de cerca de 77.000 Tokens para cerca de 8.700 Tokens; na avaliação interna de MCP, a precisão de seleção de ferramentas do Claude Opus 4 subiu de 49% para 74%. A OpenAI mediu, no MCP Atlas, em 250 tarefas e 36 servidores MCP, uma redução total de Tokens de 47%, com a precisão mantida. No momento, o Google apresenta apenas um exemplo hipotético de cálculo: com 200 ferramentas, cerca de 85,6% de redução; com 10 ferramentas combinadas com contexto longo, na verdade há um aumento de cerca de 36,5%.
Gemini Tool Search: os dois modos de recuperação, no servidor e no cliente
O Tool Retrieval do Gemini se apoia na Interactions API e exige o uso de v1beta — o antigo generateContent não é compatível. Para habilitar o modo servidor, basta adicionar {"type": "tool_search"} em tools e depois definir defer_loading: true para as function ou mcp_server de baixa frequência. No começo, o modelo vê apenas o nome e a short_description das ferramentas adiadas. Testes iniciais do Google mostraram que cada entrada de ferramenta consome, em média, cerca de 26 tokens. Quando não há uma descrição curta configurada, a primeira frase da description completa é usada no lugar.
Há um ponto que costuma gerar mal-entendidos: no modo servidor, o desenvolvedor continua precisando enviar a definição completa das ferramentas. Mesmo usando previous_interaction_id, é preciso reenviar o array tools completo a cada requisição. O carregamento adiado apenas evita que o Schema completo entre antecipadamente no contexto do modelo. Além disso, um Schema já carregado não pode ser descarregado na sessão atual; uma única requisição pode declarar no máximo um tool_search; e a recuperação no servidor e no cliente não podem ser misturadas na mesma requisição.
| Dimensão | Recuperação no servidor | Recuperação no cliente |
|---|---|---|
execution |
server (padrão) |
client |
| Recuperador | A Gemini API se encarrega | Construído pelo desenvolvedor |
| Precisa declarar o conjunto de ferramentas com antecedência | Sim | Não |
defer_loading |
Aplicável | Não aplicável |
| Round-trips extras | Nenhum round-trip extra do cliente | Um round-trip a mais a cada busca |
| Cenários típicos | Conjuntos de ferramentas grandes e relativamente fixos | Tool Registry privado, multilocatário, ferramentas dinâmicas |
No modo cliente, o modelo chama uma função de busca definida pelo desenvolvedor (como search_tool_registry), e a aplicação retorna, em function_result.result, os objetos completos de declaração das ferramentas que correspondem. Dessa forma, é possível introduzir na conversa ferramentas que não foram declaradas na requisição original — por exemplo, quando o usuário conecta temporariamente um novo serviço SaaS durante a sessão.
Claude Tool Search: Regex, BM25 e tool_reference
A Tool Search Tool do Claude faz parte da Messages API, e o lado do servidor oferece dois tipos de ferramenta de busca: tool_search_tool_regex_20251119, em que o modelo gera expressões regulares — ideal para bibliotecas de ferramentas com padrões de nomenclatura bem definidos; e tool_search_tool_bm25_20251119, em que o modelo gera consultas em linguagem natural — ideal para descobrir ferramentas a partir da descrição de capacidade. As duas abordagens indexam nomes de ferramentas, descrições, nomes de parâmetros e descrições de parâmetros. O campo de parâmetros do Claude é input_schema, e isso é diferente do parameters dos outros dois provedores.
A cadeia de eventos de uma busca típica é: o Claude primeiro dispara um server_tool_use para invocar a ferramenta de busca nativa, a API retorna um tool_search_tool_result que contém um tool_reference, a API então expande isso para a definição completa, e por fim o modelo produz o tool_use de nível de negócio. A Anthropic esclarece especialmente que o identificador srvtoolu_... da ferramenta de busca nativa não exige que o desenvolvedor devolva um tool_result; o aplicativo só precisa executar o tool_use de negócio propriamente dito.
| Regra do Claude Tool Search | Definição oficial |
|---|---|
| Limite de ferramentas adiadas por requisição | 10.000 |
| Retorno padrão por busca | Até 5, ajustável via limit |
| Comprimento da consulta Regex | Até 200 caracteres |
| Comprimento da consulta BM25 | Até 500 caracteres |
| Modelos não suportados | Claude Opus 4.1 e modelos anteriores |
| Restrição de cache | Ferramentas com defer_loading: true não podem definir cache_control |
Os desenvolvedores também podem implementar buscas personalizadas com algoritmos próprios, como embedding, mas o retorno continua sendo tool_reference, e a ferramenta referenciada precisa já estar declarada no tools de nível superior. Por isso, o design do Claude se aproxima mais de “encontrar a ferramenta necessária dentro de uma biblioteca de ferramentas previamente declarada”. No lado do MCP, o Claude configura a estratégia de adiamento por meio do mcp_toolset do MCP Connector — dá para definir de forma unificada em default_config ou individualmente por ferramenta em configs.
GPT Tool Search: Namespace e injeção dinâmica de ferramentas
O Tool Search da OpenAI fica na Responses API, é suportado pelo GPT-5.4 e por modelos compatíveis mais recentes, e também é habilitado com tool_search e defer_loading. O diferencial é o namespace: os desenvolvedores podem agrupar funções relacionadas por domínio de negócio, como crm e billing, e o modelo primeiro usa o nome e a descrição do namespace para decidir que tipo de capacidade é relevante; só quando precisa é que ele expande as funções adiadas dentro do grupo. Assim, o agrupamento de ferramentas passa a ser uma estrutura no nível da API, e não apenas uma convenção de nomenclatura.
No modo servidor, a cadeia de eventos é tool_search_call → tool_search_output → function_call → o aplicativo retorna function_call_output. No modo cliente, depois de receber tool_search_call, o aplicativo consulta por conta própria o catálogo de ferramentas e retorna tool_search_output com o mesmo call_id; seu campo tools contém as declarações completas das ferramentas correspondentes, e o modelo só chama essas funções na rodada seguinte. A documentação oficial permite que aqui se retornem ferramentas não declaradas na requisição original, e ao mesmo tempo exige que os desenvolvedores validem rigorosamente o Schema dinâmico e exponham apenas definições de ferramentas confiáveis.
Em relação a cache, a OpenAI acrescenta as definições de ferramentas recém-descobertas ao final do contexto, para reduzir o impacto sobre o prefixo de cache já existente. No lado do MCP, é preciso atenção: o Tool Search da Responses API oferece descoberta sob demanda de ferramentas MCP, enquanto a Agents API, quando o modelo e o provedor dão suporte, integra automaticamente a descoberta de ferramentas pelo runtime. A documentação oficial deixa claro que as duas configurações não podem ser aplicadas diretamente uma na outra.
Veja abaixo uma requisição ilustrativa da Responses API, que demonstra a estrutura básica do carregamento adiado. Os campos seguem a documentação oficial da OpenAI:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Entrada compatível com OpenAI da APIYI
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "inventory_get_stock",
        "description": "Inventory: check stock level by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    }
]

resp = client.responses.create(
    model="gpt-5.4",
    input="订单 A-1042 还没发货,帮我查一下 SKU-88 的库存。",
    tools=tools
)
for item in resp.output:
    print(item.type)  # Espera-se ver eventos como tool_search_call / function_call
Ver o código ilustrativo de busca no cliente e injeção dinâmica
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Encaminha a requisição da Responses API via APIYI
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

def search_registry(query: str) -> list:
    """Pesquisa no catálogo privado de ferramentas da empresa e filtra pelas permissões do usuário (ilustrativo)"""
    return [{
        "type": "function",
        "name": "warehouse_schedule_shipment",
        "description": "Warehouse: schedule a new shipment date.",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "date": {"type": "string"}
            },
            "required": ["order_id", "date"]
        }
    }]

def handle(output_items: list) -> list:
    follow_ups = []
    for item in output_items:
        if item["type"] == "tool_search_call":
            query = item.get("arguments", {}).get("query", "")
            follow_ups.append({
                "type": "tool_search_output",
                "call_id": item["call_id"],      # Usa o mesmo call_id da chamada de busca
                "tools": search_registry(query)  # Pode incluir ferramentas não declaradas na requisição inicial
            })
    return follow_ups
# Atenção: valide sempre o Schema retornado dinamicamente; exponha apenas ferramentas confiáveis
🚀 Sugestão de validação rápida: antes de integrar ao negócio real, você pode primeiro usar a chave unificada do APIYI apiyi.com para chamar GPT, Claude e Gemini separadamente, rodar o mesmo catálogo de ferramentas em cada um dos três, confirmar que a estrutura de eventos consegue ser reconhecida corretamente pela sua camada de parsing, e só então decidir a solução principal.
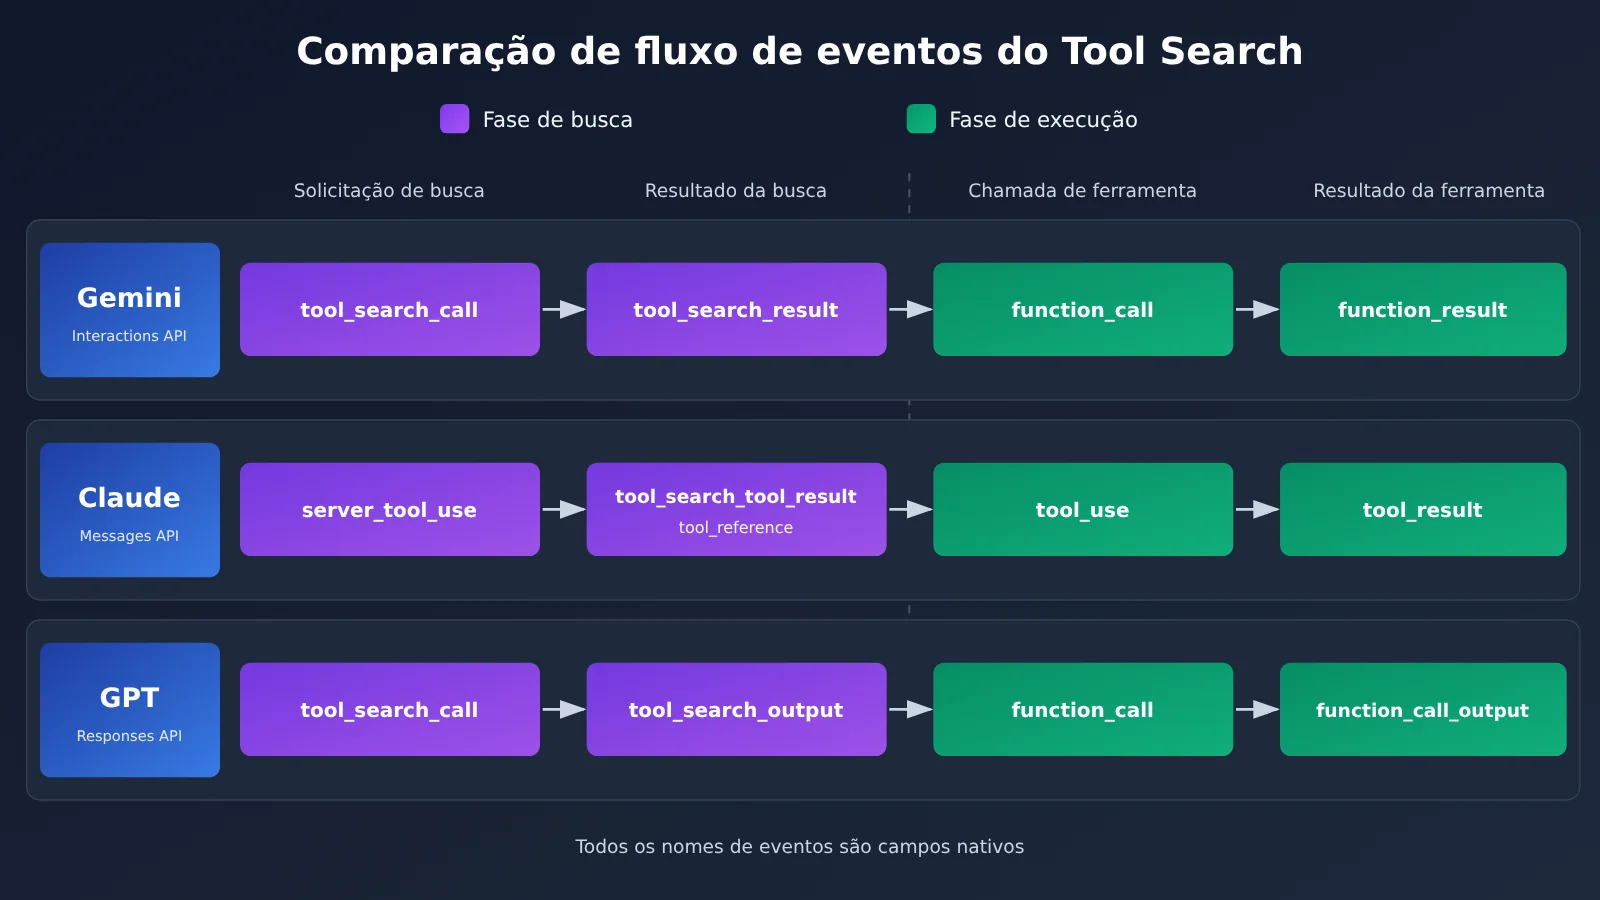
Os nomes de eventos na imagem acima são todos campos nativos de cada fornecedor. Leitores que precisam testar na prática o fluxo de eventos de cada um podem, através do APIYI apiyi.com, usar o mesmo conjunto de scripts de teste e alternar entre os modelos para fazer a comparação.
Comparação centralizada dos mecanismos de Tool Search das três plataformas
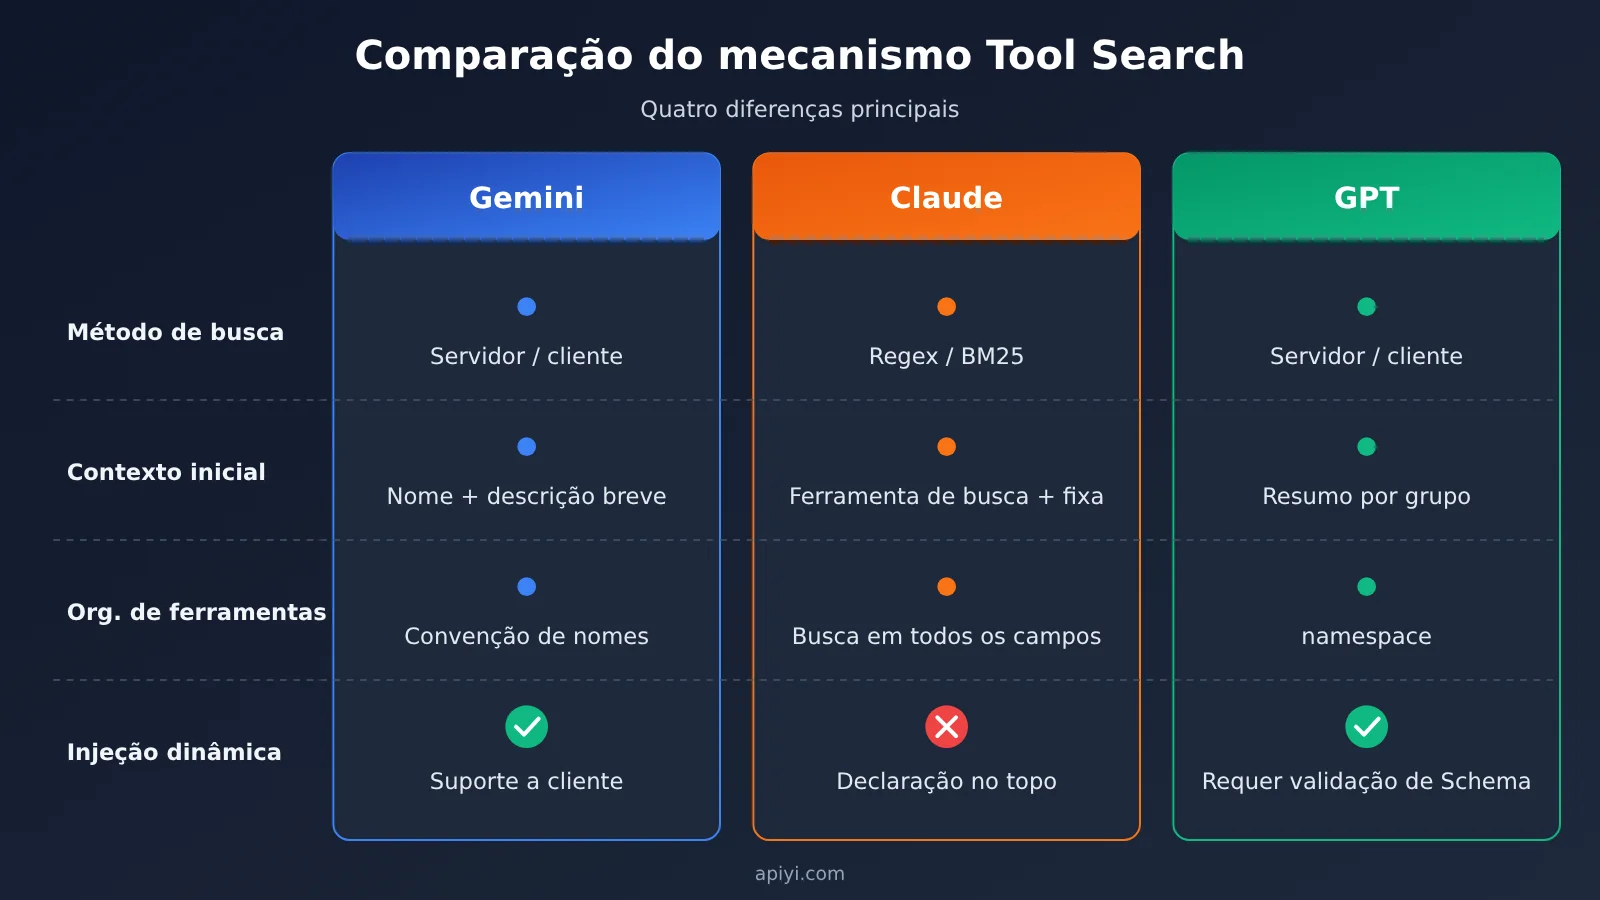
| Dimensão | Gemini | Claude | GPT |
|---|---|---|---|
| API à qual pertence | Interactions API (v1beta) |
Messages API | Responses API |
| Método de recuperação | Lado do servidor (algoritmo não divulgado) / lado do cliente | Regex / BM25 / busca personalizada | Lado do servidor / lado do cliente |
| Retenção no contexto inicial | Nome + short_description |
Ferramenta de busca + ferramentas não diferidas | Ferramentas diferidas ou resumo de namespace |
| Organização das ferramentas | Convenção de nomenclatura + descrição curta | Nome, descrição e parâmetros podem todos ser recuperados | Agrupamento por namespace |
| Campo de parâmetros | parameters |
input_schema |
parameters |
| Recuperação no cliente | Suportado | Busca personalizada retorna tool_reference |
Suportado (tool_search_output) |
| Adição dinâmica de novas ferramentas | Suportado no modo cliente | As ferramentas referenciadas precisam já estar declaradas no nível superior | Suportado no modo cliente, requer validação de Schema |
| Integração MCP | mcp_server + defer_loading |
default_config / configs do mcp_toolset |
Regras diferentes entre Responses e Agents |
| Cache e cobrança | Sem taxa independente pela funcionalidade; observe total_tool_use_tokens |
Não cobrado à parte; ferramentas diferidas não podem definir cache_control |
Novas ferramentas são anexadas ao final para proteger o prefixo do cache |
💡 Sugestão de escolha: a tabela acima compara apenas as regras de interface que podem ser verificadas. O efeito real depende da sua biblioteca de ferramentas e do comprimento da conversa; recomenda-se fazer um teste A/B com uma pequena amostra usando o ponto de entrada unificado multimodelo do APIYI apiyi.com, e depois calcular o custo combinando os campos de faturamento de cada fornecedor.
Análise e decisão: condições de adequação para escolher o Tool Search
Avaliando três rotas técnicas com um Agent de pedidos e estoque
Imagine o seguinte requisito de negócio: o usuário consulta o status de um pedido, descobre que o produto ainda não foi enviado, consulta o estoque e então avalia se é possível agendar uma nova data de envio. O sistema tem nove categorias de ferramentas — CRM, pedidos, estoque, agendamento de armazém, logística, reembolsos, cobrança, notificações e aprovações —, e cada categoria tem várias funções.
- Rota Gemini: carregue diretamente as consultas de pedidos mais usadas; deixe ferramentas de cauda longa, como estoque e agendamento de armazém, com carregamento sob demanda; e escreva bem o
short_description, para que a recuperação no servidor selecione o Schema deget_inventory. Se as ferramentas de agendamento de armazém forem provisionadas dinamicamente por tenant, passe para a recuperação no cliente e retorne a partir de um Registry privado. - Rota Claude: se a nomenclatura das ferramentas for padronizada (como
inventory_*ewarehouse_*), o Regex consegue fazer correspondências exatas; se o usuário falar de forma coloquial, como “será que ainda dá para repor”, o BM25 é mais adequado. No fim, otool_referenceé expandido para umtool_useinvocável. - Rota GPT: crie
namespaceporcrm,inventoryelogistics; o modelo primeiro identifica que o caso envolve os domínios de estoque e logística, e depois expande as funções dentro do grupo. Uma nova transportadora integrada temporariamente pode ser injetada pelotool_search_outputno cliente.
Este cenário serve apenas para ilustrar as diferenças de mecanismo; ele não representa a taxa de sucesso nem a latência medida das três opções.
Quatro princípios de escolha para desenvolvedores
- Biblioteca de ferramentas grande e fixa: priorize a capacidade de busca no lado do servidor. As três plataformas cobrem esse cenário, mas atenção: o Gemini reenvia o array completo de ferramentas a cada requisição, e o Claude tem um limite de 10.000 ferramentas com carregamento adiado por requisição.
- Precisa controlar explicitamente a estratégia de busca: o Regex e o BM25 divulgados pelo Claude são a única solução que revela explicitamente os algoritmos, adequada para equipes que querem acertar com precisão seguindo regras de nomenclatura. Os algoritmos do lado do servidor do Gemini e do GPT não são divulgados, e não se deve presumir que sejam iguais aos do Claude.
- Biblioteca de ferramentas muda com frequência ou precisa ser filtrada por permissões do usuário: foque na injeção dinâmica no cliente. Os modos cliente do Gemini e do GPT conseguem introduzir novas ferramentas; a busca personalizada do Claude só pode referenciar ferramentas já declaradas, então é preciso montar o conjunto de candidatas antes de enviar a requisição.
- Poucas ferramentas: um exemplo de cálculo do Google mostra que, com 10 ferramentas e um contexto longo de 30.000 Tokens, o uso de Tokens na verdade aumenta cerca de 36,5%. O Google recomenda continuar com carregamento estático quando houver menos de cerca de 20 ferramentas estáveis. Isso também serve de referência para as outras duas plataformas, mas cada uma ainda precisa testar na prática.
Adaptação de protocolo em gateways entre modelos
O erro mais comum entre equipes que trabalham com agentes entre modelos é tratar “conseguir chamar este modelo” como equivalente a “o Tool Search deste modelo funciona”. Dá para dividir a capacidade em quatro camadas: acesso ao modelo; endpoint de protocolo (Interactions / Messages / Responses); campos de declaração de ferramentas (tool_search, defer_loading, namespace, configuração de MCP); execução e gerenciamento de estado (eventos de busca, resultados de função, signature, histórico da sessão). Conectar o modelo com sucesso só prova que a primeira camada está ok.
Atenção especial a uma regra do Gemini: em sessões sem estado com store=false, tool_search_call, tool_search_result e o signature correspondente não podem ser modificados nem removidos; caso contrário, a API retorna HTTP 400. Isso significa que o gateway não pode comprimir nem reescrever o histórico de mensagens de qualquer jeito. Para abstrair as três plataformas em uma interface Tool Search unificada, é preciso manter uma tabela de mapeamento de eventos na camada do framework de agente; não dá para achar que basta trocar a Base URL para o mesmo corpo de requisição funcionar em todas.
🎯 Recomendação técnica: ao integrar vários modelos por meio de plataformas agregadoras como a APIYI apiyi.com, vale a pena começar com pouco tráfego para confirmar se o endpoint de destino e campos como
tool_search,defer_loadingenamespaceestão sendo repassados integralmente. Só depois inclua o Tool Search no fluxo de produção.
Variáveis que merecem acompanhamento contínuo
O Gemini Tool Retrieval ainda está em versão de visualização (preview), e a interface pode sofrer ajustes antes do lançamento oficial. A taxa média de economia em ambientes reais de produção, a latência e a precisão — até 20 de novembro de 2026 — ainda não têm testes independentes verificáveis. Uma direção que podemos prever: as três empresas estão delegando a “governança do catálogo de ferramentas” aos desenvolvedores, e nomenclatura, descrições curtas, agrupamento e permissões vão se parecer cada vez mais com engenharia de índice de um sistema de recuperação. Antes de entrar em produção, recomendo montar um experimento controlado com base em tokens de entrada iniciais, tokens de uso de ferramentas, taxa de escolha correta da ferramenta, taxa de recuperação sem correspondência e número médio de buscas, validando horizontalmente no mesmo conjunto de tarefas em ambientes multimodelo como o APIYI apiyi.com, para não ser induzido pelos números promocionais de um único fornecedor.
Ter muitas ferramentas não significa que o Agent ficou mais inteligente; o que define o teto do Agent é a capacidade de encontrar a ferramenta certa na hora certa. Como dizem os Analectos (Lunyu · Wei Ling Gong): “Para fazer bem o seu trabalho, é preciso primeiro afiar suas ferramentas.”
Referências
- Documentação técnica do Google Tool Retrieval: recuperação no servidor e no cliente, limites, cobrança e exemplos de cálculo
- Link:
aistudio.google.com/docs/tool-retrieval
- Link:
- Anúncio oficial do Google: Introducing Tool Retrieval in the Gemini API
- Link:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- Link:
- Documentação do Anthropic Tool Search Tool: Regex, BM25, tool_reference e limitações
- Link:
platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Link:
- Anúncio do Anthropic Advanced Tool Use: lançamento do Tool Search e avaliação interna
- Link:
anthropic.com/research/advanced-tool-use
- Link:
- Documentação do OpenAI Tool Search: namespace, recuperação no cliente e injeção dinâmica
- Link:
developers.openai.com/api/docs/guides/tools-tool-search
- Link:
- Anúncio do OpenAI GPT-5.4: lançamento do Tool Search e testes do MCP Atlas
- Link:
openai.com/index/introducing-gpt-5-4
- Link:
Autor: Equipe técnica da APIYI
Intercâmbio técnico: se você quiser discutir mais a fundo a adaptação de chamadas de ferramentas em Agents multimodelo, visite o APIYI apiyi.com para entrar em contato. Mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com