Nota do autor: A “velocidade” do Gemini 4 Neon pode ser medida de pelo menos três formas. Este artigo organiza separadamente o tempo até o primeiro token, a saída por segundo e o tempo para concluir uma tarefa, e indica a fonte de cada número.
O Gemini 4 Neon foi lançado em 2026-11-18. O post de lançamento de Sundar Pichai diz que o modelo consegue concluir tarefas mais rapidamente em engenharia de software complexa, trabalho de conhecimento e processos científicos. Muitas pessoas leram essa frase como “o mais rápido em tudo”. Na prática, a medição de velocidade tem pelo menos três critérios, e os rankings que eles produzem não coincidem.
Todos os números de velocidade neste artigo vêm da página do modelo no Artificial Analysis e de artigos do Artificial Analysis; as pontuações de benchmark vêm de dados divulgados oficialmente e do model card; nenhum número foi medido por nós. Números de fontes diferentes e critérios diferentes serão listados lado a lado, sem média e sem sintetizar novos números.
Valor central: depois de ler este artigo, você saberá distinguir o tempo até o primeiro token, a saída por segundo e o tempo por tarefa do Gemini 4 Neon, entenderá como os quatro níveis de raciocínio afetam velocidade e pontuação, e saberá qual indicador observar na hora de escolher um modelo.
Pontos-chave sobre a velocidade do Gemini 4 Neon
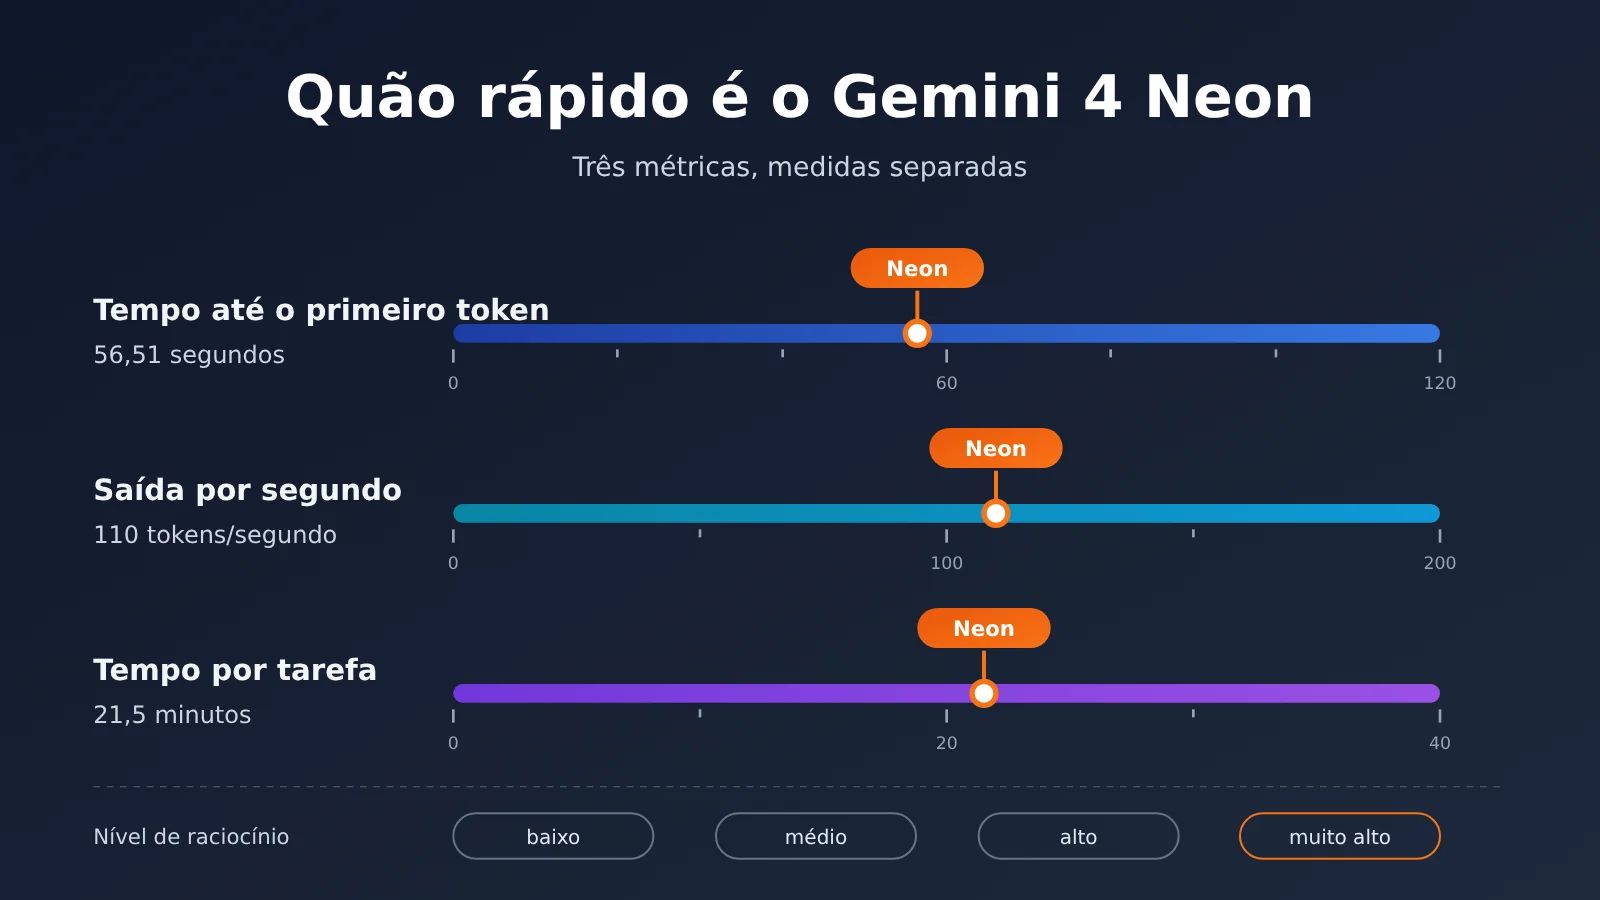
Primeiro, vamos separar três métricas que costumam ser confundidas. Na tabela abaixo, os valores do Neon correspondem todos ao nível xhigh e foram obtidos da página do modelo no Artificial Analysis (consultada em 2026-11-19, índice v5.0.1).
| Métrica | Significado | Valor do Gemini 4 Neon xhigh | Percepção do usuário |
|---|---|---|---|
| Tempo até o primeiro token | Espera entre enviar a solicitação e ver o primeiro token da resposta | 56.51 segundos | Em uma interação, “quanto tempo trava até começar a produzir texto” |
| Tokens por segundo | Quantos tokens são gerados por segundo depois que a saída começa | 110 tokens/segundo | Quão rápido o streaming é atualizado |
| Tempo por tarefa | Tempo médio para concluir uma questão do índice | 21.5 minutos | Quanto tempo uma tarefa leva para ser entregue |
| Volume de saída do índice | Quantos tokens são gerados ao executar o conjunto completo do índice | 283 milhões de tokens | A outra metade que determina o tempo por tarefa |
Por que as três métricas de velocidade do Gemini 4 Neon devem ser analisadas separadamente
O tempo até o primeiro token tem o maior impacto em interações de chat. Modelos de raciocínio precisam concluir uma etapa de inferência antes de emitir o primeiro token da resposta; por isso, o tempo até o primeiro token costuma ser medido em segundos ou até minutos e está fortemente relacionado ao nível de raciocínio.
Os tokens por segundo medem apenas a vazão “depois que a saída começa” e não têm relação com quanto o modelo precisa falar. O tempo por tarefa é afetado por duas coisas ao mesmo tempo: quantos tokens podem ser gerados por segundo e quantos tokens essa questão exige no total. Um modelo pode ter uma saída por segundo muito alta e, ainda assim, ser mais lento para concluir uma tarefa se costumar escrever processos de raciocínio muito longos. É exatamente isso que acontece na comparação entre Neon, GPT-6.2 Sol e GPT-6.2 Astra mais adiante.
Funcionalidades principais do Gemini 4 Neon: posicionamento na família e quatro níveis de pensamento
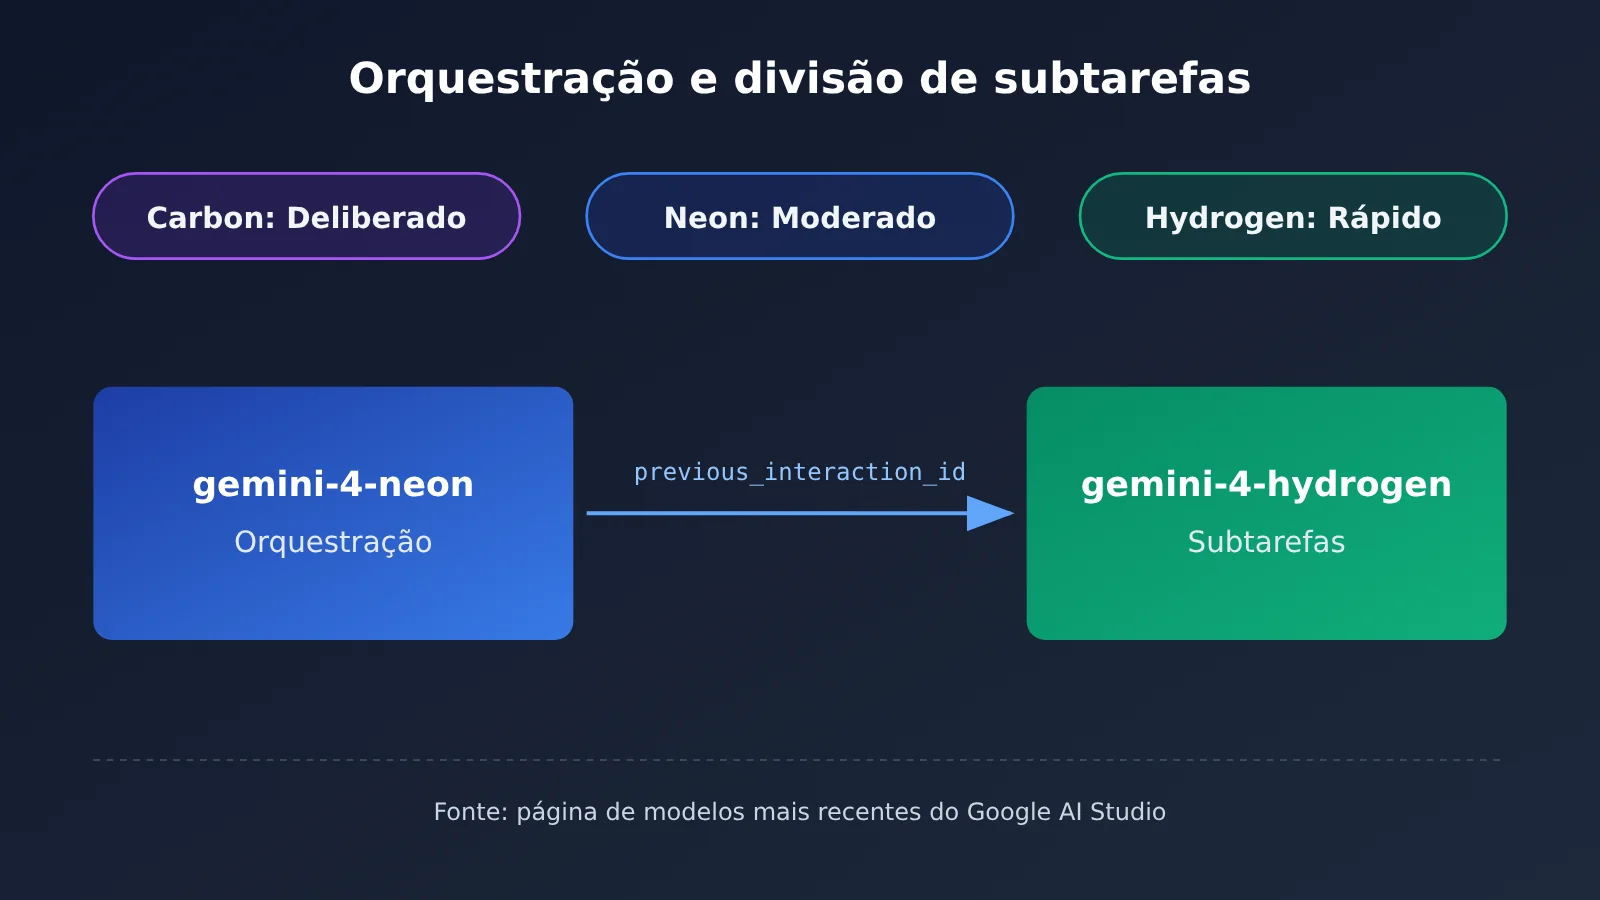
A página mais recente de modelos do Google AI Studio atribui rótulos qualitativos de velocidade às três versões do Gemini 4: Carbon é Deliberate, Neon é Moderate, Hydrogen é Fast. Ou seja, na própria classificação qualitativa oficial, o Neon fica no meio da família, e o Hydrogen é a versão marcada como Fast. O blog do Google também posiciona o Carbon como o mais indicado para tarefas longas e difíceis, o Hydrogen para execuções rápidas do dia a dia, e o Neon como meio-termo, voltado a fluxos complexos de alta frequência.
| Modelo | Classificação de velocidade no AI Studio | Níveis de pensamento | Nível padrão | Posicionamento na família (blog do Google / guia do desenvolvedor) |
|---|---|---|---|---|
| Gemini 4 Carbon | Deliberate | low, medium, high | medium | Tarefas longas e complexas |
| Gemini 4 Neon | Moderate | low, medium, high, xhigh | high | Meio-termo, fluxos complexos de alta frequência |
| Gemini 4 Hydrogen | Fast | não detalhado nos materiais | não detalhado nos materiais | Ciclo rápido do dia a dia |
Capacidades e especificações do Gemini 4 Neon
Segundo o model card, o Gemini 4 Neon é uma adaptação do Gemini 4 Carbon, com corte de conhecimento em março de 2026, entrada com suporte a texto, imagem, áudio e vídeo e janela unificada de até 1 milhão de tokens. A saída síncrona padrão chega a até 64 mil tokens, e a decodificação longa em segundo plano vai até 1 milhão de tokens. O guia do desenvolvedor do Google Cloud informa o ID do modelo gemini-4-neon, com limite unificado de 1048576 tokens, incluindo entrada e saída, sendo que a saída abrange pensamento, chamadas de função e resposta final.
Em termos de capacidade, o Artificial Analysis Intelligence Index autodeclarado pela própria empresa é 61 no nível xhigh, ficando em 3º lugar no ranking geral, e o blog também admite que ele fica atrás de modelos maiores e mais lentos. O quadro comparativo do model card tem apenas três colunas: Neon, Claude Opus 5.5 e GPT-6.2 Sol. Os resultados de modelos que não são Gemini são, por padrão, os autodeclarados por cada fornecedor, portanto aquela tabela é uma compilação oficial, não um reteste feito pelo mesmo laboratório no mesmo dia. Na tabela também há itens em que o Neon fica atrás — por exemplo, no Terminal-bench 4.1, com o ajuste contra trapaça, a acurácia do Opus 5.5 é 65,8%, acima dos 65,2% do Neon.
O guia do desenvolvedor ainda apresenta um uso de orquestração: usar gemini-4-neon como controlador principal e passar o previous_interaction_id para o gemini-4-hydrogen executar subtarefas mais rápidas. Se você acha o Neon lento demais, esse caminho vale mais a pena do que simplesmente baixar os níveis de pensamento (essa é a nossa avaliação, não o texto do guia).
Dados de velocidade do Gemini 4 Neon: os quatro níveis de raciocínio, um a um
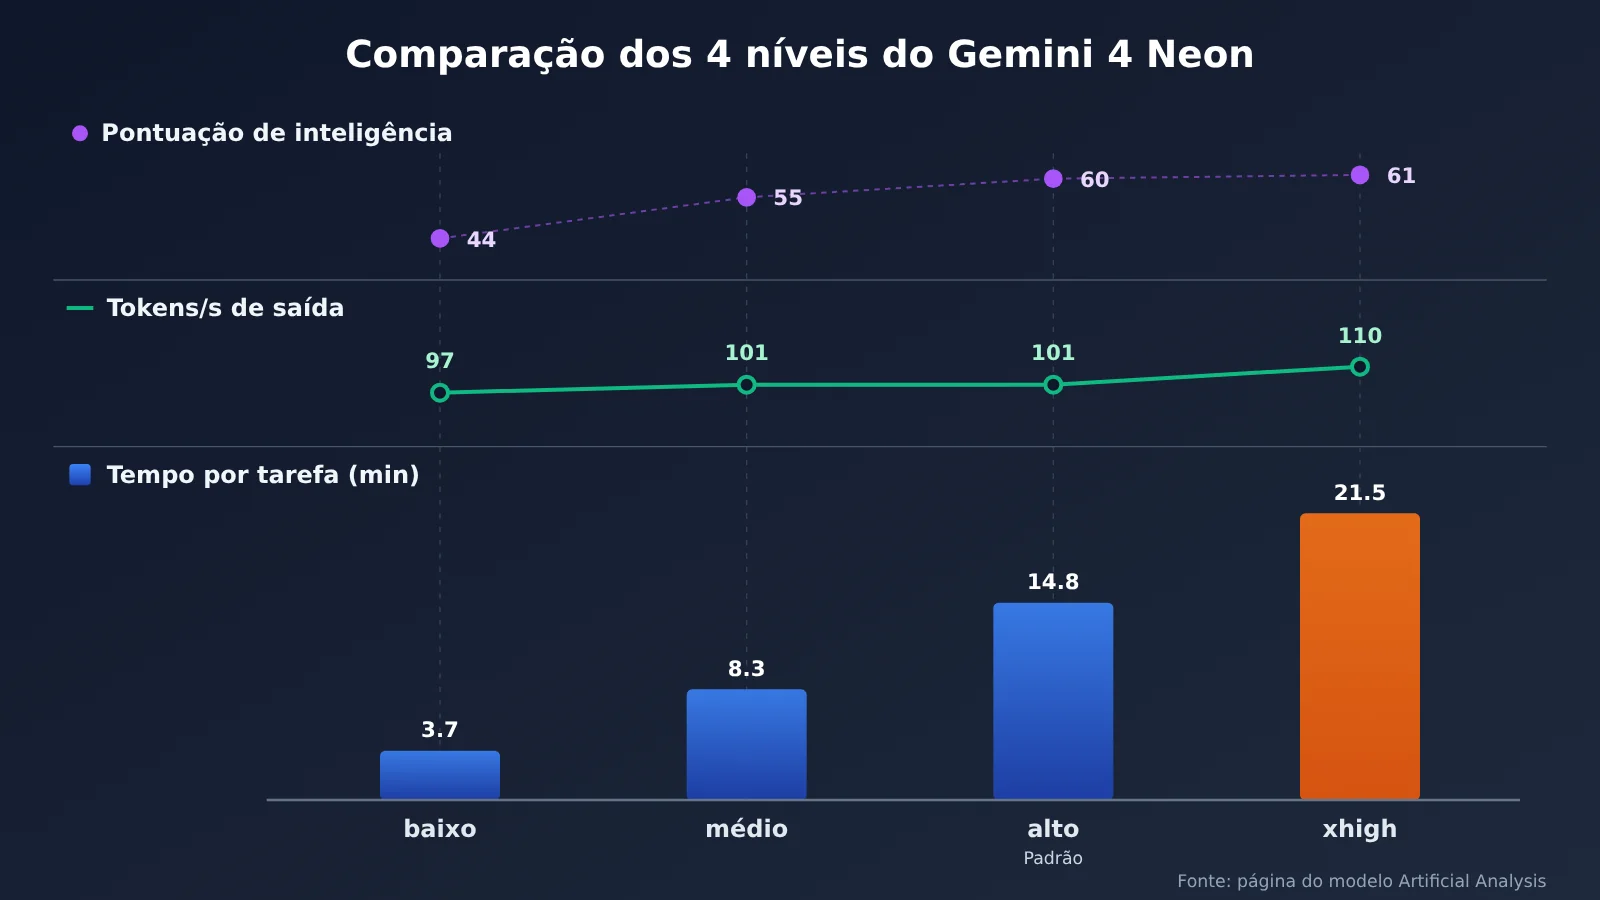
A tabela abaixo vem da página do modelo no Artificial Analysis. O tempo até o primeiro token na coluna mais à direita precisa de uma explicação separada: a tabela-resumo da página traz apenas 56.51 segundos para o xhigh; os valores de tempo até o primeiro token para high, medium e low vêm da seção FAQ da mesma página, e não da mesma coluna da tabela-resumo. Ao citar, mantenha essa fonte.
| Nível de raciocínio | Pontuação de inteligência | Tempo por tarefa | Saída por segundo | Tempo até o primeiro token (seção FAQ da página do modelo) |
|---|---|---|---|---|
| xhigh | 61 | 21.5 minutos | 110 tokens/segundo | 56.51 segundos |
| high (padrão) | 60 | 14.8 minutos | 101 tokens/segundo | 40.64 segundos |
| medium | 55 | 8.3 minutos | 101 tokens/segundo | 20.14 segundos |
| low | 44 | 3.7 minutos | 97 tokens/segundo | 13.93 segundos |
Olhando para a tabela, a saída por segundo dos quatro níveis varia só entre 97 e 110 tokens/segundo, mas o tempo por tarefa vai de 3.7 minutos a 21.5 minutos. O que muda ao trocar o nível é principalmente “quanto pensar”; o impacto em “quão rápido ele escreve por segundo” é pequeno. Essa é uma inferência a partir dos números da tabela — a página do modelo não coloca as coisas desse jeito.
O custo em pontuação também é claro. Do high padrão, com 60 pontos, para o medium você perde só 5 pontos; para o low, cai para 44. O xhigh tem 1 ponto a mais que o high, mas acrescenta quase 7 minutos por tarefa. Se vale a pena depende da sua tarefa.
Gemini 4 Neon é mais rápido por segundo; por que ainda pode levar mais tempo para concluir uma tarefa?
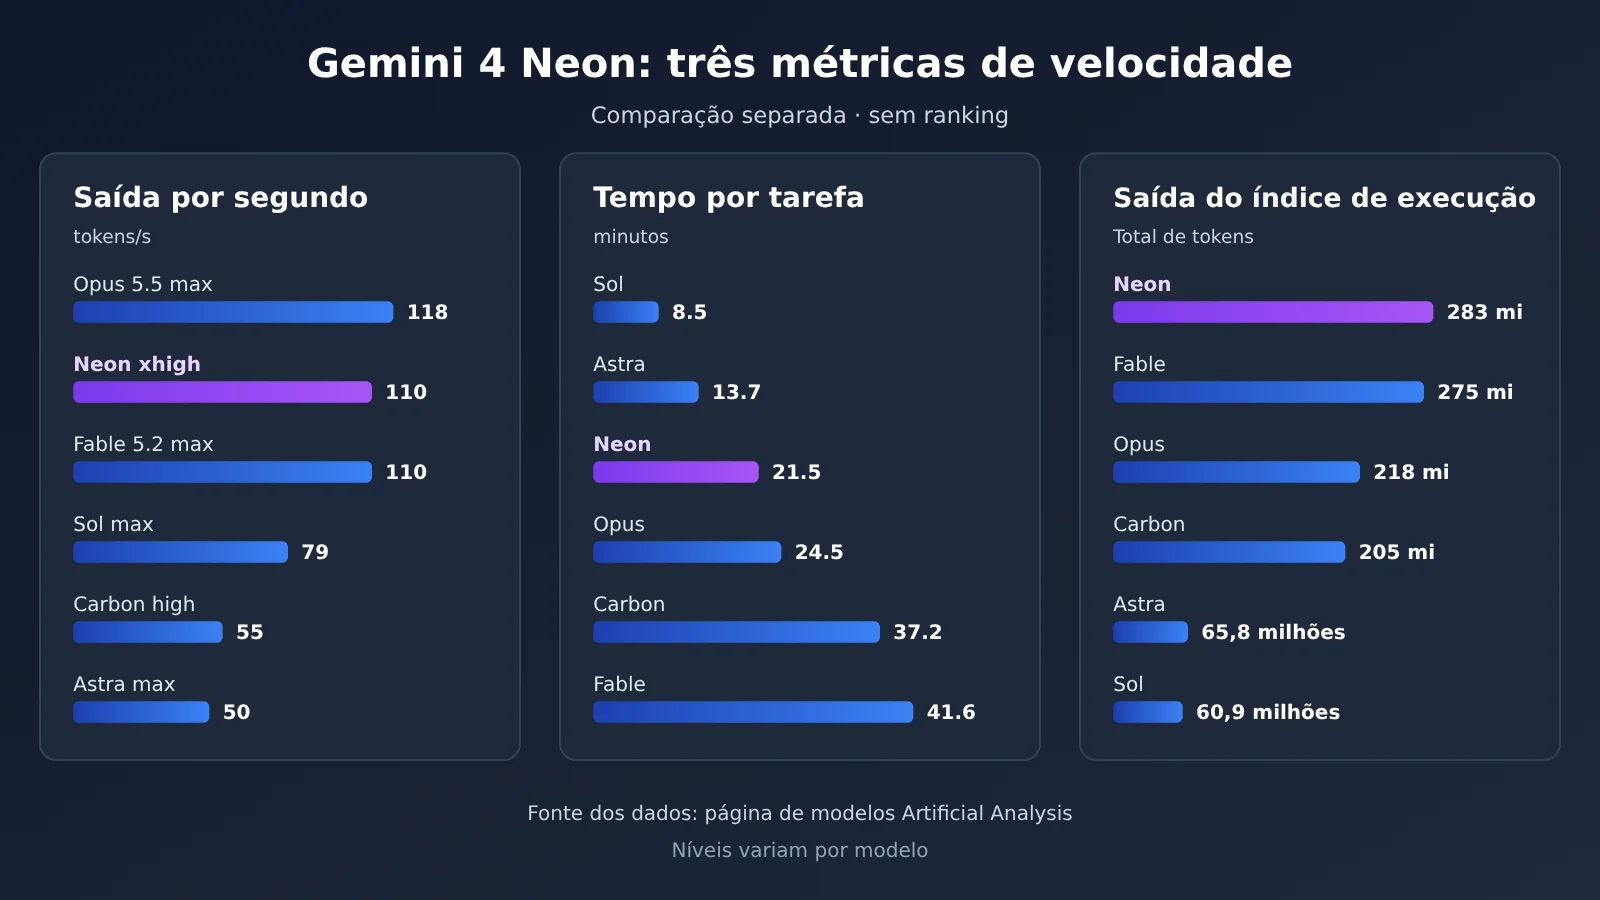
A página do modelo no Artificial Analysis registra que o Neon xhigh, ao executar a suíte completa de benchmarks, gerou 283 milhões de tokens de saída e teve 8,12 bilhões de tokens de entrada. Quanto mais tokens de saída, mesmo a 110 por segundo, maior será o tempo total. O GPT-6.2 Astra, no nível max, produz só 50 tokens por segundo, mas, ao rodar a suíte, gera apenas 65,8 milhões de tokens, com tempo por tarefa de 13,7 minutos. O GPT-6.2 Sol, no nível max, produz 79 tokens por segundo, gera 60,9 milhões de tokens e leva 8,5 minutos por tarefa.
Então, “mais tokens de saída por segundo” e “terminar a tarefa mais cedo” são duas coisas diferentes. Comparando o Neon com esses dois GPTs, a saída por segundo do Neon é maior, mas o tempo por tarefa é ainda maior — justamente porque o Neon gera muito mais tokens de saída.
Gemini 4 Neon comparado separadamente com os modelos de referência
Todos os números da tabela abaixo vêm da página de modelos da Artificial Analysis. O nível usado por cada modelo é diferente (o Neon usa xhigh, o Carbon usa high, os demais usam max), então só dá para olhar a relação relativa dentro de uma mesma coluna — não dá para tratar isso como uma disputa em condições iguais.
| Modelo (nível) | Pontuação de inteligência | Tempo por tarefa | Saída por segundo | Tempo até o primeiro token | Tokens de saída do índice |
|---|---|---|---|---|---|
| Gemini 4 Neon (xhigh) | 61 | 21,5 minutos | 110 | 56,51 segundos | 283 milhões |
| Gemini 4 Carbon (high) | 60 | 37,2 minutos | 55 | 73,04 segundos | 205 milhões |
| Claude Opus 5.5 (max) | 59 | 24,5 minutos | 118 | 335,85 segundos | 218 milhões |
| Claude Fable 5.2 (max) | 65 | 41,6 minutos | 110 | 247,46 segundos | 275 milhões |
| GPT-6.2 Astra (max) | 62 | 13,7 minutos | 50 | 197,65 segundos | 65,8 milhões |
| GPT-6.2 Sol (max) | 57 | 8,5 minutos | 79 | 75,06 segundos | 60,9 milhões |
Olhando indicador por indicador:
- Saída por segundo: o Claude Opus 5.5 max faz 118 tokens/s, acima dos 110 do Neon xhigh; o Claude Fable 5.2 max empata com o Neon em 110.
- Tempo por tarefa: os 8,5 minutos do GPT-6.2 Sol max e os 13,7 minutos do GPT-6.2 Astra max são mais curtos que os 21,5 minutos do Neon xhigh.
- Tempo até o primeiro token: os 56,51 segundos do Neon xhigh são o menor valor desta tabela, mas como cada linha usa um nível diferente, não dá para concluir a partir disso que ele lidera em tudo.
A aceleração do Neon em relação ao Carbon aparece em duas contas diferentes. A página de modelos da Artificial Analysis traz o Carbon high com 55 tokens/s e 37,2 minutos. Já o artigo da Artificial Analysis dá valores aproximados: o Neon leva cerca de 21 minutos por tarefa, contra cerca de 36 minutos do Carbon — uns 40% a menos —, e o ganho vem da velocidade de saída, cerca de 110 contra cerca de 57 tokens/s, enquanto o Neon produz cerca de 15% mais tokens de saída por tarefa. As duas séries de números do Carbon usam bases de medição diferentes, então aqui elas não são subtraídas uma da outra.
Como começar rapidamente: seleção de níveis do Gemini 4 Neon e método de teste de velocidade
gemini-4-neon atualmente precisa ser chamado pelos canais oficiais do Google. As etapas abaixo se dividem em duas partes: primeiro explico como escolher o nível do Neon, depois monto o fluxo de teste de velocidade usando os modelos Gemini 4 já disponíveis na APIYI — quando o Neon estiver disponível, basta trocar o ID do modelo.
Primeiro passo: entender os quatro níveis de raciocínio do Neon. O guia para desenvolvedores do Google Cloud especifica que os níveis de raciocínio do gemini-4-neon são apenas low, medium, high e xhigh, com high como padrão. Passar thinking_budget ou MINIMAL retorna HTTP 400 — esse é o erro mais fácil de cometer ao migrar código da versão antiga do Gemini.
Segundo passo: reduzir o nível conforme a necessidade de velocidade. Se estiver achando lento, dá para descer do high padrão para medium ou low. Segundo a página do modelo na Artificial Analysis, o tempo por tarefa cai dos 14,8 minutos do high para 8,3 minutos ou 3,7 minutos, enquanto a pontuação de inteligência vai dos 61 do xhigh (60 no high padrão) para 55 ou 44. A queda de pontuação do low é grande, então antes de reduzir vale a pena fazer uma amostragem nas suas próprias tarefas para confirmar.
Terceiro passo: preparar a conta e a Key da APIYI. Registre-se em APIYI apiyi.com e obtenha a API Key, colocando-a em uma variável de ambiente (por exemplo, APIYI_API_KEY). No código, leia apenas a variável de ambiente, nunca escreva a chave em texto puro.
Quarto passo: escolher a forma de chamada. Para a interface compatível com OpenAI, preencha o base_url com https://api.apiyi.com/v1 e o nome do modelo com gemini-4-carbon ou gemini-4-hydrogen, que já estão disponíveis; se usar o protocolo nativo do Gemini, o endereço é https://api.apiyi.com, com versão de api v1beta.
Quinto passo: registrar as três métricas separadamente. Ative a saída em streaming com stream e anote, respectivamente, o tempo até o primeiro token de resposta chegar, os tokens/segundo após o início da saída e o tempo total até o fim da tarefa. Registre também o total de tokens gerados nesta execução. Só com o número de tokens de saída é possível saber se a demora vem de “escrever devagar” ou de “escrever muito”.
🚀 Sugestão de início rápido: o ideal é validar o fluxo de teste de velocidade primeiro nos modelos Gemini 4 já disponíveis. A APIYI cobre as séries Gemini, Claude e GPT com uma única Key, então o script de registro das três métricas é escrito uma vez e serve para comparar vários modelos lado a lado. Quando o Neon estiver disponível, só é preciso alterar o ID do modelo.
Preço do Gemini 4 Neon e conferência de modelos na APIYI
O preço oficial do Gemini 4 Neon (na página de preços do Google AI Studio) é de US$ 3 por milhão de tokens de entrada e US$ 15 por milhão de tokens de saída.
Na APIYI, verificamos dois lugares: a tabela geral da APIYI (docs.apiyi.com/models.md, com atualização indicada na página em 2026-11-16 09:39, UTC+8) e a interface de preços consultada em 2026-11-19 (api.apiyi.com/api/pricing, versão shell-api-modelmak-v1, com 285 modelos). A seguir estão os modelos já disponíveis que podem ser comparados entre as duas fontes, com valores em dólares por milhão de tokens.
| ID do modelo | Entrada | Leitura de cache | Saída | Endpoint | Observações (fonte) |
|---|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | Corresponde ao preço introdutório do Google até 2026-11-30 (tabela geral da APIYI) |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | Tabela geral da APIYI |
claude-opus-5-5 / claude-opus-5-5-thinking |
4 | 0.2 | 20 | chat, messages | Tabela geral da APIYI |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 0.2 | 40 | chat, messages | Tabela geral da APIYI |
gpt-6.2-sol |
2 (acima de 272000, 3) | 0.1 | 10 (cerca de 11.25 na faixa superior da interface de preços) | responses (recomendado), chat | A tabela geral só informa o salto na entrada |
gpt-6.2-astra |
8 (acima de 272000, 16) | 0.4 | 40 (cerca de 60 na faixa superior da interface de preços) | responses, chat | A tabela geral só informa o salto na entrada |
Alguns detalhes merecem atenção. O preço listado do gemini-4-carbon corresponde ao preço introdutório do Google, e não ao preço padrão posterior (4/20). A grafia dos nomes de grupo não é totalmente consistente entre as duas fontes: para os modelos Gemini, a tabela geral usa Default e SVIP, enquanto a interface de preços usa default e svip; para os modelos Claude, a tabela geral usa ClaudeCode, Claude_Reverse, Claude_Enterprise, Default e SVIP, e a interface de preços usa ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default e svip. O preço de saída da faixa superior dos modelos GPT só aparece na interface de preços; nela, quando se ultrapassa 272000 tokens, o CompletionRatio passa de 5 para 3.75.
O gemini-4-neon não está incluído na tabela geral da APIYI nem na interface de preços, portanto ainda não foi disponibilizado. Vamos disponibilizá-lo o mais breve possível; a referência para modelos e preços é a lista de modelos da plataforma.
Análise de prós e contras do Gemini 4 Neon
Vantagens
- Saída por segundo maior que a das gerações anteriores da família: A página do modelo no Artificial Analysis mostra Neon xhigh a 110 tokens por segundo, e Carbon high a 55 tokens por segundo.
- Tempo até o primeiro token relativamente curto: O TTFT do xhigh é 56.51 segundos, o menor valor da tabela comparativa acima (os níveis são diferentes, então serve apenas como referência).
- Níveis de raciocínio bem granulados: Quatro níveis de pensamento, de 3.7 minutos no low a 21.5 minutos no xhigh, permitindo escolher conforme a tarefa.
- Especificações completas: A ficha do modelo lista entradas de texto, imagem, áudio e vídeo, além de uma janela unificada de 1 milhão de tokens; o guia do desenvolvedor explica que o cache implícito é ativado automaticamente para prefixos compartilhados acima de 4096 tokens.
Limitações
- Muitos tokens de saída: A execução do índice consumiu 283 milhões de tokens de saída, o que faz uma única tarefa no xhigh demorar mais do que no Sol e no Astra. A solução é baixar o nível ou delegar subtarefas ao Hydrogen.
- A classificação oficial é apenas Moderate: O AI Studio atribuiu o rótulo Fast ao Hydrogen; cenários que buscam a interação mais rápida devem testar o Hydrogen primeiro.
- Algumas configurações não são suportadas: O guia do desenvolvedor afirma que o cache de contexto explícito não é suportado, e que
thinking_budgeteMINIMALretornam400. - Não há nível gratuito: A página de preços do AI Studio afirma que
gemini-4-neonnão tem nível gratuito. - Critérios de benchmark mistos: O Coding Agent Index é 58.6 no blog do Google e 59 no artigo do Artificial Analysis; os 12.8% e 39.0% do SWE-sweep vêm de dois harnesses diferentes. É preciso observar a fonte ao ler os dados.
Perguntas frequentes (FAQ)
P1: O Gemini 4 Neon é o mais rápido da família Gemini 4?
De acordo com a classificação da página de modelos mais recente do Google AI Studio, o Hydrogen é Fast, o Neon é Moderate e o Carbon é Deliberate. O “termina mais rápido” citado na documentação oficial se refere principalmente à comparação com o Carbon.
P2: Quanto tempo o Gemini 4 Neon leva para gerar o primeiro token?
A tabela resumo da página de modelos do Artificial Analysis indica 56,51 segundos para o primeiro token em xhigh. A seção de FAQ da mesma página também traz 40,64 segundos em high, 20,14 segundos em medium e 13,93 segundos em low; esses números das três faixas vêm da seção de FAQ, não da mesma coluna da tabela resumo.
P3: Por que o Gemini 4 Neon gera 110 tokens por segundo e ainda assim leva 21,5 minutos por tarefa?
Porque ele gera muitos tokens. A página de modelos do Artificial Analysis registra que o Neon em xhigh, ao rodar o índice, gerou 283 milhões de tokens, enquanto o Sol max gerou apenas 60,9 milhões e o Astra max apenas 65,8 milhões; por isso os dois últimos são mais lentos por segundo, mas levam menos tempo por tarefa.
P4: Qual faixa o Gemini 4 Neon usa por padrão? Como ajustar para ficar mais rápido?
O guia do desenvolvedor indica que o padrão é high. Para ficar mais rápido, dá para reduzir para medium ou low; segundo a página de modelos do Artificial Analysis, o tempo por tarefa cai para 8,3 minutos e 3,7 minutos, respectivamente, e a pontuação de inteligência cai de 61 em xhigh (60 em high) para 55 ou 44.
P5: Já é possível chamar o Gemini 4 Neon via APIYI?
Até 2026-11-19, o `gemini-4-neon` ainda não aparece na tabela geral da APIYI nem na interface de preços; ele ainda não está disponível, mas vamos disponibilizá-lo o quanto antes. Por enquanto, você pode se registrar em apiyi.com e montar seu fluxo de teste de velocidade usando o `gemini-4-carbon` ou o `gemini-4-hydrogen`, que já estão disponíveis; o endereço compatível com OpenAI é o mesmo do guia rápido acima.
P6: Quanto o Gemini 4 Neon é mais barato que o Carbon?
Aqui há três formas de contabilizar: o blog do Google diz que o custo por tarefa no padrão high é 32% menor que o do Carbon; o artigo do Artificial Analysis diz que é cerca de 17% menor que o preço sem desconto do Carbon; e a página de modelos do Artificial Analysis, calculando pelo preço de lançamento, indica 4,90 dólares por tarefa para o Carbon em high. Os três critérios são diferentes e não podem ser combinados em um único número.
P7: As pontuações de benchmark do Gemini 4 Neon podem ser comparadas diretamente com as dos concorrentes?
É preciso ter cuidado. O model card observa que os resultados de modelos que não são Gemini vêm por padrão dos relatos de cada empresa, tratando-se de um resumo oficial, e não de um reteste no mesmo dia; já a comparação do Artificial Analysis tem diferenças de faixa (xhigh, high e max misturados).
Principais pontos do Gemini 4 Neon
- A velocidade tem três dimensões: tempo até o primeiro token, tokens por segundo e tempo por tarefa são independentes, e as classificações podem se contradizer.
- A posição oficial fica no meio-termo: o AI Studio classifica o Neon como Moderate; o Hydrogen é que é Fast.
- Dados do xhigh: a página do modelo no Artificial Analysis mostra 61 pontos, 21,5 minutos, 110 tokens/segundo e primeiro token em 56,51 segundos.
- O volume de saída alonga o tempo: 283 milhões de tokens de saída fazem o tempo por tarefa do Neon ficar maior que o do Sol e do Astra.
- Não é o maior tokens/segundo: o Opus 5.5 max, com 118 tokens/segundo, supera os 110 do Neon.
- Baixar a configuração em troca de velocidade: no medium são 8,3 minutos e 55 pontos; no low, 3,7 minutos e 44 pontos; o padrão é high.
- Situação atual de acesso: o APIYI ainda não disponibilizou o Neon; por enquanto, dá para montar o fluxo de teste de velocidade usando os modelos Gemini 4 já disponíveis.
Conclusão
As conclusões centrais sobre a velocidade do Gemini 4 Neon:
- Em relação ao Carbon, ele é de fato rápido: os dois conjuntos de dados do Artificial Analysis mostram que a saída por segundo do Neon é cerca do dobro da do Carbon, e o tempo por tarefa é claramente menor.
- Em um panorama mais amplo, ele não lidera em tudo: a saída por segundo fica abaixo do Opus 5.5 max, e o tempo por tarefa é maior que o do Sol max e do Astra max.
- A configuração é o principal botão de ajuste: a saída por segundo varia pouco entre os quatro níveis; a diferença de tempo vem principalmente da quantidade de tokens de raciocínio.
Nossa avaliação: em cenários interativos, olhe primeiro para o tempo até o primeiro token; em processamento em lote, olhe primeiro para o tempo por tarefa; e só no caso de experiência em streaming vale focar na saída por segundo. Se o Neon é “rápido o suficiente” depende de qual métrica você prioriza. A sugestão é primeiro rodar todo o processo de registro dessas três métricas no APIYI apiyi.com com os modelos Gemini 4 existentes; assim, quando o Neon for disponibilizado, basta trocar o modelo para fazer a comparação.
📚 Materiais de Referência
-
Post de lançamento de Sundar Pichai: Lançamento e escopo de disponibilidade do Gemini 4 Neon
- Link:
x.com/sundarpichai/status/2123167780988125621 - Descrição: Canal de lançamento e a declaração oficial de “terminar mais rápido”
- Link:
-
Blog do Google “Introducing Gemini 4 Neon”: Pontuações autorreportadas oficiais, preços e posicionamento na família
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Descrição: Todos os números são autodeclarados oficialmente
- Link:
-
Model Card do DeepMind: Especificações e tabela comparativa de três colunas
- Link:
deepmind.google/models/model-cards/gemini-4-neon/ - Descrição: Resultados que não são do Gemini vêm, por padrão, de autodeclarações de cada empresa
- Link:
-
Guia para desenvolvedores do Google Cloud: IDs de modelo, níveis de raciocínio e descrições de erros
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Descrição: Quatro níveis de raciocínio, padrão high e condições de acionamento do HTTP 400
- Link:
-
Página de preços e modelos mais recentes do Google AI Studio: Preços oficiais e caracterização de velocidade
- Link:
aistudio.google.com/docs/pricing,aistudio.google.com/docs/latest-model - Descrição: Três níveis qualitativos: Deliberate, Moderate e Fast
- Link:
-
Artigo do Artificial Analysis: Comparação de terceiros entre Neon e Carbon
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Descrição: Aproximações como cerca de 21 minutos, cerca de 36 minutos e cerca de 57 tokens/segundo
- Link:
-
Página de modelo do Artificial Analysis: Quatro níveis de velocidade e dados dos modelos de comparação
- Link:
artificialanalysis.ai/models/gemini-4-neon - Descrição: Lido em 2026-11-19, índice v5.0.1, a seção FAQ também traz o tempo até o primeiro token de cada nível
- Link:
-
Tabela geral da APIYI: Modelos já listados e preços
- Link:
docs.apiyi.com/models.md - Descrição: Modelos e preços estão sujeitos à lista de modelos da plataforma
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Para saber o progresso da listagem e tirar dúvidas sobre os modelos do Gemini 4 Neon, fale conosco na página inicial da APIYI apiyi.com