Nota do autor: este texto separa as pontuações públicas do Gemini 4 Neon em três blocos — programação, trabalho do conhecimento e ciência —, indicando a fonte item por item para ajudar você a decidir que tipo de tarefa faz sentido delegar a ele.
Em 2026-11-18, o Google lançou o Gemini 4 Neon, e no post de anúncio Sundar Pichai resumiu seu posicionamento como “concluir mais rápido” em engenharia de software complexa, trabalho do conhecimento e processos científicos. No mesmo dia, a DeepMind publicou o model card, e a Artificial Analysis também divulgou um artigo de medição independente e uma página do modelo; de uma hora para outra, surgiram vários conjuntos de dados públicos.
O problema é que esses conjuntos de números usam critérios diferentes. O blog do Google é autodeclaração oficial; a tabela comparativa do model card até lista Claude Opus 5.5 e GPT-6.2 Sol, mas as notas de avaliação deixam claro que os resultados de modelos que não são Gemini vêm, por padrão, da autodeclaração de cada fornecedor; somente a Artificial Analysis faz medição independente de terceiros. Este artigo usa 2026-11-19 como data de checagem dos dados, mantém as etiquetas de fonte item por item e coloca lado a lado os números que não batem entre os conjuntos, sem calcular média.
Valor central: depois de ler este artigo, você terá uma tabela por tipo de tarefa e saberá em quais itens de programação, leitura de materiais e ciência os números oficiais colocam o Gemini 4 Neon em primeiro lugar, em quais itens o concorrente aparece à frente no model card e em quais itens a medição de terceiros mostra uma liderança de apenas 1 ponto.
Principais pontos do Gemini 4 Neon: comece pela entrada e depois divida em três blocos
A pontuação geral é o número que a maioria das pessoas vê primeiro. O artigo da Artificial Analysis mostra que o Gemini 4 Neon, no nível de raciocínio xhigh, tem pontuação de inteligência 61 e fica em 3º lugar geral, atrás de GPT-6.2 Astra (max) e Claude Fable 5.2 (max). O blog do Google (autodeclaração oficial) também informa 61 e 3º lugar, e acrescenta que ele “fica atrás de modelos maiores e mais lentos”. A coluna AA Index v5.0.1 da ficha do modelo também traz 61; para comparação, Opus 5.5 aparece com 59 e Sol, com 57.
Esse 61 é consistente nas três fontes, mas é apenas um ponto de entrada. A pontuação geral junta programação, leitura de materiais e ciência, mas o trabalho que você precisa entregar costuma pertencer a apenas uma dessas partes. A tabela abaixo esclarece primeiro a natureza dos três tipos de fonte; as seções seguintes detalham cada bloco.
| Fonte | Natureza | O que este artigo usa para analisar |
|---|---|---|
| Blog do Google | Autodeclaração oficial | Quais itens o Google autodeclara em primeiro lugar e as pontuações de cada um |
| Ficha do modelo DeepMind | Resumo oficial; resultados de modelos que não são Gemini em geral vêm de autodeclarações das respectivas empresas | Comparação item a item entre Neon, Opus 5.5 e Sol nas três colunas |
| Artigo da Artificial Analysis | Medição de terceiros | Coding Agent Index, GDP.pdf, MKA etc. |
| Página do modelo Artificial Analysis | Medição de terceiros, separada por nível de raciocínio | Diferenças de pontuação de inteligência entre os quatro níveis de raciocínio |
A posição do Gemini 4 Neon na família
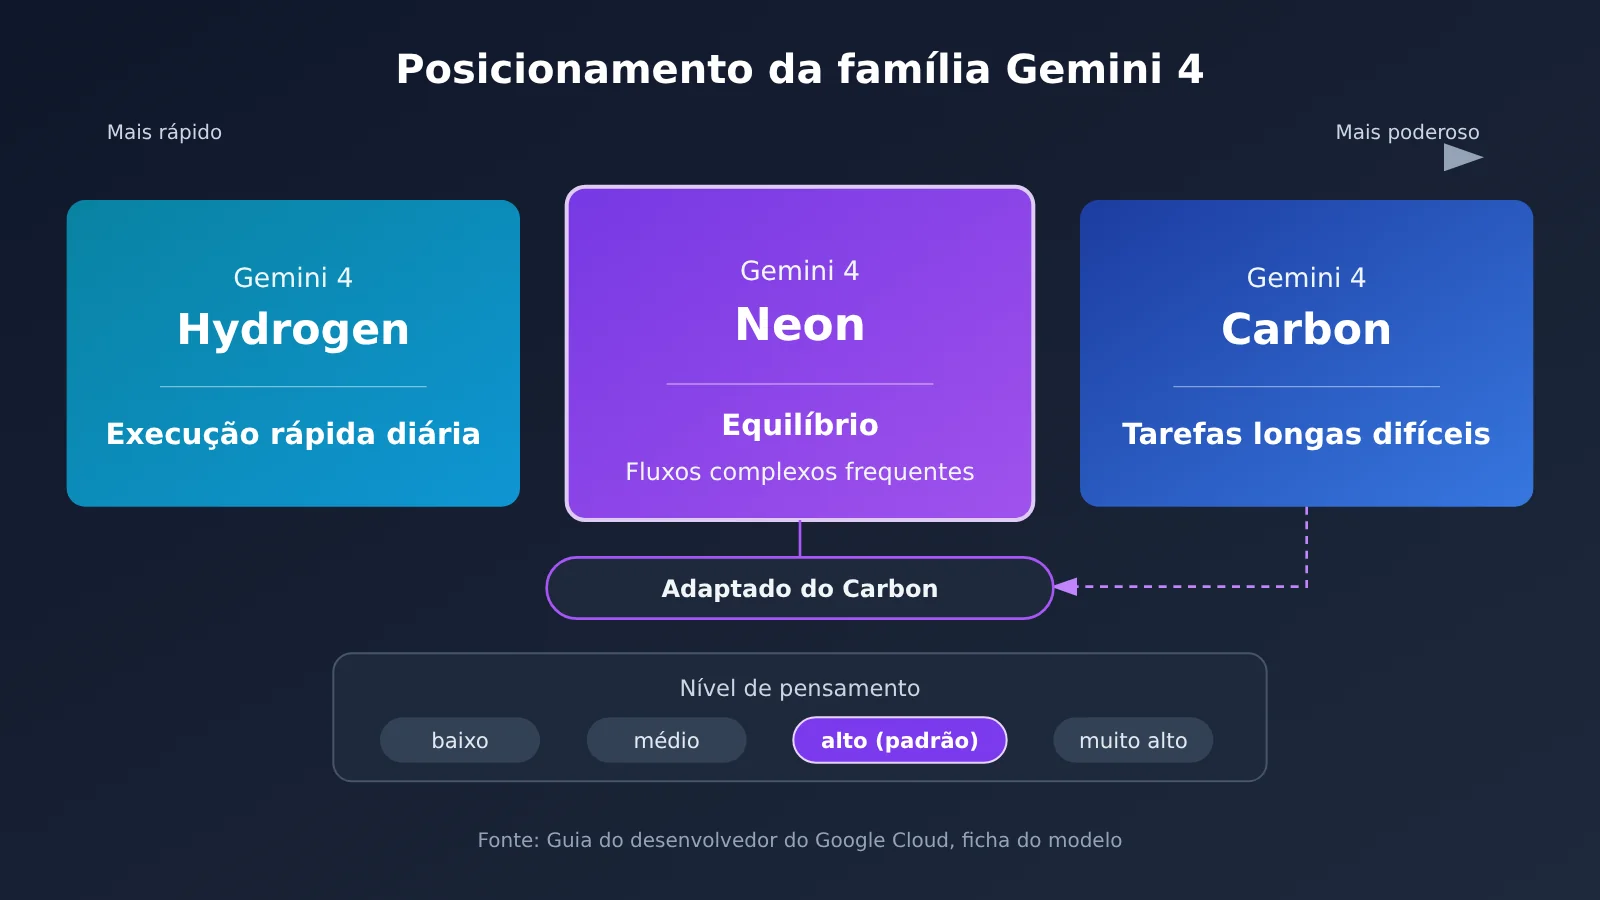
A ficha do modelo diz que o Gemini 4 Neon foi adaptado do Gemini 4 Carbon, tem corte de conhecimento em março de 2026 e aceita texto, imagem, áudio e vídeo na entrada, com janela unificada de até 1 milhão de tokens. O guia do desenvolvedor do Google Cloud o posiciona entre Hydrogen (ciclo rápido do dia a dia) e Carbon (tarefas longas e complexas); o blog oficial também afirma que ele é voltado para fluxos complexos de alta frequência.
Entender esse posicionamento ajuda a interpretar as pontuações a seguir. Os modelos de comparação do Neon mudam conforme a fonte: a ficha do modelo traz apenas as colunas de Opus 5.5 e Sol, sem Fable 5.2, Astra e Carbon; enquanto a Artificial Analysis o compara principalmente com Carbon, Fable e Opus. Nas comparações item a item, este artigo não pega células de outras fontes para preencher lacunas.
Capacidade de programação do Gemini 4 Neon: duas lideranças, dois pontos em que a Opus leva ligeira vantagem
Programação é a área à qual o blog do Google dedica mais espaço. A divulgação oficial afirma que o Gemini 4 Neon alcança 58.6 no Artificial Analysis Coding Agent Index, ficando em 1º no ranking geral. O artigo da Artificial Analysis traz o número 59, medido com Neon xhigh no Antigravity CLI. Como 58.6 e 59 vêm de duas fontes diferentes, este artigo mantém os dois.
A margem de liderança nas fontes de terceiros precisa ser olhada em separado. No artigo da Artificial Analysis, o Fable xhigh e o Opus 5.5 max no Claude Code ficam ambos em 58, enquanto o Carbon high fica em 55. Ou seja, a vantagem do Neon sobre esses dois modelos Claude é de 1 ponto.
Já o detalhamento por item do model card é mais minucioso, e em dois itens o Opus 5.5 é maior.
| Item de programação (model card) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | Sem dados |
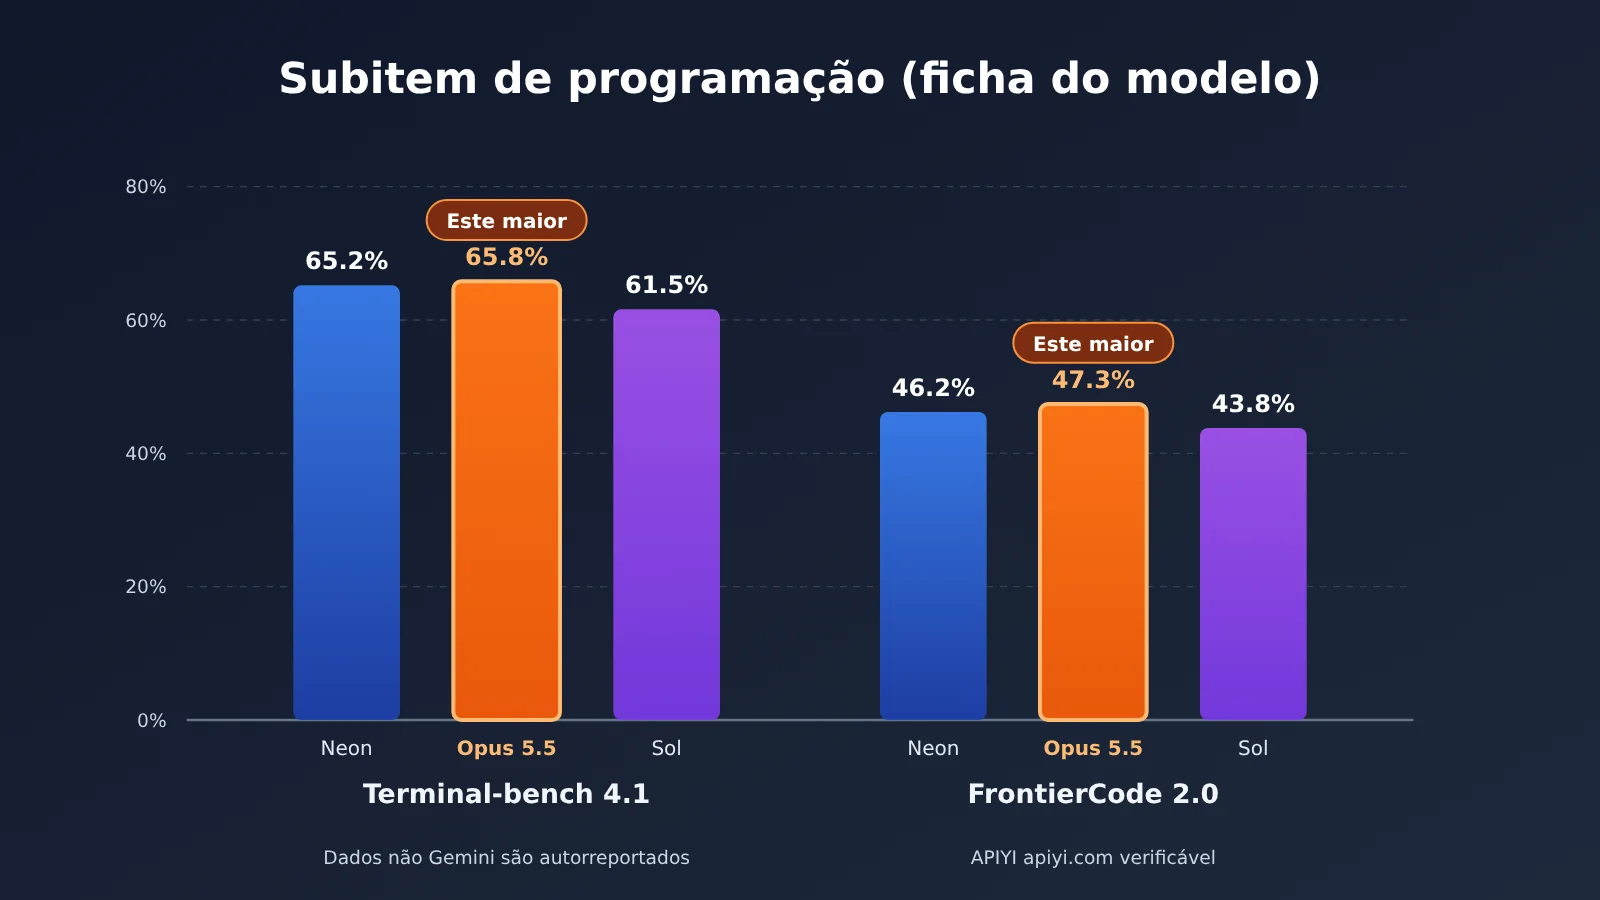
| Terminal-bench 4.1 (com ajuste de trapaça) | 65.2% | 65.8% | 61.5% |
| FrontierCode 2.0 | 46.2% | 47.3% | 43.8% |
| SWE-sweep harness do fabricante | 39.0% | 10.1% | 8.3% |
| SWE-sweep harness mini-SWE | 12.8% | 3.6% | 11.6% |
Como ler os números de programação do Gemini 4 Neon
No Terminal-bench 4.1, o Opus 5.5 marca 65.8% e o Neon 65.2%; no FrontierCode 2.0, o Opus 5.5 fica em 47.3% e o Neon em 46.2%. As duas diferenças giram em torno de um ponto percentual, mas a direção é de leve vantagem para o Opus. No blog oficial, os 46.2% do FrontierCode 2.0 estão anotados como o nível high padrão.
Os dois números do SWE-sweep são os mais fáceis de interpretar errado. Os 12.8% são o resultado sob o harness mini-SWE, enquanto os 39.0% são o resultado dentro do Google Antigravity (o harness do fabricante). O blog oficial descreve a diferença entre os dois como um desbloqueio proporcionado pelo harness: ela reflete o papel da cadeia de ferramentas e não deve ser lida como se o modelo em si tivesse um desempenho três vezes maior. Vale notar também que, sob o harness mini-SWE, o Sol fica em 11.6%, bem próximo dos 12.8% do Neon.
Gemini 4 Neon em trabalho de conhecimento: liderança na maioria dos casos, Chartography é onde o Sol se sai melhor
Nesta área de trabalho de conhecimento, o blog oficial listou vários “1º lugar”. O Legal Research Bench e o Tax Agent Bench são ambos declarados em 1º lugar, mas o blog não fornece as porcentagens desses dois itens; no Surge, as tarefas de finanças, contabilidade, modelagem de planilhas e restrições complexas também são declaradas em sua maioria em 1º lugar, novamente sem pontuações item a item. Esses dados só podem ser registrados como rankings autodeclarados oficiais; este artigo não complementa os números.
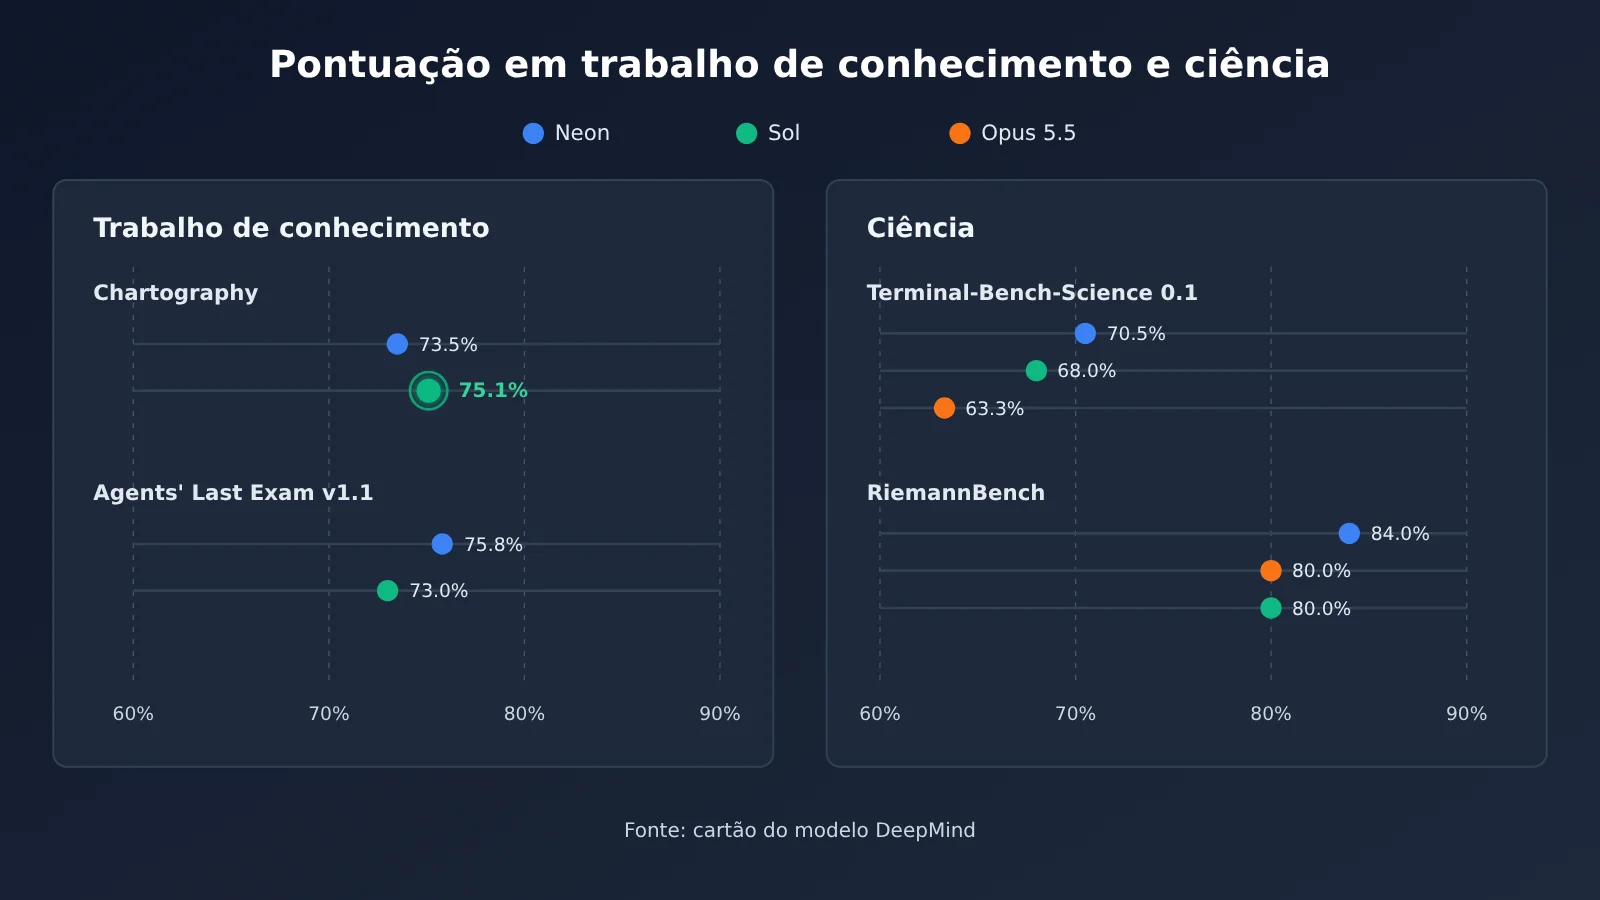
Os itens com pontuação podem ser comparados com o cartão do modelo. O Zapier AutomationBench no blog oficial é 1º lugar, 56,3%, e o Andon Labs Vending-Bench 2 é 1º lugar, 16.843 dólares. O Chartography é o único item deste bloco em que o Sol é superior: Sol 75,1%, Neon 73,5%.
Medições de terceiros trazem mais detalhes. Um artigo da Artificial Analysis mostra que, no GDP.pdf, o Neon high fica em 33,4%, enquanto o Neon xhigh cai para 28,0%, e o Carbon high fica em 28,4%, o que indica que aumentar o nível de raciocínio nem sempre resulta em pontuação maior. No AA-Briefcase, o Neon xhigh tem pontuação total de 1700 Elo e qualidade de apresentação de 1771 Elo, acima dos 1726 do Claude Sonnet 5.5 max. No item MKA, o artigo da Artificial Analysis registra o Neon em 56%, próximo dos 57% do Fable max e 2 pontos acima do Carbon; o cartão do modelo registra 56,5%, e cada número é mantido como está.
Capacidades científicas do Gemini 4 Neon: três resultados que a própria Google chama de “best in class”
Entre as três áreas, a ciência é aquela em que a comunicação oficial é mais enfática. O blog do Google afirma que Terminal-Bench Science (70.5%), RiemannBench (84.0%) e HLE-Diamond (71.3%) são best in class nos três benchmarks — dados divulgados pela própria empresa. A tabela comparativa do model card bate com isso: nos três itens, o Neon fica acima do Opus 5.5 e do Sol, mas a coluna de comparação também é uma compilação de números divulgados por cada fabricante.
| Itens de conhecimento e ciência (model card) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AutomationBench | 56.3% | 42.5% | 41.3% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% | 73.0% |
| Chartography | 73.5% | 66.3% | 75.1% |
| LVBench | 89.0% | 83.7% | 87.6% |
| GraphWalks (256k–1M, BFS F1) | 95.2% | 66.8% | 80.1% |
| MKA Climb WSR | 56.5% | 53.0% | 52.7% |
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% | 68.0% |
| HLE-Diamond | 71.3% | 67.9% | 64.0% |
No GraphWalks, os 95.2% no intervalo de contexto longo de 256k a 1M ficam bem à frente dos 66.8% do Opus 5.5 — vale ficar de olho nesse número em cenários que exigem ler materiais muito longos. Já no Terminal-Bench-Science, o Sol marca 68.0%, apenas 2.5 pontos percentuais atrás dos 70.5% do Neon — é a menor diferença entre os três itens científicos.
Gemini 4 Neon por tarefa: uma tabela consolidada
Juntando os três blocos e organizando conforme três cenários — “oficial diz que é primeiro”, “model card mostra rival maior” e “terceiros lideram por apenas 1 ponto” —, chegamos à tabela por tarefa abaixo. Ela não responde quem é o mais forte no geral; apenas mostra em qual evidência cada tipo de tarefa se apoia.
| Tipo de tarefa | Oficial autodeclarado em 1º | Model card: rival maior | Terceiros: diferença de 1 ponto |
|---|---|---|---|
| Programação | Coding Agent Index 58.6, 1º no geral | Terminal-bench 4.1, FrontierCode 2.0: Opus 5.5 é maior | Coding Agent Index 59 contra Fable xhigh e Opus 5.5 max com 58 |
| Trabalho de conhecimento | Legal Research Bench, Tax Agent Bench, AutomationBench, Vending-Bench 2 | Chartography: Sol é maior | MKA 56% contra Fable max 57% (Neon 1 ponto abaixo) |
| Ciência | Terminal-Bench Science, RiemannBench, HLE-Diamond | Nenhum | Sem pontuação científica de terceiros separada |
| Entrada agregada | Vals Index 2º (70.9%) | Nenhum | AA pontuação de inteligência 61, 1 ponto acima de Carbon high |
Análise de prós e contras do Gemini 4 Neon
Vantagens
- Liderança consistente nas três métricas científicas: tanto o relatório oficial quanto o model card mostram Terminal-Bench Science, RiemannBench e HLE-Diamond acima dos dois modelos de comparação.
- Forte leitura de contexto longo: o model card do GraphWalks mostra BFS F1 de 95.2% na faixa de 256k–1M, correspondendo a uma janela unificada de 1 milhão de tokens.
- Amplificação evidente pela cadeia de ferramentas: o SWE-sweep atinge 39.0% sob o harness do fabricante, indicando ganho considerável ao usar ambientes de agente como o Antigravity.
- Entradas multimodais completas: o model card indica suporte a entradas de texto, imagem, áudio e vídeo; a página do modelo no Artificial Analysis mostra que a entrada do Opus 5.5 é apenas texto e imagem.
Limitações
- Programação não é primeiro item a item: no Terminal-bench 4.1 e no FrontierCode 2.0, o Opus 5.5 é ligeiramente maior; para tarefas puramente de terminal ou de código de ponta, recomenda-se testar os dois.
- Compreensão de gráficos tem rival maior: no Chartography, o Sol é maior; em tarefas de relatórios com muitos gráficos, vale incluir o Sol na comparação.
- Nível mais alto não garante pontuação maior: no artigo do Artificial Analysis, o xhigh do GDP.pdf é inferior ao high; o nível de raciocínio precisa ser ajustado por tarefa.
- Restrições de parâmetros mais rígidas: o guia do desenvolvedor indica que passar
thinking_budgetouMINIMALretornaHTTP 400; o cache de contexto explícito não é suportado, usando-se apenas o cache implícito de prefixo compartilhado acima de 4096 tokens.
Sobre preço e velocidade, este artigo deixa apenas uma frase: a comparação do custo por tarefa com o Carbon tem critérios diferentes — o Google autodeclara 32% menor, e o artigo do Artificial Analysis cerca de 17% menor —, deixando o detalhamento para um artigo dedicado à precificação; o tempo e a velocidade de saída de cada nível de raciocínio ficam para o artigo dedicado à velocidade.
Início rápido com Gemini 4 Neon: primeiro defina a tarefa, depois o nível de raciocínio
A ordem sugerida para começar tem três passos: primeiro escolha o tipo de tarefa conforme a tabela geral acima, depois defina o nível de raciocínio e, por fim, confira na tabela geral do APIYI se os modelos da família Gemini 4 já disponíveis atendem às suas necessidades.
- Escolha o tipo de tarefa: raciocínio científico e leitura de materiais longos são os pontos fortes do Neon; para programação em terminal e compreensão de gráficos, inclua também o Opus 5.5 ou o Sol entre os candidatos.
- Escolha o nível de raciocínio: o guia do desenvolvedor informa que o Neon tem apenas quatro níveis —
low,medium,highexhigh— comhighcomo padrão. A página do modelo no Artificial Analysis mostra pontuações de inteligência de 44, 55, 60 e 61 para os quatro níveis; dehighparaxhigha diferença é de apenas 1 ponto, e no GDP.pdf ohighé na verdade mais alto. Por isso, na maioria das tarefas basta começar pelo nível padrão. - Confira os modelos disponíveis: para tarefas de orquestração, dá para seguir a abordagem do guia do desenvolvedor — entregue o controle principal a um modelo forte e as subtarefas rápidas ao
gemini-4-hydrogen; para as tarefas de longo prazo mais difíceis, use ogemini-4-carbon.
Sobre os endereços de chamada: na interface compatível com OpenAI, defina o base_url como https://api.apiyi.com/v1; na interface nativa do Gemini, use https://api.apiyi.com e selecione a versão v1beta. Leia a chave de uma variável de ambiente, por exemplo APIYI_API_KEY, e nunca escreva a chave em texto puro no código. Na chamada, basta preencher model com gemini-4-carbon ou gemini-4-hydrogen — os endpoints dos dois na tabela geral do APIYI são chat e gemini.
A tabela abaixo reúne os modelos que servem de comparação, com base na tabela geral do APIYI atualizada em 2026-11-16 (docs.apiyi.com/models.md) e na interface de preços consultada em 2026-11-19 (api.apiyi.com/api/pricing, 285 modelos no total); a unidade é dólar por milhão de tokens.
| ID do modelo | Entrada | Leitura de cache | Saída | Plataformas disponíveis |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | Tabela geral do APIYI, interface de preços |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | Tabela geral do APIYI, interface de preços |
claude-opus-5-5 |
4 | 0.2 | 20 | Tabela geral do APIYI, interface de preços |
gpt-6.2-sol |
2 (3 para entradas acima de 272000 tokens) | 0.1 | 10 (cerca de 11.25 no nível alto da interface de preços) | Tabela geral do APIYI, interface de preços |
O 2/10 do gemini-4-carbon é o preço atual de prateleira do APIYI, correspondente ao preço de introdução do Google até 2026-11-30. O Gemini 4 Neon está listado na página de preços do Google AI Studio por 3,00 de entrada e 15,00 de saída em dólares por milhão de tokens, sem faixa gratuita; ele ainda não aparece nem na tabela geral do APIYI nem na interface de preços. Ainda não está disponível na plataforma, mas vamos disponibilizá-lo o quanto antes; modelos e preços seguem a lista de modelos da plataforma.
🚀 Dica de início: antes de o Neon ser disponibilizado, você pode usar a mesma chave no APIYI apiyi.com para chamar
gemini-4-carbon,claude-opus-5-5egpt-6.2-solseparadamente, rodando suas próprias tarefas de programação ou de relatórios em cada um, para descobrir quais tipos de tarefa realmente exigem capacidade no nível do Neon.
Perguntas frequentes (FAQ)
Q1: Qual é o posicionamento do modelo Gemini 4 Neon?
É a faixa intermediária da família Gemini 4, lançada pelo Google em 18/11/2026 e adaptada a partir do Carbon. O guia do desenvolvedor a coloca entre o Hydrogen e o Carbon, e o blog oficial diz que ela é voltada para fluxos de trabalho complexos e de alta frequência. O ID do modelo é `gemini-4-neon`.
Q2: Com pontuação geral 61, em que posição o Gemini 4 Neon fica?
O artigo da Artificial Analysis mostra 61 pontos na faixa xhigh e 3º lugar geral, atrás do GPT-6.2 Astra (max) e do Claude Fable 5.2 (max). Os 61 pontos do blog do Google e do model card batem com esse número, mas a pontuação geral serve apenas como porta de entrada — os subescores precisam ser avaliados conforme a tarefa.
Q3: O Coding Agent Index é 58.6 ou 59?
Os dois estão certos, mas vêm de fontes diferentes. 58.6 é o número do blog do Google (autorrelatado pela própria empresa), e 59 é o número medido pela Artificial Analysis ao testar o Neon xhigh no Antigravity CLI. Não se deve combiná-los nem tirar a média entre eles.
Q4: O 12.8% e o 39.0% do SWE-sweep diferem tanto assim — o que isso indica?
São resultados de dois harnesses distintos: 12.8% vem do mini-SWE harness e 39.0% vem do Google Antigravity. O blog oficial atribui a diferença ao efeito desbloqueador do harness, então na hora de escolher o modelo você deve olhar para o ambiente de agente que realmente usa.
Q5: Em quais itens os concorrentes superam o Gemini 4 Neon?
No model card, o Claude Opus 5.5 fica um pouco acima no Terminal-bench 4.1 e no FrontierCode 2.0, e o GPT-6.2 Sol fica um pouco acima no Chartography. No artigo da Artificial Analysis, o MKA do Fable max é 57%, acima dos 56% do Neon.
Q6: Já é possível chamar o Gemini 4 Neon via API?
Do lado do Google, ele já foi lançado no Gemini API do AI Studio e em outros canais. A tabela geral e a interface de preços da APIYI apiyi.com ainda não têm `gemini-4-neon` — ele ainda não está disponível na plataforma, mas vamos colocá-lo no ar o quanto antes; modelo e preço devem seguir a lista de modelos da plataforma.
Q7: Antes do lançamento, quais modelos posso usar como alternativa para testes?
Você pode chamar `gemini-4-carbon` ou `gemini-4-hydrogen` na APIYI apiyi.com pelo endereço compatível com OpenAI `https://api.apiyi.com/v1`. A mesma chave ainda permite alternar para `claude-opus-5-5` e `gpt-6.2-sol` para comparações lado a lado. Novos usuários ganham cota gratuita de teste.
Q8: Quais são as restrições de chamada do Gemini 4 Neon?
O guia do desenvolvedor especifica: existem apenas quatro níveis de pensamento, de `low` a `xhigh`; passar `thinking_budget` ou `MINIMAL` retorna `HTTP 400`; não há suporte a cache de contexto explícito; o limite unificado é de 1048576 tokens, incluindo entrada e saída, e cada segmento tem no máximo 65536 tokens de saída por padrão.
Pontos-chave do Gemini 4 Neon (Key Takeaways)
- A pontuação agregada é só o ponto de partida: a pontuação de inteligência AA de 61 e o 3º lugar batem em três fontes, mas a escolha do modelo ainda precisa ser feita tarefa por tarefa.
- Na programação, dois itens foram superados: no model card, Terminal-bench 4.1 e FrontierCode 2.0 são ligeiramente maiores no Opus 5.5.
- Na programação, vantagem de 1 ponto em avaliação de terceiros: Coding Agent Index 59 contra 58 do Fable xhigh e do Opus 5.5 max.
- No trabalho de conhecimento, lidera na maioria: no Chartography o Sol é maior, e a vantagem de contexto longo no GraphWalks é a mais evidente.
- Nas três áreas científicas, a fabricante afirma ser best in class: no comparativo do model card também lidera, mas os dados dos concorrentes são autodeclarados por cada empresa.
- O nível de raciocínio começa em high: a diferença de pontuação de inteligência entre high e xhigh é de apenas 1, e no GDP.pdf o high é maior.
- Para começar, teste os modelos já disponíveis: antes do lançamento do Neon, dá para usar Carbon e Hydrogen no APIYI apiyi.com e rodar as tarefas primeiro.
Resumo
Quão forte é o Gemini 4 Neon? Fica bem mais claro olhando por três blocos separados:
- Programação: a fabricante autodeclara o primeiro lugar no Coding Agent Index, terceiros apontam vantagem de apenas 1 ponto e, no model card, o Opus 5.5 é ligeiramente maior em dois itens.
- Trabalho de conhecimento: lidera na maioria, como AutomationBench e o GraphWalks de contexto longo; no Chartography, o Sol é maior.
- Ciência: nas três, a fabricante afirma best in class e o comparativo do model card confirma a liderança — é o bloco com as evidências mais consistentes dos três.
A sugestão é primeiro classificar sua tarefa em uma dessas categorias e depois conferir a tabela geral deste artigo para decidir se você precisa do Neon. Antes do lançamento, dá para usar o APIYI apiyi.com e chamar Gemini 4 Carbon, Hydrogen, além de Opus e Sol, por uma interface unificada e fazer o comparativo; quando o gemini-4-neon estiver disponível, basta trocar o ID do modelo e repetir o teste.
📚 Referências
-
Blog do Google – Introducing Gemini 4 Neon: Post oficial de lançamento e pontuações autorreportadas
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Descrição: Rankings, pontuações de programação e ciência autorreportadas oficialmente
- Link:
-
Model Card do DeepMind – Gemini 4 Neon: Tabela comparativa de três colunas e especificações do modelo
- Link:
deepmind.google/models/model-cards/gemini-4-neon/ - Descrição: Pontuações item por item de Neon, Opus 5.5 e Sol; resultados que não são do Gemini vêm, por padrão, dos autorrelatos de cada empresa
- Link:
-
Guia do Desenvolvedor do Google Cloud – Gemini 4 Neon: Parâmetros e restrições de invocação
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Descrição: Níveis de raciocínio, limite de tokens, cache e códigos de erro
- Link:
-
Artigo do Artificial Analysis – Gemini 4 Neon intelligence gain: Medição de terceiros
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Descrição: Coding Agent Index 59, GDP.pdf, MKA, etc.
- Link:
-
Página do modelo no Artificial Analysis – Gemini 4 Neon: Índices separados por nível de raciocínio
- Link:
artificialanalysis.ai/models/gemini-4-neon - Descrição: Comparação das pontuações de inteligência nos quatro níveis
- Link:
-
Tabela geral de modelos da APIYI: Modelos já disponíveis e preços
- Link:
docs.apiyi.com/models.md - Descrição: Modelos e preços conforme a lista de modelos da plataforma
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Fique à vontade para nos contatar pela página inicial do site APIYI; mais materiais estão disponíveis no centro de documentação em docs.apiyi.com