Nota do autor: usando como base o preço oficial do Google, este artigo destrincha as três células do Gemini 4 Neon — entrada, cache implícito e saída —, mostra que os tokens de raciocínio entram na célula de saída, que não existe faixa gratuita e que o cache explícito não é suportado, além de trazer um exemplo com tokens inteiros e o método de comparação com a tabela geral do APIYI.
Depois do lançamento do Gemini 4 Neon, em 2026-11-18, a primeira coisa que muita gente quer saber é quanto custa uma chamada sua. O “custo por tarefa” que aparece nos rankings é o resultado ponderado de uma bateria inteira de índices de avaliação — é uma coisa bem diferente da sua fatura por requisição. Este artigo abre célula por célula as três células de preço do Gemini 4 Neon: US$ 3 de entrada, US$ 0,15 de leitura de cache implícito e US$ 15 de saída, e explica em qual delas os tokens de raciocínio acabam caindo.
As informações de preço deste artigo vêm da página de preços do Google AI Studio, do guia para desenvolvedores do Google Cloud, do model card do DeepMind, do artigo e da página do modelo no Artificial Analysis, além da tabela geral e da interface de preços do APIYI. A data de verificação dos dados é 2026-11-19: cada número traz sua fonte e, onde os critérios não batem, mantivemos as duas versões.
O que você leva daqui: ao terminar a leitura, você consegue aplicar a fórmula com seus próprios números de token para calcular o custo de uma chamada do Gemini 4 Neon, sabe em qual célula um acerto de cache economiza e também como encontrar o preço de prateleira dos modelos da mesma família na tabela geral do APIYI (apiyi.com).
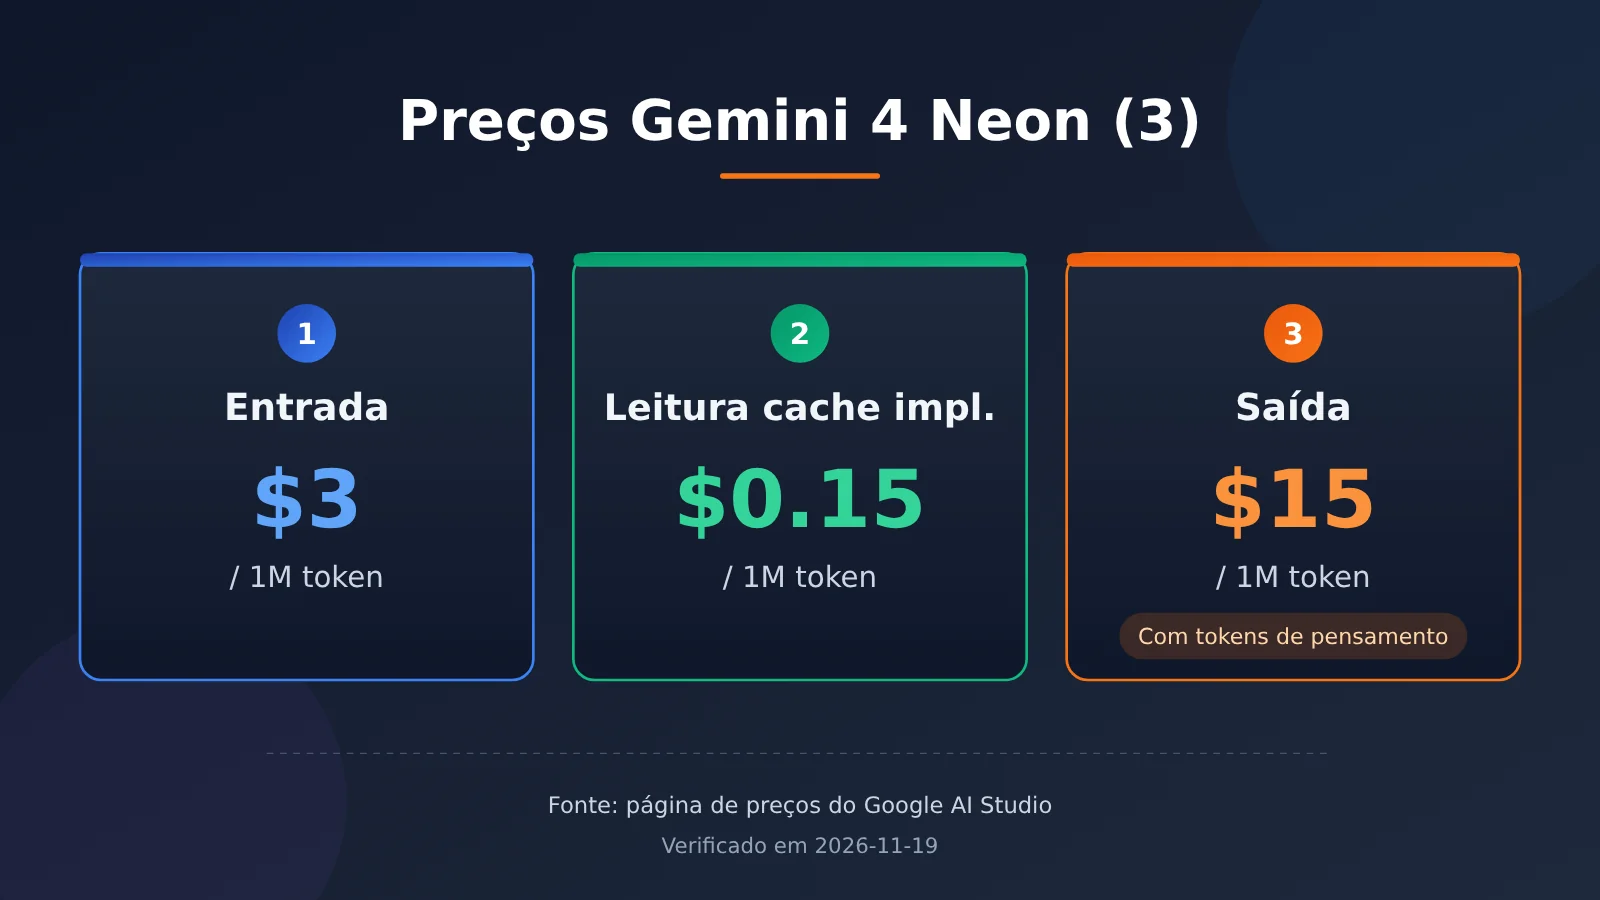
Pontos principais da precificação do Gemini 4 Neon
Vamos começar colocando as condições oficiais de preço em uma tabela. Os preços e as regras de cache da tabela abaixo vêm da página de preços do Google AI Studio e do guia do desenvolvedor do Google Cloud; os limites de contexto e de saída vêm do guia do desenvolvedor e do cartão do modelo.
| Ponto | Especificação oficial | O que significa na sua fatura |
|---|---|---|
| Entrada | US$ 3,00 por milhão de tokens (página de preços do AI Studio) | Comandos, documentos e histórico de mensagens entram todos nessa linha |
| Entrada em cache | US$ 0,15 por milhão de tokens, apenas cache implícito (página de preços do AI Studio) | O prefixo compartilhado que dá hit é cobrado a 0,15; comparado aos 3 dólares, é 95% de desconto (blog do Google, divulgação oficial) |
| Saída | US$ 15,00 por milhão de tokens, incluindo tokens de raciocínio (página de preços do AI Studio) | Quanto mais profundo o raciocínio, maior essa linha |
| Plano gratuito | Não existe plano gratuito (página de preços do AI Studio) | A cobrança começa já na primeira invocação |
| Cache explícito | Cache de contexto explícito não é suportado (guia do desenvolvedor do Google Cloud) | Não dá para criar objetos de cache manualmente, só contar com hits automáticos |
| Limite do cache implícito | Prefixos compartilhados com mais de 4096 tokens passam a valer automaticamente, cache persistente vem ativado por padrão (guia do desenvolvedor) | Comandos curtos quase nunca conseguem o preço de cache |
| Contexto | Limite unificado de 1048576 tokens, incluindo entrada e saída (guia do desenvolvedor); o cartão do modelo diz janela unificada de até 1 milhão | Em cenários com documentos longos, a linha de entrada vai pesar bastante |
Tokens de raciocínio na precificação do Gemini 4 Neon
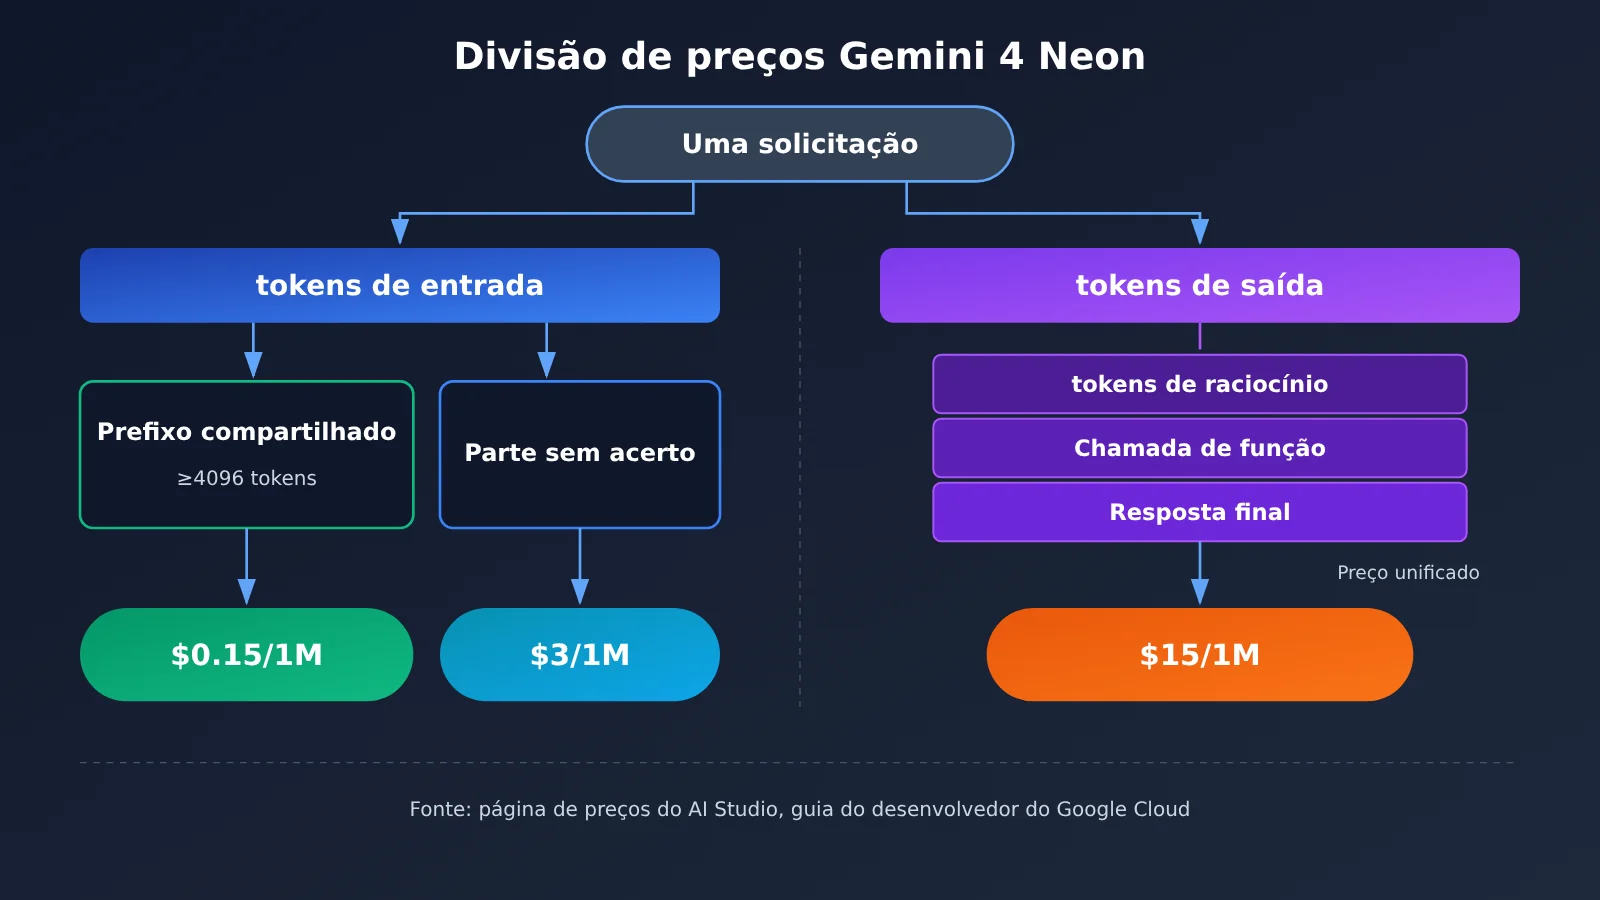
O guia do desenvolvedor do Google Cloud deixa claro que a saída é composta por três partes: raciocínio, chamadas de função e resposta final, com no máximo 65536 tokens por segmento por padrão. A página de preços do AI Studio também inclui os tokens de raciocínio na linha de saída de 15 dólares, então o número de tokens de saída que você vê na fatura costuma ser bem maior do que a resposta que você enxerga a olho nu.
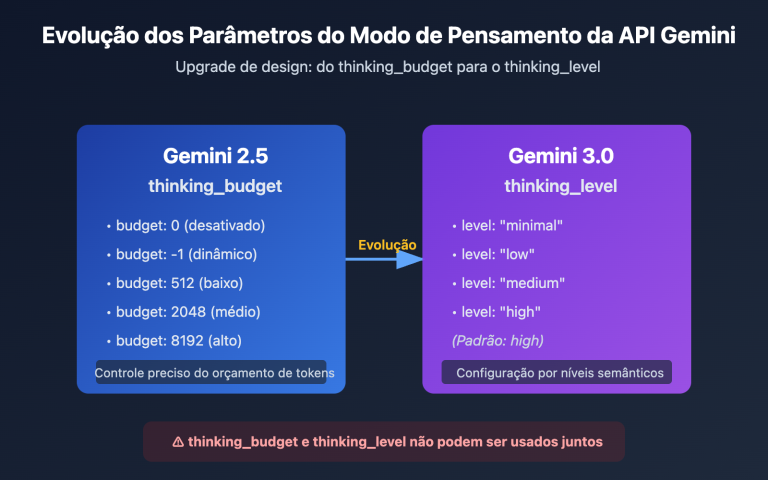
O Neon tem apenas quatro níveis de raciocínio: low, medium, high e xhigh, sendo high o padrão. O guia do desenvolvedor também avisa que passar thinking_budget ou MINIMAL retorna HTTP 400. A descrição do blog do Google (divulgação oficial) é que quanto mais alto o nível, mais profundo o raciocínio e mais tokens — e isso impacta diretamente a linha de saída.
Cache implícito na precificação do Gemini 4 Neon
O cache implícito atua sobre o trecho inicial idêntico entre requisições, como um comando de sistema fixo, o mesmo documento longo ou o mesmo conjunto de definições de ferramentas. O limite dado pelo guia do desenvolvedor é um prefixo compartilhado com mais de 4096 tokens; ao atingir isso, a cobrança passa automaticamente a ser pelo preço de cache, sem precisar de chamada extra à API.
Isso rende uma dica de escrita bem prática: coloque o conteúdo estável e imutável no início da mensagem e a pergunta do usuário que muda a cada vez no final. Quanto mais longo e estável o prefixo, maior a proporção cobrada a 0,15 dólar. O desconto de cache só vale para a linha de entrada; a linha de saída é sempre cobrada a 15 dólares.
Preços do Gemini 4 Neon e como o preço unitário se compara ao Carbon e ao Hydrogen
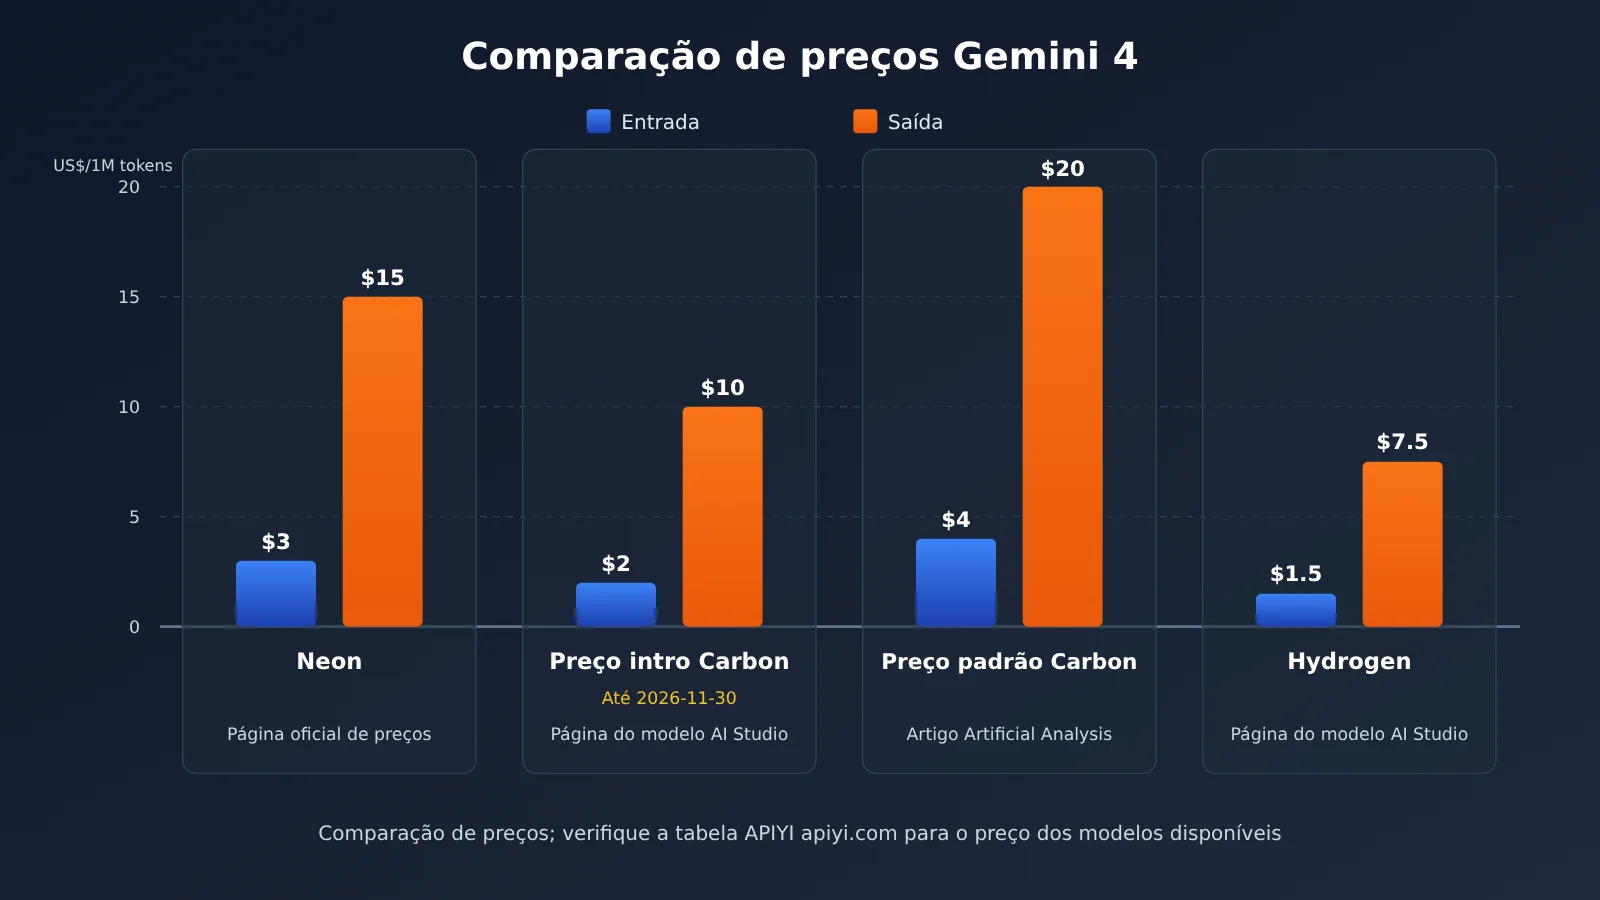
O Neon fica no meio da família, entre o Hydrogen e o Carbon. Segundo o blog do Google, o Carbon assume as tarefas de longa duração mais difíceis, o Hydrogen dá conta da execução rápida do dia a dia e o Neon faz o meio de campo, voltado a fluxos complexos de alta frequência. Os preços unitários seguem essa mesma ordem, mas o Carbon tem uma tabela de preço de lançamento e outra de preço padrão — é preciso olhar cada uma separadamente.
| Modelo | Entrada / 1M | Saída / 1M | Base do preço e fonte |
|---|---|---|---|
| Gemini 4 Neon | US$ 3.00 | US$ 15.00 | página de preços do AI Studio, valor oficial de tabela |
| Gemini 4 Carbon (preço de lançamento) | US$ 2.00 | US$ 10.00 | página dos modelos mais recentes do AI Studio, válido até 2026-11-30 |
| Gemini 4 Carbon (preço padrão) | US$ 4 | US$ 20 | preço padrão citado no artigo da Artificial Analysis |
| Gemini 4 Hydrogen | US$ 1.50 | US$ 7.50 | página dos modelos mais recentes do AI Studio |
Com base nisso, o artigo da Artificial Analysis apresenta duas comparações: o 3/15 do Neon fica 25% abaixo do preço padrão do Carbon, que é 4/20; já em relação ao valor promocional de 2/10 do Carbon, válido até 30 de novembro, o Neon sai 50% mais caro. As duas contas batem — a diferença está só em qual tabela de preço do Carbon se usa como referência.
O desconto de cache também aparece em duas versões. A página de modelo da Artificial Analysis indica 95% de desconto de cache para o Neon e 90% para o Carbon. Na tabela geral da APIYI, a leitura de cache do gemini-4-carbon é de US$ 0.1, o que corresponde a 5% dos US$ 2 de entrada. Os dois números vêm de páginas diferentes; este artigo os reproduz como estão, sem convertê-los para uma base comum.
Precificação do Gemini 4 Neon: início rápido
Vamos seguir quatro passos: primeiro aplicar as três categorias oficiais, depois estimar o impacto do nível de raciocínio sobre a saída, em seguida conferir na tabela geral do APIYI os modelos já listados da mesma família e, por fim, confirmar o status de listagem do próprio Neon.
Passo 1: calcular uma chamada com as três categorias oficiais
A fórmula é simples: custo de entrada = tokens de entrada sem cache hit ÷ 1 milhão × 3; custo de cache = tokens de entrada com cache hit ÷ 1 milhão × 0,15; custo de saída = tokens de saída (incluindo raciocínio) ÷ 1 milhão × 15. A soma dos três é o custo desta requisição.
- Exemplo sem cache: entrada de 1.000.000 tokens, saída de 100.000 tokens. Entrada 1.000.000 ÷ 1.000.000 × 3 = 3 dólares, saída 100.000 ÷ 1.000.000 × 15 = 1,5 dólares, total 4,5 dólares.
- Exemplo com cache hit: a mesma entrada de 1.000.000 tokens, dos quais 800.000 tokens são prefixo compartilhado com hit. A parte com hit: 800.000 ÷ 1.000.000 × 0,15 = 0,12 dólares; os 200.000 tokens sem hit ficam em 0,6 dólares; a saída continua 1,5 dólares, total 2,22 dólares.
- Mesma quantidade de tokens trocando para o preço de introdução do Carbon: 1.000.000 × 2 mais 100.000 × 10, total 3 dólares; trocando para o preço padrão do Carbon 4/20, total 6 dólares; trocando para o Hydrogen 1,5/7,5, total 2,25 dólares.
Vale notar que, para uma mesma tarefa, modelos diferentes geram quantidades de tokens diferentes. O artigo do Artificial Analysis menciona que, em uma única tarefa, o Neon gera cerca de 15% mais tokens de saída que o Carbon; por isso, a comparação por mesma quantidade de tokens só mostra a diferença de preço unitário — a fatura real ainda precisa multiplicar pelo uso de tokens de cada um.
Segundo passo: estimar quanto o nível de raciocínio eleva a cota de saída
O nível de raciocínio determina o tamanho da cota de saída. O blog do Google (divulgação oficial da própria empresa) só diz que, quanto mais alto o nível, mais tokens são gerados — não informa o número exato de tokens por nível. A página do modelo no Artificial Analysis traz o tempo por tarefa para completar o índice em cada nível, o que serve como evidência indireta de que “quanto mais profundo o raciocínio, mais longo o processo”.
| Nível de raciocínio | É o padrão? | Tempo por tarefa (página do modelo no Artificial Analysis) | Velocidade de saída |
|---|---|---|---|
low |
Não | 3.7 minutos | 97 token/s |
medium |
Não | 8.3 minutos | 101 token/s |
high |
Sim (guia do desenvolvedor) | 14.8 minutos | 101 token/s |
xhigh |
Não | 21.5 minutos | 110 token/s |
No exemplo de cálculo do primeiro passo, se ao subir o nível de raciocínio a saída passar de 100000 tokens para 200000 tokens, a cota de saída vai de 1.5 dólares para 3 dólares. Quanto aumenta na prática depende da sua tarefa; a recomendação é rodar vários níveis com seus próprios comandos e olhar o campo usage retornado antes de definir o nível padrão.
Terceiro passo: comparar com modelos da mesma família na tabela geral do APIYI
Abra a tabela geral do APIYI em docs.apiyi.com/models.md (página marcada como atualizada em 2026-11-16 09:39, UTC+8) ou consulte a interface de preços api.apiyi.com/api/pricing (consulta em 2026-11-19, versão shell-api-modelmak-v1, 285 modelos no total) para ver o preço de prateleira dos modelos já listados da família Gemini 4.
| ID do modelo | Entrada / 1M | Leitura de cache / 1M | Saída / 1M | Endpoint | Plataformas disponíveis |
|---|---|---|---|---|---|
gemini-4-carbon |
2 dólares | 0.1 dólar | 10 dólares | chat, gemini | APIYI apiyi.com |
gemini-4-hydrogen |
1.5 dólares | 0.075 dólar | 7.5 dólares | chat, gemini | APIYI apiyi.com |
gemini-4-neon |
— | — | — | — | Não listado nem na tabela geral nem na interface de preços |
Na tabela geral do APIYI, os valores 2/0.1/10 do gemini-4-carbon são o preço de prateleira atual, que corresponde ao preço promocional do Google válido até 2026-11-30 — não é o mesmo conjunto do preço padrão 4/20. Quanto aos grupos, a tabela geral traz Default e SVIP, enquanto a interface de preços traz default e svip. A página do modelo também informa contexto de 1048576, saída máxima de 65536 e corte de conhecimento em 2026-03.
A interface de preços representa o preço por meio de multiplicadores: model_ratio igual a 1 corresponde a 2 dólares por milhão de tokens de entrada, e completion_ratio igual a 5 significa que a saída custa 5 vezes a entrada. Nessa conversão, um modelo com entrada 2 e saída 10 corresponde a 1 e 5, o que bate com a primeira faixa da tabela geral.
Etapa 4: confirmar o status de disponibilidade do Gemini 4 Neon
O gemini-4-neon não aparece na tabela geral da APIYI nem na interface de preços, e também não tem uma página de modelo independente. Ainda não foi disponibilizado; vamos publicar esse modelo o mais rápido possível. Modelos e preços devem ser consultados na lista de modelos da plataforma.
Enquanto isso, você pode usar o gemini-4-carbon ou o gemini-4-hydrogen, que já estão disponíveis, para validar todo o fluxo de invocação. A forma de chamada é a seguinte:
- Interface compatível com OpenAI: defina
base_urlcomohttps://api.apiyi.com/v1e preenchamodelcomgemini-4-carbon. - Interface nativa do Gemini: use o endereço
https://api.apiyi.come preencha a versão da API comv1beta. - Leia a chave de uma variável de ambiente, por exemplo
api_key=os.environ["APIYI_API_KEY"]; não coloque a chave em texto claro no código. - Depois que a requisição retornar, leia em
usageos números de tokens de entrada, de acerto de cache e de saída, e aplique a fórmula da Etapa 1 para conferir o custo.
🚀 Início rápido: ao se registrar na APIYI apiyi.com você pode receber créditos de teste gratuitos. Comece usando o
gemini-4-carbonpara validar a chamada ahttps://api.apiyi.com/v1e a contabilização de usage; quando o Neon for disponibilizado, basta alterar o campomodel.
As três contas de preço do Gemini 4 Neon
Além do preço unitário, o Google e a Artificial Analysis apresentaram cada um sua própria comparação de “custo por tarefa”. Esses percentuais usam critérios diferentes e não podem ser convertidos entre si.
| Versão | Número | Fonte e critério |
|---|---|---|
| O custo por tarefa do Neon no nível high padrão é menor que o do Carbon | 32% | Blog do Google, divulgação oficial, sem indicar se o Carbon usa preço de lançamento ou preço padrão |
| O custo por tarefa do Neon em xhigh é menor que o preço sem desconto do Carbon | cerca de 17% | Artigo da Artificial Analysis, Carbon pelo preço padrão de US$ 7,76 |
| Custo por tarefa do Neon high comparado ao Carbon high | menos da metade | Artigo da Artificial Analysis, com base no preço padrão do Carbon |
| Custo por tarefa do Carbon high | US$ 4,90 | Página do modelo na Artificial Analysis, com base no preço de lançamento atual da página |
Esses quatro números vêm de três contas diferentes, e os níveis e o critério de preço do Carbon também não são os mesmos. Este artigo não faz média entre 32% e 17%, nem subtrai 4,90 de 7,76. Para o seu projeto, o mais confiável é aplicar a fórmula da Etapa 1 com a sua própria contagem de tokens.
💡 Sugestão de escolha: a tabela de preços unitários só diz quanto custa cada token; quanto token uma tarefa realmente consome depende dos seus próprios testes. Você pode usar a APIYI apiyi.com para chamar o Carbon e o Hydrogen já disponíveis com o mesmo conjunto de comandos, registrar o usage e depois estimar a faixa de custo do Neon.
Perguntas frequentes (FAQ)
P1: Em quantas faixas a precificação do Gemini 4 Neon é dividida?
De acordo com a página de preços do Google AI Studio, o Gemini 4 Neon tem três faixas: entrada a US$ 3.00 por milhão de tokens, entrada em cache a US$ 0.15 e saída a US$ 15.00. Os tokens de raciocínio entram na faixa de saída; não há nível gratuito.
P2: Como fazer o cache do Gemini 4 Neon funcionar?
O guia para desenvolvedores do Google Cloud diz que apenas o cache implícito é suportado; ele funciona automaticamente para prefixos compartilhados com mais de 4096 tokens, o cache persistente fica ativado por padrão e o cache de contexto explícito não é suportado. Coloque o comando de sistema fixo e os documentos longos no início da mensagem para aumentar a taxa de acerto.
P3: O valor de US$ 6.44 no ranking é o preço de uma única requisição?
US$ 6.44 é o custo ponderado por tarefa depois que o Artificial Analysis executa seu índice de inteligência no nível xhigh; um conjunto de índices inclui muitas tarefas longas. Para um chat ou uma requisição de API, calcule usando as três faixas oficiais de acordo com os seus números de tokens de entrada, cache e saída.
P4: Quanto os níveis de raciocínio aumentam a precificação do Gemini 4 Neon?
A documentação oficial não informa a quantidade de tokens de cada nível. O guia para desenvolvedores confirma quatro níveis: `low`, `medium`, `high` (padrão) e `xhigh`; o blog do Google diz que, quanto mais alto o nível, mais tokens são usados. Recomenda-se testar os níveis nas suas próprias tarefas e usar os tokens de saída em `usage` como referência.
P5: Como consultar os preços da família Gemini 4 e fazer chamadas pela APIYI?
Abra a tabela geral do APIYI apiyi.com em `docs.apiyi.com/models.md`, ou consulte o endpoint de preços, para ver `gemini-4-carbon` (2/0.1/10) e `gemini-4-hydrogen` (1.5/0.075/7.5). Ao fazer a chamada, use o endereço compatível com OpenAI `https://api.apiyi.com/v1`. O `gemini-4-neon` ainda não está disponível; vamos disponibilizar esse modelo o mais rápido possível. Os modelos e preços devem ser confirmados na lista de modelos da plataforma.
P6: Como consultar o preço do Carbon na APIYI após 30 de novembro?
O preço de catálogo atual do Carbon na tabela geral da APIYI, 2/0.1/10, corresponde ao preço introdutório do Google até 2026-11-30. A tabela geral não indica ajustes posteriores; quando chegar a essa data, use como referência os dados em tempo real da tabela geral e do endpoint de preços do APIYI apiyi.com.
P7: Quais limitações de preço do Gemini 4 Neon merecem atenção?
São principalmente quatro pontos:
– **Sem nível gratuito**: a página de preços do AI Studio informa que a cobrança começa na primeira chamada.
– **Sem cache explícito**: só é possível contar com o acerto implícito para prefixos com mais de 4096 tokens.
– **Raciocínio entra na saída**: um único segmento tem, por padrão, no máximo 65536 tokens, e o raciocínio consome parte desse orçamento.
– **Restrições de parâmetros**: passar `thinking_budget` ou `MINIMAL` retorna HTTP `400`.
P8: Por que algumas páginas mostram um preço misto de US$ 2.21 para o Neon?
Esse é o preço único calculado pela página do modelo no Artificial Analysis com base no seu critério de preço misto, para facilitar a comparação entre modelos. A fatura real continua sendo cobrada separadamente pelas três faixas de entrada, cache e saída; ao calcular seu próprio custo, é recomendável usar diretamente os preços unitários das três faixas.
Principais pontos da precificação do Gemini 4 Neon — Key Takeaways
- Três faixas oficiais: entrada US$ 3, leitura de cache implícito US$ 0,15 e saída US$ 15, todos por milhão de tokens.
- Onde entram os tokens de raciocínio: tokens de raciocínio, chamadas de função e a resposta final contam na faixa de saída.
- Regras de cache: só existe cache implícito; prefixos compartilhados acima de 4096 tokens entram em vigor automaticamente.
- Sem plano gratuito: a página de preços do AI Studio deixa claro que o Neon não tem plano gratuito.
- Exemplo com números inteiros: 1 milhão de entrada mais 100 mil de saída dá US$ 4,5; após 800 mil acertos de cache, fica US$ 2,22.
- Carbon com dois conjuntos de preços: preço de introdução 2/10 até 2026-11-30, e o preço padrão 4/20 vem do artigo da Artificial Analysis.
- Consulta na prateleira: confira na tabela geral da APIYI apiyi.com os preços já listados de
gemini-4-carbonegemini-4-hydrogen.
Resumo
Os pontos centrais da precificação do Gemini 4 Neon:
- Três faixas calculadas separadamente: entrada sem acerto de cache a US$ 3, acerto de cache a US$ 0,15 e saída com raciocínio a US$ 15.
- O nível de raciocínio define a faixa de saída: padrão
high; quanto mais alto o nível, mais tokens de saída e maior o custo. - Métricas diferentes, contas diferentes: os 32% do Google, os cerca de 17% da Artificial Analysis e os US$ 4,90 vêm de três bases de cálculo distintas; o custo por tarefa e a fatura da sua requisição individual também precisam ser entendidos separadamente.
Se você quer estimar o seu próprio custo, o caminho mais direto é rodar um conjunto de comandos reais para obter o usage e depois aplicar os preços das três faixas. O gemini-4-neon ainda não está listado na APIYI; vamos subir esse modelo o quanto antes; modelo e preço valem conforme a lista de modelos da plataforma. Neste momento, recomendamos usar a APIYI apiyi.com para primeiro colocar o fluxo de ponta a ponta em funcionamento com o Carbon e o Hydrogen já listados; quando o Neon entrar no ar, basta trocar o ID do modelo.
📚 Referências
-
Página de preços e página dos modelos mais recentes do Google AI Studio: preços das três faixas do Neon, plano gratuito e detalhes do cache; preço introdutório do Carbon e preço do Hydrogen
- Link:
aistudio.google.com/docs/pricing - Link:
aistudio.google.com/docs/latest-model - Observação: principal fonte dos preços unitários oficiais deste artigo
- Link:
-
Guia do desenvolvedor do Google Cloud – Gemini 4 Neon: ID do modelo, limite de contexto, níveis de raciocínio e limite do cache implícito
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Observação: origem da composição da saída e das restrições de parâmetros
- Link:
-
Blog do Google – Introducing Gemini 4 Neon: informações do lançamento e comparação de custos autodeclarada oficialmente
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Observação: origem do desconto de 95% no cache e do custo por tarefa 32% menor
- Link:
-
Model card do DeepMind – Gemini 4 Neon: janela de contexto, limite de saída e corte de conhecimento
- Link:
deepmind.google/models/model-cards/gemini-4-neon - Observação: referência das especificações do modelo
- Link:
-
Artigo e página do modelo do Artificial Analysis: custo por tarefa medido por terceiros, tempo de cada faixa e preço padrão do Carbon
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Link:
artificialanalysis.ai/models/gemini-4-neon - Observação: o artigo e a página do modelo usam critérios diferentes e devem ser citados separadamente
- Link:
-
Tabela geral e interface de preços da APIYI: preço de prateleira e multiplicador dos modelos já disponíveis
- Link:
docs.apiyi.com/models.md - Observação: consulta de modelos e preços da família Gemini 4
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: fique à vontade para falar com a gente pela página inicial da APIYI em apiyi.com; mais instruções de integração estão disponíveis no centro de documentação docs.apiyi.com