作者注:按 Google 官方价拆解 Gemini 4 Neon 的输入、隐式缓存和输出三格,说明思考 token 计入输出、无免费档、不支持显式缓存,并给出整数 token 算例与 API易 总表对照方法。
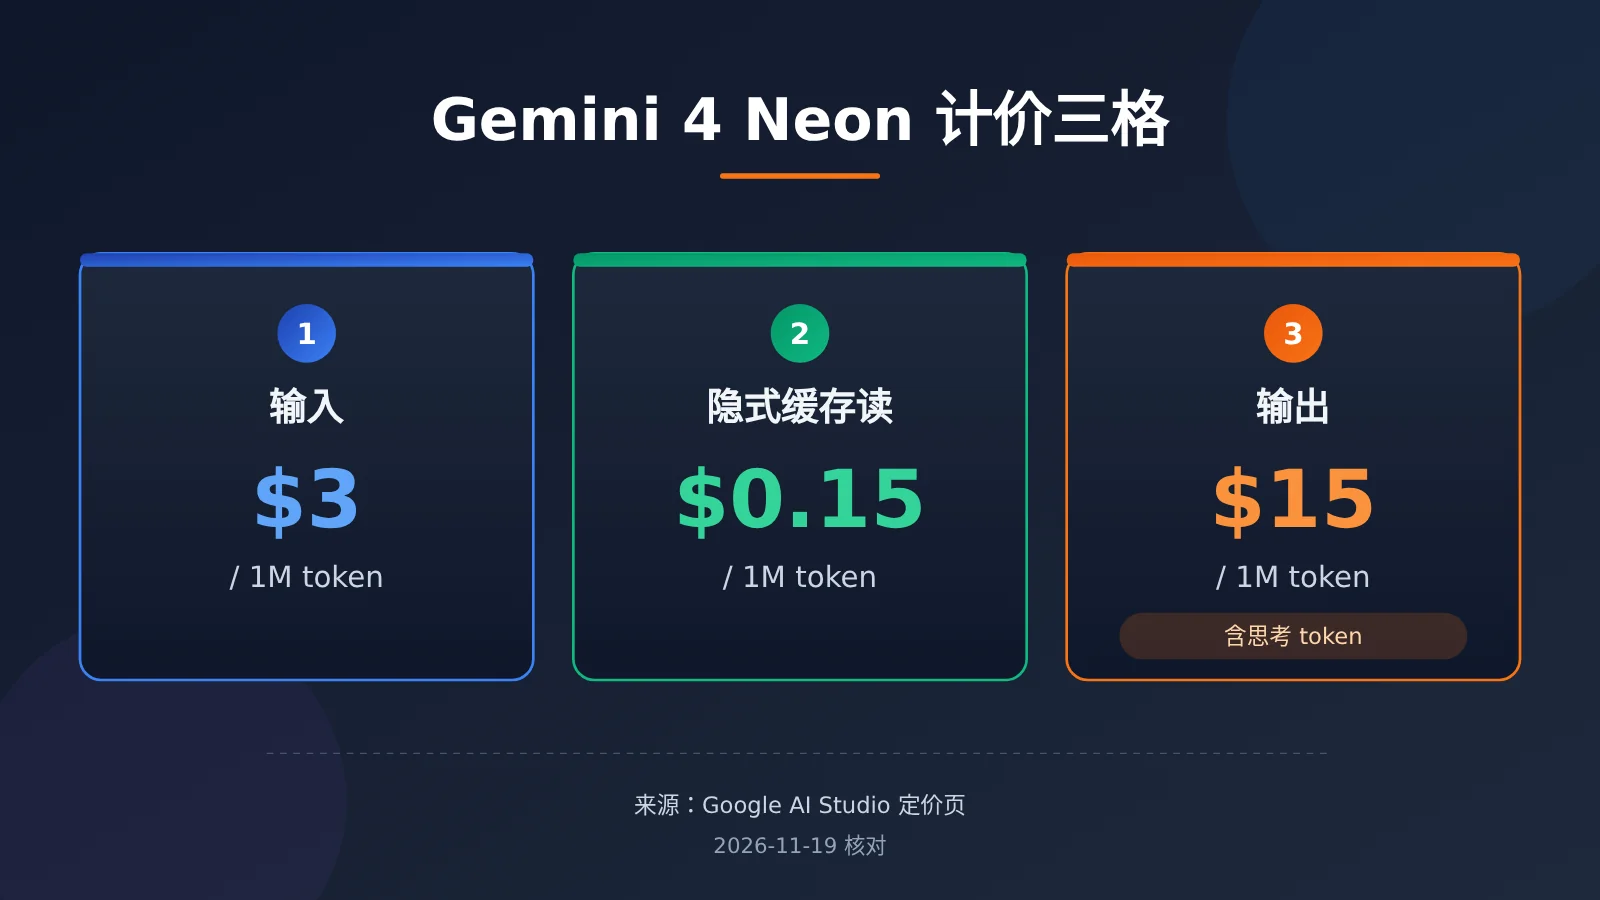
Gemini 4 Neon 在 2026-11-18 发布后,很多开发者最先要弄清的是自己的一次调用要花多少钱。榜单上的“单任务费用”是跑完一整套评测指数的加权结果,和你账单上的一次请求是两件事。本文把 Gemini 4 Neon 计价的三格:输入 3 美元、隐式缓存读 0.15 美元、输出 15 美元 逐格拆开,并说明思考 token 归到哪一格。
本文的价格信息来自 Google AI Studio 定价页、Google Cloud 开发者指南、DeepMind 模型卡、Artificial Analysis 的文章与模型页,以及 API易 总表和定价接口。数据核对日为 2026-11-19,每个数字都标明出处,口径对不上的地方两套都保留。
核心价值:读完本文,你可以用自己的 token 数套公式算出 Gemini 4 Neon 的单次费用,知道缓存命中能省在哪一格,也知道怎样在 API易 apiyi.com 的总表里查到同家族型号的货架价。
Gemini 4 Neon 计价核心要点
先把官方给出的计价条件放进一张表。下表的价格和缓存规则来自 Google AI Studio 定价页与 Google Cloud 开发者指南,上下文与输出上限来自开发者指南和模型卡。
| 要点 | 官方说明 | 对你的账单意味着什么 |
|---|---|---|
| 输入 | 每百万 token 3.00 美元(AI Studio 定价页) | 提示词、文档、历史消息都按这一格计 |
| 缓存输入 | 每百万 token 0.15 美元,只支持隐式缓存(AI Studio 定价页) | 命中的共享前缀按 0.15 计,相对 3 美元是 95% 折扣(Google 博客,官方自报) |
| 输出 | 每百万 token 15.00 美元,含思考 token(AI Studio 定价页) | 思考越深,这一格越大 |
| 免费档 | 没有免费档(AI Studio 定价页) | 从第一次调用开始计费 |
| 显式缓存 | 显式上下文缓存不支持(Google Cloud 开发者指南) | 无法手动创建缓存对象,只能依赖自动命中 |
| 隐式缓存门槛 | 4096 token 以上的共享前缀自动生效,持久缓存默认开(开发者指南) | 短提示词基本吃不到缓存价 |
| 上下文 | 统一上限 1048576 token,含输入和输出(开发者指南);模型卡写统一窗口最多 100 万 | 长文档场景输入格占比会很高 |
Gemini 4 Neon 计价中的思考 token
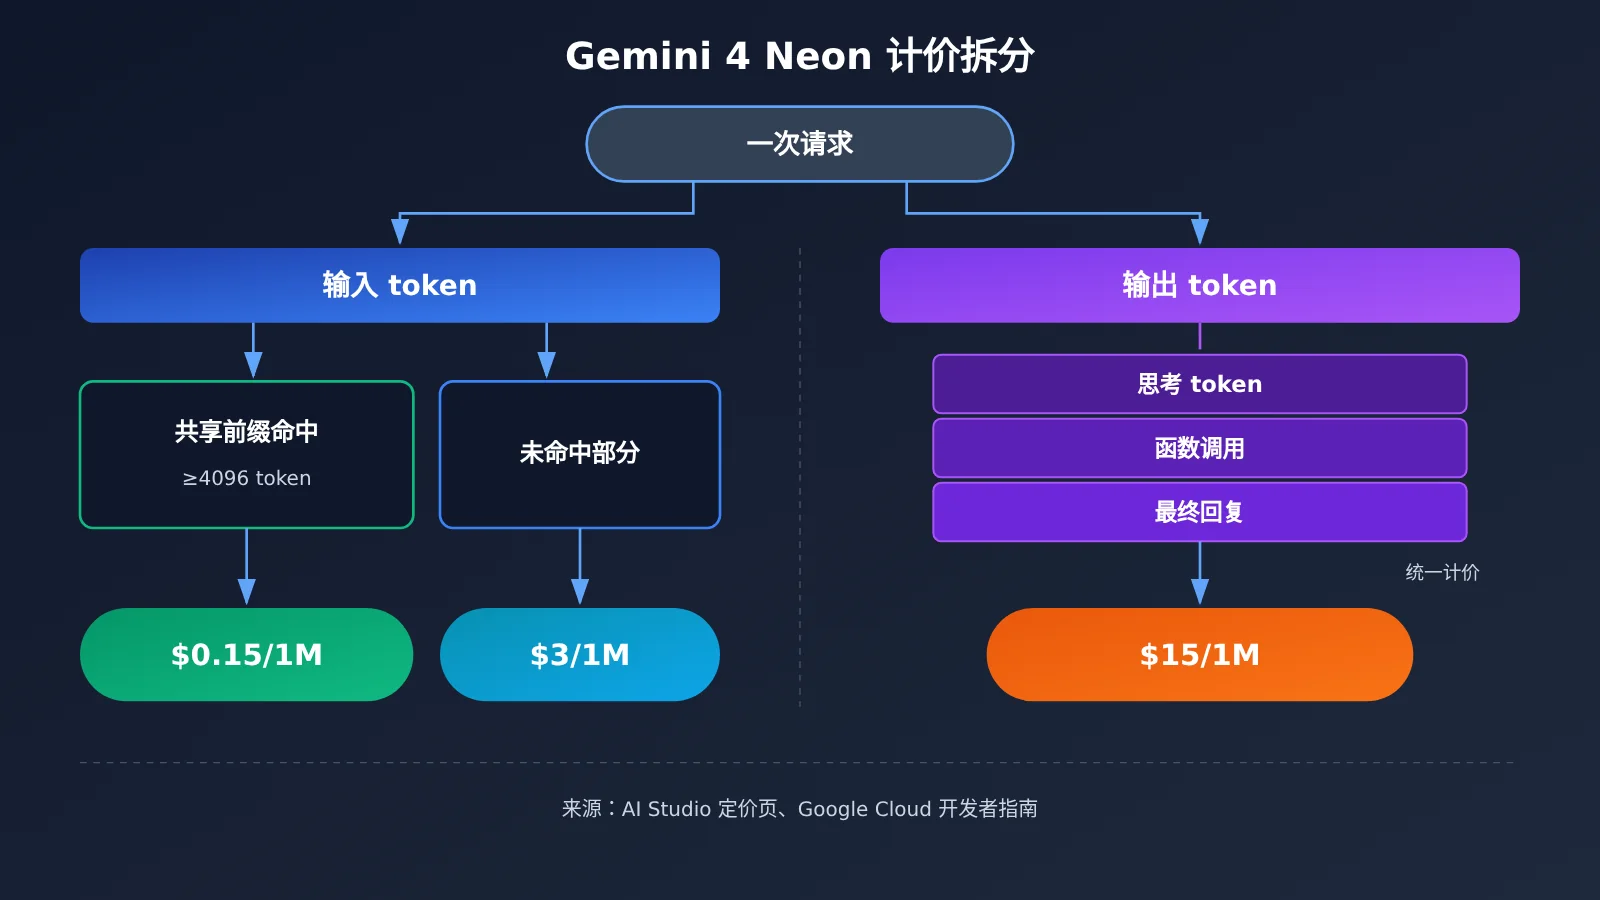
Google Cloud 开发者指南写明,输出包含思考、函数调用和最终回复三部分,单段默认最多 65536 token。AI Studio 定价页同样把思考 token 计进 15 美元的输出格,所以你在账单上看到的输出 token 数,通常会比你肉眼看到的回复长得多。
Neon 的思考档只有 low、medium、high、xhigh 四档,其中 high 是默认值。开发者指南还提醒,传 thinking_budget 或 MINIMAL 会返回 HTTP 400。Google 博客(官方自报)的描述是档位越高、思考越深、token 越多,这直接作用在输出格上。
Gemini 4 Neon 计价中的隐式缓存
隐式缓存针对的是请求之间相同的开头部分,例如固定的系统提示、同一份长文档、同一套工具定义。开发者指南给出的门槛是 4096 token 以上的共享前缀,满足后自动按缓存价结算,不需要额外调用接口。
这带来一个很实际的写法建议:把稳定不变的内容放在消息最前面,把每次变化的用户问题放在最后。前缀越长、越稳定,被按 0.15 美元计的比例就越高。缓存折扣只作用于输入格,输出格始终按 15 美元计。
Gemini 4 Neon 计价与 Carbon、Hydrogen 的单价差别
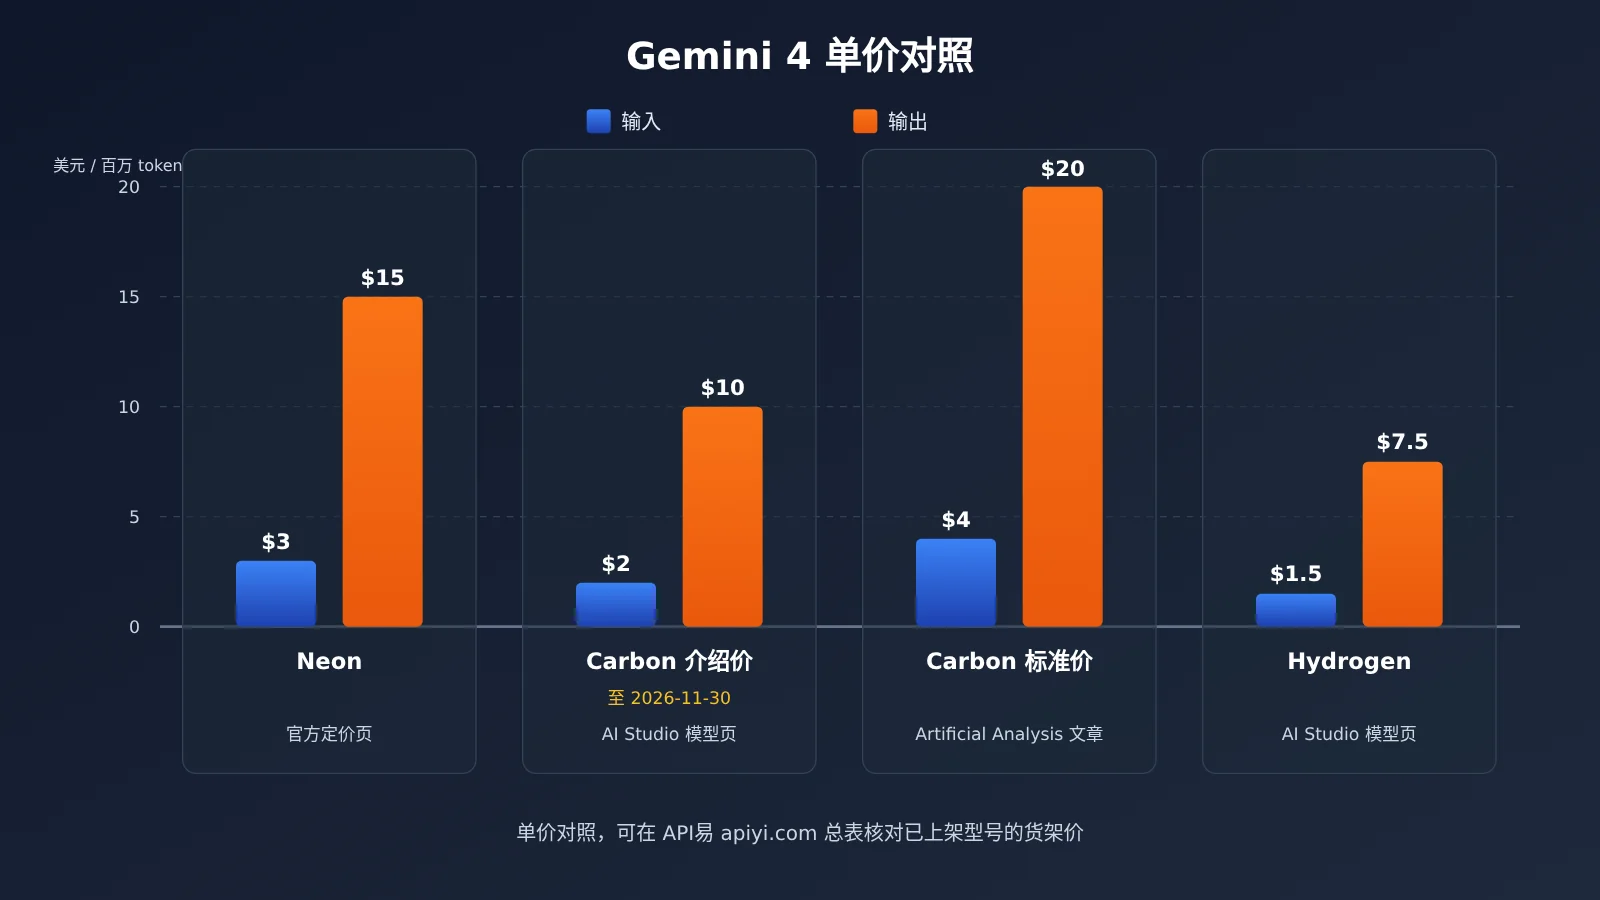
Neon 在家族里的位置介于 Hydrogen 和 Carbon 之间。Google 博客的说法是 Carbon 做最难的长程任务,Hydrogen 做日常快执行,Neon 折中,面向高频的复杂流程。单价也呈现这个顺序,但 Carbon 有一套介绍价和一套标准价,需要分开看。
| 型号 | 输入 / 1M | 输出 / 1M | 价格口径与出处 |
|---|---|---|---|
| Gemini 4 Neon | 3.00 美元 | 15.00 美元 | AI Studio 定价页,官方标价 |
| Gemini 4 Carbon(介绍价) | 2.00 美元 | 10.00 美元 | AI Studio 最新模型页,写到 2026-11-30 |
| Gemini 4 Carbon(标准价) | 4 美元 | 20 美元 | Artificial Analysis 文章引用的标准价 |
| Gemini 4 Hydrogen | 1.50 美元 | 7.50 美元 | AI Studio 最新模型页 |
Artificial Analysis 文章据此给出两个比例:Neon 的 3/15 比 Carbon 标准价 4/20 低 25%;相对 Carbon 到 11 月 30 日的折扣价 2/10,Neon 单价高 50%。两个比例都成立,差别只在拿哪一套 Carbon 价来比。
缓存折扣也有两套说法。Artificial Analysis 模型页给 Neon 标的缓存折扣是 95%,给 Carbon 标的是 90%。API易 总表里 gemini-4-carbon 的缓存读是 0.1 美元,对应输入 2 美元的 5%。这两个数来自不同页面,本文照原样列出,不做换算统一。
Gemini 4 Neon 计价快速上手
下面按四步走:先套官方三格,再估思考档对输出的影响,再去 API易 总表对照已上架的同家族型号,最后确认 Neon 本身的上架状态。
第一步:用官方三格算一次调用
算式很简单:输入费用 = 未命中输入 token ÷ 100 万 × 3;缓存费用 = 命中输入 token ÷ 100 万 × 0.15;输出费用 = 输出 token(含思考)÷ 100 万 × 15。三项相加就是这次请求的费用。
- 无缓存算例:输入 1000000 token,输出 100000 token。输入 1000000 ÷ 1000000 × 3 = 3 美元,输出 100000 ÷ 1000000 × 15 = 1.5 美元,合计 4.5 美元。
- 缓存命中算例:同样输入 1000000 token,其中 800000 token 是命中的共享前缀。命中部分 800000 ÷ 1000000 × 0.15 = 0.12 美元,未命中的 200000 token 为 0.6 美元,输出仍是 1.5 美元,合计 2.22 美元。
- 同 token 量换成 Carbon 介绍价:1000000 × 2 加 100000 × 10,合计 3 美元;换成 Carbon 标准价 4/20,合计 6 美元;换成 Hydrogen 1.5/7.5,合计 2.25 美元。
需要注意,同一任务下不同模型产生的 token 数并不相同。Artificial Analysis 文章提到 Neon 单任务的输出 token 比 Carbon 大约多 15%,所以按同 token 量的对比只能说明单价差,实际账单还要乘上各自的 token 用量。
第二步:估算思考档对输出格的拉高
思考档决定了输出格有多大。Google 博客(官方自报)只说档位越高 token 越多,没给每档的具体 token 数。Artificial Analysis 模型页给出了各档跑完指数的单任务耗时,可以作为“思考越深、过程越长”的旁证。
| 思考档 | 是否默认 | 单任务耗时(Artificial Analysis 模型页) | 输出速度 |
|---|---|---|---|
low |
否 | 3.7 分钟 | 97 token/秒 |
medium |
否 | 8.3 分钟 | 101 token/秒 |
high |
是(开发者指南) | 14.8 分钟 | 101 token/秒 |
xhigh |
否 | 21.5 分钟 | 110 token/秒 |
在第一步的算例里,如果思考档提高后输出从 100000 token 增加到 200000 token,输出格就从 1.5 美元变成 3 美元。实际增加多少,取决于你的任务,建议在自己的提示词上分别跑几档,看返回的 usage 字段再决定默认档位。
第三步:在 API易 总表对照同家族型号
打开 API易 总表 docs.apiyi.com/models.md(页面标注更新于 2026-11-16 09:39,UTC+8),或查询定价接口 api.apiyi.com/api/pricing(2026-11-19 查询,版本 shell-api-modelmak-v1,共 285 个模型),可以看到 Gemini 4 家族已上架型号的货架价。
| 模型 ID | 输入 / 1M | 缓存读 / 1M | 输出 / 1M | 端点 | 可用平台 |
|---|---|---|---|---|---|
gemini-4-carbon |
2 美元 | 0.1 美元 | 10 美元 | chat、gemini | API易 apiyi.com |
gemini-4-hydrogen |
1.5 美元 | 0.075 美元 | 7.5 美元 | chat、gemini | API易 apiyi.com |
gemini-4-neon |
— | — | — | — | 总表与定价接口均未列出 |
API易 总表里 gemini-4-carbon 的 2/0.1/10 是当前货架价,对得上 Google 到 2026-11-30 的介绍价,和标准价 4/20 不是同一套。分组方面,总表写 Default、SVIP,定价接口写 default、svip。型号页还写了上下文 1048576、最大输出 65536、知识截止 2026-03。
定价接口用倍率表示价格:model_ratio 为 1 对应输入每百万 token 2 美元,completion_ratio 为 5 表示输出是输入的 5 倍。按这个换算,输入 2、输出 10 的型号就对应 1 和 5,和总表首档一致。
第四步:确认 Gemini 4 Neon 的上架状态
gemini-4-neon 在 API易 总表和定价接口里都没有出现,也没有独立的型号页。暂未上架,我们会尽快上架这个模型;型号与价格以平台型号列表为准。
在等待期间,可以先用已上架的 gemini-4-carbon 或 gemini-4-hydrogen 打通调用链路。调用方式如下:
- OpenAI 兼容接口:把
base_url设为https://api.apiyi.com/v1,model填gemini-4-carbon。 - Gemini 原生接口:地址用
https://api.apiyi.com,api 版本填v1beta。 - 密钥从环境变量读取,例如
api_key=os.environ["APIYI_API_KEY"],不要把明文写进代码。 - 请求返回后,读
usage里的输入、缓存命中和输出 token 数,套第一步的公式核对费用。
🚀 快速开始:在 API易 apiyi.com 注册后可领取免费测试额度,先用
gemini-4-carbon跑通https://api.apiyi.com/v1的调用和 usage 统计,等 Neon 上架后只需改model字段。
Gemini 4 Neon 计价的三本账
除了单价,Google 和 Artificial Analysis 还各自给过“单任务成本”的比较,这几个比例口径不同,不能互相换算。
| 说法 | 数字 | 出处与口径 |
|---|---|---|
| Neon 默认 high 单任务成本比 Carbon 低 | 32% | Google 博客,官方自报,未写 Carbon 用介绍价还是标准价 |
| Neon xhigh 单任务费用比 Carbon 非折扣价少 | 约 17% | Artificial Analysis 文章,Carbon 按标准价 7.76 美元 |
| Neon high 对比 Carbon high 单任务费用 | 不到一半 | Artificial Analysis 文章,按 Carbon 标准价 |
| Carbon high 单任务费用 | 4.90 美元 | Artificial Analysis 模型页,按页面当前介绍价 |
这四个数分别来自三本账,档位和 Carbon 的价格口径都不一样。本文不把 32% 和 17% 平均,也不用 4.90 和 7.76 做减法。对你的项目来说,最可靠的是用自己的 token 数套第一步的公式。
💡 选择建议:单价表只能告诉你每个 token 多少钱,任务实际消耗多少 token 要靠自己的请求来测。可以在 API易 apiyi.com 用同一组提示词分别调用已上架的 Carbon 与 Hydrogen,记录 usage 后再估算 Neon 的费用区间。
常见问题 FAQ
Q1:Gemini 4 Neon 计价分哪几格?
按 Google AI Studio 定价页,Gemini 4 Neon 分三格:输入每百万 token 3.00 美元,缓存输入 0.15 美元,输出 15.00 美元。思考 token 计入输出格,没有免费档。
Q2:Gemini 4 Neon 的缓存怎么才能生效?
Google Cloud 开发者指南写明只支持隐式缓存,对 4096 token 以上的共享前缀自动生效,持久缓存默认开启,显式上下文缓存不支持。把固定的系统提示和长文档放在消息开头,命中率会更高。
Q3:榜单上的 6.44 美元是一次请求的价格吗?
6.44 美元是 Artificial Analysis 在 xhigh 档跑完其智力指数后的加权单任务费用,一套指数包含大量长任务。你的一次聊天或一次 API 请求,应按自己的输入、缓存、输出 token 数套官方三格来算。
Q4:思考档会让 Gemini 4 Neon 计价高多少?
官方没有给每档的 token 数。开发者指南确认四档为 `low`、`medium`、`high`(默认)、`xhigh`,Google 博客说档位越高 token 越多。建议在自己的任务上分档测试,以 usage 里的输出 token 为准。
Q5:如何通过 API易 查 Gemini 4 家族的价格并调用?
打开 API易 apiyi.com 的总表 `docs.apiyi.com/models.md`,或查询定价接口,可以看到 `gemini-4-carbon`(2/0.1/10)和 `gemini-4-hydrogen`(1.5/0.075/7.5)。调用时 OpenAI 兼容地址填 `https://api.apiyi.com/v1`。`gemini-4-neon` 暂未上架,我们会尽快上架这个模型;型号与价格以平台型号列表为准。
Q6:API易 上 Carbon 的价格在 11 月 30 日之后怎么看?
API易 总表当前的 Carbon 货架价 2/0.1/10 对得上 Google 到 2026-11-30 的介绍价。总表没有写之后的调整安排,届时请以 API易 apiyi.com 总表和定价接口的实时数据为准。
Q7:Gemini 4 Neon 计价有哪些需要留意的限制?
主要有四点:
– **无免费档**:AI Studio 定价页写明从首次调用计费。
– **无显式缓存**:只能依赖 4096 token 以上前缀的隐式命中。
– **思考计入输出**:单段默认最多 65536 token,思考会占用这部分预算。
– **参数限制**:传 `thinking_budget` 或 `MINIMAL` 会返回 HTTP `400`。
Q8:为什么有的页面写 Neon 混合价 2.21 美元?
这是 Artificial Analysis 模型页按其混合口径算出的单一价格,便于横向比较。实际账单仍按输入、缓存、输出三格分开结算,计算自己的成本时建议直接用三格单价。
Gemini 4 Neon 计价核心要点 Key Takeaways
- 官方三格:输入 3 美元、隐式缓存读 0.15 美元、输出 15 美元,均为每百万 token。
- 思考归属:思考 token、函数调用和最终回复都计入输出格。
- 缓存规则:只有隐式缓存,4096 token 以上的共享前缀自动生效。
- 无免费档:AI Studio 定价页写明 Neon 没有免费档。
- 整数算例:100 万输入加 10 万输出为 4.5 美元,80 万命中缓存后为 2.22 美元。
- Carbon 两套价:介绍价 2/10 写到 2026-11-30,标准价 4/20 来自 Artificial Analysis 文章。
- 货架查询:在 API易 apiyi.com 总表核对
gemini-4-carbon与gemini-4-hydrogen的已上架价格。
总结
Gemini 4 Neon 计价的核心要点:
- 三格分开算:未命中输入按 3 美元,命中缓存按 0.15 美元,输出含思考按 15 美元。
- 思考档决定输出格:默认
high,档位越高输出 token 越多,费用随之上升。 - 口径分开看:Google 的 32%、Artificial Analysis 的约 17% 和 4.90 美元来自三本账,单任务费用和你的单次请求账单也要分开理解。
如果要估算自己的成本,最直接的办法是拿一组真实提示词跑出 usage,再套三格单价。gemini-4-neon 在 API易 暂未上架,我们会尽快上架这个模型;型号与价格以平台型号列表为准。现阶段推荐通过 API易 apiyi.com 先用已上架的 Carbon 与 Hydrogen 跑通链路,等 Neon 上线后只改模型 ID 即可。
📚 参考资料
-
Google AI Studio 定价页与最新模型页:Neon 三格价格、免费档与缓存说明,Carbon 介绍价与 Hydrogen 价格
- 链接:
aistudio.google.com/docs/pricing - 链接:
aistudio.google.com/docs/latest-model - 说明: 本文官方单价的主要来源
- 链接:
-
Google Cloud 开发者指南 – Gemini 4 Neon:模型 ID、上下文上限、思考档、隐式缓存门槛
- 链接:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - 说明: 输出构成与参数限制的出处
- 链接:
-
Google 博客 – Introducing Gemini 4 Neon:发布信息与官方自报的成本比较
- 链接:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - 说明: 缓存 95% 折扣与单任务成本低 32% 的出处
- 链接:
-
DeepMind 模型卡 – Gemini 4 Neon:上下文窗口、输出上限与知识截止
- 链接:
deepmind.google/models/model-cards/gemini-4-neon - 说明: 模型规格参考
- 链接:
-
Artificial Analysis 文章与模型页:第三方测量的单任务费用、各档耗时与 Carbon 标准价
- 链接:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - 链接:
artificialanalysis.ai/models/gemini-4-neon - 说明: 文章与模型页口径不同,引用时需分开
- 链接:
-
API易 总表与定价接口:已上架型号的货架价与倍率
- 链接:
docs.apiyi.com/models.md - 说明: 查询 Gemini 4 家族型号与价格
- 链接:
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 首页联系我们,更多接入说明可查阅 docs.apiyi.com 文档中心