Nota del autor: desglosamos, según los precios oficiales de Google, las tres celdas de Gemini 4 Neon —entrada, caché implícita y salida—, explicamos que los tokens de pensamiento se contabilizan en la salida, que no hay nivel gratuito y que no se admite caché explícita, además de incluir un ejemplo de cálculo con tokens enteros y el método de comparación con la tabla general de APIYI.
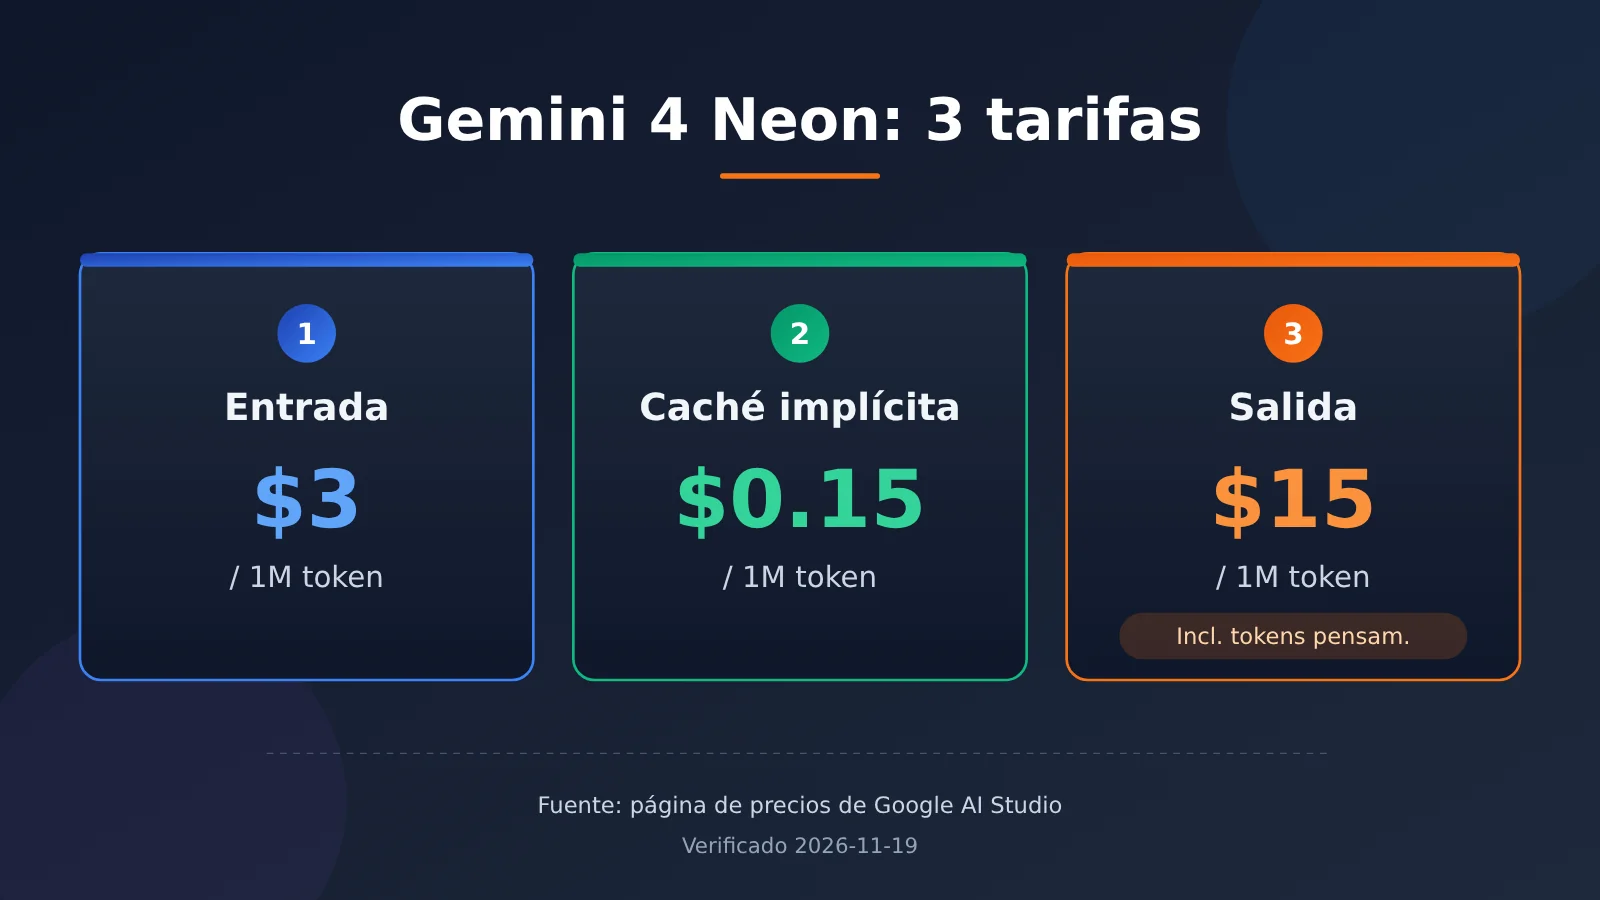
Tras el lanzamiento de Gemini 4 Neon el 2026-11-18, lo primero que muchos desarrolladores quieren aclarar es cuánto cuesta una llamada. El “coste por tarea” de las clasificaciones es el resultado ponderado de ejecutar todo un conjunto de índices de evaluación, y no es lo mismo que una sola solicitud en tu factura. En este artículo desglosamos, celda por celda, las tres celdas de precios de Gemini 4 Neon: entrada 3 USD, lectura de caché implícita 0.15 USD y salida 15 USD, y explicamos en qué celda se contabilizan los tokens de pensamiento.
La información de precios de este artículo proviene de la página de precios de Google AI Studio, la guía para desarrolladores de Google Cloud, la ficha del modelo de DeepMind, el artículo y la página del modelo de Artificial Analysis, así como de la tabla general y la API de precios de APIYI. La fecha de verificación de los datos es el 2026-11-19; cada cifra indica su fuente y, cuando los criterios no coinciden, conservamos ambas versiones.
Valor clave: después de leer este artículo, podrás aplicar la fórmula con tu propio número de tokens para calcular el coste por solicitud de Gemini 4 Neon, sabrás en qué celda ahorras cuando hay acierto de caché y también cómo consultar el precio de lista de modelos de la misma familia en la tabla general de APIYI apiyi.com.
Puntos clave del precio de Gemini 4 Neon
Primero, vamos a poner sobre la mesa las condiciones de precio que publica oficialmente Google. Los precios y las reglas de caché de la tabla siguiente vienen de la página de precios de Google AI Studio y de la guía para desarrolladores de Google Cloud; los límites de contexto y de salida provienen de la guía para desarrolladores y de la ficha del modelo.
| Punto clave | Lo que dice la documentación oficial | Qué significa para tu factura |
|---|---|---|
| Entrada | 3,00 USD por millón de tokens (página de precios de AI Studio) | Indicaciones, documentos e historial de mensajes se cobran todos en esta casilla |
| Entrada en caché | 0,15 USD por millón de tokens, solo con caché implícita (página de precios de AI Studio) | El prefijo compartido que acierta se cobra a 0,15, un 95 % de descuento frente a los 3 USD (blog de Google, cifra que la propia compañía declara) |
| Salida | 15,00 USD por millón de tokens, incluidos los tokens de pensamiento (página de precios de AI Studio) | Cuanto más profundo sea el pensamiento, más crece esta casilla |
| Nivel gratuito | No hay nivel gratuito (página de precios de AI Studio) | Se factura desde la primera invocación |
| Caché explícita | La caché de contexto explícita no está soportada (guía para desarrolladores de Google Cloud) | No puedes crear objetos de caché a mano, solo depender de los aciertos automáticos |
| Umbral de la caché implícita | Los prefijos compartidos de más de 4096 tokens se aplican automáticamente, y la caché persistente está activada por defecto (guía para desarrolladores) | Con indicaciones cortas, prácticamente no vas a beneficiarte del precio de caché |
| Contexto | Límite unificado de 1048576 tokens, que incluye entrada y salida (guía para desarrolladores); la ficha del modelo indica una ventana unificada de hasta 1 millón | En casos de documentos largos, la casilla de entrada ocupará una proporción muy alta |
Los tokens de pensamiento en el precio de Gemini 4 Neon
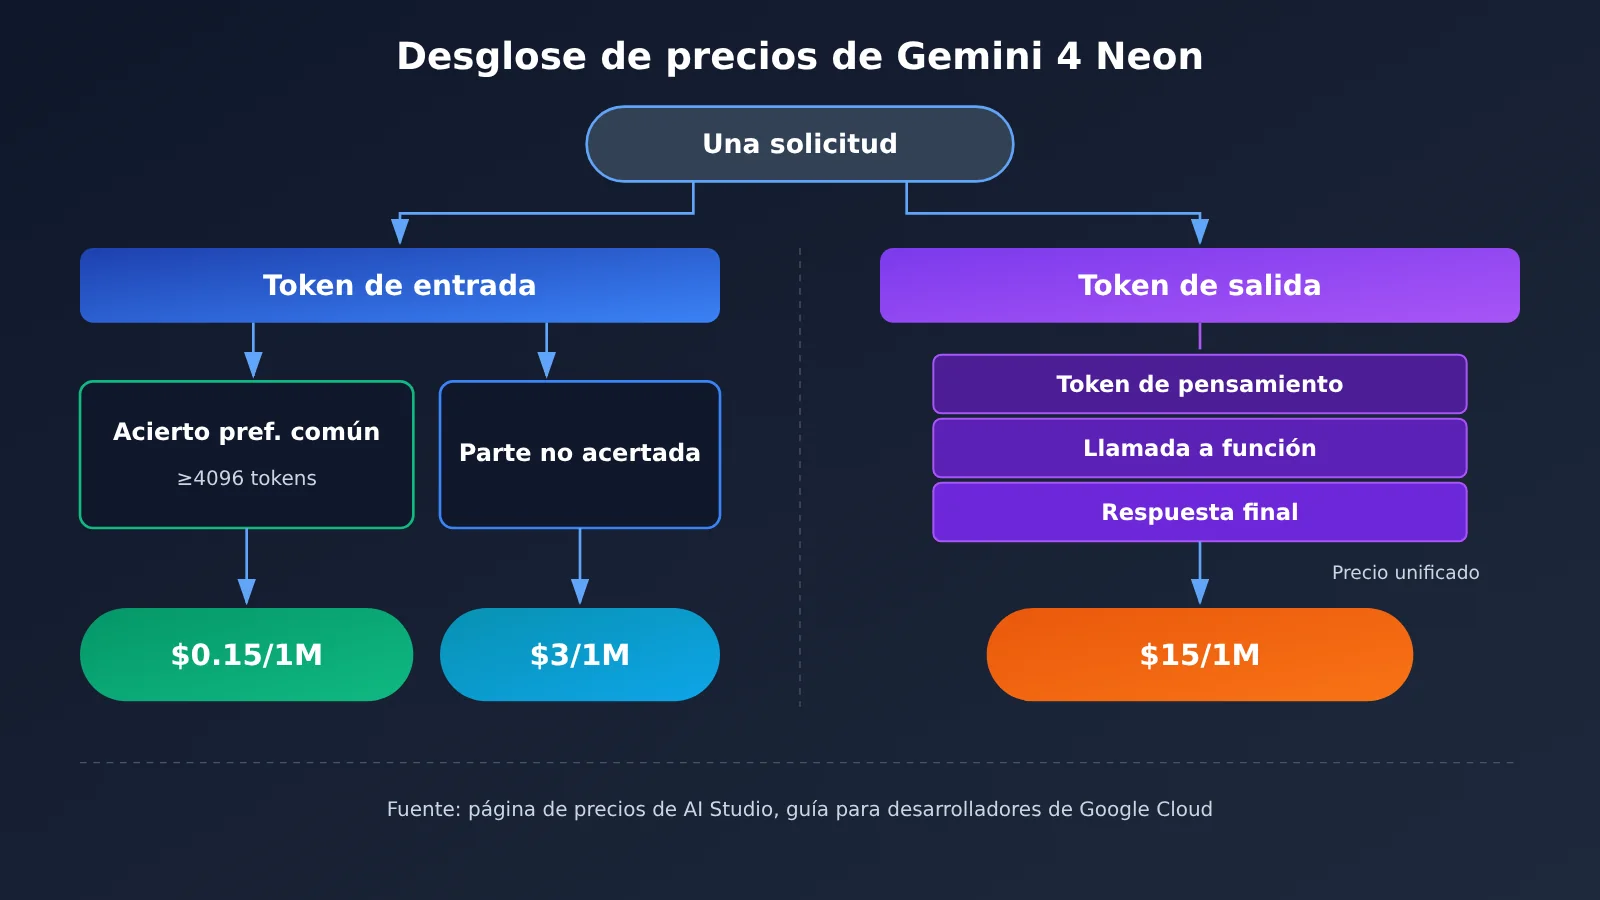
La guía para desarrolladores de Google Cloud especifica que la salida se compone de tres partes: pensamiento, llamada a función y respuesta final, con un máximo de 65536 tokens por defecto en cada tramo. La página de precios de AI Studio también include los tokens de pensamiento en la casilla de salida de 15 USD, así que la cantidad de tokens de salida que verás en la factura normalmente será bastante mayor que la respuesta que percibes a simple vista.
Los niveles de pensamiento de Neon son solo cuatro: low, medium, high y xhigh, donde high es el valor por defecto. La guía para desarrolladores también advierte que pasar thinking_budget o MINIMAL devuelve un HTTP 400. La descripción del blog de Google (cifra declarada por la propia compañía) es que cuanto más alto el nivel, más profundo el pensamiento y más tokens, lo que repercute directamente en la casilla de salida.
La caché implícita en el precio de Gemini 4 Neon
La caché implícita apunta a la parte inicial idéntica entre distintas solicitudes, por ejemplo una indicación de sistema fija, el mismo documento largo o el mismo conjunto de definiciones de herramientas. La guía para desarrolladores marca el umbral en prefijos compartidos de más de 4096 tokens: al cumplirse, la facturación pasa automáticamente a precio de caché, sin necesidad de llamar a ninguna interfaz adicional.
Esto deja una recomendación de redacción muy práctica: coloca el contenido estable e invariable al principio de los mensajes y deja la pregunta del usuario que cambia cada vez al final. Cuanto más largo y estable sea el prefijo, mayor será la proporción que se cobra a 0,15 USD. El descuento de caché solo aplica a la casilla de entrada; la de salida siempre se cobra a 15 USD.
Precio de Gemini 4 Neon y diferencias de precio unitario con Carbon e Hydrogen
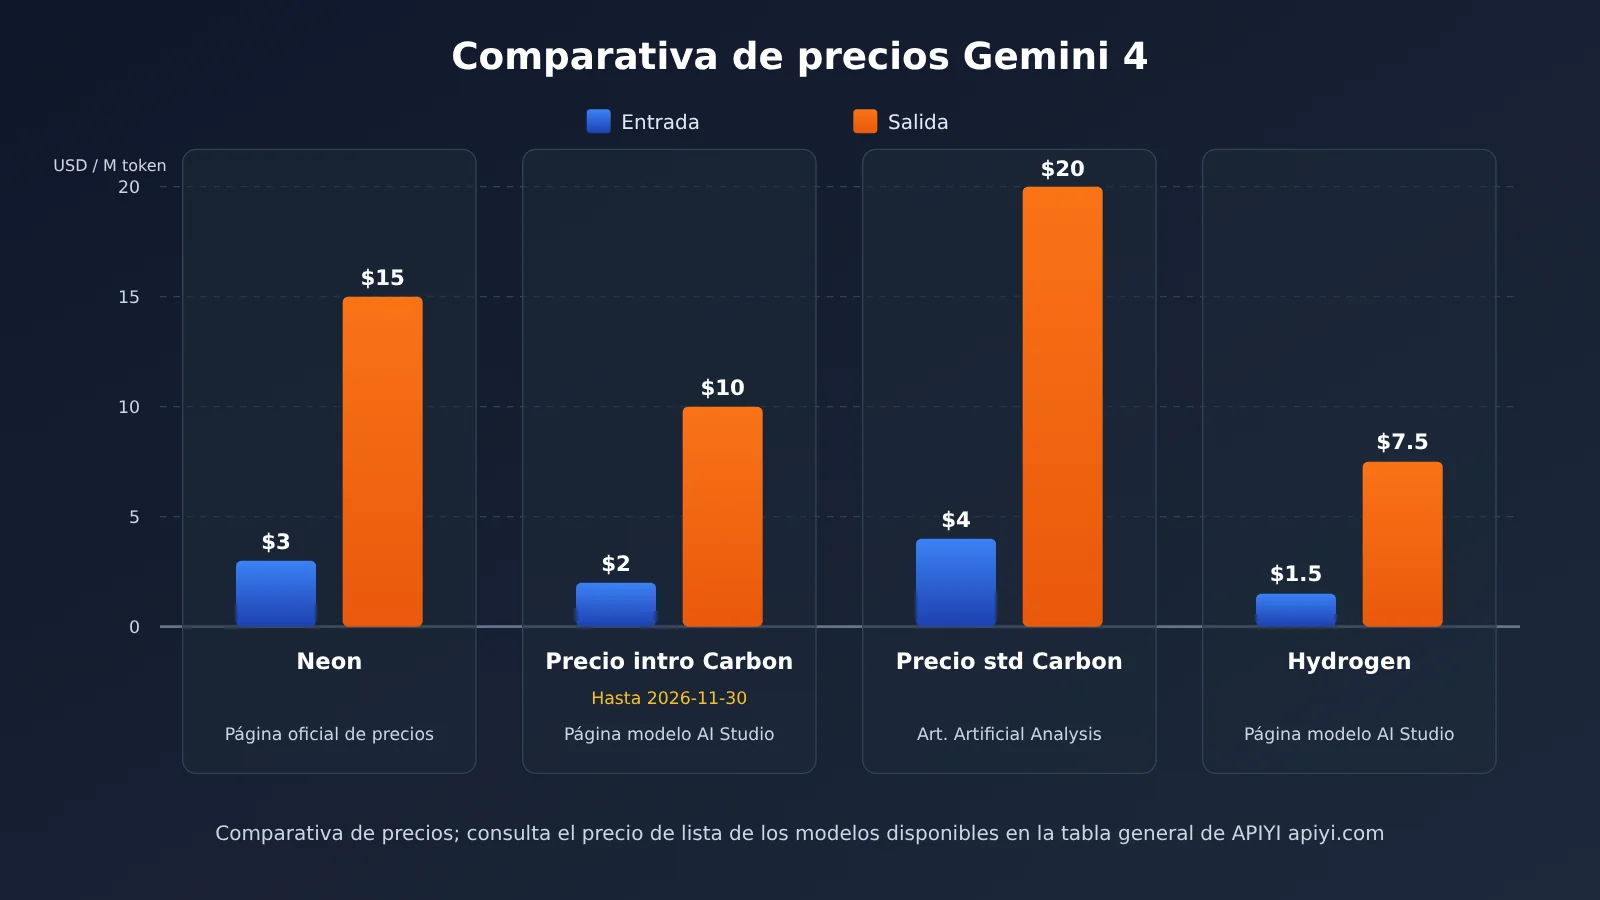
Neon se sitúa entre Hydrogen y Carbon dentro de la familia. Según el blog de Google, Carbon se encarga de las tareas de horizonte largo más difíciles, Hydrogen de la ejecución rápida diaria, y Neon queda en un punto medio, orientado a flujos complejos de alta frecuencia. El precio unitario también sigue ese orden, pero Carbon tiene un precio introductorio y un precio estándar, que conviene analizar por separado.
| Modelo | Entrada / 1M | Salida / 1M | Criterio de precio y fuente |
|---|---|---|---|
| Gemini 4 Neon | 3.00 USD | 15.00 USD | Página de precios de AI Studio, precio oficial |
| Gemini 4 Carbon (precio introductorio) | 2.00 USD | 10.00 USD | Página de modelos más recientes de AI Studio, vigente hasta 2026-11-30 |
| Gemini 4 Carbon (precio estándar) | 4 USD | 20 USD | Precio estándar citado en el artículo de Artificial Analysis |
| Gemini 4 Hydrogen | 1.50 USD | 7.50 USD | Página de modelos más recientes de AI Studio |
A partir de estos datos, el artículo de Artificial Analysis ofrece dos comparaciones porcentuales: el 3/15 de Neon es un 25% inferior al 4/20 del precio estándar de Carbon; frente al precio con descuento 2/10 de Carbon vigente hasta el 30 de noviembre, el precio unitario de Neon es un 50% superior. Ambas comparaciones son válidas; la diferencia está solo en qué conjunto de precios de Carbon se toma como referencia.
Los descuentos de caché también tienen dos versiones. La página de modelos de Artificial Analysis indica un descuento de caché del 95% para Neon y del 90% para Carbon. En la tabla general de APIYI, la lectura de caché de gemini-4-carbon cuesta 0.1 USD, lo que equivale al 5% de una entrada de 2 USD. Estas cifras proceden de páginas distintas; este artículo las reproduce tal cual, sin convertirlas ni unificarlas.
Inicio rápido del cálculo de precios de Gemini 4 Neon
Vamos por cuatro pasos: primero aplicamos las tres categorías oficiales, luego estimamos cómo el nivel de «pensamiento» afecta la salida, después contrastamos con la tabla general de APIYI para comparar con los modelos ya publicados de la misma familia, y por último confirmamos el estado de publicación del propio Neon.
Paso 1: calcular una invocación con las tres categorías oficiales
La fórmula es sencilla: costo de entrada = tokens de entrada sin caché ÷ 1 millón × 3; costo de caché = tokens de entrada con caché ÷ 1 millón × 0.15; costo de salida = tokens de salida (incluyendo pensamiento) ÷ 1 millón × 15. La suma de los tres términos es el costo de esta solicitud.
- Ejemplo sin caché: 1 000 000 de tokens de entrada y 100 000 de tokens de salida. Entrada: 1 000 000 ÷ 1 000 000 × 3 = 3 USD; salida: 100 000 ÷ 1 000 000 × 15 = 1.5 USD; total 4.5 USD.
- Ejemplo con cache hit: los mismos 1 000 000 de tokens de entrada, de los cuales 800 000 corresponden al prefijo compartido y cacheado. La parte con cache hit: 800 000 ÷ 1 000 000 × 0.15 = 0.12 USD; los 200 000 tokens restantes sin caché cuestan 0.6 USD; la salida sigue siendo 1.5 USD; total 2.22 USD.
- Mismo volumen de tokens con el precio introductorio de Carbon: 1 000 000 × 2 más 100 000 × 10, total 3 USD; con el precio estándar de Carbon (4/20), total 6 USD; con Hydrogen (1.5/7.5), total 2.25 USD.
Ojo: para una misma tarea, distintos modelos generan cantidades de tokens distintas. El artículo de Artificial Analysis señala que Neon produce aproximadamente 15% más tokens de salida que Carbon por tarea, así que comparar con la misma cantidad de tokens solo muestra la diferencia de precio unitario; la factura real también tiene que multiplicarse por el consumo de tokens de cada modelo.
Paso 2: estimar cuánto eleva el nivel de pensamiento la partida de salida
El nivel de pensamiento determina qué tan grande es la partida de salida. El blog de Google (según lo que la propia empresa declara) solo dice que cuanto mayor el nivel, más tokens; no da el número concreto de tokens por nivel. La página del modelo en Artificial Analysis ofrece el tiempo por tarea individual que tarda cada nivel en completar el índice, lo que sirve como evidencia indirecta de que «cuanto más profundo el pensamiento, más largo el proceso».
| Nivel de pensamiento | ¿Predeterminado? | Tiempo por tarea (página del modelo en Artificial Analysis) | Velocidad de salida |
|---|---|---|---|
low |
No | 3.7 minutos | 97 tokens/s |
medium |
No | 8.3 minutos | 101 tokens/s |
high |
Sí (guía para desarrolladores) | 14.8 minutos | 101 tokens/s |
xhigh |
No | 21.5 minutos | 110 tokens/s |
En el ejemplo de cálculo del paso 1, si al subir el nivel de pensamiento la salida pasa de 100000 tokens a 200000 tokens, la partida de salida pasa de 1.5 dólares a 3 dólares. Cuánto aumenta realmente depende de tu tarea; te recomendamos ejecutar tu propia indicación con varios niveles y revisar el campo usage que devuelve la API antes de decidir el nivel predeterminado.
Paso 3: comparar con la tabla general de APIYI los modelos de la misma familia
Abre la tabla general de APIYI docs.apiyi.com/models.md (página marcada como actualizada el 2026-11-16 09:39, UTC+8), o consulta la interfaz de precios api.apiyi.com/api/pricing (consulta del 2026-11-19, versión shell-api-modelmak-v1, 285 modelos en total), donde puedes ver el precio de lista de los modelos ya disponibles de la familia Gemini 4.
| ID del modelo | Entrada / 1M | Lectura de caché / 1M | Salida / 1M | Endpoint | Plataformas disponibles |
|---|---|---|---|---|---|
gemini-4-carbon |
2 dólares | 0.1 dólares | 10 dólares | chat, gemini | APIYI apiyi.com |
gemini-4-hydrogen |
1.5 dólares | 0.075 dólares | 7.5 dólares | chat, gemini | APIYI apiyi.com |
gemini-4-neon |
— | — | — | — | No aparece ni en la tabla general ni en la interfaz de precios |
En la tabla general de APIYI, los 2/0.1/10 de gemini-4-carbon son el precio de lista actual, que coincide con el precio introductorio de Google hasta el 2026-11-30; no es el mismo conjunto que el precio estándar 4/20. En cuanto a los grupos, la tabla general escribe Default, SVIP, mientras que la interfaz de precios escribe default, svip. La página del modelo también indica contexto 1048576, salida máxima 65536 y corte de conocimiento 2026-03.
La interfaz de precios expresa los precios con multiplicadores: model_ratio igual a 1 corresponde a 2 dólares por millón de tokens de entrada, y completion_ratio igual a 5 indica que la salida es 5 veces la entrada. Con esta conversión, un modelo con entrada 2 y salida 10 corresponde a 1 y 5, lo que coincide con el primer nivel de la tabla general.
Paso 4: Confirmar el estado de disponibilidad de Gemini 4 Neon
gemini-4-neon no aparece ni en la tabla general de APIYI ni en la interfaz de precios, y tampoco tiene una página de modelo independiente. Por ahora no está disponible; lo publicaremos lo antes posible, y tanto el modelo como el precio se rigen por la lista de modelos de la plataforma.
Mientras esperas, puedes usar gemini-4-carbon o gemini-4-hydrogen, que ya están disponibles, para validar la cadena de invocación. Las formas de invocación son las siguientes:
- Interfaz compatible con OpenAI: configura
base_urlcomohttps://api.apiyi.com/v1ymodelcomogemini-4-carbon. - Interfaz nativa de Gemini: usa
https://api.apiyi.comcomo dirección yv1betacomo versión de api. - Lee la clave desde una variable de entorno, por ejemplo
api_key=os.environ["APIYI_API_KEY"]; no escribas la clave en texto plano dentro del código. - Cuando received la respuesta, lee los números de tokens de entrada, aciertos de caché y salida en
usage, y aplica la fórmula del paso 1 para verificar el costo.
🚀 Inicio rápido: después de registrarte en APIYI apiyi.com puedes obtener crédito de prueba gratuito; primero usa
gemini-4-carbonpara completar la invocación dehttps://api.apiyi.com/v1y el conteo de uso, y cuando Neon esté disponible solo tendrás que cambiar el campomodel.
Las tres cuentas de la fijación de precios de Gemini 4 Neon
Además del precio unitario, Google y Artificial Analysis también han publicado comparativas de «costo por tarea»; esas proporciones responden a criterios distintos y no se pueden convertir entre sí.
| Afirmación | Cifra | Fuente y criterio |
|---|---|---|
| El costo por tarea de Neon en high por defecto es 32% menor que Carbon | 32% | Blog de Google, autoinformado por la fuente oficial; no especifica si Carbon usa precio introductorio o precio estándar |
| El costo por tarea de Neon xhigh es aproximadamente 17% menor que Carbon a precio no descontado | ~17% | Artículo de Artificial Analysis, Carbon a precio estándar de 7,76 dólares |
| Costo por tarea de Neon high frente a Carbon high | menos de la mitad | Artículo de Artificial Analysis, según precio estándar de Carbon |
| Costo por tarea de Carbon high | 4,90 dólares | Página del modelo en Artificial Analysis, según el precio introductorio vigente en la página |
Estas cuatro cifras provienen de tres cuentas distintas; tanto los niveles como el criterio de precio de Carbon son diferentes. Este artículo no promedia 32% y 17%, ni resta 4,90 de 7,76. Para tu proyecto, lo más fiable es aplicarle la fórmula del paso 1 con tus propios conteos de tokens.
💡 Recomendación de selección: la tabla de precios unitarios solo te dice cuánto cuesta cada token; cuántos tokens consume realmente una tarea depende de tus propias peticiones. En APIYI apiyi.com puedes invocar Carbon e Hydrogen (ya disponibles) con el mismo conjunto de indicaciones, registrar el usage y luego estimar el rango de costo de Neon.
Preguntas frecuentes (FAQ)
P1: ¿En cuántas categorías se divide el precio de Gemini 4 Neon?
Según la página de precios de Google AI Studio, Gemini 4 Neon se divide en tres categorías: 3.00 USD por millón de tokens de entrada, 0.15 USD para entrada en caché y 15.00 USD para salida. Los tokens de pensamiento se contabilizan en la categoría de salida, y no hay nivel gratuito.
P2: ¿Cómo se activa la caché de Gemini 4 Neon?
La guía para desarrolladores de Google Cloud indica que solo admite caché implícita, que se activa automáticamente para prefijos compartidos de más de 4096 tokens; la caché persistente está activada por defecto y la caché de contexto explícita no es compatible. Coloca la indicación del sistema fija y los documentos largos al inicio del mensaje, y la tasa de aciertos será mayor.
P3: ¿Los 6.44 USD del ranking son el precio de una sola solicitud?
Los 6.44 USD son el costo ponderado por tarea que calcula Artificial Analysis tras ejecutar su índice de inteligencia en el nivel xhigh; un conjunto de índices incluye muchas tareas largas. Una sola conversación tuya o una sola solicitud de API debe calcularse con las tres categorías oficiales según tus propios conteos de tokens de entrada, caché y salida.
P4: ¿Cuánto encarece el nivel de pensamiento el precio de Gemini 4 Neon?
La documentación oficial no proporciona el número de tokens por nivel. La guía para desarrolladores confirma que hay cuatro niveles: `low`, `medium`, `high` (predeterminado) y `xhigh`; el blog de Google dice que cuanto más alto el nivel, más tokens. Se recomienda probar por niveles en tus propias tareas y guiarse por los tokens de salida que aparecen en el usage.
P5: ¿Cómo consultar los precios de la familia Gemini 4 y llamarla a través de APIYI?
Abre la tabla maestra `docs.apiyi.com/models.md` de APIYI apiyi.com, o consulta la interfaz de precios, donde puedes ver `gemini-4-carbon` (2/0.1/10) y `gemini-4-hydrogen` (1.5/0.075/7.5). Al invocar, la dirección compatible con OpenAI es `https://api.apiyi.com/v1`. `gemini-4-neon` aún no está disponible, y la incorporaremos lo antes posible. El modelo y el precio están sujetos a la lista de modelos de la plataforma.
P6: ¿Cómo interpretar el precio de Carbon en APIYI después del 30 de noviembre?
El precio de lista actual de Carbon en la tabla maestra de APIYI, 2/0.1/10, coincide con el precio introductorio de Google hasta el 2026-11-30. La tabla maestra no indica ajustes posteriores; en ese momento, consulta los datos en tiempo real de la tabla maestra y de la interfaz de precios de APIYI apiyi.com.
P7: ¿Qué limitaciones hay que tener en cuenta en el precio de Gemini 4 Neon?
Principalmente cuatro:
– **Sin nivel gratuito**: la página de precios de AI Studio indica que el cobro comienza desde la primera llamada.
– **Sin caché explícita**: solo se puede depender de la caché implícita para prefijos de más de 4096 tokens.
– **Pensamiento contabilizado en la salida**: cada segmento tiene por defecto un máximo de 65536 tokens, y el pensamiento consume parte de ese presupuesto.
– **Restricciones de parámetros**: pasar `thinking_budget` o `MINIMAL` devuelve HTTP `400`.
P8: ¿Por qué algunas páginas muestran un precio híbrido de 2.21 USD para Neon?
Es el precio único calculado por la página de modelo de Artificial Analysis según su criterio mixto, pensado para facilitar la comparación horizontal. La facturación real sigue calculándose por separado en las tres categorías: entrada, caché y salida. Al calcular tu propio costo, se recomienda usar directamente los precios unitarios de las tres categorías.
Puntos clave del precio de Gemini 4 Neon
- Tres tarifas oficiales: entrada a 3 USD, lectura de caché implícita a 0.15 USD y salida a 15 USD, todas por millón de tokens.
- Asignación del razonamiento: los tokens de razonamiento, las llamadas a funciones y la respuesta final se cuentan todos en la tarifa de salida.
- Reglas de caché: solo existe la caché implícita; los prefijos compartidos desde 4096 tokens se aplican automáticamente.
- Sin plan gratuito: la página de precios de AI Studio indica que Neon no tiene plan gratuito.
- Ejemplo con cifras redondas: 1 millón de tokens de entrada más 100.000 tokens de salida dan 4.5 USD; con 800.000 aciertos de caché, queda en 2.22 USD.
- Dos precios para Carbon: el precio introductorio 2/10 se indica hasta el 2026-11-30; el precio estándar 4/20 proviene de un artículo de Artificial Analysis.
- Consulta en el catálogo: en la tabla general de APIYI apiyi.com, verifica los precios ya publicados de
gemini-4-carbonygemini-4-hydrogen.
Resumen
Puntos clave del precio de Gemini 4 Neon:
- Tres tarifas separadas: la entrada que no acierta en caché se cobra a 3 USD, la que acierta en caché a 0.15 USD y la salida, incluido el razonamiento, a 15 USD.
- El nivel de razonamiento determina la tarifa de salida: el valor predeterminado es
high; cuanto más alto el nivel, más tokens de salida y mayor el costo. - Bases contables distintas: el 32% de Google, el aproximadamente 17% de Artificial Analysis y los 4.90 USD provienen de tres cálculos diferentes; además, conviene distinguir entre el costo por tarea y la factura de cada solicitud individual.
Si quieres estimar tu propio costo, lo más directo es lanzar un conjunto de indicaciones reales para obtener los datos de uso y luego aplicar las tres tarifas unitarias. gemini-4-neon aún no está disponible en APIYI; publicaremos este modelo lo antes posible. El modelo y el precio están sujetos a la lista de modelos de la plataforma. Por ahora, recomendamos usar APIYI apiyi.com para probar el flujo con Carbon y Hydrogen, que ya están disponibles; cuando Neon se lance, solo tendrás que cambiar el ID del modelo.
📚 Referencias
-
Página de precios y página de modelos más recientes de Google AI Studio: precios de los tres niveles de Neon, nivel gratuito y notas sobre caché, precio de presentación de Carbon y precio de Hydrogen
- Enlace:
aistudio.google.com/docs/pricing - Enlace:
aistudio.google.com/docs/latest-model - Nota: fuente principal de los precios unitarios oficiales citados en este artículo
- Enlace:
-
Guía para desarrolladores de Google Cloud – Gemini 4 Neon: ID del modelo, límite de contexto, niveles de razonamiento y umbral de caché implícita
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Nota: origen de la composición de la salida y de las restricciones de parámetros
- Enlace:
-
Blog de Google – Introducing Gemini 4 Neon: información del lanzamiento y comparación de costes según la propia empresa
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Nota: origen del descuento del 95% en caché y del coste por tarea 32% menor
- Enlace:
-
Ficha del modelo de DeepMind – Gemini 4 Neon: ventana de contexto, límite de salida y fecha de corte del conocimiento
- Enlace:
deepmind.google/models/model-cards/gemini-4-neon - Nota: referencia de especificaciones del modelo
- Enlace:
-
Artículo y página del modelo de Artificial Analysis: coste por tarea medido por terceros, tiempos de cada nivel y precio estándar de Carbon
- Enlace:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Enlace:
artificialanalysis.ai/models/gemini-4-neon - Nota: el artículo y la página del modelo usan criterios distintos, conviene citarlos por separado
- Enlace:
-
Tabla general y API de precios de APIYI: precios de lista y multiplicadores de los modelos ya disponibles
- Enlace:
docs.apiyi.com/models.md - Nota: consulta de modelos y precios de la familia Gemini 4
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: puedes comunicarte con nosotros desde la página principal de APIYI apiyi.com; encontrarás más instrucciones de integración en el centro de documentación docs.apiyi.com