Nota do autor: comparar Qwen4-Max e Kimi K3.1 Pro em cinco dimensões — abertura de pesos, tarefas de terminal, entrega de tarefas longas, visão e vídeo, e custo por milhão de tokens — e explicar por que as pontuações oficiais do Terminal-Bench das duas empresas não batem.
Conclusão antecipada: se você precisa obter os pesos para fine-tuning, quantização ou implantação privada, escolha Kimi K3.1 Pro; se precisa de API gerenciada, valoriza visão, vídeo e entrega de tarefas longas, e quer reduzir ao mínimo o custo por milhão de tokens, escolha Qwen4-Max. E se a sua carga principal são agentes de linha de comando rodando no terminal, o Kimi K3.1 Pro leva vantagem clara hoje.
Esta não é uma análise morna de “cada um tem seus pontos fortes”. Todos os números abaixo vêm com a fonte indicada: os do Qwen vêm do blog oficial da Alibaba e de gráficos comparativos de mesma base divulgados pela própria empresa; os do Kimi vêm da documentação oficial da Moonshot; os dados de terceiros vêm de um snapshot público do ranking da arena (2026-11-14). Por que as duas empresas, ao reportarem o mesmo benchmark, chegam a resultados diferentes — este artigo destrincha isso à parte.
Valor central: ao terminar a leitura, você terá uma linha divisória clara para a escolha e saberá como converter as duas vantagens — “mais barato” e “dá para obter os pesos” — para as suas próprias tarefas.
Principais diferenças entre Qwen4-Max e Kimi K3.1 Pro
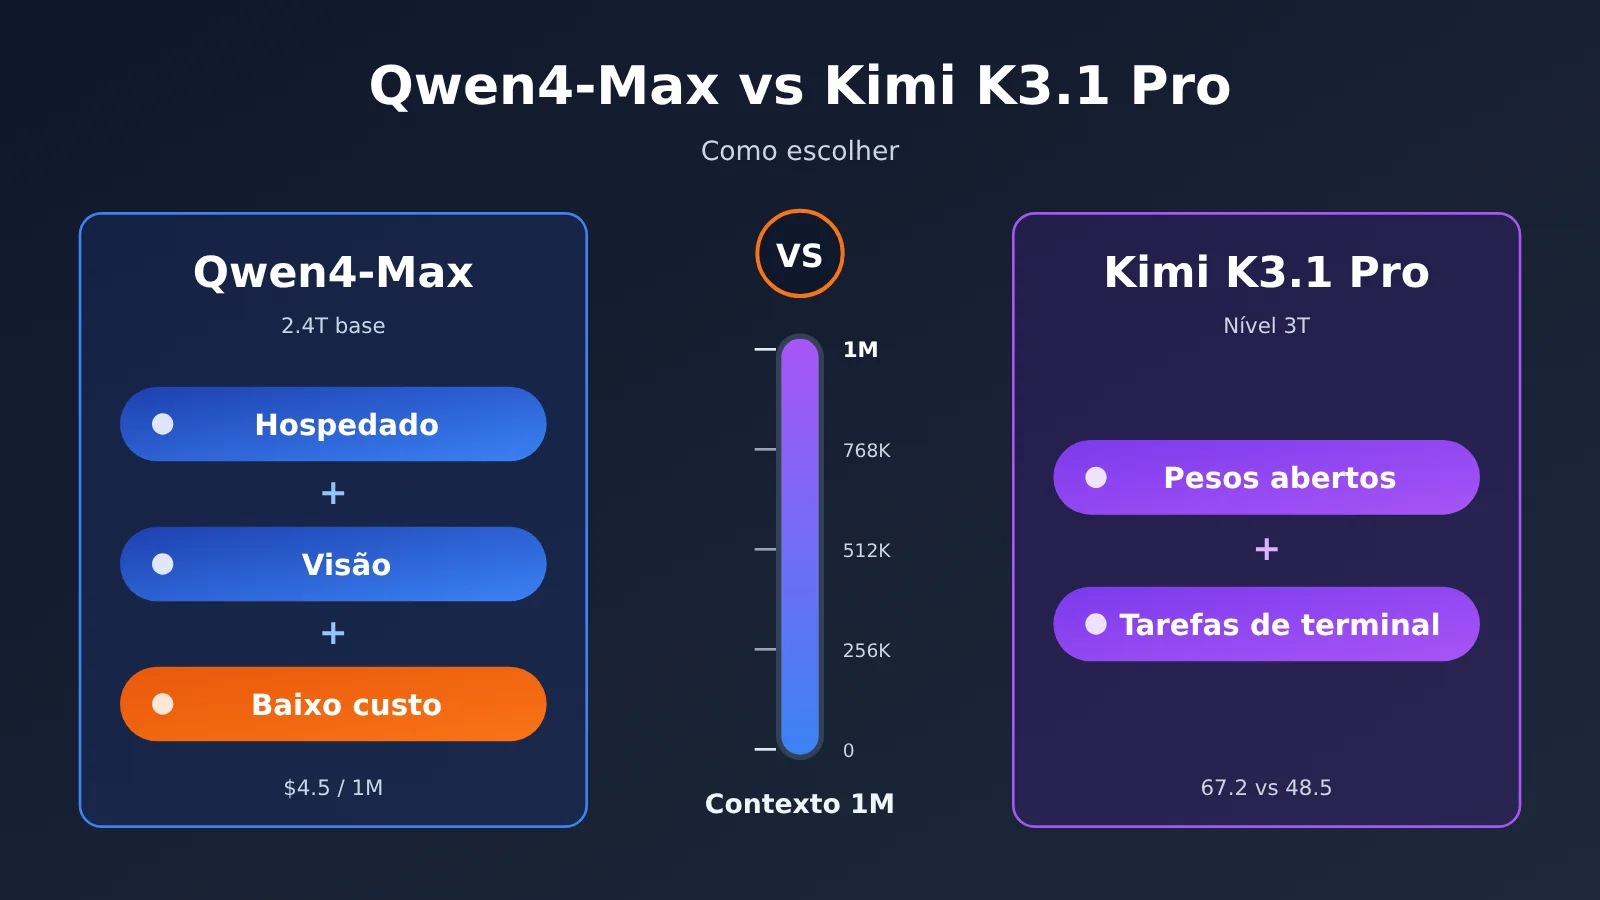
Ambos os modelos são carros-chefe nacionais do segundo semestre de 2026, com janela de contexto na casa de 1M. Os parâmetros superficiais são parecidos, mas o posicionamento é bem diferente. O Qwen4-Max usa um tronco de 2,4T, 71B de parâmetros ativados, além de 328B de N-gram Embedding, suporte nativo a visão, saída máxima de 393K e cadeia de pensamento máxima de 262K, com reasoning_effort padrão em high. O Kimi K3.1 Pro é o primeiro modelo da série K3.1, da classe 3T, e a própria empresa o descreve como o modelo de pesos abertos de classe 3T mais capaz, com janela de contexto de 1.048.576 tokens.
| Dimensão de comparação | Qwen4-Max | Kimi K3.1 Pro | Vantagem |
|---|---|---|---|
| Escala | tronco de 2,4T / 71B ativados + 328B N-gram Embedding | classe 3T | — |
| Pesos | materiais públicos mencionam apenas a API gerenciada QwenCloud | pesos abertos | Kimi |
| Contexto | 1M, saída máxima de 393K | 1.048.576 tokens | empate |
| Tarefas de terminal (mesmo gráfico da Alibaba) | 48,5 | 67,2 | Kimi |
| Tarefas longas e entrega para o setor | liderança em vários itens | ligeiramente superior no AutomationBench | Qwen4 |
| Visão e vídeo | visão nativa, liderança em métricas de gráficos e vídeo | métricas atrás | Qwen4 |
| Preço por 1M de saída | US$ 4,5 | US$ 10 | Qwen4 |
Resumindo em uma frase: a vantagem do Kimi está em “poder ser modificado” e “rodar no terminal”; a do Qwen4 está em “ampla cobertura de entrega” e “ser mais barato”. A seguir, detalhamos em cinco dimensões.
Kimi K3.1 Pro e Qwen4-Max permitem alterar os pesos?
Essa é a linha divisória mais dura entre os dois. O Kimi K3.1 Pro é um modelo de pesos abertos: as equipes podem levá-lo para seus próprios clusters para fazer fine-tuning de domínio, compressão por quantização, destilação ou implantação offline em ambientes com requisitos rígidos de conformidade. Para equipes que precisam “alterar o modelo em si”, não há alternativa — resultados de benchmark mais altos não compensam isso.
As informações públicas sobre o Qwen4-Max mencionam apenas que ele é oferecido via QwenCloud como uma API gerenciada; os materiais de referência não falam em pesos abertos. A vantagem do modelo gerenciado é não precisar se preocupar com GPUs, frameworks de inferência e escalabilidade; a desvantagem é que você só consegue adaptar o modelo ao negócio por meio de comandos, contexto e chamadas de ferramentas. Vale deixar claro: pesos abertos não significam automaticamente mais segurança — a segurança ainda depende da sua implantação, do controle de acesso e dos processos de auditoria.
Regra prática: se você apenas “chama o modelo”, o valor dos pesos abertos para você é praticamente zero; se você precisa claramente fazer fine-tuning ou implantação privada, o Kimi é a única opção nesta comparação, e as próximas dimensões servem apenas para avaliar se ele é “suficiente”.
Qwen4-Max vs Kimi K3.1 Pro: quem é melhor em tarefas de terminal?
Tarefas de terminal são aquelas em que o modelo lê e grava arquivos no ambiente de linha de comando, executa comandos e faz iterações de correção com base nos erros — o cenário mais próximo do trabalho real para um agente de programação. Nesse quesito, o Kimi K3.1 Pro é claramente mais forte: na comparação no mesmo gráfico divulgada oficialmente pela Alibaba, o Qwen4-Max obteve 48,5 no Terminal-Bench 4.0, enquanto o Kimi K3.1 ficou com 67,2 — uma diferença de 18,7 pontos, o maior atraso do Qwen4 em todo o gráfico.
Por que os números da Terminal-Bench divergem entre as duas fontes
Há um detalhe fácil de passar despercebido: o mesmo Kimi K3.1 Pro aparece com pontuações diferentes no Terminal-Bench 4.0 nos materiais oficiais das duas empresas.
| Fonte | Kimi K3.1 Pro | Outra referência |
|---|---|---|
| Documentação oficial da Moonshot | 65,7% | Claude Opus 5.5 com 66,4%, GPT-6 Astra com 58,2% |
| Comparação no mesmo gráfico divulgada oficialmente pela Qwen | 67,2 | Qwen4-Max com 48,5 |
A própria Kimi informa 65,7%, enquanto o gráfico da Alibaba atribui 67,2 ao Kimi — uma diferença de 1,5 ponto. Essa diferença vem do harness de avaliação (framework do agente, definição de ferramentas, políticas de timeout e retry), da configuração de reasoning effort e da versão do conjunto de tarefas. Não dá para interpretar isso como fraude de qualquer lado, nem misturar os dois números em uma única “pontuação de tarefas de terminal do Kimi” para citar. Da mesma forma, Claude Opus 5.5 aparece com 66,4% na documentação da Moonshot; sob o framework de avaliação da Alibaba, também seria outro número. Montar rankings combinando documentos diferentes não faz sentido.
A leitura correta é: compare posições relativas apenas dentro do mesmo gráfico e do mesmo harness. Sob os critérios da Moonshot, Kimi fica um pouco abaixo do Opus 5.5 e bem acima do GPT-6 Astra; sob os critérios da Alibaba, Kimi lidera com folga sobre o Qwen4-Max. As duas conclusões são válidas e apontam na mesma direção — a capacidade em terminal do Kimi K3.1 Pro está no primeiro escalão.
🎯 Dica técnica: As pontuações de benchmark flutuam conforme o harness e o effort; o método mais confiável é rodar uma rodada com seu próprio framework de agente e tarefas reais. Com o APIYI apiyi.com, você pode usar a mesma chave API para chamar modelos como
kimi-k3.1-pro, mantendo o framework igual e alterando apenas o parâmetromodel; assim a comparação faz sentido.
Outro ponto relacionado são os demais indicadores de tarefas de código. No mesmo gráfico da Alibaba, o DeepSWE v1.1 fica praticamente empatado (75,7 contra 75,5). No ProgramBench, o Qwen4-Max é 6,5 pontos maior (31,5 contra 25,0). A documentação oficial da Moonshot também traz 61,2% no Kimi Code Bench 3.0 Long-horizon, um avanço claro em relação aos 55,95% da geração anterior, K3. Então a formulação precisa é: Kimi se destaca na interação via terminal, enquanto o Qwen4 não fica atrás em parte das tarefas de programação que não envolvem terminal.
Qwen4-Max e Kimi K3.1 Pro: tarefas longas e entrega setorial
Se o seu agente é responsável por “entregar um trabalho completo” — montar um relatório, percorrer um fluxo de negócio de ponta a ponta, resolver problemas de um domínio especializado — o Qwen4-Max se sai melhor no comparativo divulgado pela própria Alibaba. A tabela abaixo traz os números desse comparativo oficial da Qwen que têm relação com tarefas longas e cenários setoriais.
| Benchmark (comparativo oficial da Qwen) | Qwen4-Max | Kimi K3.1 | Diferença |
|---|---|---|---|
| JobBench | 68.5 | 61.2 | Qwen4 maior em 7.3 |
| APEX-Agents v1.1 | 72.1 | 65.5 | Qwen4 maior em 6.6 |
| HLAB-Vals-1.1 | 21.3 | 11.7 | Qwen4 maior em 9.6 |
| AA-Briefcase v1.1 Elo | 1686 | 1674 | Qwen4 maior em 12 |
| AgentArena Net Improvement | 7.5 | 3.9 | Qwen4 maior em 3.6 |
| AutomationBench-AA | 72.5 | 73.3 | Kimi maior em 0.8 |
| BioMysteryBench | 85.0 | 80.6 | Qwen4 maior em 4.4 |
| HealthBench Professional | 60.0 | 57.2 | Qwen4 maior em 2.8 |
| Humanity’s Last Exam | 51.7 | 51.1 | praticamente empatados |
O padrão nesses dados é bem claro: o Qwen4-Max lidera na maioria dos casos em tarefas profissionais, na entrega por agentes e em áreas especializadas como biologia e saúde, com margens de 3 a 10 pontos; o Kimi só fica à frente no AutomationBench-AA, por escassos 0.8 ponto, e no HLE os dois praticamente empatam. Vale o alerta: esse é o framework de avaliação da própria Alibaba, então os números do Kimi podem ser diferentes quando medidos no harness da Moonshot.
A saída máxima de 393K tokens e a cadeia de pensamento de até 262K do Qwen4-Max também ajudam bastante em tarefas longas. Isso significa que dá para gerar um relatório ou um arquivo de código bem extenso em uma única chamada, sem precisar quebrar e remontar a saída toda hora — o que reduz os pontos de falha na orquestração de agentes.
Capacidades visuais e de vídeo do Qwen4-Max e do Kimi K3.1 Pro
O Qwen4-Max oferece suporte nativo a entrada visual, e isso também aparece no comparativo da Alibaba: no benchmark de compreensão de gráficos Chartography, o Qwen4 marcou 54,2 e o Kimi, 50,0; no benchmark de compreensão de vídeo Video-Index, o Qwen4 marcou 68,1 e o Kimi, 63,2 — vantagens de 4,2 e 4,9 pontos, respectivamente.
Para negócios que precisam ler capturas de tela, analisar gráficos de relatórios, entender gravações de tela de produtos ou fazer análise de conteúdo de vídeo, o Qwen4-Max é a escolha mais prática. O Kimi até tem resultados nessas duas áreas, mas, se a carga principal for visual, a diferença tende a crescer quando o uso escala.
Na geração de front-end, vale olhar dados de terceiros. No snapshot público do ranking da Arena (2026-11-14), no Code Arena WebDev, o Qwen4-Max (xHigh) aparece em 6º lugar com 1750 pontos, mas ainda marcado como Preliminary, com 1.814 votos; o Kimi K3.1 Pro (Max) está em 13º com 1686 pontos e 5.215 votos, e já não está como preliminary. O Qwen4 tem pontuação maior, mas tem menos amostras, então a posição no ranking ainda pode oscilar.
Como calcular o custo: Qwen4-Max vs Kimi K3.1 Pro
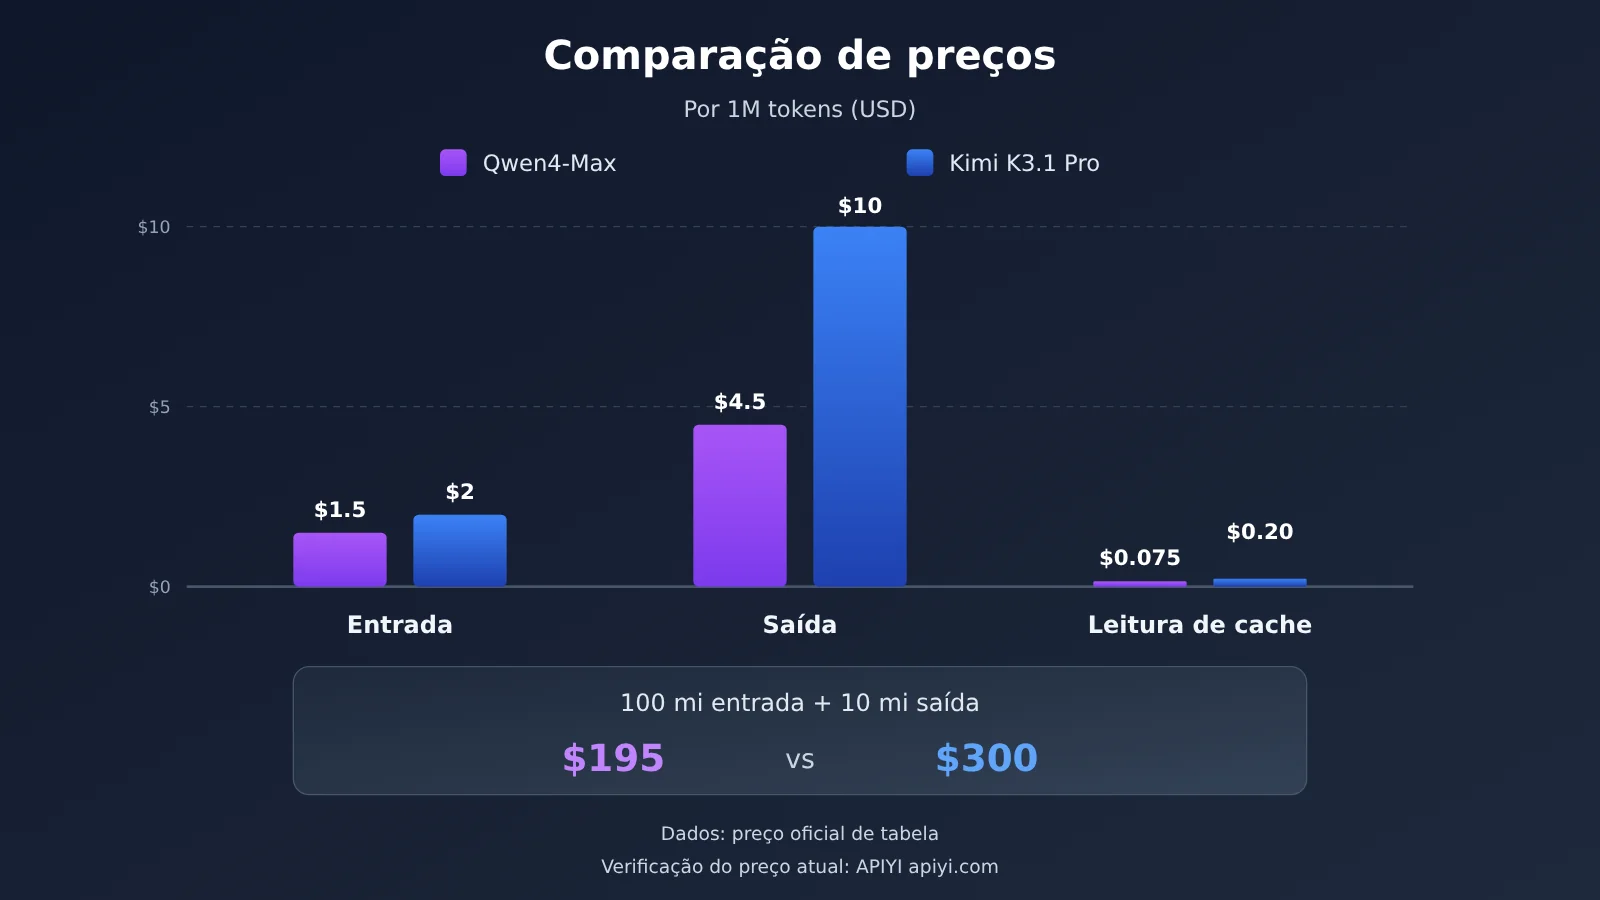
Preço de tabela oficial (por 1M tokens, dados de 2026-11-16)
| Item de cobrança | Qwen4-Max (QwenCloud) | Kimi K3.1 Pro (Moonshot) | Kimi K3.1 Pro Highspeed |
|---|---|---|---|
| Entrada | $1.5 | $2 | $4 |
| Saída | $4.5 | $10 | $20 |
| Leitura de cache / acerto de cache | $0.075 | $0.20 | $0.20 |
| Escrita de cache de 5 minutos | $1.875 | $2 | — |
| Escrita de cache de 1 hora | $3 | $4 | — |
Convertendo pelos preços de tabela, o preço de entrada do Qwen4-Max é 75% do Kimi, o de saída é 45%, e a leitura de cache é só 37,5%. Estimando com uma carga típica de agente de “100 milhões de tokens de entrada + 10 milhões de saída”, o Qwen4-Max fica em cerca de $195 e o Kimi K3.1 Pro em cerca de $300. O Kimi também tem o modo Batch, com preço de 60% do padrão, ideal para tarefas em lote offline; a versão Highspeed custa o dobro e entrega cerca de 2 a 3 vezes mais velocidade.
Token mais barato não significa tarefa mais barata
Esse é o ponto mais contraintuitivo da dimensão de custo. O snapshot da arena mostra que o custo por tarefa do Qwen4-Max (xHigh) é $4.18, enquanto o do Kimi K3.1 Pro (Max) é de apenas $0.89. O Qwen4 é mais barato por token, mas por tarefa fica várias vezes mais caro — o motivo é que, no nível de effort alto, o modelo gera uma quantidade enorme de tokens de cadeia de pensamento, com volume de saída muito acima do Kimi.
Por isso, ao calcular o custo real, é preciso olhar para “preço × consumo real de tokens”. O reasoning_effort padrão do Qwen4-Max é high; se a tarefa não exige raciocínio profundo, vale a pena reduzir o effort de propósito para converter a vantagem de preço unitário em vantagem de custo total.
Preços atuais no APIYI (2026-11-16)
| ID do modelo | Entrada | Saída | Leitura de cache | Status |
|---|---|---|---|---|
kimi-k3.1-pro |
$2 | $10 | $0.2 | Disponível |
kimi-k3.1-pro-highspeed |
$4 | $20 | $0.2 | Disponível |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | Disponível |
qwen4-max |
— | — | — | Ainda não disponível; vamos disponibilizar em breve |
Os valores acima são por 1M tokens. O qwen4-max ainda não aparece na lista de modelos do APIYI; vamos disponibilizá-lo em breve. Até lá, você pode montar seu pipeline de chamadas com qwen3.8-max. Todos os nomes de modelos e preços seguem a lista de modelos da plataforma APIYI apiyi.com — antes de trocar de modelo, vale a pena conferir o modelo, checar o preço e confirmar o protocolo de chamada.
Como chamar Kimi K3.1 Pro e a série Qwen pela APIYI
A APIYI oferece uma interface compatível com OpenAI. Para integrar, são necessárias apenas três alterações, sem trocar o SDK:
- Defina o
base_urldo cliente comohttps://api.apiyi.com/v1; o caminho da requisição é/chat/completions; - Preencha a chave API obtida no console da APIYI;
- Defina o parâmetro
modelcomokimi-k3.1-pro,kimi-k3.1-pro-highspeedouqwen3.8-max. Quando oqwen4-maxestiver disponível, basta substituir o identificador do modelo.
Ao fazer comparações A/B, recomendo manter fixos o comando, as definições de ferramentas e o nível de esforço, alterando apenas o campo model, e registrar, a cada chamada, o número de tokens de entrada, saída e cache. Assim, você consegue tanto reproduzir o fenômeno descrito anteriormente de que “o harness altera a pontuação” quanto calcular o custo real por tarefa de cada modelo no seu negócio.
🚀 Início rápido: novos usuários que se cadastrarem em APIYI apiyi.com recebem uma cota gratuita de testes. Com a mesma chave, é possível alternar entre os modelos Kimi e da série Qwen. Valide primeiro com pouco tráfego e depois decida qual será o modelo principal no ambiente de produção.
Recomendações de cenários para Qwen4-Max e Kimi K3.1 Pro
Quando escolher Kimi K3.1 Pro
- Implantação privada e ajuste fino: quando você precisa de pesos abertos para ajuste fino de domínio, quantização ou implantação offline;
- Agente de codificação no terminal: quando a carga principal é o ciclo de leitura, escrita, execução e correção na linha de comando;
- Processamento em lote offline: quando resultados assíncronos são aceitáveis e você pode usar o Batch com 40% de desconto para reduzir custos;
- Interação de baixa latência: se velocidade for crítico, escolha a versão Highspeed e troque preço por 2 a 3 vezes mais velocidade.
Quando escolher Qwen4-Max
- Prioridade a serviço gerenciado: quando você não quer manter um cluster de inferência e só precisa de uma API estável;
- Visão e vídeo: quando a principal entrada é compreensão de capturas de tela, análise de gráficos e análise de vídeo;
- Entrega de tarefas longas: geração de relatórios, agentes de fluxos de negócio e perguntas especializadas, como medicina e biologia;
- Sensibilidade ao custo por token: com o nível de esforço bem controlado, é o menor custo por milhão de tokens.
Recomendações de decisão: Qwen4-Max vs Kimi K3.1 Pro
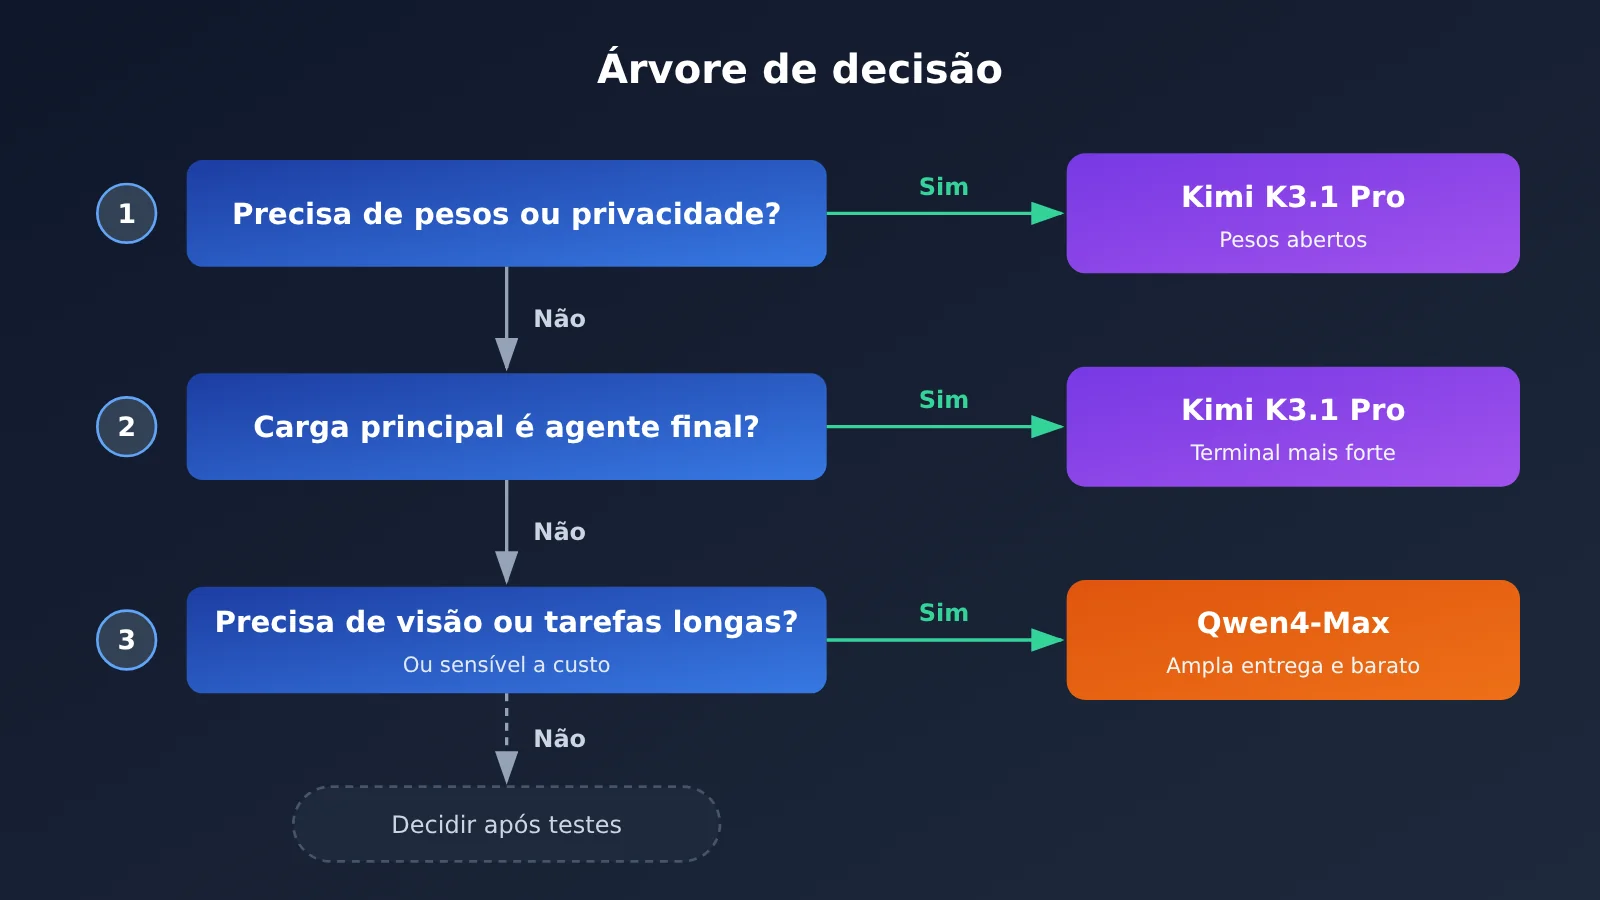
Resumindo cinco dimensões em três perguntas: primeiro, você precisa necessariamente obter os pesos? Se sim, escolha diretamente o Kimi K3.1 Pro. Segundo, sua carga principal é um agente de linha de comando no terminal? Se sim, o Kimi é mais estável. Terceiro, se nenhuma das anteriores se aplica, o Qwen4-Max leva vantagem em visão, entrega de tarefas de longa duração e preço unitário.
O uso combinado também é comum: usar o Kimi K3.1 Pro para execução no terminal e a linha Qwen para compreensão visual e entrega de relatórios. Esse tipo de orquestração exige que os dois modelos usem o mesmo conjunto de interfaces; um gateway unificado elimina bastante trabalho de adaptação.
💡 Recomendação de escolha: a seleção depende, no fim, da distribuição das suas tarefas. Sugerimos rodar uma rodada comparativa com tarefas reais na APIYI apiyi.com, registrar a taxa de sucesso e o consumo de tokens dos dois lados usando o mesmo base_url, e só então decidir o modelo principal.
Perguntas frequentes (FAQ)
Q1: Qual é a maior diferença entre Qwen4-Max e Kimi K3.1 Pro?
O Kimi K3.1 Pro é um modelo de pesos abertos de escala 3T, que pode ser implantado e ajustado por conta própria; o Qwen4-Max é oferecido como API gerenciada, tem visão nativa e preço de tabela mais baixo. O primeiro se destaca em tarefas de terminal; o segundo, em visão e entrega de tarefas de longa duração.
Q2: O Terminal-Bench do Kimi K3.1 Pro é 65.7 ou 67.2?
Os dois estão corretos, mas os critérios são diferentes. Os 65.7% vêm da documentação oficial da Moonshot; os 67.2 vêm da comparação no mesmo gráfico reportada pela própria Qwen. A diferença vem do harness, do effort e da versão do conjunto de tarefas. Ao citar, é obrigatório indicar a fonte, não misturar os números nem montar rankings combinando documentos diferentes.
Q3: Os dois têm o mesmo comprimento de contexto?
Praticamente iguais. O Kimi K3.1 Pro tem 1,048,576 token, e o Qwen4-Max tem 1M. O Qwen4-Max também informa o máximo de saída de 393K e o máximo de cadeia de raciocínio de 262K, o que favorece saídas longas em uma única chamada.
Q4: Por que o Qwen4-Max tem preço unitário menor, mas o custo por tarefa na arena é maior?
No snapshot da arena, o Qwen4-Max usa o nível xHigh, consome muitos tokens de cadeia de raciocínio e custa $4.18 por tarefa, enquanto o Kimi K3.1 Pro (Max) custa $0.89. O custo real é o preço unitário multiplicado pelo consumo de tokens; só reduzindo `reasoning_effort` é possível concretizar a vantagem de preço unitário.
Q5: Já é possível chamar o Qwen4-Max pela APIYI?
O `qwen4-max` ainda não está no catálogo; vamos disponibilizá-lo assim que possível. No momento, é possível chamar `kimi-k3.1-pro`, `kimi-k3.1-pro-highspeed` e `qwen3.8-max` na APIYI apiyi.com, com base_url `https://api.apiyi.com/v1`. Modelos e preços seguem a lista de modelos da plataforma.
Q6: Quais são as deficiências conhecidas de cada modelo?
O Qwen4-Max fica claramente atrás nas tarefas de terminal (48.5 contra 67.2 no mesmo gráfico da Alibaba), o ranking na arena ainda é Preliminary e o nível de esforço alto padrão pode elevar o custo por tarefa. O preço dos tokens de saída do Kimi K3.1 Pro é mais de duas vezes o do Qwen4, e ele fica atrás em visão, vídeo e na maioria dos indicadores de entrega do setor.
Qwen4-Max vs Kimi K3.1 Pro: principais pontos (Key Takeaways)
- Os pesos são a linha divisória: para fazer ajuste fino ou implantação privada, só o Kimi K3.1 Pro está disponível.
- Kimi é forte em tarefas de terminal: no mesmo gráfico da Alibaba, o Kimi lidera sobre o Qwen4-Max por 18.7 pontos.
- Benchmark depende do critério: 65.7 e 67.2 vêm de harnesses diferentes, não dá para misturar.
- Qwen4 é forte em entrega e visão: lidera em vários itens como JobBench, APEX-Agents e Video-Index.
- Preço unitário do Qwen4 é menor: o preço de saída é só 45% do Kimi, mas é preciso controlar o effort.
- Como começar: na APIYI, use a mesma chave para alternar entre
kimi-k3.1-proe a série Qwen e fazer a comparação.
Resumo
As conclusões centrais da comparação entre Qwen4-Max e Kimi K3.1 Pro:
- Dá para alterar o modelo?: pesos abertos são vantagem exclusiva do Kimi K3.1 Pro;
- Terminal e entrega: o Kimi é forte em agentes de linha de comando, o Qwen4-Max é forte em entrega de tarefas longas, visão e vídeo;
- Custo: o Qwen4-Max é o mais barato por milhão de tokens, mas a conta real depende do consumo de tokens que o effort provoca.
As pontuações de benchmark só mostram a direção; a resposta final você chega nas suas próprias tarefas. Recomendo rodar uma rodada de comparação com pouco tráfego na APIYI apiyi.com usando uma interface unificada — depois que o qwen4-max for lançado, também dá para trocar o modelo sem nenhum problema e continuar validando.
📚 Materiais de referência
-
Blog oficial do Qwen4-Max: especificações do modelo, contexto e preços do QwenCloud
- Link:
qwen.ai/blog?id=qwen4-max - Descrição: inclui dados comparativos de mesma imagem autorreportados oficialmente pelo Qwen
- Link:
-
Início rápido do Kimi K3.1 Pro: documentação oficial da Moonshot
- Link:
platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart.md - Descrição: inclui pontuações autorreportadas oficiais do Terminal-Bench 4.0 e do Kimi Code Bench 3.0
- Link:
-
Preços dos modelos de chat Kimi: página oficial de preços da Moonshot
- Link:
platform.kimi.ai/docs/pricing/chat.md - Descrição: regras de cobrança da versão padrão, da versão Highspeed e do Batch
- Link:
-
Arena Code Arena WebDev: snapshot do ranking público, 2026-11-14
- Link:
arena.ai - Descrição: ranking por votos de terceiros e custo por tarefa
- Link:
Autor: equipe técnica da APIYI
Comunicação técnica: sinta-se à vontade para entrar em contato conosco pela página inicial do site APIYI; mais materiais estão disponíveis no centro de documentação em docs.apiyi.com