作者注:從權重開放、終端任務、長任務交付、視覺視頻和每百萬 token 成本五個維度對比 Qwen4-Max 與 Kimi K3.1 Pro,並解釋兩家官方 Terminal-Bench 分數爲何不一致。
先給結論:需要拿到權重做微調、量化或私有化部署,選 Kimi K3.1 Pro;需要託管 API,同時重視視覺、視頻、長任務交付,並想把每百萬 token 成本壓到最低,選 Qwen4-Max。如果你的核心負載是終端裏的命令行 agent,Kimi K3.1 Pro 目前優勢明顯。
這不是一份“各有千秋”的折中分析。下文所有數字都標明出處:Qwen 數字來自阿里官方博客與官方自報的同圖對照,Kimi 數字來自 Moonshot 官方文檔,第三方數據來自 arena 公開榜快照(2026-11-14)。兩家自報的同一項基準爲什麼對不上,本文會單獨拆開講。
核心價值:讀完本文,你會得到一條清晰的選型分界線,並知道如何把“更便宜”和“能拿權重”這兩個優勢換算到自己的任務上。
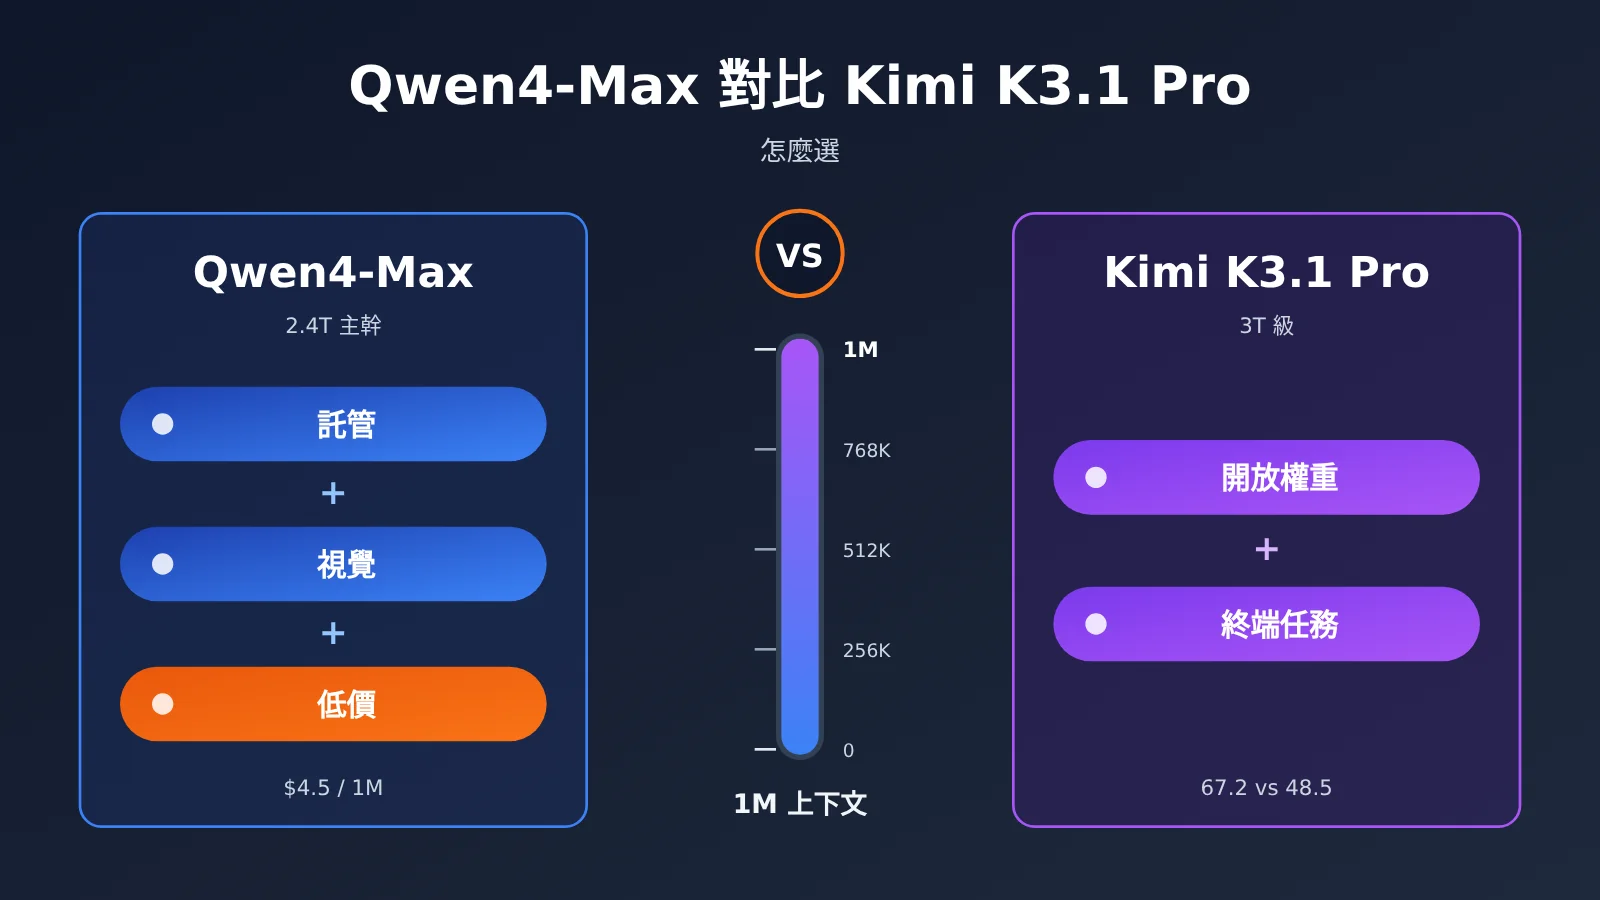
Qwen4-Max 對比 Kimi K3.1 Pro 核心差異
兩款模型都是 2026 年下半年的國產旗艦,上下文都在 1M 級別,表面參數接近,但定位差異很大。Qwen4-Max 採用 2.4T 主幹、71B 激活參數,外加 328B N-gram Embedding,原生支持視覺,最大輸出 393K,最大思維鏈 262K,默認 reasoning_effort 爲 high。Kimi K3.1 Pro 是 K3.1 系列的首個模型,屬於 3T 級,官方稱其爲能力最強的 3T 級開放權重模型,上下文爲 1,048,576 token。
| 對比維度 | Qwen4-Max | Kimi K3.1 Pro | 傾向 |
|---|---|---|---|
| 規模 | 2.4T 主幹 / 71B 激活 + 328B N-gram Embedding | 3T 級 | — |
| 權重 | 公開資料僅提及 QwenCloud 託管 API | 開放權重 | Kimi |
| 上下文 | 1M,最大輸出 393K | 1,048,576 token | 持平 |
| 終端任務(阿里同圖) | 48.5 | 67.2 | Kimi |
| 長任務與行業交付 | 多項領先 | AutomationBench 略高 | Qwen4 |
| 視覺與視頻 | 原生視覺,圖表與視頻指標領先 | 指標落後 | Qwen4 |
| 每 1M 輸出價格 | $4.5 | $10 | Qwen4 |
一句話概括:Kimi 的優勢在於“能改”和“能跑終端”,Qwen4 的優勢在於“交付面廣”和“便宜”。下面按五個維度分別展開。
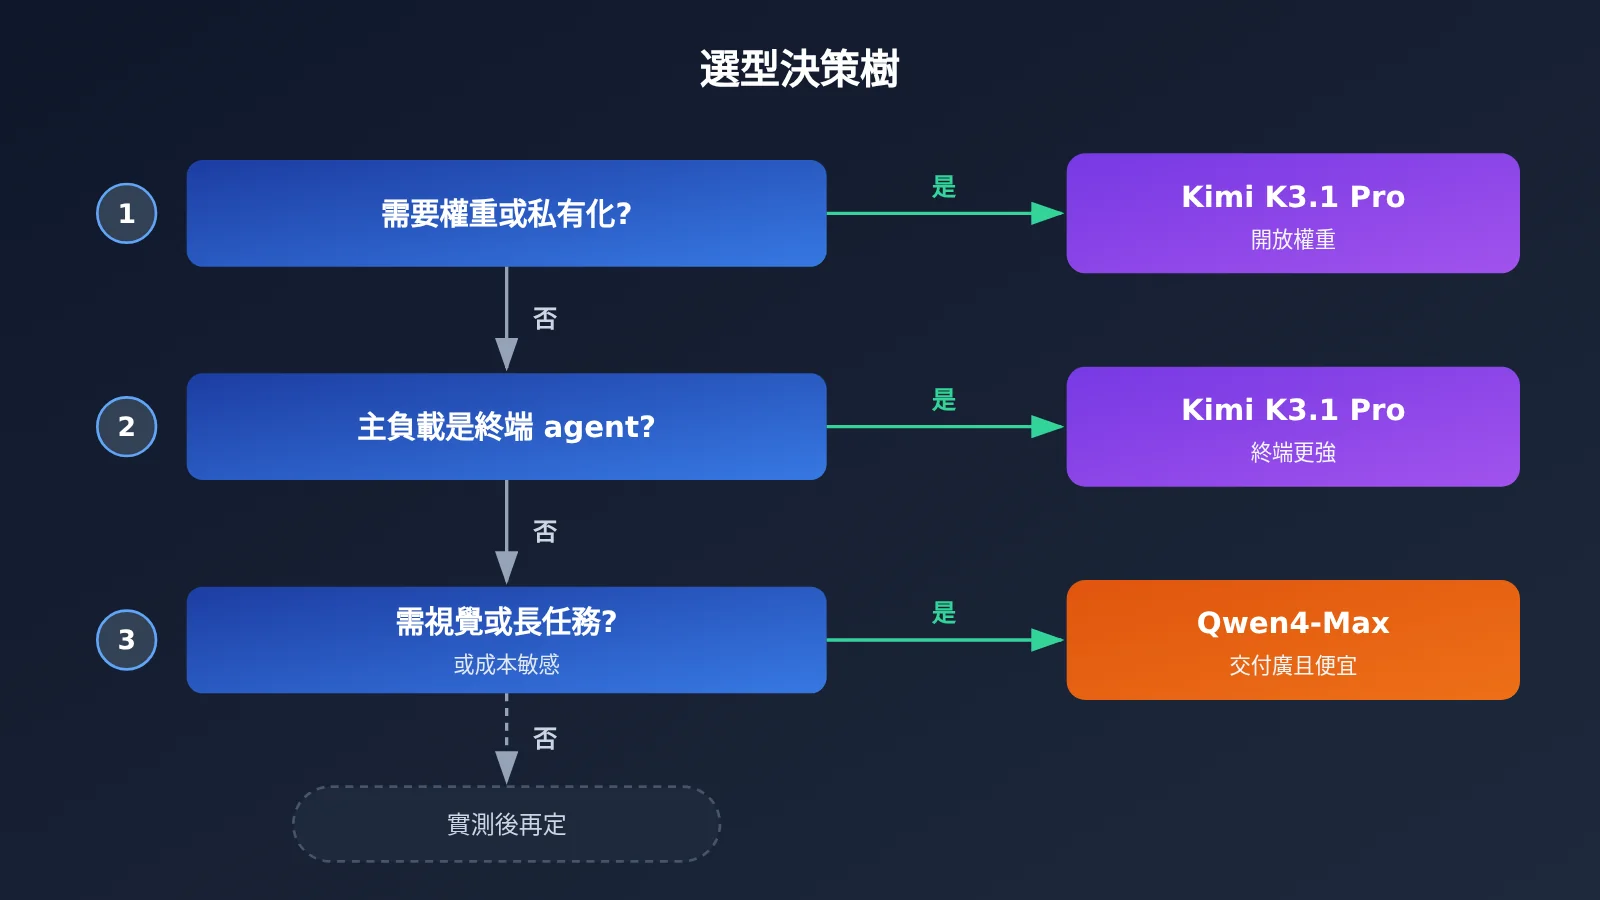
Kimi K3.1 Pro 與 Qwen4-Max 能不能改權重
這是兩者最硬的分界線。Kimi K3.1 Pro 是開放權重模型,團隊可以把它拉到自己的集羣上做領域微調、量化壓縮、蒸餾,或者在合規要求嚴格的環境裏離線部署。對於需要“改模型本身”的團隊,這一點沒有替代方案,再高的跑分也換不來。
Qwen4-Max 目前的公開資料只提到通過 QwenCloud 以託管 API 方式提供,參考資料中沒有提及開放權重。託管的好處是不用管顯卡、推理框架和擴縮容,壞處是隻能通過提示詞、上下文和工具調用來適配業務。需要說明的是,開放權重本身並不自動等於更安全,安全性仍取決於你的部署、訪問控制與審計流程。
換算方法:如果你只是“調用模型”,權重開放對你的價值約等於零;如果你明確要微調或私有化,Kimi 是這組對比裏唯一的選項,後面幾個維度只用來評估它是否“夠用”。
Qwen4-Max 對比 Kimi K3.1 Pro 終端任務誰強
終端任務指模型在命令行環境裏讀寫文件、執行命令、根據報錯迭代修復,是編碼 agent 最貼近真實工作的場景。這一項 Kimi K3.1 Pro 明顯更強:阿里官方自報的同圖對照中,Qwen4-Max 的 Terminal-Bench 4.0 得分爲 48.5,Kimi K3.1 爲 67.2,差距 18.7 分,是整張圖上 Qwen4 落後最多的一項。
Terminal-Bench 兩家口徑爲什麼不一樣
這裏有一個容易被忽略的細節:同一個 Kimi K3.1 Pro,在兩家官方材料裏的 Terminal-Bench 4.0 分數並不相同。
| 來源 | Kimi K3.1 Pro | 其他參照 |
|---|---|---|
| Moonshot 官方文檔 | 65.7% | Claude Opus 5.5 爲 66.4%,GPT-6 Astra 爲 58.2% |
| Qwen 官方自報的同圖對照 | 67.2 | Qwen4-Max 爲 48.5 |
Kimi 自家寫的是 65.7%,阿里圖上給 Kimi 標的是 67.2,相差 1.5 分。這個差值來自評測 harness(代理框架、工具定義、超時與重試策略)、reasoning effort 設置以及題集版本的不同,不能解讀爲任何一方造假,也不能把兩個數字混成一個“Kimi 終端任務得分”來引用。同理,Claude Opus 5.5 在 Moonshot 文檔中是 66.4%,放在阿里的測評框架下也會是另一個數,跨文檔拼接排名是不成立的。
正確的讀法是:只在同一張圖、同一套 harness 內比較相對位置。在 Moonshot 的口徑下,Kimi 略低於 Opus 5.5、明顯高於 GPT-6 Astra;在阿里的口徑下,Kimi 大幅領先 Qwen4-Max。兩個結論都成立,結論方向也一致——Kimi K3.1 Pro 的終端能力處於第一梯隊。
🎯 技術建議:基準分數會隨 harness 與 effort 浮動,最可靠的辦法是用你自己的 agent 框架和真實任務各跑一輪。通過 API易 apiyi.com 可以用同一個 API Key 調用
kimi-k3.1-pro等模型,保持框架不變、只切換model參數,得到的對比才有意義。
另一個相關項是代碼類任務的其餘指標。在阿里同圖中,DeepSWE v1.1 兩者基本打平(75.7 對 75.5),ProgramBench 上 Qwen4-Max 高 6.5 分(31.5 對 25.0)。Moonshot 官方文檔還給出 Kimi Code Bench 3.0 Long-horizon 61.2%,相比上一代 K3 的 55.95% 有明顯提升。所以準確的說法是:Kimi 強在終端交互,Qwen4 在部分非終端編碼任務上不落下風。
Qwen4-Max 與 Kimi K3.1 Pro 長任務與行業交付
如果你的 agent 負責的是“把一件工作完整交付”——整理報告、走完業務流程、處理專業領域問題——Qwen4-Max 在阿里同圖裏的表現更好。下表摘錄 Qwen 官方自報的同圖對照中與長任務、行業場景相關的指標。
| 基準(Qwen 官方自報同圖) | Qwen4-Max | Kimi K3.1 | 差值 |
|---|---|---|---|
| JobBench | 68.5 | 61.2 | Qwen4 高 7.3 |
| APEX-Agents v1.1 | 72.1 | 65.5 | Qwen4 高 6.6 |
| HLAB-Vals-1.1 | 21.3 | 11.7 | Qwen4 高 9.6 |
| AA-Briefcase v1.1 Elo | 1686 | 1674 | Qwen4 高 12 |
| AgentArena Net Improvement | 7.5 | 3.9 | Qwen4 高 3.6 |
| AutomationBench-AA | 72.5 | 73.3 | Kimi 高 0.8 |
| BioMysteryBench | 85.0 | 80.6 | Qwen4 高 4.4 |
| HealthBench Professional | 60.0 | 57.2 | Qwen4 高 2.8 |
| Humanity’s Last Exam | 51.7 | 51.1 | 基本持平 |
這組數據的規律很清楚:Qwen4-Max 在職業任務、agent 交付和生物醫療等專業領域多數領先,幅度在 3 到 10 分之間;Kimi 只在 AutomationBench-AA 上以 0.8 分微弱領先,HLE 兩者幾乎相同。需要提醒的是,這是阿里一方的測評框架,Kimi 在自家 harness 下的數字可能會有所不同。
Qwen4-Max 的 393K 最大輸出和 262K 最大思維鏈,對長任務也很實用。它意味着一次調用裏可以生成很長的報告或代碼文件,而不必頻繁拆分、拼接,減少了 agent 編排中的出錯點。
Qwen4-Max 與 Kimi K3.1 Pro 視覺與視頻能力
Qwen4-Max 原生支持視覺輸入,這在阿里同圖中也有體現:圖表理解基準 Chartography 上 Qwen4 爲 54.2、Kimi 爲 50.0,視頻理解基準 Video-Index 上 Qwen4 爲 68.1、Kimi 爲 63.2,分別領先 4.2 和 4.9 分。
對於需要讀截圖、解析報表圖表、理解產品錄屏或做視頻內容分析的業務,Qwen4-Max 是更省事的選擇。Kimi 在這兩項上雖然也有成績,但如果視覺是主負載,差距會在規模化後被放大。
前端生成方面可以看第三方數據。arena 公開榜快照(2026-11-14)的 Code Arena WebDev 中,Qwen4-Max(xHigh)以 1750 分排第 6,但仍標註爲 Preliminary,票數 1,814;Kimi K3.1 Pro(Max)1686 分排第 13,票數 5,215,已非 preliminary。Qwen4 分數更高,但樣本更少,排名後續仍可能波動。
Qwen4-Max 對比 Kimi K3.1 Pro 成本怎麼算
官方掛牌價(每 1M tokens,取數日期 2026-11-16)
| 計費項 | Qwen4-Max(QwenCloud) | Kimi K3.1 Pro(Moonshot) | Kimi K3.1 Pro Highspeed |
|---|---|---|---|
| 輸入 | $1.5 | $2 | $4 |
| 輸出 | $4.5 | $10 | $20 |
| 緩存讀 / 緩存命中 | $0.075 | $0.20 | $0.20 |
| 5 分鐘緩存寫 | $1.875 | $2 | — |
| 1 小時緩存寫 | $3 | $4 | — |
按掛牌價換算,Qwen4-Max 的輸入價是 Kimi 的 75%,輸出價是 45%,緩存讀只有 37.5%。以“1 億輸入 + 1000 萬輸出”的典型 agent 負載估算,Qwen4-Max 約 $195,Kimi K3.1 Pro 約 $300。Kimi 另有 Batch 模式,價格爲標準價的六折,適合離線批量任務;Highspeed 版本價格翻倍,換來約 2 到 3 倍的速度。
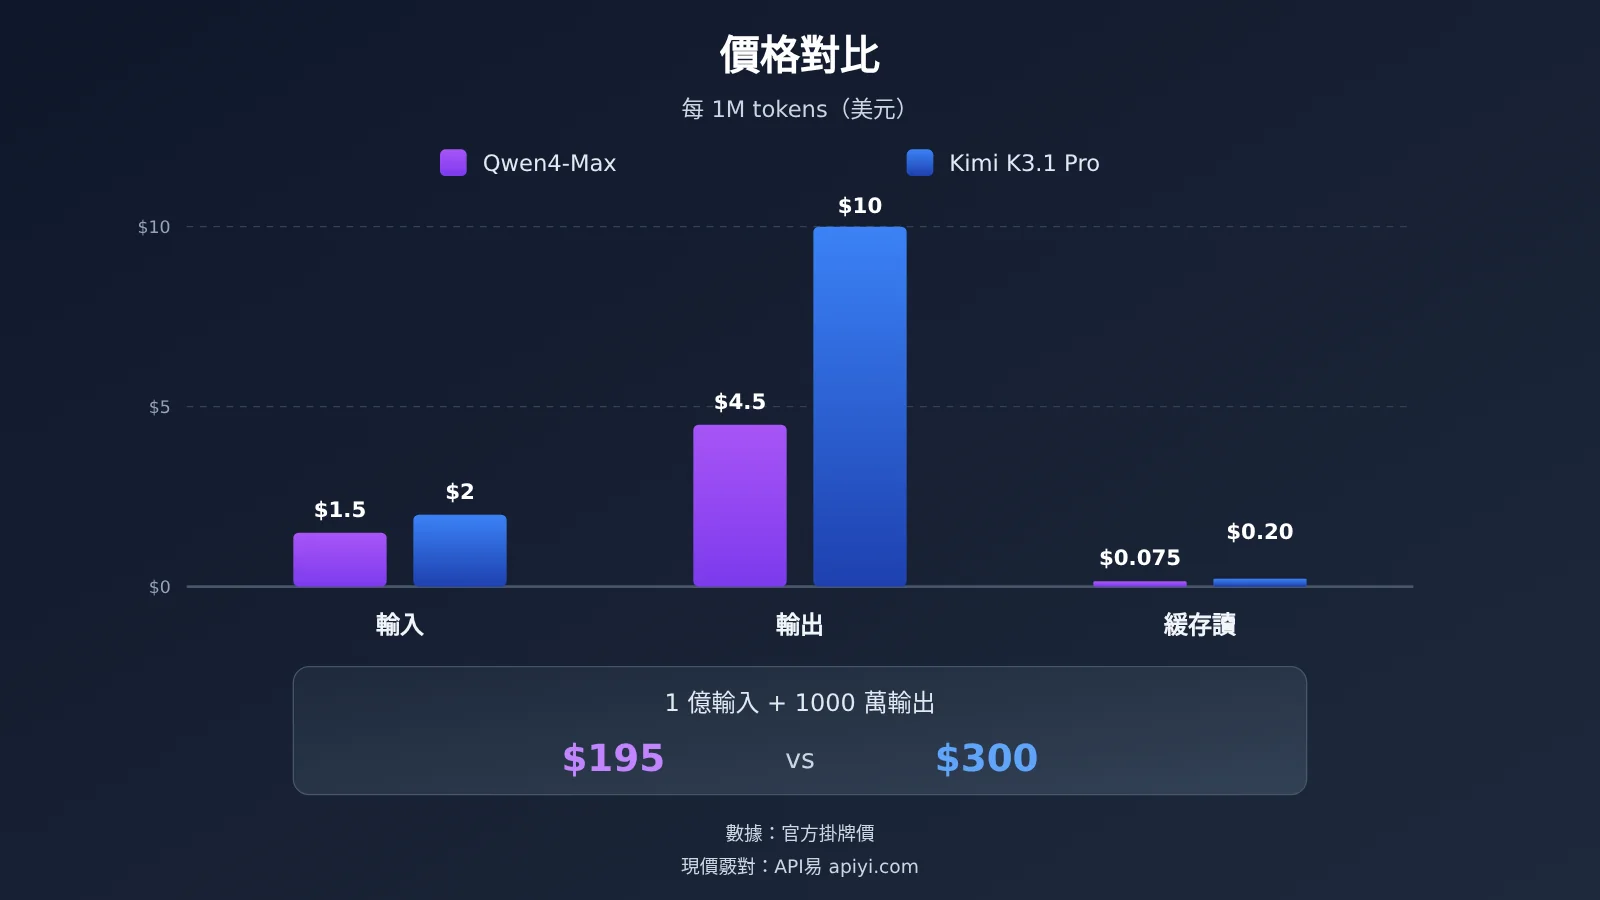
單 token 便宜不等於單任務便宜
這是成本維度裏最反直覺的一點。arena 快照顯示,Qwen4-Max(xHigh)的單任務成本爲 $4.18,Kimi K3.1 Pro(Max)只有 $0.89。Qwen4 每 token 更便宜,單任務卻貴了數倍,原因在於高 effort 檔位下模型會生成大量思維鏈 token,輸出量遠超 Kimi。
因此計算真實成本時要看“價格 × 實際 token 消耗”。Qwen4-Max 默認 reasoning_effort 爲 high,如果任務不需要深度推理,主動調低 effort 才能把單價優勢兌現成總成本優勢。
API易 現價(2026-11-16)
| 模型 ID | 輸入 | 輸出 | 緩存讀 | 狀態 |
|---|---|---|---|---|
kimi-k3.1-pro |
$2 | $10 | $0.2 | 已上架 |
kimi-k3.1-pro-highspeed |
$4 | $20 | $0.2 | 已上架 |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | 已上架 |
qwen4-max |
— | — | — | 暫未上架,我們會盡快上架 |
以上爲每 1M tokens 價格。qwen4-max 目前還沒有出現在 API易 的型號列表裏,我們會盡快上架這個模型;在此之前,可以先用 qwen3.8-max 搭好調用鏈路。所有型號名稱與價格以 API易 apiyi.com 平臺型號列表爲準,換模型前建議先查型號、對價格,再確認調用協議。
如何通過 API易 調用 Kimi K3.1 Pro 與 Qwen 系列
API易 提供 OpenAI 兼容接口,接入時只需要三處改動,無需更換 SDK:
- 將客戶端的 base_url 設置爲
https://api.apiyi.com/v1,請求路徑爲/chat/completions; - 填入在 API易 控制檯獲取的 API Key;
- 把
model參數設爲kimi-k3.1-pro、kimi-k3.1-pro-highspeed或qwen3.8-max,待qwen4-max上架後直接替換型號即可。
做 A/B 對比時,建議固定提示詞、工具定義和 effort 檔位,只切換 model 字段,並記錄每次調用的輸入、輸出與緩存 token 數。這樣既能復現前文“harness 改變分數”的現象,也能算出兩款模型在你業務上的真實單任務成本。
🚀 快速開始:新用戶在 API易 apiyi.com 註冊後有免費測試額度,可以用同一個 Key 在 Kimi 與 Qwen 系列之間切換,先用小流量驗證效果,再決定生產環境的主力模型。
Qwen4-Max 與 Kimi K3.1 Pro 場景推薦
選擇 Kimi K3.1 Pro 的場景
- 私有化與微調:需要開放權重做領域微調、量化或離線部署;
- 終端編碼 agent:主負載是命令行裏的讀寫、執行與修復循環;
- 離線批處理:可以接受異步結果,利用 Batch 六折壓低成本;
- 低延遲交互:對速度敏感時可選 Highspeed 版本,以價格換 2 到 3 倍速度。
選擇 Qwen4-Max 的場景
- 託管優先:不想維護推理集羣,只需要穩定的 API;
- 視覺與視頻:截圖理解、圖表解析、視頻分析是主要輸入;
- 長任務交付:報告生成、業務流程 agent、醫療生物等專業問答;
- 按 token 成本敏感:在控制好 effort 的前提下,每百萬 token 成本最低。
Qwen4-Max 對比 Kimi K3.1 Pro 決策建議
把五個維度壓縮成三個問題:第一,是否必須拿到權重?是則直接選 Kimi K3.1 Pro。第二,主負載是否爲終端命令行 agent?是則 Kimi 更穩。第三,以上都不是,那麼 Qwen4-Max 在視覺、長任務交付和單價上更有優勢。
混合使用也是常見做法:用 Kimi K3.1 Pro 承擔終端執行,用 Qwen 系列處理視覺理解與報告交付。這種編排要求兩個模型走同一套接口,統一網關能省掉不少適配工作。
💡 選擇建議:選型最終取決於你的任務分佈。我們建議在 API易 apiyi.com 上用真實任務跑一輪對照,用同一個 base_url 記錄兩邊的成功率和 token 消耗,再決定主力模型。
常見問題 FAQ
Q1: Qwen4-Max 和 Kimi K3.1 Pro 最大的區別是什麼?
Kimi K3.1 Pro 是 3T 級開放權重模型,可以自行部署和微調;Qwen4-Max 以託管 API 形式提供,原生視覺,掛牌價更低。前者強在終端任務,後者強在視覺與長任務交付。
Q2: Kimi K3.1 Pro 的 Terminal-Bench 到底是 65.7 還是 67.2?
兩個都對,但口徑不同。65.7% 出自 Moonshot 官方文檔,67.2 出自 Qwen 官方自報的同圖對照,差異來自 harness、effort 和題集版本。引用時必須註明來源,不能混用,也不能跨文檔拼接排名。
Q3: 兩者的上下文長度一樣嗎?
基本一致。Kimi K3.1 Pro 爲 1,048,576 token,Qwen4-Max 爲 1M。Qwen4-Max 額外公開了最大輸出 393K 與最大思維鏈 262K,對單次長輸出更友好。
Q4: 爲什麼 Qwen4-Max 單價更低,arena 上的單任務成本反而更高?
arena 快照中 Qwen4-Max 使用 xHigh 檔位,思維鏈 token 消耗大,單任務成本 $4.18,而 Kimi K3.1 Pro(Max)爲 $0.89。真實成本等於單價乘以 token 消耗,調低 `reasoning_effort` 才能兌現單價優勢。
Q5: 現在能通過 API易 調用 Qwen4-Max 嗎?
`qwen4-max` 暫未上架,我們會盡快上架。目前可在 API易 apiyi.com 調用 `kimi-k3.1-pro`、`kimi-k3.1-pro-highspeed` 和 `qwen3.8-max`,base_url 爲 `https://api.apiyi.com/v1`,型號與價格以平臺型號列表爲準。
Q6: 兩款模型各有哪些已知不足?
Qwen4-Max 在終端任務上明顯落後(阿里同圖 48.5 對 67.2),arena 排名仍爲 Preliminary,默認高 effort 可能推高單任務成本。Kimi K3.1 Pro 輸出價是 Qwen4 的兩倍多,在視覺、視頻和多數行業交付指標上落後。
Qwen4-Max 對比 Kimi K3.1 Pro 核心要點 Key Takeaways
- 權重是硬分界:要微調或私有化,只有 Kimi K3.1 Pro 可選。
- 終端任務 Kimi 強:阿里同圖中 Kimi 領先 Qwen4-Max 18.7 分。
- 跑分看口徑:65.7 與 67.2 來自不同 harness,不能混用。
- 交付與視覺 Qwen4 強:JobBench、APEX-Agents、Video-Index 等多項領先。
- 單價 Qwen4 低:輸出價僅爲 Kimi 的 45%,但要控制 effort。
- 上手方式:在 API易 用同一個 Key 切換
kimi-k3.1-pro與 Qwen 系列做對照。
總結
Qwen4-Max 對比 Kimi K3.1 Pro 的核心結論:
- 能不能改模型:開放權重是 Kimi K3.1 Pro 的獨佔優勢;
- 終端與交付:Kimi 強在命令行 agent,Qwen4-Max 強在長任務交付、視覺和視頻;
- 成本:Qwen4-Max 每百萬 token 最便宜,但真實賬單取決於 effort 帶來的 token 消耗。
基準分數只能告訴你方向,最終答案要在你自己的任務上得出。推薦通過 API易 apiyi.com 用統一接口跑一輪小流量對照,qwen4-max 上架後也可以無縫替換型號繼續驗證。
📚 參考資料
-
Qwen4-Max 官方博客:模型規格、上下文與 QwenCloud 定價
- 鏈接:
qwen.ai/blog?id=qwen4-max - 說明: 含 Qwen 官方自報的同圖對照數據
- 鏈接:
-
Kimi K3.1 Pro 快速入門:Moonshot 官方文檔
- 鏈接:
platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart.md - 說明: 含 Terminal-Bench 4.0 與 Kimi Code Bench 3.0 官方自報分數
- 鏈接:
-
Kimi 對話模型定價:Moonshot 官方價格頁
- 鏈接:
platform.kimi.ai/docs/pricing/chat.md - 說明: 標準版、Highspeed 版與 Batch 計費規則
- 鏈接:
-
Arena Code Arena WebDev:公開榜快照,2026-11-14
- 鏈接:
arena.ai - 說明: 第三方投票排名與單任務成本
- 鏈接:
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心